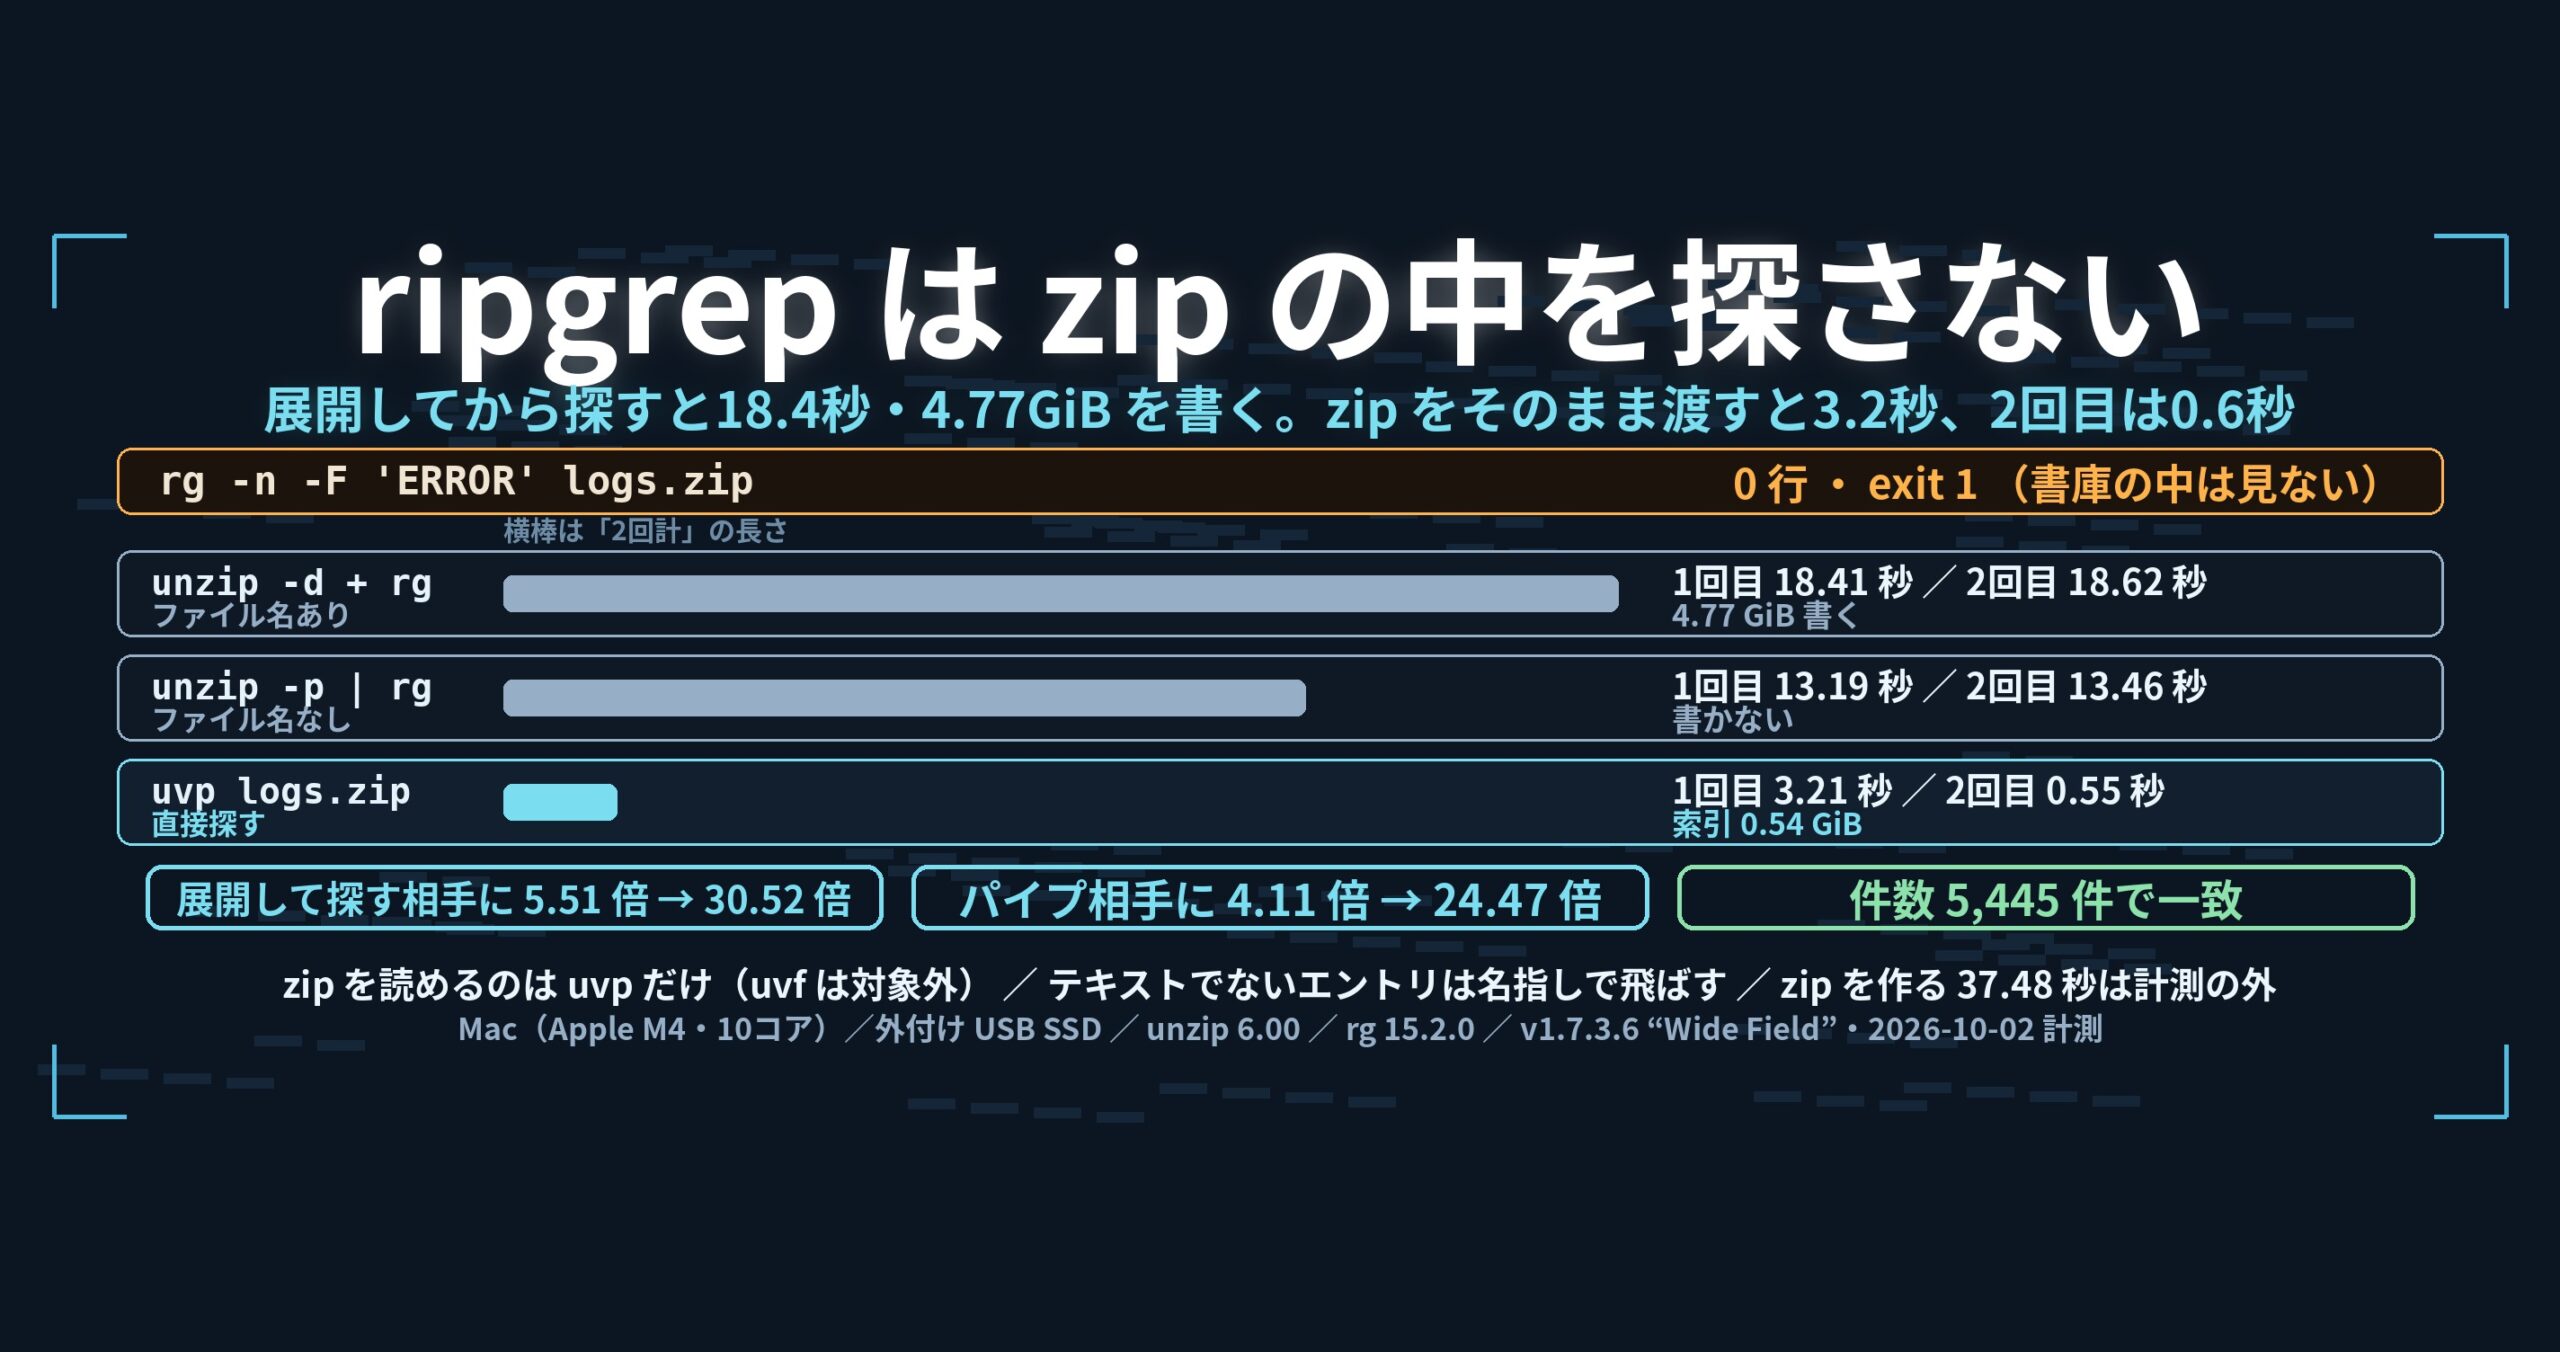
0件、と返ってきます。
rg に zip を渡しても、中は見てくれません。終了コードは1。ログを zip で固めて置いてあると、まず展開しないと探せないわけです。
その展開は、いくらの買い物でしょうか。
- 先に結論: uvp は zip を直接探します。unzip で展開してから rg にかけると cold 18.41秒・hot 18.62秒(4.77GiB をディスクに書いてから探す)、unzip -p のパイプなら 13.19秒・13.46秒。uvp は 1回目 3.21秒(索引作成込み)・2回目 0.55秒で、展開して探す形に対して 5.51倍/30.52倍(パイプ相手なら 4.11倍/24.47倍)。件数は 5,445件で一致。ただし zip を読めるのは有料版の uvp だけです
- 先に、できないことと代価を書きます
- まず、rg が何をするか
- 展開の仕方は2つあって、値段が違う
- 数字
- エントリを絞る — zip!path
- エントリごとに束ねる、という決め方
- 確かめ方
- 持ち帰れる一般論
- 正直に書いておくこと
- 使っている道具
- リンク
先に結論: uvp は zip を直接探します。unzip で展開してから rg にかけると cold 18.41秒・hot 18.62秒(4.77GiB をディスクに書いてから探す)、unzip -p のパイプなら 13.19秒・13.46秒。uvp は 1回目 3.21秒(索引作成込み)・2回目 0.55秒で、展開して探す形に対して 5.51倍/30.52倍(パイプ相手なら 4.11倍/24.47倍)。件数は 5,445件で一致。ただし zip を読めるのは有料版の uvp だけです
対象は uvzip-plain5.zip 0.52GiB(OpenStreetMap の XML 5本・元 4.77GiB を deflate -6 で固めたもの)。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD、相手は unzip 6.00 と ripgrep 15.2.0。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。zip 入力は v1.7.5 相当の実装で、この記事の秒数は v1.7.3.6 の実物を2026年10月2日に測った値です。
先に、できないことと代価を書きます
この回も速さで負けている項目がありません。なので限界のほうを先に並べます。
- 無料版では読めません。 zip を扱えるのは
uvpだけです。 - 索引の置き場所が要ります。 できあがりの
.uwvzは 0.54GiB(エントリを1本に絞ったときは 0.11GiB)。ただし展開して探す形が書く 4.77GiB よりは小さいので、ここは比べ方しだいです。 - 相手は ripgrep 単体ではありません。
rgは書庫の中を見ないので、比べているのはunzipとの組み合わせです。「同じ土俵で速い」のではなく、土俵が1つ少なくて済むという話です。 - テキストでないエントリは束ねません。 画像や実行ファイルが混ざっていたら、名指しで知らせて飛ばします。黙って落とさない代わりに、探せる範囲は狭くなります。
- zip を作る時間は計測の外です。 この記事の 0.52GiB の zip を作るのに 37.48秒かかっていますが、どの道のりでも等しくかかる前提の費用なので、表には入れていません。
.Z(compress)には対応していません。
まず、rg が何をするか
zip をそのまま渡してみます。
$ rg -n -F '東京' uvzip-plain5.zip
$ echo $?
1
出力0行、終了コード1。「無い」と答えます。
これは不具合ではありません。ripgrep は書庫の中を展開して探す道具ではない、というだけです(-z は gzip などの単体の圧縮には効きますが、zip のような書庫は対象外です)。
ただ、使う側から見ると困ります。0件は、正しい答えの顔をしているからです。rg が「この zip は対象外です」と言ってくれるわけではないので、慣れていないと「このログには東京が無い」と受け取ってしまいます。
展開の仕方は2つあって、値段が違う
パイプで流す
unzip -p uvzip-plain5.zip | rg -n -F '東京'
ディスクには何も書きません。そのぶん速い。ただしファイル名が出ません。unzip -p は全エントリの中身を continuous に吐くだけなので、受け取る rg から見れば1本の長いテキストです。行番号も、エントリをまたいで通し番号になります。
「どのファイルの何行目か」が要るなら、これは使えません。
フォルダーに展開する
unzip -q -o -d tmp/ uvzip-plain5.zip && rg -n -F '東京' tmp/
こちらはファイル名も行番号も正しく出ます。実運用ではこの形になることが多いはずです。
その代わり 4.77GiB をディスクに書きます。そして書いたものを、rg がもう一度読みます。
数字
キャッシュを捨てて10秒待ってから1回目(cold)、続けて2回目(hot)。相手は unzip 6.00 + ripgrep 15.2.0。
| 道のり | 1回目 | 2回目 | 2回計 | ディスクに書く量 | 件数 |
|---|---|---|---|---|---|
rg に zip をそのまま |
— | — | — | 0 | 0件・exit 1 |
unzip -p \| rg(ファイル名なし) |
13.19秒 | 13.46秒 | 26.65秒 | 0 | 5,445 |
unzip -d + rg(ファイル名あり) |
18.41秒 | 18.62秒 | 37.03秒 | 4.77GiB | 5,445 |
uvp zip 東京 |
3.21秒(索引作成込み) | 0.55秒 | 3.76秒 | 0.54GiB | 5,445 |
倍率にするとこうなります。
| 相手 | 1回目 | 2回目 | 2回計 |
|---|---|---|---|
unzip -p \| rg |
4.11倍 | 24.47倍 | 7.09倍 |
unzip -d + rg |
5.51倍 | 30.52倍 | 9.37倍 |
1回目から勝っています。これは少し珍しい形です。この連載の第1回でも第4回でも、「束ねる1回目は ripgrep より遅い」と書いてきました。索引を作る仕事は、ただ読むより重いからです。
ここで逆になるのは、相手が1本ずつ順に展開しているからだと見ています。unzip -p は zip の中のエントリを1本ずつ、順番に展開して吐き出します。こちらはエントリを並べて展開しているので、その分だけ先に進む。ただし これを切り分けて測ってはいません。設計からの説明です。
展開が律速なので、2回目も速くならない
表の2列目を見てください。相手は 13.19 → 13.46秒、18.41 → 18.62秒で、2回目がほとんど速くなっていません。
ディスクの読み込みが律速なら、2回目はキャッシュが効くはずです。そうならないのは、時間のほとんどが展開に使われているからです。0.52GiB を読む時間は、4.77GiB 分を展開する時間に比べれば小さい。読み直しを節約できる場所が、そもそも少ないわけです。
同じ形は、First Light の第8回で gz を調べたときにも出ました。展開が律速のとき、cold と hot はほとんど同じになります。
一方 uvp の2回目が 0.55秒まで落ちるのは、.uwvz(uvp 用の圧縮形式+索引)を読んでいるからで、読む量そのものが違います。
エントリを絞る — zip!path
zip 全体ではなく、中の1本だけを探したいときはこう書きます。
uvp 'uvzip-plain5.zip!japan-dv-10m.osm' '東京'
! の右はエントリ名のワイルドカードです(* と ? が使えます)。出力は uvzip-plain5.zip!japan-dv-10m.osm:12345:… の形で出るので、結果の1行をそのまま次の指定に貼り戻せます。
| 1エントリ(1,145件) | 1回目 | 2回目 | 2回計 |
|---|---|---|---|
unzip -p ZIP ENTRY \| rg |
2.74秒 | 2.80秒 | 5.54秒 |
uvp 'ZIP!ENTRY' 東京 |
0.72秒 | 0.15秒 | 0.87秒 |
| 倍率 | 3.81倍 | 18.67倍 | 6.37倍 |
このとき作られた索引の名前が、少し面白いことになりました。
uw-osm17-gc6ybj5yrhoz.uwvz
前回(第8回)に書いた「24文字を超えたら見出し8文字+ハッシュ12文字に切り替える」が、ここで実際に効いています。指定の文字列 osm17/uvzip-plain5.zip!japan-dv-10m.osm を可逆変換すると24文字を大きく超えるので、見出し(osm17)とハッシュの名前になりました。zip 全体を指定したときは uvzip-plain5.zip.uwvz と zip の隣に置かれ、エントリを絞ったときだけカレントに別名で置かれる——指定ごとに別物だからです。
エントリごとに束ねる、という決め方
実装で決めたことを、いくつか書いておきます。
索引の置き場所は、zip 1本なら zip の隣。 logs.zip を開いたのだから logs.zip.uwvz が自然です。エントリを絞ったときは、上に書いたとおり指定から作る名前でカレントに置きます。
テキストでないエントリは束ねず、名指しで知らせます。 判定は先頭4KBに 0 バイトがあるかどうかで、拡張子では決めません。画像や実行ファイルを本文として索引に入れても探せず、行数だけが狂います。かといって黙って落とすと、利用者は「入れたはずのファイルが無い」ことに気付けない。だから not text, skipped: logs.zip!blob.bin のように名前を出して飛ばします。
並びはエントリ名順にそろえます。 zip の中の格納順は、固めた側の都合で変わります。名前順(序数比較)にしておけば、同じ zip からは毎回同じ順で出ます。
そして、直した副作用がひとつあります。束ねた中身の改行コードを決めるとき、以前は「1本目のファイル」の頭を見ていました。zip ではその1本目が圧縮されたバイト列なので、平文が1つも混ざっていないと圧縮バイトを覗いて改行を決めていたことになります。中身を1本開いて頭を読むように直しました。
確かめ方
- 相手: unzip 6.00(
unzip -pとunzip -q -o -d)+ ripgrep 15.2.0(rg -n -F) - 版:
uvf・uvpとも v1.7.3.6 “Wide Field” - データ:
uvzip-plain5.zip0.52GiB。中身は OpenStreetMap の XML 5本(japan-dv-1m/3m/6m/10m/3g.osm・合計 5,126,445,571バイト=4.77GiB)を deflate -6 で固めたもの - 測り方:
sync→ キャッシュ破棄 → 10秒待機 → 1回目 → 続けて2回目。uvpは.uwvzを消してから1回目を取っています - 機械: Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD
- 照合: 件数だけでなく、本文の集合(行番号とファイル名を落として並べ替えたもの)で突き合わせて一致(3ケースとも)。一致しなければ倍率は出しません
- 正しさ: 複数ファイルのテストで「zip の中をエントリごとに束ねて探せる」「テキストでないエントリは名指しで飛ばす」が PASS
- 同じ計測を同日に2回走らせています(
unzip -p13.31/13.49秒 → 13.19/13.46秒、uvp3.22/0.59秒 → 3.21/0.55秒)。値はほぼ同じでした - OS をまたいだ秒数の比較はしていません。この記事の数字はすべて Mac のものです
持ち帰れる一般論
(1)0件を返す相手が、いつも正直とは限らない。 rg が zip に 0件・exit 1 を返すのは仕様どおりです。それでも、受け取る側から見れば「無い」と「見ていない」は区別がつきません。自分が読めない入力を渡されたとき、黙って0件を返さない——これは、こちらの uvf が pbf を断るときにも同じ判断をしています。
(2)「展開してから探す」の値段を、書く量で見る。 パイプなら 0 バイト、フォルダーに出すなら 4.77GiB。速さの差(13.19秒と18.41秒)より、ディスクに 4.77GiB 書いて消すことのほうが運用では効きます。索引 0.54GiB と比べるべきなのは、秒数だけではありません。
(3)順に展開するか、並べて展開するか。 1回目から勝てたのは、相手が1本ずつ順に展開しているからだと見ています。独立に展開できる単位があるなら、それが並列の単位です。zip のエントリ、gz のブロック、pbf の blob——形は違っても、同じ話です。
(4)キャッシュの鍵は、入力の文字列から作る。 エントリを絞った指定が、そのまま索引の名前(見出し+ハッシュ)になりました。前回書いた「引用符を必須にした理由」が、別の入力の形でそのまま効いています。設計の決まりは、想定した場面の外で試されたときに価値が出ます。
正直に書いておくこと
- この記事に速さの負けはありません。代わりに、無料版では読めないこと・索引 0.54GiB の置き場所が要ること・テキストでないエントリは探せないことが代価です
- 相手は ripgrep 単体ではありません。
rgは書庫を探さないので、unzipとの組み合わせと比べています。同じ土俵の比較ではありません - 1回目から勝っている理由を、切り分けて測っていません。「相手は1本ずつ順に展開し、こちらは並べて展開している」は設計からの説明です
- zip を作る 37.48秒は計測の外です。記事に出すなら「準備の時間」として別に数えるべき値です
unzipの設定を詰め切れていない可能性は残ります。-pと-q -o -dの既定のまま測りました- 展開して探す形(18.41秒)には、展開したファイルを消す時間は入っていません。実運用ではそのぶん足されます
- エントリ数の多い zip は試していません。5本の zip で測っています。何千本の小さいエントリを固めた zip では、別の傾向が出るかもしれません
- 暗号化された zip は扱えません。
.Z(compress)にも対応していません - 索引 0.54GiB は zip(0.52GiB)より少し大きくなります。保管の節約にはなりません。速く何度も探すための形です
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと7つの圧縮形式、zip、そして OpenStreetMap の pbf を、外部のコマンドなしで探せます。
uvp ならこう書く
# zip の中を全部探す。1回目に .uwvz を作り、2回目からはそれを読む(UwView Pro)
uvp logs.zip 'ERROR'

# エントリを絞る(! の右はワイルドカードが使える)
uvp 'logs.zip!server/*.log' 'ERROR'

# 大文字小文字を区別しない/正規表現として
uvp logs.zip 'ERROR' -i
uvp logs.zip '[0-9]{3}-[0-9]{4}' -E

# 2語で絞る/前後3行つき
uvp logs.zip ERROR timeout
uvp logs.zip ERROR -C 3 retry

# 捕まえたところを数える
uvp logs.zip 'ERROR' -uniq 'code=([0-9]+)' -sort count -head 20

# 結果を画面で読む(GUI へ渡す)
uvp logs.zip 'ERROR' -open

# その索引が何を束ねたものか見る(無料)
uvp logs.zip.uwvz --info

# 中身を取り出す
uvp logs.zip.uwvz -extract -out out/
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- ファイル指定を引用符ひとつに決めた理由と、24文字で切り替える索引の名前: https://uvp.y42u.net/blog/uwview-wf08-file-globs/
- gz を展開せずに探す(展開律速は cold と hot が同じ): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
- 外部コマンドを呼ばずに7形式を探す: https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- 束ねた索引を使い回す(1本消えても作り直さない): https://uvp.y42u.net/blog/uwview-wf04-bundle-keep/
- 複数ファイルを1コマンドで探す: https://uvp.y42u.net/blog/uwview-wf01-multi-file-one-command/
.uwvzを作って、中を探して、取り出す: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/- 圧縮ログの検索を ugrep・ripgrep・zgrep と比べた: https://uvp.y42u.net/blog/uwview-ugrep-ripgrep-zgrep-compressed-logs/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。