UwView は、ほかのツールに負けた記録の積み重ねでできています。
klogg に機能表で負け、ripgrep に正規表現で負け、grep のパイプには「自動化では今もかなわない」と書いてきました。そのたびに、相手の良いところを1つずつ持ち帰っています。この記事は、その持ち帰ったものの一覧です。 どのツールの何が良かったのか、UwView にどう入れたのか、そして入れなかったものと、その理由も並べます。
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版 UwView、uvpは有料版 UwView Pro)。画面(GUI)とコマンドの両方があります。版番号は、それぞれの機能を紹介した過去の記事に書いた値です。
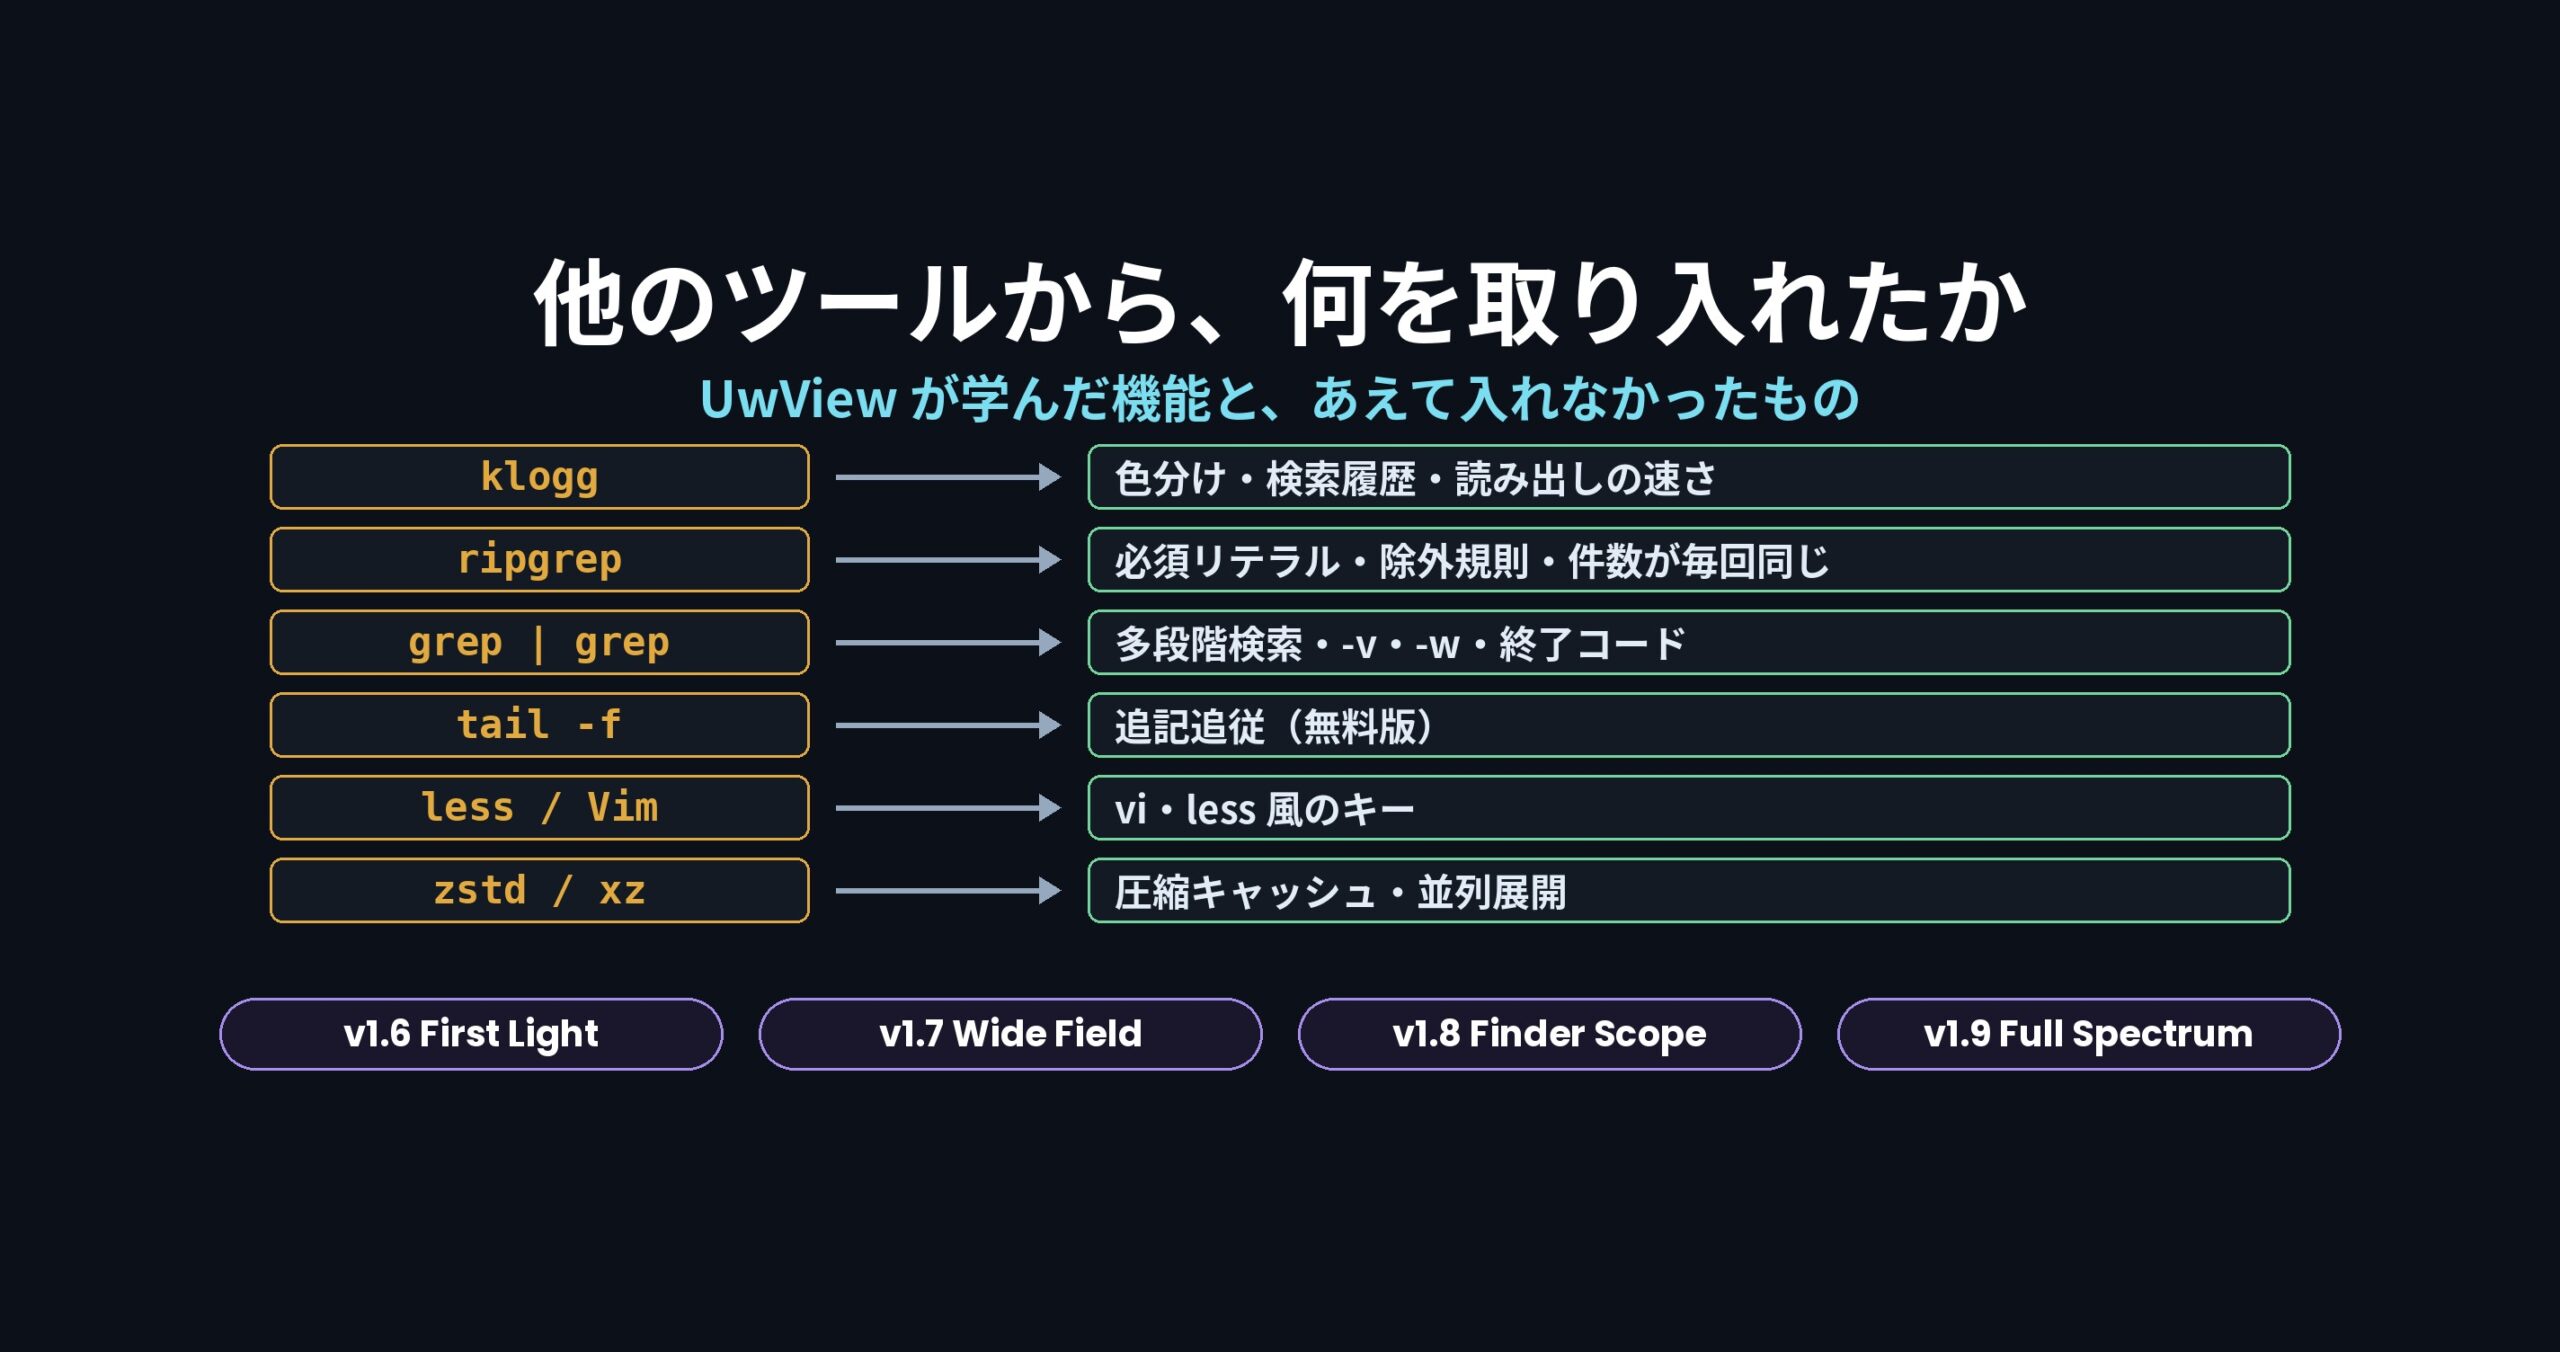
先に結論: ツールごとに取り入れたもの
| ツール | 種類 | 良いところ | UwView に取り入れたこと(版) |
|---|---|---|---|
| klogg | 画面のログビューア | 色分け・検索履歴・追記の追跡・セッション復元がそろっている。開く速さが媒体の速さに届いている | 色分けハイライタ・検索履歴(v1.1)/右クリックで即着色・セッション復元(v1.1.1)/画面の読み出しを klogg の速さに合わせて約2倍に(v1.6.6) |
| grep(+パイプ) | コマンド検索 | 1回きりなら単純に速い。cron・CI・ssh 越しにそのまま動く | grep A \| grep B を多段階検索(最大8段・v1.3.0)に/-v・-w(v1.5.0)/終了コード 0・1・2(v1.6.0) |
| uniq -c・sed | コマンド加工 | 決まった加工は、いまも一番確実 | sort \| uniq -c を「集計」(v1.5.0)に/sed -i を、元ファイルを書き換えない全置換(Edit Upgrade)に |
| PowerGREP | Windows の高機能 grep | Word・Excel・PDF の中まで探せる。範囲で切り出す・伏せ字・整形して集めるまで、1つの検索の流れで書ける | 範囲(-seq … -range)・伏せ字(-mask)・整形して収集(-format・--csv)(v1.8.1.9)/Word・Excel・PDF の検索(v1.9.0) |
| ripgrep | コマンド検索 | 正規表現でも固定文字列とほぼ同じ速さ。同じコマンドなら件数が毎回同じ。.gitignore で除外できる |
必須リテラル抽出(v1.6.0)/件数を毎回同じにする(v1.6.2)/除外規則を ripgrep 15 に合わせる(v1.7.2.5〜2.6)/--json |
| Rust の regex | ライブラリ | 必須の文字列が取れない正規表現でも、1文字やバイト列で先に行を絞る | 同じ絞り方を C# の uvf に入れ、該当する式が 2.3〜6.1倍速く |
| grix | 索引型 grep | Linux カーネル(9万本超)という土俵で測っている | 「小さなファイルが大量」の土俵を自分でも測り、ファイルを開く回数を減らした(1.7.3.6.6) |
| zstd・xz・gzip | 圧縮 | zstd は展開が速い | .uwvz の圧縮に zstd/xz の並列展開(1.7.2)/gz は OS の zlib を直接呼ぶ |
| less・Vim | ページャ | 1回開くだけなら軽い | キーの割り当てに「vi・less 風」のひな形(v1.9.0) |
| tail -f | 追記の追跡 | 追記を流す役に徹している | 無料版 UwView の追記追従(v1.9.0 でローテーション・切り詰めにも追従) |
| Elastic EQL・Splunk | ログ基盤 | 順番のある流れ(A のあとに B)を検出できる | Sequence 検索(v1.3.0・Pro)を、サーバーに入れずにローカルで |
| osmium | OSM 変換 | OSM の定番。pbf を XML にできる | uvp が pbf を直接読み、osmium と1バイト同じ XML を出す |
| jq | JSON 処理 | 出力を自分で切り分けずに済む | --json(JSON Lines)を jq に渡す使い方 |
ツールごとに: 何が良くて、どう変えて入れたか
klogg — 機能表で負けて、1行ずつ埋めた
klogg は、ログを読むための道具箱がそろっています。v1.1 の頃に機能を1行ずつ並べた比較表を作ると、UwView は多くの行で負けていました。色分け、検索履歴、追記の追跡、セッションの復元です。
ここで決めたのは、klogg をそのまま真似ず、自分が毎日使って気持ちいい形に直して入れることでした。たとえば色分けハイライタ(v1.1・32色・正規表現のキャプチャ・用途別のプリセット同梱)では、検索でヒットした黄色を常に一番手前に描き、色付けは画面に見えている行だけを評価します。klogg の「1行の中の AND・OR」は、行をまたいで絞る多段階検索(v1.3.0)に置き換えました。
速さでは、klogg が 51GB を開くときの読み出し(930MB/s)を目標値の実測として使いました。無料版の画面が 486MB/s だったので、v1.6.6(First Light)で 967MB/s まで上げています。それでも「開くだけなら klogg が速い」記録は、そのまま残しています。対応する文字コードの幅や、10年を超える実績も klogg の方が上です。
grep・uniq -c・sed — パイプを画面に載せる
grep A | grep B は、段ごとの件数も、元の行番号も残りません。UwView の多段階検索(最大8段)は、各段を件数付きのタブで残し、元ファイルの行番号を最後まで保ちます。-v(含まない)と -w(単語一致)は v1.5.0 で各段のチェックとして入れ、sort | uniq -c | sort -rn は「集計」に、> hits.txt は保存(行番号・前後 N 行つき)にしました。
v1.6.0 からはコマンド(uvf・uvp)も付き、終了コードは grep と同じ 0(ヒットあり)・1(ヒットなし)・2(エラー)です。
入れなかったもの: awk です。決まった加工の自動化は「今日も awk が正しい」と書いたとおりで、UwView は awk の代わりを名乗りません。
PowerGREP — 「探す」の先と、ファイルの種類を広げる
PowerGREP は Windows の高機能 grep です。テキストだけでなく、Word・Excel・PDF の中まで探せます。そして、ヒットした行を出すだけで終わらず、開始と終了の行で範囲を切り出す・IP アドレスなどを伏せ字にする・正規表現で取り出した値を整形して CSV にまとめるといった、調べたあとの仕事まで1つの検索の流れで書けます。
ここから2つ持ち帰りました。
- 範囲・伏せ字・整形(v1.8.1.9 Finder Scope)。 PowerGREP の使い方の例をそのまま
uvpで書けるようにしました。-seq '開始,終了' -rangeで「開始の行から終了の行まで」をブロックとして切り出し、-grep・-vでブロックごとに絞り、-maskで出す行だけを伏せ字にし、-format '$1,$2' --csvで取り出した値を CSV にします。出力は ripgrep(と perl などの組み合わせ)と1バイトも違わないことを確かめています。 - Word・Excel・PDF(v1.9.0 Full Spectrum)。 文字を取り出して索引にし、テキストと同じ検索・集計・範囲・整形が使えるようにしました。
あえて変えたもの: 元の形式には書き戻しません(Word・Excel・PDF は探すだけで、置換して保存はしない)。また、PowerGREP との速さの比較は、PowerGREP 側が検索だけで範囲・伏せ字・整形をしていない条件だったので、同じ仕事の比較にならず、ここには数字を載せていません。
ripgrep — 機能名ではなく「答えが同じ」で合わせる
ripgrep から持ち帰ったのは、機能よりも性質です。
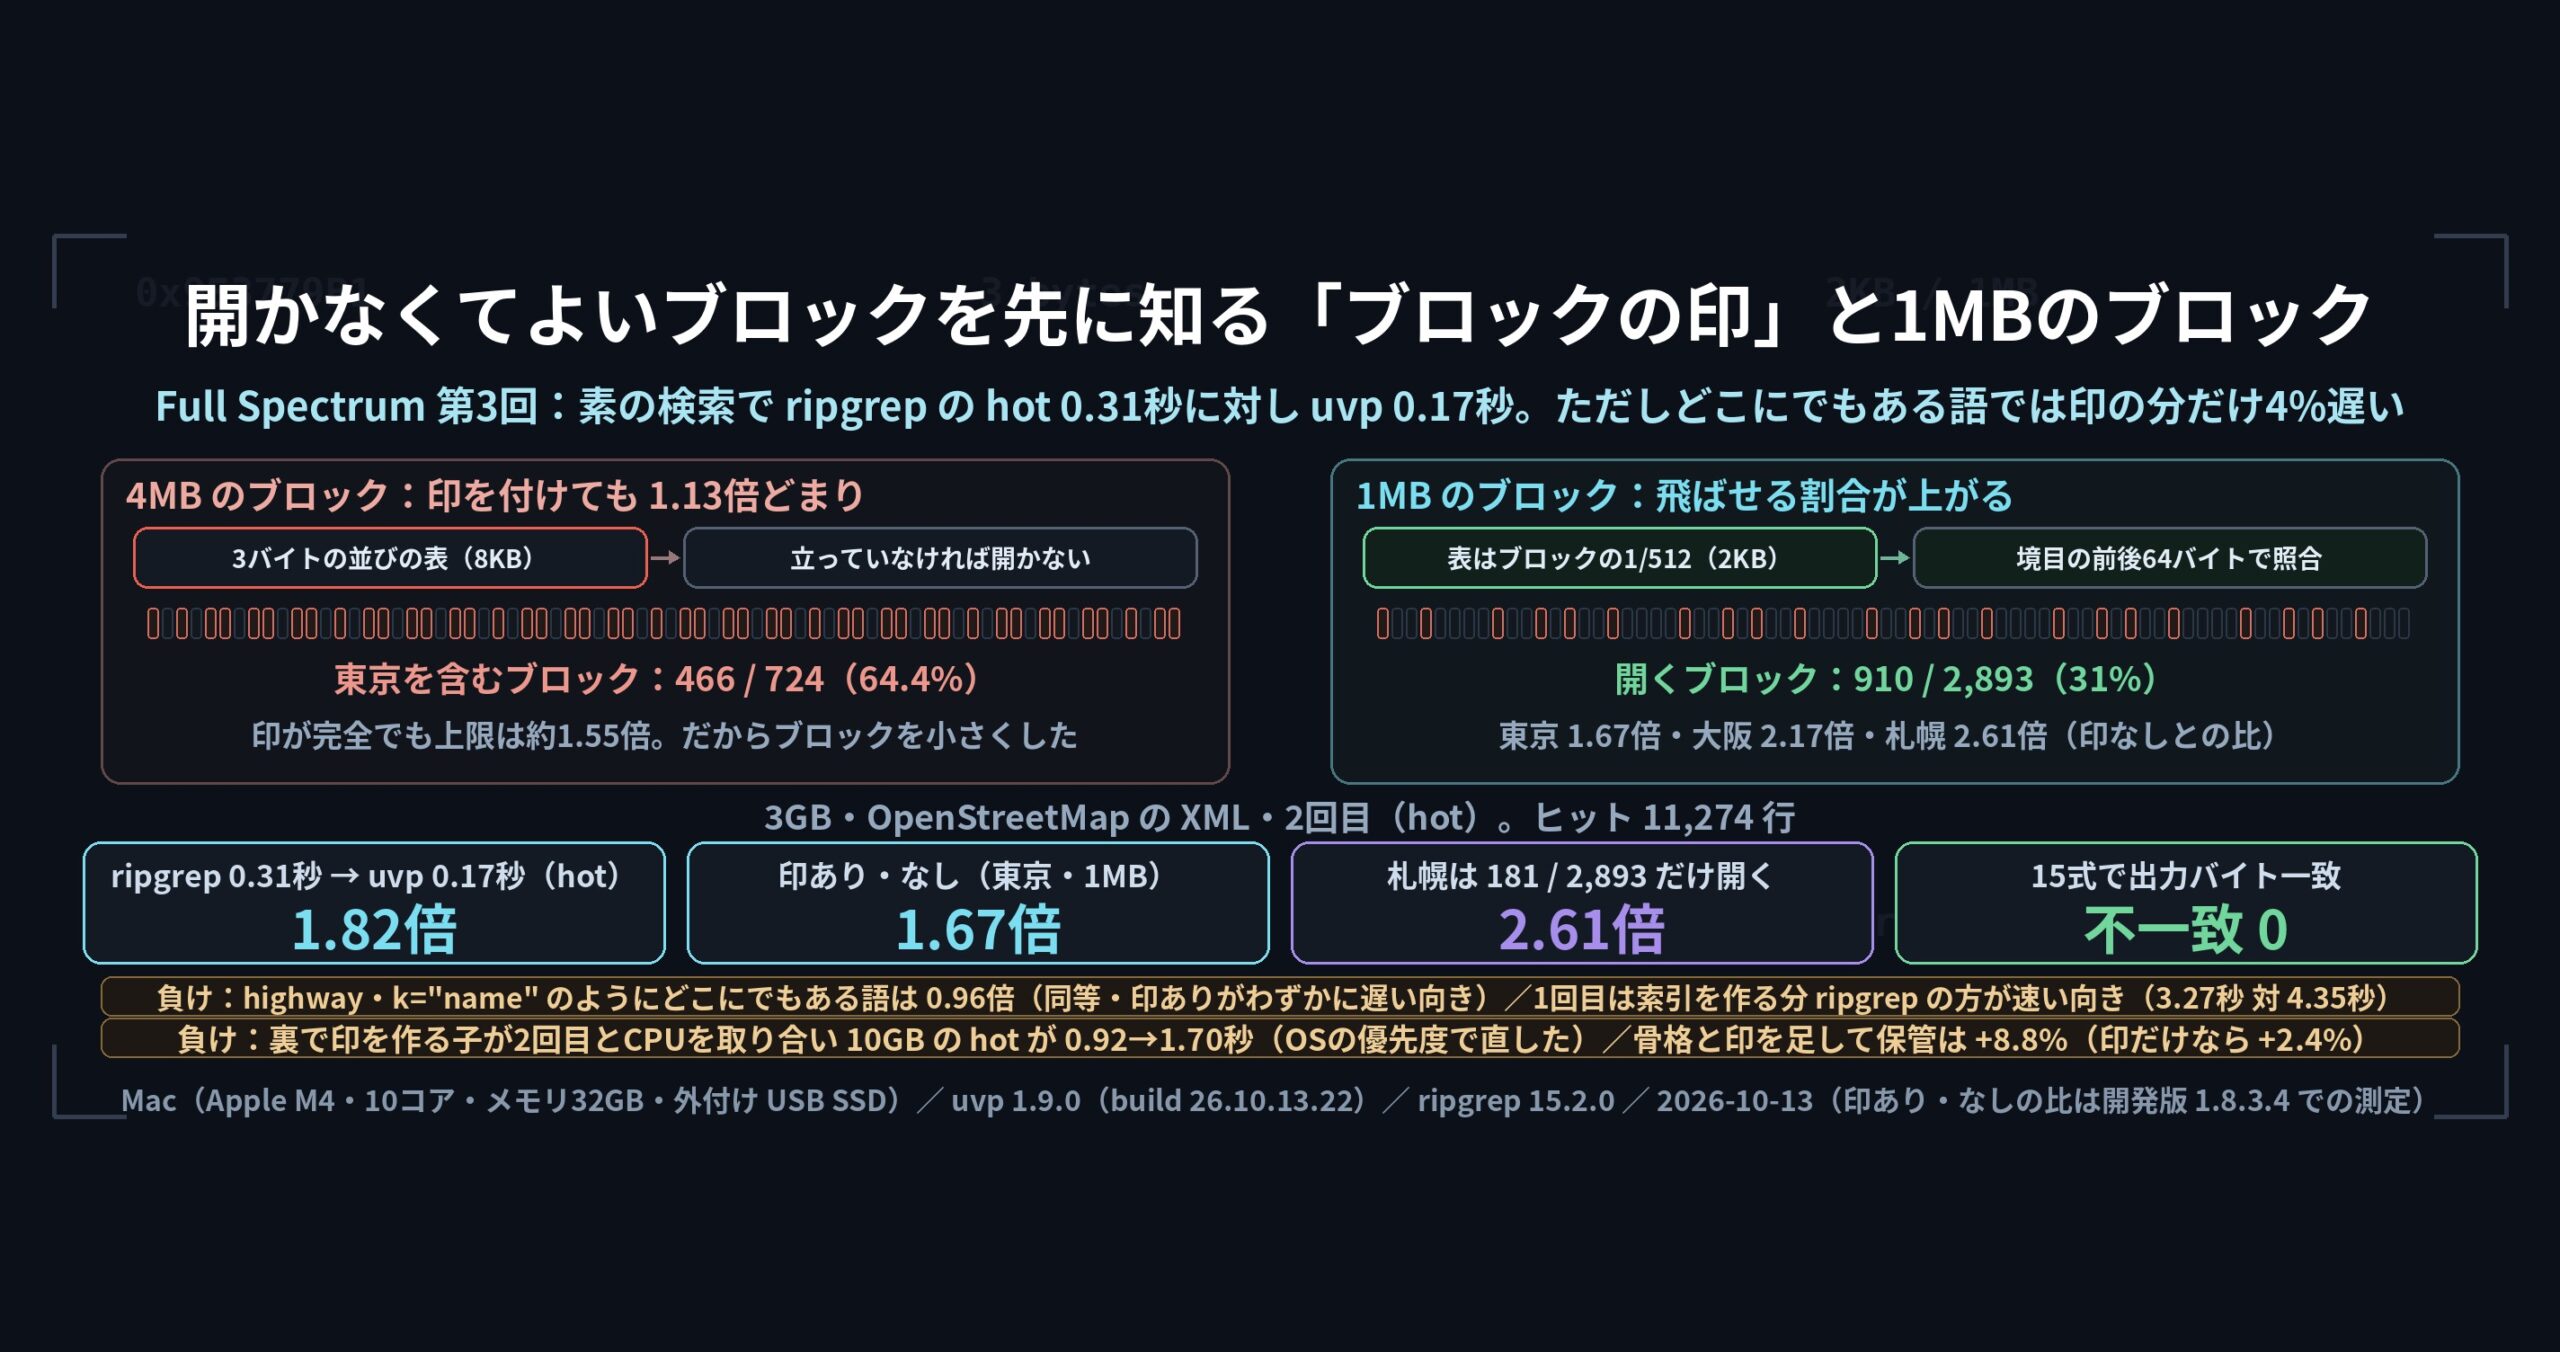
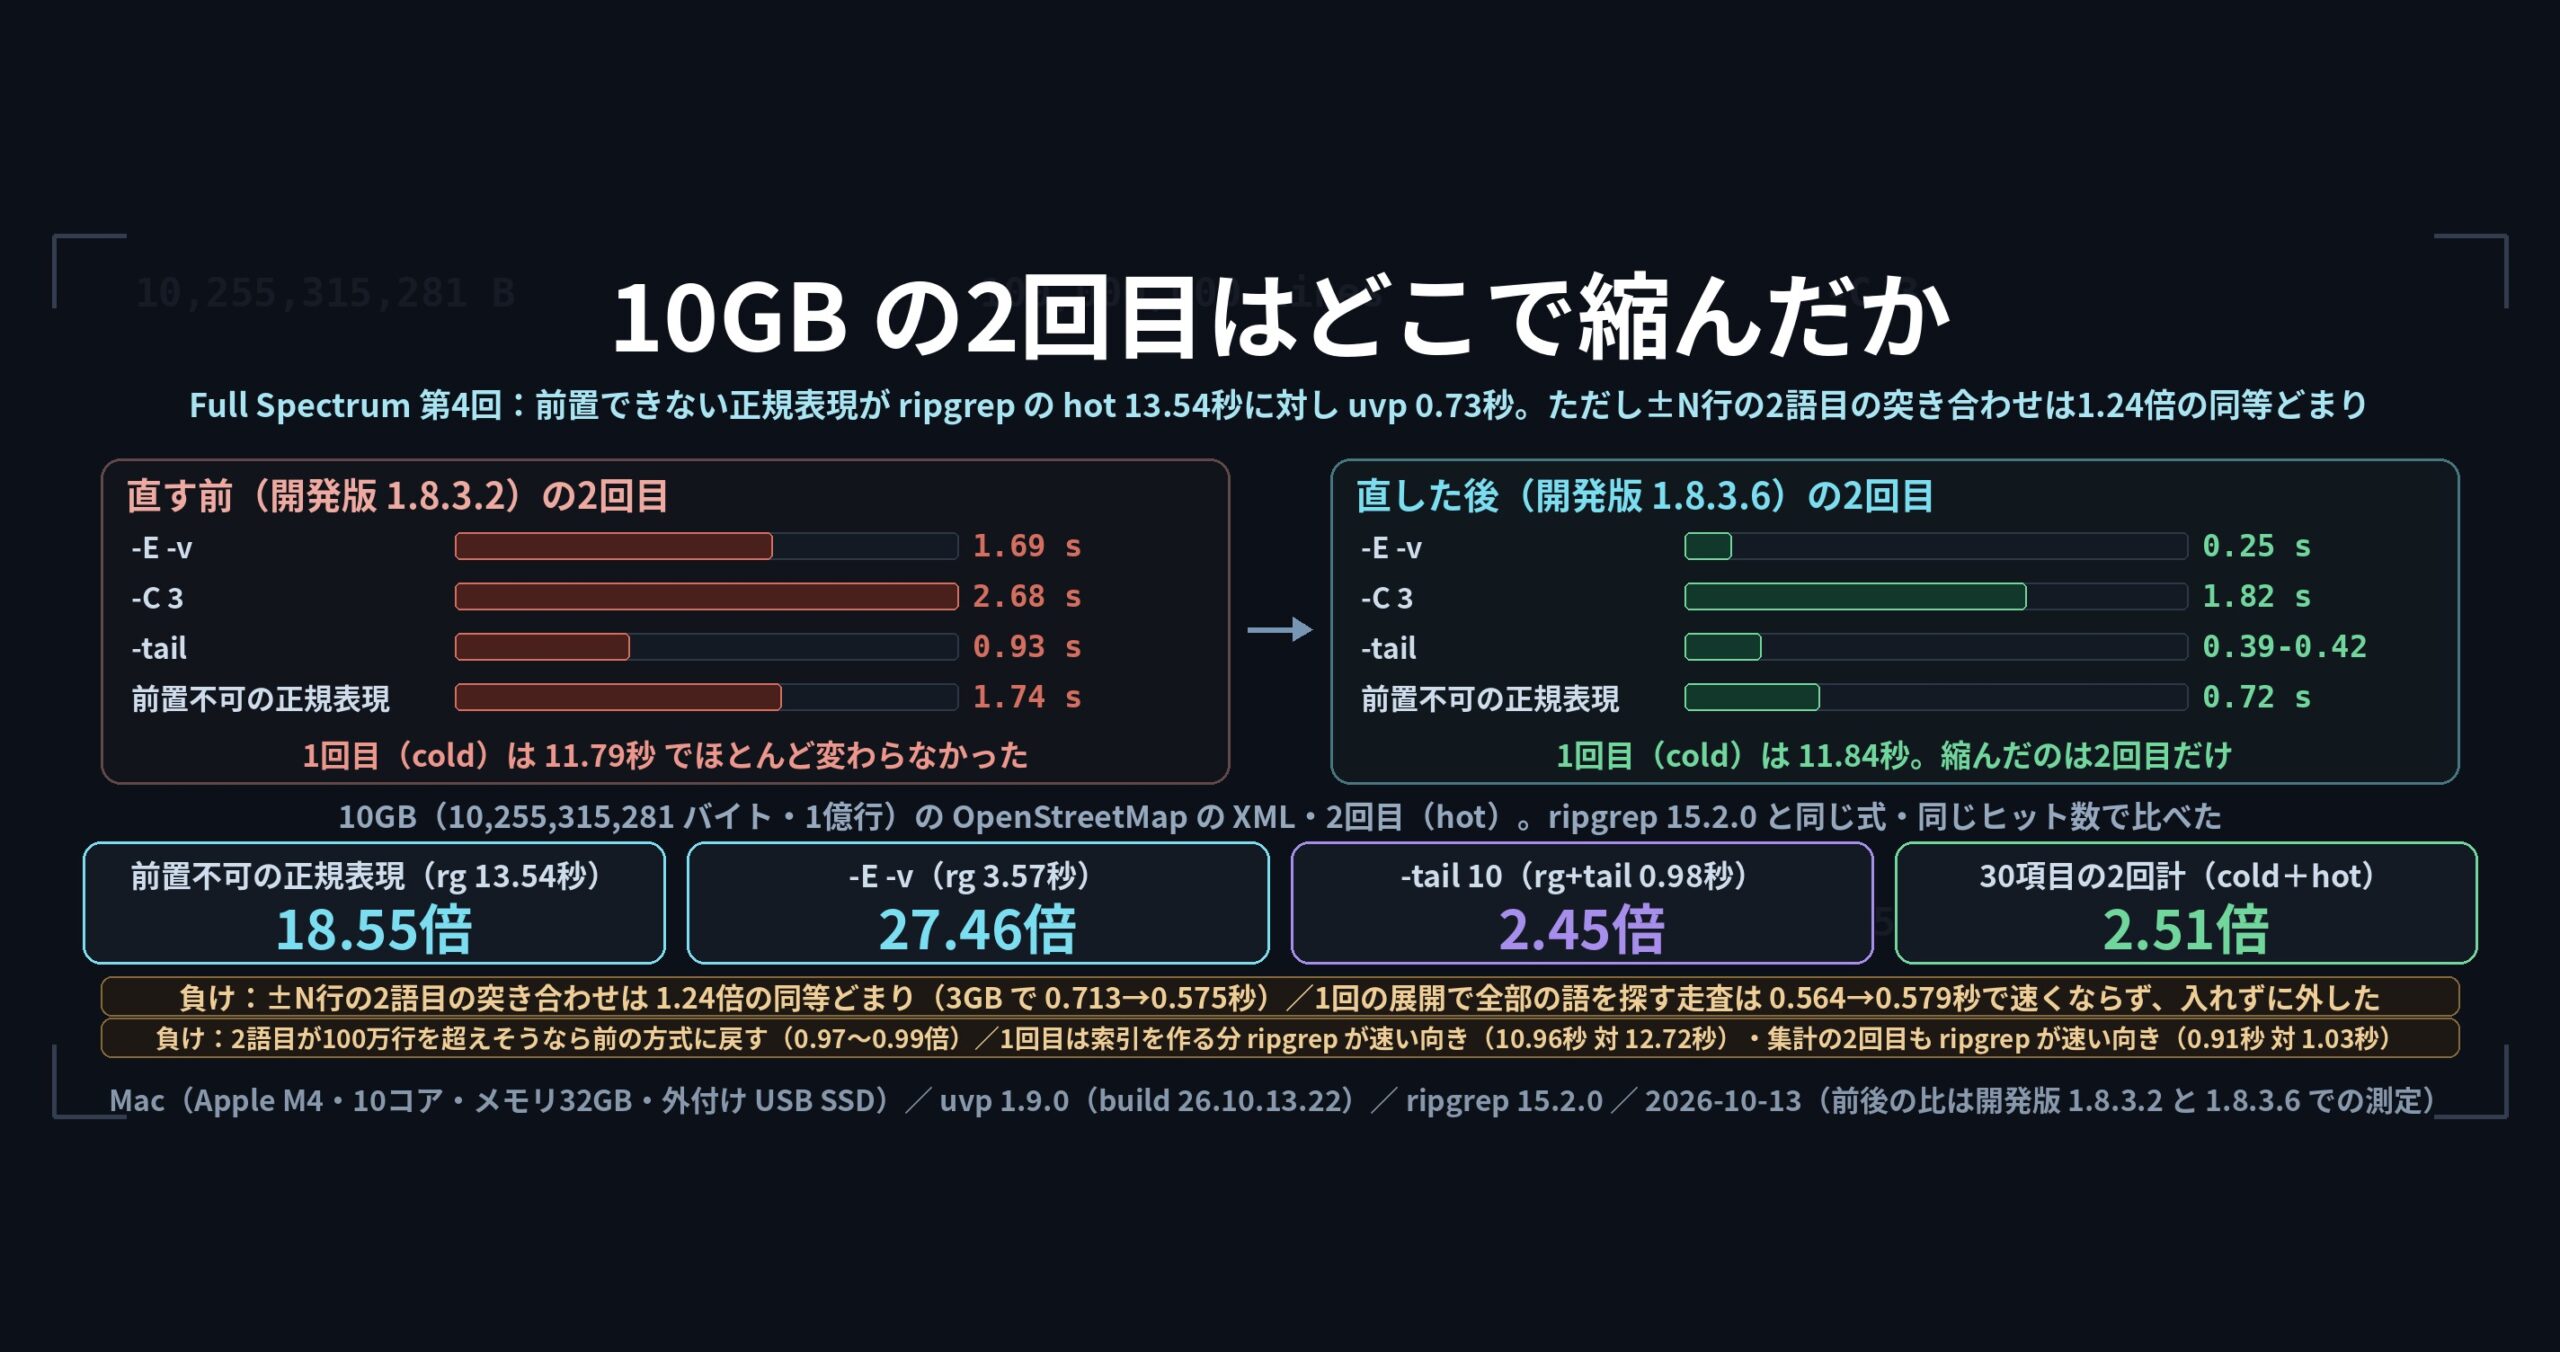
- 正規表現でも遅くならない。 正規表現から必ず含まれる文字列を取り出し、先に候補の行を絞る「必須リテラル抽出」を v1.6.0 で入れました。取り損ねる側に倒して保守的に取り出すので、取りすぎてヒットが消えることはありません。50GB(OpenStreetMap の XML・51,254,526,392 バイト)の
-Eが 13.68秒から 7.75秒になりました。 - 同じコマンドなら件数が毎回同じ。 v1.6.2 で打ち切りの既定を無制限にし、ripgrep・sed と 81項目を突き合わせて一致を確かめています。
- 除外規則。
.ignore・.gitignoreを読む順番、!の取り消し、親フォルダーへのさかのぼりまで ripgrep 15 に合わせ、rg --filesとの突き合わせ 43項目が Mac・Windows・Linux のすべてで一致しました。
あえて変えたもの: 既定は文字列検索で、正規表現は -E です(ripgrep と逆。速さのため)。.rgignore は読みません。ファイル指定は引用符で囲んだ1つの引数にしています(その文字列がそのまま索引の名前になるため)。
Rust の regex — 学んだのは言語ではなく絞り方
C# の uvf を Rust で書き直す実験もしました。分かったのは、Rust 版と C# 版の速さはほぼ同じだということと、Rust の regex が必須の文字列を取り出せない式でも、1文字やバイトの並びで先に行を絞っていることでした。後者を C# に入れると、該当する式が 2.3〜6.1倍速くなりました。
grix — 測っていない土俵は、遅いかどうかすら分からない
trigram 索引で候補のファイルだけを読む grix の記事は、Linux カーネルのソース(9万本超)で測っていました。UwView は巨大な1本のファイルばかり測っていたので、同じ土俵で測ると ripgrep に 19倍負けていました。原因はファイルを開く回数で、1.7.3.6.6 で数を減らし、uvf の1問が 25.82秒から 3.76秒になりました。
入れなかったもの: trigram 索引そのものです。grix は「たくさんのファイルから読むべきファイルを絞る」索引、uvp の .uwvz(uvp 用の圧縮形式+索引)は「本文を圧縮して持ち、元のファイルが無くても探して戻せる」索引で、目的が違います。
tail -f と less — 操作の作法をもらう
tail -f の「追記を流す」は、無料版 UwView の追記追従になりました。v1.9.0 でローテーションと切り詰めにも追従します。この機能は UwView Pro にはありません。 Pro は編集を差分ファイル(.ewvz)で管理するので、元ファイルが書き換わり続ける状態と相性が悪いためです。
less と Vim からは、キー操作をもらいました。v1.9.0 のキーの割り当てで「vi・less 風」のひな形を選ぶと、j k g G n N m や 5j・120g が使えます。less が開くたびに捨てている行の区切りは、UwView では捨てずに索引に残します。
圧縮・ログ基盤・変換ツール
- zstd:
.uwvzの圧縮に使っています。展開が速いので、圧縮したほうがディスクから素で読むより速く探せる、が前提です。 - xz・gzip: xz は外部コマンドの並列展開に合わせて内蔵の展開を並列にし、
rg -zの方が 6.19倍速かったのを、rg -zの方が 1.08倍速い(1.5倍未満なので同等)ところまで縮めました。gz は OS 標準の zlib を直接呼んで、50GB の gz の検索が 35.65秒から 17.20秒になりました。 - Elastic EQL・Splunk: 「A のあとに B が出る流れ」を探す検索(
sequence・transaction)を、Sequence 検索としてローカルの巨大ファイルにかけられるようにしました(v1.3.0・Pro)。 - osmium・jq: pbf を直接読んだときの XML を osmium の出力と1バイト同じにし、
--jsonはjqにそのまま渡せる JSON Lines にしました。
比べただけのツール
取り入れた機能は無いものの、実測で比べて、自分の立ち位置を決めるのに使ったツールです。
| ツール | 比べて分かったこと |
|---|---|
| EmEditor | 10GB くらいまでなら検索も置換も速く、編集機能も豊富。数 GB の置換は EmEditor の方が速い |
| UltraEdit・010 Editor | 48GB 級でも開いて検索・置換を最後まで終える |
| PilotEdit | 「開いた直後に何ができるか」で巨大ファイル対応を3つに分けるきっかけになった |
| ugrep | -z で圧縮7形式を ripgrep・uvf と同じくらいの速さで探す |
| VS Code | 大きいファイルには安全装置があり、そのかわりに機能が止まる |
数字と条件は、それぞれの比較記事にあります(下のリンク)。
取り入れ方の決まり
ふり返ると、持ち帰り方には決まりがありました。
- 負けている行を全部並べて、1行ずつ埋める。 機能表で負けた行を隠さず、埋まった行と残った行を公開してきました。
- そのまま真似ず、毎日使う形に直して入れる。 同じ名前の機能でも、手ざわりは自分で決めます。
- 互換は、機能の名前ではなく答えの一致で決める。
rg --filesと 43項目、ripgrep・sed と 81項目、osmium と1バイト。合わせたと言うのは、答えが同じときだけにしています。 - 相手の速さを、自分の目標値として使う。 klogg の 930MB/s がなければ、画面の読み出しを2倍にしようとは思いませんでした。
- 入れなかったものにも理由を書く。
.rgignore、Pro の追記追従、trigram 索引、awk。入れない理由が書けないものは、まだ考えが足りないものです。
版ごとのペットネームと、入った機能
v1.6 からは、版の2桁目ごとにペットネームを付けています。どれも望遠鏡で星を観る言葉で、頭が F です。
| 版 | ペットネーム | 主な機能 | 元になったツール |
|---|---|---|---|
| v1.6.6 | First Light | 画面が索引の完成を待たずに探し始め、開くと探すが1回の読みに重なった。画面の読み出しを 486MB/s から 967MB/s に | klogg(読み出しの速さ) |
| v1.7.3.6 | Wide Field | 複数のファイルを1本の .uwvz に束ねる。除外規則・圧縮7形式・zip の中・OSM の pbf・--json。小さなファイル大量の高速化(1.7.3.6.6〜) |
ripgrep(除外規則・--json)・xz・osmium・jq・grix |
| v1.8.1.9 | Finder Scope | 画面の「コマンドライン」で uvp と同じ書き方の検索。複数行のブロック(範囲)・伏せ字・整形して収集 |
PowerGREP(範囲・伏せ字・整形)・grep・ripgrep(書き方) |
| v1.9.0 | Full Spectrum | Shift-JIS・EUC-JP・UTF-16 を索引の中で UTF-8 に。Word・Excel・PDF の検索。vi・less 風キー。追記追従のローテーション対応。ファイル指定の {a,b} |
PowerGREP(Word・Excel・PDF)・less・Vim・tail -f・ripgrep(-g の書き方) |
「Full Spectrum」は、文字コード4つ × ファイルの種類(プレーン・Word・Excel・PDF・圧縮・pbf・zip)× 画面とコマンド × 巨大と多数の、全部の組み合わせを同じ速さで扱える版、という意味で付けました。
uvp ならこう書く
grep のパイプで書いていたことは、uvp ではこう書きます(uvf も同じ書き方で、索引を作らずにそのつど読みます)。
# grep で書くと
grep 東京 japan.osm | grep -v 医療 | grep -w Ariake

# uvp なら
uvp japan.osm 東京                     # 1回目に .uwvz を作って探す。2回目からは索引の中を探す
uvp japan.osm 'k="highway[^"]*"' -E    # 正規表現は -E
uvp 'logs/**/*.log' ERROR --json | jq -r .file | sort -u   # ヒットしたファイルの一覧
多段階の絞り込み(含まない・単語一致)は、画面の多段階検索で各段をタブに残しながら行います。
測定条件
- Mac(Apple M4・10コア・メモリ32GB)・外付け USB SSD。数字はそれぞれのリンク先の記事で測った値で、版・日付・相手ソフトの版はリンク先に書いています。
- 「50GB」「51GB」は同じ OpenStreetMap 日本の XML(51,254,526,392 バイト・8.9億行)です。
- 秒数は環境によって変わります。環境をまたいで比べないでください。
リンク
- klogg との機能比較表(v1.1.1 時点で、埋まった行と残った行): https://uvp.y42u.net/blog/uwview-klogg-feature-comparison-v111/
- 色分けハイライタ(klogg に負けていた行を埋めた回): https://uvp.y42u.net/blog/uwview-v11-color-highlighter/
- 画面の読み出しを klogg に追いつかせた v1.6.6: https://uvp.y42u.net/blog/uvp-gui-catches-up-v166/
- grep・uniq -c・sed と画面の対応表: https://uvp.y42u.net/blog/uvp-cli-to-gui-map/
- 正規表現を ripgrep と同じ性質にした(必須リテラル抽出): https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- 除外規則を ripgrep にそろえた(43項目): https://uvp.y42u.net/blog/uwview-wf07-ignore-rules/
- Rust の ripgrep に C# で追いつくまで: https://uvp.y42u.net/blog/uvp-rust-csharp-ripgrep-history/
- 小さなファイル大量で ripgrep に 19倍負けていた話(Zenn): https://zenn.dev/amru195704/articles/5f2a6203ec7f61
- 流れ続けるログを追う(tail -f): https://uvp.y42u.net/blog/uwview-ps19-streaming-log-follow/
- less で十分、が崩れるとき: https://uvp.y42u.net/blog/uwview-ps15-cli-craft-limits/
- Sequence 検索: https://uvp.y42u.net/blog/uvp-sequence-search/
- EmEditor・klogg・grep・010 Editor との検索と置換の比較: https://uvp.y42u.net/blog/uvp-search-replace-3-10-50gb/
- ripgrep にまだ負けているところ(全部): https://uvp.y42u.net/blog/uwview-wf14-where-ripgrep-wins/
- First Light の総まとめ: https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- Wide Field の総まとめ: https://uvp.y42u.net/blog/uwview-wf15-wide-field-recap/
- v1.9.0「Full Spectrum」の公開告知: https://uvp.y42u.net/blog/uwview-v190-full-spectrum/
- ソースコード(GitHub): https://github.com/amru195704/UwView
無料版の UwView は GitHub Releases から入手できます(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。同じファイルを何度も探すなら、索引を持つ UwView Pro をどうぞ(買い切りと月額の2通り)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。