9,224万行のうち、ヒットするのは1行でした。
3GB の OpenStreetMap の XML で ^ +< に当てはまらない行(-E -v)を探すと、出てくるのは 1行です。それでも前の版は、9,224万行すべてに正規表現を当てていました。索引を持っていて、ファイルを1回しか読まなくなっても、その1回の中では全部に式を当てていたからです。
答えが1行しかないと分かっているなら、読まずに飛ばせるはずです。 そのために何を索引に入れておけばいいか、というのが今回の話です。
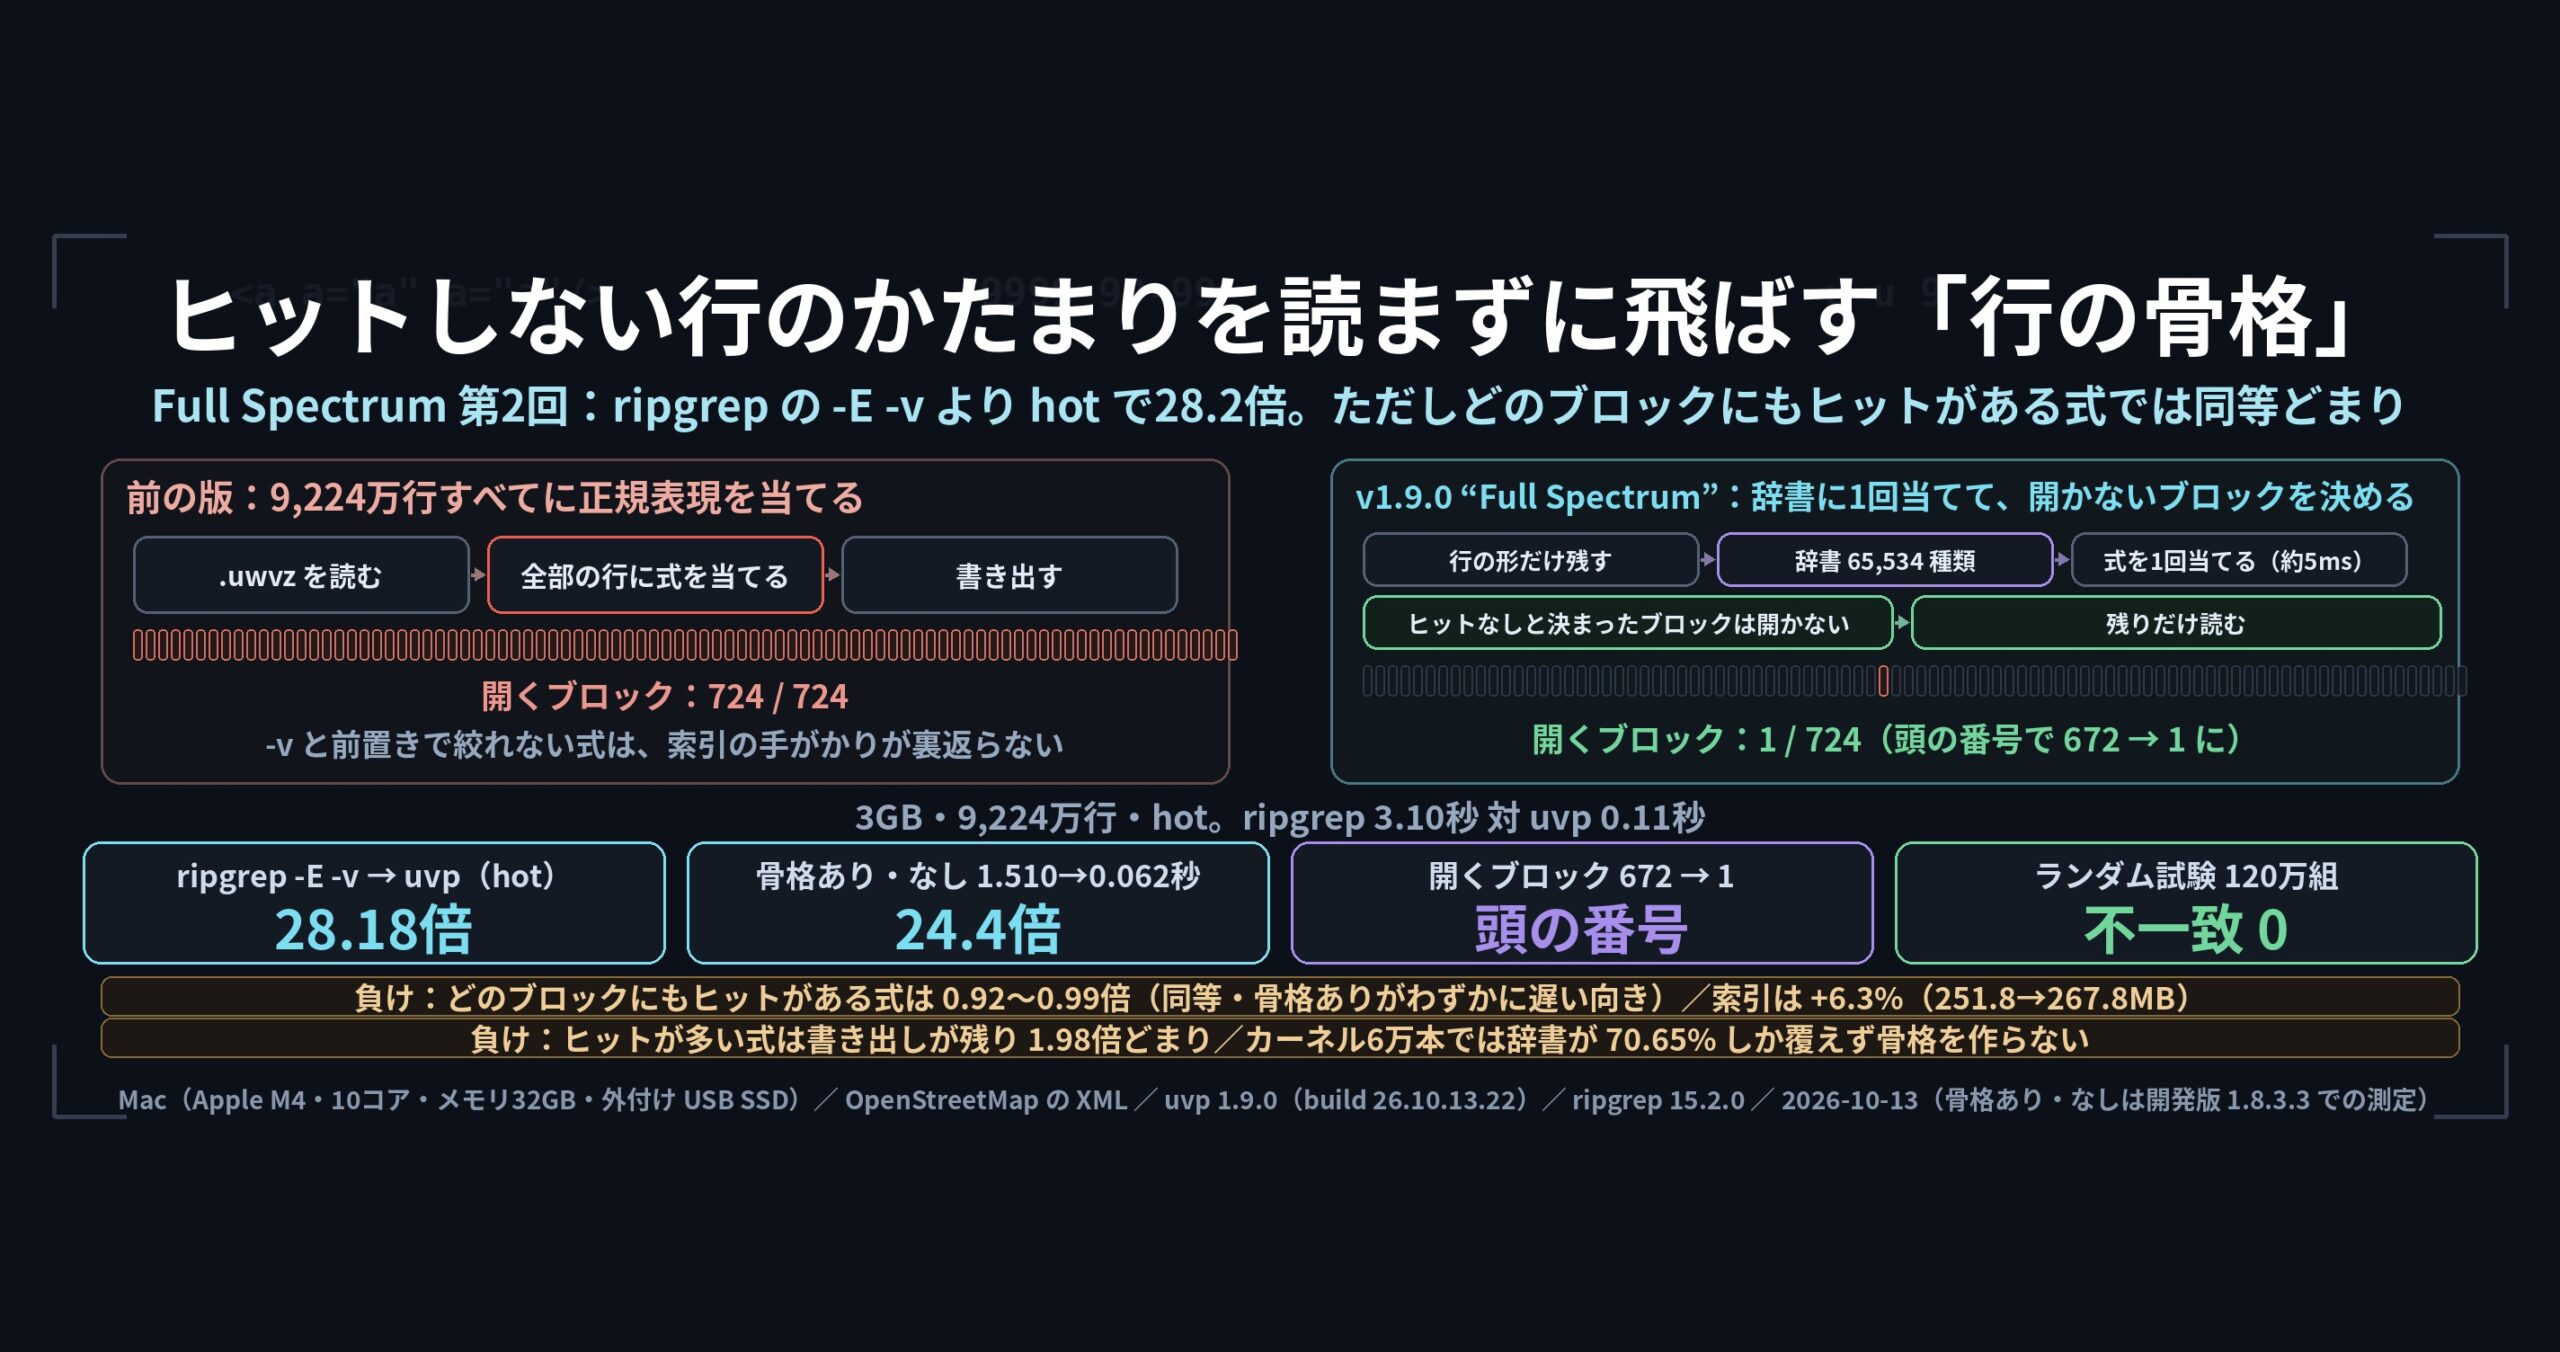
- 先に結論: -E -v が hot 3.10秒→0.11秒(ripgrep の28.2倍)。ただしどのブロックにもヒットがある式では同等どまりで、索引は6.3%大きくなる
- 問題: 索引を持っていても、-v は全部に式を当てるしかなかった
- 考え: 行の「形」だけ残せば、辞書に式を1回当てるだけで決まる
- 作り方: 65,534 種類の辞書と、ブロックごとの番号の列
- 「頭」の番号 — 1.4% の行がどのブロックにもあって、効かなかった話
- 数字: ripgrep と比べて(v1.9.0 の全体テスト・3GB)
- 数字: 骨格あり・なし(仕組みだけを切り出して見る)
- 負け: 飛ばせない式、6.3% の索引、kernel では作らない
- 正しさ: ランダム試験120万組で不一致0、出力は18式ともバイト一致
- 持ち帰れる一般論: 索引は「どこにあるか」より「どこに無いか」を持つと効く
- uvp ならこう書く
- リンク
先に結論: -E -v が hot 3.10秒→0.11秒(ripgrep の28.2倍)。ただしどのブロックにもヒットがある式では同等どまりで、索引は6.3%大きくなる
.uwvz(uvp 用の圧縮形式+索引)に、行の「形」だけを残した辞書を足しました。行を「数字は 9・英字の連続は a・0x80 以上のバイトの連続は u」に置き換えたものを骨格と呼び、多い順に 65,534 種類まで番号を振って、1MB のブロックごとに「そのブロックで始まる行の番号の列」を持ちます。検索のときは、本文ではなく辞書(数万行)に正規表現を1回当てて「ヒットする/しない/決まらない」の表を作り、ヒットも「決まらない」も無いブロックは開きません。3GB で表を作る時間は約 5ms です。
v1.9.0 の全体テスト(Mac・3GB・hot)で、^ +< の -E -v は ripgrep 3.10秒 対 uvp 0.11秒(28.2倍)。仕組みだけを切り出して骨格あり・なしで比べると、同じ式が 1.510秒→0.062秒(24.4倍) になりました。
負けを先に書きます。ヒットする行がどのブロックにもある式は、1つも飛ばせません。 [0-9]{3}-[0-9]{4}" は 724 ブロック中 703 にヒットがあり、ブロックごとに番号の列を読む手間だけが増えて 0.92〜0.99倍(骨格ありの方がわずかに遅い向き。1.5倍未満なので同等) です。索引は 6.3% 大きくなります(251.8MB→267.8MB)。そして Linux カーネルのソース6万本を束ねた .uwvz では、骨格を作りません——骨格が 408.5万種類に散って、上位 65,534 種類で覆える行が 70.65% しかなく、作らない条件(90% 未満)に当たるためです。
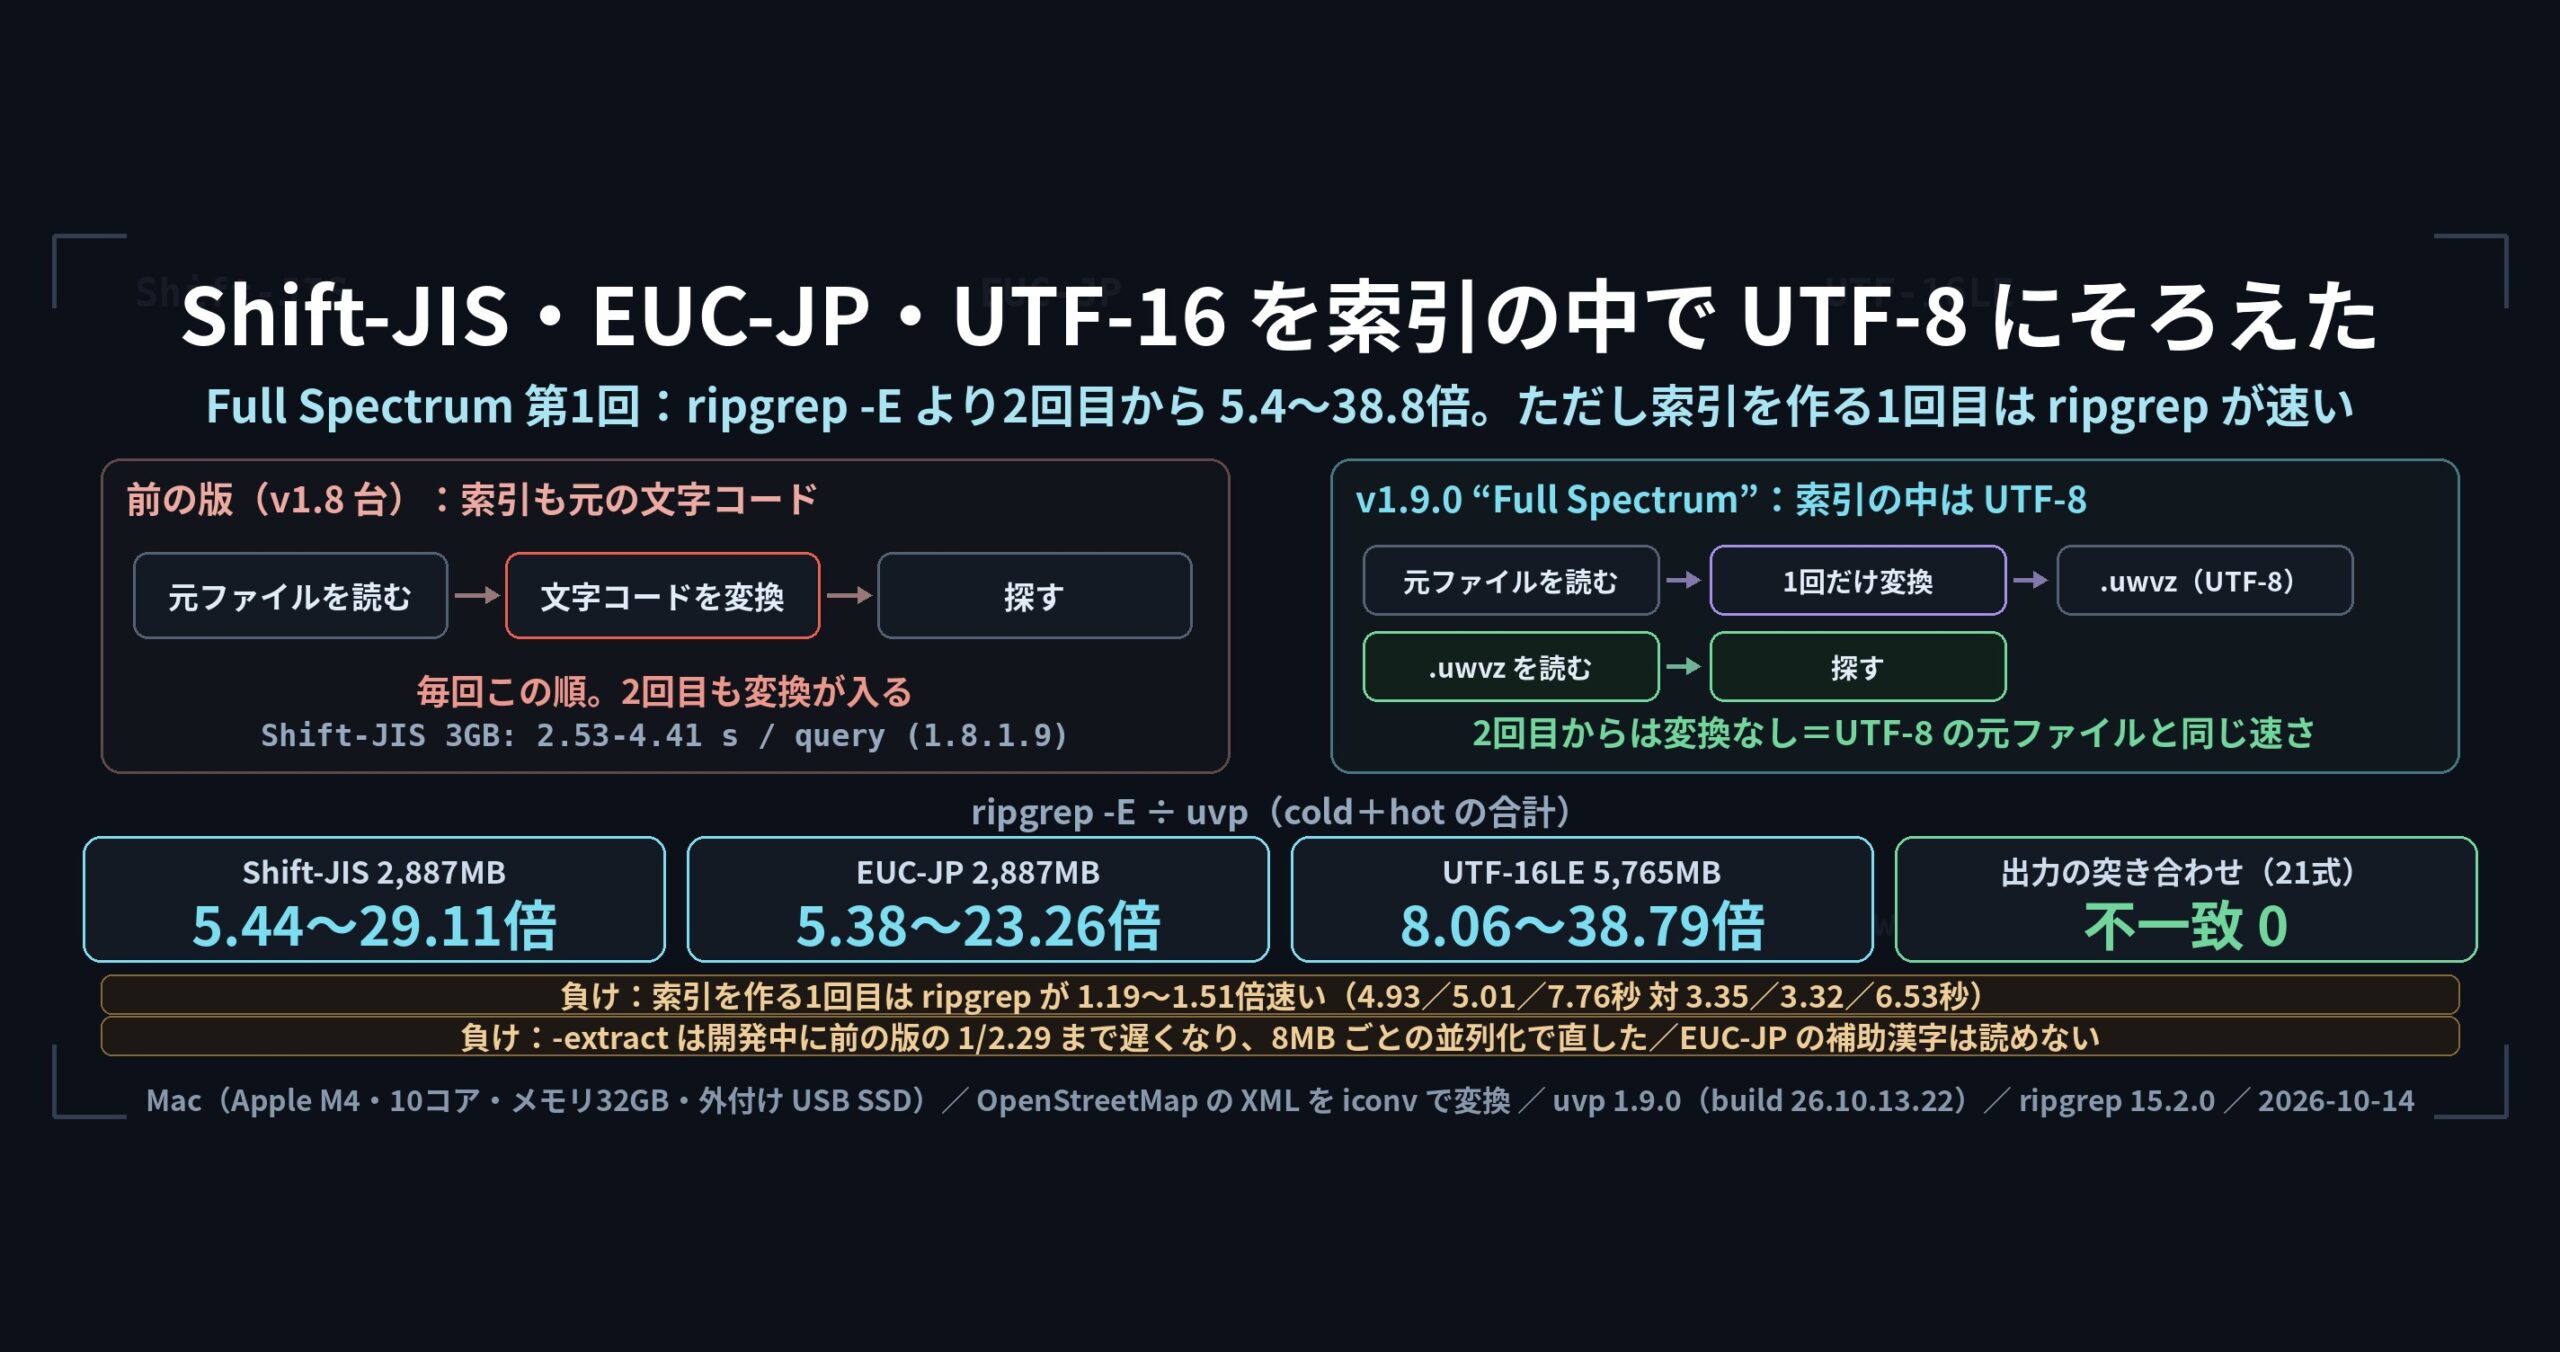
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この記事の数字は v1.9.0 “Full Spectrum”(2026年10月14日公開・build 26.10.13.22)を Mac(Apple M4・10コア・メモリ32GB・外付け USB SSD)で 2026年10月13日に測ったものです。v1.9 には「Full Spectrum」というペットネームを付けました。Shift_JIS・EUC-JP・UTF-16 のファイルも中を UTF-8 にそろえ、文字コードやファイルの種類を問わず、同じ速さで探せるようになった版だからです。
問題: 索引を持っていても、-v は全部に式を当てるしかなかった
uvp の索引がそれまで持っていたのは、どこに何があるかの情報です。どのバイトから何行目が始まるか、どの語がどのブロックに含まれるか。だから「東京 を探す」なら、東京 を含まないブロックは最初から開かずに済みます(この手がかりの話は 前の連載の総まとめ に書きました)。
ところが -v(当てはまらない行)は、この手がかりが裏返りません。「^ +< を含まないブロック」ではなく「^ +< に当てはまらない行」が答えなので、ある語を含むブロックを飛ばすと、そのブロックにある「当てはまらない行」も一緒に落ちてしまいます。同じことが、前置きで絞れる固定文字列が取り出せない正規表現([0-9]{3}-[0-9]{4}" など。この回 に書きました)でも起きます。手がかりが無いので全部に当てる。3GB で -E -v が 1.5秒、-E が 4.7秒かかっていたのはここです。
考え: 行の「形」だけ残せば、辞書に式を1回当てるだけで決まる
巨大なログや XML では、行の種類が意外に少ないです。数字と語彙が違うだけの行が、何千万行と続きます。そこで、行から「違っているところ」を落として形だけ残します。
- 数字の連続 →
9 - 英字の連続 →
a - 0x80 以上のバイトの連続 →
u - 記号・空白はそのまま
- 先頭 160 バイトで切り、途中までなら「途中までの印」を立てる
<tag k="highway" v="residential"/> は <a a="a" a="a"/> のような形になります。3GB の 9,224万行を通すと、骨格は 139.5万種類。多い順に並べると、上位 65,534 種類で全体の 98.56% の行が覆えます。
ここまで来ると、使い方は1つに決まります。検索の式を、9,224万行ではなく 65,534 行の辞書に当てる。 各骨格を「必ずヒットする/必ずヒットしない/形だけでは決まらない」の3つに振り分ければ、あとは番号の列を見るだけで開くべきブロックが分かります。3GB でこの表を作る時間は約 5ms でした。
-v は、この表をそのまま裏返すだけです。「必ずヒットする」が「必ず落ちる」に、「必ずヒットしない」が「必ず出す」に入れ替わります。索引の手がかりが裏返らなかった問題が、ここで解けました。
作り方: 65,534 種類の辞書と、ブロックごとの番号の列
置き場所は .uwvz の末尾の任意の節です。目次と目印を置き、古い uvp から見ても本文・行索引・メタデータが今までどおり読めるようにしてあります。
- 辞書: 多い順に 65,534 種類まで番号を振る。65535 は「その他」。
- 番号の列:
.uwvzのブロックごとに、そのブロックで始まる行の分を u16 で並べ、zstd で縮める。 - 作る条件: 上位 65,534 種類で覆える行が 90% 以上・UTF-8・改行に LF を含む。既存の
.uwvzにはuvp <ファイル> --skeletonで後から足せます。 - 開くブロック: 書き出す行があるブロックと、「決まらない」行があるブロックだけ。開いたブロックの中でも、書き出さない行は改行を数えてまとめて飛ばし、決まらない行にだけ本文に式を当てます。
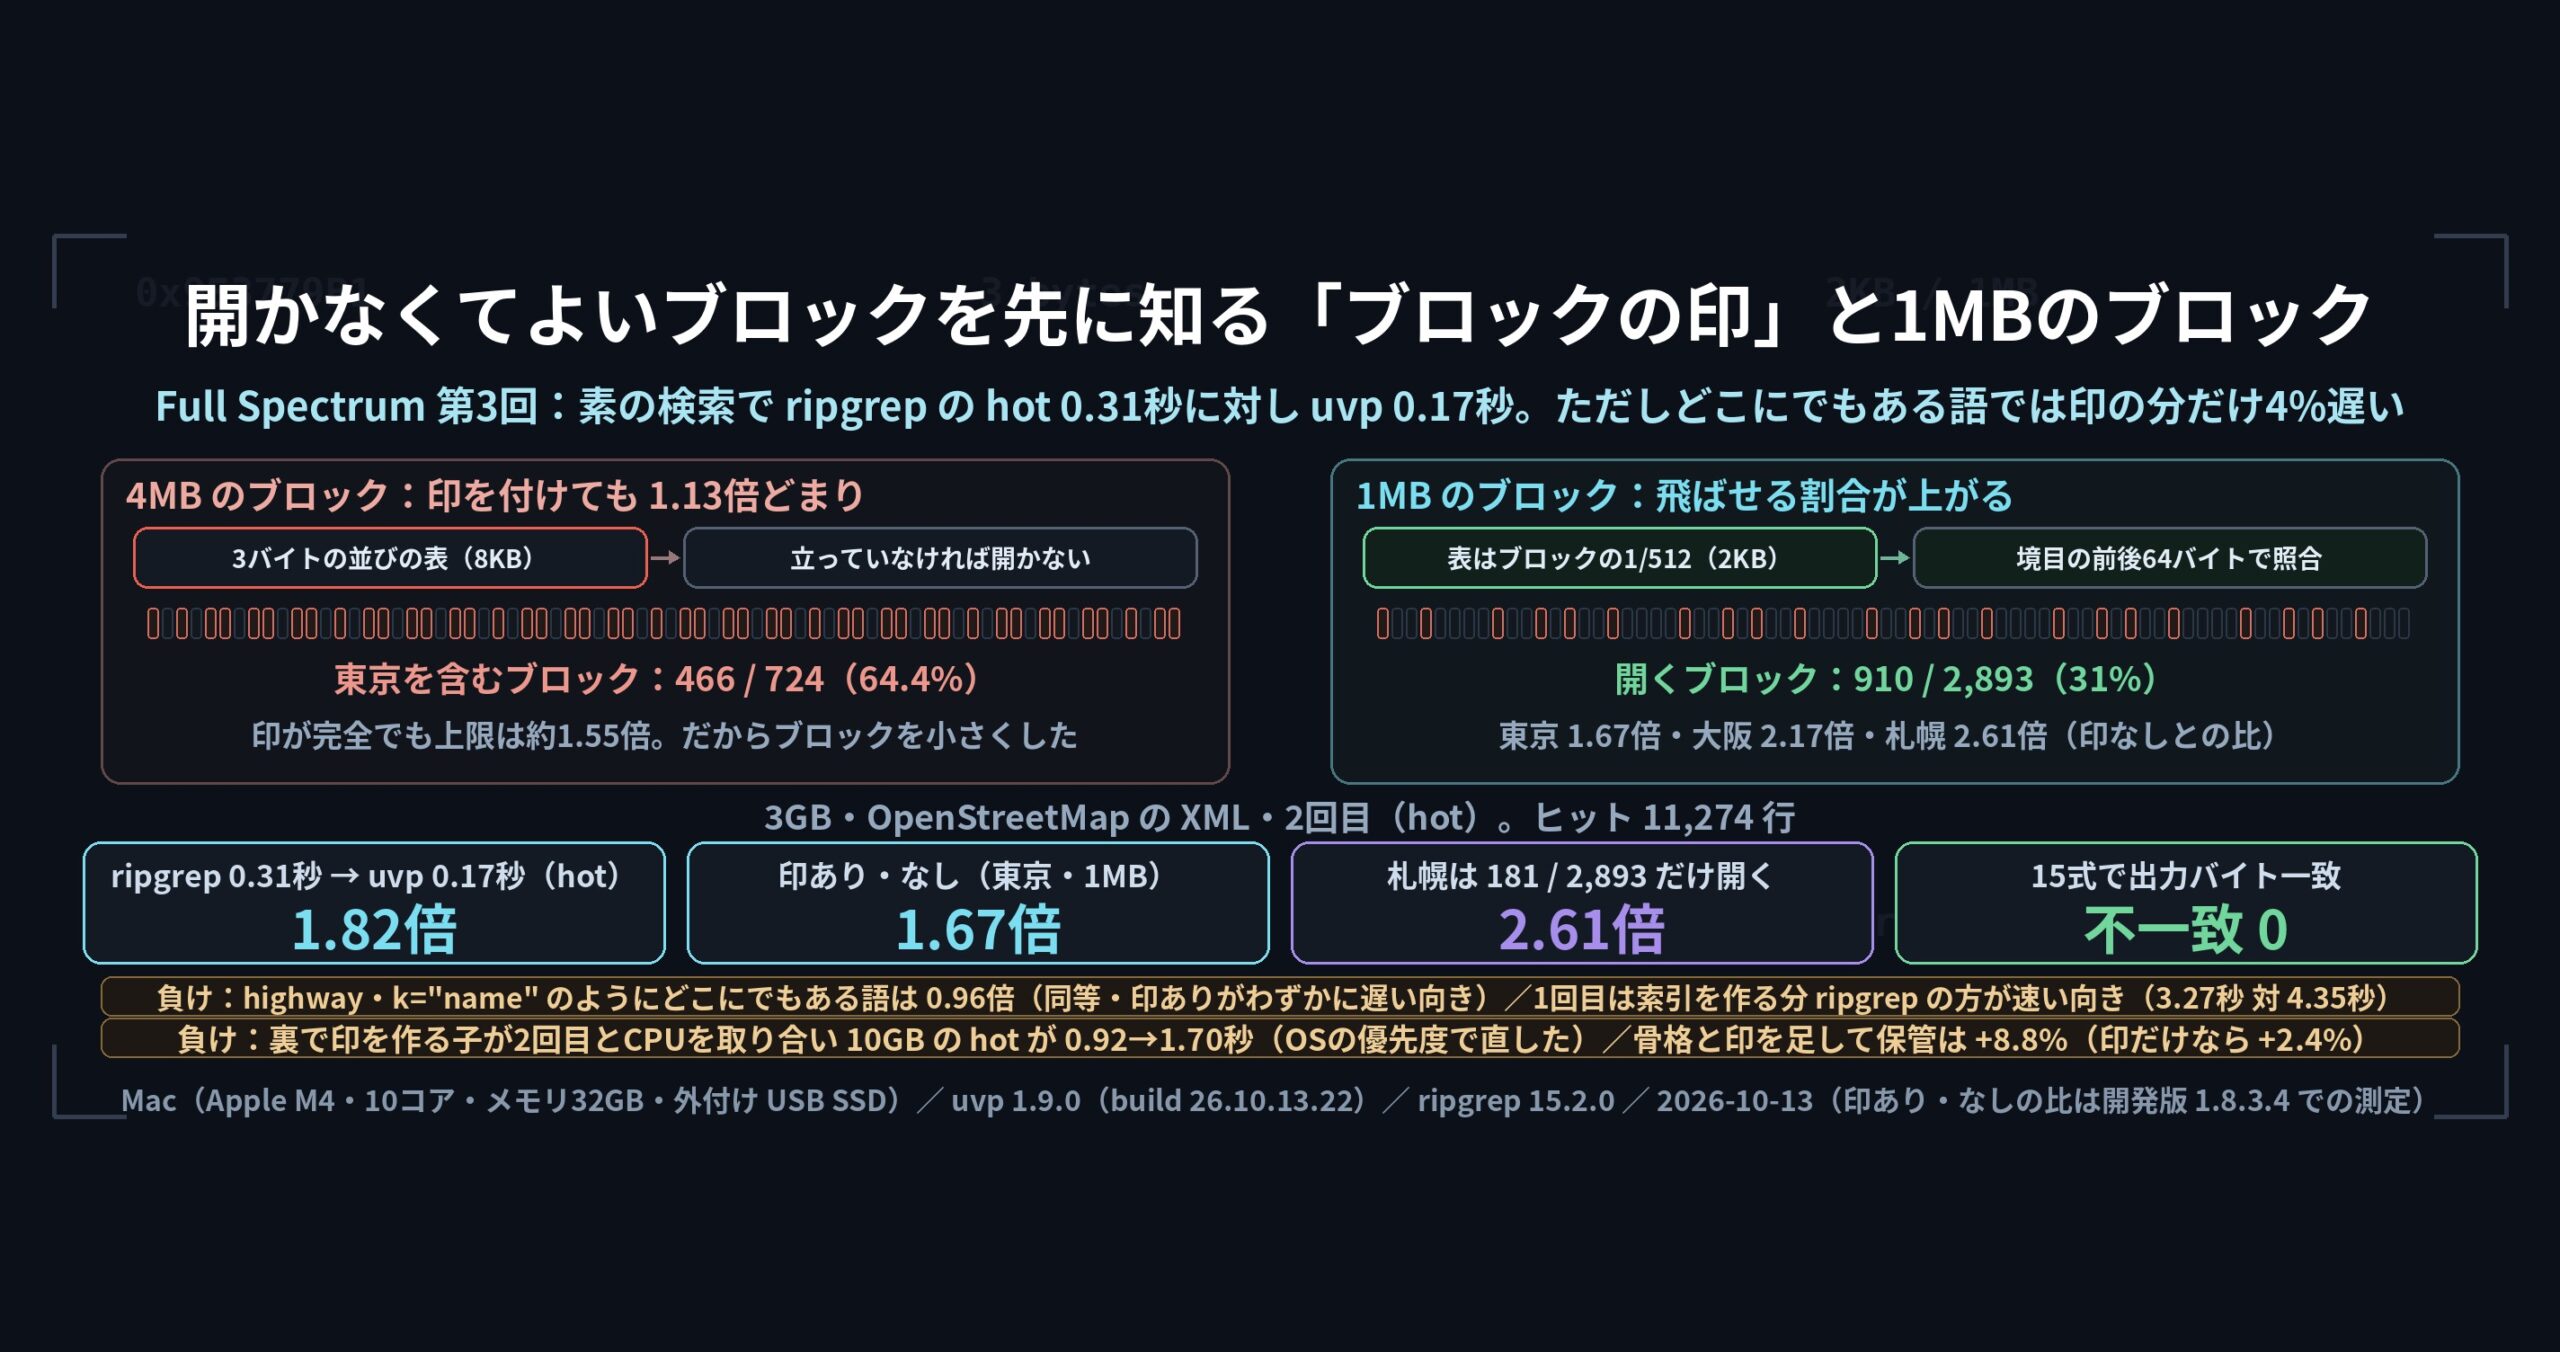
ブロックの大きさは、この版で 4MB から 1MB に変えました。1MB にすると「開かずに済む」判定が細かくなり、飛ばせる量が増えます。この話は連載の次の回(ブロックの印)で詳しく書きます。
「頭」の番号 — 1.4% の行がどのブロックにもあって、効かなかった話
最初の作りでは、この仕組みはほとんど効きませんでした。3GB では、辞書に入らない行(上位 65,534 種類から漏れた 1.4%)がどのブロックにもあったからです。辞書に無い行は「決まらない」に振られるので、^ +< の -E -v(ヒット1行)でも 724 ブロック中 672 を開くことになり、飛ばせたのは 1 割に届きません。
直し方は、枠の使い方を変えることでした。種類が 65,534 を超えるときは、枠のうち 8,192 を「骨格の先頭 16 文字」に回します。先頭 16 文字だけの骨格は「途中までの骨格」として扱われ、辞書に入らない行にもこの番号が振られます。3GB の辞書は全体の骨格 57,380 種類+頭の番号になり、頭を含めれば 100.00% の行に番号が付きます。開くブロックは 672 → 1。前節の 24.4倍は、ここで出た数字です。
なお「作るかどうか」の 90% の判定は、頭を含めずに見ています。頭の番号は精度を上げる保険で、これに頼ると判定が甘くなるためです。
数字: ripgrep と比べて(v1.9.0 の全体テスト・3GB)
相手は ripgrep 15.2.0。同じ式・同じ件数を確かめた上での値です。cold はキャッシュを破棄して10秒待ってから、hot はその直後に測りました。
| 式 | ヒット(行) | ripgrep cold(秒) | ripgrep hot(秒) | uvp cold(秒) | uvp hot(秒) | hot の倍率(倍) |
|---|---|---|---|---|---|---|
^ +< を -E -v |
1 | 3.57 | 3.10 | 0.18 | 0.11 | 28.18 |
=" を -v |
7,698,790 | 3.49 | 2.08 | 0.68 | 0.54 | 3.85 |
[0-9]{3}-[0-9]{4}" を -E(前置きで絞れない式) |
14,951 | 3.39 | 2.35 | 0.54 | 0.42 | 5.60 |
^ +<の-E -vだけ桁が違うのが、骨格の効いている式です。 ヒットが1行なので、辞書を見た段階でほぼ全部のブロックが「開かなくてよい」と決まります。- ただし、この項目には計測側から ripgrep の hot がキャッシュを使い切れていない旨の警告(cold 3.57・hot 3.10 でほぼ同じ)が付いています。cold 同士で見ると 3.57秒 対 0.18秒(19.8倍)で、どちらで見ても桁は変わりません。
="の-vは 3.85倍ですが、これは骨格のおかげではありません。 7,698,790行を書き出す式で、="を含まない行はどのブロックにもあるため、飛ばせるブロックがありません。この 3.85倍は索引そのもの(読む量が 251.8MB で済む)の分です。次の表で、骨格の寄与が 0 であることが見えます。
数字: 骨格あり・なし(仕組みだけを切り出して見る)
UVP_SKELETON=0 を付けると、同じ .uwvz で骨格を使わずに探せます。以下は開発版(1.8.3.3)での測定です(v1.9.0 の全体テストには、骨格を切った条件がないため)。3GB・hot・3回の中央値・出力は /dev/null に捨てた時間です。
| 式 | 骨格なし(秒) | 骨格あり(秒) | 向きと倍率 | ヒット(行) |
|---|---|---|---|---|
^ +< を -E -v |
1.510 | 0.062 | 骨格ありが 24.4倍速い | 1 |
^ +< を -E |
4.721 | 2.378 | 骨格ありが 1.98倍速い | 92,239,124 |
=" を -v |
0.518 | 0.522 | 同等(骨格ありがわずかに遅い向き) | 7,698,790 |
[0-9]{3}-[0-9]{4}" を -E |
0.405 | 0.420 | 同等(骨格ありがわずかに遅い向き) | 14,951 |
[0-9]{4}-[0-9]{2} を -E |
0.590 | 0.640 | 同等(骨格ありがわずかに遅い向き) | 8,043,624 |
\d+\.\d{6,} を -E |
0.393 | 0.413 | 同等(骨格ありがわずかに遅い向き) | 140 |
="(素の文字列) |
2.815 | 2.896 | 同等(骨格ありがわずかに遅い向き) | 84,540,335 |
読み方は3つに分かれます。
- ヒットが少なくて形で決まる式(
^ +<の-E -v)は 24.4倍。 - ヒットは多いが形で決まる式(
^ +<の-E)は 1.98倍。9,224万行を全部書き出すので、書き出しの時間が残り、ここが上限になります。 - 形では決まらない式(残り5つ)は 0.92〜0.99倍で、骨格ありの方がわずかに遅い。ブロックごとに番号の列を読む手間と、手がかりで飛ぶ今までの道との差です。
1GB の平文(1,000万行)でも同じ向きで、^ +< の -E -v が 0.240秒→0.032秒(7.5倍)、他は 1.00〜1.45倍でした。
負け: 飛ばせない式、6.3% の索引、kernel では作らない
1. 飛ばせない式では、わずかに遅くなります。 上の表の下 5 行です。[0-9]{3}-[0-9]{4}" は 724 ブロック中 703 にヒットがあり、=" を含まない行はどのブロックにもあるので、番号の列を読む手間だけが足されます。4〜8% なので「同等」と書く範囲ですが、速くなっていないことは確かです。素の文字列(-v なし)については、半分より多くのブロックを開くことになるなら骨格を使わないという切り替えを入れました(バイトのまま SIMD で探す今までの道のほうが速いため)。正規表現側の境目は、まだ入れていません。
2. 索引が 6.3% 大きくなります。 3GB で節が 15.2MB(.uwvz 251.8MB→267.8MB)、足す時間は 3.4秒。1GB の平文なら +2.6% です。保管の大きさを売りにしている道具なので、ここは正直に書いておきます。
3. 小さなファイルを大量に束ねた .uwvz では、骨格を作りません。 Linux カーネルのソース6万本を束ねたものでは、骨格が 408.5万種類に散り、上位 65,534 種類で覆える行は 70.65%。90% 未満なので作らない条件に当たります。ソースコードは行の形が多様で、同じ形の繰り返しが少ないためです。この仕組みは、同じ形の行が何千万行と続くログ・XML・CSV に効くもので、全部のデータに効くわけではありません。
4. 書き出しの時間を分けて測れません。 uvp の -c は -uniq の後ろにだけ書けるもので、件数だけを出す道がありません(件数は標準エラー出力の「N 件」に出ます)。そのため上の表は、すべて出力を /dev/null に捨てた時間です。
正しさ: ランダム試験120万組で不一致0、出力は18式ともバイト一致
形で「ヒットしない」と決めて本文を読まない仕組みなので、判定を1回間違えると答えが静かに欠けます。ここは手厚く確かめました。
- ランダム試験: 1,500行 × 800式 = 120万組。骨格での判定と、本文に正規表現を当てた結果に、不一致は 0。行には数字・英字・日本語・全角数字・記号・制御文字・壊れた UTF-8 を混ぜ、式には大小無視を含めました。
- 出力のバイト一致: 骨格あり・なしで出力が1バイトも違わないことを、18式(
-v・-i・-Eを含む)× LF/CRLF+BOM/束ねた.uwvz/種類が枠を超えて頭の番号を使うもの、で照合しました。64KB 超・1MB 超の行、ブロックの境目をまたぐ行も含みます。Pro.Coreの試験 1,027件も通っています。
判定を「決まらない」側に倒した場所も、いくつかあります。
\dは全角の数字にもヒットします(.NET の既定)。\dを含む式で、骨格にu(0x80 以上のバイト)がある行がヒットしないときは「決まらない」に回します。[0-9]は ASCII だけなので決まります。- 64KB を超える行は「その他」にします。
uvpは行の先頭 64KB にだけ式を当てるので、骨格と食い違わないようにしました。 - 安全な式の判定は、小さな専用の解析器で行い、迷う構文は受け付けない側(骨格を使わない側)に倒しました。辞書に式を当てるのは後戻りしない方式(NonBacktracking)で、
(\d*)*のような入れ子の量指定でも時間が読めます。
持ち帰れる一般論: 索引は「どこにあるか」より「どこに無いか」を持つと効く
索引を作るとき、まず思いつくのは「どの語がどこにあるか」です。これは裏返せないので、-v や前置きで絞れない正規表現に効きません。効いたのは、「このかたまりには答えが無い」と言える要約を持つことでした。行の形は元の行より遥かに小さく(9,224万行が 65,534 種類に)、しかも元の行に当てはまる式を、要約にそのまま当てられます。
この形の索引を作るときに考えることは、3つだと思います。要約の集合が十分小さいか(小さければ検索のたびに全部に式を当てられる。kernel で作らないのはここに当たります)。「決まらない」が少ないか(決まらないものは元を読む側に回るので、1.4% がどのブロックにもあるだけで効かなくなります)。安全側に倒してあるか(「ヒットしないと決まった」が間違うと答えが静かに欠けるので、迷ったら「決まらない」に倒す。120万組のランダム試験は、それを確かめるためのものです)。
uvp ならこう書く
uvp japan.osm '^ +<' -E -v            # 当てはまらない行(骨格が効く式)
uvp japan.osm '^ +<' -E               # 当てはまる行
uvp japan.osm '[0-9]{3}-[0-9]{4}"' -E # 前置きで絞れない式(骨格は効かない)
uvp japan.osm.uwvz --skeleton         # 既存の .uwvz に骨格を後から足す
uvp japan.osm -info                   # 骨格の節があるかを見る
UVP_SKELETON=0 uvp japan.osm '^ +<' -E -v  # 骨格を使わずに探す(照合・測定用)
UVP_SKELETON_TRACE=1 uvp japan.osm '^ +<' -E -v  # 判定表を作る時間と開いたブロック数を出す
uvf japan.osm '^ +<' -E -v            # 無料版は索引を作らず、そのつど読む
終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
リンク
- 前回(Full Spectrum①): 索引の中を UTF-8 にそろえた話: https://uvp.y42u.net/blog/uwview-fs01-sjis-utf8-index/
- v1.9.0「Full Spectrum」の公開告知(この版の全体像): https://uvp.y42u.net/blog/uwview-v190-full-spectrum/
- 正規表現から「必ず含む文字列」を取り出して絞る話: https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- ripgrep が勝つ条件をまとめた回: https://uvp.y42u.net/blog/uwview-wf14-where-ripgrep-wins/
- 2回目の検索の4割を占めていた改行の数え方: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- 前の連載の総まとめ(複数ファイル・圧縮7形式・zip・pbf): https://uvp.y42u.net/blog/uwview-wf15-wide-field-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、同じ形の行が何千万行と続くログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切り/月額プランあり・14日間の無料試用つき)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。