UwView シリーズ — 探す UwView・比べる UwDiff
巨大なファイルを開いて探すのは UwView、2つのファイル・フォルダを比べるのは UwDiff。どちらも Windows・macOS・Linux で動きます。→ UwDiff の操作マニュアル(CLI uvd)
コマンド操作マニュアルuvp(UwView Pro の CLI)
コマンド操作マニュアル
uvp コマンド操作マニュアル
対象:UwView Pro v1.9.0 “Full Spectrum” の CLI(uvp)。
uvp は UwView Pro の CLI です。GUI(画面)と同じエンジン・同じ索引(.uwvz)を使うので、GUI で見ていたのと同じ結果を、そのままスクリプトから取り出せます。探す道具としては ripgrep と同じ立場なので、このページは ripgrep と比べながら説明します(対応表は18章、性能は21章)。
uvp では、次のこともできます。
- 複数のファイルを1本の索引に束ねて探す(ワイルドカード・サブフォルダー・平文と圧縮の混在)
- 圧縮ファイル 7形式(gz・bz2・xz・lzma・zst・lz4・br)と、zip・OSM の pbf、Word・Excel・PDF(v1.9.0 から)を入力にする
- Shift-JIS・EUC-JP・UTF-16 のファイルも索引の中では UTF-8 で持ち、2 回目からは UTF-8 のファイルと同じ速さで探す(4章)
.ignore・.gitignoreに従って対象を外す(主な規則は ripgrep と同じ)。対象だけを出す--files- 7形式と zip での書き出し(
-out)、束ねた索引の中身を見る--info
ripgrep と比べて、uvp が効く場面と効かない場面です。先に効かない場面から書きます。
- 1回しか探さないなら、速くなりません。 1回目は索引を作るので、1本のファイルでは ripgrep と同等です(50G で rg 56.06秒・uvp 58.42秒=1/1.04)
- 複数のファイルを束ねる1回目は、ripgrep より遅くなります。 束ねた索引を書く分です(gz 7本+平文5本の12本で rg 24.62秒・uvp 41.23秒=rg が 1.67倍速い)。2回目は 9.52秒です(21章)
- 同じファイルに2問目を投げると速くなります。 50G の1本で「東京」を2回目に探すと、rg 70.33秒 に対し uvp 6.45秒(10.9倍。rg の2回目は 55〜70秒とぶれ、55.50秒の日でも 8.6倍)。7種類の検索の cold+hot の合計では rg 870.64秒・uvp 232.98秒(3.74倍)でした
- 圧縮ファイルは、展開を2回目からしません。 979MB を7形式で圧縮したどれでも、uvp の2回目は 0.11〜0.12秒でした(xz は ripgrep 4.21秒)
- 絞り込み・集計・並べ替え・流れを1コマンドで書けます。同じ結果になる rg・sed・sort・uniq などの組み合わせと比べて、16項目の合計で 5.12〜7.44倍でした
-openで、続きを GUI に渡せます。 画面では一覧の行をクリックするだけで、次の段に絞り込めます(15章)
数字の前提(重要)
このページの秒数は、ある1台の Mac(Apple M4・10コア)・外付け USB SSD で測った値です。ディスク・CPU・データの中身で変わります。OS や機械をまたいで秒数を比べないでください。
測った版・データ・測り方は、21章の最後の「21.7 数字の条件」にまとめています。どの値も、結果が ripgrep・sed などと一致することを確かめています(不一致 0)。
- 1. uvp でできること(無料版の CLI uvf との違い)
- 2. インストールと PATH 登録
- 3. 基本の形
- 4. 索引(.uwvz)のしくみ
- 5. 検索の段(Drill-down・集計・並べ替え・流れ)
- 6. 引用パイプ記法
- 7. オプション
- 8. ファイルの指定(1本・複数・ワイルドカード・zip・除外)
- 9. 束ねた索引(複数ファイル)
- 10. 入力の種類(圧縮 7 形式・zip・pbf・Word・Excel・PDF)
- 11. 出力(-out と圧縮での書き出し)
- 12. 元に戻す(-extract)・中身を見る(–info)
- 13. 置換(-replace)
- 14. 正規表現(-E)
- 15. CLI から GUI へ — -open
- 16. スレッド数の調整(–tune)
- 17. 終了コードとスクリプト
- 18. ripgrep との対応表
- 19. よくあるつまずき
- 20. v1.9.0(Full Spectrum)で入った機能
- 21. 性能(参考)
- 関連
1. uvp でできること(無料版の CLI uvf との違い)
無料版 UwView には、CLI の uvf が付きます。uvf は索引を作らず、毎回ファイルを読んで探します。
| uvf(無料) | uvp(Pro) | |
|---|---|---|
検索(-i -E -v) |
○ | ○ |
単語一致 -w・前後の行 -C N |
— | ○ |
| 複数ファイル・ワイルドカード | ○ | ○ |
.ignore・.gitignore に従う(主な規則は ripgrep と同じ) |
○ | ○ |
対象の一覧(--files) |
○ | ○ |
| 圧縮ファイル(gz bz2 xz lzma zst lz4 br) | 展開しながら探す | 展開して索引にする |
索引(.uwvz)で2回目以降を速く |
— | ○ |
| zip・OSM の pbf | — | ○ |
| Word・Excel・PDF(v1.9.0 から) | 取り出しながら探す(索引は作らない) | 取り出して索引にする(隣に report.docx.uwvz) |
| Shift-JIS・EUC-JP・UTF-16 を索引の中で UTF-8 にして持つ | — | ○ |
| 多段の絞り込み・集計・並べ替え・流れ | — | ○ |
| 置換した全文を出す | — | ○(Edit ライセンス) |
圧縮での書き出し・元に戻す(-extract) |
— | ○ |
| 結果から元の行へ(GUI) | ファイルを開き直してから移る | 束ねた本文の中をすぐ移る |
| GUI の検索欄(複数ファイル) | メインの1ファイルだけ | 束ねた全体 |
| 画面の結果一覧の前後の行(±N) | ±1 まで(複数ファイルの結果の窓は ±N なし) | ±64 まで |
- 1回だけ探すなら、uvf でも十分です。uvf の速さは ripgrep と同等です(50G の1本に7種類の検索をした cold+hot の合計で rg 870.64秒・uvf 768.93秒=1.13倍)。
- uvf の書き方は uvf コマンド操作マニュアル、画面は UwView 操作ガイド(PDF)、変更点は v1.9.0 のリリースノート にあります。
- ファイルの指定・正規表現・圧縮の読み込みは uvf と共通です。このページでは共通部分も省かずに書いています。
ライセンス:uvp は UwView Pro(買い切りと月額の2通り・Edit Upgrade も同じ・14日間の無料試用。価格は製品ページ)に含まれます。
ただし -extract(元に戻す)・--info(索引の中身を見る)・--files(対象の一覧)はライセンスが無くても使えます(作るのは有料・戻すのは無料)。-replace は Edit ライセンスが必要です。
2. インストールと PATH 登録
UwView Pro をインストールしたら、アプリのメニュー ヘルプ → 「コマンドライン設定…」 を選びます。同じ画面から解除もできます。
| OS | 登録先 |
|---|---|
| macOS | /usr/local/bin/uvp(書けない場合は標準のパスワード画面) |
| Windows | 配布の zip に UwView.Pro.App.exe(本体)と uvp.exe が入っています。そのフォルダーをユーザーの環境変数 PATH に追加します(管理者権限は不要) |
| Linux | /usr/local/bin(権限が無ければ ~/.local/bin。ログインし直すと有効) |
uvp --version       # 版数(1.9.0)
uvp --help          # 要点だけの使い方
uvp --help files    # ファイルの指定のくわしい説明
uvp --help regex    # 正規表現のくわしい説明
3. 基本の形
3.1 まず4つだけ
# 1. 探す(rg -n -F と同じ行が出る。1回目は索引を作りながら、2回目からは速い)
uvp huge.log 'ERROR'

# 2. 数える(sort | uniq -c | sort -rn | head の代わり)
uvp huge.log 'ERROR' -uniq 'code=([0-9]+)' -head 20

# 3. 置き換える(sed 's/A/B/g' の代わり。元ファイルは変更しない)
uvp huge.log 'old-host' -replace 'new-host' -out fixed.log

# 4. 複数のファイルを1本の索引に束ねて探す(引用符で囲む)
uvp '*.log' 'ERROR'
3.2 コマンドの形
uvp <ファイル> <検索語> [段…] [オプション]           調べる(主記法)
uvp <ファイル> '<検索語> | sort … | uniq …'          調べる(引用パイプ記法・同じ意味。6章)
uvp convert <ファイル> [-out x.uwvz]                  索引(.uwvz)を作るだけ
uvp cat <ファイル> [-out …]                          本文を出す
uvp <ファイル.uwvz> -extract [形式] [-out 出力先]     元の形に戻す(無料。12章)
uvp <索引か指定> --info                               索引の由来と中身を出す(無料。12章)
uvp <指定> --files                                    何が対象になるかだけを出す(無料。8.4)
uvp <ファイル> <検索語> -replace <置換後>             置換した全文を出す(13章)
uvp -open [<ファイル>]                                GUI を起動する(15章)
例:
uvp app.log ERROR                         # 1回目は索引を作りながら探す。2回目からは速い
uvp app.log ERROR -i                      # 大文字小文字を区別しない
uvp app.log ERROR -uniq 'code=(\d+)'      # ERROR の行を code ごとに数える
uvp '*.log' ERROR                         # 複数のファイルを1本の索引に束ねて探す
uvp app.log.xz ERROR                      # 圧縮ファイルもそのまま
検索語は、既定では文字列そのままで探します。正規表現で探すときは、検索語の直後に -E を付けます(14章)。
4. 索引(.uwvz)のしくみ
uvp は、探したファイルの索引(.uwvz)を作ります。.uwvz は圧縮形式+索引です。元の本文を圧縮し、行の位置を加えたものです。大きさは中身によって変わり、OSM の XML では元のおよそ 1/9〜1/12 でした(3GB→0.25GB、50GB→5.74GB)。
| 場面 | 動き |
|---|---|
| 1回目 | 探しながら索引を作る |
| 2回目から | 索引を使うので速い(ファイルの変化は自動で見ます) |
| 元のファイルに行が足された | 足された分だけ索引に足す |
| 元のファイルが書き換わった | 作り直す |
| 圧縮ファイルから作った | 次からは元の圧縮ファイルを展開し直さず、.uwvz を探す(展開のぶん速くなる) |
- 1本のファイルの索引は、元のファイルの隣に
app.log.uwvzの名前でできます。 - 複数ファイルを束ねた索引は実行したフォルダーにできます(9章)。
- 索引は
uvp app.log.uwvz ERRORのように直接指定しても探せます。元のファイルを消しても探せます。 - 先に作っておくだけなら
uvp convert app.log。
4.1 文字コード(v1.9.0 から)
- Shift-JIS・EUC-JP・UTF-16 のファイルは、索引の中では UTF-8 に変えて持ちます(束ねた索引・gz・zip の中も 1 本ごとに)。2 回目からは UTF-8 のファイルと同じ速さで探せます。
- 出力・表示は元の字のままです。
-extractは元の文字コードで書き戻します(12.1)。 --infoに「中の文字コード: UTF-8(元の文字コード: shift_jis)」のように出ます。- 画面で編集して書き出すときは、元の文字コードで書きます(その文字コードで表せない字があれば、件数を出して確かめます)。
4.2 索引の形(v1.9.0 から)
- 索引の形が新しくなりました(版 4)。前の版で作った
.uwvzは読まず、初めて探す・開くときに作り直します(そのぶん、その 1 回は時間がかかります)。 - 新しく作る
.uwvzは、1MB ごとのブロックで持ちます。
4.3 追加の索引(行の骨格・ブロックの印)
2 回目からの検索を速くするため、.uwvz を作るときに追加の索引(行の骨格・ブロックの印)も一緒に作り、.uwvz の末尾に持ちます。追加の索引の無い .uwvz を開いたときも作ります。
| 書き方 | 動き |
|---|---|
uvp app.log ERROR --no-extra |
追加の索引を作らない(すでにあるものは使う) |
uvp app.log --build-extra |
追加の索引を今作る(作り直す) |
uvp app.log --extra-status |
追加の索引の状態を出す |
語1 -C N 語2(前後の行の中を探す)と-seqは、2 語目を全文で 1 回探して、行番号で突き合わせます(出力は前と同じです)。
5. 検索の段(Drill-down・集計・並べ替え・流れ)
uvp は、検索のあとに段をつなげて調べられます。書いた順に実行します(パイプと同じ考え方)。-uniq してから -sort count するのと、-sort してから -uniq するのは別の意味です。
| 段 | 意味 | 例 |
|---|---|---|
<語> または -grep <語> |
検索。2つ目以降は、前の段のヒットした行(-C N があれば前後 N 行)の中だけを探す(Drill-down) |
uvp app.log ERROR -grep timeout |
-uniq <キー> |
頻度集計。キーは正規表現で、第1キャプチャ群(( ) の中)ごとに数える |
uvp app.log ERROR -uniq 'code=(\d+)' |
-sort <キー> |
並べ替え。行はキー(正規表現)で。-uniq の後は count(件数の多い順)か value(値の順) |
uvp app.log ERROR -sort 'ts=(\S+)' |
-seq a,b,c |
a → b → c がこの順で現れる「流れ」を探す | uvp app.log -seq login,timeout,restart |
-head N / -tail N |
先頭/末尾 N 件 | uvp app.log ERROR -head 10 |
検索の段に付ける指定(その検索語の直後に書く):
| 指定 | 意味 | 例 |
|---|---|---|
-i |
大文字小文字を区別しない | uvp app.log error -i |
-E |
正規表現として扱う | uvp app.log 'ERROR\|WARN' -E |
-w |
単語として一致(前後が文字でない) | uvp app.log ERROR -w |
-v |
含まない行。1段目なら「その語を含まない行」、2段目以降なら「前の段の結果からその語を含むものを除く」 | uvp app.log DEBUG -v/uvp app.log ERROR -grep dev2 -v |
-C N |
前後 N 行。出力に前後の行を付け、次の段はこの範囲の中を探す | uvp app.log ERROR -C 5 timeout |
例:
# ERROR の前後 5 行の中から timeout を探す(Drill-down)
uvp app.log ERROR -C 5 timeout

# ERROR の行のうち dev2 を含まないもの、先頭 10 件
uvp app.log ERROR -i -grep dev2 -v -head 10

# ERROR の行をエラーコードごとに数え、多い順に(CSV・JSON でも出せる)
uvp app.log ERROR -uniq 'code=(\d+)' -sort count
uvp app.log ERROR -uniq 'code=(\d+)' --csv

# 時刻で並べ替える
uvp app.log ERROR -sort 'ts=(\S+)'

# login → timeout → restart の順に起きた流れ、最後の 5 本
uvp app.log -seq login,timeout,restart -tail 5

# 検索語が - で始まるときは -grep で
uvp app.log -grep '-9999'
ripgrep などで書くとこうなります(右の uvp と同じ結果):
| やりたいこと | rg・sort・uniq など | uvp |
|---|---|---|
| 2語の絞り込み | rg -n -F 'k="amenity"' F \| rg -F 'v="parking"' |
uvp F 'k="amenity"' 'v="parking"' |
| 絞り込みで除外 | rg -n -F 'k="amenity"' F \| rg -v -F 'v="parking"' |
uvp F 'k="amenity"' 'v="parking"' -v |
| 前後3行の中に2語目 | 1コマンドでは書けない(rg -C は前後の行を表示するだけ) |
uvp F 'k="amenity"' -C 3 'k="name"' |
| 値ごとに数える | rg … \| sort \| uniq -c \| sort -rn \| head -20 |
uvp F 'k="amenity"' -uniq 'v="([^"]+)"' -head 20 |
| 順に現れる流れ | 無い(grep は語の集合しか見られない。awk で状態機械を書くことになる) |
uvp F -seq 'login,timeout,restart' |
| 末尾 N 件 | rg -n -F '東京' F \| tail -10 |
uvp F '東京' -tail 10 |
組み合わせの決まり(意味を持たない並びはエラーにして実行しません):
| 今の結果 \ 次の段 | 検索 | head / tail | sort | uniq | seq |
|---|---|---|---|---|---|
| 行(検索の結果) | ○ | ○ | ○ | ○ | ○ |
| 並べ替えた行 | ✕ | ○ | ○ | ○ | ✕ |
| 集計(ランキング) | ✕ | ○ | ○(count / value) | ✕ | ✕ |
| 流れ | ✕ | ○ | ✕ | ✕ | ✕ |
-sortと-uniqは1段目に書けません(ファイル全体が対象になり、巨大なファイルで破綻するため)。- 検索の段は最大 8 段です(GUI と同じ)。
5.1 段の細かい決まり
2段目以降の検索(Drill-down)
| 決まり | 内容 | 例 |
|---|---|---|
| 探す範囲 | 前の検索の段の -C N で決まります。-C が無ければ、前の段でヒットした行そのものの中だけを探します(両方を含む行に絞るのと同じ) |
uvp app.log ERROR -grep timeout |
-C N のとき |
ヒットした各行の前後 N 行を探します。重なる範囲・隣り合う範囲は1つにまとめ、同じ行を2回数えません | uvp app.log ERROR -C 5 timeout |
| 出る行 | 範囲の中で新しくヒットした行です(前の段の行ではありません) | |
-v のとき |
前の段の行のうち、その範囲にヒットが無いものを残します | uvp app.log ERROR -C 5 -grep retry -v |
| 前後の行の表示 | 出力に付く前後の行は、最後の検索の段の -C で決まります |
uvp app.log ERROR -grep timeout -C 2 |
-limit |
検索の段ごとに効きます | |
| 束ねた索引 | 範囲は束ねた全体の通し行で数えるので、ファイルの境目を越えることがあります(あるファイルの最後の行の後ろ N 行は、次のファイルの最初の行です) |
-seq a,b,c(流れ)
| 決まり | 内容 |
|---|---|
| 間の行数 | 上限はありません(どれだけ離れていても、この順に現れれば1つの流れ) |
| 前の語がまた出たとき | そこから数え直します(a b a c の順に出たときは、2つ目の a から数え直すので流れになりません。そのあと b c が出れば1つ) |
| 同じ行 | 1行に複数の語があってもかまいません(前の語から順に数えます) |
| 流れどうし | 重なりません(1つ見つけたら、次は新しく数え始めます) |
| 語の探し方 | 1段目なら、大文字小文字を区別する文字列そのままの検索です。前に検索の段があれば、その行の中に文字列を含むかで見ます |
| 束ねた索引 | ファイルをまたいで数えます。出力は束ねた全体の通し行番号で、ファイル名は付きません |
| 出力 | 1つの流れを1行に、各語の行番号をタブ区切りで出します |
-uniq <キー>(頻度集計)
| 決まり | 内容 |
|---|---|
| 数えるもの | 行の数です。同じ値が1行に2回あっても 1 と数えます |
| 1行に違う値が複数 | それぞれを 1 ずつ数えます |
| 値 | キーの正規表現の第1キャプチャ群 ( ) の中。( ) が無ければ、ヒットした部分全体 |
| キーに当たらない行 | 数えません |
| 並び | 件数の多い順。同じ件数なら値の文字コード順 |
| 出力 | 値<TAB>件数<TAB>割合(%)。割合の分母は「行と値の組」の数です(1行に違う値が複数あると、行数より多くなります) |
--csv |
見出しつき No,<キー名>,count,%。キー名は名前付きグループの名前か、( ) の手前の語(code=(\d+) なら code) |
| 値の種類の上限 | 20 万種類。超えると打ち切って終了コード 2 |
-head N の置き場所で意味が変わります。
- 検索の直後の
-head Nは、ファイルの先頭から読み、N 件見つけた時点で止めます。1本のファイルならrg -n -F -m N 語 ファイル(rg … | head -Nと同じ行)が出ます。 -uniq・-sort・-seqの後ろの-head Nは、「並べ替えた後の先頭 N 行」です(ランキングの上位20件など)。-tail Nは末尾を知るために全件を見ます。
6. 引用パイプ記法
段をパイプの形で1つの引用符の中に書けます。主記法と同じ意味になります。
uvp app.log ERROR -sort 'ts=(\S+)' -uniq 'code=(\d+)'          # 主記法
uvp app.log 'ERROR | sort ts=(\S+) | uniq -c code=(\d+)'        # 引用パイプ記法(同じ意味)
どちらの記法として読むか:
| 決まり | 例 | 読み方 |
|---|---|---|
ファイルの後ろが引用符1つだけで、その中に \| があるとき、引用パイプ記法として読む |
uvp app.log 'ERROR \| head 10' |
2段(検索・先頭10件) |
段の区切りは前後に空白のある \|。空白の無い \| は語の一部 |
uvp app.log 'ERROR\|WARN' |
1段。文字列「ERROR|WARN」そのものを探す(-E が無いので正規表現ではない) |
ファイルの後ろが2つ以上なら主記法。\| は検索語の中の文字 |
uvp app.log 'ERROR\|WARN' -E |
正規表現の「または」(ERROR か WARN) |
| 引用パイプ記法の中で正規表現を使う | uvp app.log 'ERROR\|WARN -E \| head 5'/uvp app.log '/ERROR\|WARN/ \| head 5' |
どちらも正規表現の「または」(/…/ は正規表現として読む) |
空白を挟んだ \| を含む語を探す |
uvp app.log '"a \| b" \| head 5' |
"…" の中は区切りにならない。文字列「a | b」を探す |
同じく正規表現で \| そのものを探す |
uvp app.log '"a \\| b" -E \| head 5' |
正規表現では \| そのものは \\| |
主記法の検索語に空白つきの \| を書く |
uvp app.log 'a \| b' -E |
エラー(「パイプ記法は全体を1つの引用文字列に」)。上の "…" の書き方を使う |
\| が無い引用文字列 |
uvp app.log 'ERROR -i' |
全体で1つの検索語(「ERROR -i」という文字列) |
| 引用パイプ記法 | 主記法(同じ意味) |
|---|---|
uvp app.log 'ERROR -i \| head 10'(先頭の grep は省ける) |
uvp app.log ERROR -i -head 10 |
uvp app.log 'ERROR \| grep -v dev2'(rg とも書ける。-i -E -w -v -C N 可) |
uvp app.log ERROR -grep dev2 -v |
uvp app.log 'ERROR \| sort ts=(\S+)' |
uvp app.log ERROR -sort 'ts=(\S+)' |
uvp app.log 'ERROR \| uniq -c code=(\d+)' |
uvp app.log ERROR -uniq 'code=(\d+)' |
uvp app.log 'seq login timeout restart \| tail 5' |
uvp app.log -seq login,timeout,restart -tail 5 |
uvp app.log 'ERROR \| head 10'(head -10 も可)/uvp app.log 'ERROR \| tail 5' |
uvp app.log ERROR -head 10/uvp app.log ERROR -tail 5 |
uvp app.log 'ERROR -i | grep -v dev2 | head 10'
uvp app.log 'ERROR -C 3 | grep timeout | uniq -c code=(\d+) | sort value'
uvp app.log 'seq login timeout restart | tail -5'
7. オプション
位置は自由です(-open だけは先頭か末尾)。
| オプション | 意味 | 例 |
|---|---|---|
-out <ファイル> |
出力先。拡張子で形が決まる(11章) | uvp app.log ERROR -out errors.txt |
--force |
既にある出力ファイルを上書きする(既定は拒否) | uvp app.log ERROR -out errors.txt --force |
-limit N |
1回の検索で持つ最大の件数(下で説明) | uvp app.log ERROR -limit 1000000 |
-H / -h |
ファイル名を必ず付ける/付けない(既定は複数ファイルを束ねたときだけ付ける)。-h だけを書くと使い方を表示 |
uvp app.log ERROR -H/uvp '*.log' ERROR -h |
--no-line-number |
行番号を付けない(sed -n '/語/p' の出力と一致) |
uvp app.log ERROR --no-line-number |
--csv |
集計の結果を CSV で出す | uvp app.log ERROR -uniq 'code=(\d+)' --csv |
--json |
1行に1つの JSON(9.4) | uvp app.log ERROR --json |
--rebuild |
束ねた索引を作り直す(前の索引は .bak-日時 に退避。9.2) |
uvp '*.log' ERROR --rebuild |
--raw |
Excel のセルを、表示されている値ではなく元の値で取り出す(式は計算結果の数。10.2) | uvp 売上.xlsx 0.5 --raw |
--no-extra |
追加の索引(行の骨格・ブロックの印)を作らない(すでにあるものは使う。4.3) | uvp app.log ERROR --no-extra |
<ファイル> --build-extra |
追加の索引を今作る(作り直す。4.3) | uvp app.log --build-extra |
<ファイル> --extra-status |
追加の索引の状態を出す(4.3) | uvp app.log --extra-status |
--files |
検索せず、指定が何に広がるかだけを出す(除外した本数も出す。索引は作らない。8.4) | uvp '**/*.log' --files |
--no-ignore |
.ignore・.gitignore による除外をしない(--ignore-file で足した規則は効く。8.4) |
uvp '**' ERROR --no-ignore |
--no-ignore-files |
--ignore-file で足した規則も使わない(8.4) |
uvp '**' ERROR --no-ignore --no-ignore-files |
--ignore-file <ファイル> |
除外の規則を足す。何回でも書ける(8.4) | uvp '**' ERROR --ignore-file extra.ignore |
-open |
先頭:GUI で実行/末尾:実行してから GUI でも開く(15章) | uvp -open app.log ERROR/uvp app.log ERROR -open |
--help / --help files / --help regex |
使い方・ファイルの指定・正規表現の説明 | uvp --help files |
--version |
版数(uvp 1.9.0 (build 26.10.13.22)) |
uvp --version |
--tune [ファイル] [--apply] |
スレッド数を測る(16章) | uvp --tune big.log |
-limit N と -head N の違い
uvp F 'ERROR' -limit 1000      # 1000件たまった時点で検索を止める
uvp F 'ERROR' -limit none      # 無制限(0 でも同じ・既定)
uvp F 'ERROR' -head 10         # 先頭から10件見つけた時点で止める
-limitは メモリを使い切らないための保険です。既定は無制限で、アプリの設定と共通です(-limitを書いたときだけそちらが優先)。- 上限に当たると 終了コード 2 と警告を返します。件数は全体の合計で数えます。並列で探すので、どの位置のヒットが残るかは決まりません。
-outを付けても上限は同じです。- 先頭 N 件が欲しいときは
-limitではなく-head Nを使ってください(rg | head -Nと同じ結果です)。
8. ファイルの指定(1本・複数・ワイルドカード・zip・除外)
8.1 いちばん大事な決まり:必ず引用符で囲む
uvp '*.log' ERROR           # ○
uvp *.log ERROR             # ✕ シェルが広げてしまう → エラーになります
uvp 'a.log b.log' ERROR     # ○
シェルではなく uvp が広げるので、Windows でも同じ書き方で動きます。
8.2 区切り・記号・例
空白かカンマで複数書けます。カンマがあればカンマだけで区切ります(空白を含むパスはカンマで)。波かっこ { } の中のカンマ・空白では区切りません。
| 記号 | 意味 | 例 |
|---|---|---|
* |
任意の文字の並び(フォルダーの区切り / はまたがない) |
uvp '*.log' ERROR |
? |
任意の1文字 | uvp 'app-0?.log' ERROR |
** |
フォルダーを何段でも(0段も含む) | uvp '**/*.log' ERROR |
{a,b} |
a か b(波かっこ。v1.9.0 から。決まりは 8.3) | uvp '**/*.{txt,log}' ERROR |
[ ] |
使えません(文字どおりの名前) | uvp 'app[1].log' ERROR(app[1].log という名前のファイル) |
| コマンド | 対象 |
|---|---|
uvp '*.log' ERROR |
今のフォルダーの .log |
uvp '*/*.log' ERROR |
1段下のフォルダーの .log |
uvp '**/*.log' ERROR |
今のフォルダー以下すべての .log |
uvp 'logs/**' ERROR |
logs 以下のすべてのファイル |
uvp 'app.log,app.log.*.gz' ERROR |
平文と gz を混ぜて |
uvp '**/*.{txt,log}' ERROR |
今のフォルダー以下すべての .txt と .log |
uvp 'app.log{,.*.gz}' ERROR |
app.log と app.log.*.gz('app.log,app.log.*.gz' と同じ) |
uvp 'logs/2026-{09,10}/*.log' ERROR |
logs/2026-09 と logs/2026-10 の .log |
uvp logs.zip ERROR |
zip の中のテキストのファイルすべて |
uvp 'logs.zip!server/*.log' ERROR |
zip の中の server/*.log だけ |
8.3 決まりごと
- 並びは書いた順。1つの指定の中は名前順。同じファイルは1回だけ。ただし、束ねた索引に後から足したファイルは索引の末尾に入るので、結果も後ろに出ます(9.2)。
- 隠しファイル・隠しフォルダー(
.で始まる名前)は、どの OS でも対象外です(ripgrep と同じ)。シンボリックリンクのフォルダーはたどりません。 - 大文字と小文字:Linux は区別、Mac と Windows は区別しません。
.uwvzはワイルドカードでは拾いません(名前を書けば使えます)。- 1件も当たらない指定は名前で知らせます。1,000本を超えると知らせます(環境変数
UVF_MANY_FILESで目安を変えられます)。 - フォルダー名だけ(
'logs')は使えません。'logs/**'と書きます。 - 波かっこ
{a,b}(v1.9.0 から):入れ子({a,{b,c}})と空の選択肢({,.gz})が使えます。1 つの指定から広がるのは 1,000 通りまでで、超えると止めます(終了コード 2)。閉じていないもの({a,b)・カンマの無いもの({}{a})は文字どおりの名前です。書いたとおりの名前のファイルが実在するときは、広げずにそれを使います。1件も当たらないときは、波かっこを書いたままの形で知らせます(一部の選択肢だけが当たらないときは知らせません)。画面の「コマンドライン」でも同じです。 .ignore・.gitignoreに当たるものは、ワイルドカードで広げたときに外します(8.4)。隠しファイルを外すのとは別の決まりです。
8.4 除外(.ignore・.gitignore)と --files
ワイルドカードで広げたファイルのうち、.ignore・.gitignore に当たるものは束ねず、探しません(uvf と同じ)。
主な規則は ripgrep と同じで、対象の一覧と検索結果が ripgrep と一致することを確かめています。違いは .rgignore を読まないことです。
.gitignore などに bin/ obj/ と書いてあれば、'**' で束ねてもそれらは入りません(git で管理しているだけでは外れません。規則に書かれているものが外れます)。
| 決まり | 内容 |
|---|---|
| 効く範囲 | ワイルドカードで広げたファイルだけ。名前を書いたファイルは除外しない。'build/**' のように先頭に書いたフォルダーも除外しない(中のファイルは規則で見る) |
| 読むファイル | .ignore・.gitignore・.git/info/exclude・git の全体設定(~/.gitconfig の [core] excludesFile。無ければ ~/.config/git/ignore)。.rgignore は読まない |
.gitignore が効くのは |
git のリポジトリの中だけ。.ignore はどこでも効く |
| 親フォルダー | 探し始めたフォルダーより上の除外ファイルも効く(.gitignore はリポジトリの根まで) |
| 強さ | .ignore → .gitignore → .git/info/exclude → 全体設定 → --ignore-file の順に強い。同じ種類なら深いフォルダーのほうが強い |
| 除外したフォルダー | 中を見ない。中のファイルを ! で戻すこともできない(git と同じ) |
| 大文字・小文字 | 区別する(git・ripgrep と同じ) |
| zip の中 | 除外は zip ファイルそのものに効く。zip の中のエントリには効かない(絞るときは 'logs.zip!server/*.log') |
書き方は .gitignore と同じです。# は注釈(\# で文字の #)、*.log はどの深さにも、/build は直下だけ、doc/*.md は途中に / があればそのフォルダーから、build/ はフォルダーだけ、[a-z] [!a-z] が使える(ファイルの指定とは違う)、** は何段でも、!keep.log で取り消し(後の行が勝つ)、行末の空白は無視(\ で空白)。CRLF・BOM の除外ファイルも読みます。
| オプション | 意味 | 例 |
|---|---|---|
--no-ignore |
.ignore・.gitignore・.git/info/exclude・全体設定による除外をしない。--ignore-file で足した規則は効いたまま(ripgrep 15 と同じ) |
uvp '**' ERROR --no-ignore |
--no-ignore-files |
--ignore-file で足した規則も使わない(ripgrep と同名) |
uvp '**' ERROR --no-ignore --no-ignore-files |
--ignore-file <ファイル> |
除外の規則を足す。何回でも。一番弱い(.ignore などの ! に負ける)。名前だけの規則(*.md など)は、置いた場所に関係なくどこにでも当たる |
uvp '**' ERROR --ignore-file extra.ignore |
--files |
検索せず、指定が何に広がるかだけを出す(「番号 |
uvp '**' --files |
知らせ方:検索の結果には何も足しません。--files の最後に「除外 N 本・フォルダー M 個(中は見ていません)」を出します。指定が除外のせいで1件も当たらなくなったときは「(.gitignore などで除外。–no-ignore で含めます)」を添えます。--ignore-file で規則を足したときは「–ignore-file で足した規則は –no-ignore-files で止めます」も添えます(--no-ignore だけでは足した規則は止まらないため)。
$ uvp '**' --files
uvp: 除外 1 本・フォルダー 2 個(中は見ていません)(.gitignore ほか。--no-ignore で含めます)
1   app.log
2   keep.tmp
3   logs/b.log

uvp '**' ERROR                   # 除外に従って束ねて探す
uvp '**' ERROR --no-ignore       # 除外せずに(除外されていたものも索引に足す。9.2)
8.5 特別な名前の書き方
| 名前 | 書き方 | 例 |
|---|---|---|
| 空白を含むファイル1本 | そのまま書けます(全体がそのまま実在するファイルなら1本として扱います) | uvp 'sp dir/my log.txt' ERROR |
| 空白を含むワイルドカード1つ | 最後にカンマを付けます(カンマがあると空白で区切らないため) | uvp 'C:/Program Files/app/*.log,' ERROR |
| 空白を含むものを複数 | カンマで区切ります | uvp 'C:/Program Files/app/*.log,D:/logs/*.log' ERROR |
| カンマを含む名前 | カンマは区切りになるので、? に置き換えます。? はどの1文字にも当たるので、a-b.log や aXb.log があればそれも対象になります。 先に --files で対象を確かめてください |
uvp 'a?b.log' --files で確かめてから uvp 'a?b.log' ERROR |
- で始まる名前 |
./ を付けます |
uvp ./-debug.log ERROR |
[ ] を含む名前 |
そのまま書けます(ワイルドカードではありません) | uvp 'app[1].log' ERROR |
{ } を含む名前 |
カンマの無い {} {a} はそのまま書けます。カンマを含む {a,b} は波かっことして広がりますが、書いたとおりの名前のファイルが実在すればそれを使います(8.3)。先に --files で確かめてください |
uvp 'report{1}.log' ERROR |
9. 束ねた索引(複数ファイル)
複数のファイルを指定すると、uvp は全部を1本の索引に束ねます。束ねた索引は、2回目からは作り直しません。
uvp '*.log' ERROR          # 1回目:束ねた索引を作る
uvp '*.log' timeout        # 2回目から:索引を使うので速い
9.1 索引の名前と置き場所
- 置き場所は実行したフォルダーです。
- 名前は
uw-で始まり、指定を記号に置き換えたものです(*→%a、/→%s、,→%c)。
| コマンド | できる索引の名前 |
|---|---|
uvp '*.log' ERROR |
uw-%a.log.uwvz |
uvp 'osm17/*.osm' 東京 |
uw-osm17%s%a.osm.uwvz |
uvp 'logs/*.log,err/*.log' ERROR(長い) |
uw-logs-ayh2yrrosfs3.uwvz(uw-見出し-ハッシュ12文字) |
- 名前(
.uwvzを除く)が 24 文字を超えるときはuw-見出し-ハッシュ.uwvzにします。元の指定は--infoで分かります(12章)。 - 絶対パスで書いても、起動フォルダーの中なら相対パスに直すので同じ索引になります。
- 索引の名前で探すこともできます:
uvp 'uw-%a.log.uwvz' ERROR
9.2 ファイルが変わったとき
| 変化 | 動き |
|---|---|
| ファイルが増えた | 増えた分だけ索引の末尾に足す(名前の並びで途中に入るファイルも末尾に足す。その結果は出力の後ろに出る) |
| ファイルに行が足された | 足された分だけ足す |
| ファイルが書き換わった | 作り直す(前に予告を出します) |
| ファイルが消えた | 作り直さない。消えたファイルの中身は索引に残り、探せます |
除外で外れた(.gitignore に書き足した・--ignore-file を付けた。ファイルはディスクに有る) |
索引に残すが、探さない。作り直さない |
除外が外れて入った(.gitignore から消した・--no-ignore を付けた) |
末尾に足す(索引にまだ無ければ)。一度 --no-ignore で足したものは、次に付けずに走らせると「残すが探さない」になる |
| 作り直したい | --rebuild(前の索引は .bak-日時 に退避) |
- ログの入れ替え(古いファイルの削除)で中身を失わないための決まりです。消えたファイルを索引からも外したいときだけ
--rebuildを付けてください。 - まとめると、探すのは「今回広げた一覧」と「ディスクから消えたファイル」です。ディスクに有るのに今回の一覧に無いもの(除外で外れたもの)は探しません。
- 足すときでも、今の索引が 4MB 未満のときと、足すものが圧縮ファイルのときは、作り直します。
9.3 出力
ファイル名:行番号<TAB>本文。zip の中はlogs.zip!app.log:行番号<TAB>本文。- 行番号はファイルごとに 1 から数えます(
-seqの出力だけは束ねた全体の通し行番号です。5.1)。
9.4 JSON の形(–json)
1行に1つの JSON を出します(全体を配列で囲みません)。
| 場合 | コマンド | 形 |
|---|---|---|
| 1本のファイル | uvp app.log ERROR --json |
{"n":行番号,"line":"本文"} |
| 束ねた索引(zip の中を含む) | uvp '*.log' ERROR --json |
{"file":"a.log","n":そのファイルの中の行番号,"line":"本文"}(-h で file を外す) |
| 行番号なし | uvp app.log ERROR --json --no-line-number |
{"line":"本文"} |
前後の行(-C) |
uvp app.log ERROR -C 2 --json |
前後の行も同じ形で出します(ヒットした行か前後の行かを見分ける項目はありません。-- の区切り行は出しません) |
集計(-uniq) |
uvp app.log ERROR -uniq 'code=(\d+)' --json |
{"value":"値","count":件数}(割合と順位は出しません) |
流れ(-seq) |
uvp app.log -seq login,timeout --json |
{"lines":[行番号,…]}(束ねた索引でも通し行番号・ファイル名なし) |
10. 入力の種類(圧縮 7 形式・zip・pbf・Word・Excel・PDF)
形式は拡張子で見分けます。
| 形式 | コマンド | uvp |
|---|---|---|
.gz |
uvp app.log.gz ERROR |
展開して索引にする |
.bz2 .xz .lzma .zst .lz4 .br |
uvp app.log.xz ERROR |
展開して索引にする(外部コマンドは使いません) |
.zip |
uvp logs.zip ERROR |
中のファイルごとに扱う(logs.zip!app.log)。テキストのものだけ(画像などは名前を出して飛ばす) |
.pbf(OSM) |
uvp japan-latest.osm.pbf 東京 |
XML(OSM-XML と同じ形)にして扱う |
.docx .docm .xlsx .xlsm .pdf |
uvp report.docx 東京 |
文字を取り出して索引にする(隣に report.docx.uwvz。v1.9.0 から。10.2) |
.doc .xls |
uvp old.doc 東京 |
扱えません(古い形式です。Word・Excel で .docx・.xlsx に保存し直してください) |
.uwvz |
uvp app.log.uwvz ERROR |
作った索引。そのまま調べられる |
.tar.gz |
uvp logs.tar.gz ERROR |
扱えません(展開して uvp で1本の索引にまとめてください) |
| それ以外 | uvp app.log ERROR |
テキストとして扱う。画像・実行ファイルなどテキストでないものは束ねず、名前を出して飛ばす(not text, skipped: 名前。ripgrep も探しません) |
- 平文と圧縮を混ぜて束ねられます:
uvp 'app.log,app.log.*.gz' ERROR - 形式の違うものを混ぜても1本に束ねられます。
- 途中で切れた圧縮ファイルは断り、索引を残しません。
- UTF-32 のファイルは、ほかと束ねられないので断ります(1本だけなら扱えます)。UTF-16 は v1.9.0 から索引の中で UTF-8 にして持つので、ほかと束ねられます(4.1)。
japan-latest.osm.pbf(2.46GB)は、XML にすると 51.3GB 分の内容になります。uvp はこれを、検索できる.uwvzに 21.6秒で変えます。続けて「東京」(94,979件)を探し終えるまで、キャッシュを捨てた状態から合計 27.34秒。2回目からは.uwvzを使うので 5.01秒(キャッシュを捨てた直後でも 6.43秒)です(2026年9月28日の実測・uvp1.7.3.5。変換と検索の処理は 1.7.3.6 と同じ)。
10.1 文字コード
ファイルの先頭(256KB まで)を見て、自動で見分けます。文字コードを指定するオプションはありません。
| 順 | 見分け方 | 文字コード |
|---|---|---|
| 1 | 先頭の BOM | UTF-8・UTF-16LE・UTF-16BE・UTF-32LE |
| 2 | BOM なしで UTF-8 として正しい(ASCII だけのものも含む) | UTF-8 |
| 3 | それ以外は Shift_JIS と EUC-JP を比べ、おかしなバイトの少ないほう | Shift_JIS か EUC-JP |
| 4 | 決められないとき | Shift_JIS |
- BOM の無い UTF-16・UTF-32、UTF-32BE、そのほかの文字コード(Latin-1・GBK・ISO-2022-JP など)は見分けません。
- 検索は文字コードに関係なく、文字として照合します。
- Shift-JIS・EUC-JP・UTF-16 は、索引の中では UTF-8 にして持ちます(4.1)。
10.2 Word・Excel・PDF(v1.9.0 から)
Word・Excel・PDF の中の文字を取り出して、隣に索引(report.docx.uwvz)を作ります。2 回目からは索引を探します。元のファイルが変われば作り直します。集計・範囲・整形などの段も、テキストと同じに使えます。
uvp report.docx 東京              # Word(隣に report.docx.uwvz を作る)
uvp '経費/**/*.xlsx' 交通費        # Excel(束ねて探す)
uvp 'docs/**/*.pdf' 契約 -i        # PDF
uvp 売上.xlsx 0.5 --raw            # Excel を、表示の値ではなく元の値で探す
| 形式 | 拡張子 | 1 行の形 |
|---|---|---|
| Word | .docx .docm |
段落ごとに 1 行。表の 1 行は、セルをタブで区切った 1 行。脚注とコメントは印を付けて後ろに出します |
| Excel | .xlsx .xlsm |
シート名!行番号<TAB>A列<TAB>B列…。セルは表示されている値(50% など)。--raw を付けると元の値(0.5。式は計算結果の数)で取り出します |
.pdf |
ページごとに ## page N の行、続けてそのページの行を読む順に(2 段組は左の段から) |
- 断るもの:古い形式(
.doc.xls)・パスワード付き・文字の無い PDF(画像だけのもの。OCR はしません)・壊れたもの。理由を出して、終了コード 2 で終わります。束ねる指定の中にあるときは、名前を出して飛ばします(束ねません)。 - 元の形式には書き出せません(
-outに.docxなどは指定できません)。-extractは、取り出した文字をreport.docx.txtに書きます(12.1)。 - 画面で開くと「文字を取り出して開きます」と進み具合を出し、索引を作ります。新しく取り出して索引を作るにはライセンスが要ります(無いときは、無料版と同じく一時フォルダーに取り出して開きます)。
- Word・Excel・PDF を読む部品(PdfPig・Apache 2.0)を入れたので、uvp のコマンドは大きくなりました(約 10MB → 21MB)。
11. 出力(-out と圧縮での書き出し)
-out の拡張子で形が決まります。検索の結果・cat・-extract のすべてで同じです。
| 拡張子 | 書き出す形 | 例 |
|---|---|---|
.gz .bz2 .xz .lzma .zst .lz4 .br |
その形式で圧縮 | uvp app.log ERROR -out errors.xz |
.zip |
zip | uvp app.log ERROR -out errors.zip |
| それ以外 | テキスト | uvp app.log ERROR -out errors.txt |
uvp app.log ERROR -out errors.txt          # テキストで(rg -n > file の代わり)
uvp app.log ERROR -out errors.txt.gz       # gz で圧縮して(rg | gzip > out.gz の代わり)
uvp app.log ERROR -out errors.xz           # xz で圧縮して
uvp cat app.log.bz2 -out app.log.zst       # bz2 を zst に書き換える
- 既にあるファイルには書きません。上書きするときは
--force。 - Word・Excel・PDF の形(
.docx.xlsx.pdfなど)には書き出せません(10.2)。 -extractでは、形式を書けばそれが-outの拡張子より優先します(12章)。束ねた索引を-extractするときの-outはフォルダーです。- 書き終えてから名前を付けるので、途中で止めても壊れたファイルは残りません。
- 圧縮の強さ:gz 6・bz2 9・xz 6(複数ブロック。後で読むとき並列で展開できる)・lzma 6・zst 3・lz4 速い設定・br 6。
- その形式のライブラリが無い環境では、テキストに落とさずにエラーにします。ただし bz2 は、OS にライブラリが無い Windows でも内蔵の方法で書けます(遅くなります)。
- 出力が大きくなるときは、端末に流すより
-outでファイルに書くほうが速く済みます。
12. 元に戻す(-extract)・中身を見る(–info)
12.1 -extract(無料)
uvp app.log.uwvz -extract                    # 元の形で、元の名前に戻す
uvp app.log.uwvz -extract txt -out app.log   # テキストで
uvp app.log.uwvz -extract gz -out app.log.gz # gz で
- 形式:
txt gz bz2 xz lzma zst lz4 br zip。省略すると元の形(app.log.bz2から作った索引はapp.log.bz2に戻る)。 - 形は「指定 →
-outの拡張子 → 元の形」の順で決まります。 - 展開した中身は元と同じバイト列です。圧縮ファイル自体のバイト列は元と一致しません(圧縮の具合や時刻が違うため)。
- pbf には戻せません(XML のテキストで戻ります。
-extract pbfはエラー)。 - Word・Excel・PDF から作った索引は、元の形式には戻せません。取り出した文字を
report.docx.txtに書きます。 - Shift-JIS・EUC-JP・UTF-16 のファイルは、索引の中では UTF-8 で持っていますが、
-extractは元の文字コードで書き戻します(4.1)。NEC・IBM の外字(機種依存文字)などは、同じ字が別の番号で戻ることがあります。 - EUC-JP の補助漢字(JIS X 0212)は読めません。「・」として読むので、元には戻りません。
- 束ねた索引は、部品ごとに元の名前・元の形で戻します(
-outはフォルダー)。形を指定すると全部品をその形にし、拡張子を付け替えます。付け替えで2本が同じ名前になるときは、書き始める前にエラーにします。 - ライセンスが無くても使えます。
12.2 –info(無料)
uvp uw-logs-ayh2yrrosfs3.uwvz --info
uvp 'logs/*.log,err/*.log' --info
元の指定・作った日時・束ねた中身の一覧を出します。Shift-JIS などから作った索引では、「中の文字コード: UTF-8(元の文字コード: shift_jis)」も出ます。ハッシュの名前の索引が何を束ねたものか知りたいときに使います。
12.3 gzip の代わりに .uwvz で置いておく
.uwvz は、戻さずにそのまま探せる圧縮形式+索引です。保管用の gzip の代わりにもなります。
- 2.9GB の OSM で比べると、
.uwvzは 240.2MB を 4.03秒以下、gzip -6は 287.0MB を 16.70秒でした。 - 50GB の
.uwvzを直接探すと cold 6.48秒・hot 5.19秒。rg が元ファイルを走査すると 54.99秒・55.04秒でした。 -extractは 3GB で 3.55秒、元ファイルとバイト一致でした。- この3つの数字の条件は 21.7 にあります。
- UwView 専用の形式です。他の人に渡すときは
-extractで戻すか、-outで gz などにしてください。
詳しくは gzip の代わりに .uwvz で置いておく。
13. 置換(-replace)
# sed・ripgrep
sed 's/東京/TOKYO/g' F > out.txt
sed -E 's/v="(bus_stop|traffic_signals)"/v="X_\1"/g' F > out.txt
rg -N -F --passthru '東京' -r TOKYO F > out.txt

# uvp(元ファイルは変更しない。全文を出力する)
uvp F '東京' -replace TOKYO -out out.txt
uvp F 'v="(bus_stop|traffic_signals)"' -E -replace 'v="X_$1"' -out out.txt
uvp app.log 'password=[^ ]+' -E -replace 'password=***' -out masked.log
uvp app.log '(\d{4})-(\d{2})-(\d{2})' -E -replace '$1/$2/$3'
- 検索語に一致した部分を置き換えた全文を出します(
sed 's/A/B/g'と同じ)。元のファイルは変えません。 - 検索語には
-i-E-wを付けられます。 - 置換後はそのままの文字列です。
-Eのときだけ$1$2などで一致部分を使えます($そのものは$$)。 - 出力は
sed/rg --passthruとバイト単位で一致することを確かめています。 - 置換の件数は「行」ではなく「箇所」を数えます(3GB の
東京:検索ヒット 11,274行に対し置換 11,361箇所。87行に2箇所以上あった、ということです)。 convert/cat/-extractとは一緒に使えません。- Edit ライセンスが必要です(14日間の無料試用で使えます)。
実測(全文を書き出すまでの時間。条件は 21.7)
| 3GB | 10GB | 50GB | |
|---|---|---|---|
uvp -replace |
4.57秒 | 13.47秒 | 69.75秒 |
sed 's/A/B/g' |
14.94秒(3.27倍) | 26.51秒(1.97倍) | 187.74秒(2.69倍) |
rg --passthru -r |
7.06秒(1.54倍) | 26.89秒(2.00倍) | 146.65秒(2.10倍) |
uvp -E -replace '$1' |
4.17秒 | 14.08秒 | 69.95秒 |
sed -E(後方参照つき) |
24.81秒(5.95倍) | 78.36秒(5.57倍) | 405.52秒(5.80倍) |
かっこ内は uvp に対する時間の比です。後方参照つきの置換は sed の約6倍で、50GB で sed が 6分45秒、uvp が 1分10秒でした。
14. 正規表現(-E)
UwView は .NET の正規表現を使います。よく使う書き方は ripgrep(Rust)と同じですが、当たる範囲が変わる違いがあります(下の表)。
| 書き方 | 意味 | 例 |
|---|---|---|
. * + ? {2,5} |
任意の1文字・0回以上・1回以上・0か1回・2〜5回 | uvp app.log 'code=\d{3}' -E |
[abc] [^abc] ( ) a\|b |
文字の集まり・グループ・どちらか | uvp app.log '(ERROR\|WARN) disk' -E |
^ $ \d \w \s \b |
行頭・行末・数字・英数字(日本語も)・空白・語の境目 | uvp app.log '^2026-09-27' -E |
(?i) |
大文字小文字を区別しない | uvp app.log '(?i)error' -E |
| 書き方 | uvp(.NET) | ripgrep |
|---|---|---|
| 既定の扱い | uvp app.log 'a.b'(文字列そのままで「a.b」を探す。正規表現は -E) |
rg 'a.b' app.log(正規表現。文字列そのままは -F) |
| 先読み・後読み | uvp app.log 'ERROR(?=.*disk)' -E(使えます) |
rg -P 'ERROR(?=.*disk)' app.log(PCRE2 を使うとき) |
| 後方参照 | uvp app.log '(\w+) \1' -E(使えます) |
rg -P '(\w+) \1' app.log(PCRE2 を使うとき) |
| 名前付きグループ | uvp app.log '(?P<code>\d{3})' -E(uvp が (?<code>…) に読み替えます) |
rg '(?P<code>\d{3})' app.log |
| POSIX 文字クラス | uvp app.log '[A-Za-z]+' -E([[:alpha:]] は使えません。エラーで同じ範囲の書き方を案内します) |
rg '[[:alpha:]]+' app.log(ASCII の英字だけに当たる) |
| 数字・空白 | uvp app.log '[0-9]+' -E(\d は全角数字にも当たる) |
rg '\d+' app.log(Unicode の数字) |
| 用字(漢字・ひらがな) | uvp app.log '\p{IsCJKUnifiedIdeographs}+' -E(\p{Han} は使えません。範囲も少し違う) |
rg '\p{Han}+' app.log |
- 1行ずつ照合します(複数行にまたがる検索はできません)。
- 1回の照合が 5 秒を超えたら止めます。
-uniqと-sortのキーも同じ正規表現で、第1キャプチャ群( )の中が値になります。- 正規表現の速さは、式の形よりもヒットの件数で決まります(21.6)。
書き換えの例(1)POSIX 文字クラス → ripgrep と同じ範囲になる書き方(当たる行は変わりません):
| ripgrep | uvp | 注意 |
|---|---|---|
rg '[[:alpha:]]+' app.log |
uvp app.log '[A-Za-z]+' -E |
\p{L} にすると日本語なども当たる(範囲が広がる) |
rg 'id=[[:digit:]]+' app.log |
uvp app.log 'id=[0-9]+' -E |
\d にすると全角数字(12)も当たる |
rg 'a[[:space:]]b' app.log |
uvp app.log 'a[ \t\r\n\f\v]b' -E |
\s にすると全角空白なども当たる |
書き換えの例(2)用字 → 近い範囲の書き方(.NET には用字の指定が無いので、Unicode のブロックで近い範囲を書きます。当たる文字は同じではありません):
| ripgrep | uvp(近い書き方) | 違い |
|---|---|---|
rg '\p{Han}+' app.log |
uvp app.log '[\p{IsCJKUnifiedIdeographs}\p{IsCJKUnifiedIdeographsExtensionA}\p{IsCJKCompatibilityIdeographs}々〇]+' -E |
\p{IsCJKUnifiedIdeographs} だけだと 々・〇・拡張A(㐀 など)に当たらない。拡張B 以降の漢字は、この書き方では含められない |
rg '\p{Hiragana}+' app.log |
uvp app.log '\p{IsHiragana}+' -E |
ブロックとスクリプトの違いで、わずかに範囲が違う(濁点の結合文字など) |
rg '\p{Katakana}+' app.log |
uvp app.log '[\p{IsKatakana}ヲ-゚]+' -E |
\p{IsKatakana} だけだと半角カナに当たらない。長音符「ー」はブロックには入るがスクリプトでは共通扱い |
日本語・全角文字も含めて探したいときは、\p{L}(文字)・\d(数字)・\s(空白)を使ってください。ripgrep の [[:alpha:]] などより範囲が広くなります。
15. CLI から GUI へ — -open
uvp は ターミナルで絞り込んだ続きを、そのまま GUI で開けます。GUI と CLI は同じ索引(.uwvz)を使うので、渡した先でも待たされません。
| 書き方 | 動き |
|---|---|
uvp -open |
GUI を起動するだけ |
uvp -open app.log |
app.log を GUI で開く |
uvp -open app.log ERROR -C 5 timeout |
同じ調べ方を GUI で実行する(先頭の -open) |
uvp app.log ERROR -uniq 'code=(\d+)' -open |
実行して結果を出し、GUI でも開く(末尾の -open) |
uvp -open '*.log' |
束ねて(2回目からは今の索引を使って)その .uwvz を GUI で開く |
uvp '*.log' ERROR -uniq 'code=(\d+)' -open |
束ねて調べ、結果を出してから、束ねた .uwvz を GUI でも開く |
uvp -open uw-%a.log.uwvz |
前に作った束ねた索引を、名前を書いて開く |
# 末尾に -open … CLI で実行して結果を出し、そのうえで GUI にも渡す
uvp osm/japan-latest.osm 'k="amenity"' -uniq 'v="([^"]+)"' -head 20 -limit none -open

# 先頭に -open … CLI では実行せず、GUI 上で実行して画面で見る
uvp -open osm/japan-latest.osm 'k="amenity"' -uniq 'v="([^"]+)"' -head 20 -limit none
末尾に付けた場合 — ターミナルに結果が出たうえで、同じ集計が GUI にも並びます(写真のボタンは文字ですが、いまのボタンはアイコンです。名前はマウスを乗せると出ます)。
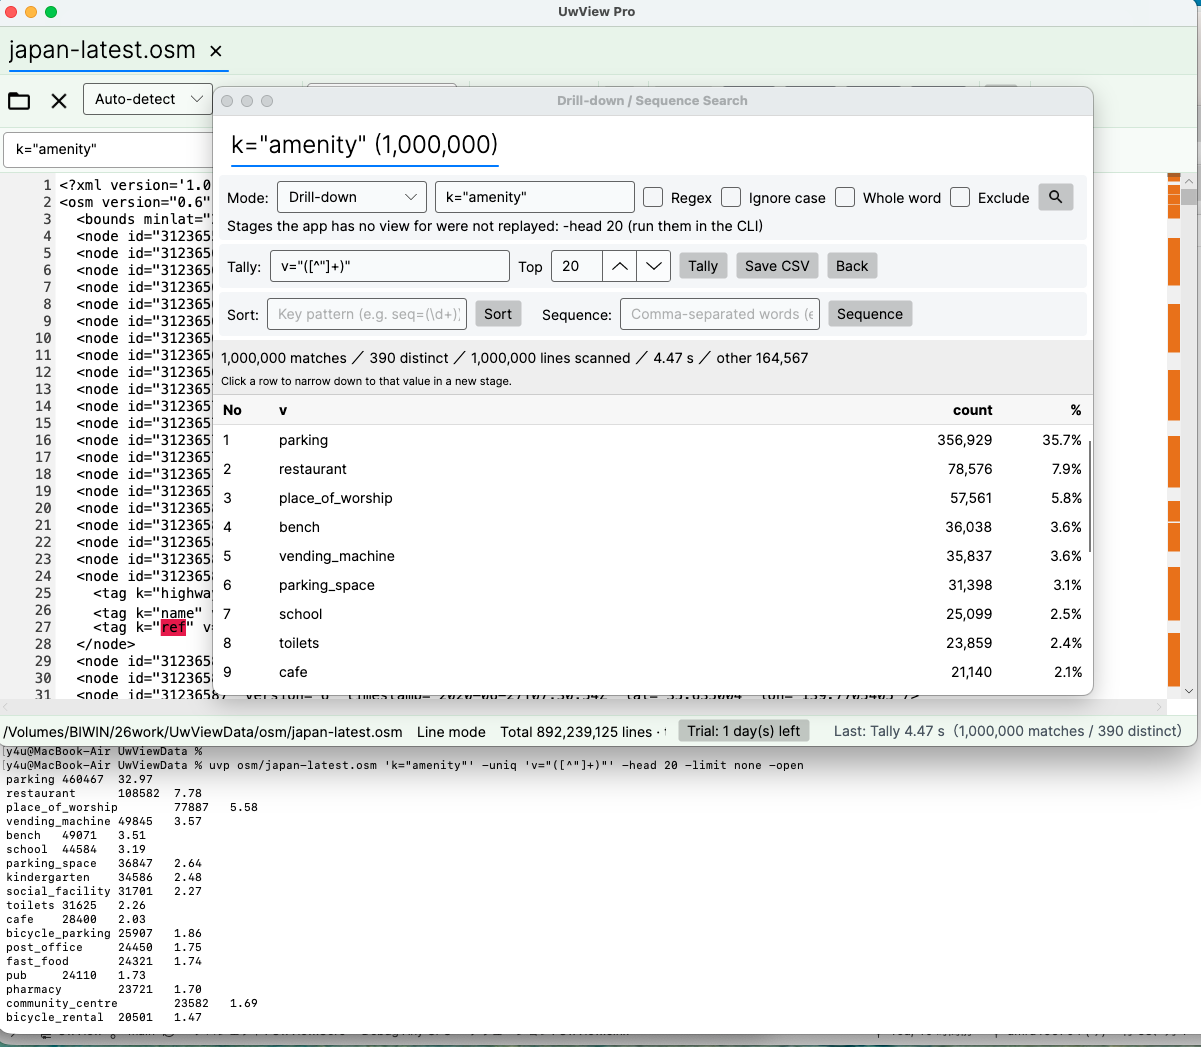
先頭に付けた場合 — 実行そのものを GUI が受け持ちます。あとはマウスで続けられます。
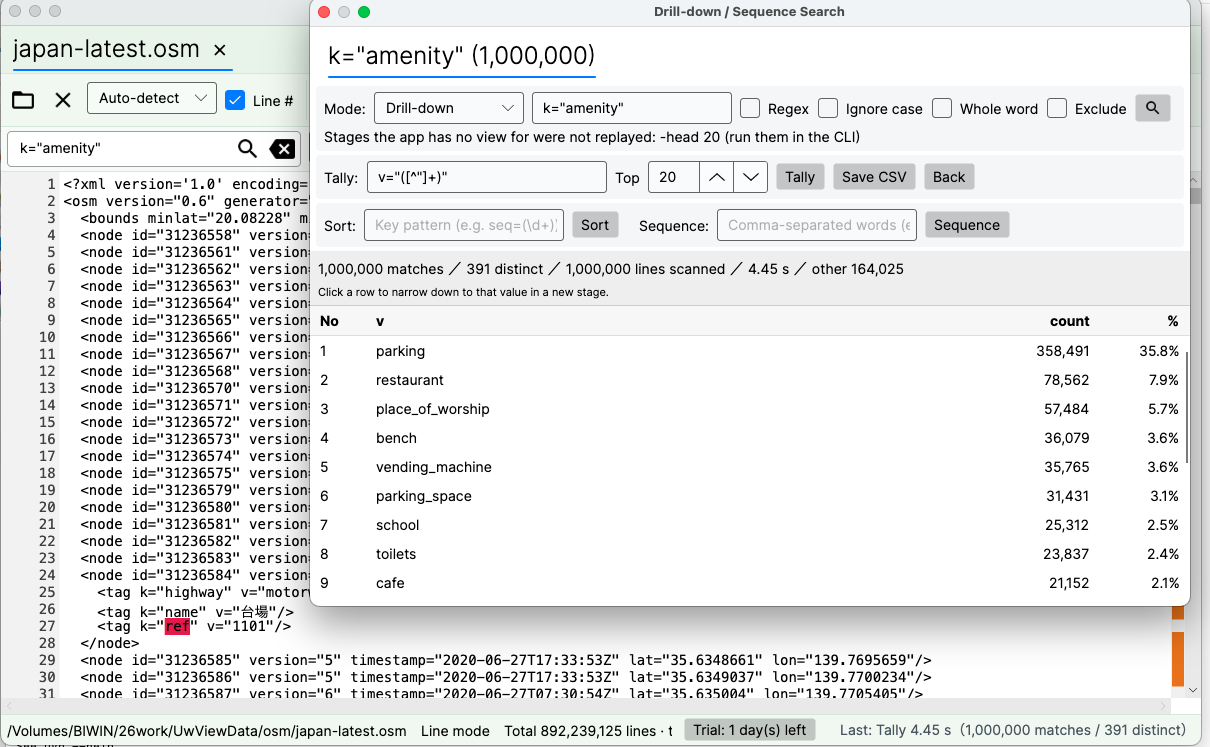
15.1 画面に着いたあとが速い
渡された先の GUI では、同じファイルに何度でも質問を足せます。
- 一覧の行をクリックすると、その値で次の段に絞り込まれます。
parkingを押せばk="amenity"かつparkingの段が新しいタブで開きます - 2段目以降は前段の範囲だけを見るので待ちがありません。条件を変えたくなったら、そのタブに戻るだけ。パイプを組み直して 51GB を読み直す必要はありません
- モードを Drill-down / Sequence で切り替え、集計・並べ替え・CSV 保存もその場でできます
- 51GB・8.9億行のファイルで、画面に出ている集計は 4.45秒でした(写真の画面のステータス「Last: Tally 4.45 s」。条件は 21.7)
スクリプトや cron では CLI。あたりが付いたら
-openで GUI に渡して、結果を見ながら何度でも絞り直す。
この行き来ができるのが、grep / rg のパイプには無い点です。
15.2 ファイル一覧とタブ(束ねた索引を開いたとき)
束ねた索引を開くと、行番号欄は ファイル番号:行番号(zip の中は n-m:行番号)になります。
本体の「ファイル一覧」ボタン(箇条書きのアイコン。検索結果の窓にも同じボタンがあります)で、番号と元ファイルの対応表を開けます。
ボタンはアイコンで、名前はマウスを乗せると出ます(はい/いいえ・開く/閉じる・保存・中止は文字のまま)。
| 列 | 中身 |
|---|---|
| 番号 | n または n-m(--files と同じ番号) |
| ファイル | 元ファイルの名前(マウスを乗せると絶対パス) |
| ヒット | 検索しているときの、そのファイルのヒットの件数 |
| 大きさ | 束ねたときの大きさ |
| 右端 | 追加のタブで開いていれば「タブ」 |
- 行をダブルクリック(または Enter)で開きます。
- 右上の 「タブで開く」 で開き方を切り替えます(状態は次に開いたときも同じ。既定はオフ)。
- オフ:束ねた本文(メイン)の中で、そのファイルの先頭へ移ります。
- オン:元のファイルを追加のタブで個別に開きます。タブ名は
3:app-0903.logのように番号付きです。 - タブは最大 8 個(メイン 1 + 追加 7)です。8 個開いているときは開かずに「タブは 8 個までです」と出します(古いタブを勝手に閉じません)。
- すでに開いているファイルは、そのタブに切り替えるだけです。
- 追加のタブを開いている間は、束ねた本文のタブは閉じられません。
- 束ねた本文(メイン)のタブは灰色です。窓の題名は
UwView Pro(uvp)-Full Spectrum(v1.9.0)の形です。 - タブは増えても1行のままで、左右にスクロールします。名前は 27 文字を越えると末尾が
...になり、マウスを重ねると全体が出ます。 - 元のファイルが消えているものと zip の中のファイルはタブで開けません。理由を出し、メインでそのファイルの先頭へ移ります。
v1.8.1.9(Finder Scope)からは、GUI の中でも束ねられます(20.1)。
- ツールバーの「コマンドライン」ボタン(Ctrl+Shift+K、Mac は Cmd+Shift+K)でダイアログを開き、ファイル指定の欄に
'*.log'のような指定を入れて[検索実行]すると、uvpと同じに束ねて開きます。検索語を入れなければ、束ねて開くだけです(uvp -open '*.log'と同じ)。 - 束ねる前に、前の索引をそのまま使う・足す・作り直す・新しく作るのどれになるかと、かかる時間の目安をダイアログに出します。
- フォルダーを窓にドロップすると、そのフォルダーを基準にしたダイアログが開きます。[開く]で 2 本以上選んだときは、別々のタブで開くか、1 本に束ねるかを尋ねます。
- 基準フォルダーに書けないときは、索引の保存先を尋ねます。
16. スレッド数の調整(–tune)
uvp --tune                 # 測って、おすすめの値を表示する
uvp --tune big.log         # 手持ちのファイルで測る
uvp --tune --apply         # 設定に保存する(GUI と共通)
17. 終了コードとスクリプト
| コード | 意味 |
|---|---|
| 0 | ヒットあり |
| 1 | ヒットなし(grep と同じ) |
| 2 | エラー(指定の誤り、-limit に達した、索引を保存できなかった、メモリが足りなくなった、など) |
検索以外のコマンド:
| コマンド | 0 | 1 | 2 |
|---|---|---|---|
uvp convert app.log |
作れた | — | 作れなかった(-out が .uwvz でない、など) |
uvp cat app.log |
出せた | — | 読めなかった |
uvp app.log.uwvz -extract |
戻せた | — | .uwvz でない・書けない |
uvp '…' --info |
出せた | — | 索引が無い・由来の記録が無い |
uvp '…' --files |
1本以上あった | — | 1本も無かった |
uvp app.log 語 -replace 置換後 |
1か所以上置き換えた | 置き換える所が無かった | Edit ライセンスが無い・エラー |
-head Nで途中まで出したときは、上限で打ち切ったのではないので 0 です(前の段で-limitに達していれば 2)。-uniqで値の種類が 20 万を超えて打ち切ったときも 2 です。- Word・Excel・PDF で断ったもの(
.doc・.xls・パスワード付き・文字の無い PDF・壊れたもの)は、理由を出して 2 で終わります(10.2)。波かっこが 1,000 通りを超えたときも 2 です(8.3)。 - 当たる行が多すぎてメモリが足りなくなったときは、落ちずに絞り方の案内を出して 2 で終わります。
#!/usr/bin/env bash
if uvp /var/log/app.log 'FATAL' -limit 100 -out /tmp/fatal.txt; then
  mail -s "FATAL found" ops@example.com < /tmp/fatal.txt
fi
- 進捗・診断は stderr、データは stdout です(パイプに流しても安全)。
- 出力が大きくなるときは
-outでファイルに書いてください。メモリを守りたいときは-limit、先頭 N 件だけ見たいときは-head Nです。
18. ripgrep との対応表
例のファイル名は app.log、フォルダーは logs、探す語は ERROR にそろえています。
| やりたいこと | ripgrep など | uvp |
|---|---|---|
| 文字列で探す | rg -F ERROR app.log |
uvp app.log ERROR |
| 正規表現で探す | rg 'ERROR\|WARN' app.log |
uvp app.log 'ERROR\|WARN' -E |
| 大文字小文字を無視 | rg -F -i error app.log |
uvp app.log error -i |
| 含まない行 | rg -F -v DEBUG app.log |
uvp app.log DEBUG -v |
| 前後の行 | rg -F -C 3 ERROR app.log |
uvp app.log ERROR -C 3 |
| 単語一致 | rg -F -w ERROR app.log |
uvp app.log ERROR -w |
| 先頭 N 件 | rg -F ERROR app.log \| head -10 |
uvp app.log ERROR -head 10 |
| 絞り込み(ERROR の行のうち timeout を含む) | rg -F ERROR app.log \| rg -F timeout |
uvp app.log ERROR -grep timeout |
| 行番号なしで出す | sed -n '/ERROR/p' app.log |
uvp app.log ERROR --no-line-number |
| サブフォルダーも | rg -F ERROR logs/ |
uvp 'logs/**' ERROR |
.ignore・.gitignore に従う |
rg -F ERROR .(既定で従う) |
uvp '**' ERROR(既定で従う。8.4) |
| 除外しない | rg -F --no-ignore ERROR . |
uvp '**' ERROR --no-ignore |
| 除外の規則を足す | rg -F --ignore-file extra.ignore ERROR . |
uvp '**' ERROR --ignore-file extra.ignore |
| 足した規則も使わない | rg -F --no-ignore --no-ignore-files ERROR . |
uvp '**' ERROR --no-ignore --no-ignore-files |
| 対象ファイルの一覧 | rg --files logs/ |
uvp 'logs/**' --files(除外の規則は同じ。.rgignore は読まない) |
| 圧縮も | rg -z -F ERROR app.log.xz |
uvp app.log.xz ERROR(-z は不要) |
| 数える(ERROR の行を code ごとに) | rg -F ERROR app.log \| rg -n -o -r '$1' 'code=(\d+)' \| sort -u \| cut -d: -f2 \| sort \| uniq -c \| sort -rn(-n と sort -u で1行の中の同じ値を1回にする。-uniq は行を数えるため) |
uvp app.log ERROR -uniq 'code=(\d+)' -sort count |
| 置換した全文 | sed -E 's/password=[^ ]+/password=***/g' app.log |
uvp app.log 'password=[^ ]+' -E -replace 'password=***' |
| zip の中 | 不可(展開してから) | uvp logs.zip ERROR |
| 2回目を速く | 索引を作って使い回す機能は無い(OS のキャッシュで2回目は速くなる) | uvp app.log ERROR(索引を作り、2回目からそれを探す) |
18.1 ripgrep にあって uvp に無いもの
uvp のオプションと段は 5章・7章の表がすべてです。次の ripgrep の機能は uvp にはありません。代わりの書き方があるものは右の列に書きました。
| ripgrep | 内容 | uvp での代わり |
|---|---|---|
rg -F -A 3 ERROR app.log・-B 3 |
後ろだけ・前だけの行 | ありません(前後両方なら uvp app.log ERROR -C 3) |
rg -F -x ERROR app.log |
行全体が一致 | uvp app.log '^ERROR$' -E |
rg -F -c ERROR app.log |
一致した行の数 | uvp app.log ERROR \| wc -l(件数は最後に「N 件」とも出ます) |
rg -F -l ERROR logs/ |
一致したファイルの名前だけ | uvp 'logs/**' ERROR --json \| jq -r .file \| uniq(jq が要ります)。パスにコロンが無いなら uvp 'logs/**' ERROR \| cut -d: -f1 \| uniq でも(Windows の C: などでは使えない簡易な方法) |
rg -F -q ERROR app.log |
あるかどうかだけ(見つけたら止める) | uvp app.log ERROR -head 1 > /dev/null(終了コードで分かる。1件見つけた時点で止まる) |
rg -F -m 5 ERROR logs/ |
ファイルごとの件数の上限 | ありません(全体の先頭なら uvp 'logs/**' ERROR -head 5) |
rg -o 'code=\d+' app.log |
一致した部分だけ出す | ありません(値ごとに数えるなら uvp app.log ERROR -uniq 'code=(\d+)') |
rg -e ERROR -e WARN app.log(-f も) |
複数の語 | uvp app.log 'ERROR\|WARN' -E(語のファイル -f はありません) |
cat app.log \| rg ERROR |
標準入力を探す | ありません(ファイルに書いてから探してください) |
rg -U 'a\nb' app.log |
複数行にまたがる | ありません(1行ずつ照合します。流れを見るなら -seq) |
rg --hidden ERROR |
隠しファイルも探す | ありません(隠しファイルも名前を書けば探せます) |
rg -L ERROR |
リンク先のフォルダーをたどる | ありません |
rg -t log ERROR・--max-depth・--max-filesize |
種類・深さ・大きさで絞る | 種類と深さはファイルの指定で(uvp '**/*.log' ERROR・uvp '*/*.log' ERROR)。大きさはありません |
rg -E sjis ERROR app.log |
文字コードを指定 | ありません(自動で見分けます) |
rg -0・--column・-b |
NUL 区切り・列番号・バイト位置 | ありません |
また、ファイルの指定は1つの文字列にまとめて書く形です(8章)。空白・カンマ・[ ] { } を含む名前はそのまま書けないことがあり、既存のスクリプトからファイル名を1つずつ渡す使い方は、ripgrep のほうが向いています。
19. よくあるつまずき
| 症状 | 原因と対処 |
|---|---|
| 「複数のファイルが直接渡されました」 | 引用符を付け忘れています。uvp '*.log' 語 |
| 「-i は検索語の直後に書いてください」 | 検索の指定(-i -E -w -v -C)は、その検索語のすぐ後ろに書きます |
| 「知らないオプションです」 | 検索語が - で始まるときは -grep -9999 のように書きます |
-sort や -uniq が1段目でエラー |
先に検索の段を書いてください |
-limit で exit 2 |
上限に達しました。先頭だけ欲しいなら -head N、全部欲しいなら上限を外す(-limit none。アプリの設定で上限を決めている場合も)。件数が多いときは -out でファイルに書くと端末に流れず速い(-out だけでは上限は外れません) |
| 「メモリが足りません」の案内が出て exit 2 | 当たる行が多すぎます。案内に出る方法(-limit N で件数を決める・-head N で先頭だけ・-out でファイルに書く・検索語を足して絞る)を使ってください |
| 消したファイルの行がまだ出る | 仕様です(9.2)。外したいときは --rebuild |
| 「output already exists」 | 出力先が既にあります。--force か別の名前 |
| 索引の名前から中身が分からない | uvp 索引 --info |
| tar.gz が扱えない | 展開してから uvp 'dir/**' 語 で束ねてください |
| あるはずのファイルが入らない | .gitignore・.ignore で除外されているかもしれません。uvp '…' --files の最後の「除外 N 本」で確かめ、含めるなら --no-ignore(8.4) |
.gitignore に書き足したファイルの行が出なくなった |
仕様です(9.2)。索引には残っているので、--no-ignore を付ければまた出ます |
| 「not text, skipped: …」と出る | 画像などテキストでないファイルを飛ばしました(10章)。探す対象から外れるだけで、エラーではありません |
| Word・Excel・PDF で「読めません」と出て exit 2 | 古い形式(.doc・.xls)・パスワード付き・文字の無い PDF(画像だけ。OCR はしません)・壊れたものは断ります。.doc・.xls は Word・Excel で .docx・.xlsx に保存し直してください(10.2) |
前の版で作った .uwvz で、1 回目が遅い |
索引の形が新しくなったので、作り直しています(4.2)。2 回目からは速くなります |
20. v1.9.0(Full Spectrum)で入った機能
| 機能 | 内容 | 入った版 |
|---|---|---|
| Word・Excel・PDF | .docx .docm .xlsx .xlsm .pdf の中の文字を取り出して索引(隣に report.docx.uwvz)にし、探す・集計する(10.2) |
v1.9.0 |
| 文字コード | Shift-JIS・EUC-JP・UTF-16 を、索引の中では UTF-8 に変えて持つ。2 回目からは UTF-8 のファイルと同じ速さ。-extract は元の文字コードで書き戻す(4.1・12.1) |
v1.9.0 |
| 索引の形(版 4) | 前の版で作った .uwvz は読まず、初めて探す・開くときに作り直す(4.2) |
v1.9.0 |
| 追加の索引 | 行の骨格・ブロックの印を .uwvz の末尾に持ち、2 回目からを速くする。--no-extra・--build-extra・--extra-status(4.3) |
v1.9.0 |
| 2 語目の突き合わせ | 語1 -C N 語2 と -seq は、2 語目を全文で 1 回探して行番号で突き合わせる(出力は同じ) |
v1.9.0 |
波かっこ {a,b} |
ファイルの指定に '**/*.{txt,log}'・'app.log{,.*.gz}' などが書ける。画面の「コマンドライン」も同じ(8.2・8.3) |
v1.9.0 |
| 画面(GUI) | 設定の画面(テーマ・本文のフォント・キーの割り当て)、結果の窓の[ヒット+ブックマーク][ブックマークだけ][ヒットだけ]の切り替え、ステータスバーのファイル名からパスのコピー・フォルダー・ターミナル・アプリで開く、開いているファイルが外で切り詰め・ローテーションされても落ちない(帯で知らせる) | v1.9.0 |
20.1 v1.8.1.9(Finder Scope)で入った機能
| 機能 | 内容 | 入った版 |
|---|---|---|
| 画面の「コマンドライン」 | uvp と同じ書き方(ファイル指定と検索パターン)を画面のダイアログに入れて実行し、結果を本体の窓に出す。ツールバーのボタン・Ctrl+Shift+K(Mac は Cmd+Shift+K) |
v1.8.1.9 |
| GUI で複数ファイルを選んで束ねる | 「コマンドライン」のダイアログで、ファイル指定に複数のファイルを書いて束ねて開く。フォルダーのドロップ・[開く]での複数選択からも束ねられる(15章) | v1.8.1.9 |
21. 性能(参考)
v1.9.0(Full Spectrum)の結果(2026-10-14・Mac。Windows・Linux は動作確認)
Mac で v1.9.0 を測った、いちばん新しい結果です(2026-10-14・Apple M4・メモリ 32GB・外付け USB SSD)。倍率は ripgrep などの秒数 ÷ uvf/uvp の秒数(cold+hot の合計)で、1.5 倍未満は同等です。
Windows・Linux でも同じテスト一式を流し、正常に動くことを確かめました(正しさのテスト:入力の種類 66 件・複数ファイル 34〜36 件・除外 43 件がすべて合格、速さの段の出力も ripgrep と不一致 0)。Windows・Linux の速さは、機械も条件も Mac と違うので参考値として右の 2 列に載せます。
| ripgrep ÷ uvf/uvp(cold+hot の合計) | Mac | Windows(参考) | Linux(参考) |
|---|---|---|---|
| 3GB の 1 本・総合(30〜32 項目) | 2.56 | 2.24 | 1.50 |
| 10GB の 1 本・総合(30 項目) | 2.51 | 3.17 | 1.96 |
無料版 uvf・検索 7 種(3GB/10GB) |
1.08/1.08(同等) | 1.46/1.92 | 1.32/1.06 |
uvp・検索 7 種(3GB/10GB・索引作りを含む) |
3.44/3.55 | 2.48/2.48 | 1.42/2.06 |
uvp・集計と並べ替え(3GB・10GB) |
4.2〜4.9 | 2.0〜3.6 | 1.4〜3.3 |
uvp・Shift-JIS・EUC-JP・UTF-16(3〜6GB・2 回目から) |
5.4〜38.8 | 2.2〜14.1 | 2.0〜15.3 |
uvp・ログの 3 例(Linux カーネル 6 万本) |
2.35〜4.56 | 1.26〜2.48 | 1/2.85〜1/3.21 |
| 出力の突き合わせ | 不一致 0 | 不一致 0 | 不一致 0 |
1 回目(索引の作成込み)は、Shift-JIS・EUC-JP で ripgrep の 1/1.4〜1/1.7 ほどです(Mac で 3 回測った幅)。展開の速い lz4 の 1 回目込みは 1/1.4 です。参考の Windows・Linux では、uvp の 1 回目・zst・lz4・複数のファイルを初めて束ねる測り方で 1.5 倍を超えて負ける値も出ました。
詳しくは v1.9.0「Full Spectrum」の記事。
この章のこの下の数字は、ことわりのない限り前の版で測った値です。
ある1台の Mac で測った例です。ディスク・CPU・データの中身によって変わります。
倍率は「相手(主に ripgrep)の時間 ÷ uvp の時間」です。1 を超えると uvp が速く、1 未満(1/x と表記)は相手が速いことを表します。1つの項目で 1.5倍未満、7項目以上の合計で 1.3倍未満の違いは「同等」と書きます。
cold はキャッシュを捨てた直後、hot は続けて2回目です。uvp の1回目は、索引(.uwvz)を作る時間を含みます(索引を消してから測りました)。2回目はその索引を使います。
測った版・機械・データ・測り方は、この章の「21.7 数字の条件」にまとめています。
21.1 読み方(負けから)
- 複数のファイルを束ねる1回目は、ripgrep・uvf より遅くなります(束ねた索引を書く分)。gz 7本+平文5本の12本で rg 24.62秒・uvp 41.23秒(rg が 1.67倍速い)、gz 5本で rg 1.34秒・uvp 3.04秒(rg が 2.27倍速い)でした。そのかわり2回目は12本で 9.52秒(rg の 2.59倍・uvf の 1.85倍)で、uvf との差は3回で取り返します(21.5)。
- 1本のファイルを1回だけ探すなら、ripgrep と同等です。1回目は索引を作る分、3GB・10GB ではわずかに遅くなります(3GB で rg 3.26秒・uvp 3.43秒=1/1.05、10GB で 10.94秒・11.82秒=1/1.08。50GB は 64.68秒・58.81秒で uvp が 1.10倍)。圧縮ファイルの1回目も、7形式すべてで ripgrep・ugrep と同等でした(21.4)。
- ファイルがキャッシュに載る大きさ(3GB・10GB)の hot は、ほとんどの項目で同等です。rg も2回目はキャッシュから読むためです(素の検索 3GB:rg 0.31秒・uvp 0.29秒)。
- 先頭 N 件だけなら、50GB の hot で ripgrep が速い結果です(
-head 10は rg 0.04秒・uvp 0.06秒で rg が 1.50倍、-limit 1000は rg 0.07秒・uvp 0.12秒で rg が 1.71倍。どれもサブ秒)。 - 同じファイルに2問目を投げると差が開きます。50GB の素の検索の2回目は rg 70.33秒・uvp 6.45秒(10.90倍。rg の2回目は 55〜70秒とぶれ、55.50秒の日でも 8.58倍)。検索7種の cold+hot 合計で 2.39〜3.74倍、段・集計・出力など16項目の合計で 5.15〜7.49倍でした(21.2・21.3)。
- 圧縮ファイルの2回目は、形式によらず 0.11〜0.12秒です(ripgrep の 2.58〜65.75倍。21.4)。
- 1回だけ探すなら、索引を作らない uvf や ripgrep で十分です(uvf のマニュアルの「性能」の章)。uvf は、1本・圧縮7形式・複数ファイルのどれでも ripgrep と同等でした。
- パイプの途中に挟んで1回だけ流す処理は、ripgrep などの CLI が素直です。
21.2 大きい1本のファイル(秒)
素の検索「東京」(rg -n -F 東京 F ⇔ uvf F 東京 ⇔ uvp F 東京)。uvp の cold は索引作成込み、hot は作った索引を使います。
| データ | ヒット | ripgrep cold/hot | uvf cold/hot | uvp cold(索引作成込み)/hot(索引あり) | uvp 倍率 cold/hot |
|---|---|---|---|---|---|
| 3GB | 11,274 | 3.26/0.31 | 3.04/0.29 | 3.43/0.29 | 1/1.05 同等/1.07 同等 |
| 10GB | 11,393 | 10.94/0.97 | 10.15/0.88 | 11.82/1.00 | 1/1.08 同等/1/1.03 同等 |
| 50GB | 94,979 | 64.68/70.33 | 50.66/55.94 | 58.81/6.45 | 1.10 同等/10.90 |
- uvf は3つの大きさとも ripgrep と同等で、cold・hot とも uvf が少し速い側です(cold 1.07/1.08/1.28、hot 1.07/1.10/1.26)。
- 3GB・10GB は hot でファイルがキャッシュに載るので、rg の2回目も速く、uvp とは同等です。50GB はメモリー(32GB)に載りきらないため、rg は2回目も 70.33秒かかり(測るたびに 55〜70秒とぶれます)、索引を使う uvp は 6.45秒でした。
検索7種の合計:素の検索・-i・-E・-E 行頭つき・-E -i・-v・-E -v。uvp は最初の素の検索の cold で索引を作り、残りはその索引を使います。
| データ | ripgrep cold/hot(合計) | uvf cold/hot(合計) | uvp cold/hot(合計) | uvf 倍率(合計) | uvp 倍率(合計) |
|---|---|---|---|---|---|
| 3GB | 26.03/7.60(33.63) | 27.24/6.31(33.55) | 9.63/4.42(14.05) | 1.00 同等 | 2.39 |
| 10GB | 82.83/12.58(95.41) | 71.38/10.61(81.99) | 20.89/8.18(29.07) | 1.16 同等 | 3.28 |
| 50GB | 426.14/444.50(870.64) | 373.08/395.85(768.93) | 145.49/87.49(232.98) | 1.13 同等 | 3.74 |
- uvp の cold だけ・hot だけの倍率は、3GB 2.70/1.72、10GB 3.97/1.54、50GB 2.93/5.08 でした。
- uvf は cold だけ・hot だけで見ても同等です(1/1.05〜1.20)。
21.3 uvp の段・出力など(16項目の合計・秒)
Drill-down(2語・-grep 記法)・集計(-uniq・-sort count・-sort value)・-head/-tail/-limit・必ず含む文字列が無い正規表現・-out(txt・gz)・行番号なし・.uwvz だけで探す・見つからないとき・gz の入力(素・-E)の16項目を、同じ結果になる ripgrep・sed・sort・uniq・gzip などの組み合わせと比べたものです。uvp は 21.2 で作った索引を使った時間(gz の入力は gz から作る索引)なので、ripgrep の検索そのものより何倍速い、という意味ではありません。
| データ | 組み合わせ cold/hot(合計) | uvp cold/hot(合計) | 倍率(合計) |
|---|---|---|---|
| 3GB | 50.73/19.81(70.54) | 8.29/5.30(13.59) | 5.19 |
| 10GB | 155.89/44.12(200.01) | 24.04/14.77(38.81) | 5.15 |
| 50GB | 790.94/799.32(1,590.26) | 122.11/90.25(212.36) | 7.49 |
- 全96項目(21.2 の検索7種を uvf・uvp それぞれで14項目、この16項目、uvf の2項目を、3つの大きさで)の合計は、ripgrep などの 4,168.64秒 に対し uvf/uvp 1,672.55秒(2.49倍)でした。項目ごとの値は 21.6 にあります。
21.4 圧縮7形式(1本・秒)— grep 系との比較
同じ 979MB の OSM XML を7形式で圧縮し、「東京」(1,145行)を探しました。hot(キャッシュが温まった状態)で各2回測った速い方です。標準の grep はその形式用の grep(lz4・br は専用の grep が無いので、展開コマンドを BSD grep へパイプ)、ugrep は ugrep -z -n -F、ripgrep は rg -z -n -F、uvf・uvp は uvf F 東京・uvp F 東京 です。
| 形式 | 大きさ | 標準の grep | ugrep | ripgrep | uvf | uvp 1回目(ripgrep 比) | uvp 2回目(ripgrep 比) |
|---|---|---|---|---|---|---|---|
| gz | 111MB | 0.90(zgrep) | 0.45 | 0.43 | 0.33 | 0.42(1.02 同等) | 0.12(3.58) |
| bz2 | 88MB | 8.03(bzgrep) | 7.62 | 7.89 | 7.43 | 7.64(1.03 同等) | 0.12(65.75) |
| xz | 56MB | 4.01(xzgrep) | 3.64 | 4.21 | 3.37 | 3.44(1.22 同等) | 0.11(38.27) |
| lzma | 56MB | 3.21(xzgrep) | 2.83 | 3.40 | 2.57 | 2.64(1.29 同等) | 0.12(28.33) |
| zst | 122MB | 0.63(zstdgrep) | 0.65 | 0.54 | 0.50 | 0.57(1/1.06 同等) | 0.12(4.50) |
| lz4 | 186MB | 0.65(lz4 -dc|grep) | 0.33 | 0.31 | 0.28 | 0.35(1/1.13 同等) | 0.12(2.58) |
| br | 106MB | 1.33(brotli -dc|grep) | 0.91 | 0.87 | 0.74 | 0.85(1.02 同等) | 0.12(7.25) |
- uvp の1回目は、7形式すべてで ripgrep・ugrep と同等です(ripgrep 比 1/1.13〜1.29)。1回だけ探すなら uvf が7形式すべてで最短ですが、ugrep・ripgrep との差は 1.03〜1.36倍で同等です。
- uvp の2回目は形式によらず 0.11〜0.12秒です。索引は uvp 自身の形式なので、元の圧縮形式の重さが消えます(ripgrep の 2.58〜65.75倍、uvf の 2.33〜61.92倍)。
- 標準の grep に対しては、uvp の1回目でも gz 2.14倍・lz4 1.86倍・br 1.56倍でした(ほかの形式は同等)。
- ag(The Silver Searcher)は
-zを付けても4形式を展開できず、展開後 2GB を超えるファイルで落ちるため、比べていません。
21.5 複数のファイル(秒)
uvp 'a.gz,b.gz,…' 東京 のように指定し、ほかの道具にも同じファイルを渡しました。21.4 と同じく hot・各2回の速い方です。uvp の1回目は束ねた索引を作る時間を含みます。
| 対象 | ヒットした行 | zgrep | ugrep | ripgrep | uvf | uvp 1回目(束ねる) | uvp 2回目 |
|---|---|---|---|---|---|---|---|
| gz 5本(展開後 約7.4GB) | 16,069 | 9.43 | 2.56 | 1.34 | 1.04 | 3.04 | 0.73 |
| gz 7本+平文5本=12本(展開後 約60GB) | 127,886 | 89.35 | 25.38 | 24.62 | 17.60 | 41.23 | 9.52 |
- uvp の1回目は、ripgrep・uvf より遅くなります(束ねた索引を書く分)。ripgrep に対して gz 5本で 1/2.27、12本で 1/1.67 です。ugrep に対しては 5本で同等(1/1.19)、12本で 1/1.62 でした。zgrep よりは速い結果です(3.10倍・2.17倍)。
- 2回目は束ねた索引を使うので、12本で 9.52秒です。ripgrep の 2.59倍、uvf の 1.85倍です。1回目に uvf より余分にかかる約24秒は、2回目以降1回につき約8秒ずつ縮むので、3回で取り返します。
- uvf は ripgrep と同等です(1.29倍・1.40倍)。zgrep に対しては 9.07倍・5.08倍でした。
- cold(キャッシュを捨てた直後)の12本は、uvf 21.35秒・ugrep 26.85秒(同等)でした。
- 平文だけを束ねた場合は、ripgrep と同等でした(平文5本・cold+hot の合計:rg 5.56秒・uvp 6.64秒=1/1.19)。
- cold+hot で測り直した12本(2026年10月4日・1.7.3.6.9)では、uvp の1回目が 42.45秒・rg が 28.19秒(1/1.51)、1回目と2回目の合計では 52.19秒・50.16秒(1/1.04・同等)でした。uvf は合計 38.80秒で rg の 1.29倍です。
21.6 項目別の実測(cold/hot・秒)
21.2・21.3 の項目を1つずつ載せます。各欄は「相手 cold/hot・uvp cold/hot(倍率 cold/hot)」です。uvp は、素の検索の cold だけが索引作成込みで、ほかは索引がある状態です。
データは OpenStreetMap 日本(XML)の 3,032,812,644 / 10,255,315,281 / 51,254,526,392 バイトです。出力は、突き合わせた84項目すべてで rg / sed と一致しました(不一致 0)。
検索
| ヒット(50GB) | 3GB | 10GB | 50GB | |
|---|---|---|---|---|
固定文字列 東京 |
94,979 | rg 3.26/0.31・uvp 3.43/0.29(同等/同等) | rg 10.94/0.97・uvp 11.82/1.00(同等/同等) | rg 64.68/70.33・uvp 58.81/6.45(同等/10.90倍) |
大小無視 -i(HIGHWAY) |
11,693,479 | rg 3.30/0.60・uvp 0.57/0.47(5.79倍/同等) | rg 11.02/1.66・uvp 1.35/1.06(8.16倍/1.57倍) | rg 63.71/62.51・uvp 15.41/14.46(4.13倍/4.32倍) |
正規表現 -E(k="highway[^"]*") |
11,529,957 | rg 3.32/0.50・uvp 0.54/0.45(6.15倍/同等) | rg 10.95/1.03・uvp 1.34/1.00(8.17倍/同等) | rg 55.88/56.88・uvp 15.04/14.05(3.72倍/4.05倍) |
行頭つき ^ *<tag k="name" |
3,337,643 | rg 3.28/0.45・uvp 0.44/0.32(7.45倍/同等) | rg 15.76/1.05・uvp 1.35/1.01(11.67倍/同等) | rg 56.06/56.15・uvp 6.97/5.61(8.04倍/10.01倍) |
-E -i(K="NAME[^"]*") |
6,857,377 | rg 3.31/0.56・uvp 0.53/0.42(6.25倍/同等) | rg 11.05/1.73・uvp 1.48/1.20(7.47倍/同等) | rg 55.51/72.02・uvp 7.84/6.55(7.08倍/11.00倍) |
当てはまらない行 -v(=") |
48,984,614 | rg 3.49/2.08・uvp 1.83/1.44(1.91倍/同等) | rg 11.99/2.60・uvp 1.50/1.23(7.99倍/2.11倍) | rg 56.66/68.87・uvp 28.69/28.22(1.97倍/2.44倍) |
-E -v(^ +<) |
3 | rg 6.07/3.10・uvp 2.29/1.03(2.65倍/3.01倍) | rg 11.12/3.54・uvp 2.05/1.68(5.42倍/2.11倍) | rg 73.64/57.74・uvp 12.73/12.15(5.78倍/4.75倍) |
必ず含む文字列が無い式([0-9]{3}-[0-9]{4}") |
224,915 | rg 3.37/2.34・uvp 1.41/0.98(2.39倍/2.39倍) | rg 14.19/13.56・uvp 2.16/1.75(6.57倍/7.75倍) | rg 67.52/74.05・uvp 13.28/12.12(5.08倍/6.11倍) |
- 3GB・10GB の hot はファイルがキャッシュに載るため、ほとんど同等です(差が出たのは 3GB の
-E -v、10GB の-i・-v・-E -v、両方の「必ず含む文字列が無い式」)。 - cold では、索引がある uvp が 3GB・10GB で 1.91〜11.67倍でした(索引作成込みの素の検索を除く)。
- 50GB では hot でも 2.44〜11.00倍です。出る行が1,000万を超える
-i・-E・-vで倍率が下がります(uvp はヒットを保持するため)。正規表現の速さは式の形ではなくヒット件数で決まります(50GB の hot:行頭つき 334万件 5.61秒、固定文字列 9.5万件 6.45秒)。rg の 50GB の hot は、測るたびに 55〜70秒とぶれます(この回の固定文字列は 70.33秒)。
絞り込み・集計・流れ
| 項目 | 3GB | 10GB | 50GB |
|---|---|---|---|
2語の絞り込み(rg \| rg ⇔ uvp F 語1 語2) |
rg 3.29/0.43・uvp 0.42/0.31(7.83倍/同等) | rg 18.22/1.01・uvp 3.25/0.95(5.61倍/同等) | rg 56.63/54.94・uvp 6.57/5.26(8.62倍/10.44倍) |
同じ・-grep 記法(uvp F 語1 -grep 語2) |
rg 3.23/0.46・uvp 0.51/0.31(6.33倍/同等) | rg 10.93/1.02・uvp 1.29/0.95(8.47倍/同等) | rg 55.80/54.95・uvp 6.59/5.26(8.47倍/10.45倍) |
集計 上位20(rg -o \| sort \| uniq -c \| sort \| head ⇔ -uniq) |
rg 3.29/0.41・uvp 0.49/0.38(6.71倍/同等) | rg 10.92/0.90・uvp 1.43/1.07(7.64倍/同等) | rg 54.68/54.81・uvp 7.34/6.04(7.45倍/9.07倍) |
集計 件数順(-sort count) |
rg 3.28/0.41・uvp 0.48/0.37(6.83倍/同等) | rg 10.90/0.91・uvp 1.41/1.09(7.73倍/同等) | rg 61.85/55.72・uvp 7.38/6.03(8.38倍/9.24倍) |
集計 値順(-sort value) |
rg 3.28/0.41・uvp 0.50/0.38(6.56倍/同等) | rg 10.93/0.90・uvp 1.40/1.07(7.81倍/同等) | rg 54.81/66.94・uvp 7.38/6.01(7.43倍/11.14倍) |
前後3行に2語目(-C 3) |
uvp 0.90/0.79 | uvp 3.07/2.79 | uvp 17.47/16.66 |
流れ -seq |
uvp 0.68/0.59 | uvp 2.29/1.95 | uvp 12.43/11.53 |
- 10GB の hot の集計は rg が 1.19〜1.20倍速く、同等の範囲です(rg がキャッシュから読むため)。
- 前後3行・流れは ripgrep などに同じ働きのものが無いので、uvp の値だけを載せています。
- 2段目以降は前段の結果だけを見るので、50GB でも1段 0.24秒でした(条件は 21.7)。
先頭・末尾と -limit(「東京」)
| 項目 | 3GB | 10GB | 50GB |
|---|---|---|---|
rg \| head -10 ⇔ -head 10 |
rg 0.37/0.06・uvp 0.10/0.04(3.70倍/1.50倍) | rg 0.49/0.07・uvp 0.09/0.05(5.44倍/同等) | rg 0.17/0.04・uvp 0.13/0.06(同等/rg が 1.50倍) |
rg \| tail -10 ⇔ -tail 10 |
rg 3.26/0.31・uvp 0.39/0.28(8.36倍/同等) | rg 10.93/0.97・uvp 1.28/0.94(8.54倍/同等) | rg 54.84/54.76・uvp 6.45/5.11(8.50倍/10.72倍) |
rg \| head -1000 ⇔ -limit 1000 |
rg 0.76/0.09・uvp 0.14/0.08(5.43倍/同等) | rg 2.04/0.20・uvp 0.29/0.19(7.03倍/同等) | rg 0.54/0.07・uvp 0.20/0.12(2.70倍/rg が 1.71倍) |
| 50GB・「東京」(94,979件)・hot | uvp | ripgrep | 備考 |
|---|---|---|---|
-head 10 |
0.06秒 | rg \| head -10 0.04秒(rg が 1.50倍) |
先頭から10件見つけた時点で止まる |
-limit 1000 |
0.12秒 | rg \| head -1000 0.07秒(rg が 1.71倍) |
1000件たまった時点で止まる(どの1000件かは決まらない・exit 2) |
| 既定(無制限・全件) | 6.45秒 | 70.33秒(10.90倍) |
- 50GB の hot の
-head 10・-limit 1000は rg の勝ちです(どちらもサブ秒)。rg | headは N 件で打ち切れるうえ、uvp には起動と索引読み込みの固定費が乗ります。cold では uvp が速い(-head 101.31倍・-limit 10002.70倍)ので、1回目と2回目の合計では uvp が速い側です。 tailやsort | headは全件が要るので、大きいファイルでは uvp が速くなります(50GB の-tail 10:hot で 10.72倍)。
出力と保管
| 項目 | 3GB | 10GB | 50GB |
|---|---|---|---|
テキスト(rg -n > file ⇔ -out hits.txt) |
rg 3.26/0.31・uvp 0.41/0.29(7.95倍/同等) | rg 10.93/0.98・uvp 1.29/0.95(8.47倍/同等) | rg 55.55/55.30・uvp 6.43/5.12(8.64倍/10.80倍) |
圧縮(rg \| gzip > out.gz ⇔ -out out.txt.gz) |
rg 3.26/0.31・uvp 0.39/0.29(8.36倍/同等) | rg 10.92/0.97・uvp 1.28/1.00(8.53倍/同等) | rg 55.52/69.22・uvp 6.47/5.07(8.58倍/13.65倍) |
行番号なし(sed -n '/語/p' ⇔ --no-line-number) |
sed 11.11/11.37・uvp 0.40/0.30(27.77倍/37.90倍) | sed 12.94/12.07・uvp 1.29/0.94(10.03倍/12.84倍) | sed 109.64/103.77・uvp 6.49/5.19(16.89倍/19.99倍) |
.uwvz だけで探す(rg は元ファイルを走査) |
rg 3.26/0.31・uvp 0.41/0.28(7.95倍/同等) | rg 11.84/0.98・uvp 1.29/0.93(9.18倍/同等) | rg 56.12/55.27・uvp 6.41/4.92(8.76倍/11.23倍) |
| 見つからない(exit 1) | rg 3.27/0.31・uvp 0.39/0.29(8.38倍/同等) | rg 10.90/0.98・uvp 1.29/0.94(8.45倍/同等) | rg 62.37/55.61・uvp 6.37/4.89(9.79倍/11.37倍) |
-outは 3GB でも、cold と hot の2回計で 5.10〜5.25倍でした。sedは1行ずつ処理するので、3GB でも 11秒かかります。.uwvzだけで探す値は、元ファイルを見ずに索引だけで探した時間です(12.3)。
gz の入力
| 項目 | 3GB | 10GB | 50GB |
|---|---|---|---|
gz を直接(rg -z ⇔ uvp F.gz 東京) |
rg 1.16/1.15・uvp 1.32/0.28(同等/4.11倍) | rg 4.37/4.30・uvp 3.67/0.95(同等/4.53倍) | rg 21.97/21.73・uvp 19.64/5.12(同等/4.24倍) |
gz を -E で(k="highway[^"]*") |
rg 1.28/1.13・uvp 0.53/0.44(2.42倍/2.57倍) | rg 4.44/4.30・uvp 1.33/1.00(3.34倍/4.30倍) | rg 22.93/22.14・uvp 14.98/13.93(1.53倍/1.59倍) |
.gzを直接指定すると、初回に.gz.uwvzを作って2回目から使います(50GB:uvp cold 19.64秒・hot 5.12秒、rg -zは 21.97秒・21.73秒)。3GB の cold は rg が 1.14倍速い(同等)。- 出る行が多い式(
-E・1,153万件)では、50GB で差が小さくなります(cold 1.53倍・hot 1.59倍)。
21.7 数字の条件
- 共通:Mac(Apple M4・10コア・メモリ 32GB)・外付け USB SSD、ripgrep 15.2.0。データは OSM(日本)の XML、検索語は主に「東京」。結果はすべて ripgrep(または sed・sort・uniq などの組み合わせ、21.4・21.5 は uvf)と一致することを確かめました(不一致 0)。
- 21.2・21.3・21.6(1本の大きいファイル)と、冒頭の「効く場面・効かない場面」・1章・12.3 の該当する値:uvf/uvp 1.7.3.6.9(2026年10月4日)、BSD sed。毎回 sync → キャッシュ破棄(purge)→ 10秒待つ → cold → 続けて hot。uvp は素の検索の cold の前に索引を消し、それ以外は索引がある状態で測りました。時間はコマンドの開始から終了まで。
- 21.4・21.5(圧縮7形式・複数ファイル)と、冒頭の該当する値:uvf 1.7.3.4(検索の処理は 1.7.3.6 と同じ)/uvp 1.7.3.5(検索の処理は 1.7.3.6 と同じ)、ugrep 7.8.5、2026年9月28日。標準の grep は macOS の zgrep・bzgrep(BSD grep 2.6.0)/xzgrep(XZ Utils 5.8.4)/zstdgrep(zstd 1.5.7)、lz4(1.10.0)・brotli(1.2.0)は展開して BSD grep へパイプ。hot で各2回測り、速い方を載せました。uvp の1回目は索引を消してから、2回目は続けて。12本の cold(uvf・ugrep)は、
sudo purgeのあとに別に測った値です。 - 21.5 の平文5本と、cold+hot の12本:uvf/uvp 1.7.3.6.9(2026年10月4日)、cold と hot の合計。
- 21.6 の「1段 0.24秒」:uvp 1.6.6 “First Light”(2026年9月20日)。
- 13章の置換:uvp 1.6.2(2026年9月16日)。
- 12.3:gzip との比較は 2026年9月24日、
-extractは v1.6.2。 - 10章の pbf:オーナーの実測(2026年9月28日・uvp 1.7.3.5。変換と検索の処理は 1.7.3.6 と同じ)。
- 15章:写真と「4.45秒」は、ボタンがアイコンになる前の版の画面です。
21.8 違う結果になったら
環境によって数字は変わります。違う結果になった方は お問い合わせ から教えてください。確認のうえ、このページを直します。
関連
- UwView Pro(製品ページ・価格)/ ダウンロード(14日間の無料試用キーもこちら)
- UwView Pro 操作ガイド(GUI のマニュアル)
- 実測まとめ(1回目・cold を含む値)
- uvp コマンドを付けました — ripgrep と同じ答えを、10GBで7倍速く。3GBも、冷えていれば勝ちます(索引を作る1回目を含めた比較の記事)
- CLIコマンド → UwView Pro 対応表(GUI 側の対応)
- 無料版:uvf コマンド操作マニュアル・UwView 操作ガイド・v1.9.0 リリースノート(GitHub)