jq に渡せません。
検索結果を cut -d: でファイル名と行番号に割ろうとして、C:/logs/app.log のコロンで割れました。Windows のパスです。ならば最初から JSON で出せばいい——と思ったところで、次の問いが出ます。
機械に渡す出力は、相手(ripgrep)と同じ形にするべきなのでしょうか。
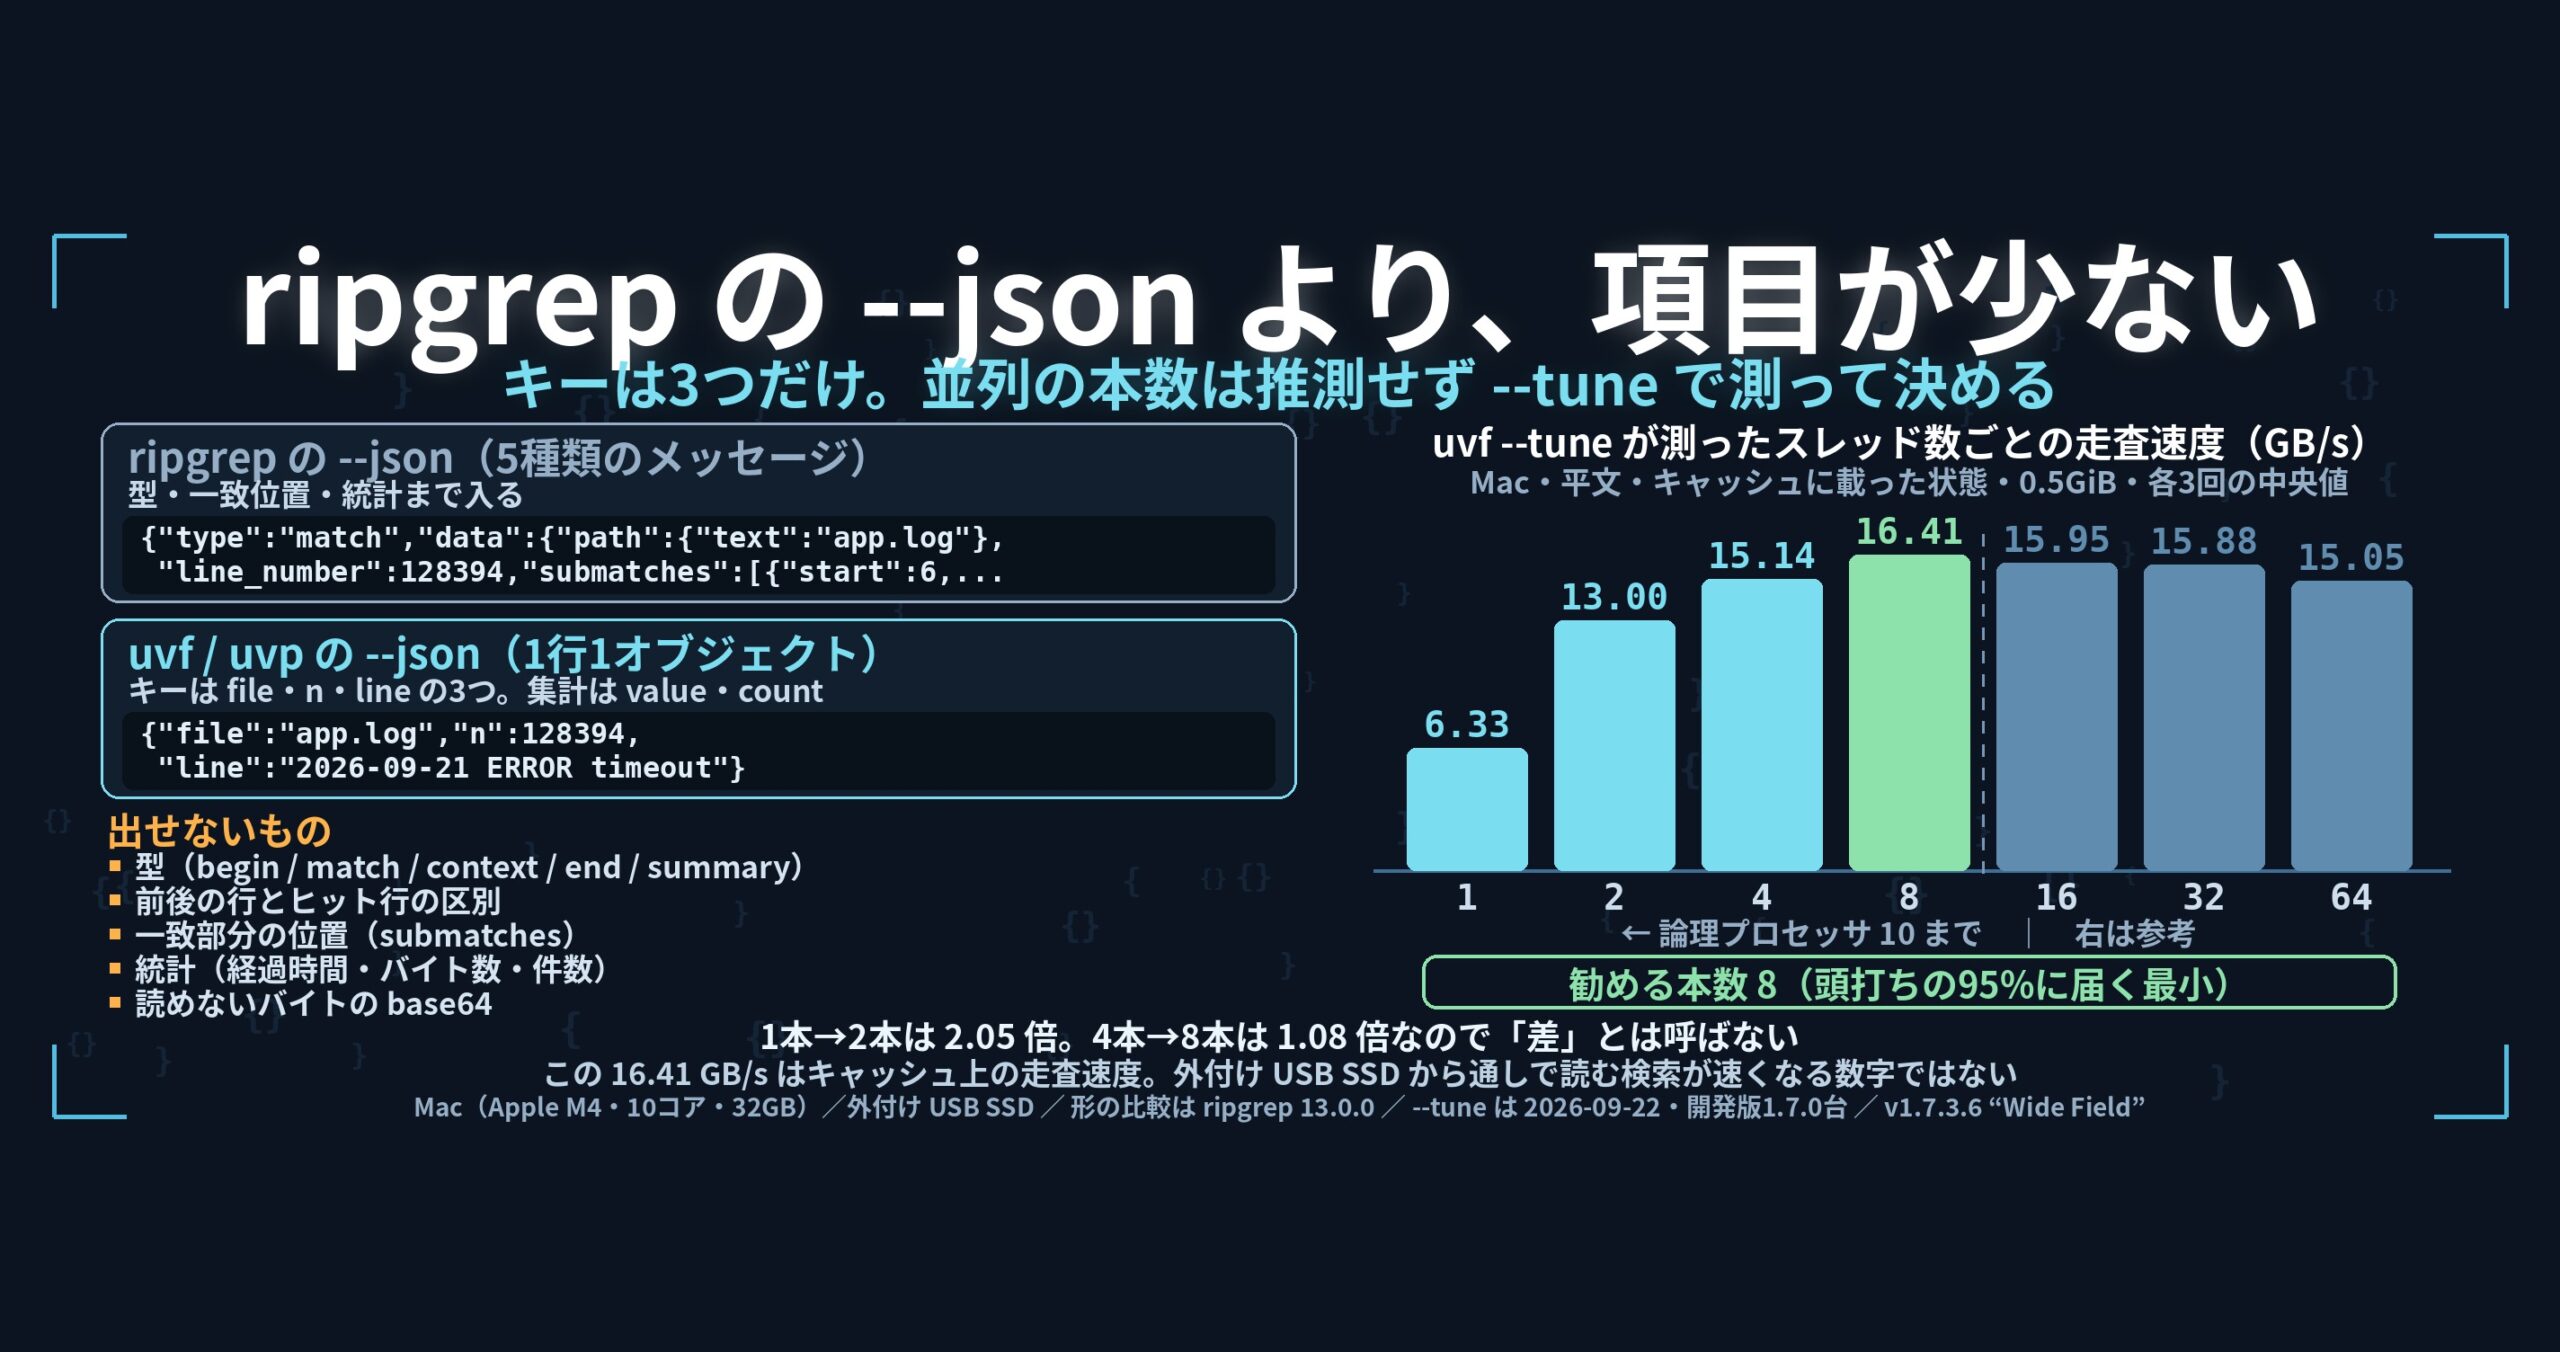
- 先に結論: --json は1行1オブジェクトの JSON Lines。キーは file・n・line の3つだけで、ripgrep の --json より出せる項目は少ない(型・一致位置・統計を出しません)。並列の本数は --tune が実測して勧めます(Mac で1本 6.33 → 8本 16.41 GB/s・勧める本数 8)
- 先に、負けているところを書きます
- なぜ3つのキーしか出さないのか
- 「テキスト出力と同じ中身」をテストで縛る
- cut -d: ではなく --json | jq -r .file
- --tune — 何本が良いかは、機械ごとに測って決める
- 数字 — Mac で測った表(予測は外れました)
- uvp --tune は .uwvz を測ります
- 確かめ方
- 持ち帰れる一般論
- 正直に書いておくこと
- 使っている道具
- リンク
先に結論: --json は1行1オブジェクトの JSON Lines。キーは file・n・line の3つだけで、ripgrep の --json より出せる項目は少ない(型・一致位置・統計を出しません)。並列の本数は --tune が実測して勧めます(Mac で1本 6.33 → 8本 16.41 GB/s・勧める本数 8)
形をそろえたのは「1行に1つのオブジェクト」というところだけで、中身は意図的に削っています。--tune のほうは「この機械は何本が良いか」を3回ずつ測って表で出し、--apply で設定に保存します。どちらも無料版の uvf から使えます。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。--jsonと--tuneは Wide Field の段階1〜2で入れました。この記事の--tuneの数字は 2026年9月22日に開発版(1.7.0 台)で測ったもので、v1.7.3.6 で測り直した値は持っていません(同じ値になるとは書きません)。なお配布中の最新版は v1.7.3.6.9(Wide Field の系列・2026年10月4日)です。
先に、負けているところを書きます
出せる項目の数では ripgrep の --json に負けています。 具体的に、こちらが出さないものを数え上げます。
- メッセージの型が無い。 ripgrep は
begin・match・context・end・summaryの5種類をtype付きで流します。こちらはヒット行のオブジェクトだけです。 - 前後の行(
-C)とヒット行を見分けられない。 ripgrep は"type":"context"で区別します。こちらは区切りの--を混ぜない代わりに、どちらなのかを示す印も付けていません。ここは素直に劣っています。 - 統計が出ない。 ripgrep の
--jsonは--statsを含み、summaryに経過時間・探したバイト数・ヒット件数が入ります。こちらが返すのは終了コードと stderr の知らせだけです。 - 一致した位置が出ない。 ripgrep は
submatchesに一致部分の開始・終了バイト位置を入れます。こちらは行の本文を丸ごと渡すだけです。 - 読めないバイトを base64 にする仕組みが無い。 ripgrep は正しい UTF-8 でない部分を
{"bytes":"<base64>"}にします。こちらは一度テキストに直してから書くので、読めないバイトは置換文字になります。バイト列をそのまま運ぶ用途には向きません。 -openと併用できません(--jsonは画面ではなく標準出力の形なので、エラーで止めます)。--csvとの同時指定もエラーです。--tuneの数字は、検索が速くなる約束ではありません。 測っているのはキャッシュに載った状態の走査速度です。詳しくは後述します。- 既定のスレッド数は 8 のまま変えていません。 実測が3台そろうまで動かさない、という決めごとのままです。
なぜ3つのキーしか出さないのか
流せなくなるのが怖かった、というのが第一の理由です。
配列で包むと、最後の ] を書くまで1文字も出せません。50GB のファイルから35万件出るような検索で、全部貯まるまで待つ形にはできない。だから1行に1つのオブジェクトを書いて、見つけた順に流します。JSON Lines を選んだのはそれだけの理由です。
キー名を短く固定したのは、その先の話です。
{"file":"logs/app.log","n":128394,"line":"2026-09-21 ERROR timeout"}
{"n":128394,"line":"2026-09-21 ERROR timeout"}
上が複数ファイルのとき、下が1本だけのときです。1本のときは file を省きます——テキスト出力でも、1本ならファイル名を付けないので、それに合わせました。集計(-uniq)だけ別の形で、{"value":"503","count":1298} になります。順序検索(-seq)は {"lines":[…]} です。
キーが path ではなく file、line_number ではなく n なのは、35万行ぶん掛かるからです。1行あたり十数バイトの差でも、出力の大きさとしては効きます。読みやすさを捨てた判断で、ここは好みが分かれるところだと思っています。
もう一つ、日本語をエスケープしません。 東京 を \u6771\u4eac にしない、という意味です。端末にもファイルにもそのまま流れるので、\u に逃がす理由がありません。実装は JsonSerializer ではなく JsonEncodedText の逃がしだけを使っています——JsonSerializer は型をリフレクションで調べるので、NativeAOT でビルドした uvf では動かないのです。文字列の逃がしだけなら、どのビルドでも同じ結果になります。
「テキスト出力と同じ中身」をテストで縛る
形を2つ持つと、片方だけ直して食い違う事故が起きます。そこでテキスト出力と --json が同じ中身になることを、テストのほうで縛りました。
--jsonの各行を読んで行番号 + TAB + 本文に組み直すと、テキスト出力と1バイト違わず一致する。素の検索・-i・-E・-vの4通りで確認します。- 出力は必ず
{で始まり}で終わり、[を含まない(配列に包んでいないことの確認)。 -uniqのときはvalueが空でなくcountが 1 以上。-C(前後の行)のとき、テキスト出力で入る区切り行--が混ざらない。- 日本語を含むログで
\uが出力に現れない。
「同じ中身になる」をテストで書けるなら、仕様書に書くより強い。どちらかを直したときに、もう片方が落ちてくれます。
cut -d: ではなく --json | jq -r .file
冒頭のコロンの話に戻ります。
マニュアルには、複数ファイルの結果からファイル名だけ取り出す方法として cut -d: -f1 を書いていました。これが外部レビューで指摘されました。 Windows のドライブレターや logs.zip!app.log のようなエントリ名を含むパスでは、コロンで割れてしまう。
直し方は、案内の順番を入れ替えるだけでした。
# 第一の方法(パスにコロンが入っていても壊れない)
uvp 'logs/**/*.log' ERROR --json | jq -r .file | sort -u

# cut はコロンを含まないパス向けの簡易な方法、と書き直した
uvp 'logs/**/*.log' ERROR | cut -d: -f1 | sort -u
--json を入れた目的の半分は、この種の「出力を自分で割らせない」ための逃げ道です。人が読む形と機械が読む形を同じにしようとすると、どちらかが壊れます。
--tune — 何本が良いかは、機械ごとに測って決める
もう一つの機能です。これまで並列検索は8本固定でした。32コア級の機械では使い切れず、かといって既定を上げると、メモリの少ない機械で遅くなる事故が起きます。
そこで設定の口(環境変数 UVF_MAX_THREADS / UVP_MAX_THREADS、設定ファイルの MaxThreads、優先順は環境変数 > 設定ファイル > 既定)と、実測して勧める --tune を同時に作りました。片方だけでは意味を持たないからです——設定口だけ出すと根拠のない数字を打たせることになり、--tune だけでは保存先が無い。
測り方の決めごとは、こうなっています。
| 項目 | 決め | 理由 |
|---|---|---|
| 状態 | キャッシュに載った状態だけ | 本数が効くのは CPU 側。載っていなければ媒体で止まるので何本でも同じ |
| 権限 | 管理者権限を要求しない | キャッシュ破棄を求めた時点で、大半の人は走らせない |
| 反復 | 各設定3回・ばらつきを併記 | 1回だと、利用者がノイズに合わせて設定してしまう |
| 測る量 | 先頭 4GiB まで。空きメモリの半分に収まるよう縮める | 載らない量を測ると「本数は効かない」という誤った結論になる |
| 試す本数 | 1・2・4・… 論理プロセッサ数、+その先を4段(上限64) | 2点だけだと、平らなのか測れていないのか分からない |
| 媒体の速さ | こちらが何も読む前に1回測って併記 | CPU 側と媒体側のどちらで止まっているかを示さないと、推奨の根拠が伝わらない |
| 勧める本数 | 頭打ちの値の 95% に届くいちばん少ない本数 | 伸びない区間に本数を使わせない |
| 差が小さいとき | 1本で8割出るなら「どれでも同じです」と言い切る | 単項目 1.5 倍未満を差と呼ばない、という基準と同じ姿勢 |
| 保存 | --apply で設定に書く |
表を読んで画面に打ち込む手順を挟むと、やらない人が出る |
--tune が平らな結果になったときは、媒体の速さと並べて「止まっているのは CPU・メモリの側か、媒体か」まで書きます。ここを言わずに「この機械は1本で十分」とだけ出すと、本当は本数が効く場面を取り逃がします。
数字 — Mac で測った表(予測は外れました)
--tune が実際に出した値です。平文の走査・キャッシュに載った状態・各3回の中央値で、対象は 0.5 GiB です。
| スレッド | 速度 | 備考 |
|---|---|---|
| 1 | 6.33 GB/s | |
| 2 | 13.00 GB/s | 1本の 2.05 倍 |
| 4 | 15.14 GB/s | |
| 8 | 16.41 GB/s | ← 勧める本数 |
| 16 | 15.95 GB/s | ここから先は論理プロセッサ数(10)超え・参考 |
| 32 | 15.88 GB/s | |
| 64 | 15.05 GB/s |
読み方を2つ付けます。1本→2本の 2.05 倍は「差」と呼べます(単項目で 1.5 倍以上)。一方、4本→8本の 1.08 倍は差と呼びません。8本を勧めているのは「頭打ちの値の 95% に届くいちばん少ない本数」という規則の結果であって、4本より速いと主張しているわけではありません。16本以降が下がっているのも、平らの範囲として読んでいます。
予測は 5.4 GB/s でした
作る前に、3台ぶんの予測を仕様書に書いていました。Mac は8本で約 5.4 GB/s、推奨は 8〜10 だろう、と。
推奨の本数は当たりましたが、速度は3倍ほど外れました(予測 5.4 に対し実測 16.41 GB/s)。1スレッドあたり 650〜800 MB/s という目安も外れています(実測は1本で 6.33 GB/s)。おそらく予測のほうが .uwvz を読む経路——zstd の展開を含む数字——を見ていたのだと思います。平文の走査は「見つからない語を最後まで探す」だけなので、ほぼメモリ帯域の仕事になり、1バイトあたりの手間がまったく違います。
外れた予測表は消さずに残しました。消すと、次に予測を書くときに同じ間違いをします。
この 16.41 GB/s は、検索が速くなる数字ではありません
ここが、読者がいちばん疑うところだと思います。16.41 GB/s で 50GB を探せば3秒——そうはなりません。
--tune が測っているのは、キャッシュに載った 0.5 GiB を何本で走査できるかです。実際の検索は、外付け USB SSD から通しで読むところが先に頭打ちになります。CPU 側にどれだけ余裕があっても、媒体から出てこない分は速くなりません。同じ機械で媒体側を測った話は、First Light の第10回(mmap と pread)・第11回(改行を数える速さと媒体の速さ)に書きました。
だから --tune の表には媒体の速さも並べて出していますし、平らなときは「止まっているのはどちら側か」を文字で書きます。測る道具は、測った条件まで一緒に出さないと害になるという判断です。
uvp --tune は .uwvz を測ります
同じ --tune でも、uvp は本番と同じ経路を測ります。対象のファイルに使える .uwvz(uvp 用の圧縮形式+索引)があれば、それを読んで(zstd で展開しながら)探す時間を測り、.uwvz が無ければ平文の走査に落とします。
経路が違えば1バイトあたりの手間が違い、勧める本数も変わります。表示にも「測った処理: .uwvz の検索(本番と同じ)」と出ます。媒体で頭打ちかの判断に使う比率も、.uwvz は元の1割強しか読まないぶんを掛けてそろえています。
uvp --tune の秒数は、この記事には載せません。手元に突き合わせ済みの Mac の実測値が無いためです。
確かめ方
--tuneの数字: Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD。平文の走査・キャッシュに載った状態・各3回の中央値・対象 0.5 GiB。2026年9月22日・開発版(1.7.0 台)での計測- JSON の形の比較: ripgrep に
--jsonを付けて実際に出力させて確かめました(手元の ripgrep 13.0.0)。begin/match/end/summaryとsubmatchesの形はそのときの実物です - こちら側のテスト:
--jsonの中身がテキスト出力と一致すること、配列に包まないこと、-uniq・-C・日本語の扱いを単体テストで固定しています - この記事に速さの比較はありません。
--jsonと--tuneのどちらも、ripgrep との秒数の比較は持っていません - 版は
uvf・uvpとも v1.7.3.6 “Wide Field”。ただし上に書いたとおり--tuneの表は開発版での値です
持ち帰れる一般論
(1)機械に渡す出力は、人に見せる出力と別の設計にする。 cut -d: が壊れたのは、人が読む1行を機械に割らせたからです。区切り文字でデータを運ぶのをやめるのがいちばん確実な直し方でした。
(2)「相手と同じにする」より「出せないものを数え上げる」。 除外の規則(第7回)では ripgrep と答えを一致させることが正解でしたが、JSON では違いました。相手の形は相手の機能に合わせて作られていて、こちらが持っていない情報まで入っています。全部同じだと言い張るより、足りない5項目を並べたほうが信用されます。
(3)測る道具は、測った条件まで出さないと害になる。 16.41 GB/s という数字だけを見せると、検索がその速さで走ると読まれます。--tune が媒体の速さを併記し、平らな理由まで文字で書くのは、そのためです。
(4)外れた予測を消さない。 5.4 GB/s という予測は3倍外れました。残しておくと、次に予測を書くときに「どの経路の数字を見ているか」を確かめる癖がつきます。
(5)設定の口と、根拠を出す道具は、同時に出す。 スレッド数を設定できるようにしただけでは、利用者は何を入れればいいか分かりません。逆に測るだけでは保存先が無い。片方だけでは機能として成立しない組み合わせがあります。
正直に書いておくこと
--tuneの数字は 2026年9月22日・開発版(1.7.0 台)の値です。v1.7.3.6 で測り直していないので、「公開版と同じ」とは書きません--jsonの項目数は ripgrep に劣ります。型・前後の行の区別・一致位置・統計・バイト列の base64——どれも出しませんuvp --tune(.uwvzの経路)の秒数は持っていません。設計の説明だけです- この記事に ripgrep との速さの比較はありません。
--jsonを付けたときの出力の速さも測っていません - 既定のスレッド数は 8 のままです。3台の実測がそろうまで動かさない、という決めごとを守っています
- Windows・Linux の結果は持ち込んでいません。この連載の数字は Mac で測ったものだけにしています
--tuneの推奨は論理プロセッサ数までしか出しません。その先の段は「本当に頭打ちか」を見せるための参考値です- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと7つの圧縮形式を、外部のコマンドなしで1回で探せます。
uvp ならこう書く
# 1行に1つの JSON で出す(無料版でも使える)
uvf 'logs/**/*.log' ERROR --json

# ファイル名だけ取り出す(パスにコロンが入っていても壊れない)
uvp 'logs/**/*.log' ERROR --json | jq -r .file | sort -u

# 集計を JSON で出す({"value":…,"count":…})
uvp app.log ERROR -uniq 'code=(\d+)' --json

# 行番号を付けない(uvp)
uvp app.log ERROR --json --no-line-number

# この機械に合うスレッド数を測る(表を出すだけ)
uvf --tune app.log

# 測って、そのまま設定に保存する
uvp --tune app.log --apply

# 1回だけ本数を指定して走らせる
UVP_MAX_THREADS=4 uvp 'logs/**/*.log' ERROR
--json は -open とも --csv とも併用できません。終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- ripgrep と同じ除外規則にそろえた(答えを一致させた回): https://uvp.y42u.net/blog/uwview-wf07-ignore-rules/
*・**・カンマ — ファイルの指定と引用符を必須にした理由: https://uvp.y42u.net/blog/uwview-wf08-file-globs/- ripgrep と正規表現の書き方はどこまで同じか: https://uvp.y42u.net/blog/uwview-wf09-regex-vs-ripgrep/
- 探した結果を入力と同じ形式で書き出す: https://uvp.y42u.net/blog/uwview-wf10-output-same-format/
- mmap は順次読みで帯域の6割しか出ない: https://uvp.y42u.net/blog/uwview-fl10-mmap-vs-pread/
- 改行を数える速さと媒体の速さ: https://uvp.y42u.net/blog/uwview-fl11-newline-vs-media/
- 測って分かった「差」の下限(1.5 倍未満を差と呼ばない理由): https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- 集計(
-uniq)で件数を数える: https://uvp.y42u.net/blog/uvp-tally-uniq-c-drilldown/ - 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。