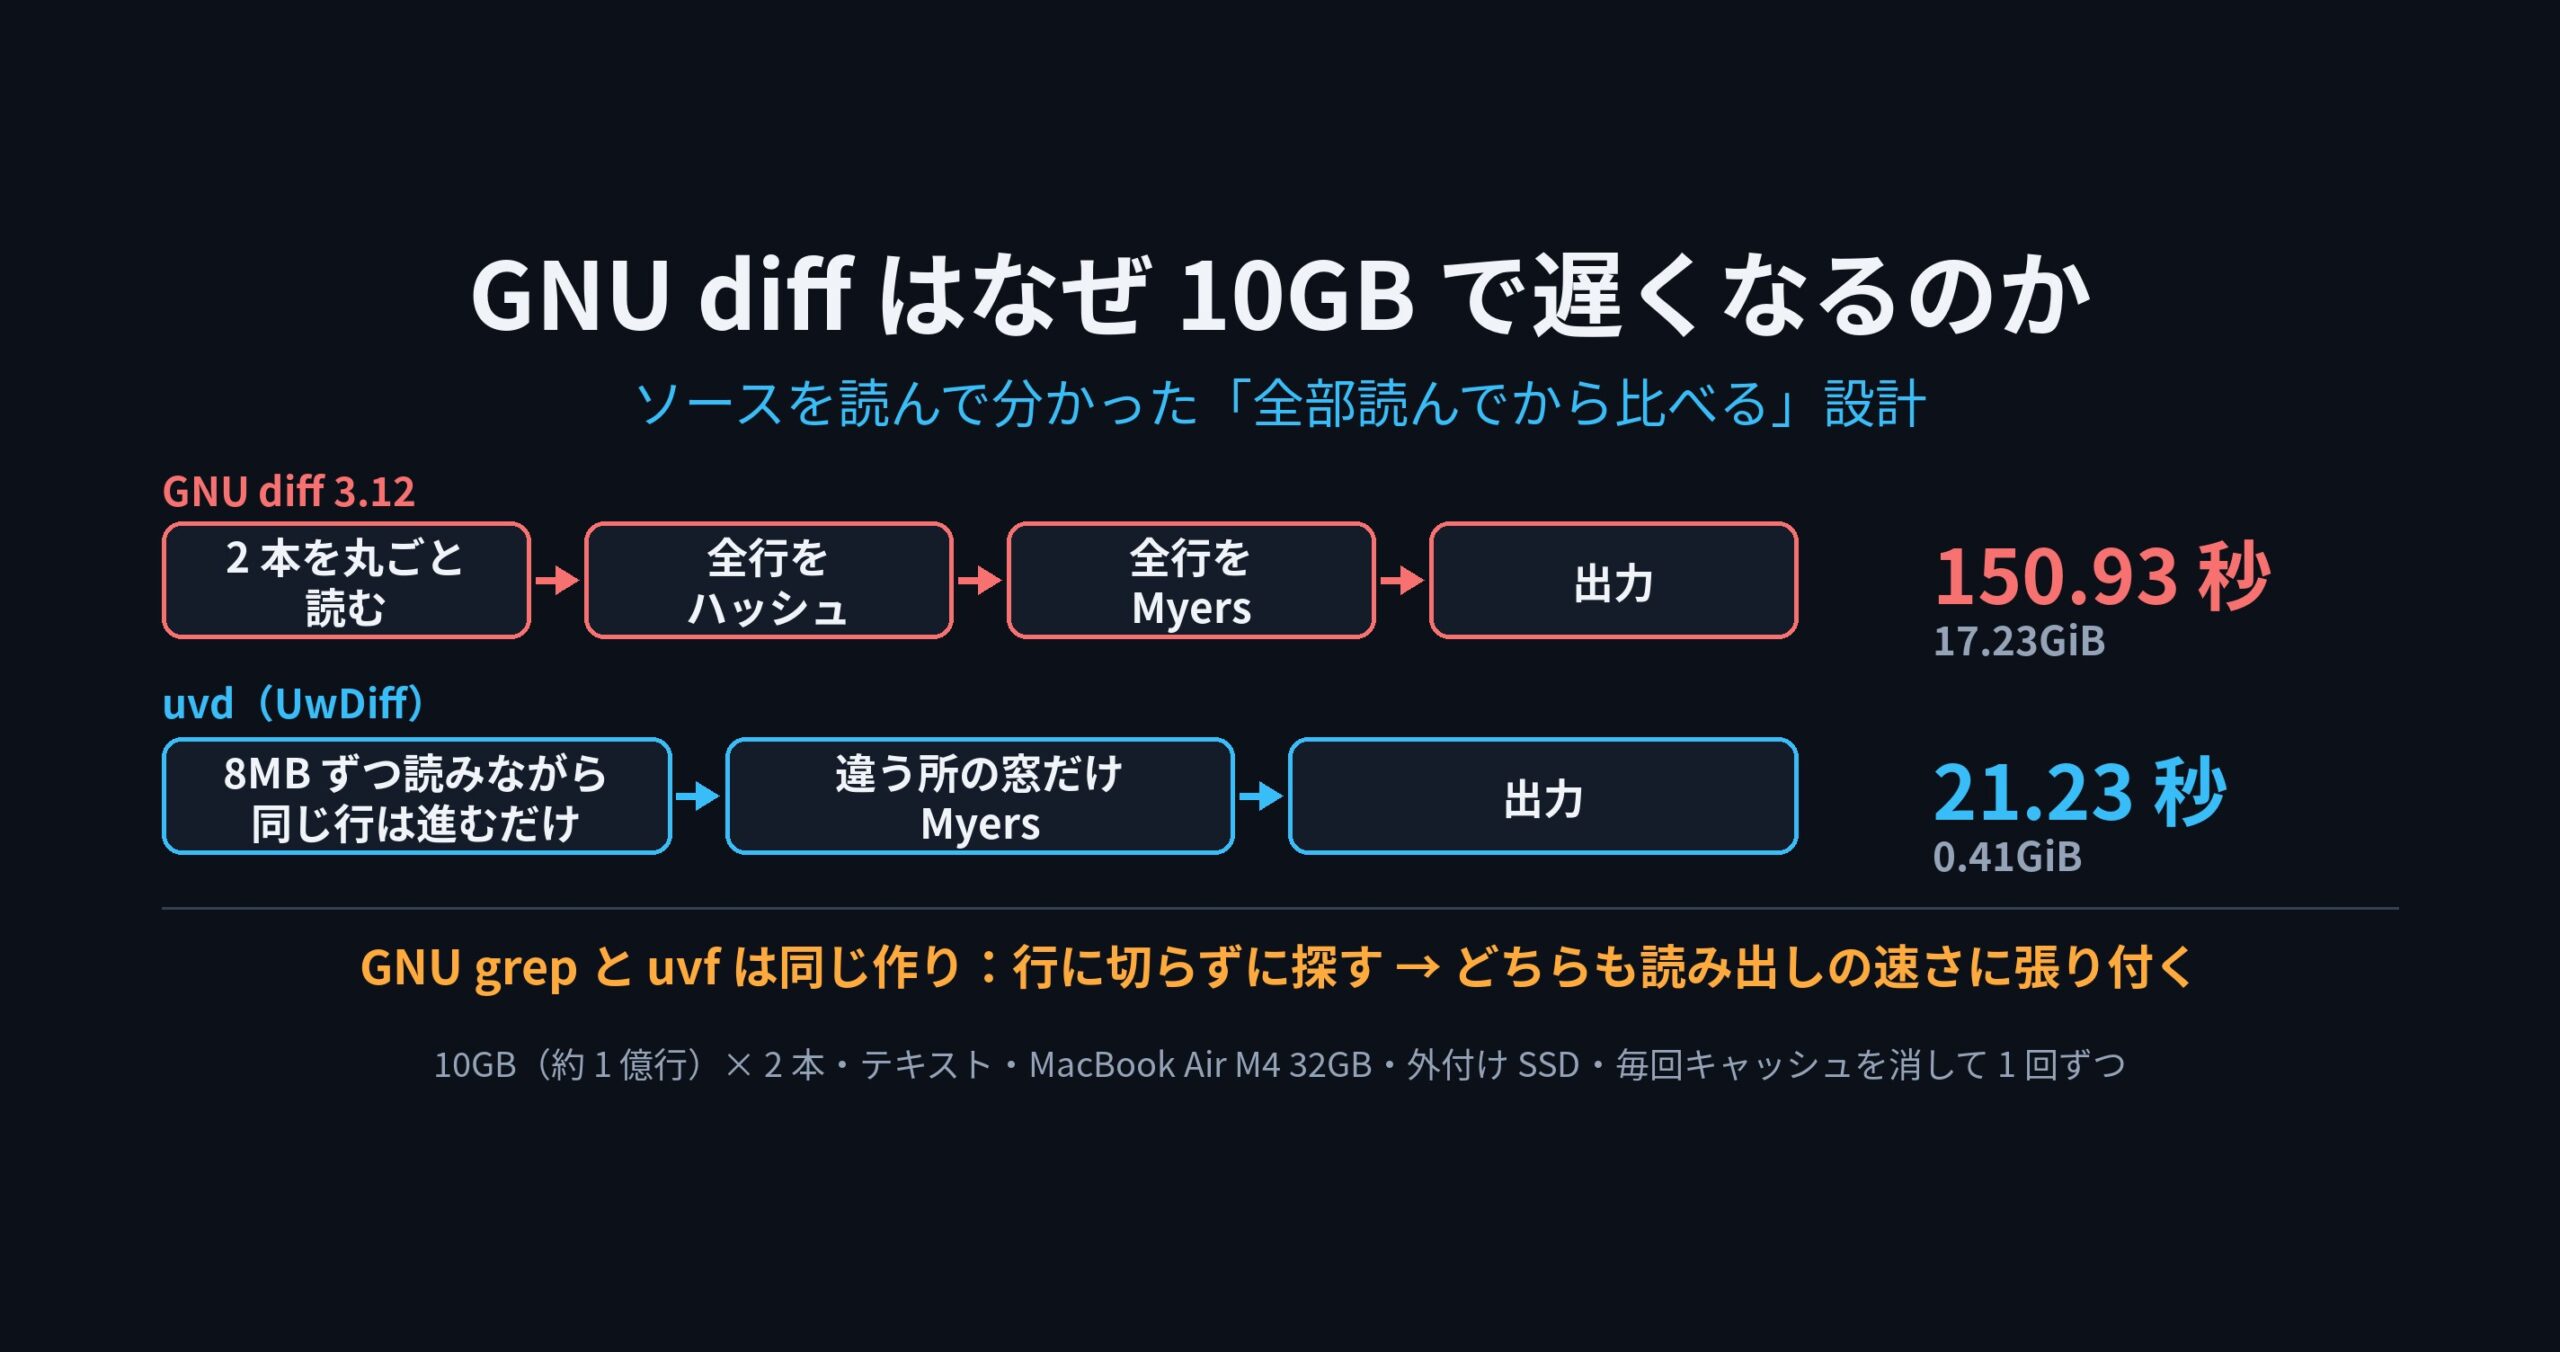
10GB(約 1 億行)のテキスト 2 本を比べると、GNU diff は 150.93 秒、私の作っている UwDiff の uvd は 21.23 秒でした。使ったメモリは 17.23GiB と 0.41GiB です。
一方で、同じ GNU の grep は、私の uvf(UwView の検索コマンド)と同じように、ストレージの読み出しの速さに張り付いて走ります。
同じ GNU の道具なのに、なぜ diff だけが大きなファイルで遅くなるのか。推測で書くのをやめて、GNU diff と GNU grep のソースを読みました。
先に結論: GNU diff は「2 本を全部メモリに読んでから、全行を何周もする」作り。GNU grep は「行に切らずに読み流す」作りで、uvf とそっくりだった
- GNU diff: 旧と新を丸ごとメモリに読み終えてから、全行のハッシュ表を作り、全行をまとめて Myers のアルゴリズムにかけます。読み終わるまで比較が始まらず、行数に比例する大きな表を何周もします。
- uvd: 2 本を8MB ずつ流し読みしながら比べます。同じ行が続く間はハッシュを見て進むだけで、違いが出た所の前後(窓)だけに表を作り、短い区間だけ Myers をかけます。
- GNU grep: 読んだ塊を行に切らずに探し、当たってから行を切り出し、行番号も当たったときだけ数えます。uvf と同じ原理で、どちらも 1 バイトあたりの仕事が少なく、ストレージの読み出しの速さで決まります。
速さの差は、アルゴリズムの賢さよりも、「全部読んでから始める」か「読みながら進む」かという設計の違いから来ていました。
読んだもの
- GNU diffutils:
src/io.c(読み込みと行のハッシュ)・src/analyze.c(比較の流れ)・gnulib のlib/diffseq.h(Myers のアルゴリズムの本体) - GNU grep:
src/grep.c(読み込みと行の扱い)・src/kwset.c(固定文字列の検索)・src/kwsearch.c・src/dfasearch.c(正規表現) - 版: GitHub の非公式ミラー(
gnu-mirror-unofficial/diffutils・grep)の開発版。上に挙げたファイルの作りは、実測に使った GNU diff 3.12 と同じです。 - 比べた自分のソース: UwDiff の
TextDiffEngine・Myers・Hashing、UwView のRawGrep(uvf の検索)
GNU のソースは GPL です。この記事では作りを説明するだけで、コードは写していません。
まず実測: GNU diff は大きくなるほど差が開く
同じ MacBook Air(Apple M4・10 コア・メモリ 32GB)・外付け SSD・同じ試験データで、毎回キャッシュを消してから(sudo purge)1 回ずつ測りました。テキストを行の並びで比べる diff -u の形です。
| 大きさ × 2 本 | uvd 1.0.0 | GNU diff 3.12 | 比 |
|---|---|---|---|
| 1GB(1,053 万行) | 2.37 秒・0.31GiB | 8.24 秒・3.15GiB | 3.5 倍 |
| 5GB(5,267 万行) | 10.74 秒・0.41GiB | 41.24 秒・13.78GiB | 3.8 倍 |
| 10GB(1 億 534 万行) | 21.23 秒・0.41GiB | 150.93 秒・17.23GiB | 7.1 倍 |
uvd は大きさにほぼ比例して伸び、メモリは 0.4GiB 前後で止まります。GNU diff はメモリが大きさとともに増え、5GB から 10GB で時間が 3.7 倍に跳ねます。
全部の表と測り方は UwDiff の実測のページ にあります。
GNU diff の中で起きていること
diff 旧 新 を実行すると、GNU diff は次の順で進みます。
- 2 本を丸ごと読む(
io.cのslurp)。普通のファイルなら、ファイルの大きさぶんのメモリを確保して、最後まで読み切ります。 - 共通の先頭と末尾を削る(
find_identical_ends)。メモリ上で、先頭から同じ部分と末尾から同じ部分を、何バイトかずつまとめて比べて外します。速い処理ですが、1 行目から違いがあれば何も削れません。 - 全行をハッシュして、両ファイル共通の表に入れる(
find_and_hash_each_line)。1 バイトずつ計算するハッシュで、全行を 1 つのハッシュ表に入れ、同じ行には同じ番号(等価クラス)を振ります。行の先頭を指す配列も全行ぶん作ります。 - 相手に無い行を外す(
analyze.cのdiscard_confusing_lines)。片方にしか無い行は必ず追加か削除になるので、本番の比較から外します。これも全行の配列をなめます。 - 残りの全行を、1 回の Myers の分割統治で比べる(
diffseq.hのcompareseq)。前と後ろの両方から対角線を伸ばして真ん中で出会う点を探し、再帰します。手間がかかりすぎるときは、最良ではない点で打ち切ります(--minimalを付けない場合)。作業用の配列も行数ぶん確保します。 - 変更の境界を見やすく動かし(
shift_boundaries)、差分を組み立てて出力します。
1 から 6 まで、前の段が全部終わってから次の段に進む作りです。ストレージから読んでいる間は比べられず、比べている間は読みません。2〜6 はどれも、行数(10GB で約 1 億行 × 2 本)に比例する配列を相手にします。
この作りから言えること・言えないこと
ソースから言えるのは、次のことです。
- 10GB × 2 本の読み出しだけで、この外付け SSD では 20 秒前後かかります。GNU diff はそれが終わるまで比較を始めないので、比較がどれだけ速くても、合計は「読む時間+比べる時間」になります。
- 両ファイル全行ぶんのハッシュ表と配列を作るので、メモリは行数に比例して増えます。測ったメモリ(1GB で 3.15GiB、10GB で 17.23GiB)もその形です。
- 全行のハッシュ表は、1 億行規模ではあちこちに飛んで書き込む表になります。
一方、段ごとに何秒かかっているかは測っていません(プロファイルは取っていません)。5GB から 10GB で時間が 3.7 倍に跳ねるのは、使うメモリが機械の 32GB に近づいていく所と重なりますが、原因をそこに決めつけはしません。
uvd の中で起きていること
uvd(UwDiff のテキストの比較)は、GNU diff と同じ Myers のアルゴリズムを使いますが、かけ方が違います。
- 2 本を、ファイルごとに別のスレッドで 8MB ずつ読み、行に切って、行ごとに 16 バイト単位で計算するハッシュを付けます。
- 比べるスレッドは、ハッシュが同じ行が続く間は、ただ進みます。比べ終わった行は捨てます。
- 違いが出たら、その前後に窓を広げ、窓の中で旧と新にそれぞれ 1 回だけ出てくる行を目印にして、次に「そろう所」を決めます。
- そろう所までの短い区間だけ、Myers のアルゴリズムで最小の差分を求めます。
- 片方が終わったら、残りはまとめて追加か削除にします。
読むスレッド 2 本と比べるスレッド 1 本が重なって動くので、合計はほぼ「読む時間+α」です。ハッシュ表は違いの周りの窓の中にしか作らないので、表の大きさは違いの量で決まり、ファイルの大きさでは決まりません。
| GNU diff | uvd | |
|---|---|---|
| 読み方 | 2 本を丸ごとメモリに読み終えてから始める | 2 本を別スレッドで 8MB ずつ読みながら比べる |
| 行の表 | 両ファイル全行ぶん | 違いの周りの窓だけ |
| ハッシュ | 1 バイトずつ | 16 バイトずつ |
| Myers | 全行を 1 回で | 目印から目印までの短い区間ごと |
| メモリ(10GB × 2 本) | 17.23GiB | 0.41GiB |
GNU diff の方が良い所もある
uvd は、窓の中の目印でそろう所を決めるので、差分がいつも最小になるとは限りません。行の並びが細かく入れ替わった試験データでは、uvd の差分は GNU diff より 0.5% 多くなりました(どちらも、旧に当てると新とバイト単位で一致する正しい差分です)。
ファイルがメモリに余裕で収まり、差分が大きく、しかも最小の差分が欲しいなら(diff --minimal)、GNU diff の作りが合っています。uvd は、最小性を少し手放す代わりに、読みながら比べる形を選びました。
GNU grep が速いままの理由: uvf とほぼ同じ作りだった
GNU grep のソースを読むと、作りは uvd ではなく、uvf(UwView の検索)とそっくりでした。
GNU grep(grep.c) |
uvf(RawGrep) |
|
|---|---|---|
| 読み方 | 読んだ塊を行に切らず、最後の改行だけ探して、その手前までをひと塊で探す | 4MB ずつ読み、最後の改行の手前までをひと塊で探す |
| 行をまたいだ残り | 次の塊の先頭へ繰り越す | 次の塊の先頭へ繰り越す |
| 固定の文字列 | Boyer-Moore 法(kwset.c)。進みが小さいときは memchr 系に切り替え |
.NET の IndexOf(SIMD)で手がかりへ飛ぶ |
| 正規表現 | 正規表現から「必ず含まれる文字列」を取り出して候補へ飛び、そこで DFA を当てる(dfasearch.c) |
正規表現から手がかりの文字列を取り出して候補へ飛び、候補の行だけ正規表現を当てる |
| 行の切り出し | 当たってから前後の改行を探す | 当たってから前後の改行を探す |
行番号(-n) |
当たったときだけ、前回の位置からの改行を数える | 手がかりの位置までの改行を、SIMD でまとめて数える |
どちらも、「読んだ塊を行に分けない」「当たるまで改行を見ない」「行番号は後から数える」という同じ考え方です。1 バイトあたりの仕事が少ないので、CPU に余裕が残り、速さはストレージの読み出しで決まります。
実際、258GB(45 億行)のファイルでは、GNU grep は 273.66 秒でした。ファイルを 1 回読み切るだけの wc -l が 268.49 秒なので、その +1.9% です(258GB の記事)。uvf も、50GB の検索を 50.82 秒・962MB/s で走ります(uvf を 1 回読みにした記事)。別の日・別のファイルの測定なので秒数どうしは比べませんが、どちらも約 0.96GB/s、つまり読み出しの速さそのものに届いています。
同じ GNU で、なぜ diff だけがこうなのか
ソースを読んで分かったのは、解いている問題の形の違いです。
- grep は 1 本を前から 1 回読めば済む問題です。前の行を覚えておく必要が無いので、最初から「読み流す」作りが自然で、それがそのまま今の SSD の速さにも追いつきます。
- diff は 2 本の「最小の差分」を求める問題です。Myers のアルゴリズム(1986 年の論文)は、2 本の列のどこでも自由に見られることを前提にしています。ファイルがメモリに収まるのが当たり前だった時代には、全部読んで全行に番号を振る作りが理にかなっていました。GNU diff のその後の工夫(共通の先頭と末尾を削る、相手に無い行を外す、手間がかかりすぎたら打ち切る)も、メモリの中の配列を速く処理する方向で、読みながら比べる形にはなっていません。
uvd は「diff で比べるのは、たいていよく似た 2 本」という前提を置き、最小性を少し手放す代わりに、grep と同じ「読み流す」形で diff を組み直しました。1GB では 3.5 倍だった差が 10GB で 7.1 倍に開くのは、この作りの違いが、ファイルが大きくなるほど効いてくるからです。
uvd に取り入れられそうなこと
逆に、GNU diff から学べることもありました。今の uvd には入っていないので、今後の検討の種として書いておきます。
- 先頭から同じ間は、行に切らずにバイト列のまま進む: GNU diff の「共通の先頭を削る」に当たる道です。uvd は同じ行が続く間も行に切ってハッシュを付けているので、差分が後ろにしか無いファイルでは省ける仕事があります(ただし、読み出しで速さが決まっている間は、あまり効かないかもしれません)。
- 相手に無い行を、Myers に渡す前に外す: 違いの窓が大きいときに、Myers にかける区間を小さくできる可能性があります。
試すには
# Mac(Homebrew)
brew install --cask amru195704/uwview/uwdiff
# Windows(Scoop)
scoop bucket add uwview https://github.com/amru195704/scoop-uwview
scoop install uwdiff
# Linux(Snap)
sudo snap install uwdiff
uvd 旧.log 新.log -o 差分.diff # diff -u と同じ形の差分を、読みながら作る
Scoop が入っていない場合の入れ方や、手で入れる方法はダウンロードのページにあります。
次に確認する
- UwDiff の実測(条件つき・負けも含めて) — GNU diff・macOS の diff・qsv・DuckDB と、1GB・5GB・10GB で比べた全部の表
- diff や grep で比べられないファイルはなぜ多いのか — UwDiff を作った理由と、「読む時間+α」の予想を試作で確かめた話
- 258GB・45 億行に、5 つの質問をする — GNU grep・ripgrep・BSD grep が、どこまでストレージの速さに張り付くか
- 姉妹の道具 UwView — 巨大なログを開いて、grep のように探す道具
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。