203 秒が 50.82 秒に。
コードを速く書き直したわけではありません。並列化もしていません。減らしたのは、同じファイルを読む回数だけです。では「数える・探す・書き出す」という 3 つの仕事を 1 回の読みに畳むと、何が壊れるのでしょうか。
壊さずに畳むために、満たさなければならない条件が 3 つありました。
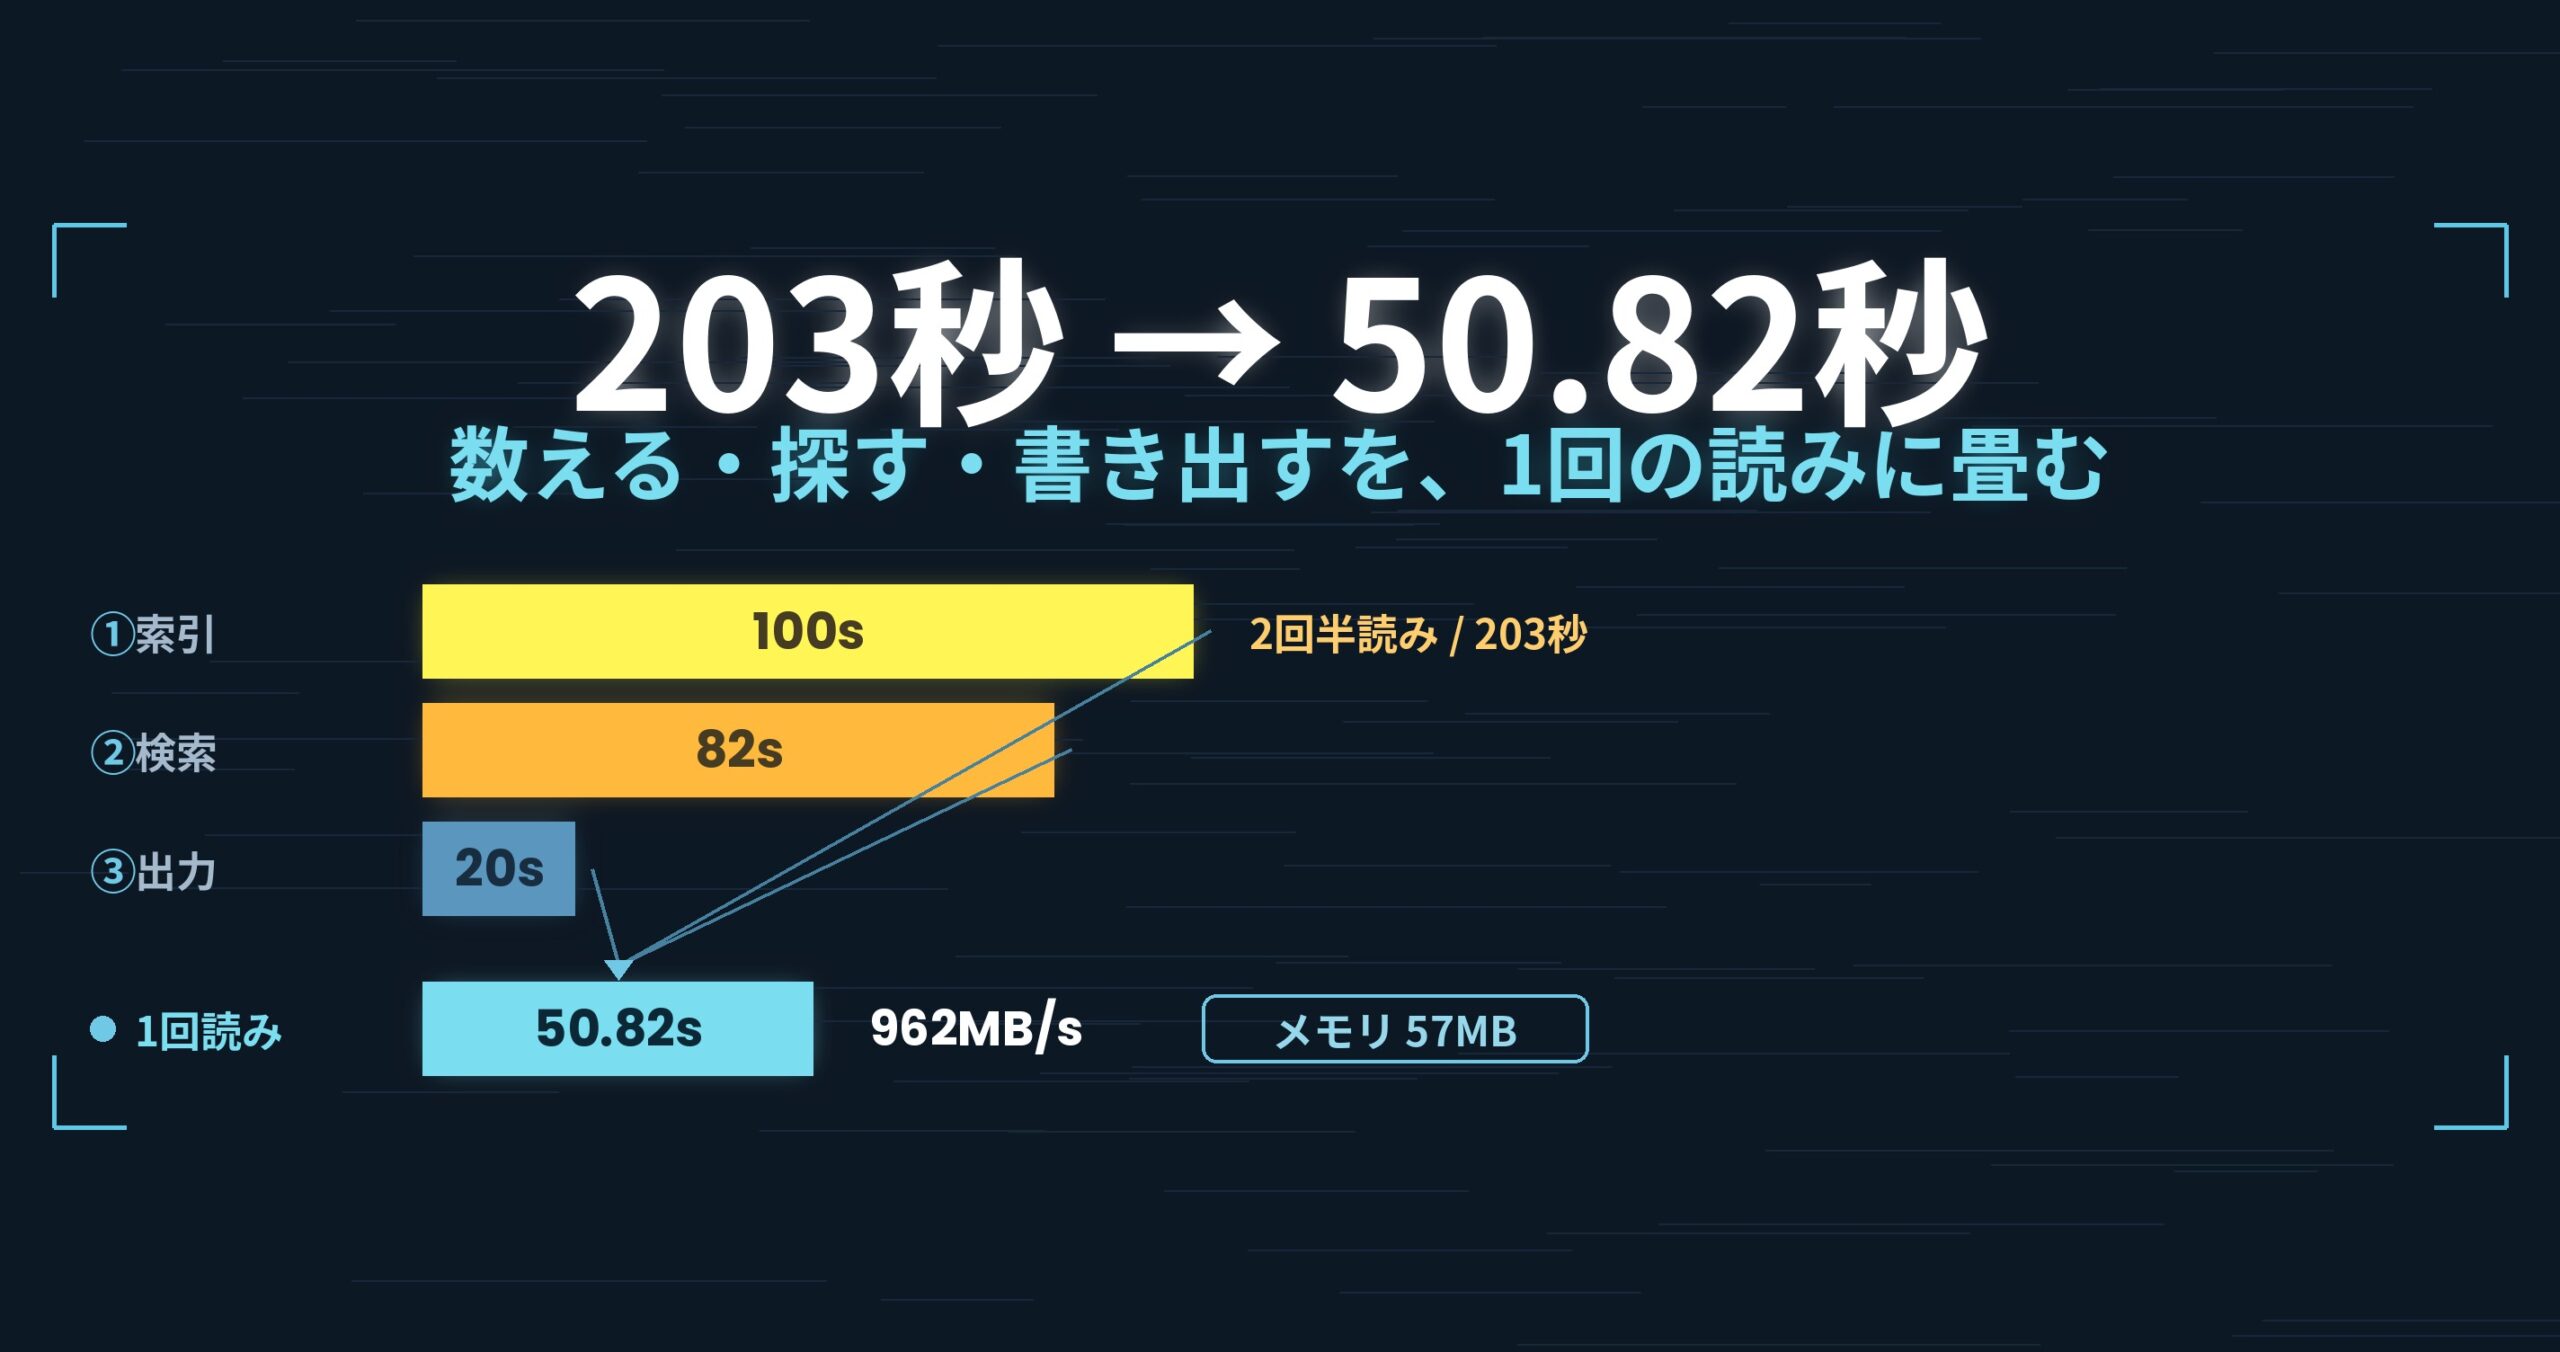
- 先に結論: 行番号を数える/語に一致するか調べる/当たった行の本文を渡す——この 3 つを 1 回の読みの中で同時に行う RawGrep を入れ、50GB の検索は 203 秒 → 50.82 秒(962MB/s)、作業メモリはファイルサイズによらず 57MB になりました。読み取りブロックは 1MB より 4MB が速く(889 → 966MB/s)、一致判定の規則は画面側と同じものを共有しています。ただし 3GB のような小さいファイルでは、1 パス化だけでは ripgrep に負けたまま(hot で 0.32 対 0.54 秒)——そちらの原因は読む回数ではなく固定費でした。いずれも特定環境での測定例です。詳細は記事末尾。
- 問題: 「数える」「探す」「書き出す」が、それぞれ別にファイルを読んでいた
- 原因: 足りなかったのではなく、持っていた情報を捨てていた
- 手当て: RawGrep — 4MB のブロックを読み、その場で 3 つを済ませる
- 数字: 203 → 50.82 秒、メモリ 57MB、出力は ripgrep と同一行
- 持ち帰れる一般論: あとで要る情報は、通り過ぎる前に数えておく
- 使っている道具
- リンク
先に結論: 行番号を数える/語に一致するか調べる/当たった行の本文を渡す——この 3 つを 1 回の読みの中で同時に行う RawGrep を入れ、50GB の検索は 203 秒 → 50.82 秒(962MB/s)、作業メモリはファイルサイズによらず 57MB になりました。読み取りブロックは 1MB より 4MB が速く(889 → 966MB/s)、一致判定の規則は画面側と同じものを共有しています。ただし 3GB のような小さいファイルでは、1 パス化だけでは ripgrep に負けたまま(hot で 0.32 対 0.54 秒)——そちらの原因は読む回数ではなく固定費でした。いずれも特定環境での測定例です。詳細は記事末尾。
この記事は「First Light」連載の第 2 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。今回扱うのは、その 1 回読みが最初に入った v1.6.3 の CLI の中身です。
問題: 「数える」「探す」「書き出す」が、それぞれ別にファイルを読んでいた
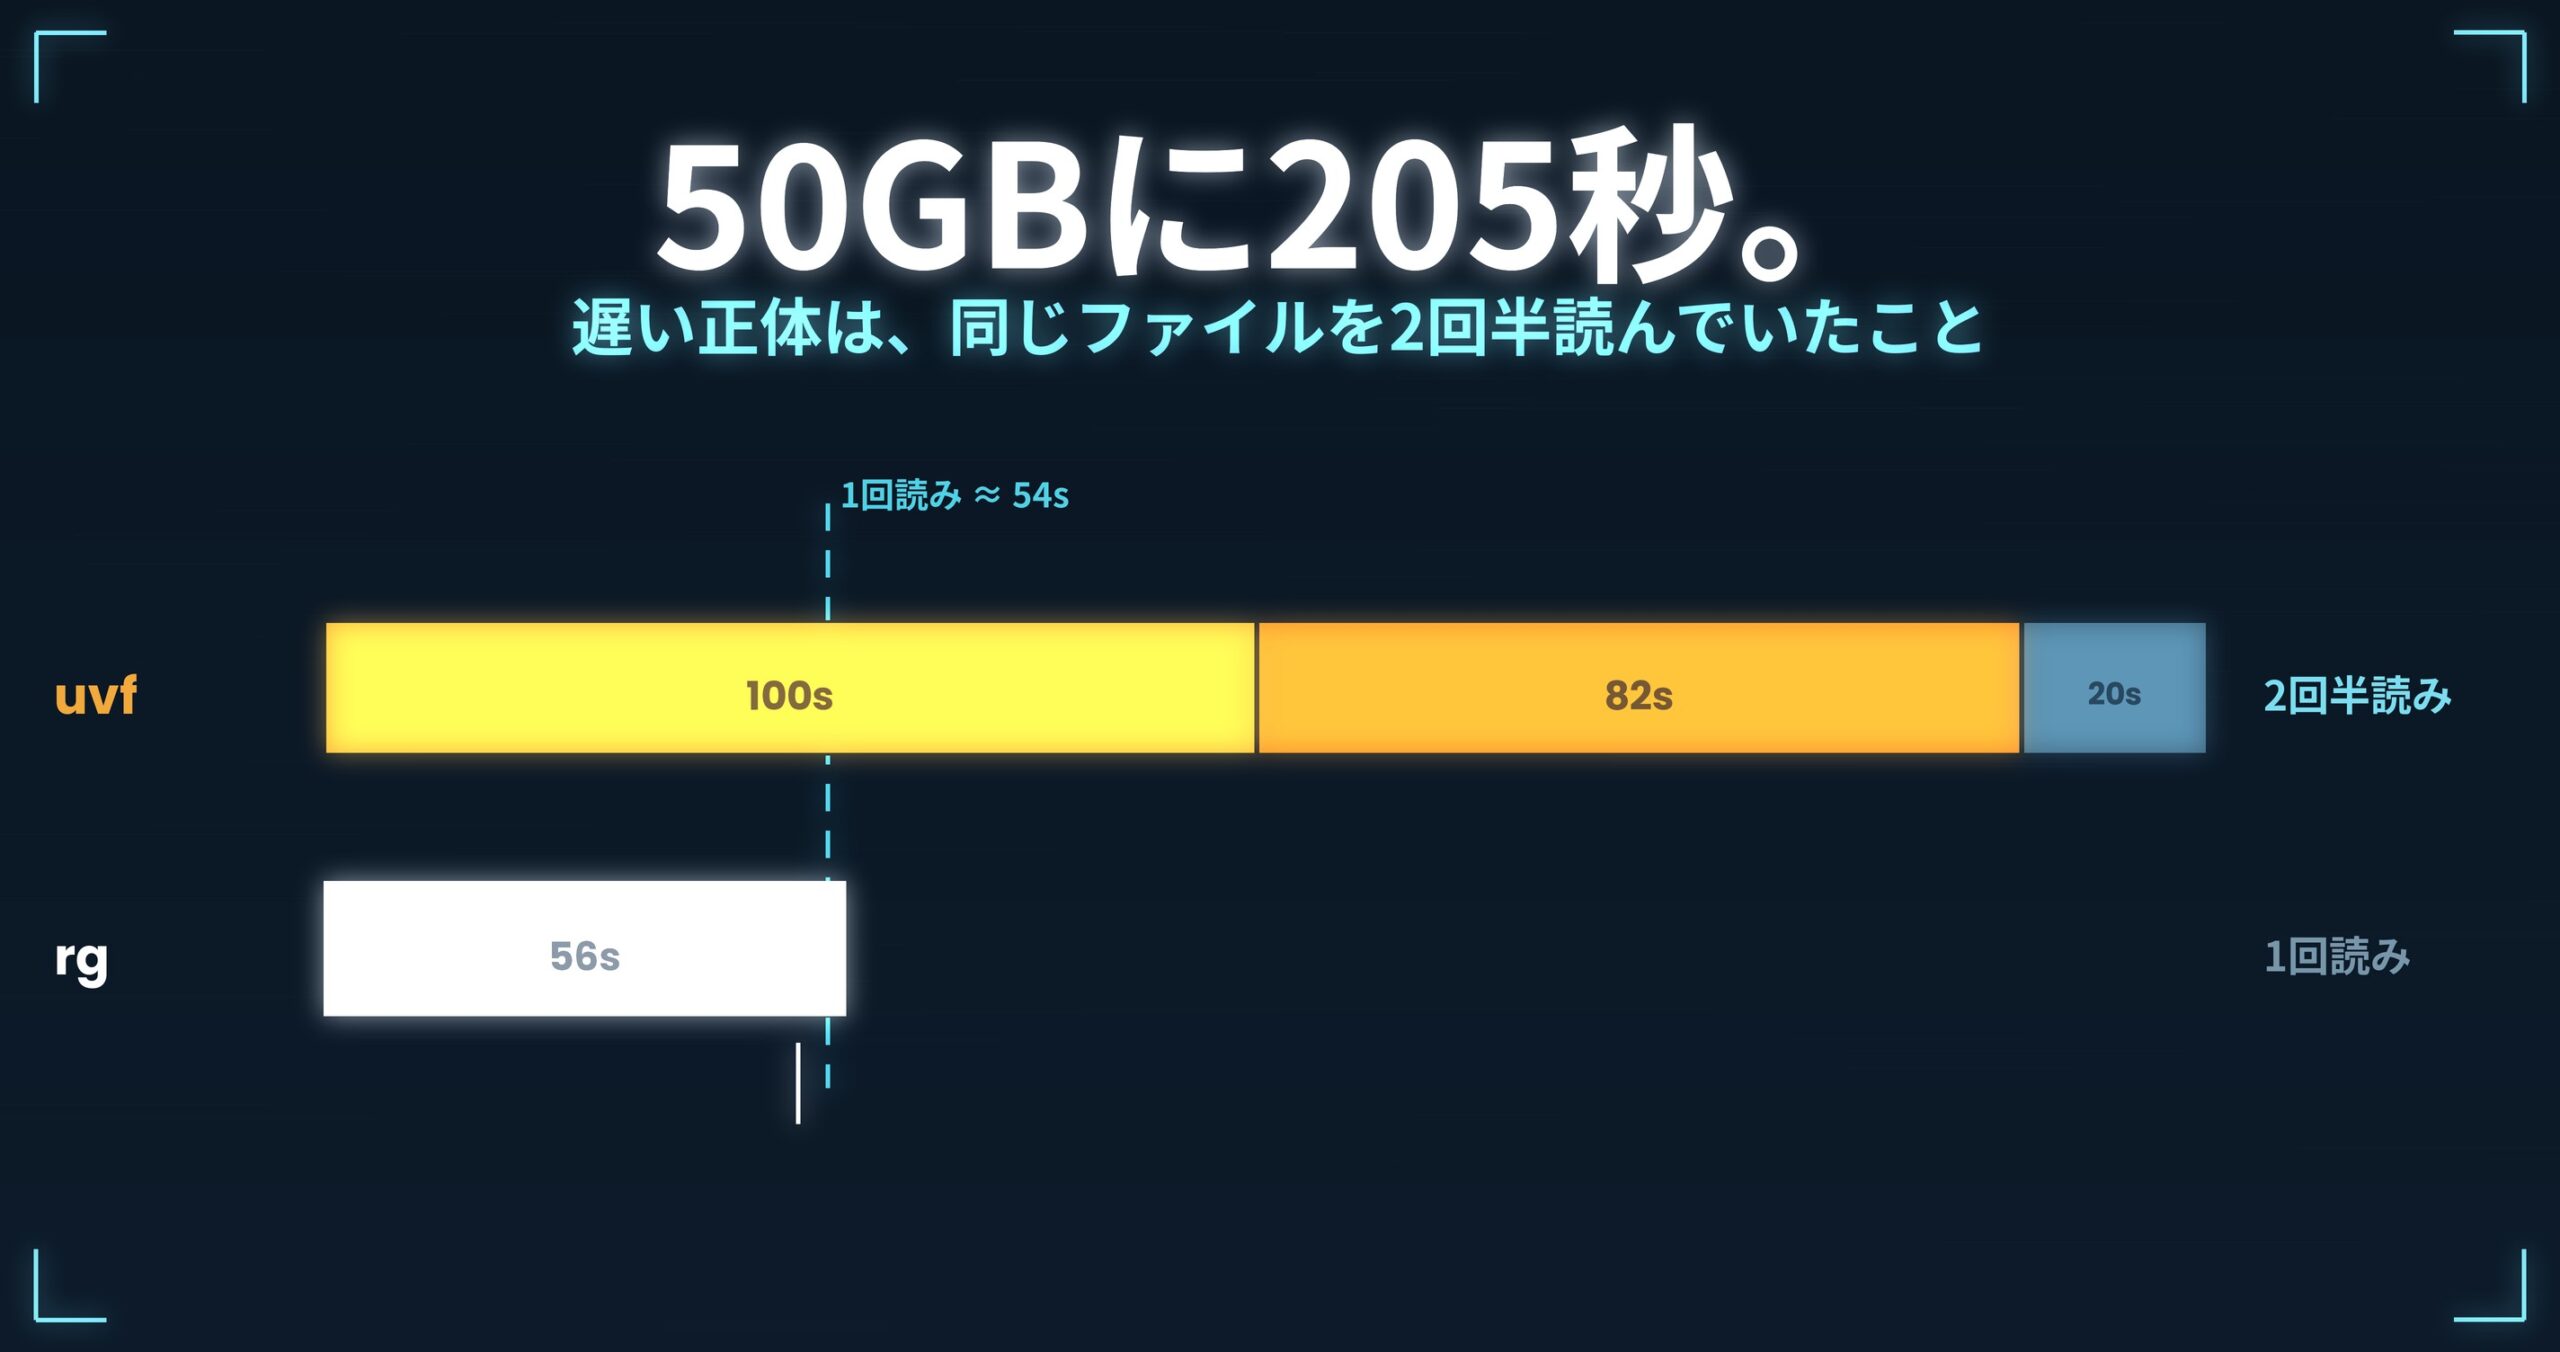
第 1 回で分解したとおり、v1.6.0 の uvf が 50GB の検索に費やしていた 205 秒(v1.6.2 以前は 203 秒)は、こう分かれていました。
| 段 | やっていること | 時間 |
|---|---|---|
| ① 索引を作る | 全部読んで、改行の位置を数える | 100 秒 |
| ② 検索する | もう一度全部読んで、一致する行を探す | 82 秒 |
| ③ 出力する | 一致した行の本文を読み直して並べる | 20 秒 |
なぜ 3 つに分かれていたのか。ひとつずつ見ると、どれも素直な設計でした。
- 行番号を出すには、改行の位置が要る。 だから先に全部読んで索引を作る。
- 検索は索引と関係なく本文を走る。 だから先頭からもう一度読む。
- 出力にはヒット行の本文が要る。 検索の段では「当たった位置」だけを覚えていたので、本文はもう一度取りに行く。
段ごとの責務ははっきりしていて、テストも書きやすい。問題は、3 つの段がそれぞれ「ファイルを読む」という一番高い操作を持っていたことでした。51.25GB を 1 回読むだけで、この外付け USB SSD では約 54 秒かかります。段を分けた瞬間、その 54 秒が段の数だけ積まれます。
原因: 足りなかったのではなく、持っていた情報を捨てていた
1 パスに畳めるかどうかは、「各段が必要とする情報が、先頭から順に読むだけで作れるか」で決まります。3 つを並べ直すと、答えは全部「作れる」でした。
行番号は、その位置までに現れた改行の数です。先頭から数えないと分からない——つまり先頭から順に読む処理と向きが同じ。検索も先頭から順に読みます。向きが同じものは、同時にできます。
ヒット行の本文に至っては、もっと単純でした。一致を見つけたその瞬間、その行の中身は手元の読み取りバッファの中にあります。にもかかわらず読み直していたのは、一致位置だけ控えてバッファを捨てていたからです。情報が足りなかったのではなく、通り過ぎるときに持っていたものを手放していた。20 秒はその代金でした。
索引の 100 秒も同じ話です。改行を数える処理は、検索のために読んでいるブロックの上でそのまま走れます。どのみち全部読むなら、読みながら数えるものを 1 つ増やしても、値段はほとんど変わりません。高いのは「読むこと」そのものだからです。
手当て: RawGrep — 4MB のブロックを読み、その場で 3 つを済ませる
入れたのは RawGrep という通し読み専用の経路です(v1.6.3・UwView.Core/Cli/RawGrep.cs)。やることは単純で、ブロックを 1 つ読むたびに、
- そのブロックに含まれる改行を数えて、現在の行番号を進める
- 語に一致する位置を探す
- 当たったら、その行の先頭と末尾をブロックの中で確定して、本文をそのまま出力へ流す
これだけです。読み切ったときには、行番号も一致も出力も終わっています。
畳むにあたって、壊さないために要った条件が 3 つありました。
① ブロックの境目をまたぐ行を取りこぼさない。 4MB で切って読む以上、行の途中でブロックが終わります。一致する語が境目にまたがることもあります。そこで前のブロックの末尾の切れ端を次へ持ち越し、境界を「行の切れ目」ではなく「読み取りの都合」として扱いました。行番号の勘定も、持ち越した切れ端の改行を二重に数えないようにしています。
② 一致判定の規則を、画面側と同じものにする。 CLI と GUI で判定を別々に書くと、同じ語で違う行が出ます。RawGrep の判定規則は画面側の SearchService と共有していて、これは後に効いてきました——CLI が探した結果をそのまま画面に渡して開く -open(第 6 回で扱います)は、両者の答えが一致していることが前提の機能だからです。同じ判定を 2 か所に書いていたら、この受け渡しは成立しませんでした。
③ 出力をため込まない。 見つけた順に流すだけにしたので、作業メモリはヒット数にもファイルサイズにも比例しません。50GB でも 57MB 一定です。
読み取りブロックは 1MB から 4MB に変えました。読み出し速度の実測(50GB 全体・3 巡の中央値)は 1MB で 889MB/s、4MB で 966MB/s、16MB で 968MB/s。4MB でほぼ頭打ちです。1.09 倍の差は単項目としては小さく、本来なら「差」と呼ばない範囲ですが、3 巡とも頭打ちの位置が同じだったので採用しました(この判断基準そのものは第 9 回で書きます)。
読み方そのもの(mmap をやめて pread にした話)も同じ時期の変更ですが、そちらは別の主題なので第 10 回に回します。
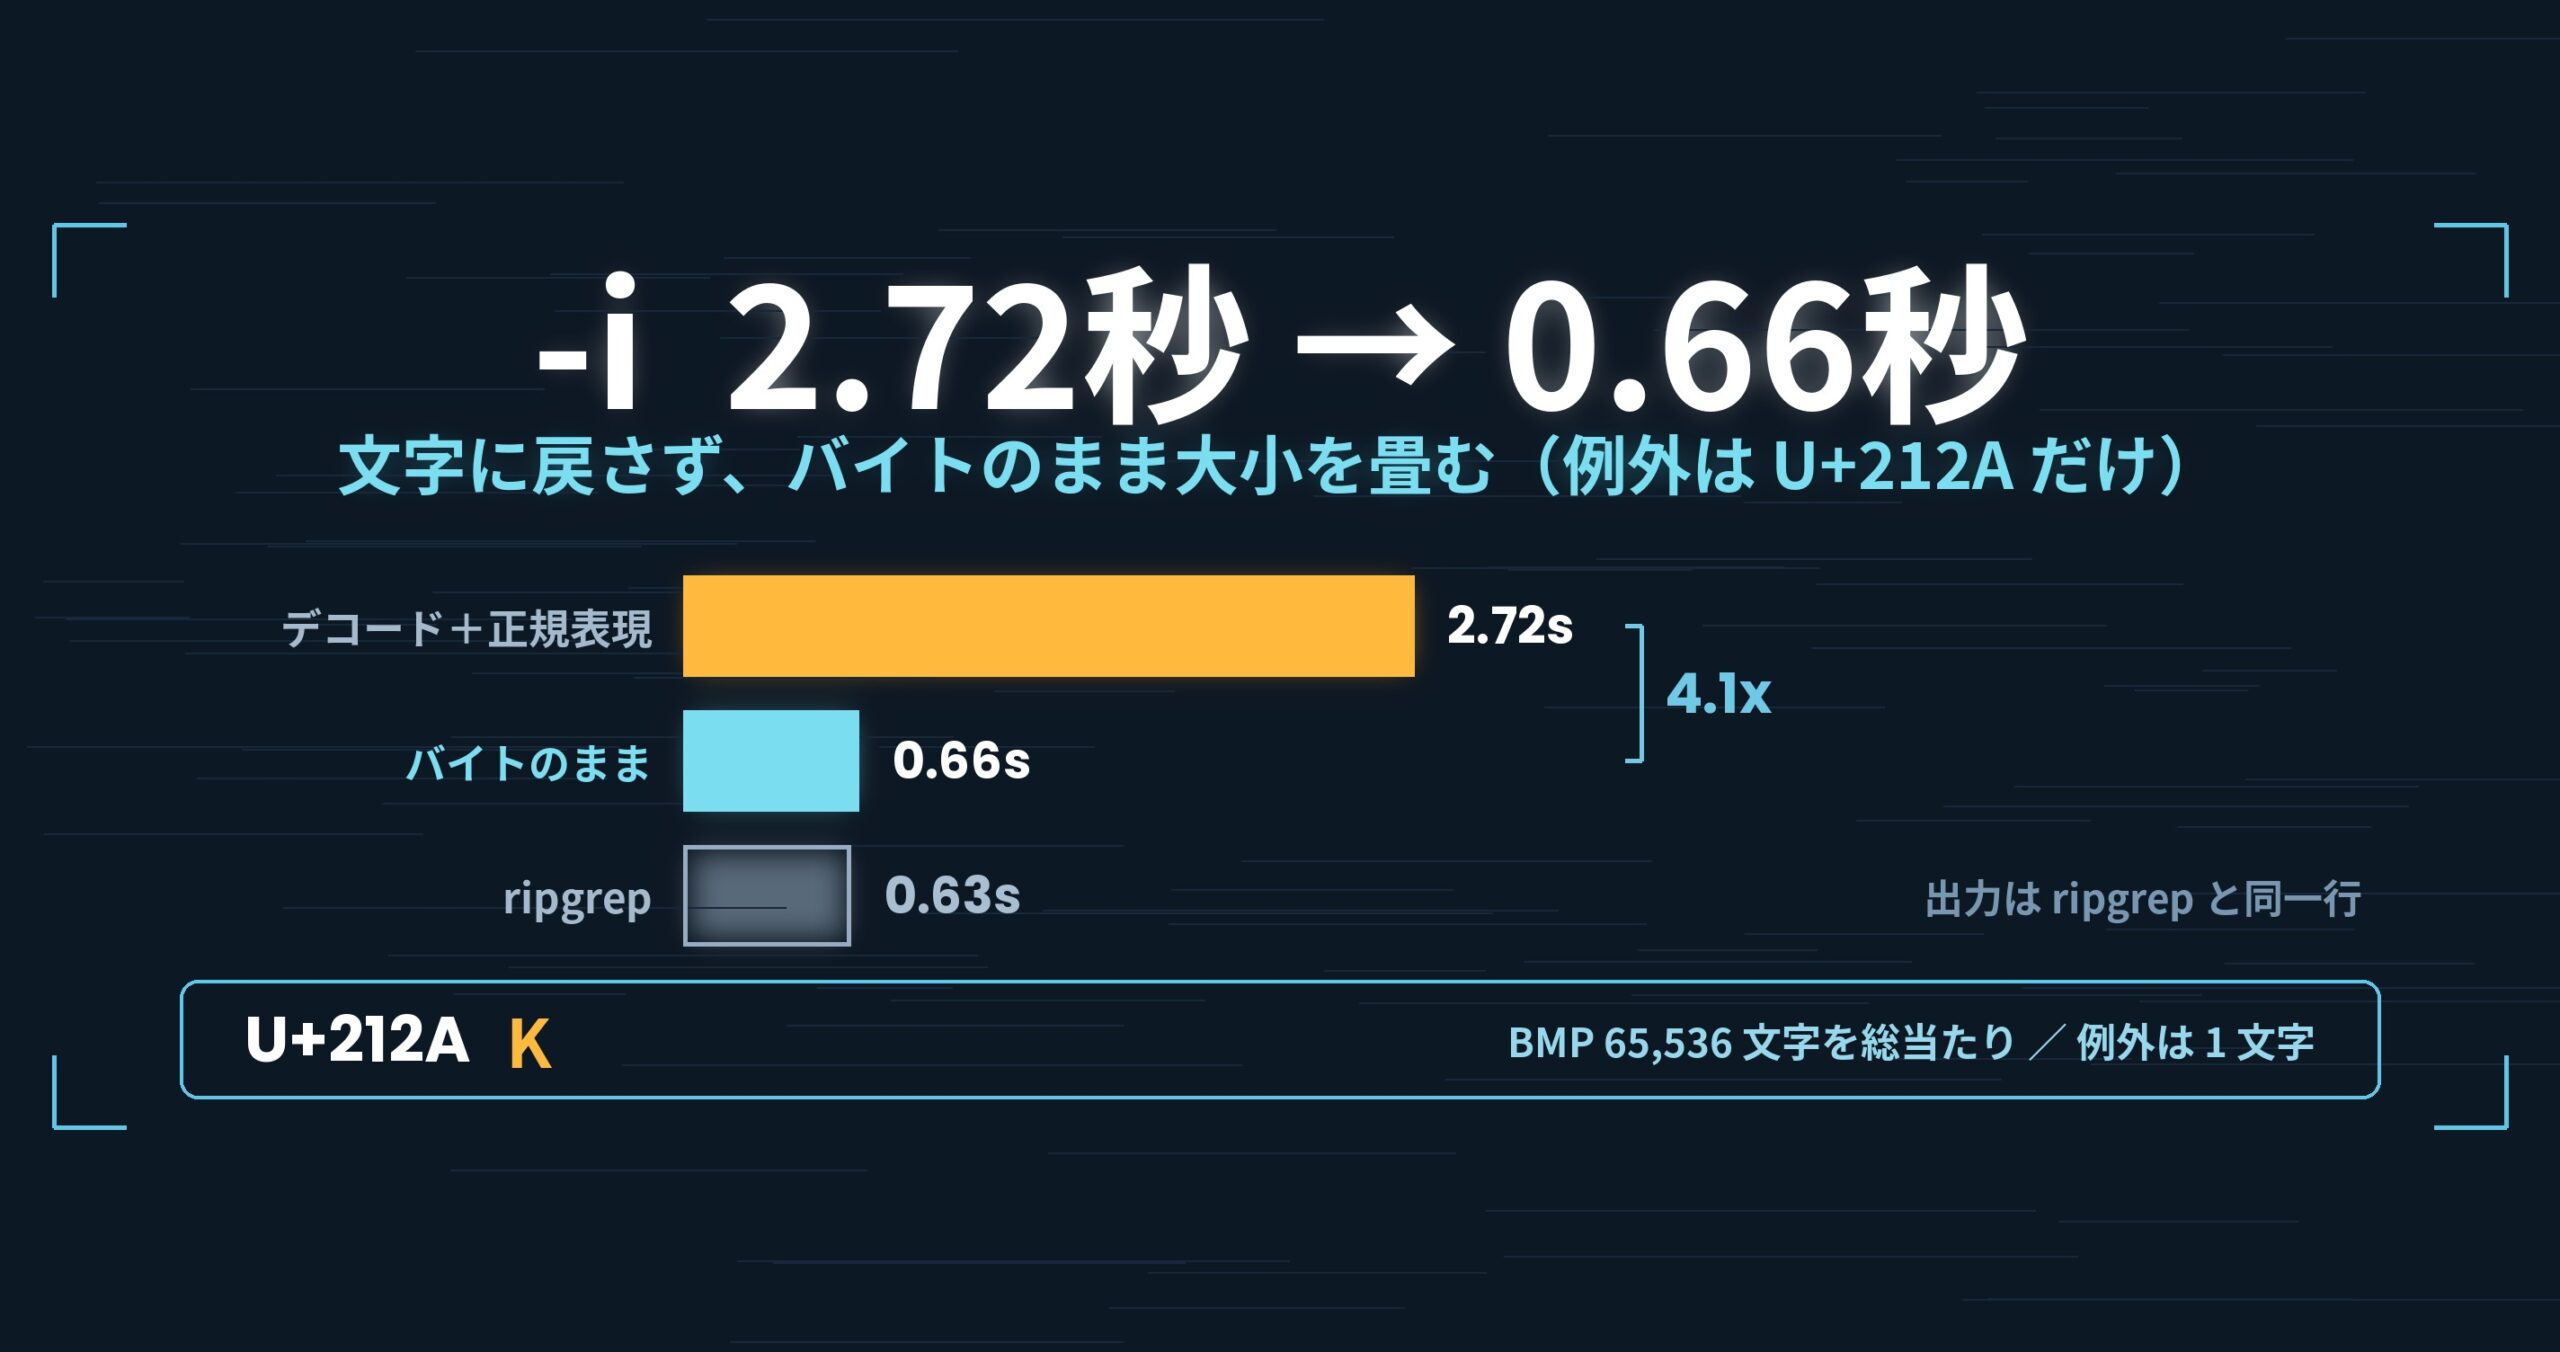
あわせて -i/-E/-v を、Pro 版の uvp と同じ綴りで uvf にも入れました。出力形式と終了コードは変えていません——既存のスクリプトを壊さないためです。
数字: 203 → 50.82 秒、メモリ 57MB、出力は ripgrep と同一行
| v1.6.2 以前 | v1.6.3(RawGrep) |
|
|---|---|---|
| 50GB の検索 | 203 秒 | 50.82 秒 |
| 読み出し換算 | — | 962MB/s |
| 作業メモリ | ヒット数に依存 | 57MB(ファイルサイズによらず一定) |
962MB/s は、この外付け USB SSD の素読み速度(950〜970MB/s)とほぼ同じです。読むのにかかる時間そのものになった、という意味で、ここから先は読み方を変えない限り縮みません。
速くなったかどうかと同じくらい大事なのは、答えが変わっていないことです。3 サイズ × 7 パターンで ripgrep と出力行を突き合わせ、同一行であることを確認しています(ハーネスでは Mac 84 項目一致・不一致 0)。
そして到達点を正直に書くと、50GB のコールド検索は uvf 51.70 秒に対し ripgrep 54.94 秒。1.06 倍です。これは「勝った」とは書きません——単項目で 1.5 倍未満は差と呼ばない、と自分たちで決めているので、ここは「同等になった」が正しい書き方です。
残った負けも書いておきます。 3GB のホット状態の素の検索は、ripgrep 0.32 秒に対し uvf 0.54 秒。1 パス化ではここは消えませんでした。小さいファイルでは読む時間そのものが短いので、読む回数を減らしても効かないからです。原因は別のところ(毎回かかる固定費)にあり、第 7 回で扱います。
持ち帰れる一般論: あとで要る情報は、通り過ぎる前に数えておく
大きな入力を扱う処理で「段に分ける」のは、普通は良い設計です。責務がはっきりして、テストも書きやすい。ただし段の境目でデータをもう一度読むなら、その設計は入力サイズに比例した代金を払っています。
畳めるかどうかは、たいてい次の 1 問で決まります。各段が必要とする情報は、先頭から順に読むだけで作れるか。 作れるなら畳めます。私たちの場合、行番号も一致判定も本文も、全部そうでした。
もう 1 つ。どのみち全部読むなら、読みながら数えるものを 1 つ増やす代金はほとんどタダです。 逆に、いま手元にあるバッファを捨てて「あとでもう一度取りに行く」のは、いちばん高い買い物になります。速くする前に、まず「通り過ぎるときに何を捨てているか」を見てみてください。
使っている道具
この記事の題材はコマンドそのものなので、末尾にも実際の書き方を置いておきます。
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 2章: 1回読みで、語があるかだけ確かめる(無料版)
uvf japan-latest.osm '東京'

# 3章①: 大文字小文字を無視する(v1.6.3 で uvf にも追加)
uvf app.log 'error' -i

# 3章②: 正規表現で探す
uvf app.log -E 'timeout|refused'

# 3章③: 2語で絞り込む(1語目の結果の中から2語目を探す)
uvf app.log 'ERROR' 'payment'

# 4章: 前後の文脈ごと見る/結果をファイルに書き出す
uvf huge.log 'FATAL' -C 5
uvf huge.log 'FATAL' -out fatal.txt

# 4章: CLI で探した結果を、そのまま GUI に渡して開く
uvf access.log ' 503 ' -open
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvf access.log ' 503 '; then がそのまま書けます。
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 画面側も同じ 1 回読みにした話(v1.6.6): https://uvp.y42u.net/blog/uvp-gui-catches-up-v166/
- uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- Qiita: 50GB の検索が 205 秒→51 秒(10 の改善をまとめた版): https://qiita.com/amru195704/items/3cb6451815624aeced73
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。