結論から書くと、diff や grep が弱いのではなく、「日本語の文字コード」「圧縮」「Office・PDF」「数 GB」「OS をまたぐ」が重なると、どの道具でも何かしらの指定や別の道具が要るからです。 その組み合わせを、指定なしで、同じ道具で比べたくて UwDiff を作りました。この記事は、その不満と予想と、作ってみて分かったことの話です。
uvdは私が作っている UwDiff の CLI です(画面は UwDiff)。UwDiff は UwView の一部ではなく、別の製品です。
▶ この記事は動画(約 4 分)でも見られます: YouTube「diff や grep で比べられないファイルはなぜ多いのか?」
grep と diff は「完成された道具」だと思っていた
grep と diff は長年使ってきました。何十年も磨かれてきた道具で、テキストを探す・比べるならこれで足りる、と思っていました。
ところが、日々の仕事で出てくるファイルを相手にすると、つまずく場面が意外と多いのです。
つまずき 1: 日本語の文字コード
Shift-JIS と UTF-8 で、中身は同じ CSV を diff で比べてみます。
$ diff utf8.csv sjis.csv
1c1
< 点名,X
---
> (Shift-JIS のバイト列)
英数字だけの行は一致しますが、日本語を含む行はすべて「違う」と出ます。diff はバイトを比べるので当然の動きですが、実際に知りたいのは「中身が変わったか」です。比べる前に iconv などでそろえる手間が要ります。UTF-8・Shift-JIS・EUC-JP・UTF-16 が混ざる現場では、まずどれなのかを確かめるところから始まります。
画面で比べる道具でも同じでした。Shift-JIS(CP932)の CSV を、既定の設定のまま開いてみた結果です(同じ Mac)。
| 道具 | 既定のまま開くと | 読めるようにするには |
|---|---|---|
| KDiff3 1.12.6 | 文字化け(UTF-8 として読む) | 設定の「地域と言語」で A・B を Shift_JIS にし、Unicode の自動検出を外す(設定は残るので、UTF-8 のファイルの前に戻す) |
| P4Merge 2026.3 | 文字化け(「System」のまま読む) | 起動時に -C shiftjis を付ける |
| UwDiff 1.0.0 | 読める(自動で判定) | 指定は要らない |
どちらも手で指定すれば読めます。ただ、ファイルごとに文字コードを知っていて、指定し直す必要があります。
つまずき 2: 圧縮ファイル
元は同じテキストを、片方は gzip で圧縮して保存した。もう片方は元のテキストを直した。この 2 つを比べたい——という場面です。
$ diff app.log app.log.gz
Binary files app.log and app.log.gz differ
gz なら zdiff、bz2 なら bzdiff、xz なら xzdiff と形式ごとに別のコマンドがあり、zst や br はいったん展開してから比べることになります。「比べられない」わけではないけれど、形式ごとに指定が要る——これが地味に効きます。
つまずき 3: Word・Excel・PDF
$ diff spec-v1.docx spec-v2.docx
Binary files spec-v1.docx and spec-v2.docx differ
違うことは分かりますが、どこが違うのかは分かりません。Excel は開けば見られますが、1,048,576 行を超える CSV は途中で切れてしまいます。
つまずき 4: OS を移ると、使い慣れた道具がない
Windows には優れた GUI の比較ツールが多く、Linux には速い CLI の道具がそろっています。ところが、OS を移ると使い慣れた道具がない。同じ比較を、OS ごとに別の道具で覚え直すことになります。
道具はたくさんある。それでも大きいファイルでは時間がかかる
grep や diff に似た道具は、数えきれないほどあります。それだけ、同じ不満を持つ人が多いのだと思います。
ただ、あらためて調べ、測ってみると、大きなファイルでは別の壁がありました。同じ MacBook Air(Apple M4・32GB)・同じデータで測った結果です(1 回ごとにキャッシュを消し、600 秒で打ち切り)。
| 比べたもの(10GB × 2本) | かかった時間 | メモリ |
|---|---|---|
| テキストの比較: GNU diff | 150.93 秒 | 17.23GiB |
| テキストの比較: macOS の diff | 289.24 秒 | 25.86GiB |
| CSV のキー照合(行順ばらばら): qsv diff | 600 秒で終わらず | — |
| CSV のキー照合(行順ばらばら): DuckDB の SQL | 220.06 秒(CP932 では 357.91 秒) | 20.80GiB |
| (参考・別の日)Beyond Compare の表の比較 | 100MB(105 万行)で 20 分たっても終わらず | — |
画面で比べる無料の道具(KDiff3・P4Merge)は、10GB の前に 1GB で止まりました。
| 画面の比較ツール(テキスト・UTF-8) | 100MB | 1GB |
|---|---|---|
| KDiff3 1.12.6 | 59.26 秒・1.27GiB | 600 秒たっても表示されず(その時点で 9.9GiB) |
| P4Merge 2026.3 | 12.61 秒・3.77GiB | 600 秒たっても表示されず(その時点で 10.8GiB) |
画面の道具は「終わった」を外から知る方法がないので、アプリが CPU を使い終えて表示し終わった時刻を、0.2 秒ごとに CPU の動きを見て測りました(誤差はおよそ ±0.2 秒)。
公平のために書いておくと、qsv は行の順番がそろっていれば 10GB を 32.56 秒で正しく照合し、メモリは 2GiB ほどと UwDiff より少なめでした。DuckDB は SQL で自由に問えます。どの道具にも得意があります。
予想: 「2 本を読む時間 + α」で終わるはず
diff が比べるのは、よく似た 2 つのファイルです。それなら、2 本を頭から同時に読みながら、ずれた所だけ前後を探して比べれば、かかる時間は「読む時間 + α」で済むはずです。ファイルが 10 倍になれば、時間もおよそ 10 倍——のはずです。
ところが、測ってみると、大きくなると時間が急に伸びる道具があります。1GB と 10GB で比べると、ファイルは 10 倍なのに、時間は下の表のように伸びました(同じ Mac・同じデータ)。
| 道具 | 1GB | 10GB | 伸び |
|---|---|---|---|
| GNU diff(テキスト・UTF-8) | 8.24 秒 | 150.93 秒 | 約 18 倍 |
| macOS の diff(テキスト・UTF-8) | 11.00 秒 | 289.24 秒 | 約 26 倍 |
| DuckDB(キー照合・UTF-8・行順ばらばら) | 4.41 秒 | 220.06 秒 | 約 50 倍 |
| qsv diff(キー照合・UTF-8・行順ばらばら) | 5.87 秒 | 600 秒で終わらず | 100 倍超 |
画面の道具では、KDiff3 が 100MB で約 1 分、P4Merge が約 13 秒かかり、どちらも 1GB では 600 秒たっても表示されませんでした。
それぞれの道具が中で何に時間を使っているのかは、作りを調べたわけではないので分かりません。分かるのは、同じ機械・同じデータで測った時間だけです。
試作してみたら、予想どおりだった
そこで、2 本を同時に読みながら比べる形で試作してみました。結果は予想どおり「読む時間 + α」でした。10GB × 2 本、合わせて 20GB を約 21 秒——1 秒あたり約 1GB を読みながら比べている計算です。時間はファイルの大きさにほぼ比例し、1GB 約 2 秒 → 5GB 約 11 秒 → 10GB 約 21〜23 秒でした。
全体の結果
UwDiff を加えて、同じ表をもう一度並べます。
| 道具 | 1GB | 10GB | 伸び |
|---|---|---|---|
| UwDiff(テキスト・UTF-8) | 2.37 秒 | 21.23 秒 | 約 9 倍 |
| GNU diff(テキスト・UTF-8) | 8.24 秒 | 150.93 秒 | 約 18 倍 |
| macOS の diff(テキスト・UTF-8) | 11.00 秒 | 289.24 秒 | 約 26 倍 |
| UwDiff(キー照合・UTF-8・行順ばらばら) | 2.27 秒 | 22.61 秒 | 約 10 倍 |
| DuckDB(キー照合・UTF-8・行順ばらばら) | 4.41 秒 | 220.06 秒 | 約 50 倍 |
| qsv diff(キー照合・UTF-8・行順ばらばら) | 5.87 秒 | 600 秒で終わらず | 100 倍超 |
画面で比べた場合も並べます(同じ Mac・テキスト・UTF-8・表示し終わるまで)。
| 画面の比較ツール | 100MB | 1GB | 5GB | 10GB |
|---|---|---|---|---|
| UwDiff 1.0.0 | 2.22 秒 | 3.22 秒 | 11.23 秒 | 21.91 秒・1.37GiB |
| P4Merge 2026.3 | 12.61 秒 | 600 秒で表示されず | — | — |
| KDiff3 1.12.6 | 59.26 秒 | 600 秒で表示されず | — | — |
CP932 でも UwDiff は 1.35 → 3.27 → 10.83 → 19.51 秒で、文字コードの指定なしにそのまま読めました。
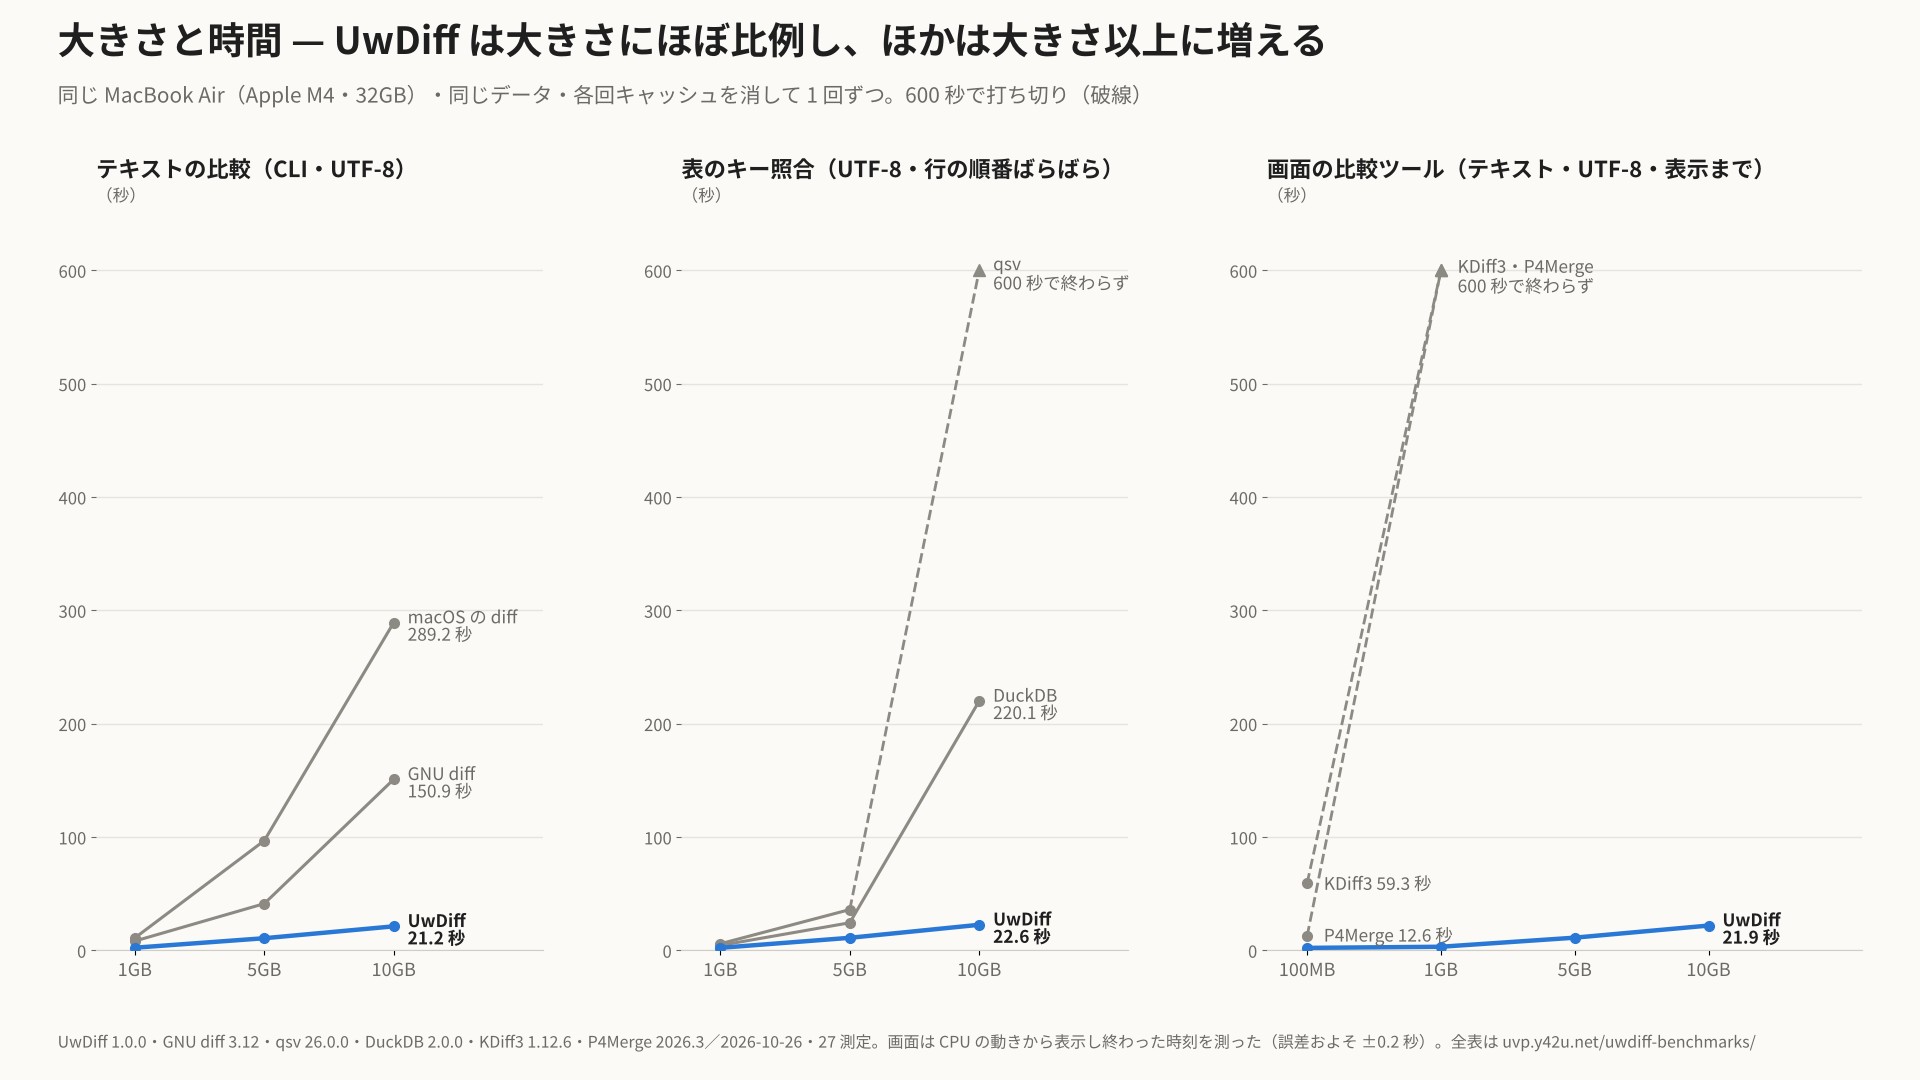
5GB を含めた全部の組(行の順番がそろった表・CP932 も)は、実測のページにあります。
なければ作ればよい
それなら、次の組み合わせのどれでも、指定なしで比べられる道具を作ろう——と考えたのが UwDiff です。
| 軸 | UwDiff で比べられるもの |
|---|---|
| 形式 | テキスト(ログ・CSV・TSV・ソース)/圧縮 7 形式(gz・bz2・xz・lzma・zst・lz4・br。片方だけ圧縮でもよい)/Word(.docx)・Excel(.xlsx)・PDF の文字 |
| 文字コード | UTF-8・Shift-JIS(CP932)・EUC-JP・UTF-16 を自動で判定。旧と新で違っていてもよい |
| 使い方 | 画面(UwDiff)と CLI(uvd)。uvd 旧 新 -open で、CLI の結果をそのまま画面に出せる |
| 大きさ・数 | 1 本 10GB を超えるファイル、数千〜数万本のフォルダ。メモリが足りなければ一時ファイルへ逃がして最後まで通す |
| OS | macOS・Linux・Windows(同じ道具・同じ使い方) |
比べ方は 4 つです。
- テキスト: 行の並びを保つ比較。
diff -uと同じ形(unified diff)で書き出すので、patchでそのまま当てられます - 表(キー照合): CSV・TSV・Excel を ID などのキー列で照合。行の順番が違ってもよく、変わったセルだけが出ます
- 順番を問わない比較: 行の並びを無視して、増えた行・減った行を数えます
- フォルダどうし: 片方だけにあるファイル・違うファイルを一覧に。違うファイルはそのまま中身を比べられます
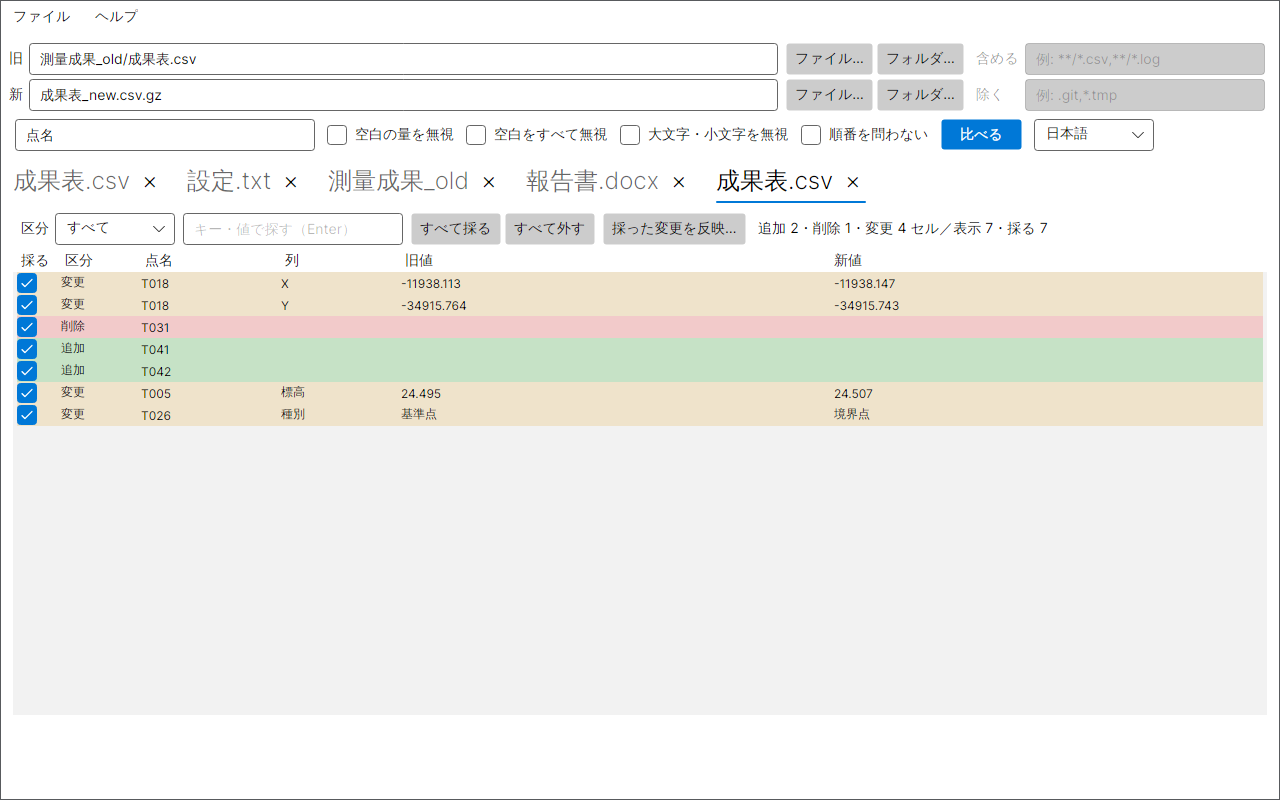
たとえば「普通の CSV」と「gzip で圧縮した CSV」を、点名で照合するとこうなります。
負けも書いておきます
- 行の順番がそろった表では、メモリは qsv の方が少ない(10GB で qsv 1.7〜2.1GiB、UwDiff 4.3〜4.5GiB)。
- 行の順番を全部並べ替えた 10GB では、UwDiff も 13GiB 前後を使います(
-memで上限を決めれば、一時ファイルへ逃がして最後まで通ります)。 - ほぼ全行が違う最悪の組(10GB × 2本)は、テキストの比較で 110 秒かかりました(同じ MacBook Air M4 での別の試験。データの作り方が違うので、上の表とは並べません)。
条件と全部の表は、UwDiff の実測のページにあります。
試すには
# Mac(Homebrew)
brew install --cask amru195704/uwview/uwdiff
# Windows(Scoop)
scoop bucket add uwview https://github.com/amru195704/scoop-uwview
scoop install uwdiff
# Linux(Snap)
sudo snap install uwdiff
uvd 旧.csv 新.csv.gz -key 点名 -open # 片方が圧縮でも、Shift-JIS でも、そのまま
Scoop が入っていない場合の入れ方や、手で入れる方法はダウンロードのページにあります。
操作の流れは動画でも見られます: UwDiff 1.0.0 操作デモ(約 90 秒)
次に確認する
- UwDiff の実測(条件つき・負けも含めて) — qsv・DuckDB・GNU diff・macOS の diff と、1GB・5GB・10GB で比べた全部の表
- UwDiff を公開した紹介記事(6 つの軸) — 形式・文字コード・CLI と画面・3OS・大きさ・速さの詳しい説明と、最悪の組の測り方
- UwDiff のダウンロードと入れ方 — Homebrew・Scoop・Snap と、配布物の SHA256
- 姉妹の道具 UwView — 「比べる」前の「開く・探す」。巨大なログを開いて、grep のように探す道具
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。