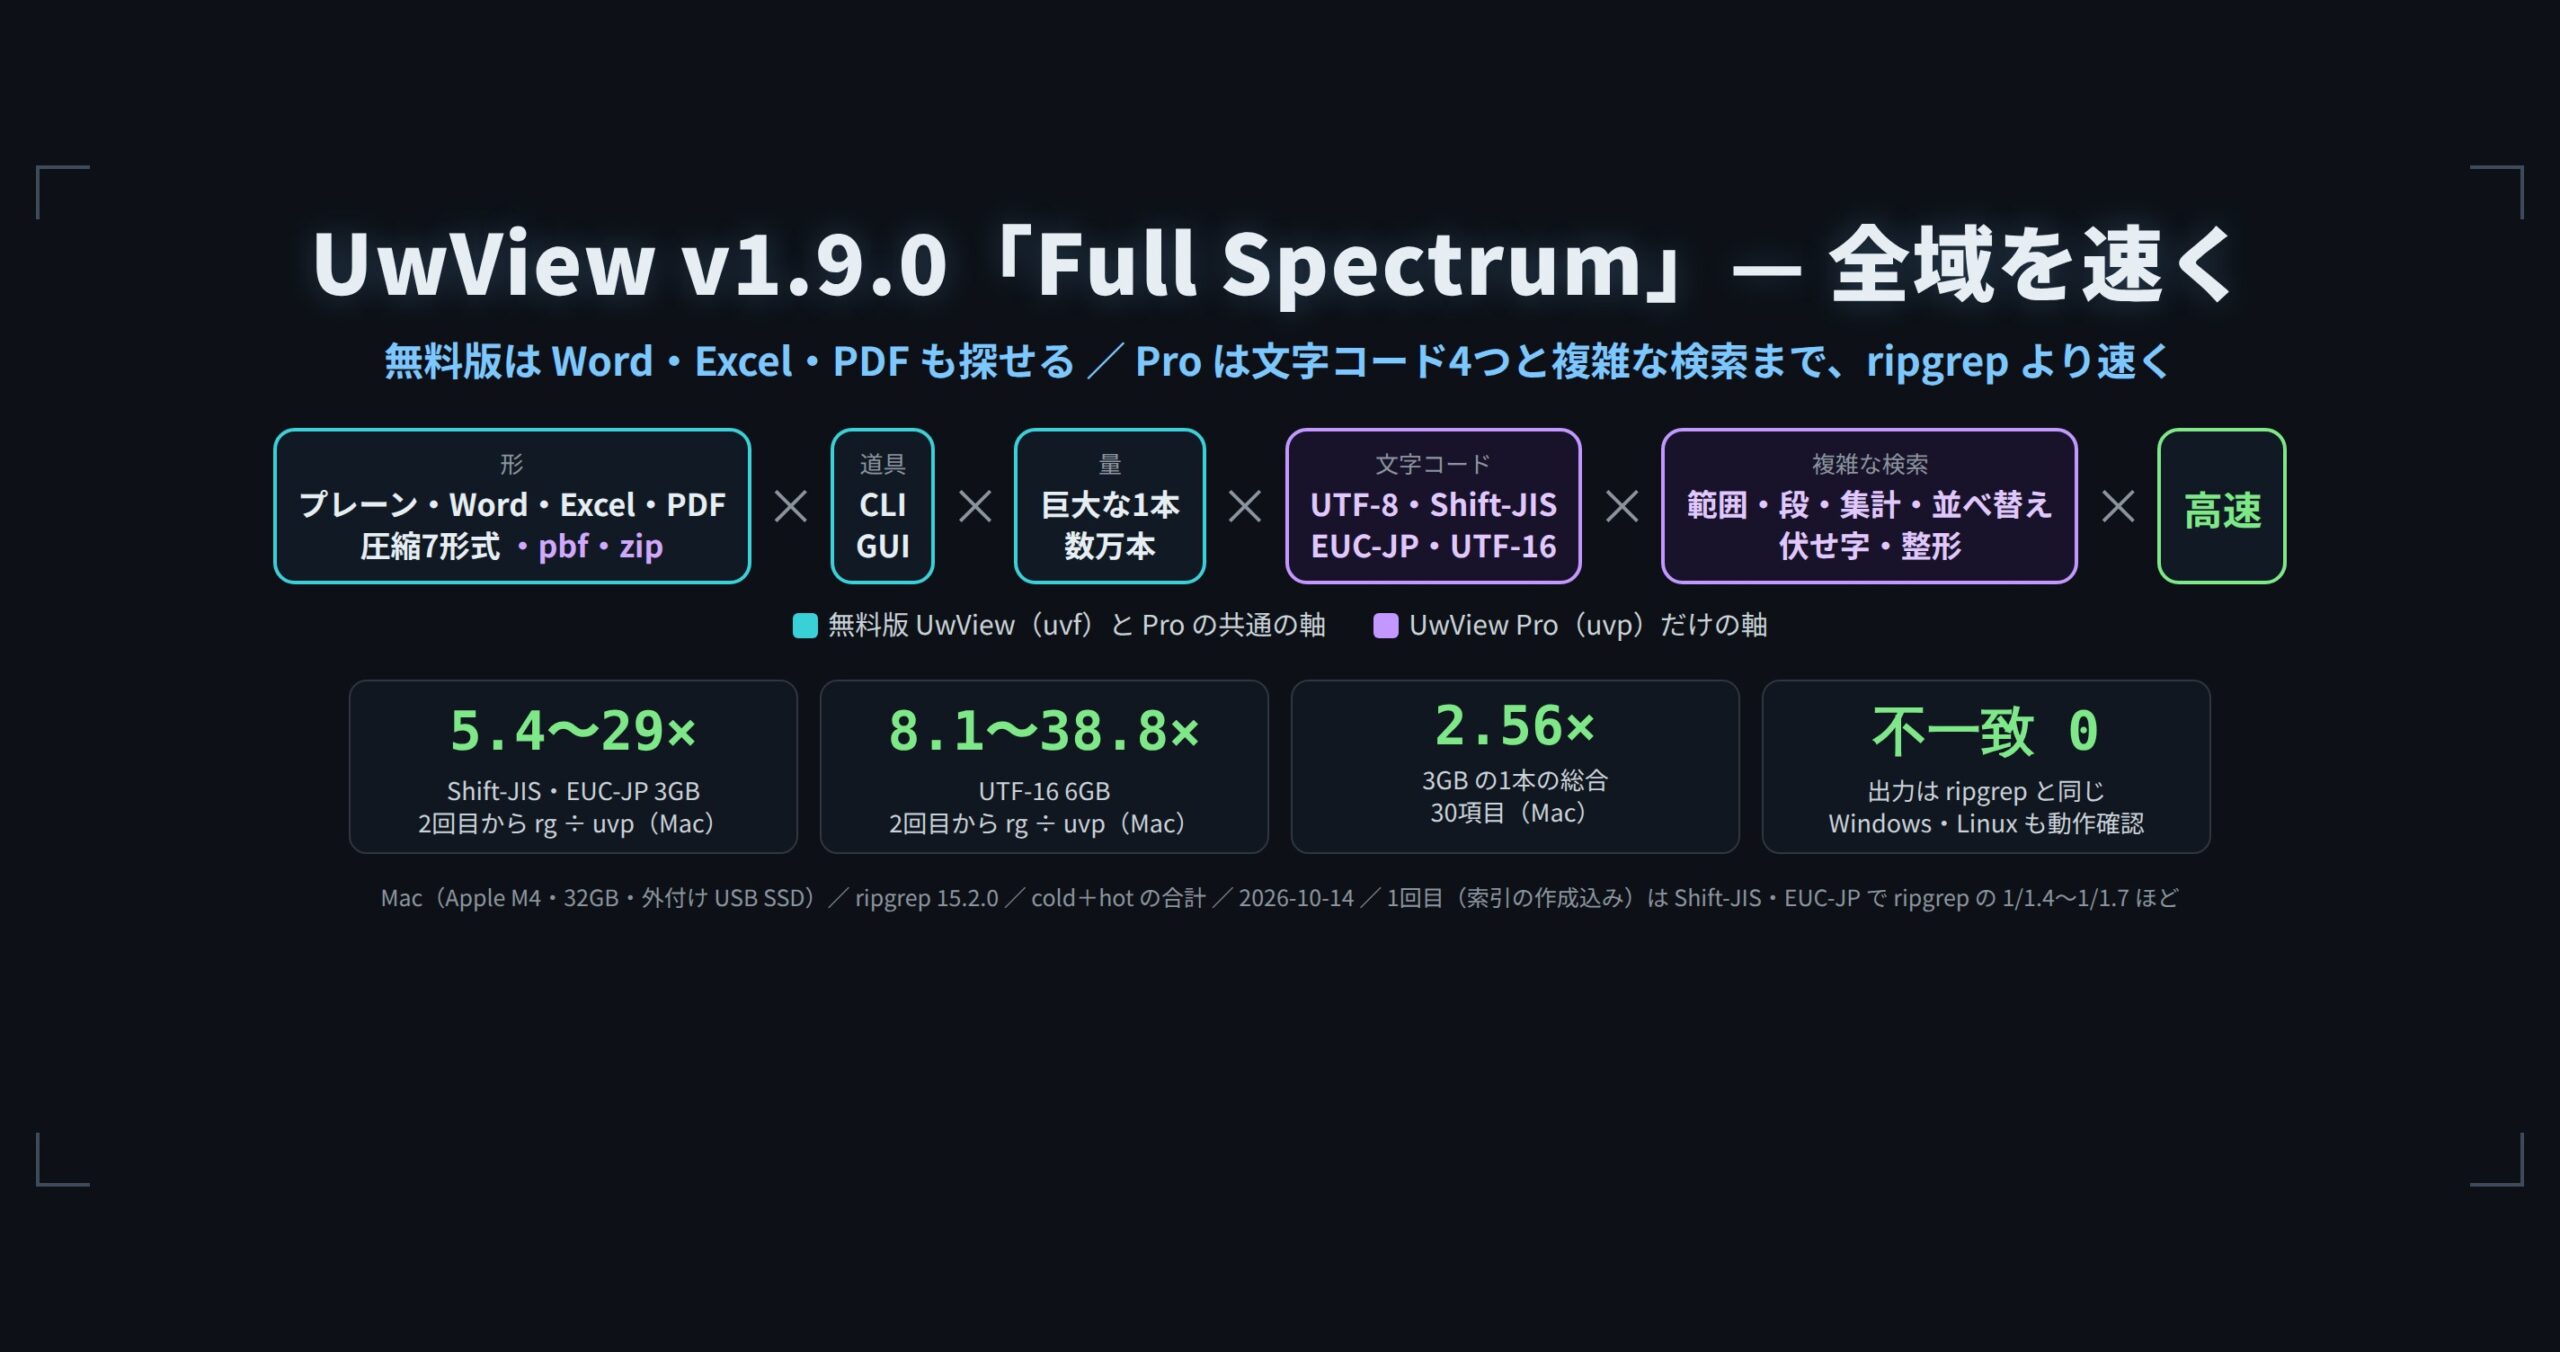
式で書くと、こうなります。
無料版 UwView(uvf)
(プレーン + Word・Excel・PDF + 圧縮[gz・bz2・xz・lzma・zst・lz4・br])× (CLI + GUI)× (巨大 + 多数)ファイル × 高速

UwView Pro(uvp)
(プレーン + Word・Excel・PDF + 圧縮[gz・bz2・xz・lzma・zst・lz4・br・pbf・zip])× (CLI + GUI)× (巨大 + 多数)ファイル
  × (UTF-8 + Shift-JIS + EUC-JP + UTF-16)× (複雑な検索:範囲・段・集計・並べ替え・伏せ字・整形)× 高速
名前の「Full Spectrum(全域)」は、この式の全部の組み合わせのことです。どの組み合わせでも ripgrep と同等以上、Pro は多くの組み合わせで数倍——を目指して作りました。どこまで測れたかは、この記事の最後に「正直に」として書いています。
UwView は、grep と vi を合わせたように使えるアプリです。CLI(無料版は
uvf、有料版 UwView Pro はuvp)でファイルから文字列を探し、GUI で数 GB〜数十 GB のファイルを開いた瞬間から読めます。v1.9.0 は 2026年10月の公開です(GitHub Releases・Homebrew・Scoop・Snap)。
1. 無料版でも、Word・Excel・PDF の中を探せるようになった
uvf report.docx 東京             # Word
uvf '経費/**/*.xlsx' 交通費       # Excel(ワイルドカードでまとめて)
uvf 'docs/**/*.pdf' 契約 -i       # PDF
uvfは、文字を取り出しながら探します。索引は作らず、元のファイルの隣にも何も作りません。- 行の形は決まっています。Excel は
シート名!行番号<TAB>A列<TAB>B列…、PDF は## page Nに続けて読む順の行です。だから ripgrep と同じように、行番号つきの結果が並びます。Excel は表示されている値で探し、--rawを付けると元の値で探します。 - 画面で開くと「文字を取り出して開きます」と進み具合を出し、取り出した文字を見ながら探せます。
- 読むだけです。元の形式には書き出せません(取り出した文字の保存・コピーはできます)。古い .doc・.xls、パスワード付き、文字の無い PDF(画像だけ)は、理由を出して飛ばします。
ripgrep だけでは Word・Excel・PDF の中を探せません(中身が zip や圧縮された流れなので)。--pre で抜き出しのコマンドをつなぐか、ripgrep-all のような別の道具を足すことになります。uvf はその抜き出しを、外部のコマンドなしで 1 本のコマンドの中でします。
2. 画面:ダークテーマ・フォント・キーの割り当て
設定の画面(Windows・Linux は「ツール → 設定…」Ctrl+,、Mac はアプリ名のメニュー Cmd+,)で選べます。
- テーマ:[OS に合わせる][ライト][ダーク]。OS の切り替えにその場でついていきます。
- フォント:本文のフォントと大きさ(6〜48)。Ctrl(Cmd)+ホイールでも。
- キーの割り当て:1 つの操作に 2 つまで。ひな形[vi・less 風]を選ぶと
jkgGnNmなどが付き、5j(5 行下)・120g(120 行目)のような数の前置きも使えます。.uwvkeysに書き出せば、Mac と Windows・Linux の間でも持っていけます。
ほかに、結果一覧に[ヒット+ブックマーク][ブックマークだけ][ヒットだけ]の切り替え、定義済み★の AND・NOT・OR のひな形、ステータスバーのファイル名から[コピー][フォルダー][ターミナル][アプリ]、ファイル指定の波かっこ '**/*.{txt,log}' が入りました。開いているログが外で切り詰められたり、ローテーションされたりしても落ちず、末尾追従がついていきます。
3. UwView Pro:Shift-JIS・EUC-JP・UTF-16 を UTF-8 の索引で
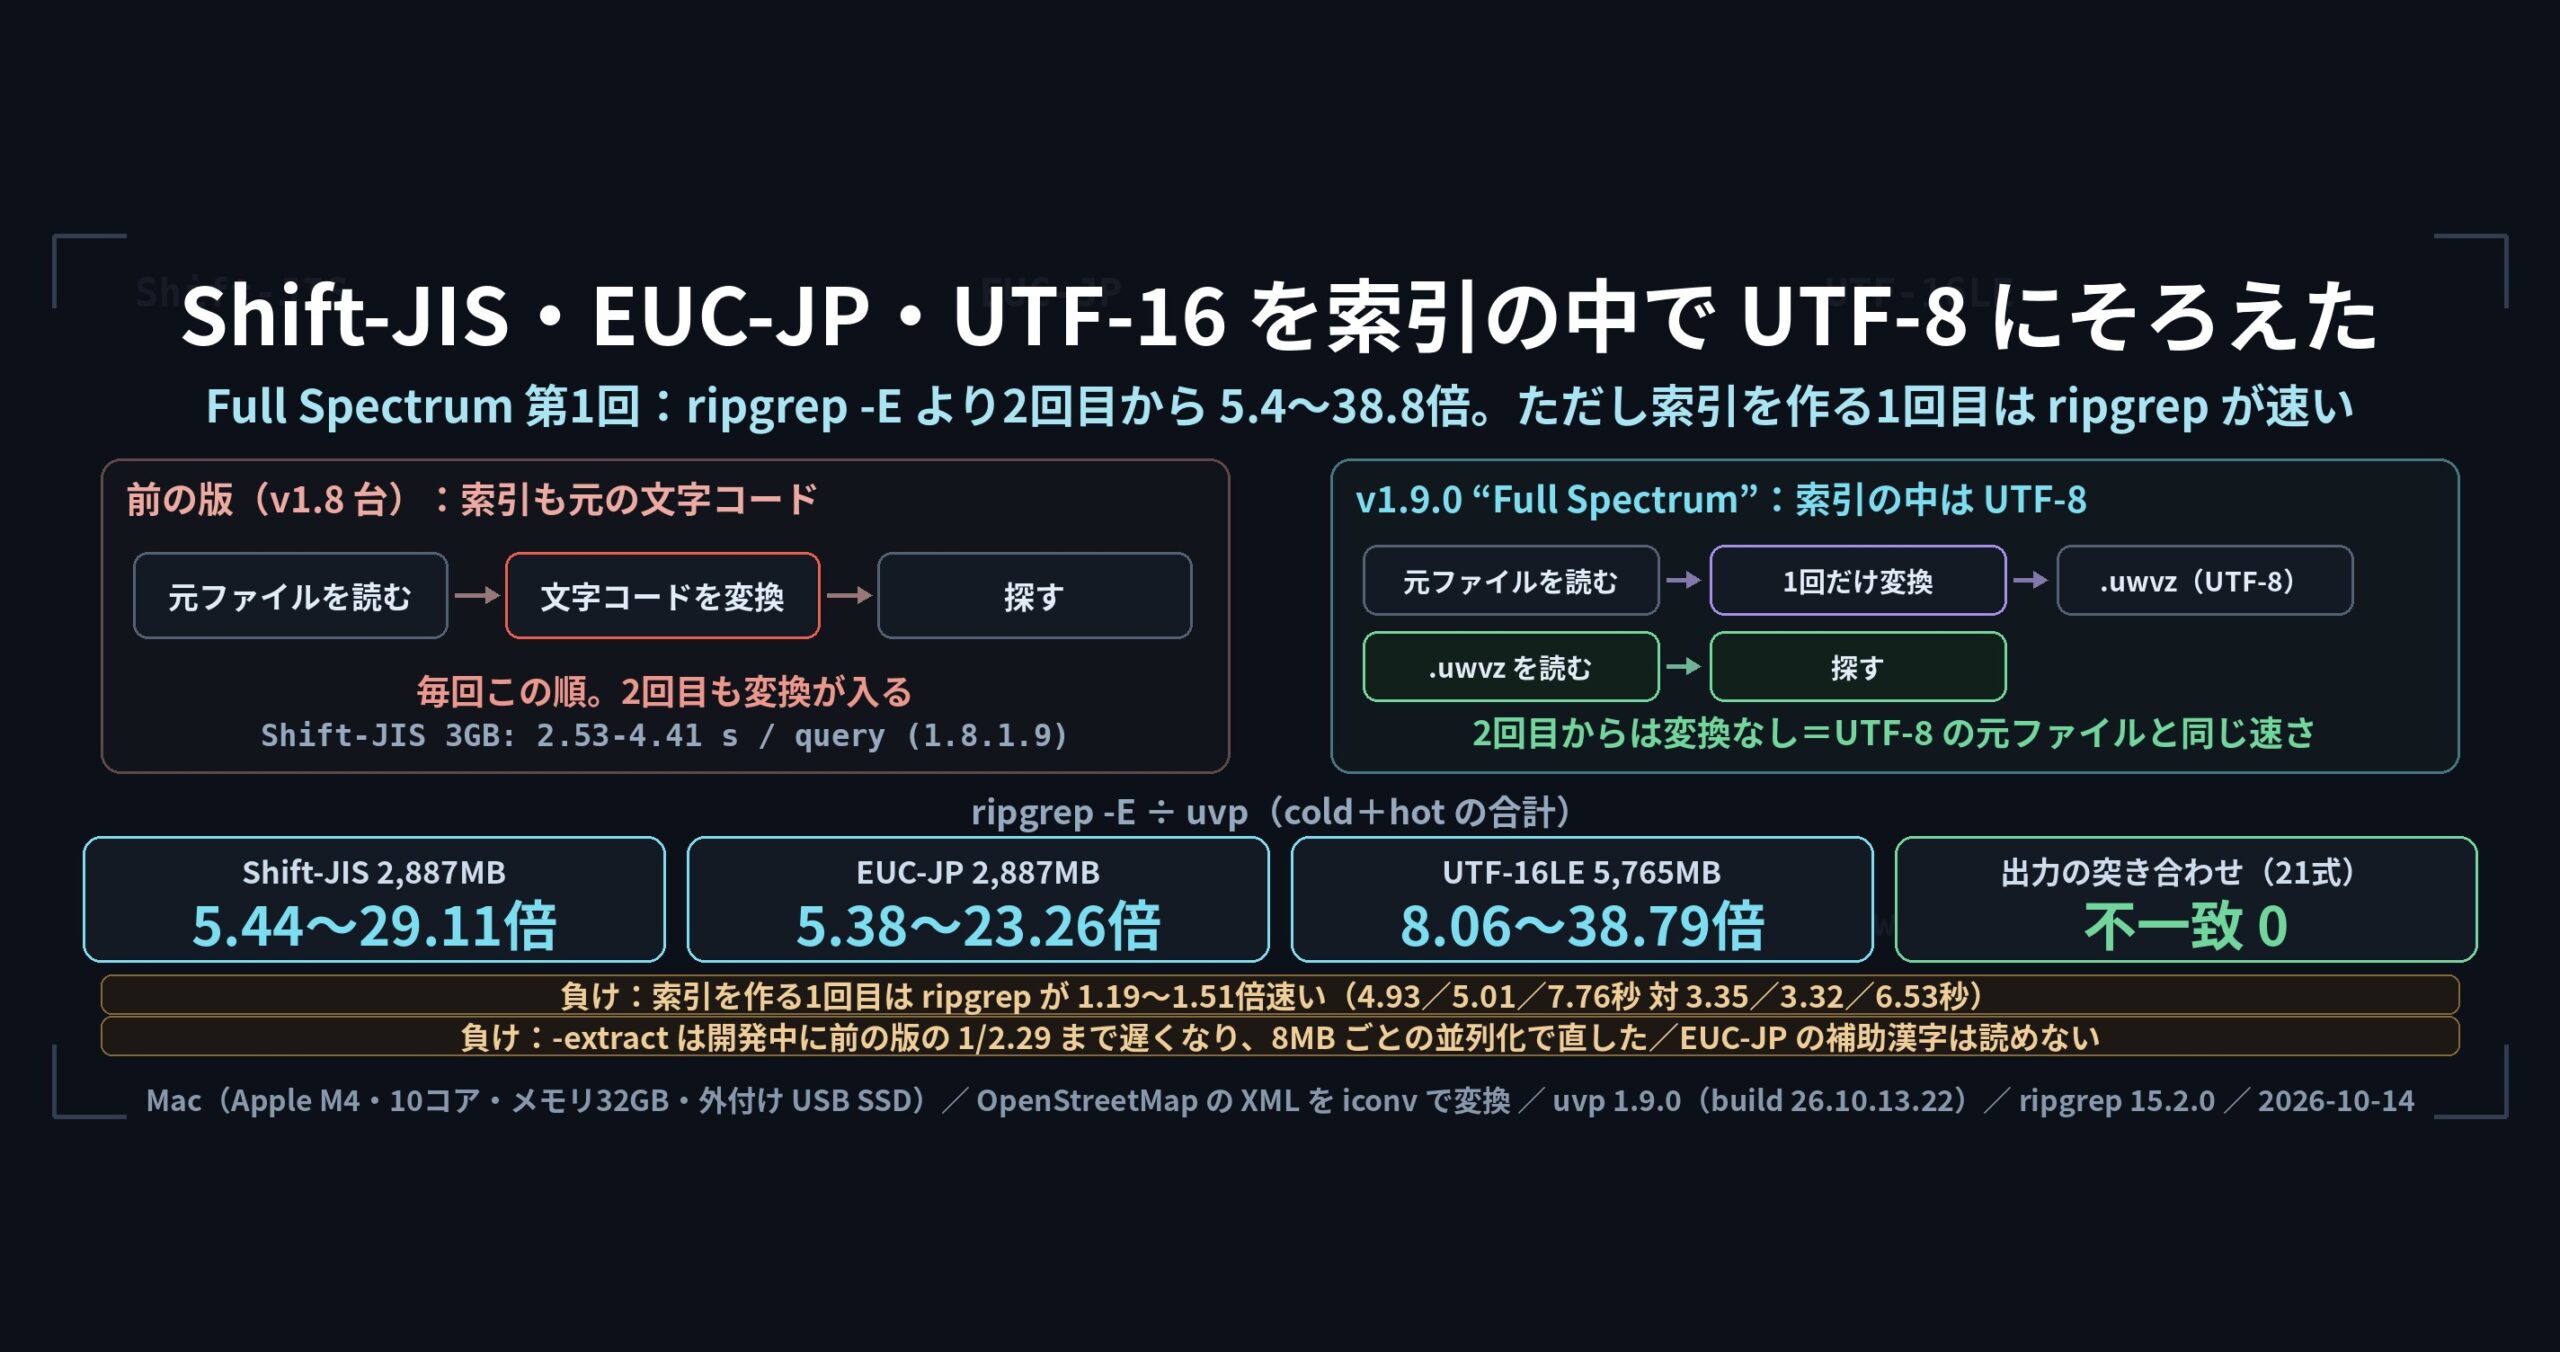
uvp は 1 回目に索引(.uwvz)を作り、2 回目からは索引を探します。v1.9.0 から、Shift-JIS・EUC-JP・UTF-16 のファイルは、索引の中では UTF-8 に変えて持ちます。
- 2 回目からは、検索のたびに文字コードを変えなくて済むので、UTF-8 のファイルと同じ速さで探せます。
- ripgrep は
rg -E shift_jisのように、毎回変換しながら読みます。 - 出力・表示は元の字のままです。
-extractで元の文字コードのファイルに戻せます。 - 索引の形が新しくなったので、前の版で作った
.uwvzは、初めて探すときに作り直します。
| 3GB・6GB の 1 本 | Mac:1 回目 uvp / ripgrep | Mac:2 回目から rg ÷ uvp | Linux(参考):1 回目 | Linux(参考):2 回目から |
|---|---|---|---|---|
| Shift-JIS 3GB | 4.93 秒 / 3.35 秒(同等) | 5.4〜29.1 倍 | 15.12 秒 / 1.82 秒(1/8.3) | 2.0〜13.0 倍 |
| EUC-JP 3GB | 5.01 秒 / 3.32 秒(1/1.51) | 5.4〜23.3 倍 | 15.41 秒 / 1.69 秒(1/9.1) | 2.0〜13.1 倍 |
| UTF-16LE 6GB | 7.76 秒 / 6.53 秒(同等) | 8.1〜38.8 倍 | 17.64 秒 / 3.17 秒(1/5.6) | 3.0〜15.3 倍 |
(7 パターン・1 回目と 2 回目の合計で比べた値。1 回目は索引の作成込み。出力は ripgrep と 1 バイトも違いません。Linux は動作確認のための参考値です。参考の Windows は、1 回目が ripgrep の 1/1.5〜1/2.3、2 回目からが 2.2〜14.1 倍でした。)
参考の Linux でも、2 回目からの uvp の hot は UTF-8 の元とほぼ同じ(A1 で 0.47 秒 対 0.54 秒)でした。
4. UwView Pro:複雑な検索も、Word・Excel・PDF も索引で
uvp は、ripgrep 1 本ではできない検索を、段を並べて書けます。範囲(-seq 開始,終了 -range)、段(-grep)、近い行(語1 -C N 語2)、集計(-uniq)、並べ替え(-sort)、伏せ字(-mask)、整形(-format … --csv)です。v1.9.0 では、2 回目からを速くする仕組み(行の骨格・ブロックの印・2 語目の突き合わせ)が入りました。Word・Excel・PDF も索引にするので、集計・範囲・整形まで使えます。
# Excel の経費を、費目ごとに数えて多い順に
uvp '経費/**/*.xlsx' '交通費|宿泊費|会議費' -E -uniq '(交通費|宿泊費|会議費)' -sort count
| 比べたもの(cold+hot・ripgrep ÷ uvp) | Mac | Windows(参考) | Linux(参考) |
|---|---|---|---|
| 3GB の 1 本(30〜32 項目の合計) | 2.56 倍 | 2.24 倍 | 1.50 倍 |
| 10GB の 1 本(30 項目の合計) | 2.51 倍 | 3.17 倍 | 1.96 倍 |
| 集計・並べ替え(3GB・10GB) | 4.2〜4.9 倍 | 2.0〜3.6 倍 | 1.4〜3.3 倍 |
| ログの 3 例(範囲+除外+伏せ字・近い行・CSV への収集。Linux カーネル 6 万本) | 2.35〜4.56 倍 | 1.26〜2.48 倍 | 1/2.85〜1/3.21(rg が速い) |
ripgrep の側は、同じことを ripgrep と perl・awk・sort・uniq を組み合わせて行った時間です。Windows・Linux は、正常に動くこと(正しさのテストがすべて合格、出力は ripgrep と不一致 0)を確かめるために流したもので、速さは機械も条件も違うので参考値です。
5. 正直に
- 測っていないマスがあります。 式の全部の組み合わせを測ったわけではありません。今の測定で「速い」と言えるのは、UTF-8 のプレーン(巨大・多数、CLI・GUI)、UTF-8 の圧縮(巨大・CLI)、Shift-JIS・EUC-JP・UTF-16 のプレーン(巨大・CLI)、複雑な検索(UTF-8)です。Word・Excel・PDF の速さ、文字コード×多数・×圧縮、GUI×圧縮は、まだ測っていません。
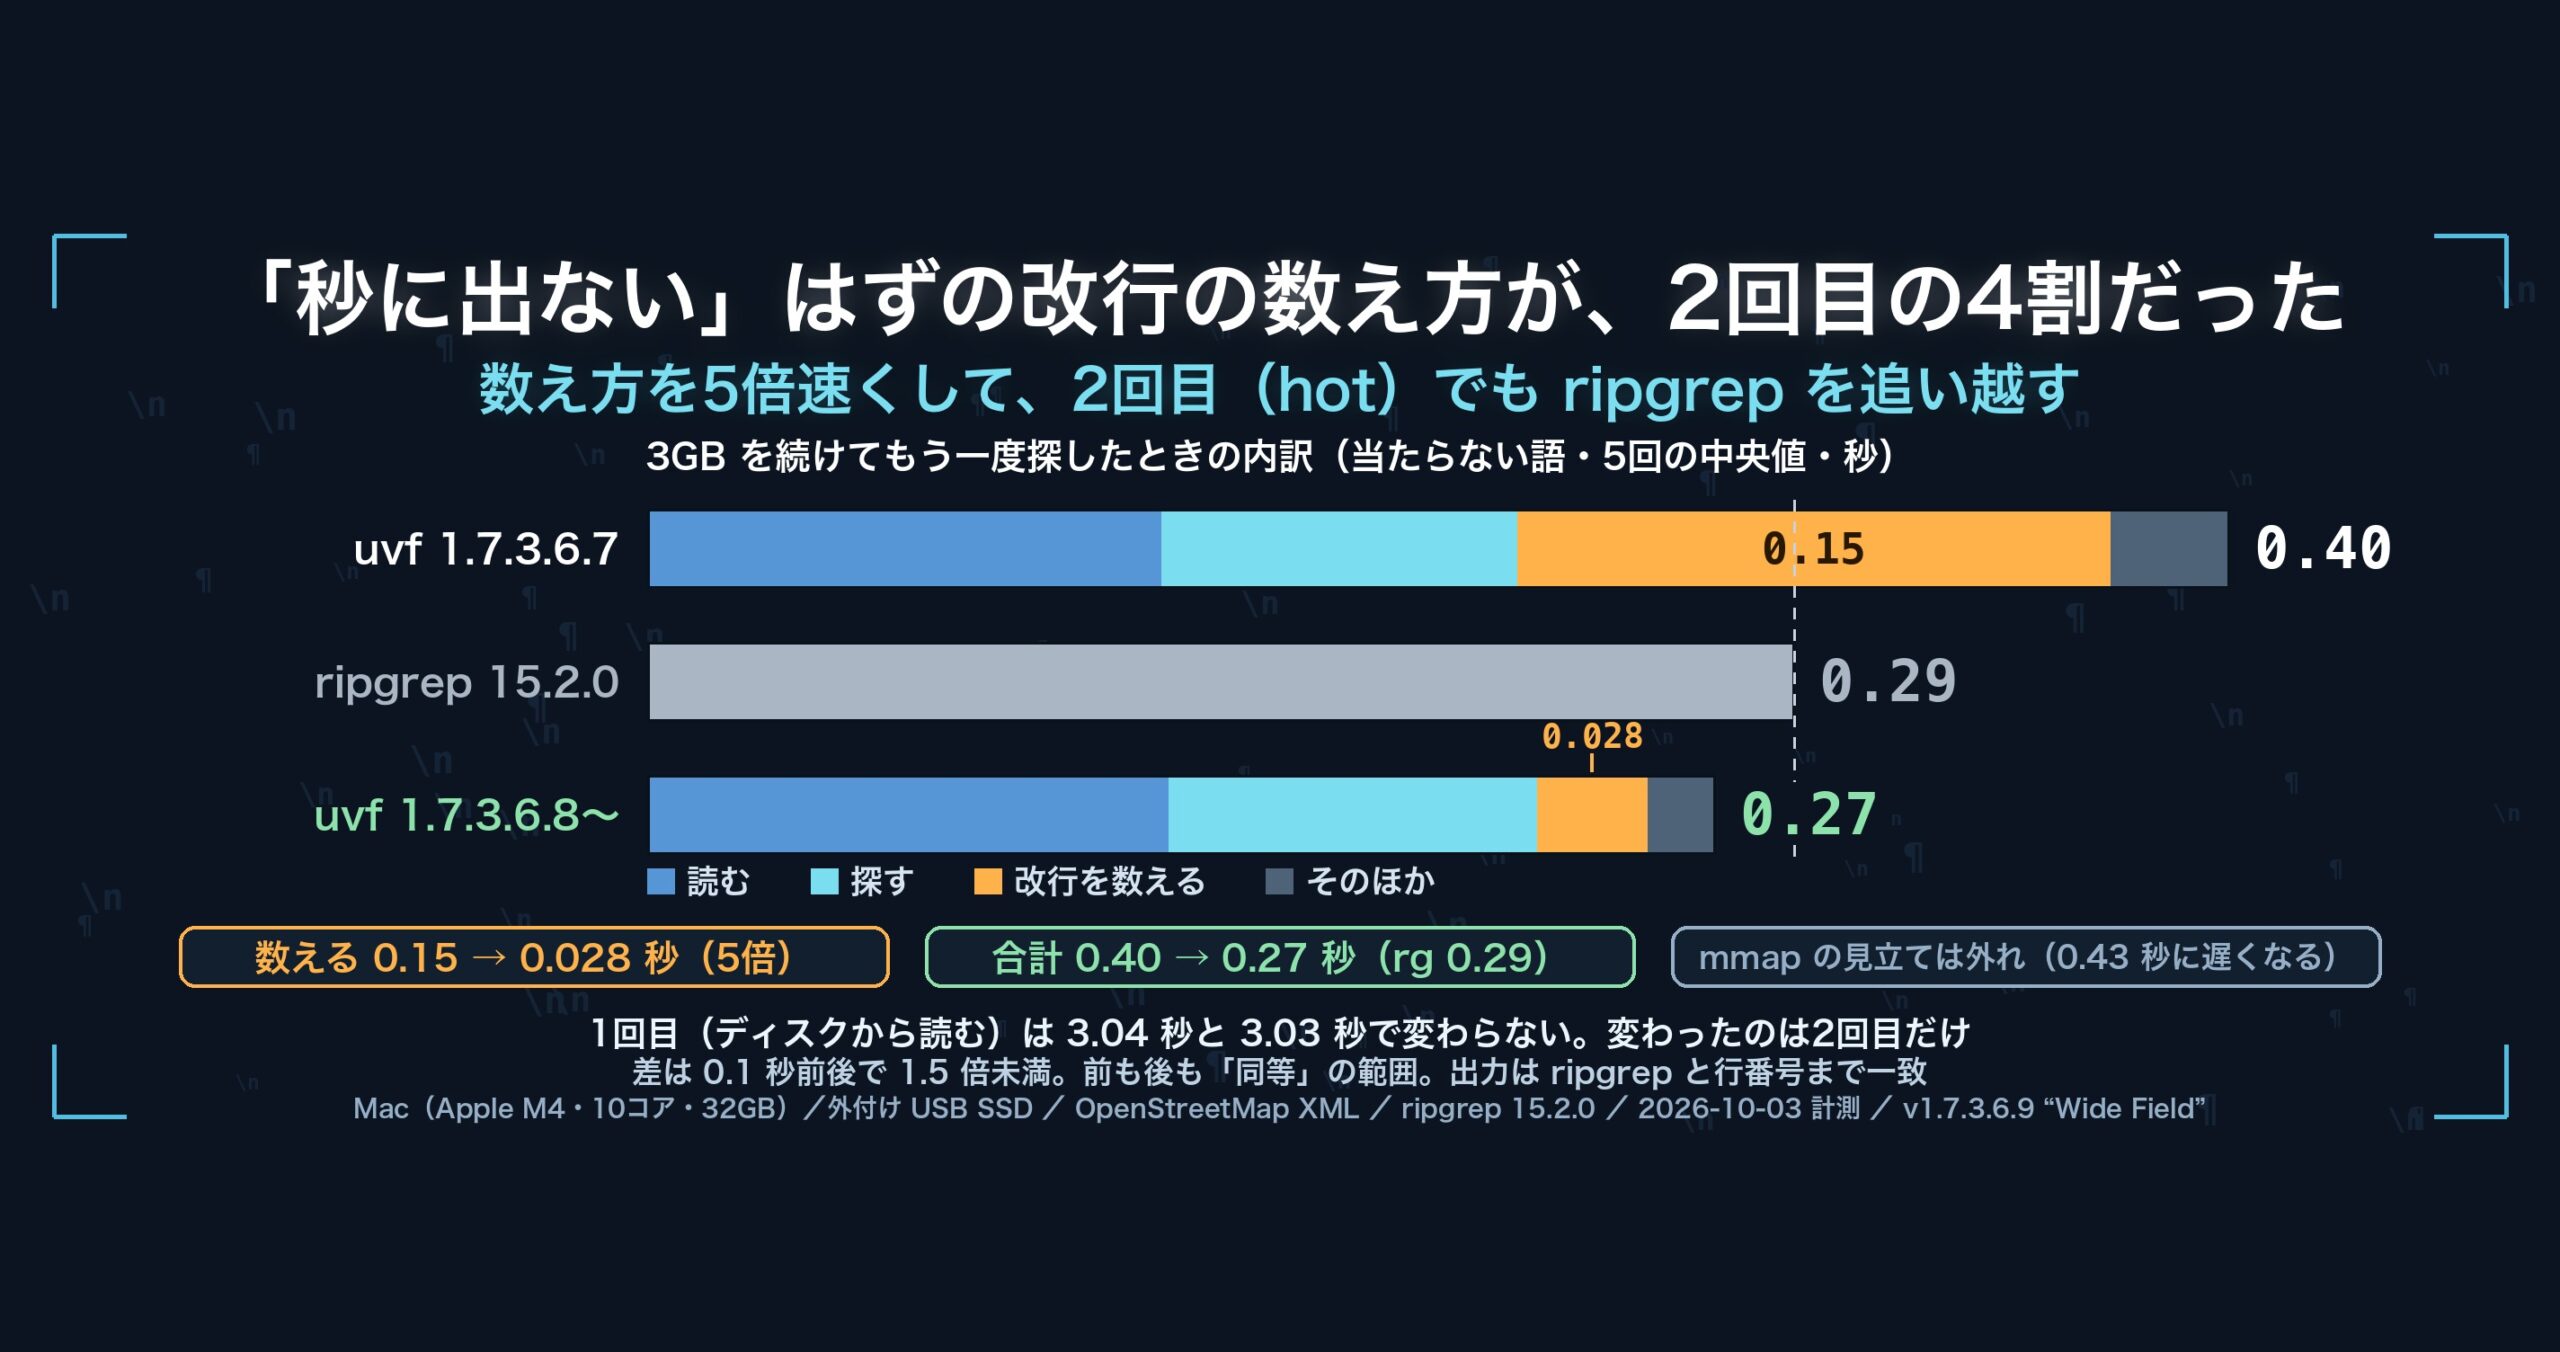
- 1 回目は、プレーンなら ripgrep と同じくらいです。 索引を作る分があるので、3GB のプレーンの
uvpの 1 回目は ripgrep の 1/1.3(Mac)でした。差が開くのは 2 回目からです。 - 1 回目(索引の作成込み)は、Shift-JIS・EUC-JP で ripgrep の 1/1.4〜1/1.7 ほどです(Mac で 3 回測った幅)。展開の速い lz4 の 1 回目込みは 1/1.4 です。参考の Windows・Linux では、1 回目込みの zst・lz4、複数のファイルを初めて束ねる測り方、Linux のログの 3 例(6 問中 5 問)で ripgrep が速い値が出ています。
- EUC-JP の補助漢字(JIS X 0212)は読めません(「・」になります)。
- 無料版
uvfは、1 本・複数ファイルで ripgrep と同等です(数倍速いのは索引を持つ Pro のほうです)。 - 秒数は 2026年10月14日に v1.9.0 を Mac(Apple M4・メモリ 32GB・外付け USB SSD)で測った値です。Windows(x64・16GB)・Linux(aarch64・2 コア・7GB)は正常に動くことの確認で、速さは参考値です。環境をまたいで秒数を比べないでください。
- ダウンロード:無料版・Pro のダウンロード
- リリースノート:UwView v1.9.0
- 使い方:UwView 操作ガイド・UwView Pro 操作ガイド・uvf コマンド操作マニュアル・uvp コマンド操作マニュアル
- UwView Pro(買い切りと月額の2通り・14日間の無料試用つき)