uvp コマンド操作マニュアル
UwView Pro v1.6.0 から、ターミナルで使える uvp コマンドが付きました。GUI と同じエンジン・同じ .uwvz を使うので、画面で見ていたのと同じ結果を、そのままスクリプトから取り出せます。
このページは全コマンドの一覧と、rg(ripgrep)・sed・sort・uniq との対比、そして実測値をまとめたものです。
uvp の特徴は3つです。
- 10GB を超えると
rgより数倍速い — 50GBの検索で 7.65倍、集計で 7.89倍、sedとの比較では最大 24.18倍(いずれも2回目・実測は §4 以降)。境界はファイルサイズではなく「2問目」で、rg は質問のたびに全体を読み直し、uvp は索引を残します - CLI から GUI へそのまま移行できる —
-openを付けるだけ。同じ.uwvzを使うので、渡した先でも待ちません(§6) - 画面に着いたあとは、何度でも自由に絞り直せる — 一覧の行をクリックすれば次の段。2段目以降は前段の範囲だけを見るので即座に返ります
数値の前提(重要)
このページの秒数は、すべて 2回目(.uwvzが既にある状態・hot) の値です。各項目はsync→sudo purge→ 10秒待機 → cold → 続けて hot の順に測り、rg も同じ条件の hot(直後の2回目)と比べています。uvpは初回に索引(.uwvz)を作ります(3GB 1.2秒・10GB 13.7秒・50GB 66秒=おおよそ 1.3秒/GB)。初回コストを含む比較と cold の値は uvp コマンドを付けました と 実測まとめ にあります。
測定環境: Mac M4・メモリ32GB・外付けUSB SSD・ripgrep 15.2.0・BSD sed・uvp 1.6.3(2026年9月17日)。データは OpenStreetMap 日本(XML)の 3GB / 10GB / 50GB。
出力は毎回rg/sedと1行ずつ突き合わせて一致を確認しています(78項目一致・不一致0)。
1. インストールと PATH 登録
UwView Pro をインストールしたら、アプリのメニュー ヘルプ → 「コマンドライン設定…」 を選びます。
| OS | 登録先 |
|---|---|
| macOS | /usr/local/bin/uvp(書けない場合は標準のパスワード画面) |
| Windows | ユーザーの環境変数 PATH にフォルダを追加(管理者権限は不要) |
| Linux | /usr/local/bin(権限が無ければ ~/.local/bin。ログインし直すと有効) |
uvp --version     # uvp 1.6.3
uvp --help        # 全コマンド
無料版 UwView にも同じ形で uvf が付きます(検索・-i・-E・-v・-open。索引は作りません。速さは rg とほぼ同じで、50GB の検索が 50.7秒 対 rg 55.4秒です)。
2. まず3つだけ
# 1. 探す(rg -n -F と同じ行が出る)
uvp huge.log 'ERROR'

# 2. 数える(sort | uniq -c | sort -rn | head の代わり)
uvp huge.log 'ERROR' -uniq 'code=([0-9]+)' -head 20

# 3. 置き換える(sed 's/A/B/g' の代わり。元ファイルは変更しない)
uvp huge.log 'old-host' -replace 'new-host' -out fixed.log
3. コマンドの形
uvp <ファイル> <検索語> [段…] [オプション]      調べる(主記法)
uvp <ファイル> '<検索語> | sort … | uniq …'     引用パイプ記法(同じ意味)
uvp convert <ファイル> [-out x.uwvz]           .uwvz を作る
uvp cat <ファイル> [-out …]                    本文を出す
uvp <ファイル.uwvz> -extract [txt|gz|zip]      元の形に戻す(無料)
uvp -open [<ファイル>]                         GUI を起動する
段は書いた順に実行されます(パイプと同じ考え方)。-uniq してから -sort count するのと、-sort してから -uniq するのは別の意味です。
4. 段(stage)— CLI ではこう書く
4-1. 検索
| やりたいこと | CLI | uvp |
|---|---|---|
| 固定文字列 | rg -n -F '東京' F |
uvp F '東京' |
| 大小無視 | rg -n -i -F tokyo F |
uvp F tokyo -i |
| 正規表現 | rg -n 'v="(a\|b)"' F |
uvp F 'v="(a\|b)"' -E |
| 単語一致 | rg -n -w 'id' F |
uvp F 'id' -w |
実測(2回目・.uwvz 再利用)
| ヒット(50GB) | 3GB | 10GB | 50GB | |
|---|---|---|---|---|
固定文字列 東京 |
94,979 | rg 0.33秒 / uvp 1.04秒(rgが3.15倍速い) | rg 11.23 / uvp 1.80(6.24倍) | rg 56.72 / uvp 7.41(7.65倍) |
大小無視 -i(HIGHWAY) |
11,693,479 | rg 0.62 / uvp 1.23(rgが1.98倍速い) | rg 11.98 / uvp 1.90(6.31倍) | rg 56.59 / uvp 16.02(3.53倍) |
正規表現 -E(k="highway[^"]*") |
11,529,957 | rg 0.53 / uvp 1.33(rgが2.51倍速い) | rg 10.94 / uvp 1.87(5.85倍) | rg 55.50 / uvp 15.03(3.69倍) |
正規表現・行頭つき ^ *<tag k="name" |
3,337,643 | rg 0.48 / uvp 1.09(rgが2.27倍速い) | rg 11.05 / uvp 1.95(5.67倍) | rg 55.78 / uvp 7.04(7.92倍) |
当てはまらない行 -v |
48,984,614 | rg 2.10 / uvp 3.61(rgが1.72倍速い) | rg 11.09 / uvp 1.99(5.57倍) | rg 57.78 / uvp 29.15(1.98倍) |
3GB がキャッシュに載った2回目は、どの形でも rg が速いです(uvp は起動と索引読み込みの固定費 0.6〜1.0秒を必ず払います)。同じ 3GB でも cold なら -i・-E で uvp が 2.2〜2.9倍速く、cold と hot を足した2回計では 1.3〜1.7倍 uvp の勝ちです。10GB からは hot でも 4.3〜6.3倍、50GB では出る行が 1,000万を超える -i・-E・-v で倍率が下がります(uvp はヒットを保持するため)。正規表現の速さは式の形ではなくヒット件数で決まります(50GB: 行頭つき 334万件 7.04秒、固定文字列 9.5万件 7.41秒)。
4-2. 絞り込み(Drill-down)— 語を並べるだけ
# CLI: パイプでつなぐ
rg -n -F 'k="amenity"' F | rg -F 'v="parking"'
rg -n -F 'k="amenity"' F | rg -v -F 'v="parking"'     # 除外

# uvp: 語を並べる。2語目以降は前段の ±N の中を再検索する
uvp F 'k="amenity"' 'v="parking"'
uvp F 'k="amenity"' 'v="parking"' -v                  # 除外
uvp F 'k="amenity"' -C 3 'k="name"'                   # 前後3行の中に2語目
実測(2語の絞り込み・2回目): 3GB rg 0.46秒 / uvp 1.04秒(rgが2.26倍速い)、10GB rg 10.94 / uvp 1.77(6.18倍)、50GB rg 56.09 / uvp 6.41(8.75倍)。v1.6.2 から2段目以降は前段の結果だけを見るので、50GB でも1段 0.24秒です。
-C N は「前後N行を表示する」ではなく「前後N行の中に次の語があるものだけ残す」です。rg -C は文脈を出すだけなので、CLI に同じ意味の1コマンドはありません。
4-3. 集計(Tally)
# CLI
rg -N -o 'k="amenity" v="([^"]+)"' -r '$1' F | LC_ALL=C sort | uniq -c | sort -k1,1nr | head -20

# uvp(キーは正規表現の第1キャプチャ群)
uvp F 'k="amenity"' -uniq 'v="([^"]+)"' -head 20
uvp F 'k="amenity"' -uniq 'v="([^"]+)"' -sort count -head 20   # 件数順
uvp F 'k="amenity"' -uniq 'v="([^"]+)"' -sort value -head 20   # 値順
uvp F 'ERROR' -uniq 'code=([0-9]+)' --csv                      # CSV / --json も可
実測(上位20・2回目): 3GB rg 0.44秒 / uvp 1.02秒(rgが2.32倍速い)、10GB rg 10.98 / uvp 1.94(5.66倍)、50GB rg 55.36 / uvp 7.02(7.89倍)。値順(-sort value)は 50GB で rg 62.59 / uvp 6.86(9.12倍)。
4-4. 順序(Sequence)
uvp F -seq 'login,timeout,restart' # この順に現れる流れだけ
grep は語の集合しか見られないので、CLI に相当機能はありません(awk で状態機械を書くことになります)。3GB 1.18秒・10GB 2.85秒・50GB 13.20秒(2回目)。
4-5. 先頭・末尾
uvp F '東京' -head 10      # 先頭10件
uvp F '東京' -tail 10      # 末尾10件
検索の直後に書いた -head N は、ファイルの先頭から読み、N 件見つけた時点で止めます(v1.6.2 から)。
出力は rg … | head -N と1バイトも変わらず、何度実行しても同じです。
| 「東京」・2回目 | 3GB | 10GB | 50GB |
|---|---|---|---|
rg \| head -10 ⇔ -head 10 |
rg 0.06秒 / uvp 0.44秒 | 0.08 / 0.45 | 0.05 / 0.55(rg の勝ち・どちらもサブ秒) |
rg \| tail -10 ⇔ -tail 10 |
rg 0.34 / uvp 0.97 | 10.96 / 1.63(6.72倍) | 56.04 / 6.37(8.80倍) |
head は rg が先頭 N 件で打ち切れるので rg の勝ちです(uvp は起動と索引読み込みの固定費が乗る。差は 0.4〜0.5秒)。tail は末尾を知るために全件走査が要るので uvp が勝ちます。sort | head(実務でよくある形)も sort が全件を要求するので同じ側です。
-uniq・-sort・-seq の後ろに書いた -head N は、これまでどおり「並べ替えた後の先頭 N 行」です(ランキングの上位20件など)。
v1.6.1 までの
-headは全件検索してから切っていたので、50GB で 6.7〜7.0秒かかっていました。
5. オプション
-limit N — 保持する最大ヒット数(メモリを守るための指定)
uvp F 'ERROR' -limit 1000      # 1000件たまった時点で検索を止める
uvp F 'ERROR' -limit none      # 無制限(0 でも同じ・既定)
既定は無制限です(v1.6.2 から。それまでは 100万件でした)。GUI の設定と共有していて、-limit を書いたときだけそちらが優先されます。
上限に当たると 終了コード 2 と警告を返します。件数は全シャードの合計で数えます。
このときどの位置のヒットが残るかは決まりません(並列で走るシャードのうち、先に埋まった分が残ります)。
先頭 N 件が欲しいときは -limit ではなく -head N を使ってください(前項。rg | head -N と同じ結果です)。
-limit は「大きすぎる結果でメモリを使い切らないための保険」です。
| 50GB・「東京」(94,979件)・2回目 | 秒 | 備考 |
|---|---|---|
-head 10 |
0.55秒 | 先頭から10件見つけた時点で止まる(rg \| head -10 は 0.05秒) |
-limit 1000 |
0.68秒 | 1000件たまった時点で止まる(どの1000件かは決まらない・exit 2。rg \| head -1000 は 0.09秒) |
| 既定(無制限・全件) | 7.41秒 | rg 56.72秒(7.65倍) |
-out <ファイル> — 出力先
uvp F 'ERROR' -out hits.txt          # テキスト
uvp F 'ERROR' -out hits.txt.gz       # .gz / .zip は圧縮して書き出す
uvp F 'ERROR' -out hits.txt --force  # 既存ファイルを上書き(既定は拒否)
実測(2回目): テキスト rg -n > file 50GB 55.36秒 / uvp 5.92秒(9.35倍)、10GB 22.23 / 1.80(12.35倍)。圧縮 rg \| gzip > out.gz 50GB 71.91秒 / uvp -out out.txt.gz 6.17秒(11.65倍)。
その他
| オプション | 意味 | CLI の対応 |
|---|---|---|
--no-line-number |
行番号を付けない | sed -n '/語/p' の出力と一致 |
--csv / --json |
集計結果の形式 | — |
-open |
先頭に書けば GUI で実行/末尾なら実行後に GUI でも開く | — |
--no-line-number の実測(sed との比較・2回目): 3GB sed 9.91秒 / uvp 1.05秒(9.44倍)、10GB sed 13.11 / uvp 1.61(8.14倍)、50GB sed 145.35 / uvp 6.01(24.18倍)。sed は 1行ずつ処理するので 3GB でも 10秒かかります。
6. CLI から GUI へ — -open(uvp のいちばんの特徴)
uvp は ターミナルで絞り込んだ続きを、そのまま GUI で開けます。同じエンジン・同じ .uwvz を使っているので、渡した先でも待たされません。
# 末尾に -open … CLI で実行して結果を出し、そのうえで GUI にも渡す
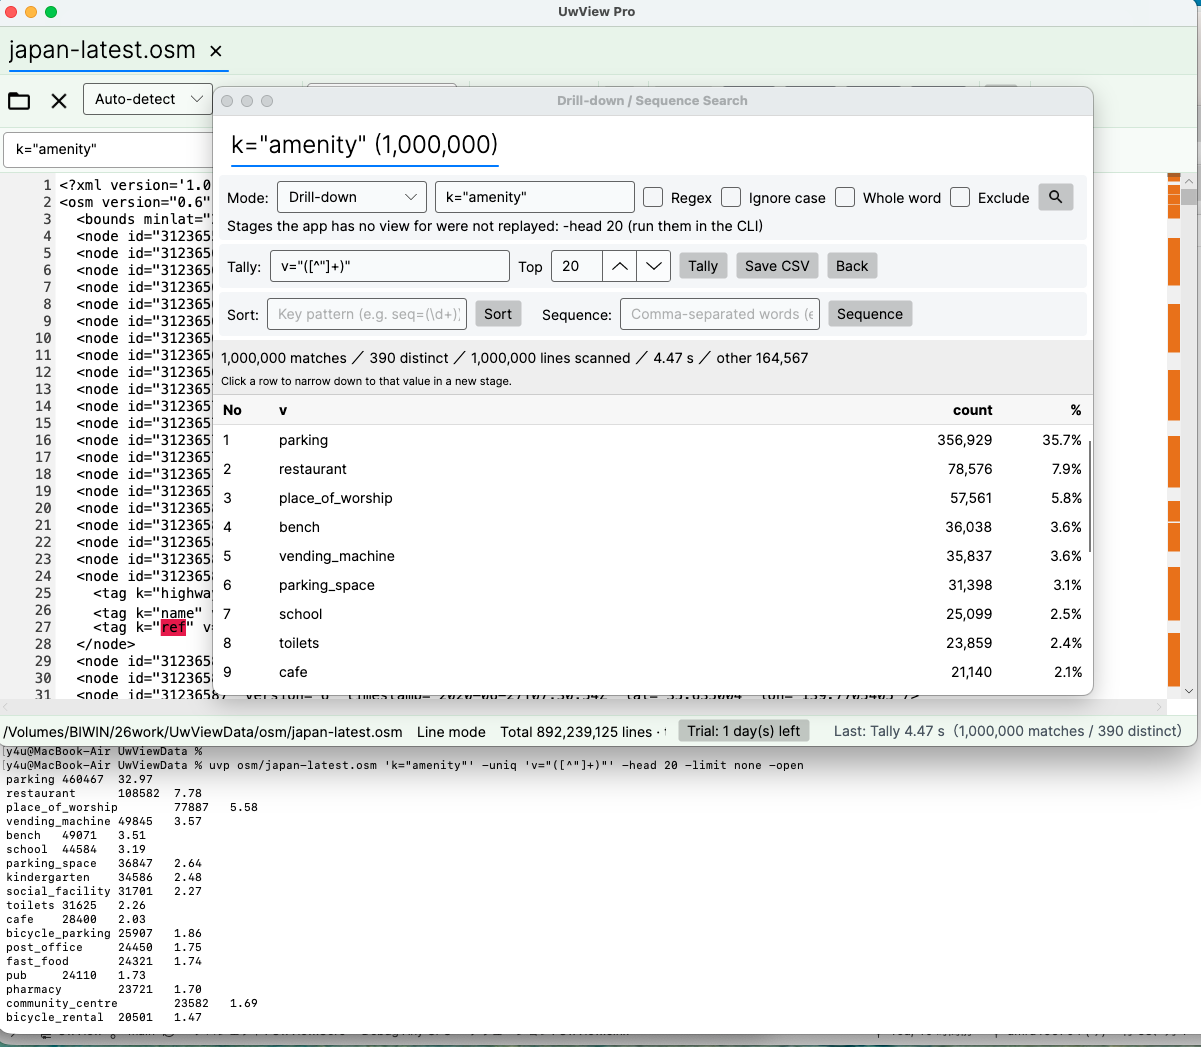
uvp osm/japan-latest.osm 'k="amenity"' -uniq 'v="([^"]+)"' -head 20 -limit none -open

# 先頭に -open … CLI では実行せず、GUI 上で実行して画面で見る
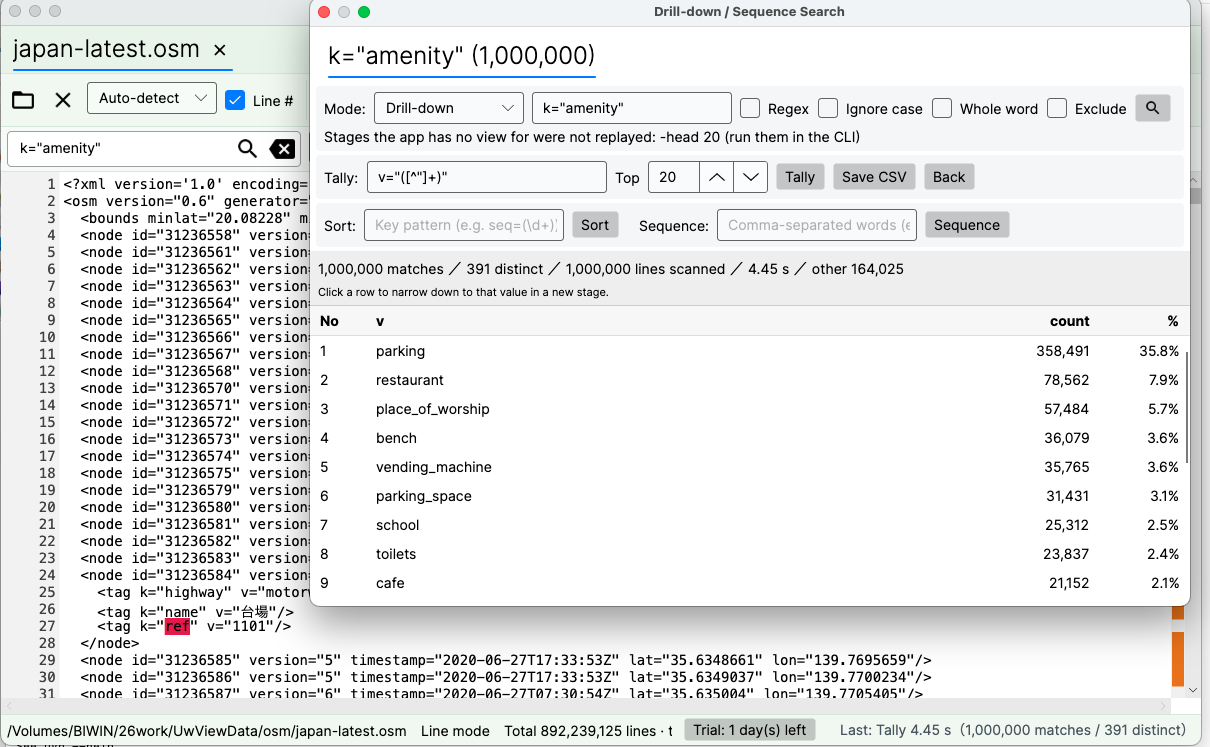
uvp -open osm/japan-latest.osm 'k="amenity"' -uniq 'v="([^"]+)"' -head 20 -limit none
末尾に付けた場合 — ターミナルに結果が出たうえで、同じ集計が GUI にも並びます。
先頭に付けた場合 — 実行そのものを GUI が受け持ちます。あとはマウスで続けられます。
ここからが本題 — 画面に着いたあとが速い
渡された先の GUI では、同じファイルに何度でも質問を足せます。
- 一覧の行をクリックすると、その値で次の段に絞り込まれます(画面の「Click a row to narrow down to that value in a new stage.」)。
parkingを押せばk="amenity"かつparkingの段が新しいタブで開きます - 2段目以降は前段の範囲だけを見るので待ちがありません。条件を変えたくなったら、そのタブに戻るだけ。パイプを組み直して 51GB を読み直す必要はありません
- モードを Drill-down / Sequence で切り替え、
Tally(集計)・Sort・Save CSVもその場で押せます - 51GB・8.9億行のファイルで、画面に出ている集計は 4.45秒(スクリーンショットのステータス「Last: Tally 4.45 s」)
つまり uvp の使い方は、こうなります。
スクリプトや cron では CLI(10GB超で
rgの数倍速い)。あたりが付いたら-openで GUI に渡して、結果を見ながら何度でも絞り直す。
CLI 単体でも rg より速く、GUI に渡してからはマウスだけで何度でも質問を変えられる——この行き来ができるのが、grep / rg のパイプには無い点です。
7. 置換 — -replace(Edit ライセンス)
# CLI
sed 's/東京/TOKYO/g' F > out.txt
sed -E 's/v="(bus_stop|traffic_signals)"/v="X_\1"/g' F > out.txt
rg -N -F --passthru '東京' -r TOKYO F > out.txt

# uvp(元ファイルは変更しない。全文を出力する)
uvp F '東京' -replace TOKYO -out out.txt
uvp F 'v="(bus_stop|traffic_signals)"' -E -replace 'v="X_$1"' -out out.txt
-E と併用すると $1 $2 で捕捉群を差し込めます($$ は $ そのもの)。出力は sed / rg --passthru とバイト単位で一致することを確認しています。
実測(全文を書き出すまでの時間・uvp 1.6.2・2026年9月16日の計測。v1.6.3 では置換の経路に変更がないため再計測していません)
| 3GB | 10GB | 50GB | |
|---|---|---|---|
uvp -replace |
4.57秒 | 13.47秒 | 69.75秒 |
sed 's/A/B/g' |
14.94秒(3.27倍) | 26.51秒(1.97倍) | 187.74秒(2.69倍) |
rg --passthru -r |
7.06秒(1.54倍) | 26.89秒(2.00倍) | 146.65秒(2.10倍) |
uvp -E -replace '$1' |
4.17秒 | 14.08秒 | 69.95秒 |
sed -E(後方参照つき) |
24.81秒(5.95倍) | 78.36秒(5.57倍) | 405.52秒(5.80倍) |
後方参照つきの置換は sed の約6倍です。50GBで sed が 6分45秒、uvp が 1分10秒。
置換の件数は「行」ではなく「箇所」を数えます(3GBの 東京: 検索ヒット 11,274行 に対し置換 11,361箇所。87行に2箇所以上あった、ということです)。
-replaceは Edit ライセンス(14日間の無料試用で使えます)の機能です。ファイル自体は書き換えず、全文を出力します。
8. .uwvz — 一度作れば、元ファイルが無くても探せる
uvp convert huge.log              # .uwvz を作る(3GB 1.2秒・10GB 13.7秒・50GB 66秒)
uvp huge.log.uwvz 'ERROR'         # 元ファイルが無くても検索できる
uvp huge.log.uwvz -extract -out restored.log   # 元の形に戻す(無料機能)
- 大きさは元の 1/9〜1/12(3GB→0.25GB、50GB→5.74GB)。gzip とほぼ同じ大きさで、作るのは gzip より5倍速い
gzipと違い、戻さずにそのまま検索できます(50GB で 5.81秒・2回目。rgが元ファイルを走査する 73.32秒の 12.6倍)。.gzを直接指定することもでき(uvp f.gz '語')、初回に.uwvzを作って2回目から再利用します(50GB: 初回 120.26秒・2回目 6.88秒)-extractはライセンス不要。3GBで 3.55秒、元ファイルとバイト一致(v1.6.2 計測)
詳しくは gzip の代わりに .uwvz で置いておく。
9. スクリプトから呼ぶ
#!/usr/bin/env bash
if uvp /var/log/app.log 'FATAL' -limit 100 -out /tmp/fatal.txt; then
  mail -s "FATAL found" ops@example.com < /tmp/fatal.txt
fi
| 終了コード | 意味 |
|---|---|
| 0 | ヒットあり |
| 1 | ヒットなし(grep と同じ) |
| 2 | エラー、または上限に当たって打ち切った |
- 進捗・診断は stderr、データは stdout(パイプに流しても安全)
- 出力が大きくなるときは
-outでファイルに書いてください。メモリを守りたいときは-limitで上限を決めます(メモリはヒット数に比例します)。先頭 N 件だけ見たいときは-head Nです
10. uvp が向かない場面(正直な話)
- 3GB 程度で、ファイルが OS のキャッシュに載っているとき。2回目の素の検索は rg が 3.15倍速く、
-i1.98倍・-E2.51倍・2語の絞り込み 2.26倍、いずれも rg の勝ちです(差は 0.6〜0.7秒)。ただし同じ 3GB でも cold(再起動直後・数日ぶりのログ・USB HDD)なら uvp が 2.2〜2.9倍速く、cold と hot を足した2回計では-i・-E・絞り込み・集計で uvp が 1.3〜1.7倍です - 1回しか聞かないとき。索引を作る意味がありません。
.uwvzが無い状態からの1問目は全サイズでrgが 1.2〜1.4倍速い(差の実体は索引作成) - 先頭 N 件だけ欲しいとき。
rg | headは N 件で打ち切れるので、全サイズで rg が速い(どちらもサブ秒) - パイプの途中に挟むとき。
uvpは.uwvzを中心にした「同じファイルに何度も聞く」道具です。他のコマンドへ流す1回きりの処理は CLI が素直です
逆に効くのは、同じファイルに2問目を投げるときです。10GB からは hot でも 4.3〜6.3倍、50GB では 2〜24倍速くなります(-head だけは rg の勝ち)。
11. 測定条件と再現
- 機材: Mac M4・メモリ32GB・外付けUSB SSD(内蔵SSDならすべて速くなります)
- データ: OpenStreetMap 日本(XML)3,032,812,644 / 10,255,315,281 / 51,254,526,392 バイト
- 比較対象: ripgrep 15.2.0・BSD sed・
sort・uniq(rg は--no-config --color never)。uvf/uvp 1.6.3・2026年9月17日 - 各項目は
sync→sudo purge→ 10秒待機 → cold → 続けて hot。このページは hot(2回目・.uwvz再利用)の値で、rg も同じ hot と比べています。cold と2回計は 実測まとめ - 出力は全項目で
rg/sedと1行ずつ突き合わせ、78項目すべて一致・不一致0(置換・-extractは 9月16日の v1.6.2 計測)
環境によって数字は変わります。違う結果になった方は お問い合わせ から教えてください。確認のうえ、このページを直します。
関連
- uvp コマンドを付けました — ripgrep と同じ答えを、10GBで7倍速く。3GBも、冷えていれば勝ちます(初回コミ込みの比較)
- CLIコマンド → UwView Pro 対応表(GUI 側の対応)
- UwView Pro 操作ガイド(GUI のマニュアル)
- ダウンロード(14日間の無料試用キーもこちら)