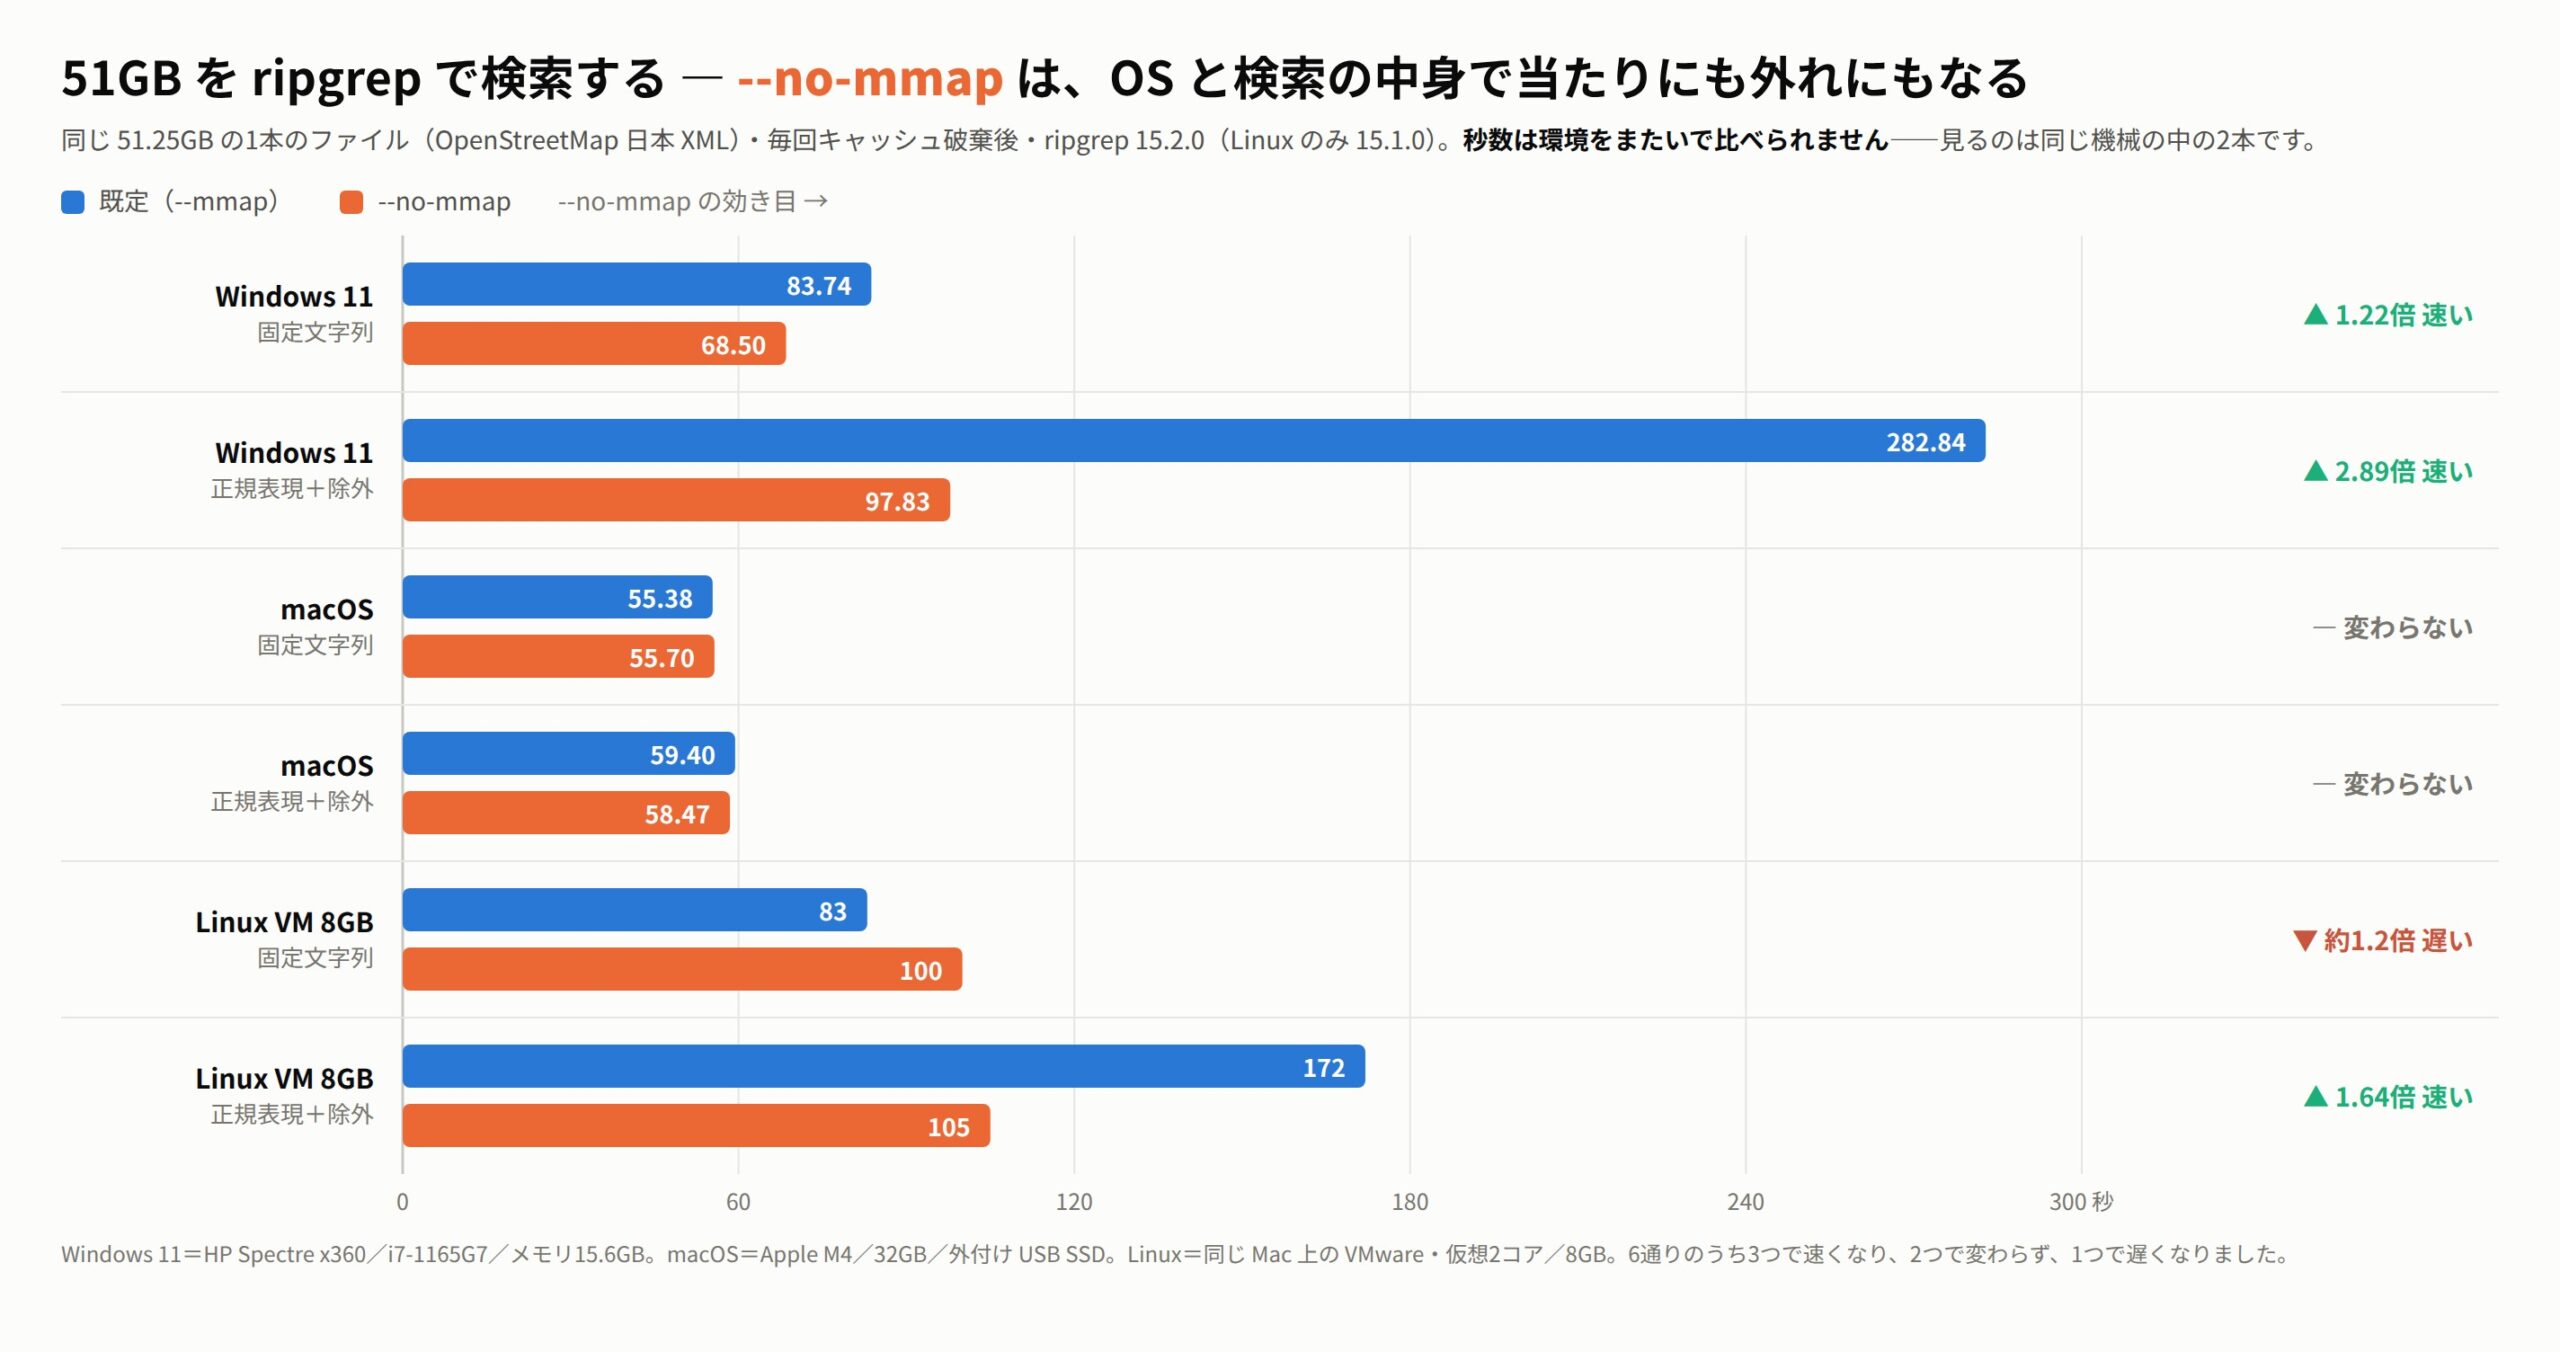
51GB のファイルを ripgrep で検索するとき、--no-mmap を付けると速くなることがあります。Windows では最大 2.89倍。Mac では何も変わりません。Linux では、検索の中身によって速くも遅くもなります。
これは ripgrep の欠陥の話ではありません。既定のメモリマップ読みは、多くの場合いちばん良い選択です。 ただ「多くの場合」であって、いつでもではなかった、という話です。
先に結論
同じ 51.25GB の1本のファイル(OpenStreetMap 日本を XML に展開したもの・51,254,526,392 バイト)に、
同じ2種類の検索を掛けました。すべてキャッシュを捨てた直後(コールド)の値です。
| 環境 | 検索 | 既定(--mmap) |
--no-mmap |
効き目 |
|---|---|---|---|---|
| Windows 11 | 固定文字列 | 83.74秒 | 68.50秒 | 1.22倍 速い |
| Windows 11 | 正規表現+除外 | 282.84秒 | 97.83秒 | 2.89倍 速い |
| macOS | 固定文字列 | 55.38秒 | 55.70秒 | 変わらない |
| macOS | 正規表現+除外 | 59.40秒 | 58.47秒 | 変わらない |
| Linux(仮想機・メモリ8GB) | 固定文字列 | 約83秒 | 約100秒 | 約1.2倍 遅い |
| Linux(仮想機・メモリ8GB) | 正規表現+除外 | 約172秒 | 約105秒 | 1.64倍 速い |
6通りのうち、3つで速くなり、2つで変わらず、1つで遅くなりました。
読み取れることは3つです。
- Mac は何も考えなくていい。 どちらでも同じです。既定のままで最善が出ています。
- Windows の 51GB は、既定が不利。 とくに重い検索では3倍近く損をします。
- Linux は検索の中身で逆転する。 軽い検索なら既定が速く、重い検索なら
--no-mmapが速い。
なぜ測ることになったのか
もともとは自分たちの CLI(UwView の無料版に付いている uvf)を ripgrep と比べていました。
3GB・10GB・50GB を Mac・Windows・Linux で測っていたところ、Windows の 50GB だけが妙だったのです。
同じ7種類の検索を掛けた合計で、Windows と Mac の比は 3GB が 1.09倍、10GB が 1.45倍。
機械の差として自然な範囲です。ところが 50GB だけ 2.25倍に跳ね上がりました。
しかも内訳を見ると、-E -v(正規表現で「当てはまらない行」を出す)の1項目が 283秒——
Mac の 58秒に対して 4.9倍です。
「機械が遅いから」では説明がつきません。サイズが上がるほど比が悪化する理由がないからです。
それで、切り分けの計測を書きました。
測り方
- ファイル: OpenStreetMap 日本の XML、51,254,526,392 バイトの1本
- 検索1(固定文字列):
rg -n -F '東京' <file>— ヒット 94,979行 - 検索2(正規表現+除外):
rg -n -v '^ +<' <file>— ヒット 3行 - ripgrep 15.2.0(Linux のみ 15.1.0)
- 毎回キャッシュを捨てて10秒待ってから測る(macOS は
sudo purge、Linux はdrop_caches、Windows は RAMMap の-Etを管理者権限で) - 時間は同じスクリプトで秒まで記録。出力の行数も毎回記録し、
--mmapと--no-mmapで一致することを確認
環境は次のとおりです。秒数を環境またぎで比べないでください。 見るのは同じ機械の中の2本です。
| macOS | Apple M4 / メモリ32GB / 外付け USB SSD |
| Windows 11 | HP Spectre x360(Core i7-1165G7・4コア8スレッド・15W級)/ メモリ15.6GB / Intel Optane H20 with SSD 512GB |
| Linux | 上記 Mac 上の VMware・仮想2コア / メモリ8GB |
犯人はディスクでも CPU でもなかった
Windows で先に疑ったのは、ファイルの置き場所と断片化でした。違いました。
ツールを通さずに同じ 3GiB を読むと、51GB ファイルの先頭 1159 MB/s・中間 1134 MB/s・末尾 1168 MB/s。
きれいに揃っています。このディスクは素で 1.1GB/s 出るので、51.25GB を読むだけなら約45秒が下限です。
次に疑ったのは CPU の熱だれです。15W の薄型ノートですから、5分近い連続負荷なら落ちてもおかしくない。
これも違いました。 クロックは開始前も終了後も 2803MHz。3GB の同じ検索を5回続けても、
2回目以降は 7.1秒前後で一定です。落ちません。
残ったのが読み方でした。そして --no-mmap を付けた瞬間、282.84秒が 97.83秒になりました。
なぜこうなるのか(ここからは推測です)
メモリマップは、ファイルをメモリのように見せる仕組みです。実際にはページに触るたびに OS が
ディスクから読み込みます。ファイルがメモリに収まっていれば、これは非常に効率的です。
コピーが1回減りますから。
問題は収まらないときです。51.25GB は、Windows 機の 15.6GB にも Mac の 32GB にも収まりません。
すると読んでいるあいだ中、ページを入れては捨て、入れては捨て、を繰り返すことになります。
この出し入れの代償が、OS によって違うのだろう——というのが、いまのところの見立てです。
ただし正直に書いておくと、これは測定結果から逆算した説明で、確かめたわけではありません。
とくに Linux で「軽い検索だと既定が速く、重い検索だと --no-mmap が速い」と逆転する理由は、
きれいに説明できていません。ご存じの方がいたら教えてください。
実用の指針
ここまでの結果を、そのまま使える形にすると次のようになります。
Windows で 10GB を超える1本のファイルを ripgrep で検索するなら、--no-mmap を一度試してください。
付けるのは1語です。損はしません。
rg --no-mmap -n 'パターン' huge.log
Mac では何もしなくて構いません。 差がありません。
Linux では、重い検索(正規表現・-v・-i の組み合わせ)のときだけ試す価値があります。
単純な固定文字列なら、既定のままのほうが速いという結果でした。
繰り返しますが、これは ripgrep を責める話ではありません。 既定が mmap なのは、
ふつうの使い方——ソースツリーを再帰的に検索する、数MBから数GBのログを見る——では正しい選択です。
今回の条件は「メモリに収まらない1本のファイル」という、かなり端のほうの使い方です。
うちの道具の話(短く)
比較の相手側として、自分たちの uvf にも触れておきます。
uvf はメモリマップを使いません。決まった大きさの入れ物に、順番に読み込んでいくだけです。
そのため、3つの環境で同じように動きます。当たり外れがありません。
Windows の 10GB・固定文字列では、コールドで ripgrep 15.91秒に対して uvf 7.22秒。
2.2倍の差が付きました。Mac では 3GB のコールドが 3.26秒 対 3.32秒でほぼ互角ですから、
この差は「Windows で mmap が不利だったぶん」だと考えています。
ただし、裏を返すと不利もあります。 Linux では軽い検索で mmap のほうが速いのに、
uvf はそれを使っていません。使えばもう一段速くなる余地がある、ということです。
いまは3環境で挙動が揃っていることを優先していますが、宿題として残っています。
uvf は無料で、Windows / macOS / Linux 版があります。
GitHub Releases から単体で動きます。
索引を作って同じファイルを何度も調べたい場合は有料版の uvp ですが、
探すだけなら uvf で足ります。
自分の環境で試すには
2行です。同じファイルに対して、キャッシュを捨ててから順に走らせてください。
# 1回目(既定)
rg --mmap -n -F '探す語' huge.log > /dev/null

# キャッシュを捨てる
#   macOS : sudo purge
#   Linux : sync && sudo sh -c 'echo 3 > /proc/sys/vm/drop_caches'
#   Windows: RAMMap64.exe -accepteula -Et (管理者権限)

# 2回目
rg --no-mmap -n -F '探す語' huge.log > /dev/null
キャッシュを捨てずに測ると、2回目が速く出るだけで何も分かりません。 ここだけは省かないでください。
そして出力の行数が両方で一致することを必ず確かめてください。違っていたら、測り方が違っています。