【追記 2026-09-17】3GBで負けたと思っていたら、勝っていた(ただし冷えていれば)
この記事には「3GB は ripgrep が速い」という趣旨の記述があります。それは ファイルが OS のキャッシュに載っているときの話でした。
sudo purgeの直後(=しばらくぶりにそのファイルを開くとき)に測り直すと、3GB でも uvp が 2.6倍速いです。
3GB・固定文字列「東京」 rg uvp コールド(purge 直後) 3.26秒 1.25秒(2.6倍) ウォーム(続けて2回目) 0.33秒 1.01秒 7種類の検索のうち6つで同じ傾向でした(uvp 1.6.3)。詳しくは 3GBで負けたと思っていたら、勝っていた(ただし冷えていれば) に書いています。計測は Mac(Apple M4 / メモリ32GB / 外付け USB SSD)で、Windows・Linux(非力なノートPC・VMware 上)では傾向が変わる可能性があります。本文の以下の数字は、そのまま(ウォームでの計測)です。
ripgrep には効率で勝てません。
258GB・45億行のファイルを ripgrep が読み終わるのは 278秒。同じファイルを wc -l が読み終わるのは 268秒。差は4%で、その4%のあいだ CPU はほとんど寝ています。この数字を見たとき、アルゴリズムで追いつく道は無いと分かりました。では、どこで戦うのか。
先に結論
258GB・45億行の1ファイルに、ripgrep と自作の索引方式 uvp を同じ作法で当てました(Apple M4 / 32GB / 外付けSSD、毎回 sudo purge、/usr/bin/time -p の real、数字はすべて2回目=索引あり)。
- ripgrep は「ファイルを1回読む時間」の1.04倍で走っています。CPU は1コアも使い切っていない(user/real = 0.04)。効率でこれに勝つ道はありません
- 勝てる場所は1つだけ、「読むバイト数」です。索引と圧縮で 258.68GB → 28.6GB(1/9.04)。読む量が1/9なら、時間も 278.35秒 → 35.51秒
- 1問目は必ず負けます(索引を作る 333.67秒)。元を取るのは 1.37問目。3GB は、キャッシュが温まっていれば何問聞いても ripgrep が速い(冷えていれば uvp が 2.6倍。上の追記)
- 副産物がひとつ。索引を持った瞬間、CLI の結果をそのまま GUI に渡して、そこから何度でも絞り直せるようになりました。絞り込みの段は 0.24秒(50GB・v1.6.2)で、この往復が実用になっています
以前 商用エディタに勝てる場所を1つだけ選ぶ という記事で、機能数では戦わず軸を1つ選ぶ話を書きました。これはその CLI 版です。相手は ripgrep で、先に負けを全部書きます。
前提: まともに戦うと必ず負ける
比較の前に、物理下限を出します。
$ /usr/bin/time -p wc -l us-260726.osm
4509830821
real 268.73
268.73秒=963MB/s。258GB を1回読み切るだけの時間です。これに対して ripgrep は、
| 問 | 語 | ヒット | rg -c |
|---|---|---|---|
| 1 | New York | 100,492 | 275.80 |
| 2 | Brooklyn | 30,871 | 278.35 |
| 3 | Central Park | 14,306 | 276.75 |
| 4 | Statue of Liberty | 88 | 293.85 |
| 5 | coffee_shop | 36,506 | 346.21 |
| 中央値 | 278.35 |
物理下限の 1.04倍。ヒットが 88件でも 10万件でも同じ。ripgrep は「読み終わったら終わる」ツールで、読む速さはディスクが決めています。
CPU の使われ方を見ると、もっとはっきりします。
rg -c 'New York' real 275.80 user 11.55 sys 51.60
275秒のうち、CPU を使ったのは 11秒。10コアの M4 で、1コアの4%しか使っていません。使う必要がないからです——ディスクが追いつかない。
ここが出発点です。I/O 律速の世界では、CPU を速くしても、並列にしても、何も起きません。アルゴリズムをどれだけ磨いても、268.73秒の壁は動かない。
(脇道ですが、これは「Rust 製なら速い」が一般則ではない理由でもあります。1本のファイルを並列走査する amber は同じファイルで 357.69秒、ripgrep より遅い。並列化で CPU 時間を 25〜36倍使っても、ディスクが1本なら速くならない。258GB の記事 に実測があります)
残った手は1つ: 読むバイト数を減らす
ディスクの速さが上限なら、読む量を減らすしかありません。
uvp は最初に索引と圧縮を作ります。
$ /usr/bin/time -p uvp convert us-260726.osm
real 333.67
333.67秒。物理下限の1.24倍で、258GB を1回読んで .uwvz を作ります。できたファイルは 28,608,409,953 byte=元の 1/9.04。以後の検索はこの 28.6GB だけを読みます。元の 258GB は消しても構いません。
| 読むバイト数 | 963MB/s での下限 | 実測(中央値) | 下限との比 | |
|---|---|---|---|---|
rg -c |
258.68GB | 268.73秒 | 278.35秒 | 1.04倍 |
uvp |
28.6GB | 29.72秒 | 35.51秒 | 1.20倍 |
どちらも自分の I/O 下限に張り付いています。違うのは読まねばならないバイト数だけ。そして1バイトあたりの効率では ripgrep のほうが上です(1.04 対 1.20)。勝っているのはアルゴリズムではなく、前払いです。
CPU の使い方も反転します。
rg   real 275.80   user  11.55   → user/real = 0.04(I/O 待ち)
uvp  real  34.70   user 168.63   → user/real = 4.86(約5コアで展開・検索)
読む量が1/9になった瞬間、ディスクが余って CPU が足りなくなる。律速がひっくり返る、というのがこの方式の正体です。
負けの表
軸を1つに絞ると、他は負けます。先に全部書きます。
| 場面 | 結果 | 理由 |
|---|---|---|
| 1問目 | ripgrep 278.4秒 対 uvp 369.3秒(1/1.33) | 索引を作る 333.67秒を払う。全サイズで一定して 1.2〜1.3倍負け(3GB 1/1.18・10GB 1/1.31・50GB 1/1.29) |
| 3GB(ウォーム) | 2問目以降も ripgrep が速い(1/3.1) | ファイルが OS キャッシュに載り、rg の全走査が 0.33秒。uvp は起動+索引ロードの固定費を必ず払って 1.01秒。絶対差は 0.7秒(冷えていれば 3.26秒 対 1.25秒で uvp) |
-head N(先頭だけ) |
rg \| head 0.05秒 対 uvp 0.32秒 |
v1.6.2 で全件走査(7.01秒)を止めて先頭 N 件で切るようにしたが、残る 0.25秒は .NET の起動。両者サブ秒・勝てはしない |
| 1バイトあたりの効率 | rg 1.04倍 対 uvp 1.20倍 | 上の表のとおり。展開のぶん uvp が重い |
文脈つきの絞り込み(-C N) |
段ごとに約8.5秒(50GB) | 前段のヒット行の外も見るので .uwvz を読み直す。±0 なら 0.24秒 |
3GB は ripgrep の土俵で、そこは譲ります。差が 0.4秒なので譲っても痛くありません。索引が効き始めるのは、ファイルがメモリに収まらなくなってからです。
何問目で元を取るか
CLI(N) = N × 278.35            (rg・5問の中央値)
uvp(N) = 333.67 + N × 35.58    (索引作成 + .uwvz 検索の平均)

N* = 333.67 ÷ (278.35 − 35.58) = 1.37
| 質問数 N | ripgrep | uvp | rg ÷ uvp |
|---|---|---|---|
| 1 | 278.4 | 369.3 | 1/1.33(ripgrep の勝ち) |
| 2 | 556.7 | 404.8 | 1.38倍 |
| 5 | 1,391.8 | 511.6 | 2.72倍 |
| 20 | 5,567.0 | 1,045.4 | 5.33倍 |
2問目で逆転します。式は索引方式全般に当てはまります(T_index ÷ (T_scan − T_search))。10GB・50GB でも同じ形で、2回目以降は 10GB で 5.5〜6.9倍、50GB で 7.3〜10.2倍です。
ここまでが「速さ」の話です。ただ、正直に言うと、これだけなら記事にする価値は薄い。索引を作れば2回目が速いのは、当たり前だからです。
副産物 — CLI と GUI が地続きになった
前払いをした結果、予定していなかったものが手に入りました。
uvp の末尾に -open を付けると、CLI の結果がそのまま GUI に渡ります。
uvp us-260726.osm.uwvz 'New York' -C 0 -grep hospital -v -grep school -v -grep Brooklyn -open
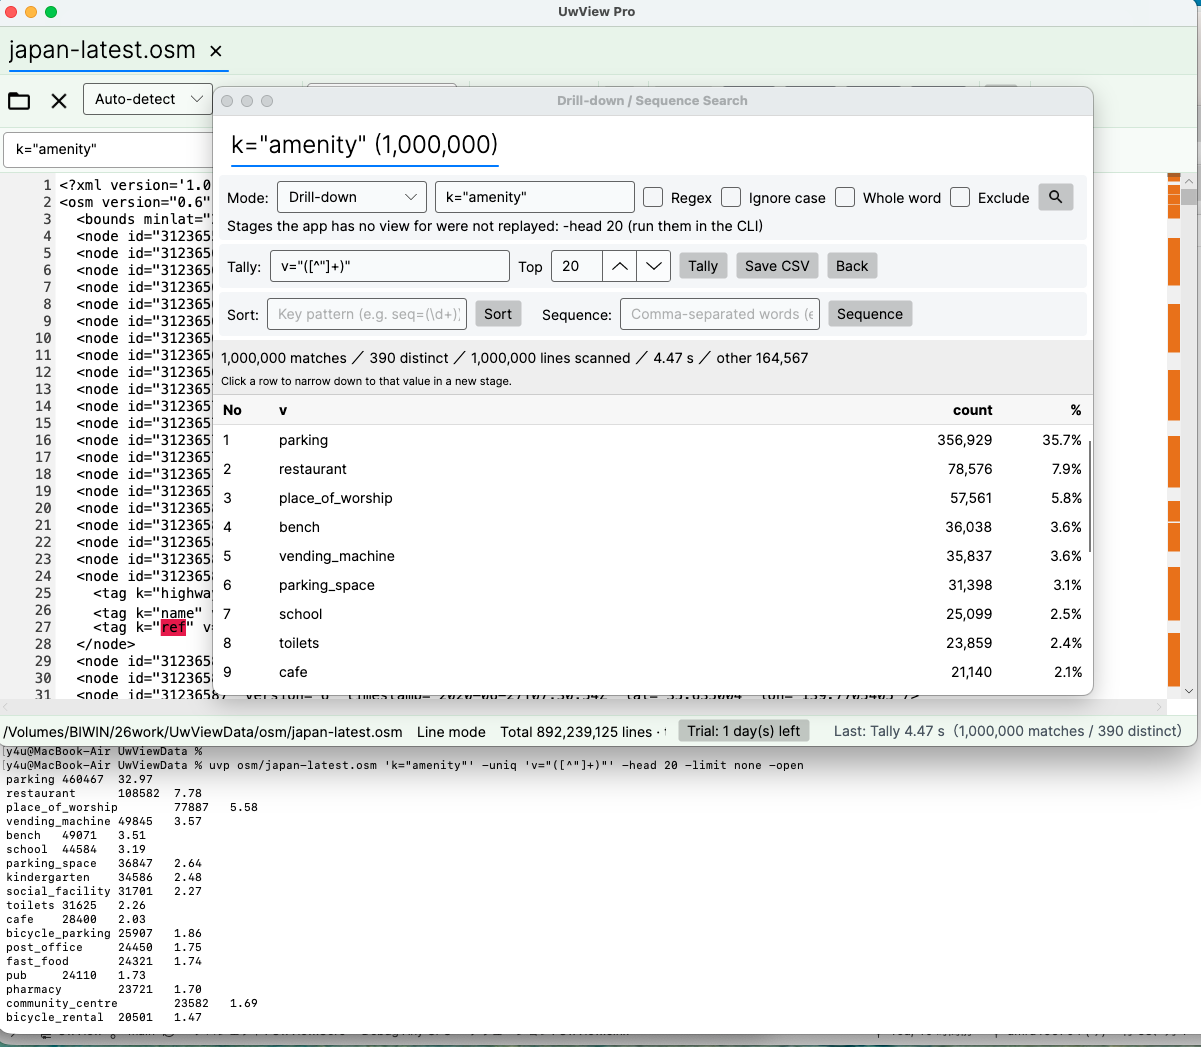
これで起きることを順に書きます。
- CLI が 258GB(の索引 28.6GB)を検索し、3段の絞り込みで 35件に落とす — 34.88秒
- その 35件を一時ファイルで GUI に渡す。GUI は検索し直さない(v1.6.2。それまでは条件だけ渡して GUI で再検索していたので、巨大ファイルでは同じ検索を2回待っていました)
- GUI が開く。索引は既にあるので、開き直しに 258GB を読まない
- 一覧の行をクリックすると本文の該当位置へ。±N 行の文脈を出す。別の語で絞り直す——ここが 0.24秒/段(v1.6.2)
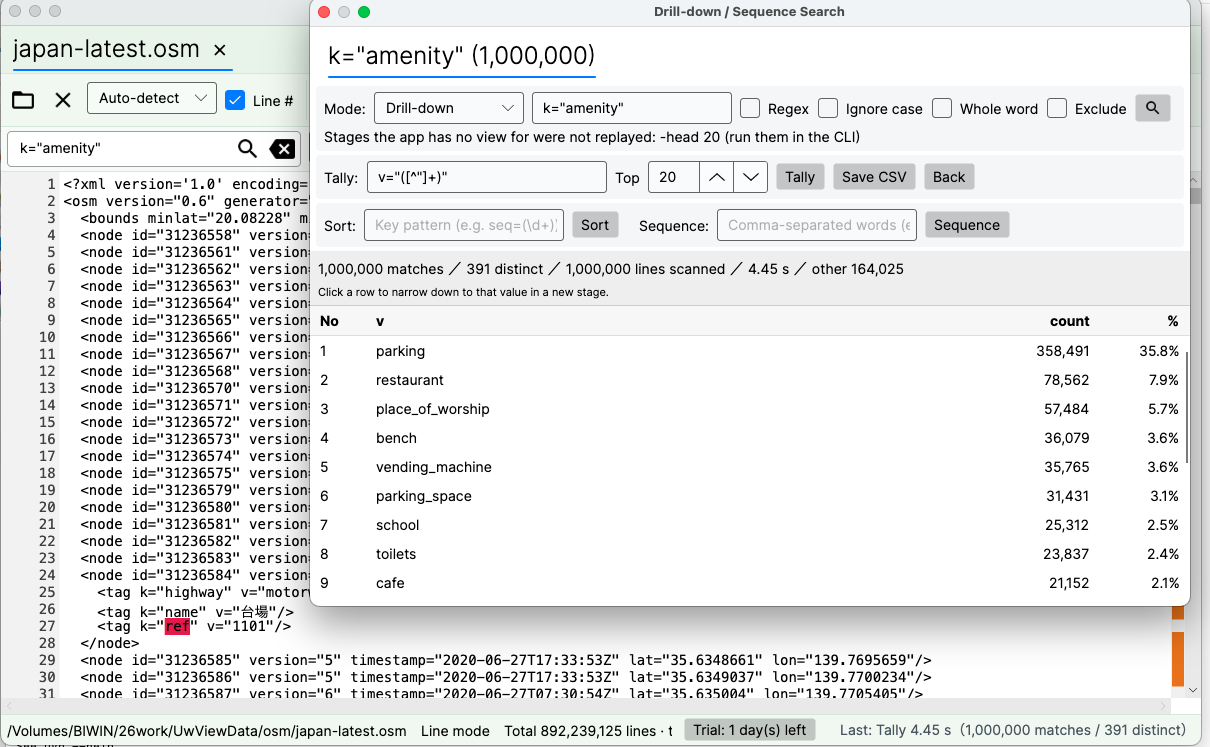
4 が肝です。ここは正直に書いておくと、rg との比較で絞り込みだけ不自然に遅い時期がありました。単発検索は 7〜9倍速いのに、段を重ねた絞り込みだけ 3〜4倍にとどまる。調べたら段ごとに読み直している箇所があり、v1.6.2 で直しました。50GB・3段で 29.46秒 → 8.10秒、1段あたり 0.24秒です。258GB の3段も 34.88秒で、単発(34.85秒)と同じになりました。原因と切り分けの手順は別の記事に書きます。
これで、ようやく次の作業が成立します。
スクリプトで絞って、人が見て、見ながらもう一度絞る。
絞り直すたびに 278秒待つ(CLI だけ)のでも、GUI を開くたびに 258GB を読み直す(GUI だけ)のでもなく、索引を1回作って、CLI と GUI の両方がそれを使う。
grep のパイプは「段を増やしても1パス」で、これは CLI の設計として正しい。でも条件を変えてもう一度となると、また1パス。GUI は条件を変えるのは速いが、開くのが遅い。索引を挟むと、この2つの「遅い」が両方消えます。
CLI と GUI は同じ関数を呼んでいるので(絞り込み・集計・順序)、CLI で出た件数と GUI で出た件数は必ず一致します。検証は 81項目+gz/zip 12項目+258GB 全項目を rg / sed とバイト単位で突き合わせて、製品側の誤りは 0 件でした。
何をしたのか、まとめ
- ripgrep には効率で勝てません。物理下限の1.04倍、CPU 使用率4%。完成しています
- 勝てる場所は「読むバイト数」だけでした。1/9 にしたら 1/8 の時間になり、それ以上でもそれ以下でもない
- 1問目は必ず負けます。分岐点は 1.37問目。3GB は、温まっていれば何問でも負けます。そこは譲ります
- 前払いの副産物として、CLI と GUI が同じ索引を使い、結果を受け渡せるようになりました
- 「速い」ではなく「調査1件の中で、CLI と GUI を行き来しても待たない」が、選んだ1つの場所です
使っている道具
uvp は UwView Pro v1.6.2 に付属します(Windows・macOS・Linux、1ライセンスで全OS。買い切り/月額。14日間の無料試用あり——試用中も uvp は使えます)。無料版 UwView にも uvf が付いていますが、索引を持たないので検索と -open だけで、速さはありません。
数値はすべて当方環境での自社実測で、独立ベンチマークではありません。ripgrep は多数ファイルの横断検索では最速の部類で、この記事はそこを争っていません。巨大な単一ファイルに、何度も聞く場面だけの話です。設定の問題があればご指摘ください。確認のうえ訂正します。
測定条件と使ったコマンド
- Apple M4 / メモリ32GB / macOS 26.3.1 / 外付けSSD(963MB/s)
- ripgrep 15.2.0 / uvp 1.6.1〜1.6.2 / 各計測の前に
sudo purge、計測間に150秒(258GB)または60秒(50GB)のクールダウン - OpenStreetMap アメリカ全土 XML 258,679,440,228 byte / 4,509,830,821 行、同 日本 51,254,526,392 byte
/usr/bin/time -p wc -l us-260726.osm                       # 物理下限
LC_ALL=C rg -c -F 'New York' us-260726.osm                 # rg
uvp convert us-260726.osm                                  # 索引 .uwvz
uvp us-260726.osm.uwvz 'New York' --no-line-number         # uvp(2回目)
uvp us-260726.osm.uwvz 'New York' -C 0 -grep hospital -v -grep school -v -grep Brooklyn -open
リンク
- 258GB・45億行に、5つの質問をする — grepとGUI、どこで逆転するか — この記事の数字の出どころ
- uvp コマンドを付けました — ripgrep と同じ答えを、10GBで7倍速く。3GBも、冷えていれば勝ちます — 3GB/10GB/50GB の実測
- uvp コマンド マニュアル —
-open・-head・-limitの現行仕様 - 商用エディタに勝てる場所を1つだけ選ぶ — 同じ考え方の GUI 版(Zenn)
- 実測まとめ — 巨大ファイル対応ツール 実測性能比較