展開のほうが、速かった。
圧縮ファイルの検索を作っていて、いちばん意外だったのはここでした。遅いのは展開だと思い込んでいたのに、測ったら展開は間に合っていて、遅かったのは「壊れていないか確かめる工程」でした。
3GB の gz を探して 7.8 秒。そのうち 6 秒が、検索でも展開でもないところに消えていました。
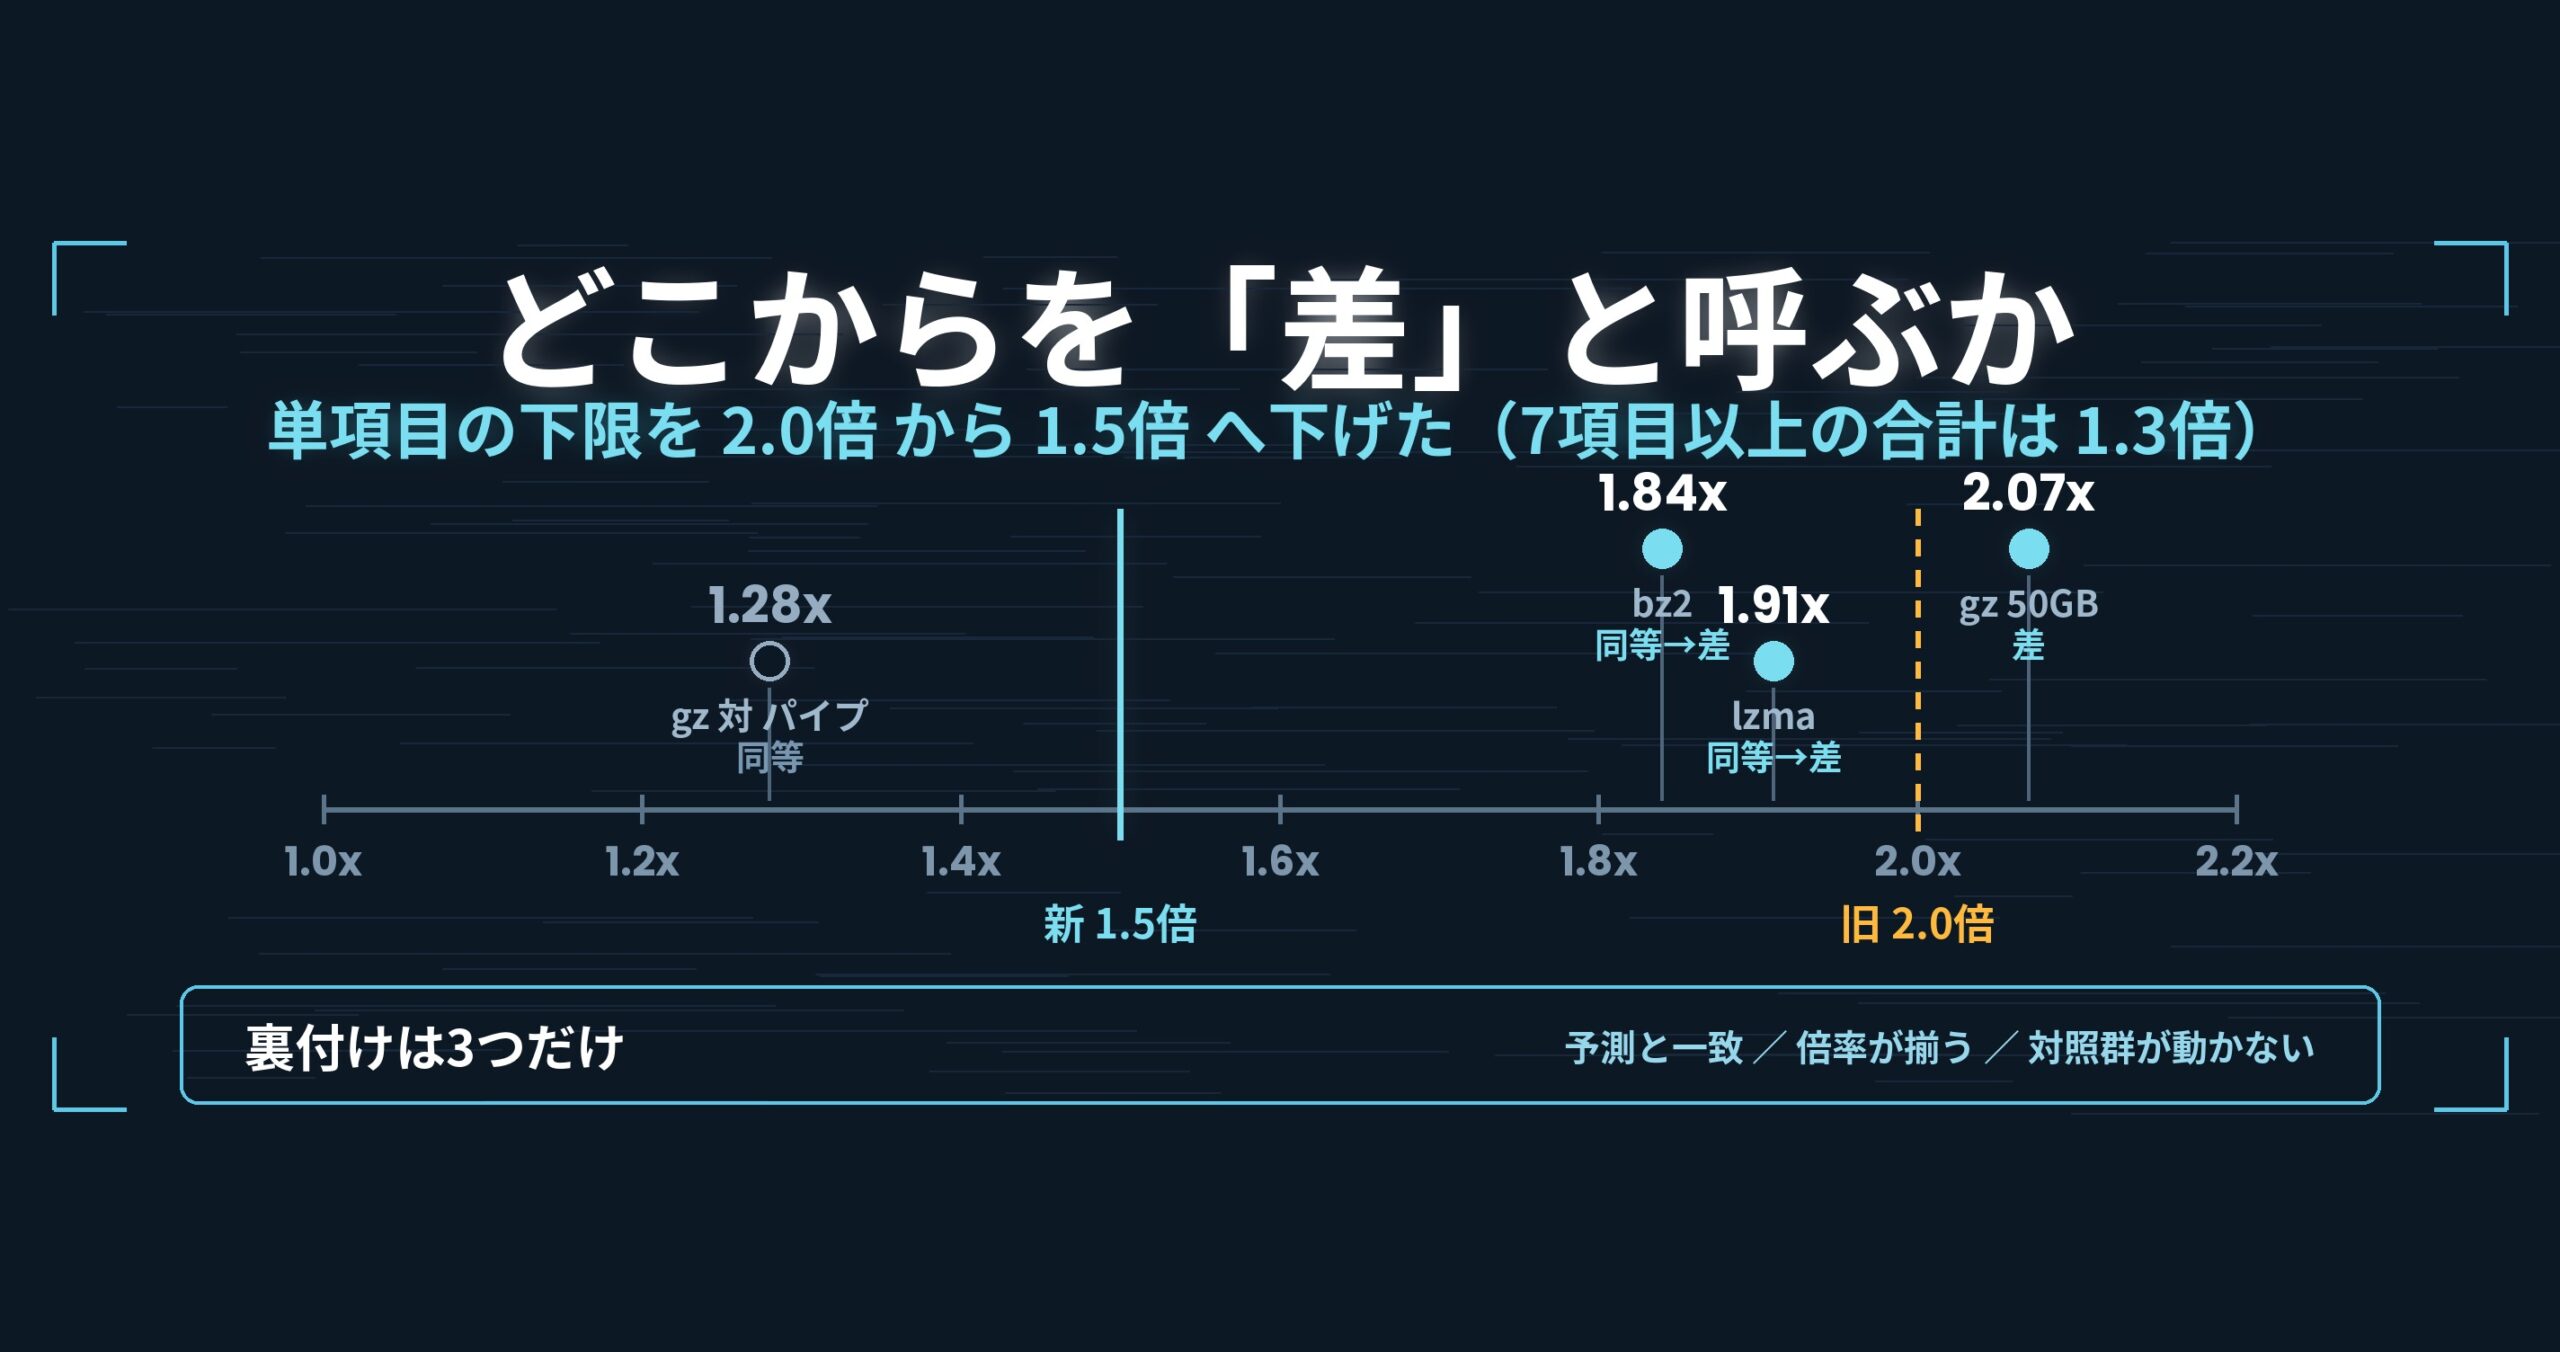
- 先に結論: 圧縮したままの gz を、展開ファイルを作らずに検索できるようにしました。macOS では OS に必ずある zlib を直接呼び、CRC32 の照合を 1 バイトずつから 8 バイトずつ(ARM64 では専用命令)に変えた結果、50GB 相当の gz 検索が 35.65 秒 → 17.20 秒(2.0〜2.1 倍)。gzip -dc の出力を ripgrep にパイプでつないだ形は同じ機械で 22.06 秒なので、1.28 倍。これは「同等」で、追い抜いたとは書きません(単項目で 1.5 倍未満を差と呼ばないと決めているため)。Windows・Linux でも同じ向きの結果が出ています(それぞれの OS の中で 1.71 倍・2.00 倍)。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
- 問題: 圧縮したログは、いったん解凍しないと探せなかった
- 原因: 律速は展開ではなく、CRC32 だった
- 手当て(1): CRC32 を 8 バイトずつ、ARM では命令で
- 手当て(2): 展開そのものを OS に任せる
- 手当て(3): パイプを渡らない
- 数字: 2.0〜2.1 倍。パイプ版とは「並んだ」
- 持ち帰れる一般論: 「重いはずの工程」を疑う前に、内訳を出す
- 使っている道具
- リンク
先に結論: 圧縮したままの gz を、展開ファイルを作らずに検索できるようにしました。macOS では OS に必ずある zlib を直接呼び、CRC32 の照合を 1 バイトずつから 8 バイトずつ(ARM64 では専用命令)に変えた結果、50GB 相当の gz 検索が 35.65 秒 → 17.20 秒(2.0〜2.1 倍)。gzip -dc の出力を ripgrep にパイプでつないだ形は同じ機械で 22.06 秒なので、1.28 倍。これは「同等」で、追い抜いたとは書きません(単項目で 1.5 倍未満を差と呼ばないと決めているため)。Windows・Linux でも同じ向きの結果が出ています(それぞれの OS の中で 1.71 倍・2.00 倍)。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
この記事は「First Light」連載の第 8 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。gz の直接検索も、この版で入りました。
問題: 圧縮したログは、いったん解凍しないと探せなかった
置いてあるログは、たいてい圧縮されています。日次でローテートして app.log.20260901.gz のように積んでいく運用は珍しくありません。50GB のログが 5GB になるなら、そうするのが自然です。
ところが、その状態では探せませんでした。v1.6.0 の UwView は、gz を受け取ると展開して平文を作り、それを開く作りでした。つまり探す前に、
- 50GB ぶんの空き容量が要る
- 展開が終わるまで何も始まらない
- 探し終わったら平文を消す(消し忘れる)
という段取りが挟まります。いちばん困るのは 1 番目です。圧縮して置いてあるのは、たいてい容量が足りないからです。探すために容量を要求する道具は、いちばん探したい場面で使えません。
一方、コマンドラインの世界にはすでに答えがあります。
gzip -dc app.log.gz | rg 'ERROR'
展開の出力をパイプで検索に流す。ファイルは作りません。強い手です。これに並べないなら、gz の直接検索を作る意味はありません。
問いはこうです。展開しながら探すとき、時間はどこへ消えるのか。
原因: 律速は展開ではなく、CRC32 だった
まず素直に作りました。gz を先頭から展開しながら、出てきたバイト列をそのまま検索に渡す仕組みです。検索は前へ前へ進むので、直近の窓だけ手元に残せば済みます。展開と検索は別スレッドに分けて重ねました。
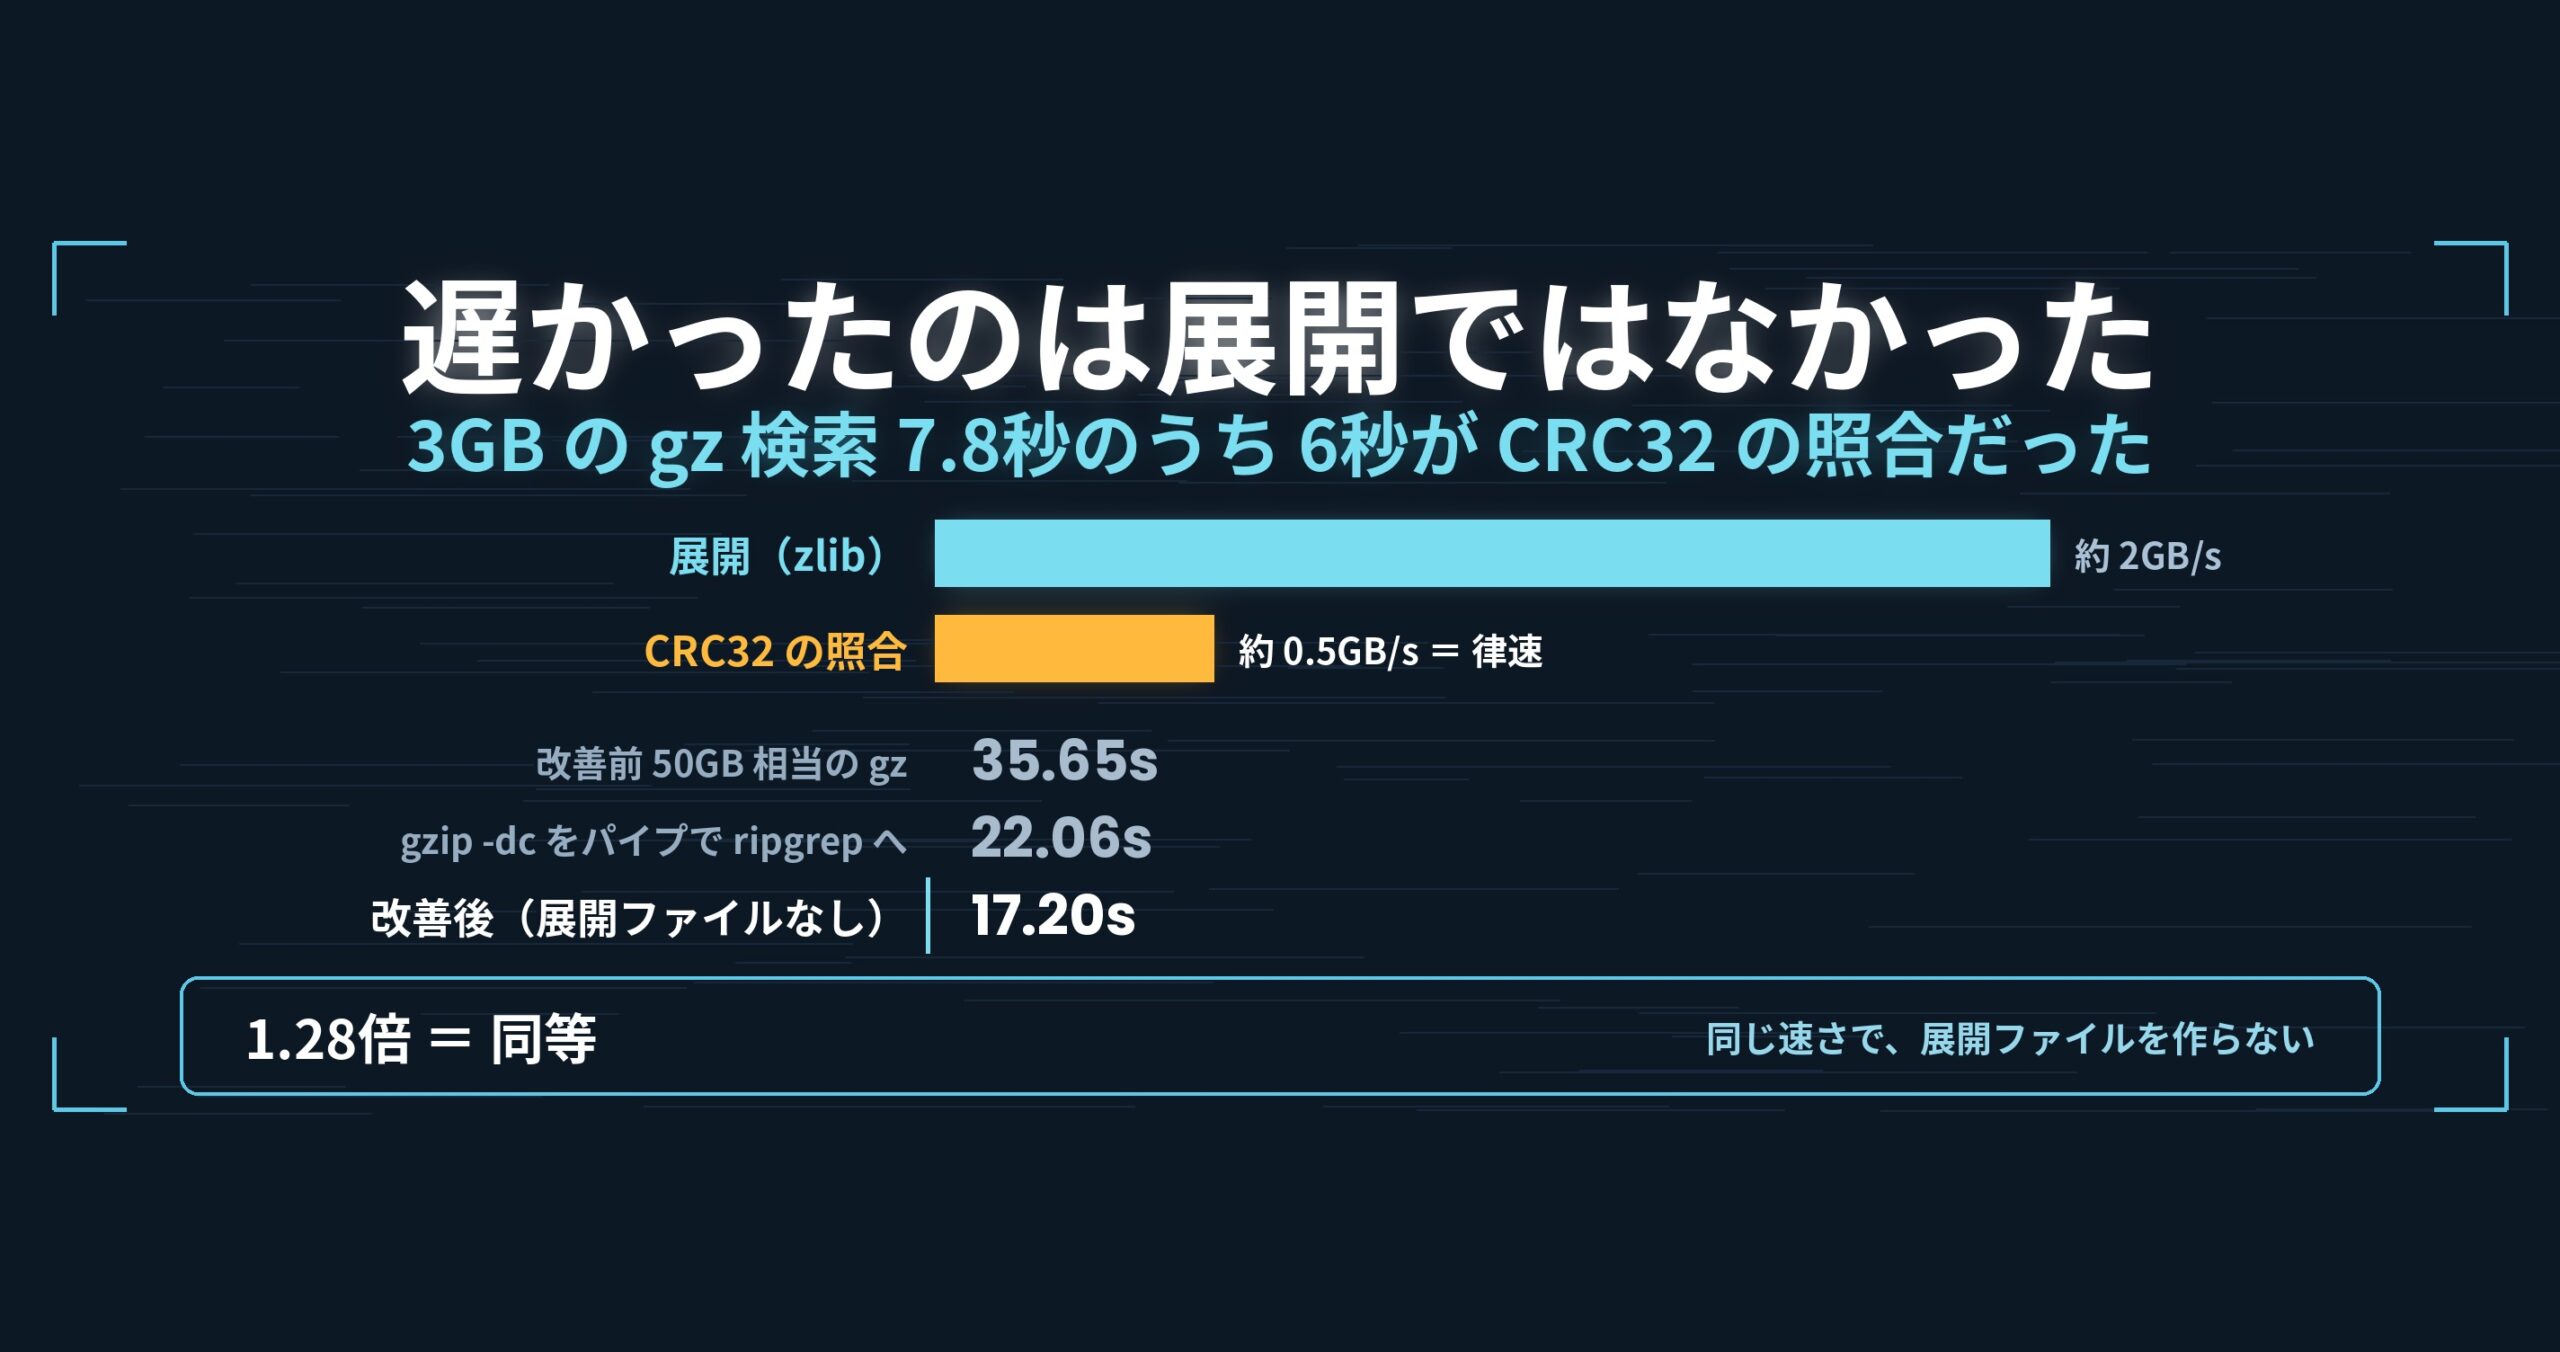
動きました。そして遅かった。3GB の gz 検索で 7.8 秒。内訳を測って、内訳のほうに驚きました。
| 工程 | 速度 |
|---|---|
展開(GZipStream) |
約 2GB/s |
| CRC32 の照合 | 約 0.5GB/s |
gz には、末尾に展開後データの CRC32(4 バイト)と長さが入っています。読み終えたら計算した値と突き合わせて、壊れていないか確かめる決まりです。この照合が、展開より 4 倍遅かった。
素朴な CRC32 は、1 バイト取り出して表を引いて畳むループです。1 バイトあたり数命令。単純だから速いつもりでいましたが、1 バイト単位という点で並列化の余地がなく、展開のほうが先に終わってしまう。3GB の検索 7.8 秒のうち 6 秒が、この「確かめる」工程でした。
探していたものが 1 バイトも見つからない場合でも、CRC の計算は全バイトに走ります。つまりこれは、検索の成否と無関係な固定の税です。
手当て(1): CRC32 を 8 バイトずつ、ARM では命令で
CRC32 の高速化は、よく知られた道が 2 つあります。
1 つは 8 バイト(あるいは 16 バイト)まとめて畳む表引きです。表を 8 本持って、8 バイトぶんの寄与を同時に引く。ループ回数が 8 分の 1 になります。
もう 1 つは CPU の CRC32 命令です。ここで 1 つ落とし穴がありました。x86 の SSE4.2 にある CRC32 命令は、gzip が使う多項式と違う多項式のものです(いわゆる CRC-32C)。使うと値が合いません。一方 ARM64 の CRC32 命令は gzip と同じ多項式なので、そのまま使えます。
そこで、ARM64 では命令を使い、それ以外では 8 バイト表引きにしました。「CPU に命令があるなら速い」ではなく、同じ名前の CRC32 でも中身が違うところが、この手当てのいちばん実務的な教訓でした。
手当て(2): 展開そのものを OS に任せる
CRC が律速でなくなると、こんどは展開が見えてきます。
.NET の GZipStream は素直な実装ですが、OS にはすでに最適化された zlib が入っています。macOS なら /usr/lib/libz.dylib です。これを直接呼ぶようにしました。
- 1.6〜1.8 倍速い(50GB 相当の展開だけで 30.2 秒 → 18.5 秒)
- 参考に
gzip -dc単体は同条件で 26.3 秒 - OS に必ずあるので、同梱するものはゼロ
- 呼び出しに失敗した場合や他の OS では
GZipStreamに落ちる(機能は失われない)
同梱物が増えないのが大きい点です。速くするために配布物を太らせると、その分だけ別の問題(更新・署名・ライセンス)が生まれます。OS にあるものを呼ぶのは、増やさずに速くする数少ない手です。
手当て(3): パイプを渡らない
最後に、gzip -dc | rg に対して構造的に有利な点が 1 つだけあります。プロセスをまたがないことです。
パイプは、展開側が書いてカーネルのバッファに入り、検索側が読む、という受け渡しをします。安くはありますが無料ではありません。同じプロセスの中で展開したバイト列をそのまま照合に渡せば、この受け渡しが丸ごと消えます。
ここで強調したいのは、この差は小さいということです。パイプを消したから勝ったのではありません。効いた順は、CRC32(6 秒)、zlib 直呼び(数秒)、パイプ(わずか)です。
数字: 2.0〜2.1 倍。パイプ版とは「並んだ」
gz 検索(展開ファイルを作らない)・Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML の gz
| 元ファイル相当 | 改善前 | 改善後 | 倍率 |
|---|---|---|---|
| 3GB | 2.18 秒 | 1.16 秒 | 1.88 倍 |
| 10GB | 7.27 秒 | 3.66 秒 | 1.99 倍 |
| 50GB | 35.65 秒 | 17.20 秒 | 2.07 倍 |
3 サイズで倍率が 1.88/1.99/2.07 と揃っています。 これが「たまたま速く出た」ではないと言える根拠です。もし測定のばらつきなら、サイズごとに倍率が散ります。同じ比で並ぶのは、全サイズに同じ割合でかかっていた工程(CRC と展開)を削ったときの形です。
比較相手はこうなりました。
| 50GB 相当の gz を探す | 秒 |
|---|---|
gzip -dc の出力を ripgrep にパイプ |
22.06 秒 |
| UwView(直接・展開ファイルなし) | 17.20 秒 |
| 比 | 1.28 倍 |
1.28 倍は「同等」です。 自分たちで「単項目は 1.5 倍未満を差と呼ばない」と決めているので、ここを「追い抜いた」「速い」とは書きません。書けるのは「並んだ」までです。
そのうえで、意味はあります。パイプ版と同じ速さで、展開ファイルを作らずに済む。容量が要らず、後片付けも要らず、途中で止めても残骸が出ない。同じ秒数なら、副作用の少ないほうが使いやすい——という言い方が、この結果に対して誠実な表現だと思っています。
Windows と Linux でも同じ向きの結果が出ました。ただし秒数を OS またぎで比べることはしません。それぞれの OS の中での比だけを書きます。
- Windows(内蔵 SSD・管理者権限+キャッシュ破棄あり):
gzip -dc | rg120.86 秒に対して 70.52 秒=1.71 倍 - Linux VM(2 コア・8GB・
drop_caches有効): 80.69 秒に対して 40.32 秒=2.00 倍
面白いのは、Windows・Linux では GZipStream のままだという点です(OS 標準 zlib の直呼びは macOS だけ)。それでも 1.7〜2.0 倍になるのは、Windows の gzip コマンド自体が遅い(5.74GB の展開に 2 分。Mac は 22 秒、Linux は 81 秒)という事情も混ざっています。「速くなった」の中身が OS ごとに違うわけで、ここを一括して語ると嘘になります。
.uwvz との関係
UwView Pro には .uwvz という圧縮形式+索引のサイドカーがあり、そちらは「圧縮したまま探す」をもっと徹底した形です(詳しい記事)。今回の話は違って、世の中にすでにある .gz をそのまま探すためのものです。手元にあるログを圧縮し直さずに扱えることのほうが、実務では効く場面が多いと考えました。
正直に書いておくこと
- 既知の制限を 1 つ残しています。 gz の中に 64MiB を超える 1 行があり、それが検索に一致した場合、「ファイルが壊れている」扱いになります。これは直しません——上限を外すと、普通のファイルの検索が遅くなるからです。制限として README に書く形を選びました
- 展開が律速なので、cold(キャッシュを捨てた直後)と hot(メモリに載った状態)でほとんど差が出ません。平文の検索は cold と hot で大きく変わりますが、gz は「読む」より「展開する」のほうが重いので、キャッシュの効き方が違います
- 上の 3 サイズの gz は
gzip -6で作ったものです。圧縮レベルが違えば展開の重さも変わります - ripgrep には
-zという圧縮ファイルを扱うオプションもあります。ここで比べたgzip -dc | rgは、実務でよく使われる書き方として選んだものです - Linux では OS 標準 zlib の直呼びを入れれば Mac と同様にもう一段速くなる余地がありますが、入れていません。
gzip -dc | rgに並ぶ目的は達成できていて、切り替えの仕組みを増やすほどの理由がないと判断しました
持ち帰れる一般論: 「重いはずの工程」を疑う前に、内訳を出す
この回の教訓は 1 行です。自分が重いと思っている工程は、たぶん重くない。
圧縮ファイルの処理を速くしようとすると、ほとんどの人は展開に目を向けます。名前が派手で、CPU を使いそうで、実際に重いからです。今回もそう思って始めました。ところが内訳を出したら、展開は 2GB/s で走っていて、律速は「確かめる」ほうの 0.5GB/s でした。
同じ形は他にもよく出ます。
- 暗号化より、そのための鍵導出やハッシュのほうが重い
- 圧縮より、チェックサムのほうが重い
- パース(構文解析)より、入力を文字列に変換する前処理のほうが重い
共通点は、軽そうに見える工程が、1 バイト単位の単純なループになっていることです。1 バイトずつのループは、命令数が少なくても、まとめて処理できないぶん帯域が出ません。逆に「重そうな工程」は、重いからこそ最適化が積んであって、まとめて処理する形になっています。
だから順序はこうです。速くする前に、工程ごとの MB/s を出す。 全体の秒数だけ見ていると、いちばん最適化されている場所を、もう一段最適化しようとして時間を使います。内訳が出れば、「表引き 1 バイトずつ」のようなまだ誰も手を入れていない場所が見つかります。今回はそこが 6 秒でした。
もう 1 つ。同じ名前の仕様が同じとは限りません。 CRC32 という名前の CPU 命令があるのに使えなかったのは、多項式が違ったからです。ハッシュ、文字コード、日時形式、正規表現の方言——名前が一致していても中身が違う場所は、性能改善のときに事故になります。値が合うことを確かめてから速い道に乗り換えるのが、順番として正しいやり方でした。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 2章: gz を展開せずにそのまま探す(無料版)
uvf app.log.gz 'ERROR'

# 4章: 正規表現・大小無視も gz のまま使える
uvf app.log.gz -E 'timeout|refused'
uvf app.log.gz 'error' -i

# 6章: 結果を gz で書き出す(圧縮したまま渡す)
uvf app.log.gz 'FATAL' -out fatal.txt.gz

# 6章: 前後の文脈ごと見る
uvf app.log.gz 'FATAL' -C 5

# 6章: 探した結果をそのまま画面で開く
uvf app.log.gz 'FATAL' -open
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvf app.log.gz 'FATAL'; then がそのまま書けます。
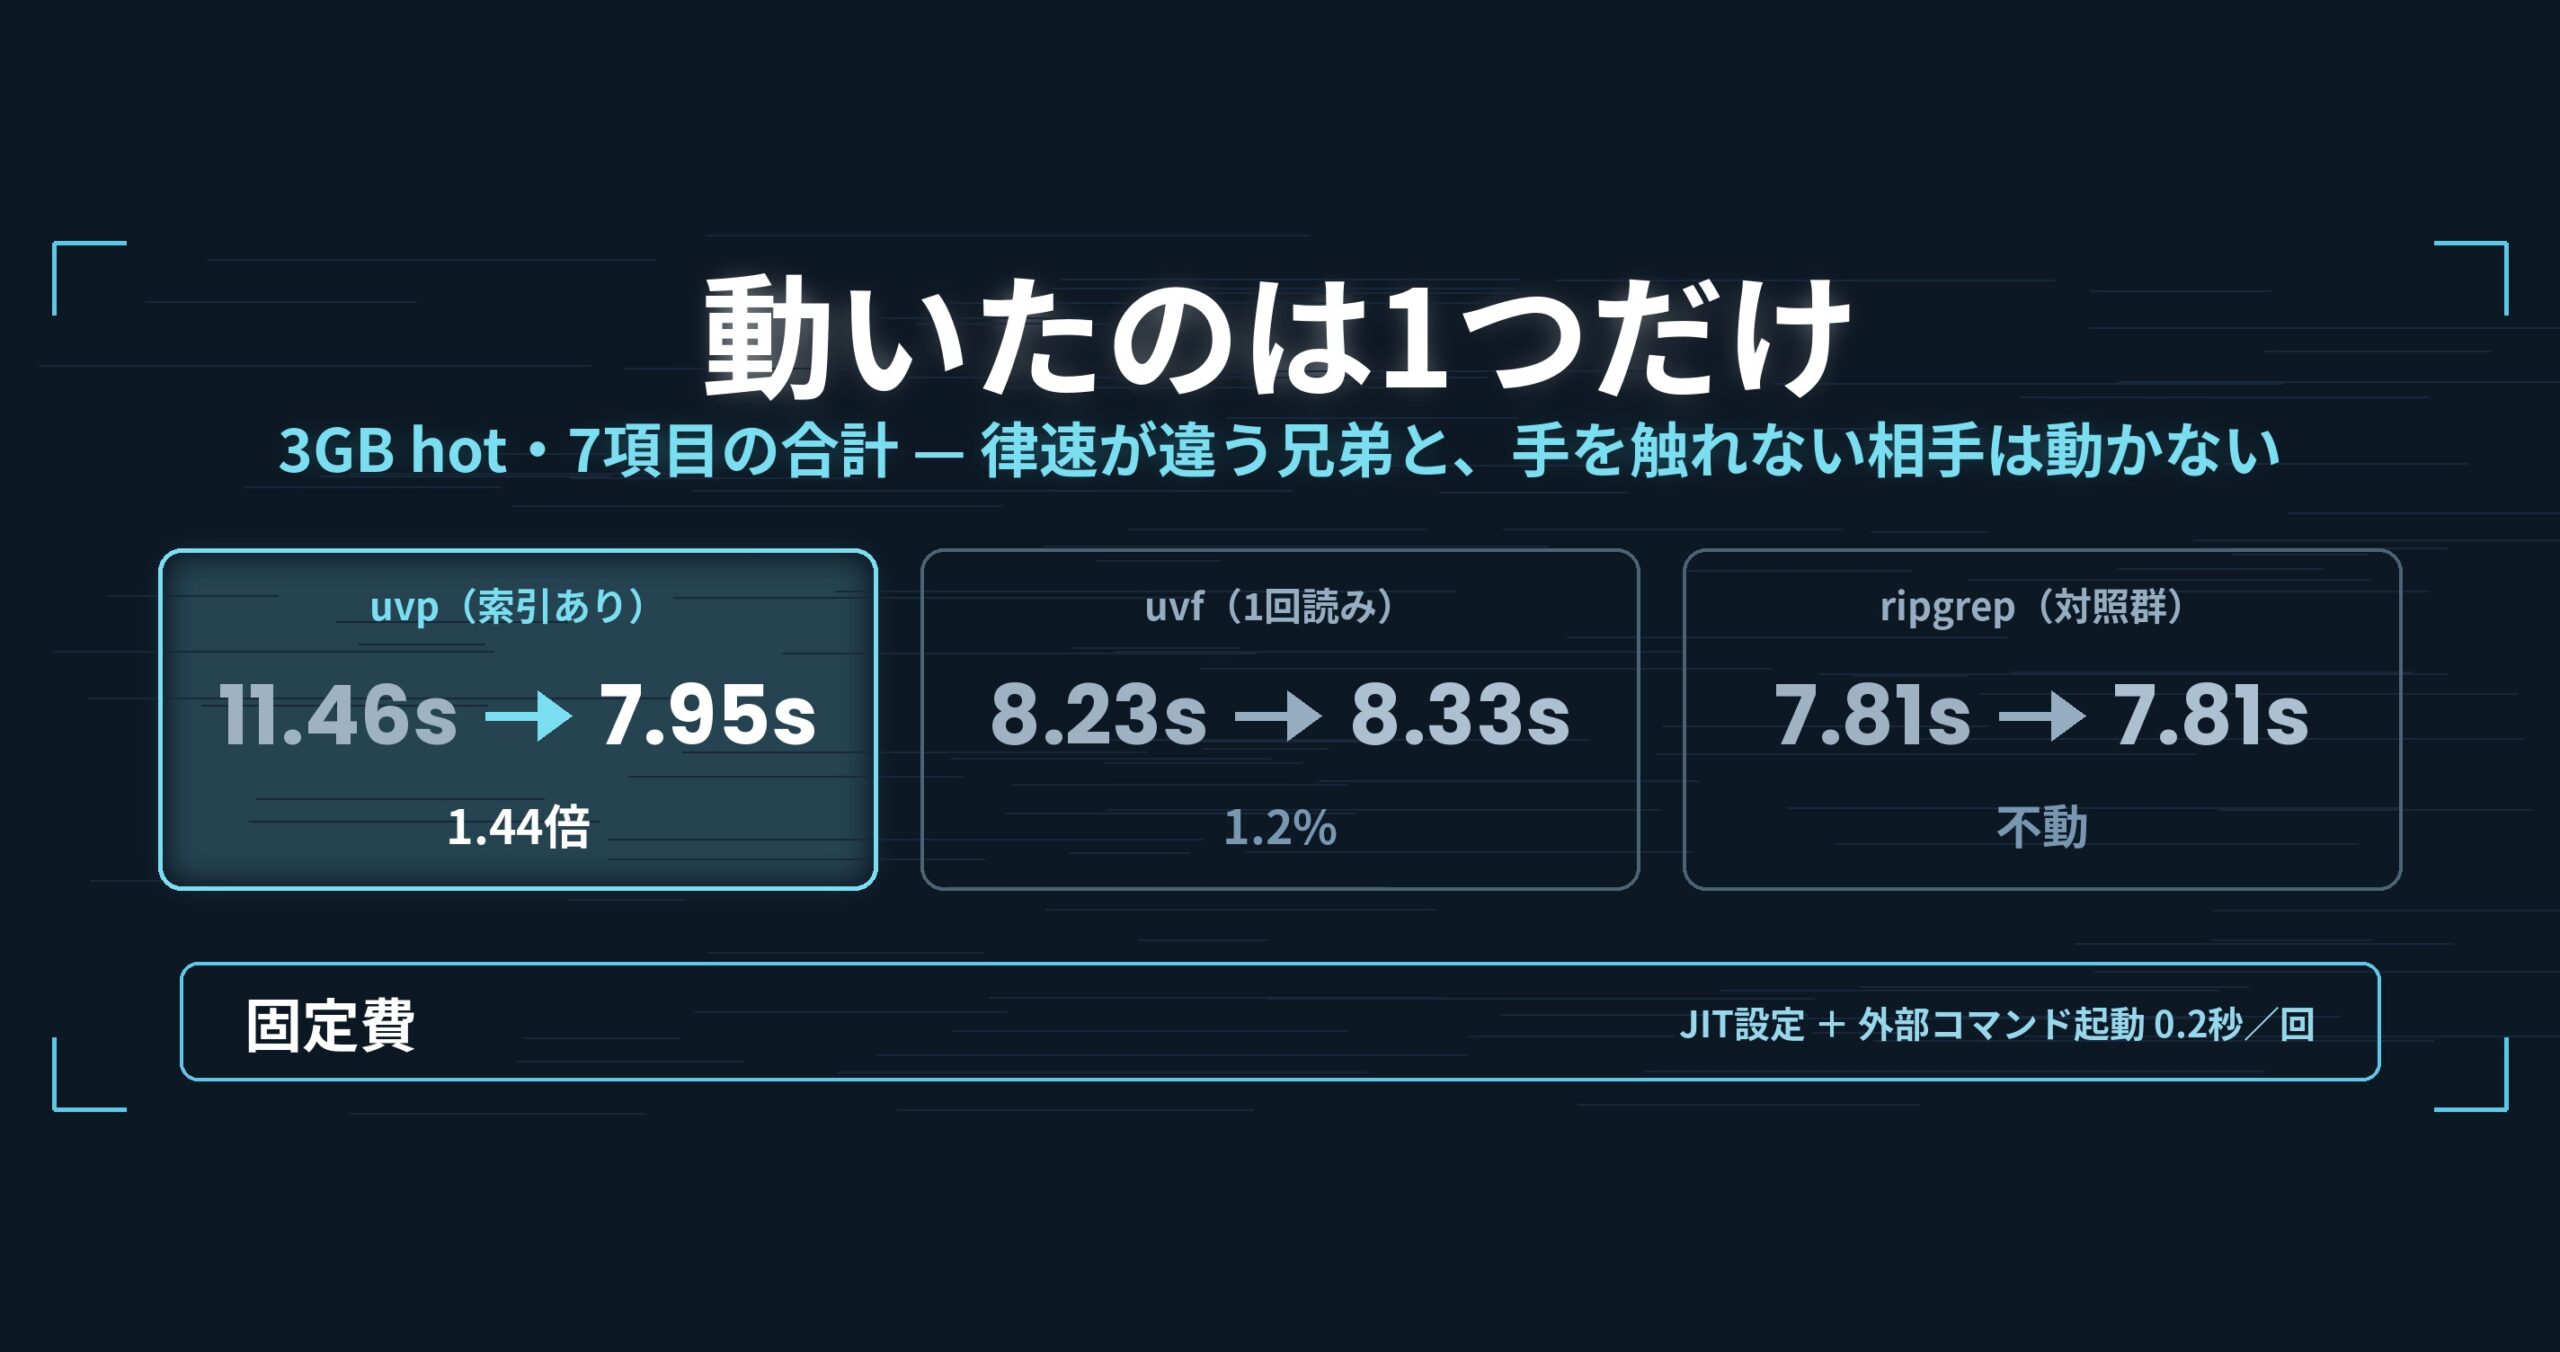
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2 回半読んでいた CLI を 1 回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 4 回: 正規表現を固定文字列と同じ速さに: https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- 圧縮したまま探す
.uwvzの話: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/ - ログの圧縮形式を 7 つ測って選んだ話: https://uvp.y42u.net/blog/log-compression-format-choice/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。