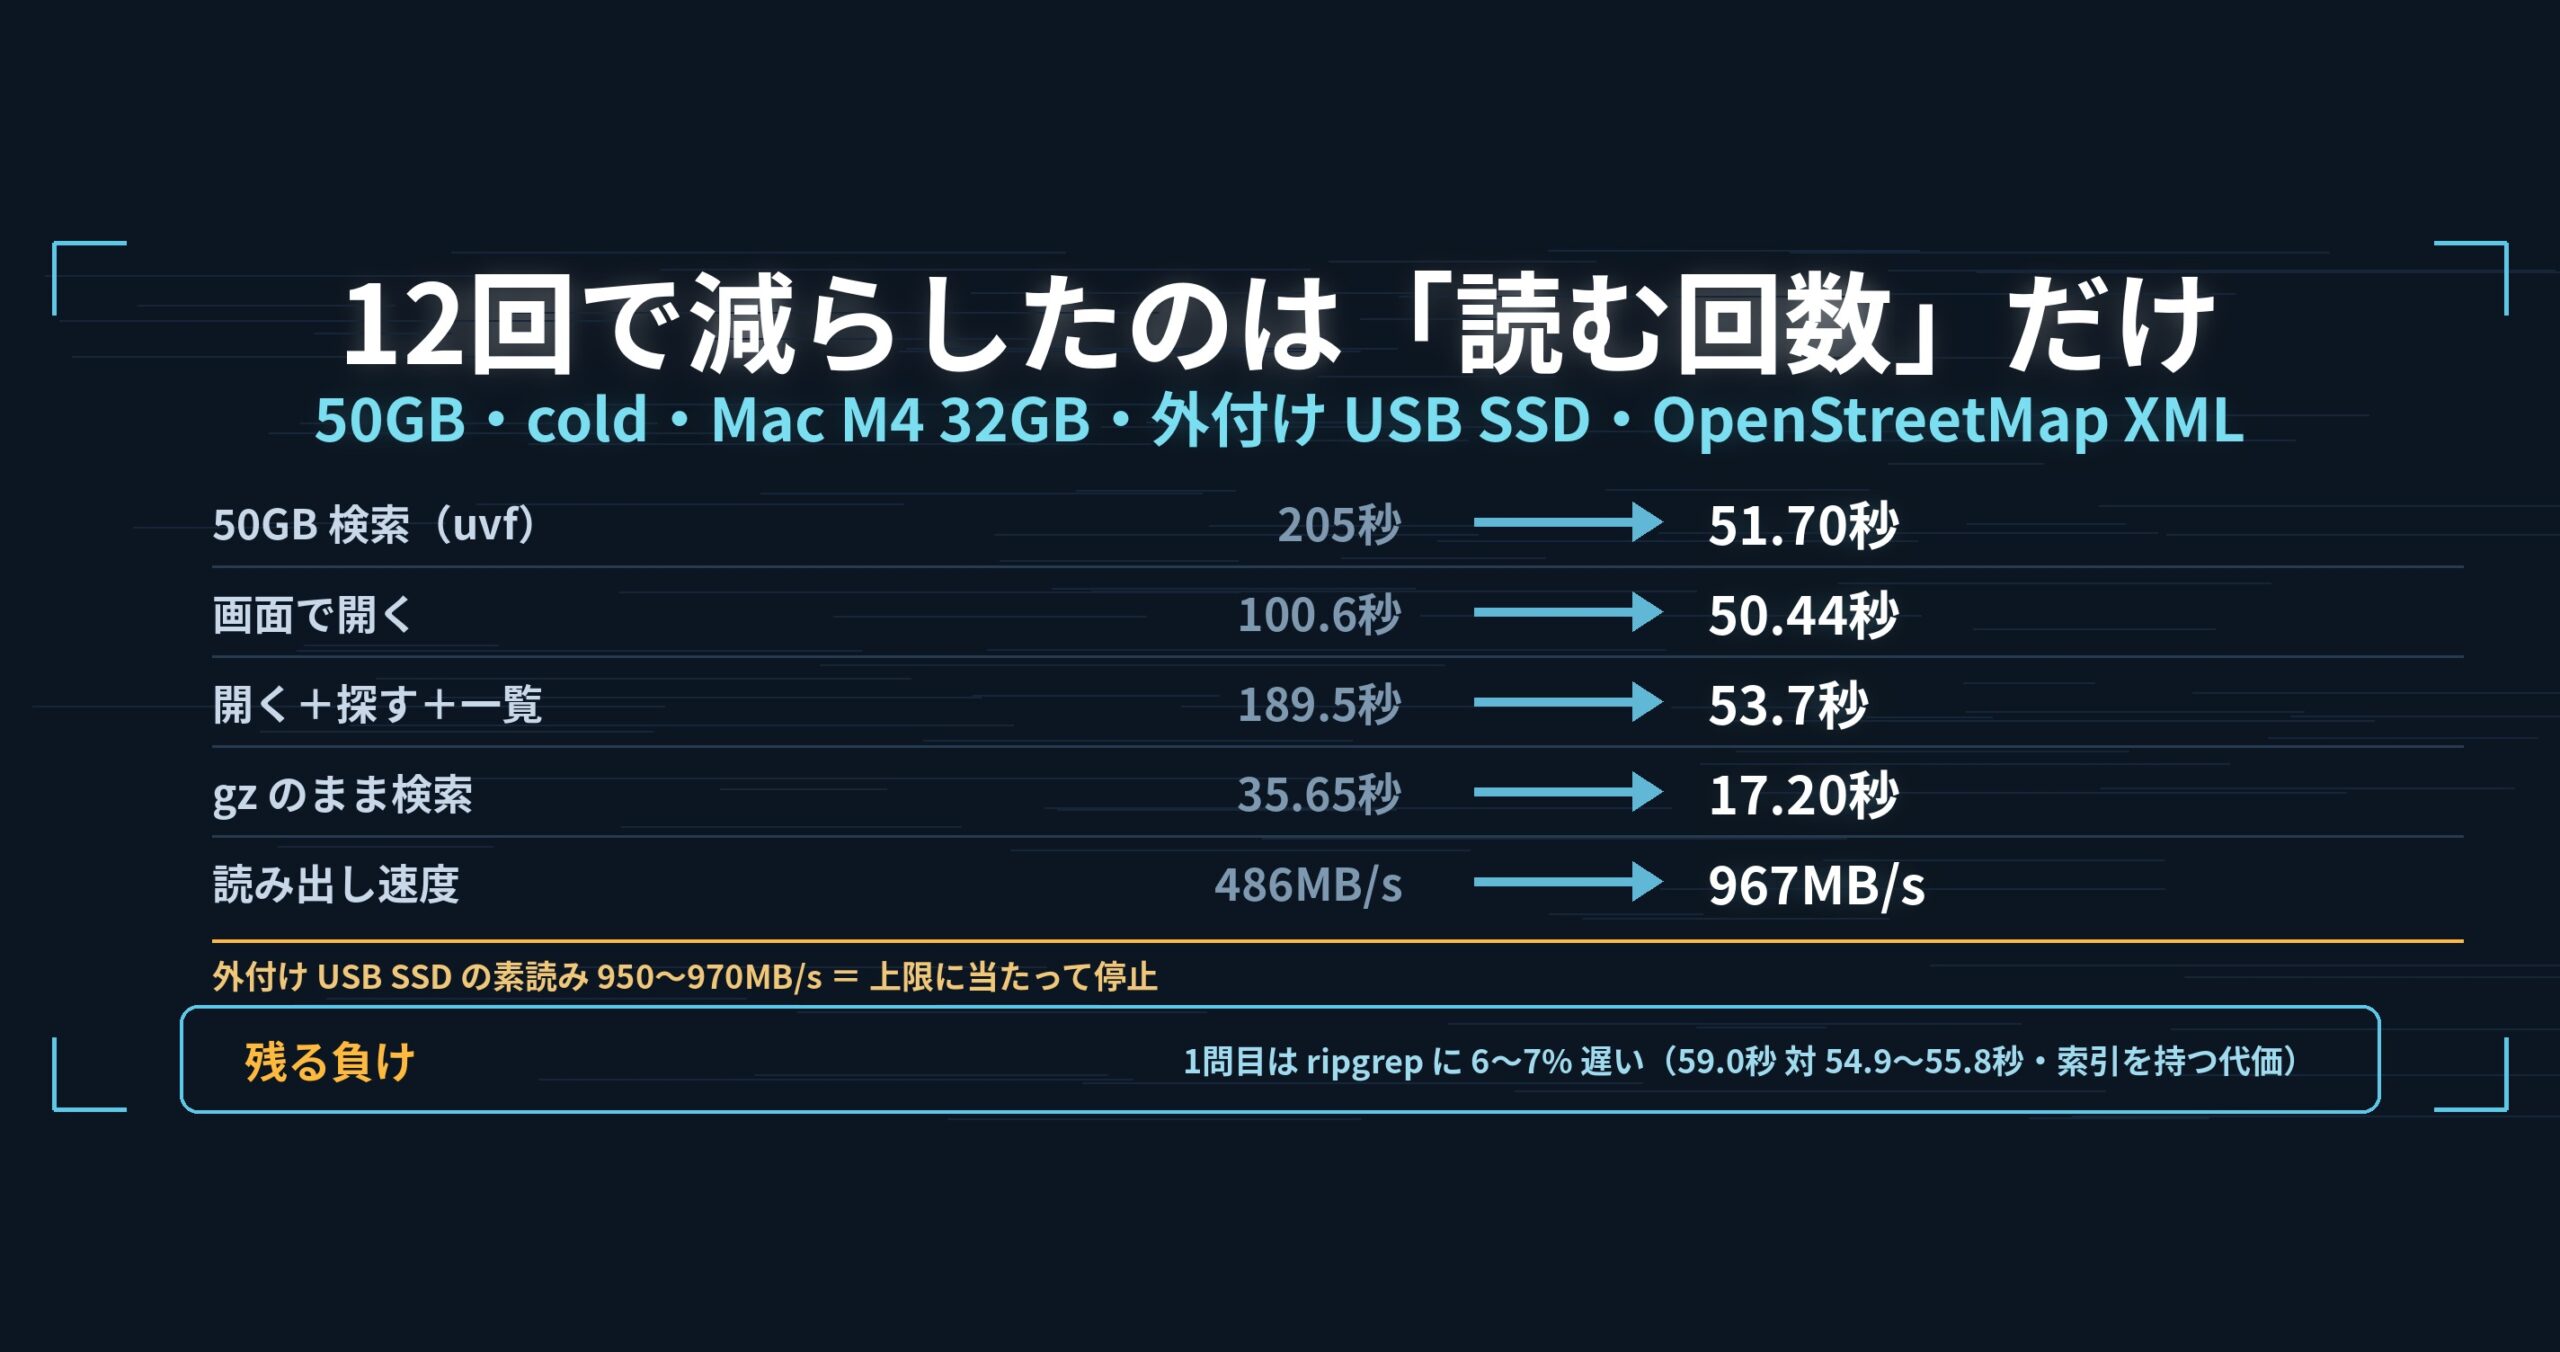
【追記 2026-10-04】v1.7.3.6.9 では、平文5本も同等(
uvfがわずかに速い)になりましたこの記事の「平文だけを複数まとめて探すと ripgrep の方が少し速い(1/1.17)」は、書いたときの版の値です。v1.7.3.6.9(2026年10月4日)で1回目+2回目の合計を測り直すと、平文5本は ripgrep 5.56秒・
uvf5.44秒(1.02倍・同等)、12本(gz 7本+平文5本)は ripgrep 50.16秒・uvf38.80秒(1.29倍・同等)でした。uvpの束ねる1回目は、この測り方(cold)では 42.45秒で、ripgrep(28.19秒)の 1/1.51、uvf(21.65秒)の 1.96倍です(本文の 2.34倍は hot・各2回の速い方の値)。本文の表と数字は、書いたときの測定のまま残しています。詳しくは Wide Field⑫ 「秒に出ない」と書いた改行の数え方が、2回目の検索の4割を占めていました。
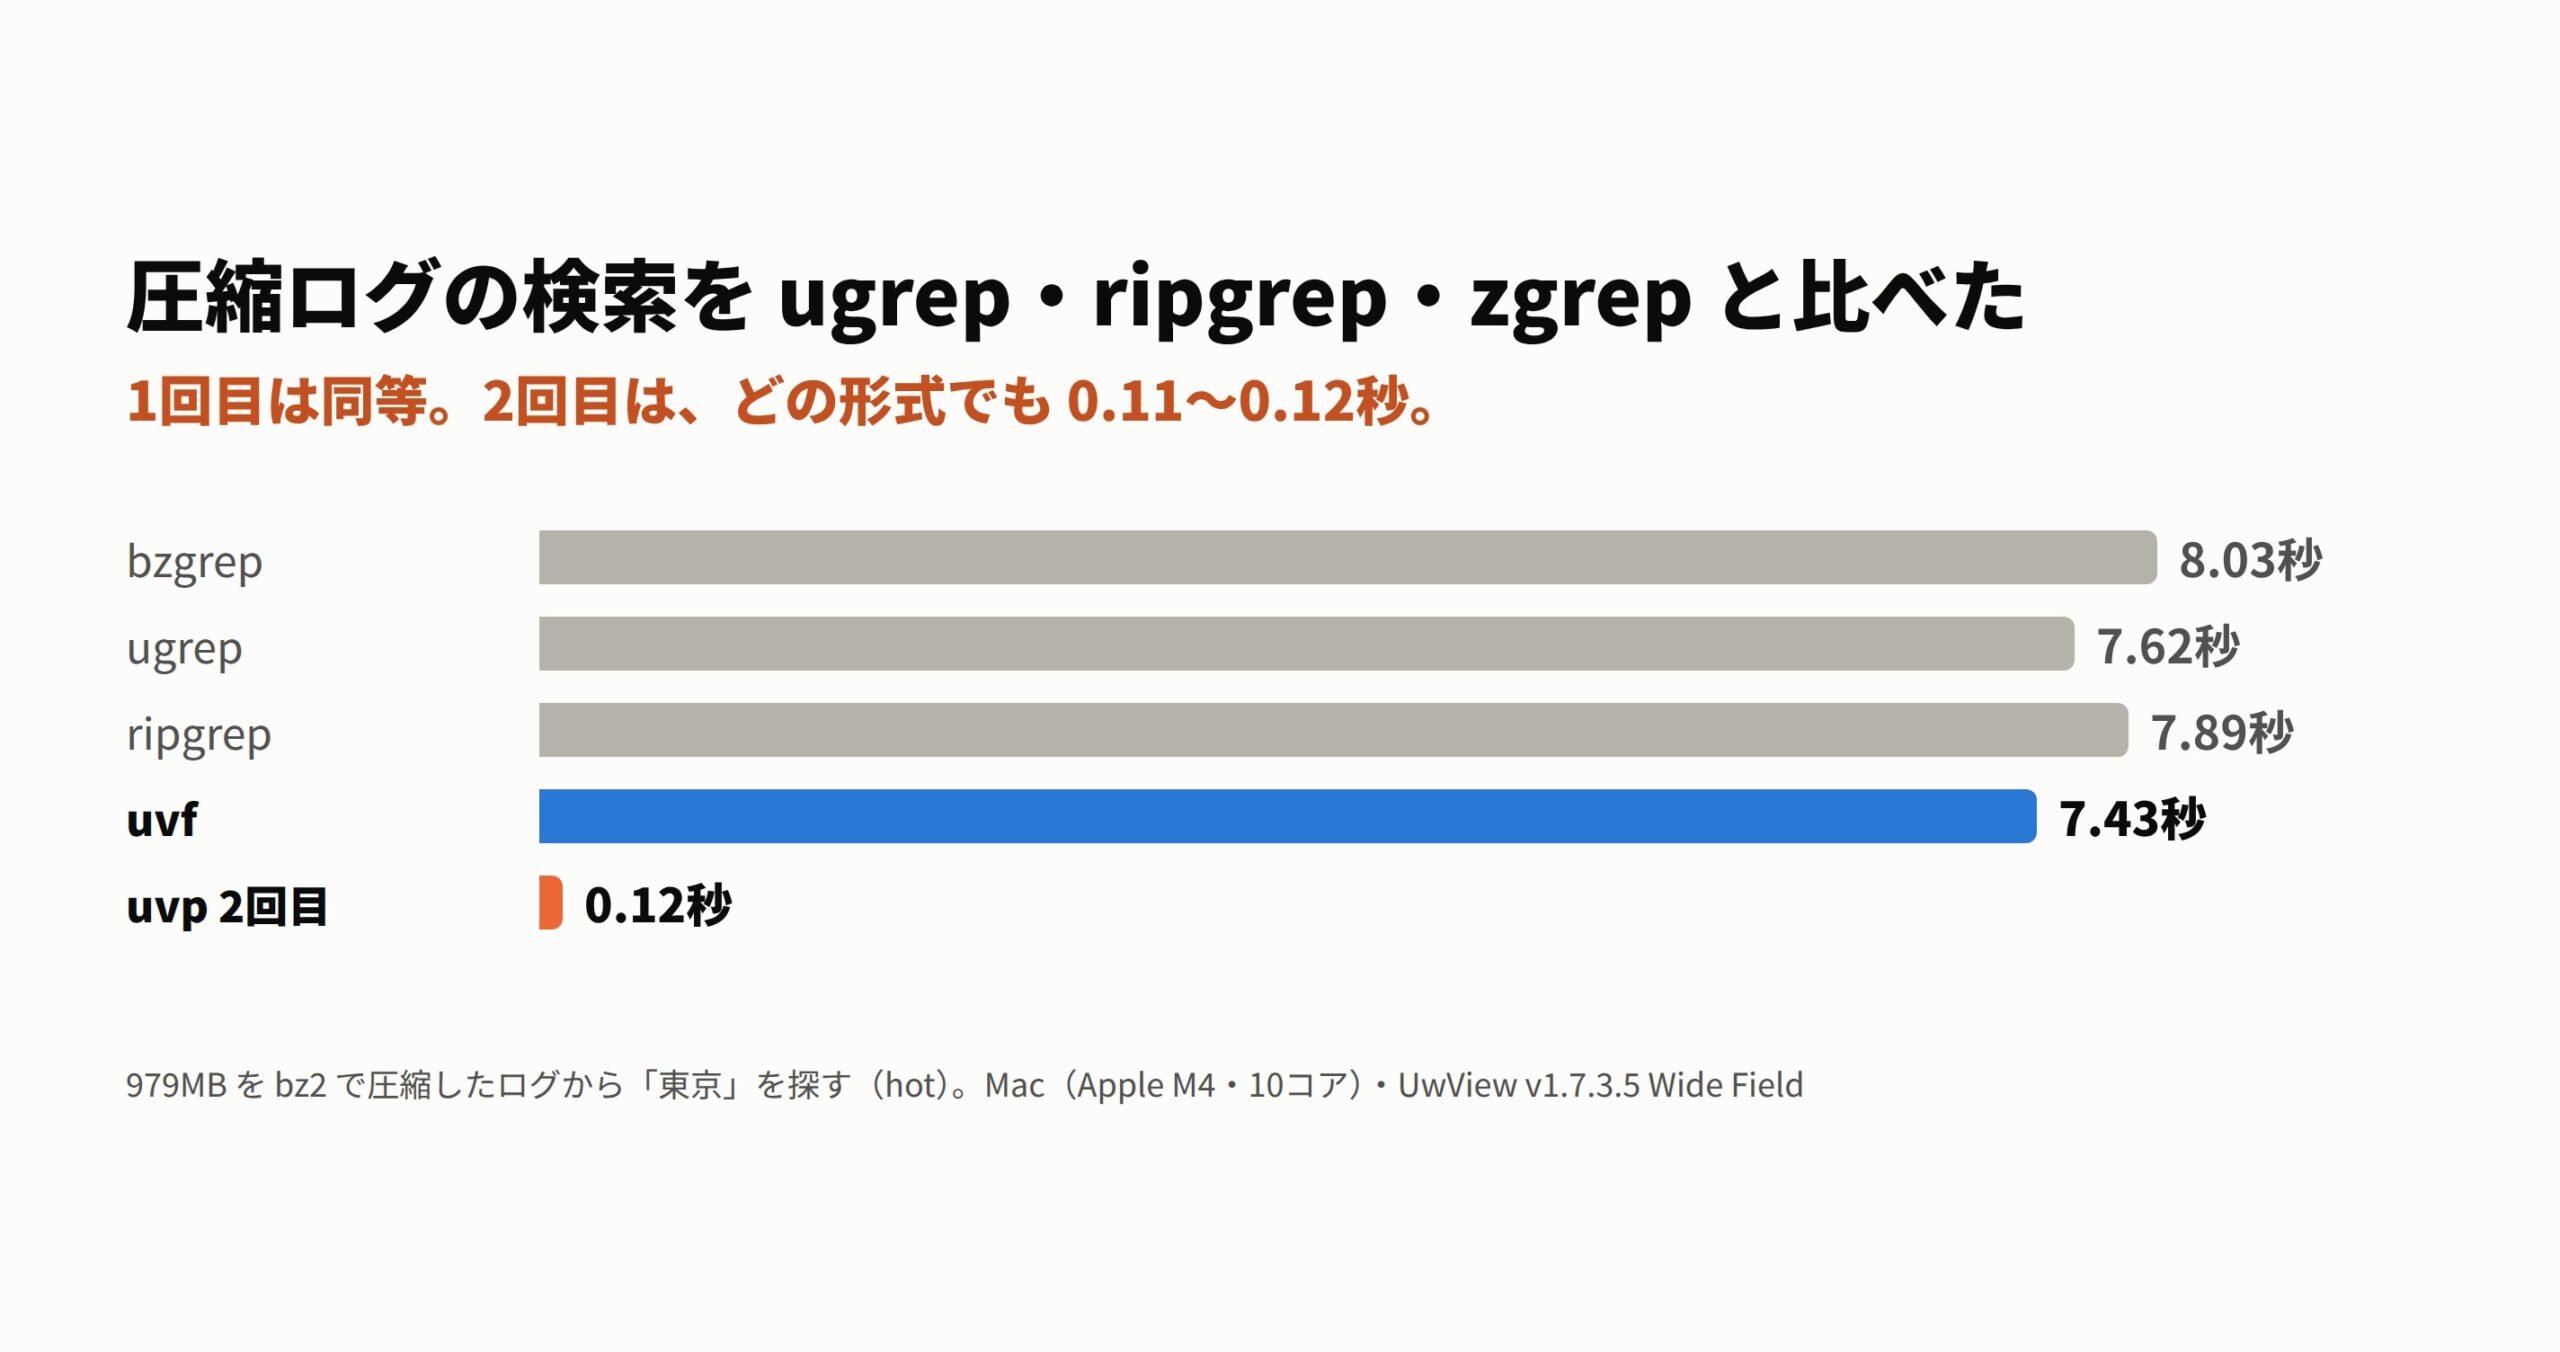
bz2 は、1回目なら7〜8秒。
圧縮したログを探すとき、zgrep を使っていますか。それとも ugrep -z や rg -z でしょうか。道具を替えれば速くなる——と思って、同じ圧縮ログを 7 形式・6 つの道具で探し比べました。
道具を替えて縮むのは、ある条件のときだけでした。秒数がまるで別物になったのは、道具ではなく「2回目」のほうです。
先に結論: 1回だけ探すなら、ugrep・ripgrep・uvf は 7 形式すべてで同等(差は 1.03〜1.36倍)。各形式の標準の grep(zgrep など)にだけ、gz 2.73倍・lz4 2.32倍・br 1.80倍の差がつきます。同じファイルを2回目に探すなら、uvp が元の形式によらず 0.11〜0.12秒(bz2 で uvf より 62倍速い)。複数のファイルを1回で探すと、zgrep は uvf の 5.08倍かかりました。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。
先に負けを書きます
- 1回目の差は「勝ち」ではありません。 1回目どうしで比べると
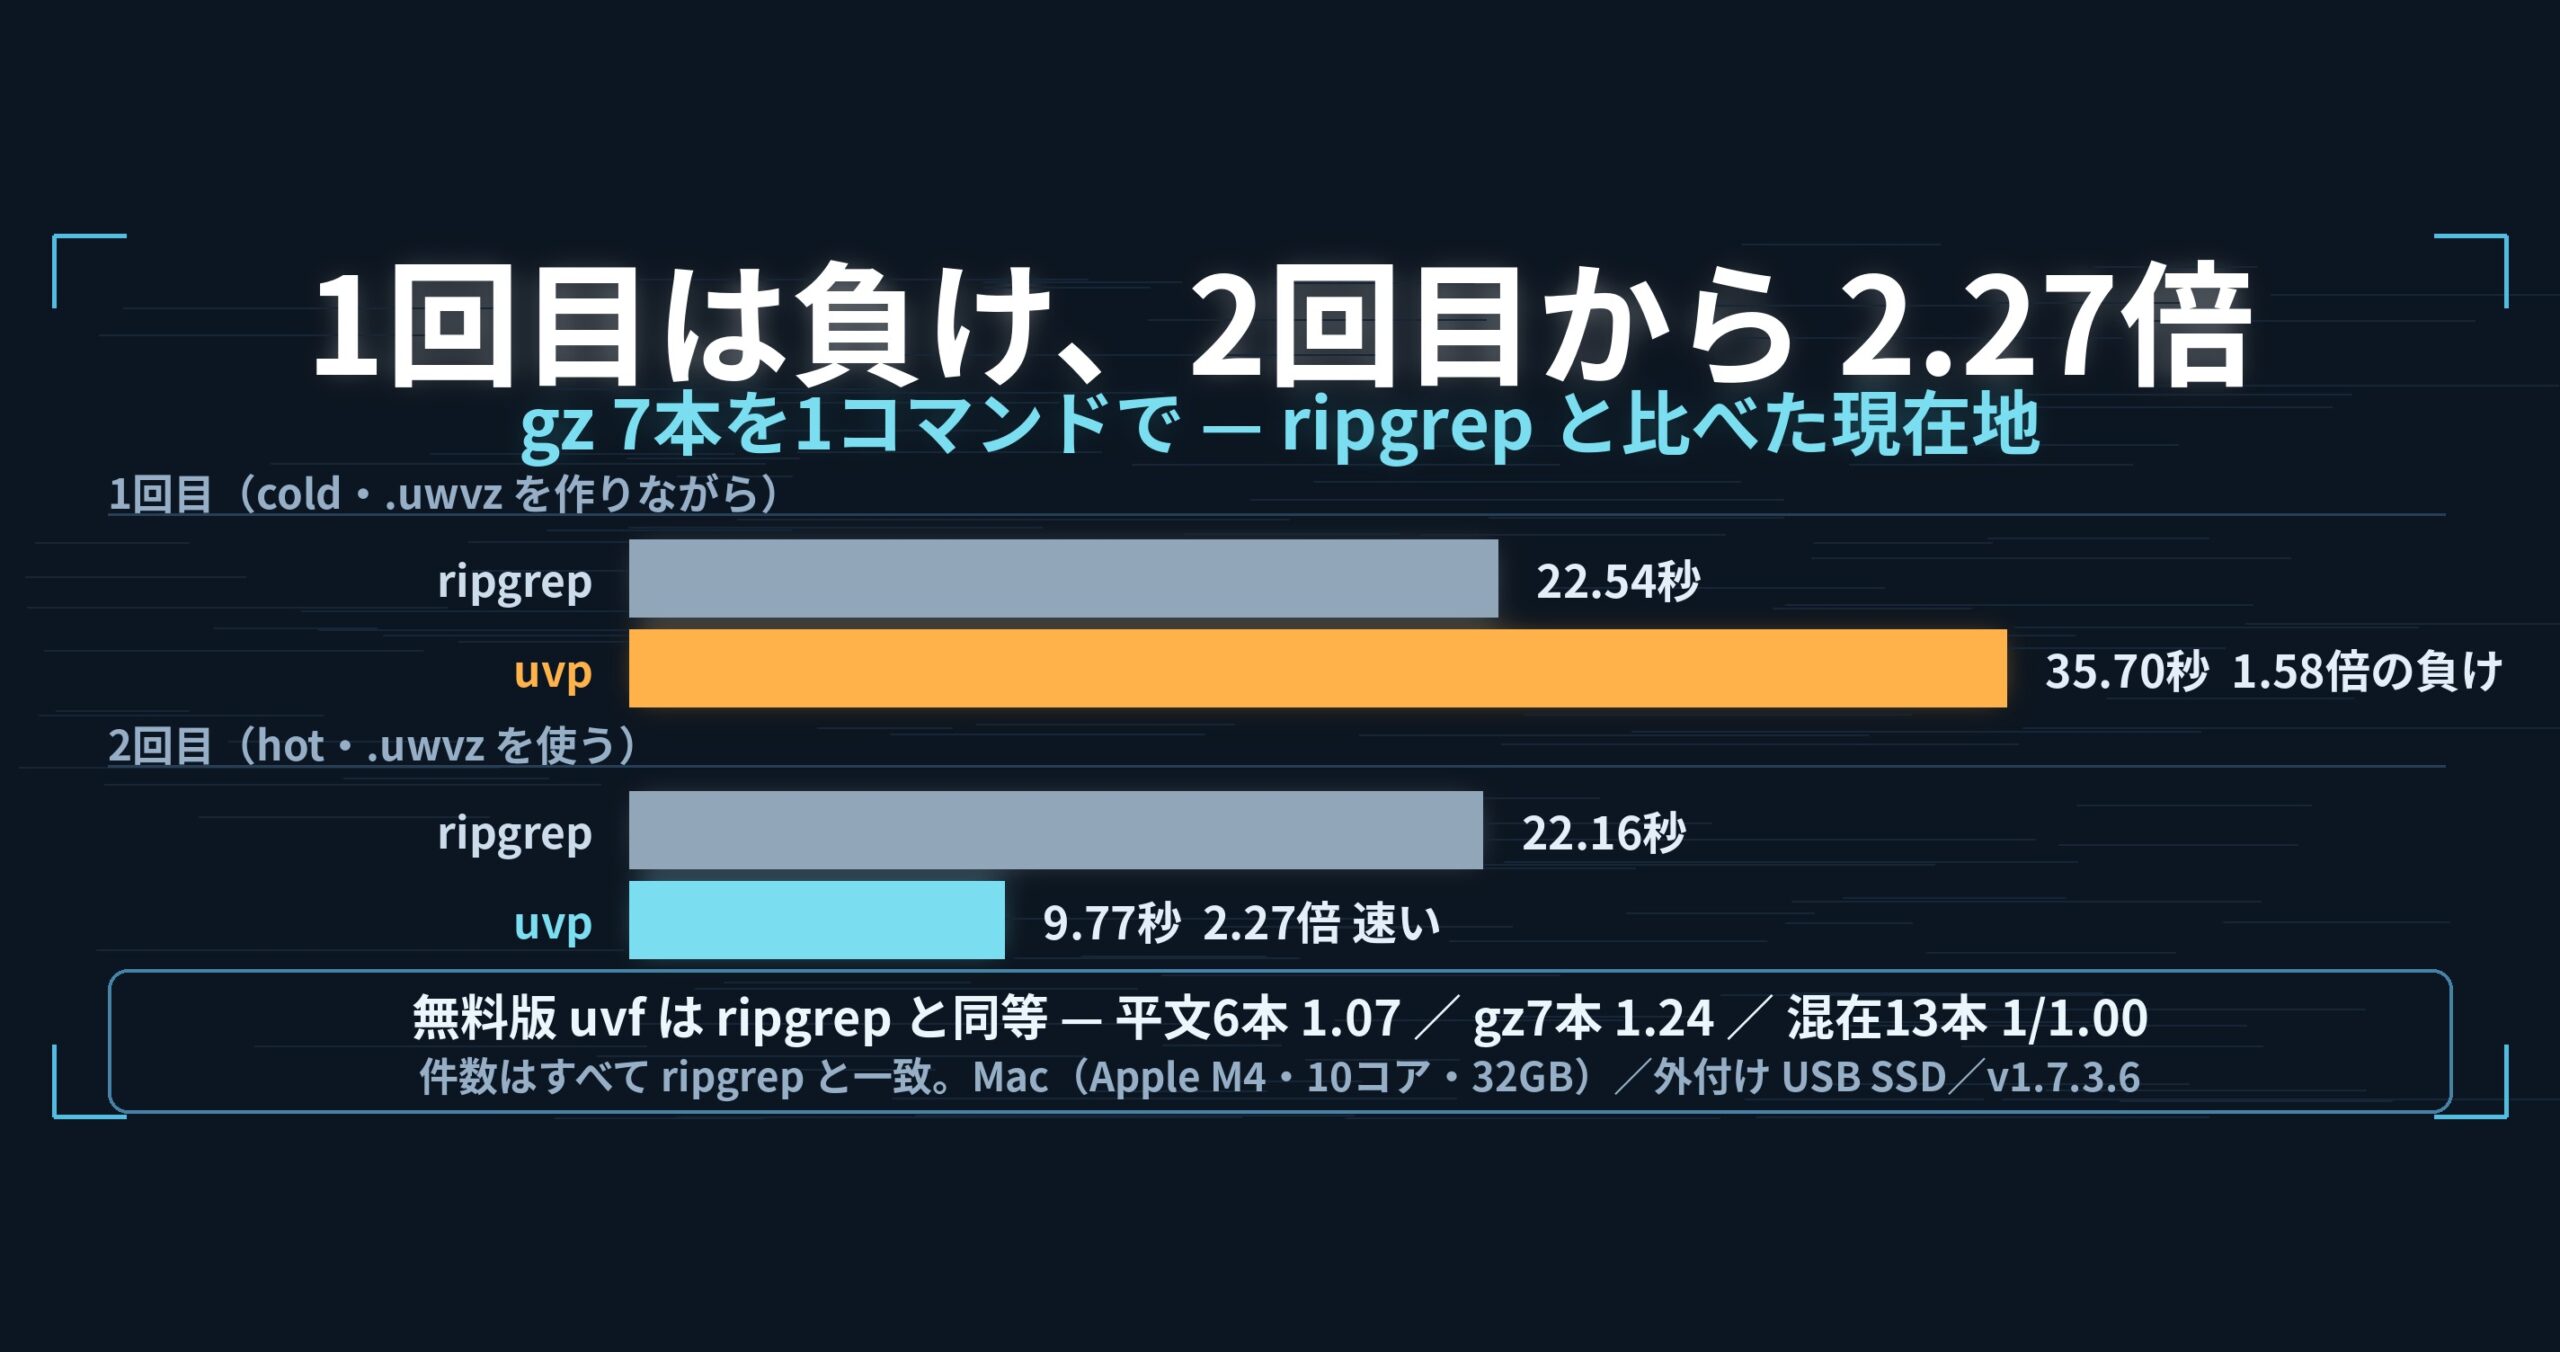
uvfは 7 形式すべてでいちばん短い値でしたが、ugrep・ripgrep との差は 1.03〜1.36倍です。この記事では 1.5倍未満を「同等」と書き、差とは呼びません。 - 平文だけを複数まとめて探すと、ripgrep の方が少し速い結果でした(平文 5 本で
uvfは ripgrep の 1/1.17。同等の範囲です。uvf1.7.2.7・cold+hot の別計測)。 uvpは、複数のファイルを束ねる1回目が遅い。 12 本で 41.23秒、uvfの 17.60秒の 2.34倍かかります。束ねた索引を書くぶんです。
7 形式を1本ずつ探す
同じ 979MB の OpenStreetMap XML を 7 形式で圧縮し、「東京」(1,145行)を探しました。hot(キャッシュが温まった状態)で各2回測り、速い方を載せています。秒・短いほど速い。
| 形式(大きさ) | 標準の grep | ugrep | ripgrep | uvf |
uvp 1回目 |
uvp 2回目 |
|---|---|---|---|---|---|---|
| gz(111MB) | 0.90(zgrep) | 0.45 | 0.43 | 0.33 | 0.42 | 0.12 |
| bz2(88MB) | 8.03(bzgrep) | 7.62 | 7.89 | 7.43 | 7.64 | 0.12 |
| xz(56MB) | 4.01(xzgrep) | 3.64 | 4.21 | 3.37 | 3.44 | 0.11 |
| lzma(56MB) | 3.21(xzgrep) | 2.83 | 3.40 | 2.57 | 2.64 | 0.12 |
| zst(122MB) | 0.63(zstdgrep) | 0.65 | 0.54 | 0.50 | 0.57 | 0.12 |
| lz4(186MB) | 0.65(lz4 -dc | grep) | 0.33 | 0.31 | 0.28 | 0.35 | 0.12 |
| br(106MB) | 1.33(brotli -dc | grep) | 0.91 | 0.87 | 0.74 | 0.85 | 0.12 |
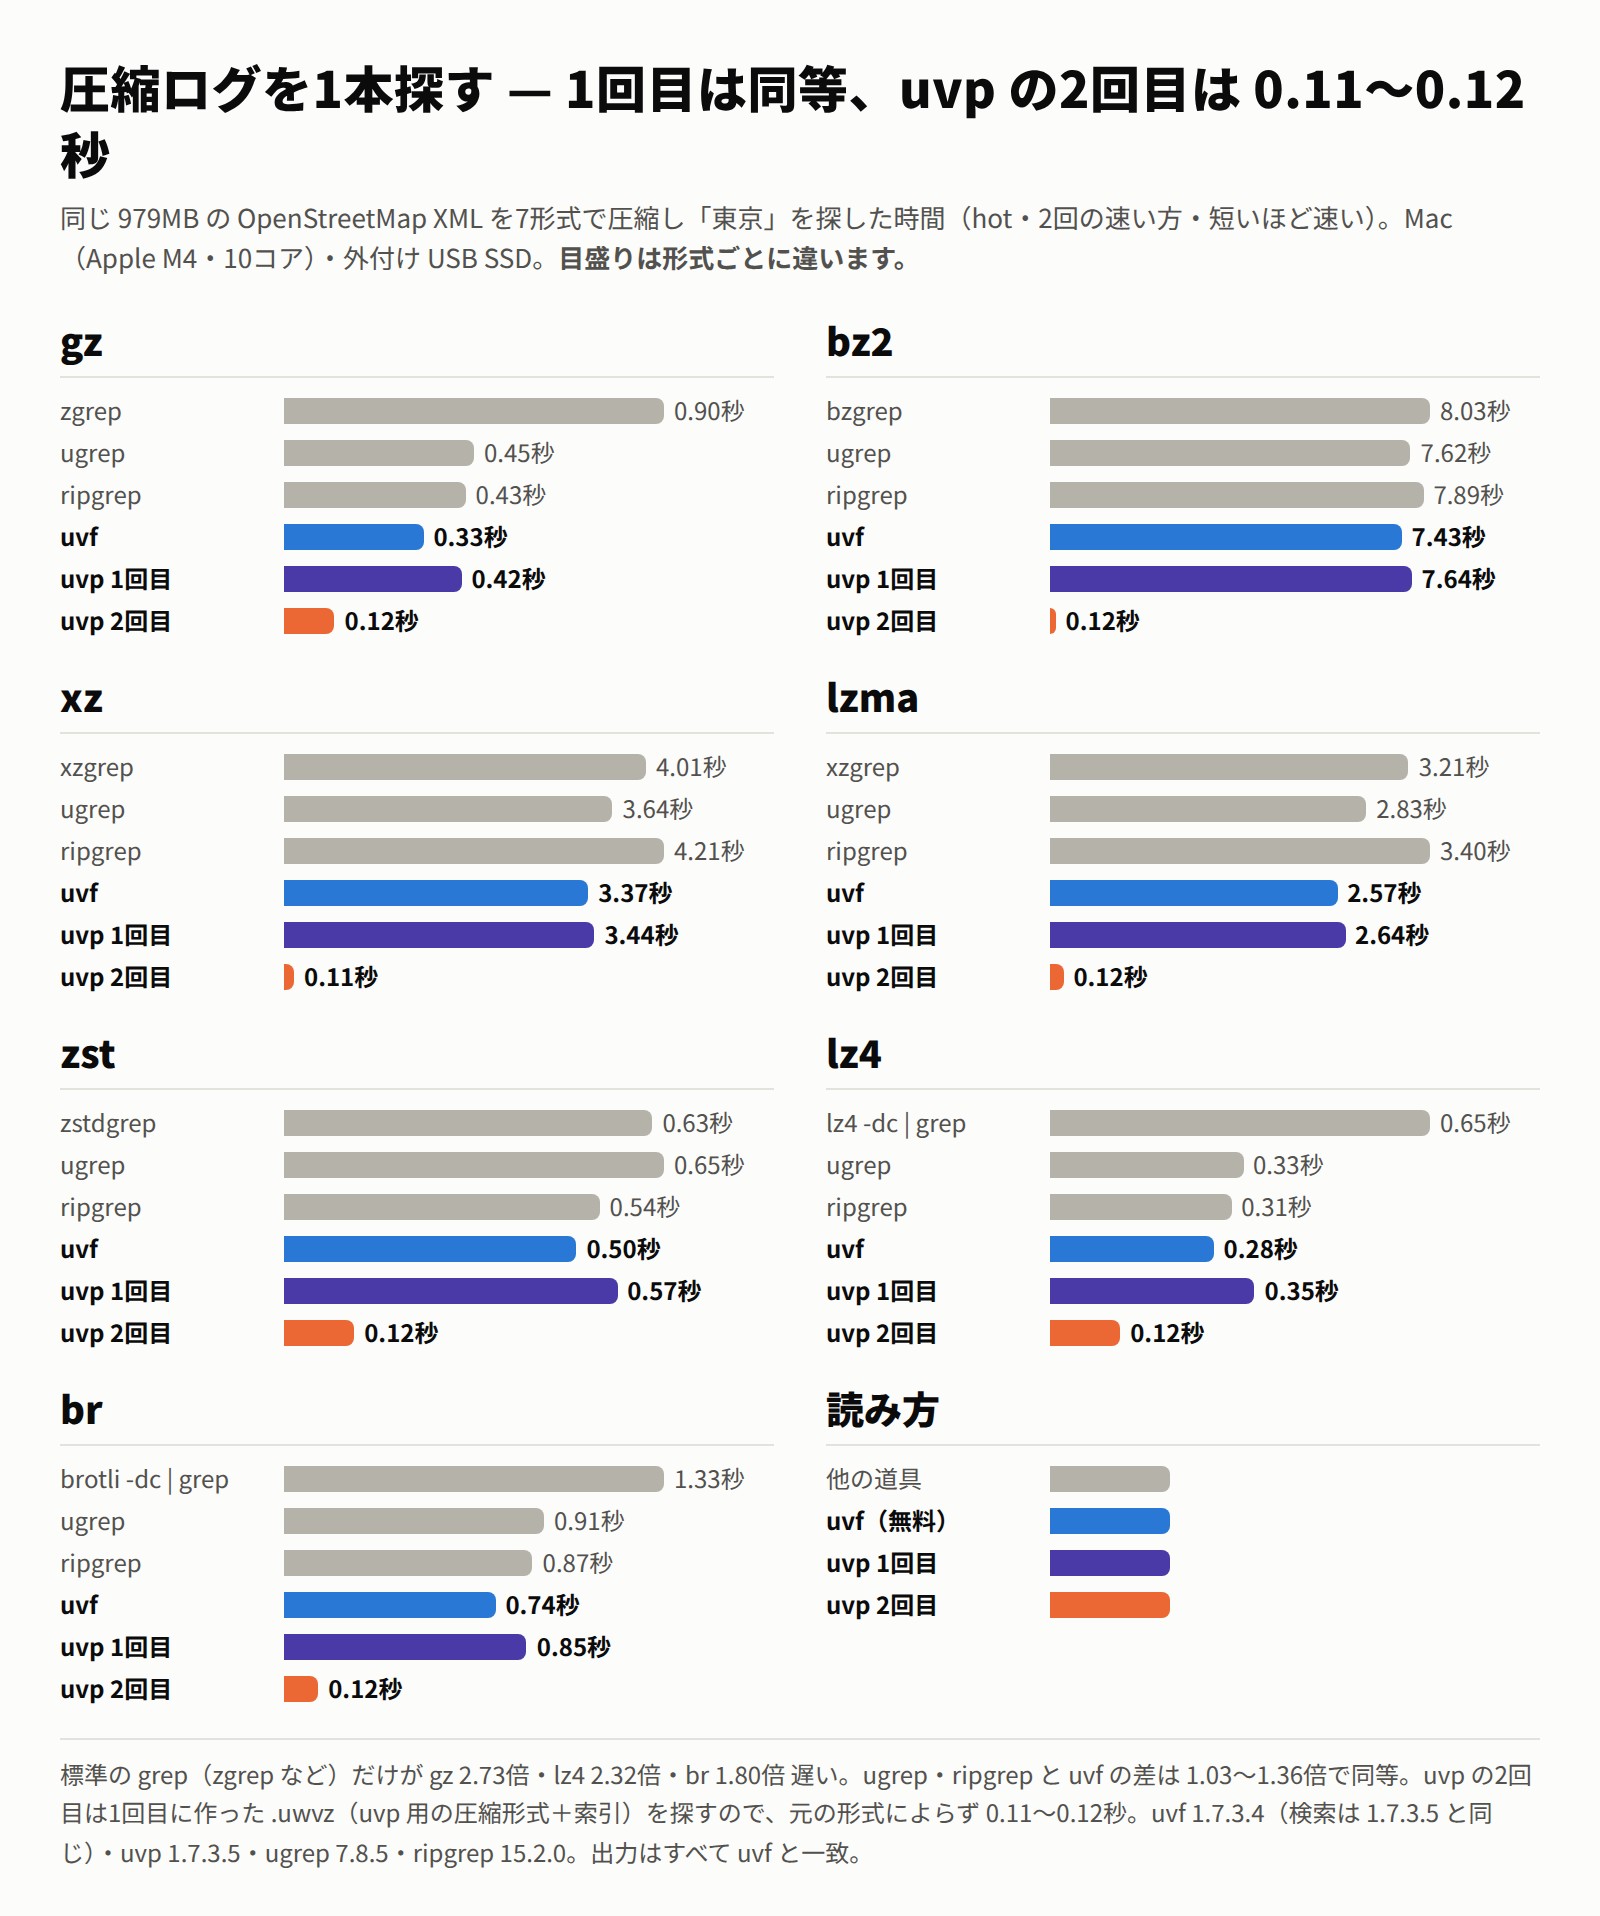
すべての測定で、出力の行数と中身(ファイル名・行番号・本文)を uvf と突き合わせて、一致を確かめています。
差がつくのは標準の grep だけ
ugrep・ripgrep・uvf の3つは、どの形式でも 1.36倍以内に収まりました。差がついたのは各形式の標準の grep で、gz(zgrep)が uvf の 2.73倍、lz4 が 2.32倍、br が 1.80倍です。標準の grep は、展開コマンドの出力を grep に流す作りです(lz4 と br は専用の grep が無いので、lz4 -dc と brotli -dc を自分でパイプでつなぎました)。ripgrep の -z も外部の展開コマンド(gzip・xz など)を呼び出しますが、こちらは ugrep・uvf と差が出ませんでした。uvf は外部のコマンドを呼ばず、中に持っている展開の仕組みで読みます。
逆に、bz2・xz・lzma・zst では、標準の grep も同等でした(1.08〜1.26倍)。特に bz2 は、索引の無い道具はどれも 7〜8秒。展開そのものが重く、どの道具もそこで律速されるので、道具を替えても縮みません。冒頭の「7〜8秒」はこのことです。
なぜ uvp の2回目だけ 0.11〜0.12秒なのか
ここは疑われるところなので、見出しを立てて書きます。
uvp は1回目に探しながら、.uwvz(uvp 用の圧縮形式+索引)を作ります。2回目からは元の圧縮ファイルを展開せず、.uwvz を探します。 bz2 でも lz4 でも、2回目に読むのは同じ .uwvz なので、元の形式の重さが消えて 0.11〜0.12秒にそろいます。uvf と比べると 2.3〜62倍(bz2 62倍・xz 31倍・lzma 21倍)です。
.uwvz を作る1回目も遅くはありません。uvf と比べて 1.02〜1.27倍で、同等です。使ったメモリーは1回目 0.12〜0.19GB、2回目 0.07GB でした。
つまり「速い grep に替える」のではなく、「2回目に展開しない」ことで秒数が変わっています。 1回しか探さないログなら、この差は出ません。
複数のファイルをまとめて探す
ログは1本では済みません。ローテーションで増えた gz を、まとめて探すことのほうが多いはずです。
| hot・秒 | zgrep | ugrep | ripgrep | uvf |
uvp 1回目(束ねる) |
uvp 2回目 |
|---|---|---|---|---|---|---|
| gz 5 本(展開後 約 7.4GB・16,069行) | 9.43 | 2.56 | 1.34 | 1.04 | 3.04 | 0.73 |
| gz 7 本+平文 5 本=12 本(展開後 約 60GB・127,886行) | 89.35 | 25.38 | 24.62 | 17.60 | 41.23 | 9.52 |
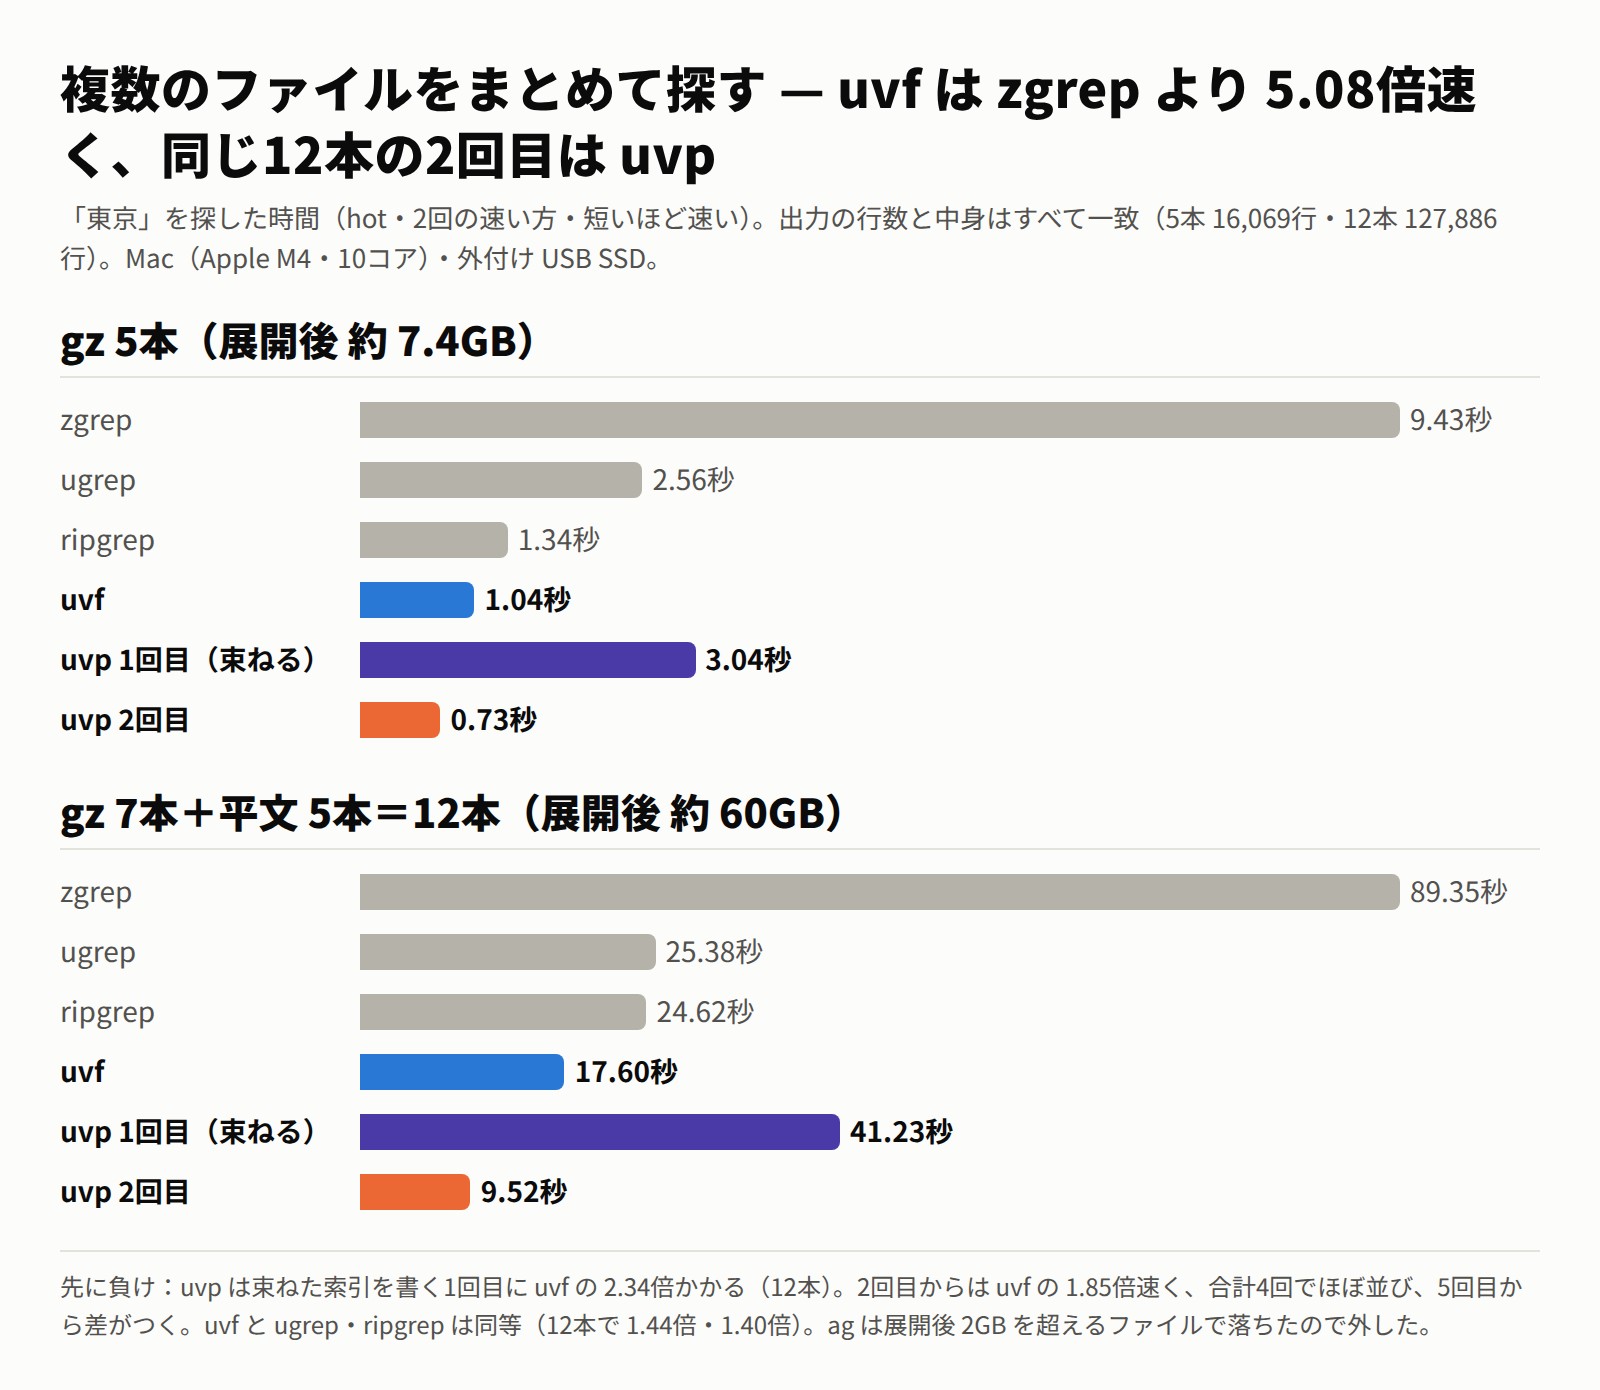
zgrepとの差がいちばん大きく開きます:5 本で 9.07倍、12 本で 5.08倍。zgrepは1本ずつ・1つのスレッドで展開するので、本数が増えるほど差が開きます。- ugrep・ripgrep と
uvfは同等です(12 本で 1.44倍・1.40倍)。キャッシュを捨てた cold でも、12 本でuvf21.35秒・ugrep 26.85秒と同等でした。 uvfの書き方はuvf 'osm17/*.gz,osm17/*.osm' 東京のように、ワイルドカードとカンマで1つの引数にまとめます。平文と圧縮が混ざっていても1回で済みます。
uvp は、合計4回で並び、5回目から差がつきます
uvp は1回目に 12 本を1本の .uwvz(約 8.2GB)に束ねるので、uvf より約24秒多くかかります。そのかわり2回目からは 9.52秒で、uvf の 1.85倍速い。1回あたり約8秒ずつ縮むので、合計4回でほぼ並び(69.79秒 対 70.40秒)、5回目からははっきり uvp の方が短くなります(79.31秒 対 88.00秒)。
同じログ群に何度も戻る調査なら uvp、1回で終わるなら uvf。分かれ目は回数です。
ag を比べる相手から外した理由
The Silver Searcher(ag)も測りましたが、表からは外しました。速さ以前に、正しく探せなかったからです。
-zだけでは圧縮ファイルを飛ばします。--search-binaryを付けても、展開できたのは gz・xz・lzma の3形式だけでした(bz2・zst・br は 0行、lz4 は偶然一致した誤りの1行)。- 展開後 2GB を超えるファイルで落ちます(Segmentation fault)。gz 5 本では、そこまでに書いた 1,197行(正しくは 16,069行)だけが残りました。
測るときに気をつけたこと
grep 系の比較は、0件のまま速く終わることがあります。
- ugrep は
-zを付けないと圧縮ファイルを展開せず、0件で速く終わります(最初の計測の 9.0秒は、実は 0件でした)。 - ripgrep の zst は、ファイルがシンボリックリンクだと 0件になりました(呼び出す
zstdがリンクを飛ばすため)。実体のパスで測っています。 uvpの1回目は、.uwvzを消してから測ります。消し忘れると2回目の値になります。
秒数を比べる前に、出力の行数と中身をそろえる。 今回の表の値は、すべてこの確認を通したものです。
測り方
- ファイル: OpenStreetMap(日本)の XML。1本の比較は同じ 979MB を 7 形式で圧縮(1,145行)。複数ファイルは gz 5 本(16,069行)と gz 7 本+平文 5 本(127,886行)
- 語:
東京(固定文字列・行番号つき) - 状態: hot・各2回の速い方。12 本の cold だけは別に
sudo purgeのあとで測った値 - 道具: 標準は macOS の
zgrep・bzgrep(BSD grep 2.6.0)・xzgrep(XZ Utils 5.8.4)・zstdgrep(zstd 1.5.7)・lz4 -dc(1.10.0)とbrotli -dc(1.2.0)を BSD grep へパイプ/ugrep 7.8.5ugrep -z -n -F/ripgrep 15.2.0rg -z -n -F/ag 2.2.0ag -z --search-binary -Q/uvf1.7.3.4(検索の処理は 1.7.3.6 と同じ)/uvp1.7.3.5(検索の処理は 1.7.3.6 と同じ) - Mac(Apple M4・10コア・メモリ 32GB)/外付け USB SSD。秒数は環境によって変わります
形式ごとの縮み方・圧縮の時間・cold での比較は、ログは圧縮したほうが、速く探せます に書きました(そちらは ripgrep の -z と比べた cold の値です)。
使っている道具
UwView は、巨大なテキストファイルを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと 7 つの圧縮形式を、外部のコマンドなしで1回で探せます。
uvf app.log.bz2 ERROR                  # 圧縮ファイルを展開しながら探す(無料)
uvf 'app.log,app.log.*.gz' ERROR       # 平文と圧縮を混ぜて、1回で(無料)
uvf '**/*.log.gz' ERROR -open          # 探して、結果を GUI で読む(無料)
uvp 'app.log,app.log.*.gz' ERROR       # 束ねて、2回目から速く(UwView Pro)
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- ログは圧縮したほうが、速く探せます(7 形式の縮み方と選び方): https://uvp.y42u.net/blog/log-compression-format-choice/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- uvf コマンド操作マニュアル(GitHub): https://github.com/amru195704/UwView/blob/main/2-doc/uvf_コマンド操作マニュアル.md
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。