【追記 2026-10-04】v1.7.3.6.8 で、2回目(hot)の読み方が速くなりました
この記事の「平文5本の2回目は
uvfが遅い側(1/1.38)」は v1.7.3.6 の値です。v1.7.3.6.8 で2回目の読み方(行番号のための改行の数え方)を見直しました。v1.7.3.6.9(2026年10月4日)で同じ平文5本を測ると、1回目は ripgrep 5.23秒・uvf5.11秒、2回目は 0.33秒どうし(1.00)、合計で 1.02倍(同等)でした。uvpの2回目は 0.47秒で ripgrep の 1/1.42(同等の範囲)です。混在12本の合計は ripgrep 50.16秒・uvf38.80秒(1.29倍)・uvp52.19秒(1/1.04)。本文の表は書いたときの測定のまま残しています。詳しくは Wide Field⑫ 「秒に出ない」と書いた改行の数え方が、2回目の検索の4割を占めていました。
1回目は、負けます。
ローテーションで溜まった .gz と、まだ圧縮していない当日分の平文。混ざったまま、まとめて探したいとき、rg -z に投げていますか。同じ 12 本を1コマンドで探して、ripgrep と並べてみました。
最初の1回は、こちらが負けます。では、何回目から引き合うのか。引き合わない組もありました。
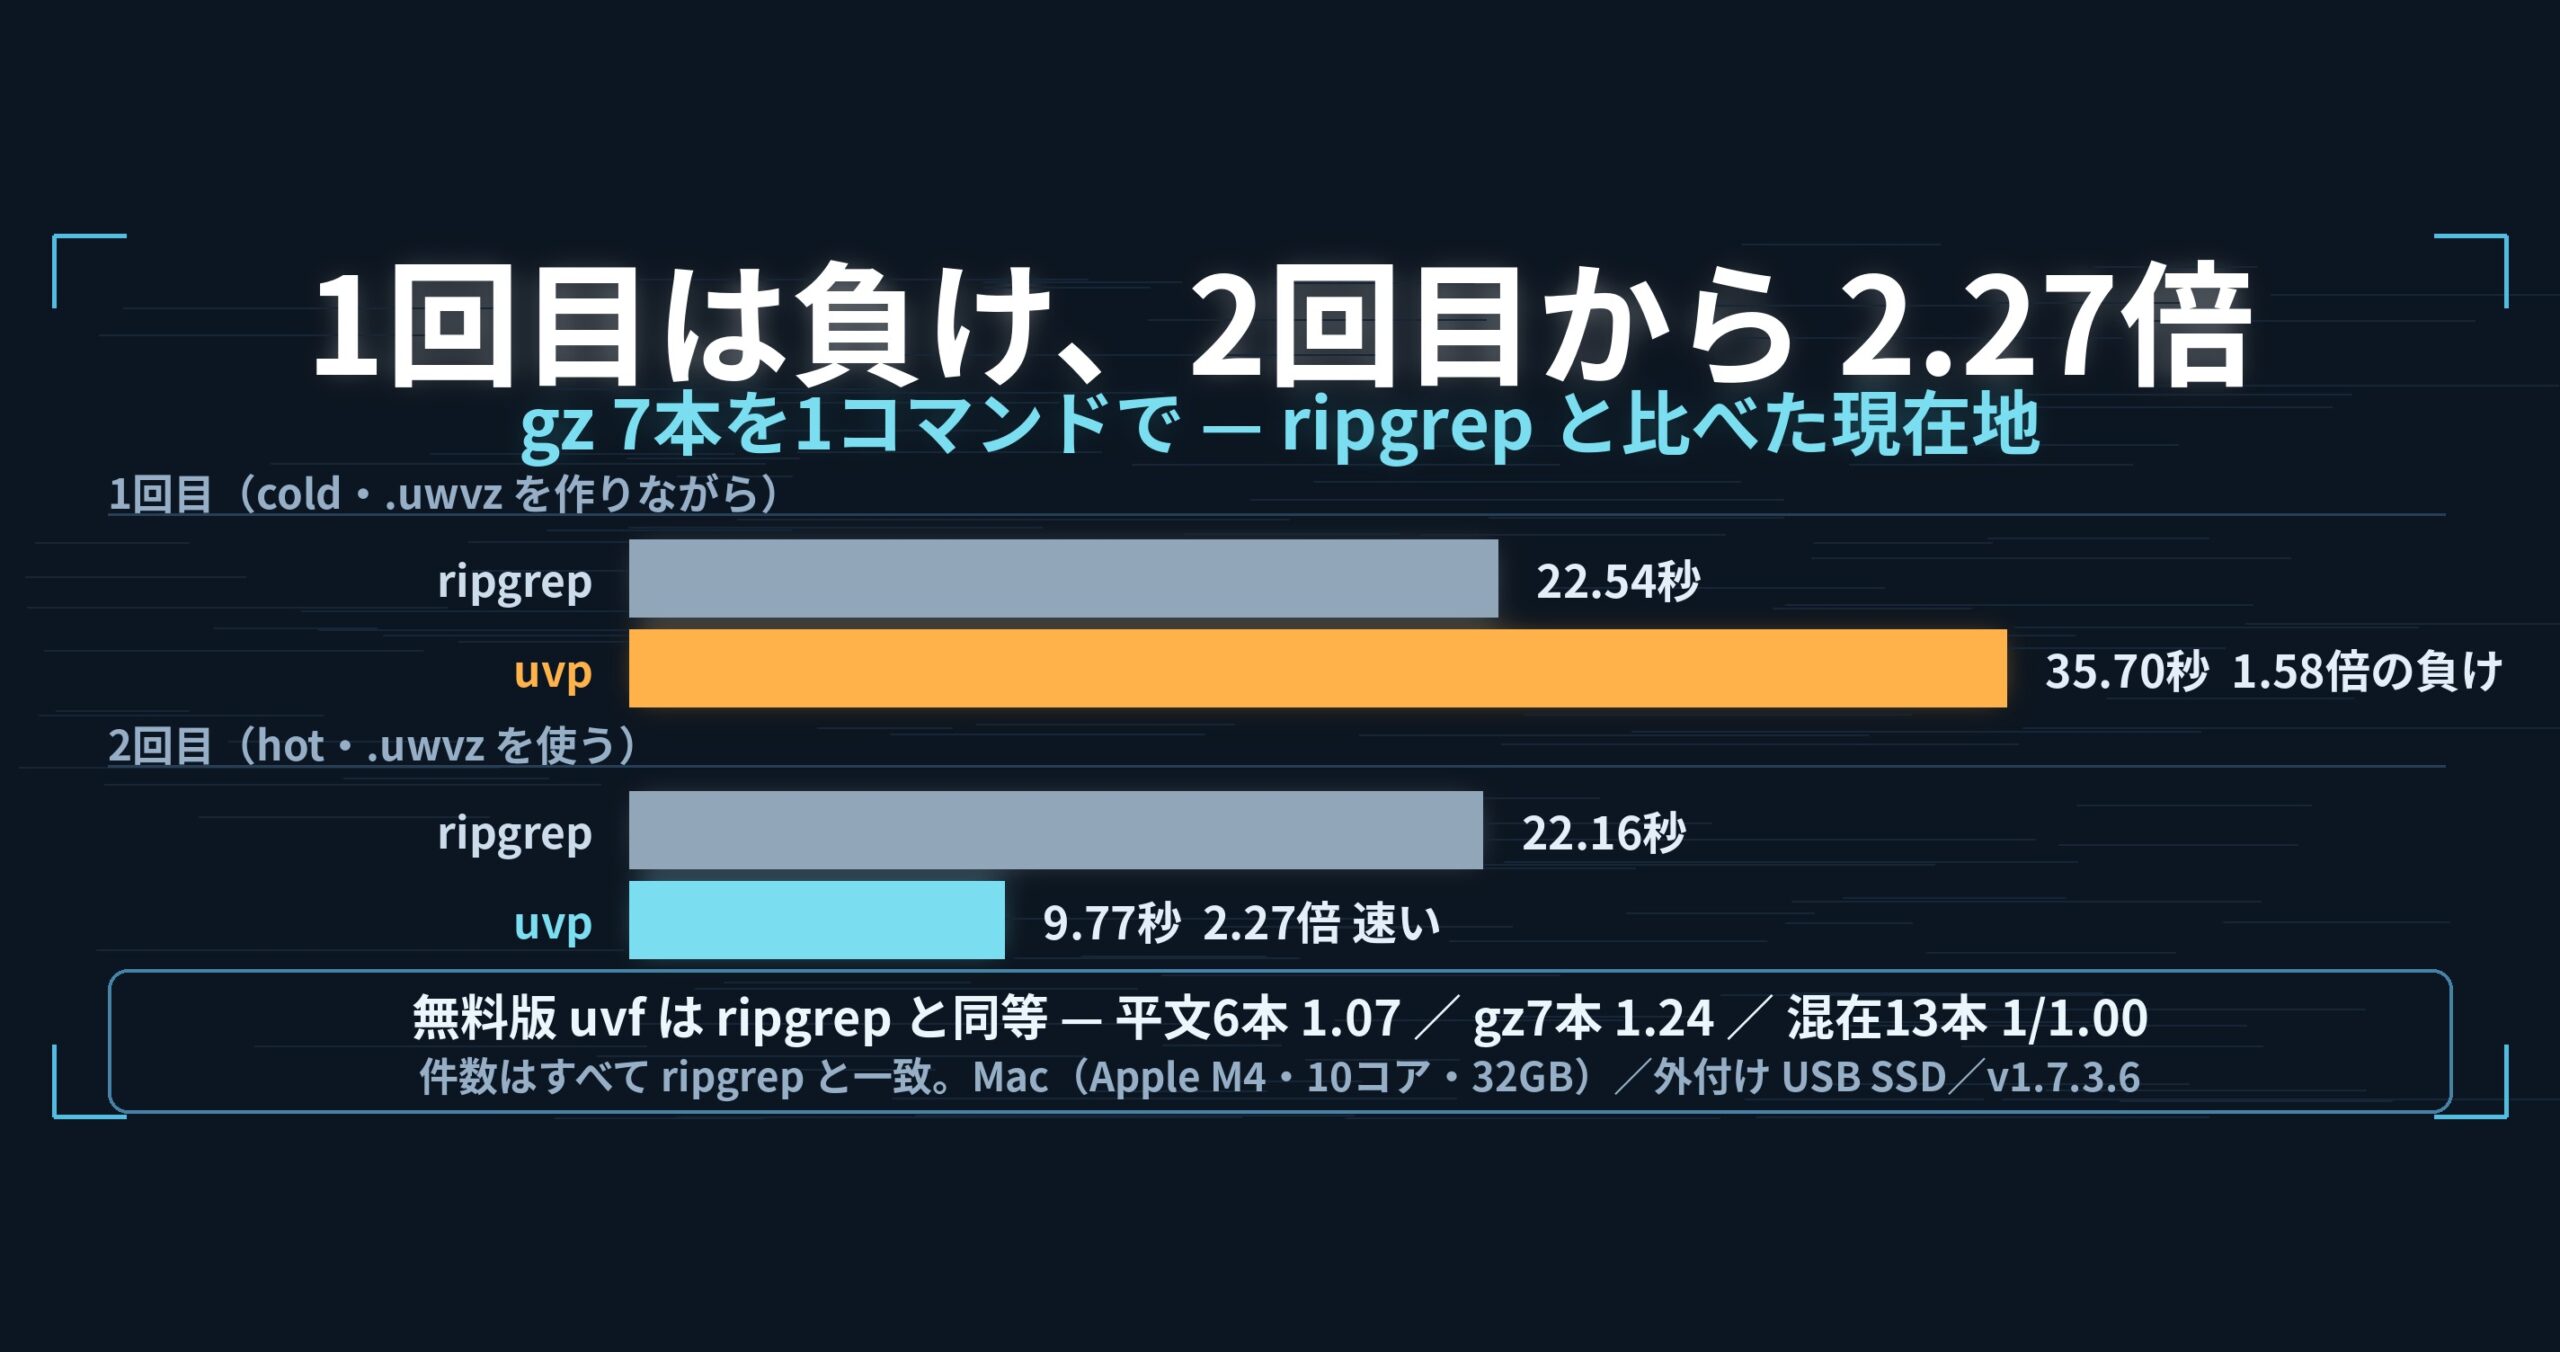
先に結論: 無料の uvf は3つの組とも ripgrep と同等(1.00〜1.31)。有料の uvp は束ねる1回目に 1.52〜1.62倍負け、2回目から 2.36〜2.42倍。ただし平文だけの組では、2回目も遅く、取り返せません
混在 12 本(osm17 の OpenStreetMap XML・当たり 127,886 件)を1コマンドで探したとき、1回目は ripgrep 25.57秒 対 uvp 41.45秒で 1.62倍の負け。2回目は ripgrep 25.22秒 対 uvp 10.43秒で 2.42倍。gz 7 本も同じ形で、1回目 1/1.52(23.12秒 対 35.20秒)→ 2回目 2.36倍(23.09秒 対 9.80秒)です。索引を持たない無料版 uvf は3つの組とも ripgrep と同等でした(1.03/1.30/1.09)。件数はすべて ripgrep と一致しています。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。数字は公開した v1.7.3.6 を 2026年10月1日に測り直したものです(この記事は当初、別の組で測った数字を載せていました。詳しくは末尾の「正直に書いておくこと」に書きます)。
先に負けを書きます
uvpの1回目は、はっきり負けます。 混在 12 本で 41.45秒 対 ripgrep 25.57秒=1/1.62、gz 7 本で 35.20秒 対 23.12秒=1/1.52。この記事では 1.5倍以上を「差」と呼ぶので、これは同等ではなく負けです。- 平文だけの組では、
uvpは2回目も遅い。 平文 5 本の2回目は ripgrep 0.37秒 対uvp0.55秒。縮むどころか伸びています。何回繰り返しても取り返せません。 uvfの 1.30 を「勝ち」とは書きません。 gz 7 本の 1.30 も、混在の 1.09 も、基準の 1.5倍に届かないので同等です。- 混在 12 本は、2回計でもまだ追いついていません(51.88秒 対 50.79秒=1/1.02)。追い越すのは3回目からです。
Wide Field で何ができるようになったか
v1.7 のペットネームは Wide Field。名前のとおり、1回に見る範囲が広がった版です。
- 複数のファイルを1コマンドで探す(この記事の主題)
- 7 つの圧縮形式を、外部コマンドなしで読む(gz・bz2・xz・lzma・zst・lz4・br)
- zip の中を、エントリごとに探す
- OpenStreetMap の pbf を、変換せずに探す
v1.6 までは「1本の巨大ファイルを速く読む」ことだけを考えていました。ところが実際のログは、app.log・app.log.1・app.log.2.gz……と本数で増えていきます。1本ずつコマンドを打ち直していたのでは、速さの話以前に手間が増えます。
3つの並べ方で測る
osm17 の OpenStreetMap XML を、次の3つの組み合わせで測りました。検索語は「東京」(固定文字列・行番号つき)。sudo purge のあと10秒待ってからの 1回目(cold) と、続けて走らせた 2回目(hot) を分けています。
| 組み合わせ | 大きさ | ripgrep | uvf(倍率) |
uvp 1回目 |
uvp 2回目 |
|---|---|---|---|---|---|
| 平文 5 本(5,445 件) | 4.78GiB | 5.23/0.37秒 | 5.09/0.51秒(1.03/1/1.38) | 6.21秒=1/1.19 | 0.55秒=1/1.49 |
| gz 7 本(122,441 件) | 7.13GiB | 23.12/23.09秒 | 17.82/17.67秒(1.30/1.31) | 35.20秒=1/1.52 | 9.80秒=2.36倍 |
| 平文5本+gz7本=12 本(127,886 件) | 11.91GiB | 25.57/25.22秒 | 23.48/23.48秒(1.09/1.07) | 41.45秒=1/1.62 | 10.43秒=2.42倍 |
2つ並んだ秒数は cold/hot です。uvf の倍率は ripgrep を1としたときの値で、大きいほうが速い側。uvp の「1/1.62」は、ripgrep の 1.62倍かかった=負けを表します。
uvf は、どの組み合わせでも同等だった
無料版 uvf は索引を作らず、その場で読んで探します。ripgrep とやっていることがほぼ同じなので、結果も同じところに落ちます。混在 12 本では 1.09/1.07、平文 5 本の2回目にいたっては 1/1.38 で、こちらが遅い側に出ました。
ここを「勝ち」と書かないと決めています。 gz の 1.30倍は、その日のキャッシュの温まり方やディスクの空き具合で簡単にひっくり返る幅です。同等を勝ちに書き換えると、その先に書く 2.42倍まで疑われます。
混在 12 本が、いちばん現場に近い
3つのうち、実際の運用にいちばん近いのは混在 12 本だと思っています。logrotate を素直に使うと、手元には「まだ圧縮されていない当日分の平文」と「昨日より前の .gz」が同時に並びます。平文だけ、gz だけ、という綺麗な状態は、むしろ作らないと出てきません。
その混在 12 本で、uvf は ripgrep の 1.09=同等、uvp は2回目から 2.42倍でした。平文が混ざっても比が崩れない——これは、平文と圧縮を同じ経路で扱っている(読み出しの前段で形式を見分けて、その先は共通)ことの裏返しです。形式ごとに別のコマンドへ振り分けていたら、こうはそろいません。
なぜ uvp の1回目だけが遅いのか
自社に有利な数字(2.42倍)の前に、不利な数字(1/1.62)の理由を書きます。ここが今回いちばん疑われるところだと思うので、見出しを立てました。
uvp は1回目に探しながら、入力ぶんを1本にまとめた .uwvz(uvp 用の圧縮形式+索引)を書き出します。混在 12 本の 41.45秒のうち、ripgrep と同じ「読んで探す」部分は 25秒台で、残りの約16秒は書き出しの代金です。書き出した .uwvz は 7.67GiB ありました。
2回目からは、元の gz を展開しません。.uwvz だけを読みます。 だから 10.43秒に落ちます。
取り返せるのは、どの組か
ここは引き算なので、組ごとに書きます。
| 組 | 1回目に余分に払う | 2回目からの短縮 | 判定 |
|---|---|---|---|
| 平文 5 本 | 約 1.0秒 | −0.18秒(むしろ伸びる) | 永久に取り返せない |
| gz 7 本 | 約 12.1秒 | 約 13.3秒/回 | 2回目で取り返す |
| 混在 12 本 | 約 15.9秒 | 約 14.8秒/回 | 3回目で追い越す |
gz 7 本は2回計でも 1.03 と前に出ますが、混在 12 本は2回計 1/1.02 でまだ追いついていません。3回目に 10秒台で済めば逆転します。
平文 5 本だけは、形が違います。 この組は 4.78GiB で、測定機のメモリ 32GB に収まる大きさです。ripgrep の2回目は 0.37秒——ほぼディスクを読んでいません。そこに索引を持ち込んでも、短縮する余地がありません。なぜ uvp のほうが 0.18秒遅いのか、原因は切り分けていません。ただ、どちらにせよ平文だけで、全部がメモリに収まる規模なら、uvp を使う理由がないという結論は動きません。
同じログ群に何度も戻る調査で、圧縮が混ざっていて、メモリに収まらない大きさなら uvp。それ以外は uvf で足ります。分かれ目は速さではなく、回数と大きさと形式です。
無料と有料の線
この記事では有料版の数字が出てくるので、線をはっきり書いておきます。設計時に決めた言い方はひとつです——「1回読むのは無料。2回目を速くするのは有料。」
- 複数ファイルの検索そのものは、無料の
uvfでできます(この記事のuvfの列がそれです) - 複数ファイルを1本の
.uwvzに束ねるのはuvp(有料)だけ - zip の中・pbf も
uvpのみ。uvfは案内を出して終了します
2回目以降が速くならなくてよいなら、無料版で ripgrep と同等の結果が出ます。 それがこの表の主張です。
書き方 — 引用符とカンマ
複数ファイルの指定は、1つの引数にまとめて渡します。
uvf 'osm17/*.gz,osm17/*.osm' 東京      # 平文と圧縮を混ぜて、1回で
uvf '**/*.log.gz' ERROR                # 再帰も同じ書き方
uvp 'app.log,app.log.*.gz' ERROR       # 束ねて、2回目から速く(UwView Pro)
ripgrep は rg -z ERROR *.gz *.log のようにファイルを並べますが、こちらは引用符で囲んだ1つの引数にします。引数はパターンと検索語の2つだけ、という形に決めました。
引用符は必須です。 外すとシェルが先に展開してしまい、こちらにはファイル名の列が届きます。その場合はエラーで止めるようにしました。黙って一部だけ探すより、止まったほうが安全だからです。
件数を先に合わせる
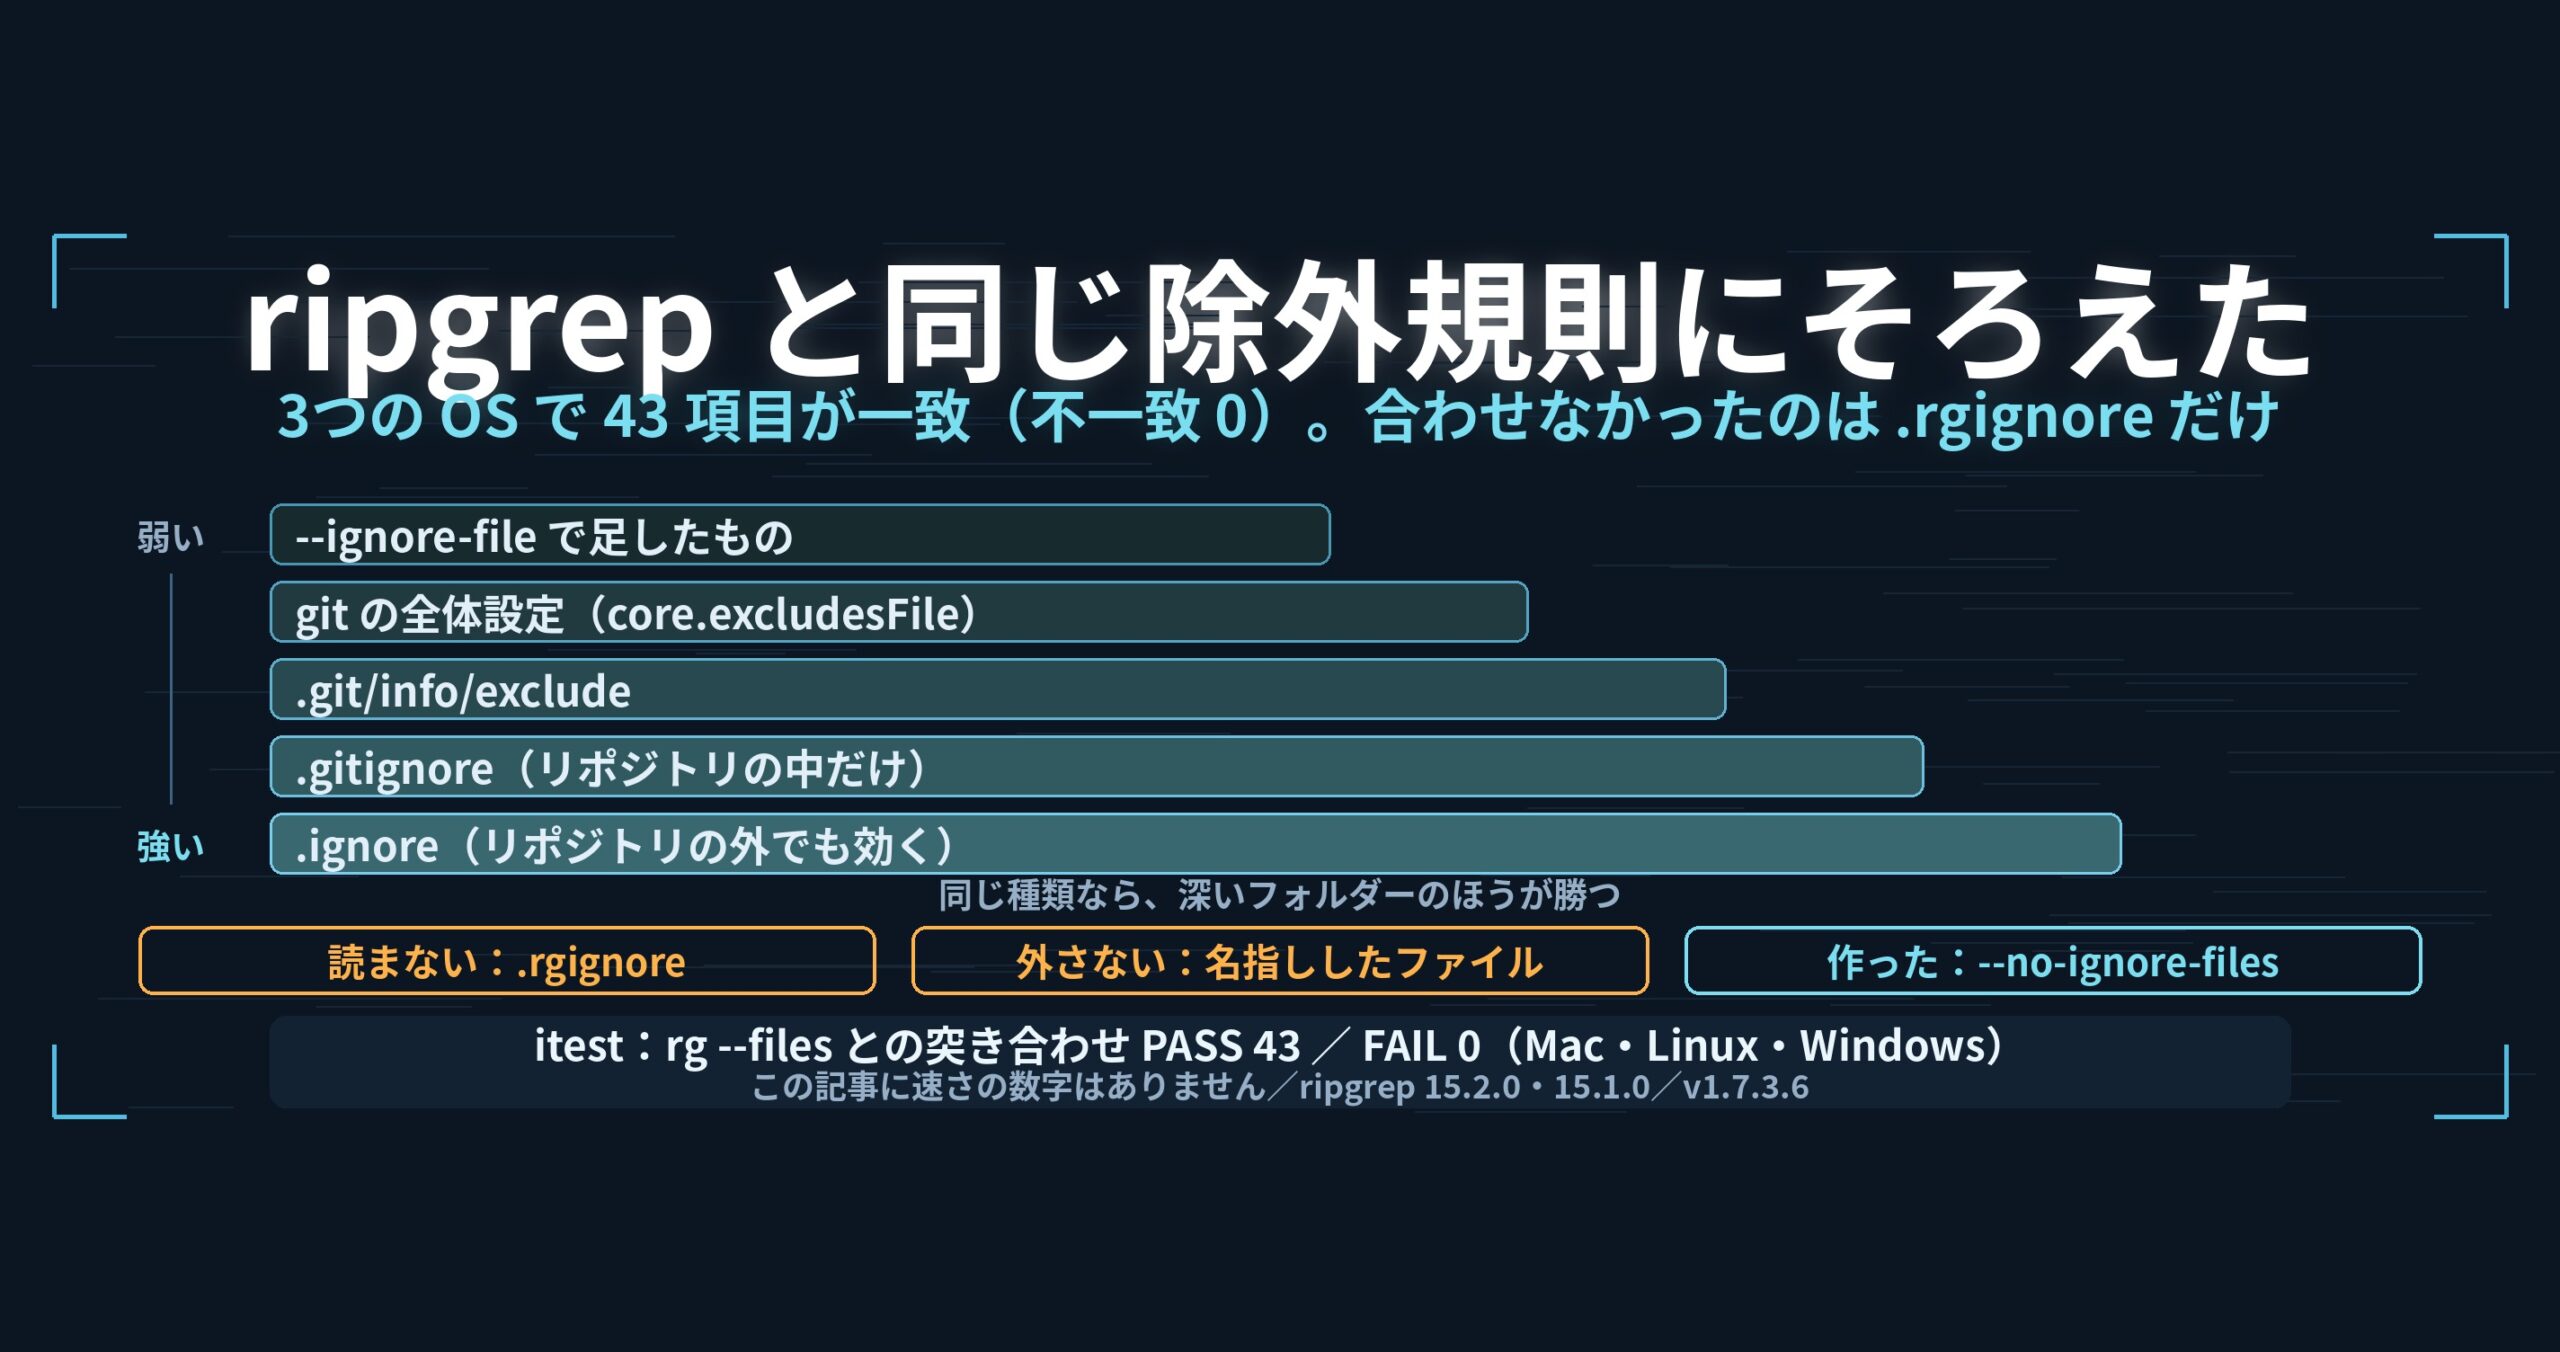
秒数を比べる前に必ずやっていることがあります。出力の行数と中身を、ripgrep と突き合わせることです。
今回の3つの組み合わせは、すべて ripgrep と件数が一致しました(5,445/122,441/127,886 件)。同じ実行の正しさの部では、ファイル指定・出力書式・統合索引の作り直しなど 35 項目が合格、不一致 0 件(pbf の1項目は、この実行では渡していないので省略)。
圧縮ファイルの比較は、道具の指定を1つ間違えるだけで「0件のまま速く終わる」ことが起こります。速い数字が出たら、まず探せていない可能性を疑うほうが当たります。
測り方
- ファイル:
osm17の OpenStreetMap(日本)XML。平文 5 本(4.78GiB)/gz 7 本(7.13GiB)/混在 12 本(11.91GiB) - 語:
東京(固定文字列・行番号つき) - 状態:
sudo purgeのあと 10秒待ってから1回目(cold)、続けて走らせた 2回目(hot) を分けて記録 - 相手: ripgrep 15.2.0(平文は
rg -n -F、gz と混在はrg -z -n -F) - こちら:
uvf/uvpv1.7.3.6 “Wide Field”。計測は 2026年10月1日 uvpの1回目は、統合.uwvzを消してから走らせています(作成込みの数字)。作られた.uwvzは平文 0.54GiB/gz 7.13GiB/混在 7.67GiB- Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD。秒数は環境によって変わります
持ち帰れる一般論
(1)「1回目」と「2回目」を混ぜた平均は、何も言っていない。 索引を作る道具は、1回目と2回目でまったく別の性格になります。平均すると「同等」に見えますが、その同等はどちらの場面でも起きない値です。分けて出すほうが、読む側が自分の使い方に当てはめられます。
(2)損益分岐を回数で言う。 「2.42倍速い」だけでは使い分けが決まりません。「1回目に16秒余分に払い、2回目から15秒ずつ返ってくる」と書けば、自分が同じログを何回見るかで選べます。速さの主張は、回数の主張に置き換えられるときだけ実用になります。
(3)取り返せない組があることを、同じ表に書く。 平文 5 本は、回数をいくら増やしても uvp が得になりません。自社の道具が効かない条件を、効く条件と同じ表に並べる。別の記事に分けると、読者は「効く条件だけ選んで出している」と受け取ります。
(4)勝ち負けの基準を、測る前に決める。 1.30倍を「勝ち」と書ける状況で書かないためには、結果を見る前の基準が要ります。ここでは単項目 1.5倍未満を差と呼ばないと決めています。基準は相手を縛るものではなく、自分を縛るものです。
正直に書いておくこと
- この記事の数字は、一度差し替えています。 最初の版は 2026年9月29日に測った「平文 6 本・混在 13 本」の組で書いていました。その組には、画面が gz を開いたときに隣へ残した 47.73GiB の平文が1本混ざっており、翌日その1本を別の場所へ移したため、再現できない数字になりました。2026年10月1日に平文 5 本・混在 12 本で取り直し、gz 7 本も含めて3組すべてを同じ実行の値に差し替えています。旧版にあった「平文の2回目 8.08倍」は、47.73GiB を含む組の値でした。いまの組では、平文の2回目は逆にこちらが遅い側です。
- 数字はすべて Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XMLでの測定例です。環境が変われば変わります
- 平文 5 本(4.78GiB)はメモリに収まる大きさです。 ここで ripgrep の2回目が 0.37秒まで落ちるのは、そのためだと考えていますが、切り分けた計測はしていません。もっと大きい平文群でどうなるかは、この記事では分かりません
- 混在 12 本は、2回計ではまだ ripgrep に追いついていません(1/1.02)。「2.42倍」は2回目1回ぶんの比です
uvpが書き出す統合.uwvzは、混在 12 本で 7.67GiB ありました。ディスクの空きが要る点は、速さと引き換えです- 1.5倍未満は「差」と呼んでいません。同等と書いた行は、環境が違えば逆転しうる幅です
- 平文のみ・gz のみ・混在の3通りしか測っていません。本数や1本あたりの大きさを変えれば比は動きます
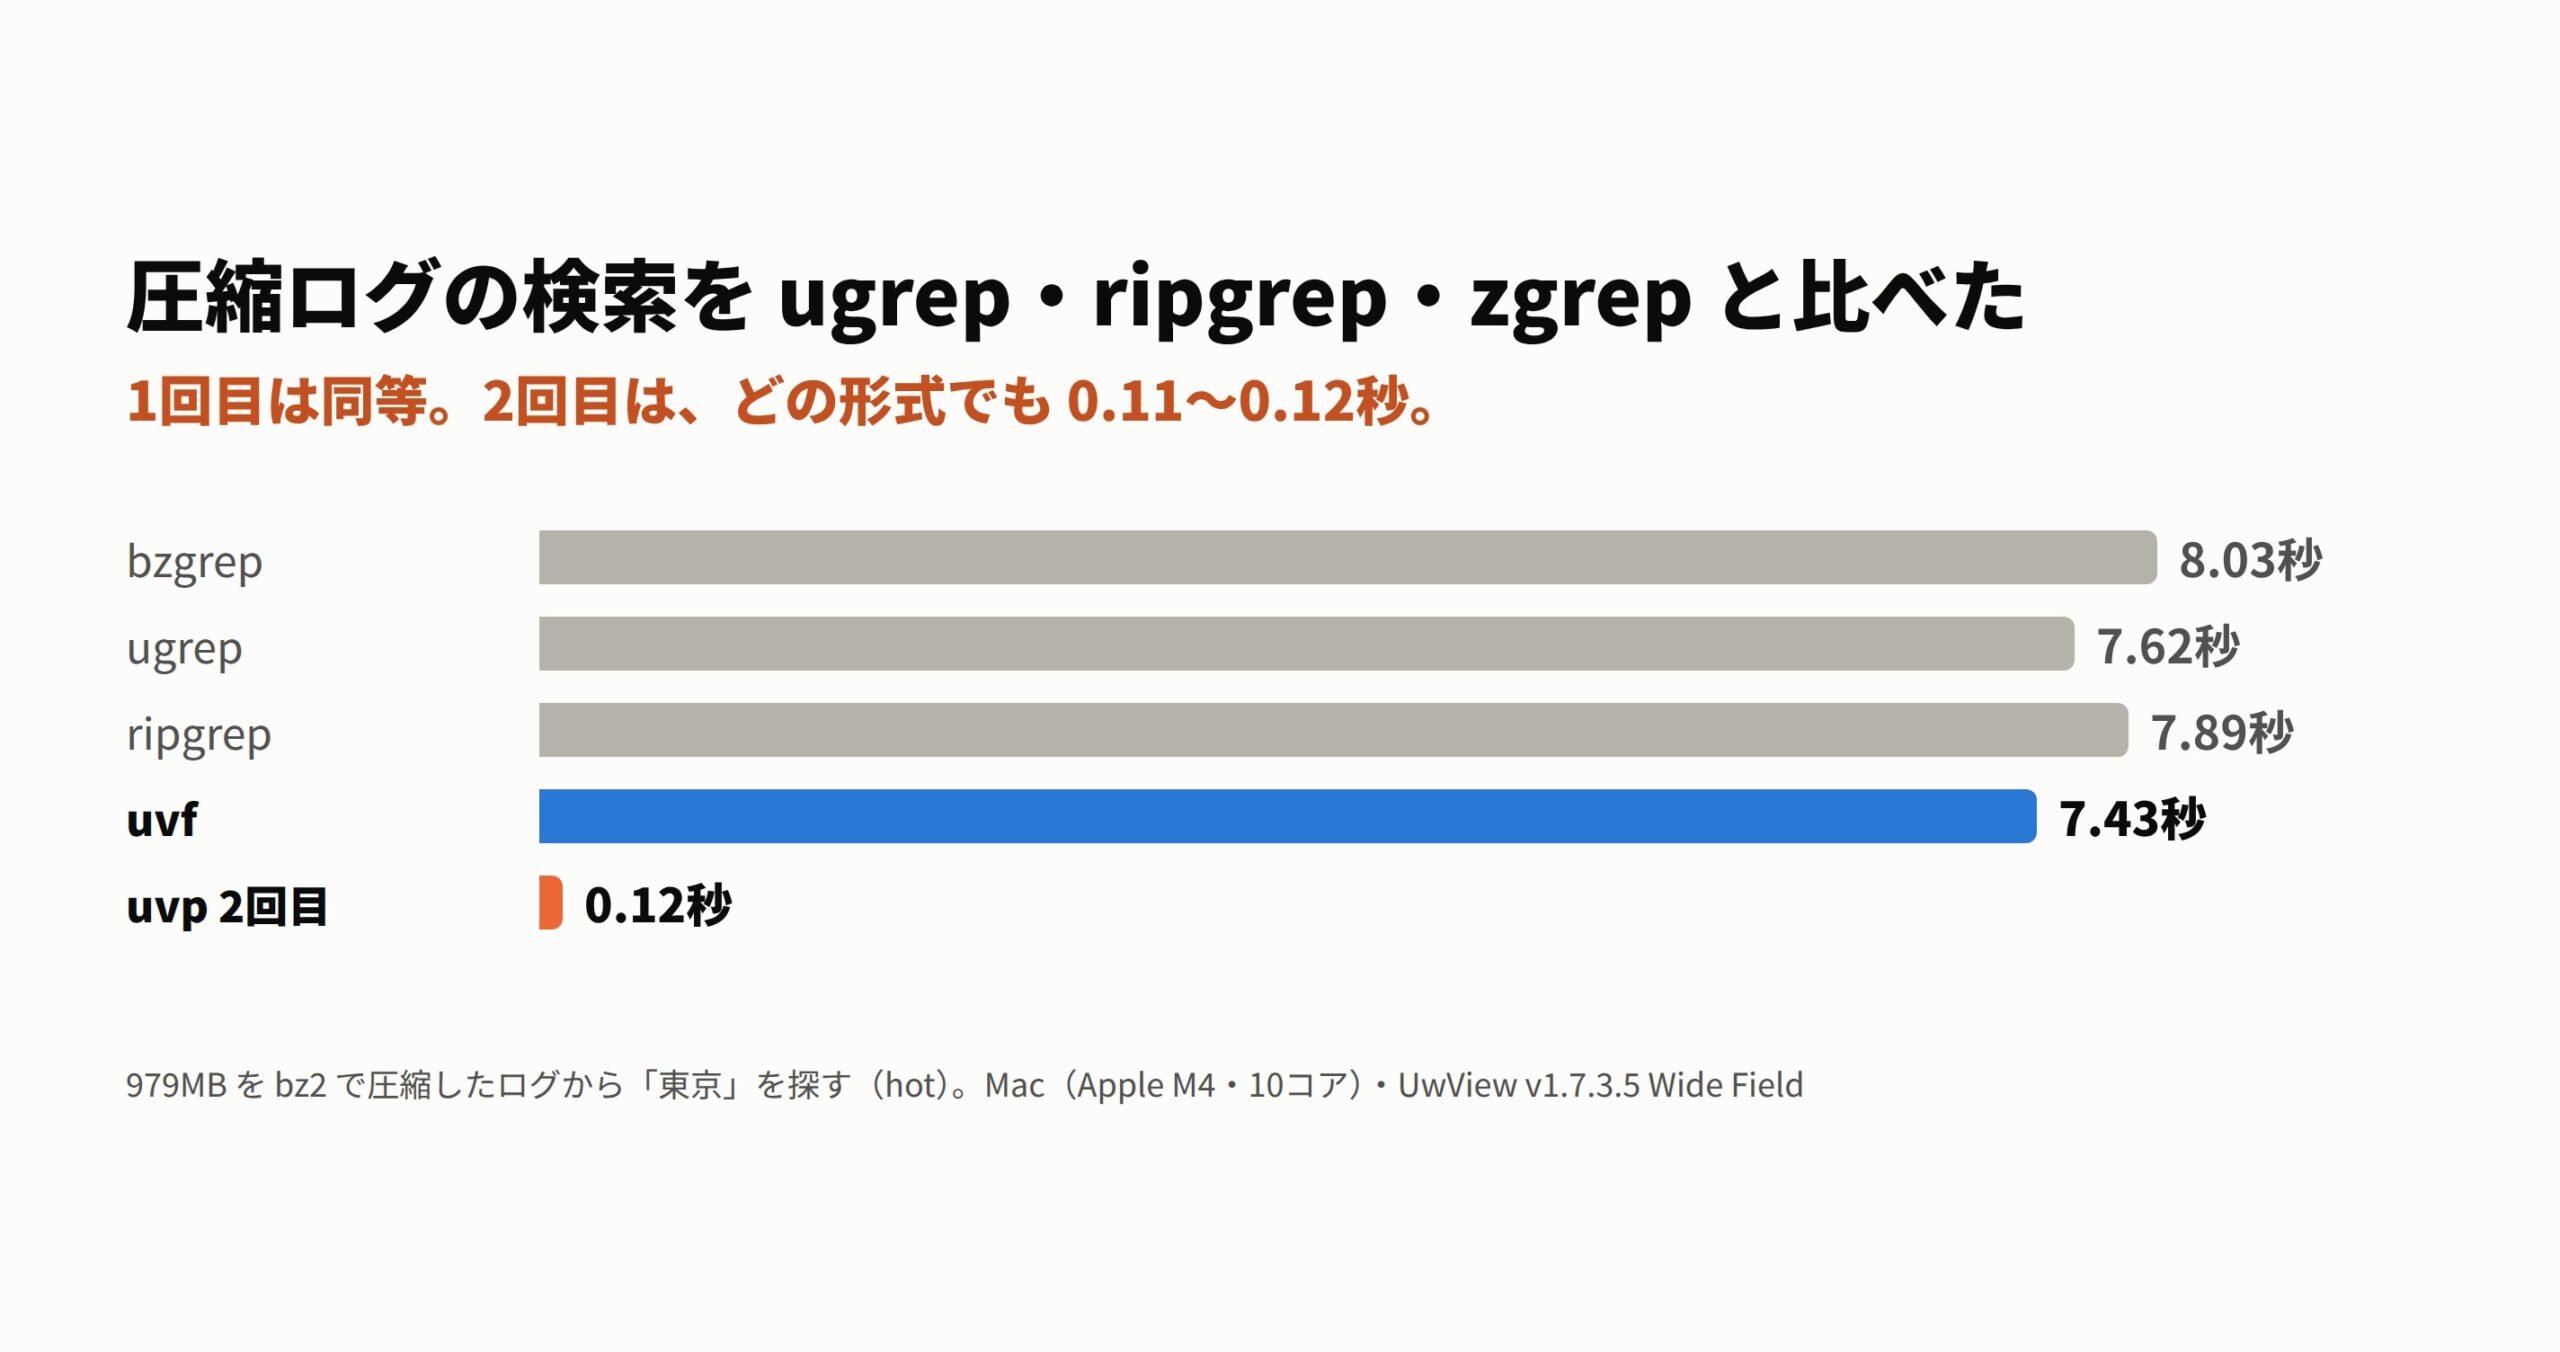
- 他の道具(ugrep・zgrep など)との比較は、この回には入れていません
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと 7 つの圧縮形式を、外部のコマンドなしで1回で探せます。
uvp ならこう書く
# 平文と圧縮を混ぜて、1回で探す(無料)
uvf 'osm17/*.gz,osm17/*.osm' 東京

# 再帰的に集める(無料)
uvf '**/*.log.gz' ERROR

# 探した結果を、そのまま画面で開く(無料)
uvf 'app.log,app.log.*.gz' ERROR -open

# 束ねた .uwvz を作りながら探す(1回目・UwView Pro)
uvp 'app.log,app.log.*.gz' ERROR

# 2回目以降は .uwvz を使う(同じコマンド・UwView Pro)
uvp 'app.log,app.log.*.gz' ERROR

# 大文字小文字を無視する
uvf 'app.log,app.log.*.gz' error -i
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- 圧縮ログの検索を ugrep・ripgrep・zgrep と比べた(7 形式・他の道具も含めた一覧): https://uvp.y42u.net/blog/uwview-ugrep-ripgrep-zgrep-compressed-logs/
- ログは圧縮したほうが、速く探せます(形式の選び方): https://uvp.y42u.net/blog/log-compression-format-choice/
- gz を展開せずに探す(1本の gz の話): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
.uwvzを作って、中を探して、取り出す: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/- 読む回数だけを減らした13回のまとめ: https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。