形が、戻りませんでした。
bz2 で保管していたログを探して、結果をまた bz2 で置きたい。入口は7つの圧縮形式を読めるのに、出口はテキストだけでした。
読めるのに書けない、というのは何が足りないのでしょうか。
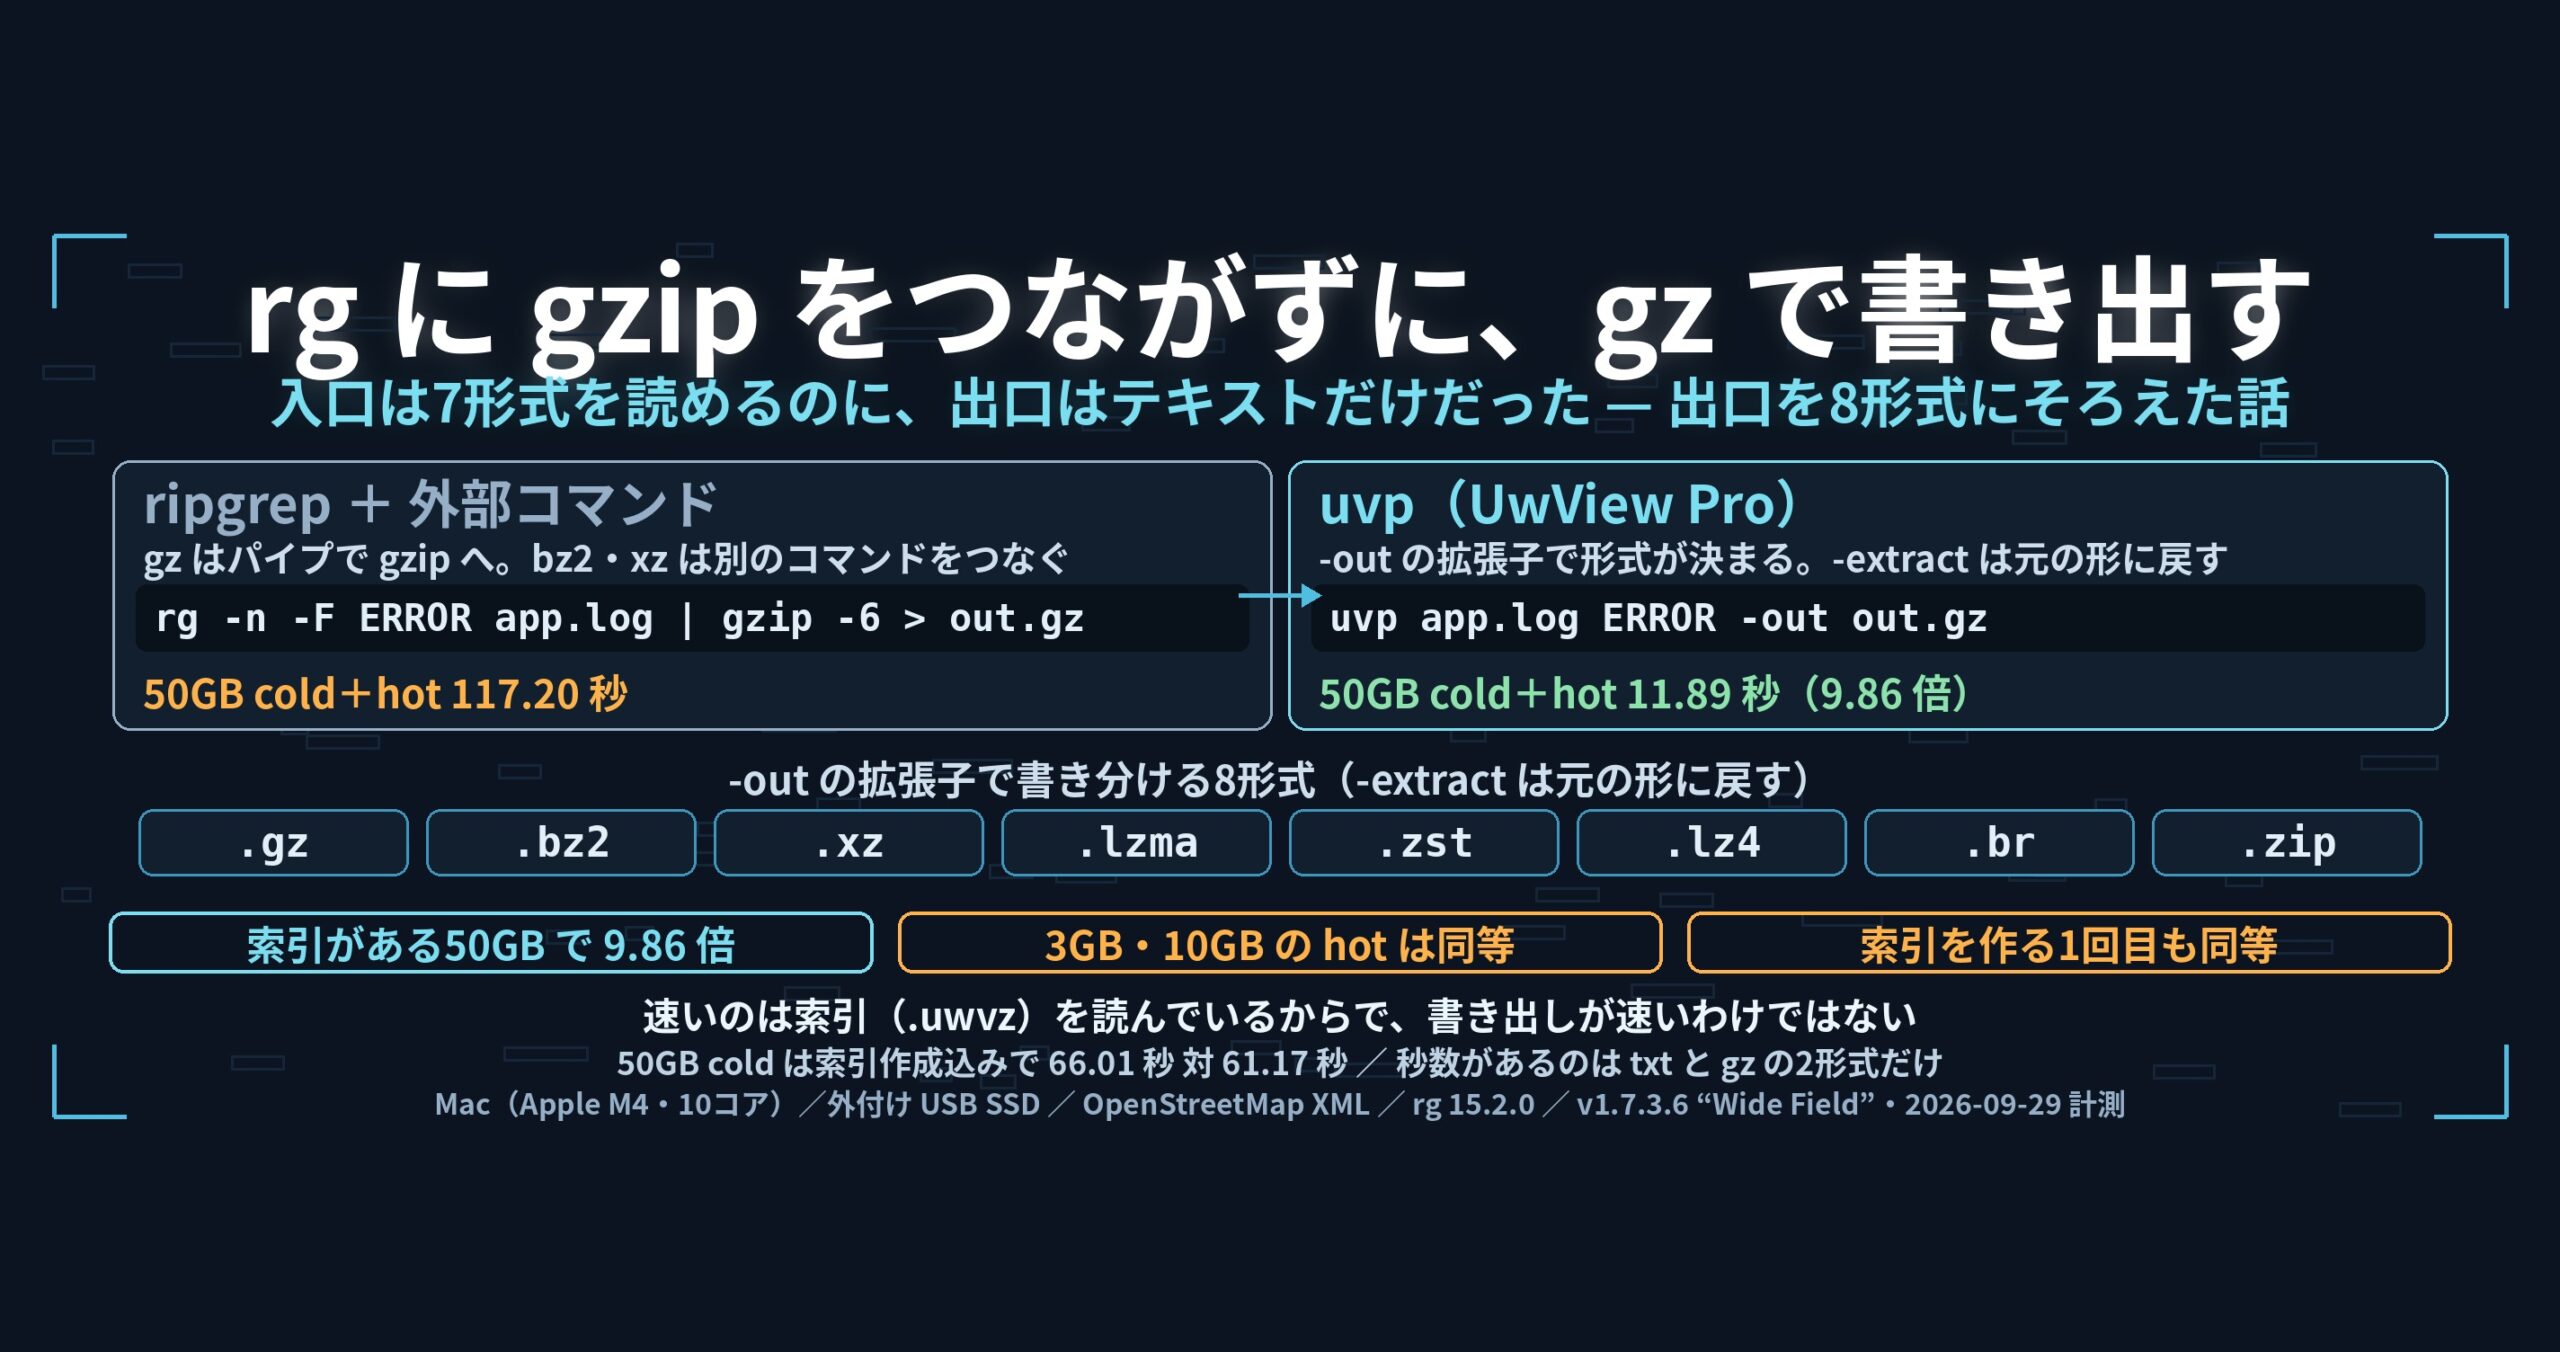
- 先に結論: 出口を入口と同じ8形式(gz・bz2・xz・lzma・zst・lz4・br・zip)にそろえた。索引がすでにある50GBでは rg -n -F … | gzip -6 > の117.20秒(cold+hot)に対し11.89秒(9.86倍)。ただしキャッシュに乗った3GB・10GB では同等(0.33秒 対 0.31秒/1.02秒 対 0.98秒)で、索引を作る1回目も ripgrep と同等(50GB cold 66.01秒 対 61.17秒)。速いのは索引を読んでいるからで、書き出しが速いわけではありません
- 先に、負けているところを書きます
- 読む側は、最初から覚えていました
- 拡張子で決める、という1つの規則に寄せました
- xz は「複数ブロックで書く」まで込みで出口
- 書けないときに、テキストに落とさない
- 名前がぶつかるときは、書く前に止めます
- 数字——50GBでは9.86倍、3GBでは同等
- なぜ uvp だけ速いのか——書き出しの話ではありません
- 確かめ方
- 持ち帰れる一般論
- 正直に書いておくこと
- 使っている道具
- リンク
先に結論: 出口を入口と同じ8形式(gz・bz2・xz・lzma・zst・lz4・br・zip)にそろえた。索引がすでにある50GBでは rg -n -F … | gzip -6 > の117.20秒(cold+hot)に対し11.89秒(9.86倍)。ただしキャッシュに乗った3GB・10GB では同等(0.33秒 対 0.31秒/1.02秒 対 0.98秒)で、索引を作る1回目も ripgrep と同等(50GB cold 66.01秒 対 61.17秒)。速いのは索引を読んでいるからで、書き出しが速いわけではありません
計測は Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML。相手は ripgrep 15.2.0。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。書き出しを8形式に広げたのは v1.7.2.2 で、秒数は2026年9月29日の v1.7.3.6 統合テスト(全体テスト)の値です。
先に、負けているところを書きます
- キャッシュに乗った3GB・10GB では同等です。 3GB の
-out(gz)(hot)はrg | gzip0.33秒 対uvp0.31秒、10GB は 1.02秒 対 0.98秒。1.5倍未満なので「差」とは呼びません。 - 索引を作る1回目を含めると、50GB でも同等です。
.uwvz(uvp用の圧縮形式+索引)を消してから測った50GB の cold は、ripgrep 66.01秒 対uvp61.17秒(1.08倍)。1回しか探さないならrg | gzipで足ります。 - 書き出しの速さを測ったのは txt と gz の2つだけです。 bz2・xz・lzma・zst・lz4・br・zip は正しさ(書けて、外部コマンドで元に戻る)を確かめただけで、秒数を持っていません。
- br の既定を、コマンドの既定より弱くしました。
brotliコマンドの既定は 11 ですが、非常に遅いので 6 を既定にしています。つまり同じ.brでも、外部コマンドで作ったものと圧縮率がそろいません。 - 圧縮ファイル自体のバイト列は、元と一致しません。 一致するのは展開した中身です(レベルや時刻が違うため)。
- pbf は書き戻せません。 XML のテキストで戻ります。
-extract pbfはエラーです。 - 束ねたものを形の指定付きで戻すと、できない組み合わせがあります。 名前がぶつかるときは書く前にエラーで止めます(後述)。
- ライブラリが無い環境では書けません。 テキストに落とさず、エラーにする作りにしました。
読む側は、最初から覚えていました
直す前の出口はこうでした。-out の拡張子で見分けるのは .gz と .zip だけで、それ以外はすべてテキスト。-extract(索引から元のファイルに戻す操作)も、元の形に戻せるのは平文・gz・zip の3つだけで、bz2 から作った索引は平文で戻っていました。
入口は7形式を読めます。.bz2 を渡せば展開して探せる。なのに出口が3つしかない。
原因を探しに行って、拍子抜けしました。索引の中には、最初から形式の種類が記録されていたのです。.uwvz の sources[] には部品ごとに Kind が入っていて、bz2 で読んだものは bz2 だと覚えている。読む側が覚えていたものを、書く側が見ていなかっただけでした。
足りなかったのは記録ではなく、記録を使う側のコードだけです。
この非対称は、たぶん珍しくありません。入口は「対応形式を増やす」という分かりやすい仕事なので手が入り、出口は「元に戻す」という地味な仕事なので後回しになる。そして記録のほうは、入口を作った人が真面目にやっているので、すでに足りている。
拡張子で決める、という1つの規則に寄せました
書き分けの規則は、増やすときにいちばん壊れます。「-out のときは拡張子、-extract のときは引数、cat のときはテキスト固定」のように経路ごとに違うと、どれがどれだか分からなくなる。
なので規則を1つにしました。
-outは拡張子で決める。.gz .bz2 .xz .lzma .zst .lz4 .br .zipならその形式で圧縮し、それ以外はテキスト。検索結果でもcatでも-extractでも同じです-extractの既定は「元の形に戻す」。app.log.bz2から作った索引はapp.log.bz2に戻ります- 形を指定したいときは引数で。
-extract [txt|gz|bz2|xz|lzma|zst|lz4|br|zip] - 束ねた索引の既定は、部品ごとに元の形。 形を指定したときだけ、全部品をその形で書いて拡張子を付け替えます
既定の強さは、各コマンドの既定に合わせました(gz 6・bz2 9・xz 6・lzma 6・zst 3・lz4 fast)。外部コマンドで作ったものと見比べたときに、理由の分からない差が出ないようにするためです。br だけは合わせていません。brotli の既定 11 は時間がかかりすぎるので 6 にしました。合わせなかったところは、合わせたところより正直に書く必要があります。
xz は「複数ブロックで書く」まで込みで出口
書き出しで1か所だけ、形式ごとの事情に踏み込みました。xz です。
xz は1本の流れとして書くこともできますが、それだと後から読むときに並列展開が効きません。この連載の第2回で、xz の読み込みが ripgrep -z に6倍以上負けていた話を書きました。直し方は並列展開で、並列展開が効くのは複数ブロックで書かれた xz だけです。
つまり、自分が書いた xz を自分で遅く読む作りにもできた。そこで書き出し側は lzma_stream_encoder_mt を使い、複数スレッドで書いて複数ブロックにしています(xz 5.6 以降の既定と同じです)。
確かめ方も入れました。テストに「xz --list のブロック数が2以上になること」を足して、大きめのファイルで4ブロック(84MB)を確認しています。
出口の作り方が、入口の速さを決めている。形式を増やすとき、書き出しは「とりあえず書ければよい」になりやすいところです。
書けないときに、テキストに落とさない
決めごとをもう1つ。その形式のライブラリが見つからないときは、テキストに落とさずエラーにします。
落としたほうが親切に見えます。.xz と書いたのに書けないなら、せめてテキストで残したい——という気持ちは分かる。ですが result.xz という名前でテキストが置かれると、後で誰かが xz -d に通して失敗します。しかもその時点では、何が起きたのか分かりません。
「この環境では .xz を書き出せません」と言って止まるほうが短い。名前と中身が食い違うファイルを置かないほうが、長い目で見て安いという判断です。
書き終えてから名前を変える作りも、同じ理由で残しました。途中で止まっても、壊れた .xz が残りません。
名前がぶつかるときは、書く前に止めます
仕様に無かったので決めたことが1つあります。束ねた索引を形の指定付きで戻すときの事故です。
a.log.bz2 と a.log.zst を束ねた索引を、gz 指定で戻す。すると拡張子を付け替えた結果がどちらも a.log.gz になります。そのまま書けば、1本目を2本目が上書きして中身が消えます。
ここは「後から来たほうを a.log.1.gz にする」ような自動の回避をしませんでした。書き始める前にエラーにして、形を指定せずに戻せば元の名前で戻ると案内します。
自動で名前を変えると、利用者が知らないファイル名ができます。戻す操作は「元に戻す」ことが目的なので、元と違う名前を勝手に作るのは目的に反します。止まってから選んでもらうほうが正しい。
数字——50GBでは9.86倍、3GBでは同等
2026年9月29日の v1.7.3.6 統合テスト(全体テスト)から、書き出しの2項目を抜きます。各測定は sync → キャッシュ破棄 → 10秒待機 → cold → 続けて hot。相手は ripgrep 15.2.0 で、uvp 側は索引(.uwvz)がある状態です。
50GB(47.73GiB・51,254,526,392バイト)
| 項目 | 相手のコマンド | 相手 cold/hot/計 | uvp cold/hot/計 |
2回計の倍率 |
|---|---|---|---|---|
| テキストで書く | rg -n -F '東京' … > out.txt |
55.62 / 57.34 / 112.96 | 6.57 / 5.37 / 11.94 | 9.46倍 |
| gz で書く | rg -n -F '東京' … \| gzip -6 > out.txt.gz |
61.15 / 56.05 / 117.20 | 6.62 / 5.27 / 11.89 | 9.86倍 |
出力は2項目とも ripgrep の出力と一致しています(94,979件)。
3GB・10GB——同等です
| 項目(hot) | 相手 | uvp |
倍率 |
|---|---|---|---|
| 3GB テキストで書く | 0.35 | 0.31 | 1.13倍(同等) |
| 3GB gz で書く | 0.33 | 0.31 | 1.06倍(同等) |
| 10GB テキストで書く | 1.02 | 0.99 | 1.03倍(同等) |
| 10GB gz で書く | 1.02 | 0.98 | 1.04倍(同等) |
1.5倍未満はすべて「差」と呼びません。この大きさでキャッシュに乗った状態では、どちらも1秒前後で終わります。差が出るのは、読む量が効いてくる大きさからです。
gz にしたことで uvp 側が増えた分は、50GB の2回計で 11.94秒 → 11.89秒。増えていません(0.05秒は測定のゆらぎの範囲です)。相手側は 112.96秒 → 117.20秒ですが、これも1.5倍未満なので差とは呼びません。
※ファイル容量の表記について:本記事の「50GB」は 47.73GiB(バイト÷1024³)のファイルです。macOS の容量表示(SI・÷1000³)では 51.25GB と表示されます。過去記事では同じファイルを「48GB」と書いています。いずれも同一ファイル(51,254,526,392バイト)です。
なぜ uvp だけ速いのか——書き出しの話ではありません
自社に都合のいい数字なので、独立した見出しにします。
9.86倍は、圧縮の書き出しが速いという話ではありません。2つのコマンドが読んでいるものが違います。
rgは毎回 51,254,526,392バイトの元ファイルを通しで読みますuvpは.uwvzを読みます。索引があるので、当たる行の位置が分かっている
書き出す中身はどちらも同じ94,979行で、gz に固める時間もほぼ同じです。違うのはその前段で読む量だけ。だから uvp が速いのは「書き出しが速い」のではなく「探すのが速い」の言い換えで、この回の主題(出口を8形式にそろえた)とは別の理由です。
そして索引は、最初に1回作らなければ存在しません。その1回を含めると50GBの cold は 66.01秒 対 61.17秒で、ripgrep と同等です。索引を使い回す話は第4回に書きました。
書き出しそのものを比べたいなら、同じ入力から同じ形式を書いて比べる必要があります。その計測は持っていません。
確かめ方
- 相手: ripgrep 15.2.0(gz は
| gzip -6をつないだパイプライン) - 版:
uvf・uvpとも v1.7.3.6 “Wide Field”。書き出しを8形式に広げたのは v1.7.2.2 - 秒数: 2026年9月29日の v1.7.3.6 統合テスト(全体テスト・各測定は
sync→ キャッシュ破棄 → 10秒待機 → cold → 続けて hot) - 正しさ: 同日の入力の種類テストで 66項目すべて合格・不一致0件。7形式の
-extract、-extract -out、検索結果の-out、束ねたものの戻し、xz の複数ブロック(4ブロック・84MB)を含みます - データ: OpenStreetMap の XML(3GB=3,032,812,644バイト/10GB/50GB=51,254,526,392バイト)
- 機械: Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD
- OS をまたいだ秒数の比較はしていません。この記事の数字はすべて Mac のものです
持ち帰れる一般論
(1)入口を増やしたら、出口の棚卸しをする。 読める形式と書ける形式がずれていても、テストは通ります。どちらの経路も単体では正しいからです。ずれは「読んで、書いて、元に戻す」という往復でしか見えません。往復のテストを1本入れておくと、入口を増やした日に出口の不足が出ます。
(2)記録は足りていることが多い。 読むために必要な情報は、読む側がすでに持っています。出口を広げる仕事は、新しい記録を増やす仕事ではなく既にある記録を使う仕事になりがちです。先に記録を疑うと、要らない設計をします。
(3)書き出し方が、次に読むときの速さを決める。 1本の流れで書いた xz は並列で読めません。出口で手を抜くと、入口の数字が下がる。しかも下がるのは別の日の計測なので、原因がつながりません。
(4)名前と中身を食い違わせない。 書けないときにテキストで落とすのも、ぶつかった名前を自動で変えるのも、その場では親切です。どちらも後で中身を開いた人に請求書が回ります。止まるほうが安い場面は、思っているより多い。
正直に書いておくこと
- キャッシュに乗った3GB・10GB では同等です。勝っているのは、索引がある大きいファイルの条件だけです
- 索引を作る1回目を含めると、50GB でも同等です(66.01秒 対 61.17秒)。1回だけ探すなら
rg | gzipで足ります - 9.86倍は書き出しの速さではありません。読む量の差で、
uvpは索引を、ripgrep は元ファイル全体を読んでいます - 書き出しそのものを比べた計測を持っていません。同じ入力から同じ形式を書いて比べる測定はしていません
- 秒数があるのは txt と gz だけです。bz2・xz・lzma・zst・lz4・br・zip は正しさだけで、速さは未計測です
- br の既定を、
brotliコマンドの既定(11)より弱い 6 にしています。圧縮率がそろいません - 圧縮ファイルのバイト列は元と一致しません。一致するのは展開した中身です
- pbf は書き戻せません。XML のテキストで戻ります
- ライブラリが無い環境では書けません。テキストに落とさずエラーにします
- 束ねたものを形の指定付きで戻すときの名前の衝突は、書く前にエラーで止める形で防いでいます。自動で別名を付ける作りにはしていません
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと7つの圧縮形式・zip・pbf を、外部のコマンドなしで扱えます。
uvp ならこう書く
# 検索結果をテキストで書き出す
uvp app.log 'ERROR' -out result.txt

# 拡張子で形式が決まる(gz・bz2・xz・lzma・zst・lz4・br・zip)
uvp app.log 'ERROR' -out result.gz
uvp app.log 'ERROR' -out result.xz

# 上書きしてよいとき
uvp app.log 'ERROR' -out result.gz --force

# 索引から元の形に戻す(既定は元の形)
uvp app.log.bz2.uwvz -extract

# 形を指定して戻す
uvp app.log.bz2.uwvz -extract zst
uvp app.log.bz2.uwvz -extract txt -out app.log

# 束ねた索引を戻す(既定は部品ごとに元の形)
uvp 'logs/*.log,logs/*.gz' -extract

# 書き出せる形式と規則を読む
uvp --help files

# 絞ってから書き出す
uvp app.log 'ERROR' -limit 1000 -out result.gz
uvp app.log 'k="amenity"' -uniq 'v="([^"]+)"' -sort count -head 20 -out tally.txt
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。書き出せない形式を指定したときは、書き始める前に2で終わります。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- 外部コマンドを呼ばずに7形式を探す(xz の並列展開もこの回): https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- 束ねた
.uwvzを使い回し、消えても作り直さない: https://uvp.y42u.net/blog/uwview-wf04-bundle-keep/ - ripgrep が探さない zip の中を探す: https://uvp.y42u.net/blog/uwview-wf05-zip-entries/
- ripgrep では読めない pbf を探す: https://uvp.y42u.net/blog/uwview-wf06-pbf-osm/
- gz を展開せずに探す(OS の zlib と CRC の話): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
.uwvzに固めて探し、-extractで戻す: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。