3GB で速くなった仕組みが、10GB でもそのまま効くとは限りません。
前の2回で入れた「行の骨格」と「ブロックの印」は、3GB の測定で決めた仕組みです。10GB・1億行で全体テストを流すと、2回目にまだ重い式が4つ残っていました。 今回は、その4つがどこで縮んだのか、何が同等どまりだったのか、そして±N行の中にある2語目をどう突き合わせることにしたかの話です。
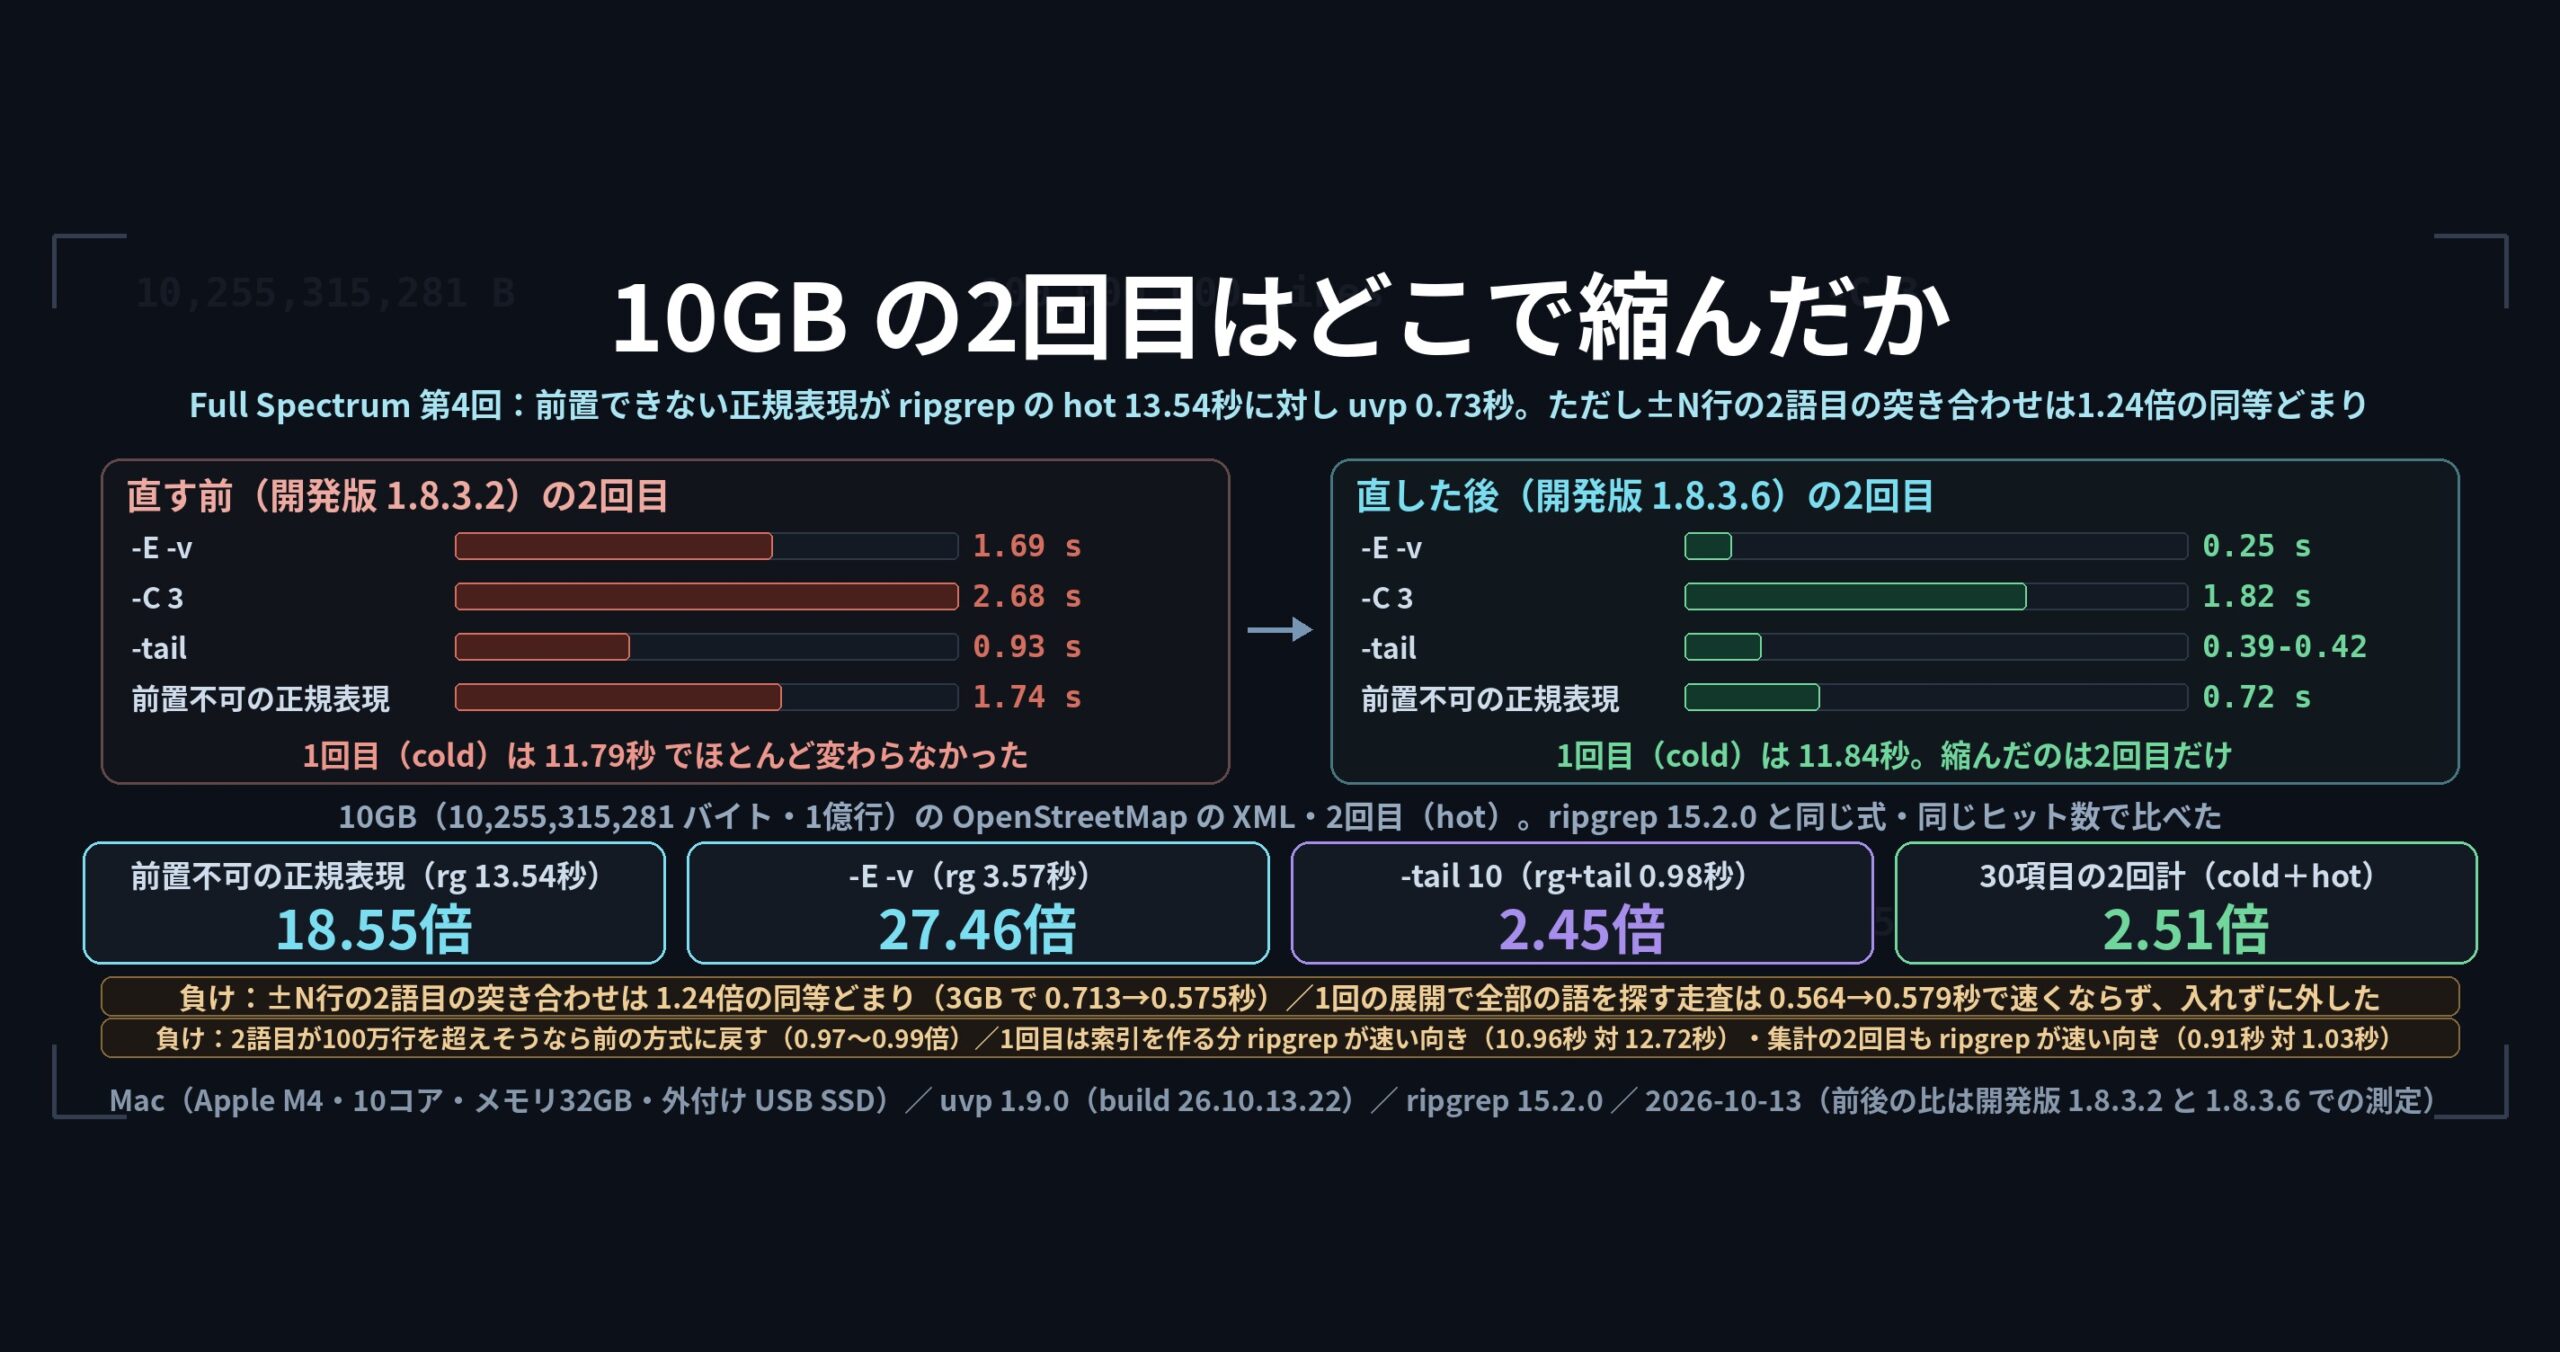
- 先に結論: 前置できない正規表現が ripgrep の hot 13.54秒に対し uvp 0.73秒。30項目の2回計の総合で 2.51倍。ただし±N行の2語目の突き合わせは 1.24倍の同等どまりで、全部の語を1回で探す走査は没にした
- 問題: 10GB の2回目に残っていた4つの式
- -E -v・前置できない正規表現 — 行の骨格が10GBでも効いた
- -C 3 — 読み直しをやめて、2語目を全文で1回探し、行番号で突き合わせる
- 没にしたもの: 1回の展開で全部の語を探す走査
- 数字: ripgrep と比べて(v1.9.0 の全体テスト・10GB)
- 負け: 同等どまりの式、1回目、集計、そして戻す条件
- 正しさ: 出力がバイト単位で同じことを確かめてから入れた
- 持ち帰れる一般論: 「重い処理を減らす」は、減らした分と増えた分を両方測ってから言う
- uvp ならこう書く
- リンク
先に結論: 前置できない正規表現が ripgrep の hot 13.54秒に対し uvp 0.73秒。30項目の2回計の総合で 2.51倍。ただし±N行の2語目の突き合わせは 1.24倍の同等どまりで、全部の語を1回で探す走査は没にした
扱うファイルは 10GB(10,255,315,281 バイト・1億行)の OpenStreetMap の XML です。過去の記事と同じ呼び方で「10GB」と書きますが、一次情報はバイト数で、SI 表示(÷1000³)では 10.26GB、GiB(÷1024³)では 9.55GiB になります。いずれも同じファイルです。
v1.9.0 の全体テスト(Mac・30項目・一致27/不一致0)で、2回目(hot)の値はこうなりました。
- 前置できない正規表現(
[0-9]{3}-[0-9]{4}"・24,988行ヒット): ripgrep 13.54秒 対 uvp 0.73秒=18.55倍 -E -v(^ +<に当てはまらない行・0行ヒット): ripgrep 3.57秒 対 uvp 0.13秒=27.46倍-tail 10(末尾10件):rgとtailをつないだ 0.98秒 対 uvp 0.40秒=2.45倍- 素の検索(
東京・11,393行ヒット): ripgrep 0.98秒 対 uvp 0.43秒=2.28倍 - 30項目の2回計(cold+hot の合計)の総合が 2.51倍
負けを先に書きます。±N行の2語目の突き合わせは、新しい方式にしても 1.24倍(1.5倍未満なので同等。新しい方式が速い向き)どまりでした。3GB で 0.713秒 → 0.575秒です。「1回の展開で全部の語を一緒に探す」走査も作って測りましたが、速くならず(0.564秒 → 0.579秒)、入れずに外しました。 2語目のヒットが100万行を超えそうなときは、新しい方式を使わず前の方式に戻します。1回目(cold)は索引を作る分 ripgrep の方が速い向き(10.96秒 対 12.72秒・1/1.16 で同等の範囲)で、集計の2回目も ripgrep の方が速い向き(0.91秒 対 1.03秒・1/1.13 で同等)です。
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この記事の数字は v1.9.0 “Full Spectrum”(2026年10月14日公開・build 26.10.13.22)を Mac(Apple M4・10コア・メモリ32GB・外付け USB SSD)で 2026年10月13日に測ったものです。前後の比(1.8.3.2 と 1.8.3.6)だけは開発版での測定です。v1.9 には「Full Spectrum」というペットネームを付けました。Shift_JIS・EUC-JP・UTF-16 のファイルも索引の中を UTF-8 にそろえ、文字コードやファイルの種類を問わず同じ速さで探せるようになった版だからです。
問題: 10GB の2回目に残っていた4つの式
骨格と印を入れた直後に 10GB で全体テストを流すと、1回目(cold)は 11.79秒 → 11.84秒でほとんど変わらず、2回目(hot)に重い式が残っていました。以下は開発版 1.8.3.2 と 1.8.3.6 での測定です(v1.9.0 の全体テストには「直す前」の条件が無いため、前後を見るにはこの2つの開発版を並べる必要があります)。
| 10GB の2回目(hot) | 1.8.3.2(秒) | 1.8.3.6(秒) |
|---|---|---|
-E -v |
1.69 | 0.25 |
-C 3(±3行に2語目) |
2.68 | 1.82 |
東京 -tail・-out |
0.93 | 0.39〜0.42 |
| 前置できない正規表現 | 1.74 | 0.72 |
4つは、重い理由が別々です。-E -v は「当てはまらない行」なので、ヒットするブロックを飛ばす印が使えません(前回の印は飛ばす方向にしか効かない仕組みです)。-C 3 は1語目を見つけた後、その前後の行をもう一度読み直していました。-tail は末尾の10件しか要らないのに全部を走っていました。前置できない正規表現は、絞り込みに使える「必ず含む文字列」が式から取り出せません。
-E -v・前置できない正規表現 — 行の骨格が10GBでも効いた
-E -v と前置できない正規表現は、第2回の「行の骨格」がそのまま効きました。行の形だけを残した小さな辞書に式を1回当てて、ヒットが1つも無いと決まったブロックを開かない仕組みです。印と違って「含まない」側にも効くので、-v でも使えます。
10GB で ^ +< に当てはまらない行を探すと、答えは0行です。骨格でそれが先に分かるので、uvp の2回目は 0.13秒で終わります(ripgrep は 3.57秒・27.46倍)。1回目も 0.22秒 対 11.09秒で、ここは元のファイルを読み直さずに済む分の差です。
前置できない正規表現も同じ道です。[0-9]{3}-[0-9]{4}" は「必ず含む文字列」が取れないので、第3回のブロックの印は使えません。骨格だけで絞って 0.73秒(ripgrep 13.54秒・18.55倍)。索引を作らない無料版 uvf は 3.82秒で、これでも ripgrep の 3.54倍でした。この式は ripgrep 側が cold 14.29秒・hot 13.54秒とほとんど縮まないので、差が大きく出ます。
-C 3 — 読み直しをやめて、2語目を全文で1回探し、行番号で突き合わせる
ここが今回の新しい仕組みです。語1 -C N 語2 は「1語目の前後N行の中に2語目がある行」を出します。前の作りでは、1語目のヒットごとに±N行の範囲を読み直して2語目を探していました。ヒットが多いと、この読み直しが積み上がります。
変えた後は、2語目を全文で1回だけ探し、1語目の±N行の窓と行番号で突き合わせます(-v も同じ道)。読み直しが消える代わりに、2語目の全文走査が1回増えます。どちらが得かはヒット数で逆転するので、切り替えの判断が要ります。
判断の材料は、ファイルの8か所 × 4,096行の見本です。そこから2語目のヒット数を見積もり、
- 100万行を超えそうなら前の方式(
UVP_JOIN_MAXで変えられます) - 1語目が骨格と印で半分未満に絞れるなら前の方式(範囲が狭いほうが読み直しでも速い)
UVP_NO_JOIN=1を付けると、いつでも前の方式(照合と測定のため)
上限を100万行にしたのは、境目を測って決めました。上限を25万・50万行にすると highway(93万行ヒット)が前の方式に回って 0.81〜0.89倍に落ち、200万行にすると <tag(2,000万行ヒット)が 0.75倍に落ちました。どちらの側に外しても遅くなるので、間の100万行にしています。
3GB・1MBブロック・節あり・2回目・3回の中央値での値です。
| 式 | 前の方式(秒) | 新しい方式(秒) | 倍率(倍) |
|---|---|---|---|
k="amenity" -C 3 k="name" |
0.713 | 0.575 | 1.24 |
同 -v |
0.749 | 0.590 | 1.26 |
highway(93万行・見積もりで前の方式) |
— | — | 0.99 |
<tag(2,000万行・同) |
— | — | 0.98 |
<nd(5,400万行・同) |
— | — | 0.97 |
1.24倍・1.26倍は「同等」の範囲です。 1.5倍に届いていないので、差とは呼べません。新しい方式が速い向きではありますが、ここは勝ったとは書けません。4MBブロック・節なしで測ると 0.858秒 → 0.647秒(1.32倍)で、こちらも同等です。見積もりで前の方式に回った3つは 0.97〜0.99倍、つまり見積もりの手間だけが乗っています。
10GB の全体テストでは k="amenity" -C 3 k="name"(66,778行ヒット)が 1回目 2.22秒・2回目 1.85秒でした。この式に ripgrep の同じものはありません(rg -C は前後の行を表示するだけで、「±N行に2語目がある行だけ」ではないため)。ripgrep の値を並べておくと、同じ行に2語がある形(rg を2回つなぐ k="amenity" → v="parking"・2,659行ヒット)なら 2回目が ripgrep 1.03秒 対 uvp 0.90秒=1.14倍(同等)です。
没にしたもの: 1回の展開で全部の語を探す走査
-seq(語が順番に現れる行を探す)は、語ごとに全文を探して位置どうしを突き合わせる作りです。ブロックを展開するのは重いので、1回の展開で全部の語を一緒に探せば速くなるはずだと考えて、実際に作って測りました。
結果は k="amenity",k="name" が 0.564秒 → 0.579秒。速くなりませんでした。 この Mac では展開より探す処理のほうが重く、2語を一緒に探しても2回探すのと同じ時間がかかっていたためです。入れると作りが複雑になるだけなので、外しました。-seq は今も元の作りのままで、3GB で 0.56〜0.60秒です。10GB では 1回目 2.22秒・2回目 1.84秒でした。
展開が重いという前提が、このデータとこの機械では成り立っていなかったということです。測らずに入れていたら、複雑さだけが残っていました。
数字: ripgrep と比べて(v1.9.0 の全体テスト・10GB)
相手は ripgrep 15.2.0。同じ式・同じヒット数を確かめた上での値です。cold はキャッシュを破棄して10秒待ってから、hot はその直後に測りました。素の検索の cold は .uwvz を消してから測っているので、索引を作る時間を含みます。
| 式 | ヒット(行) | ripgrep 相当 cold(秒) | 同 hot(秒) | uvp cold(秒) | uvp hot(秒) | hot の倍率(倍) |
|---|---|---|---|---|---|---|
前置できない正規表現 [0-9]{3}-[0-9]{4}" |
24,988 | 14.29 | 13.54 | 1.29 | 0.73 | 18.55 |
-E -v(^ +<) |
0 | 11.09 | 3.57 | 0.22 | 0.13 | 27.46 |
-v(=") |
1,224,742 | 11.08 | 2.62 | 1.41 | 1.09 | 2.40 |
-tail 10(東京) |
10 | 11.49 | 0.98 | 2.54 | 0.40 | 2.45 |
素の検索(東京) |
11,393 | 10.96 | 0.98 | 12.72 | 0.43 | 2.28 |
集計 -uniq(上位20) |
20 | 10.95 | 0.91 | 1.42 | 1.03 | 1/1.13 |
-tail の相手は rg の結果を tail -10 につないだものです。uvp は末尾から読むので、1回目でも 2.54秒 対 11.49秒で済んでいます。
30項目の合計は、cold 320.52秒 対 129.36秒(2.48倍)、hot 76.18秒 対 28.85秒(2.64倍)、2回計 396.70秒 対 158.21秒(2.51倍)でした。
負け: 同等どまりの式、1回目、集計、そして戻す条件
1. ±N行の2語目の突き合わせは同等どまりです。 1.24倍・1.26倍。読み直しを消したのに1.5倍に届かないのは、代わりに増えた2語目の全文走査が、消した読み直しとほぼ同じ重さだったということです。
2. 2語目が多いときは、新しい方式を使いません。 100万行を超えそうなら前の方式に戻します。つまりこの仕組みは「2語目が少ないとき限定」で、highway や <tag のような語には効きません。見積もりの手間(8か所×4,096行の見本)だけが乗って 0.97〜0.99倍です。
3. 1回の展開で全部の語を探す走査は没にしました。 0.564秒 → 0.579秒。作って測って捨てた分の時間は戻りません。
4. 1回目は ripgrep の方が速い向きです。 素の検索の cold は 10.96秒 対 12.72秒(1/1.16・同等の範囲)。索引を作る分です。索引を作らない無料版 uvf は cold 10.18秒・hot 0.89秒で、ripgrep とほぼ同じでした(cold 1.08倍・hot 1.10倍)。
5. 集計の2回目は ripgrep の方が速い向きです。 -uniq で上位20を出す式は 0.91秒 対 1.03秒(1/1.13・同等)。-sort count・-sort value も同じで 1/1.11・1/1.12 でした。ここは縮んでいません。
6. まとめ読みの直しは、1回目を測り直せていません。 1MBブロックにして節を読むようになった分、10GB の -i・正規表現・集計の cold が 0.15〜0.2秒遅くなりました。印の表を8MBずつまとめて読む・骨格と印の節はその式で使うときだけ読む、に直しましたが、cold の測り直しはキャッシュの破棄に sudo が要るため、手元では未測定です。次の全体テストで確かめます。
正しさ: 出力がバイト単位で同じことを確かめてから入れた
突き合わせの方式を変えると、出す行が変わりかねません。切り替えが絡むので、どちらの道を通っても同じ答えになることが前提です。
- 出力のバイト一致: 新しい方式と
UVP_NO_JOIN=1(前の方式)で1バイトも違わないことを確かめました。組み合わせは-C・-v・-i・-E・-head・-uniq・続けて書いた-C・束ねた索引・CRLF・--csvです。 - 実機での確認: 試験用の dmg で、3GB の
k="amenity" -C 3 k="name"がUVP_NO_JOIN=1と同じ出力になることを確かめました。 - 段ごとの表示: どの道を通ったかを画面に出します。突き合わせを使ったときは「2段目は、前段の前後 ±N 行を、この語を全文で探した結果と行番号で突き合わせました」と表示します。速くするために方式を切り替える道具は、どちらを使ったか見えないと信用できません。
- 全体テスト: 10GB の27項目が一致・不一致0。自動試験は
Pro.Core1,068件・画面 372件が通りました。
持ち帰れる一般論: 「重い処理を減らす」は、減らした分と増えた分を両方測ってから言う
4つの式を直して分かったことは、3つです。
消した重さと、増えた重さを並べて測ります。 読み直しを消したのに 1.24倍どまりだったのは、2語目の全文走査が同じくらい重かったからです。片方だけ見ていると「読み直しを消したのだから速くなったはず」と思い込みます。両方の秒数を出すと、同等だと分かります。
切り替えの境目は、外した側も測って決めます。 上限を100万行にしたのは、25万・50万行にすると 0.81〜0.89倍、200万行にすると 0.75倍に落ちると測ったからです。「だいたいこのくらい」で決めた境目は、どちら側にどれだけ外れると損するのかが分かりません。
前提は機械とデータで変わります。 「展開が重いから1回の展開で済ませたい」は、この Mac とこの XML では成り立ちませんでした。同じ理屈が別の機械では効くかもしれませんが、効くと分かるまでは入れないほうが、あとで直す量が少なくなります。
uvp ならこう書く
uvp japan.osm 'k="amenity"' -C 3 'k="name"'   # ±3行の中に2語目がある行
uvp japan.osm 'k="amenity"' -C 3 'k="name"' -v  # ±3行の中に2語目が無い行
uvp japan.osm -seq 'k="amenity",k="name"'      # 語がこの順に現れる行
uvp japan.osm '[0-9]{3}-[0-9]{4}"' -E          # 前置できない正規表現(骨格で絞る)
uvp japan.osm '^ +<' -E -v                     # 当てはまらない行(骨格が効く)
uvp japan.osm '東京' -tail 10                   # 末尾10件(末尾から読む)
UVP_NO_JOIN=1 uvp japan.osm 'k="amenity"' -C 3 'k="name"'  # いつも前の方式(照合・測定用)
uvf japan.osm '[0-9]{3}-[0-9]{4}"' -E          # 無料版は索引を作らず、そのつど読む
突き合わせに回す上限は UVP_JOIN_MAX で変えられます(測定用)。終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
リンク
- Full Spectrum①: 索引の中を UTF-8 にそろえた話: https://uvp.y42u.net/blog/uwview-fs01-sjis-utf8-index/
- Full Spectrum②: ヒットしない行のかたまりを読まずに飛ばす「行の骨格」: https://uvp.y42u.net/blog/uwview-fs02-line-skeleton/
- Full Spectrum③: 開かなくてよいブロックを先に知る「ブロックの印」: https://uvp.y42u.net/blog/uwview-fs03-block-marks/
- v1.9.0「Full Spectrum」の公開告知(この版の全体像): https://uvp.y42u.net/blog/uwview-v190-full-spectrum/
- 正規表現から「必ず含む文字列」を取り出して絞る話: https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- ripgrep が勝つ条件をまとめた回: https://uvp.y42u.net/blog/uwview-wf14-where-ripgrep-wins/
- 2回目の検索の4割を占めていた改行の数え方: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- 前の連載の総まとめ(複数ファイル・圧縮7形式・zip・pbf): https://uvp.y42u.net/blog/uwview-wf15-wide-field-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、同じ語を何度も探す巨大なログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。