2種類だけ残りました。
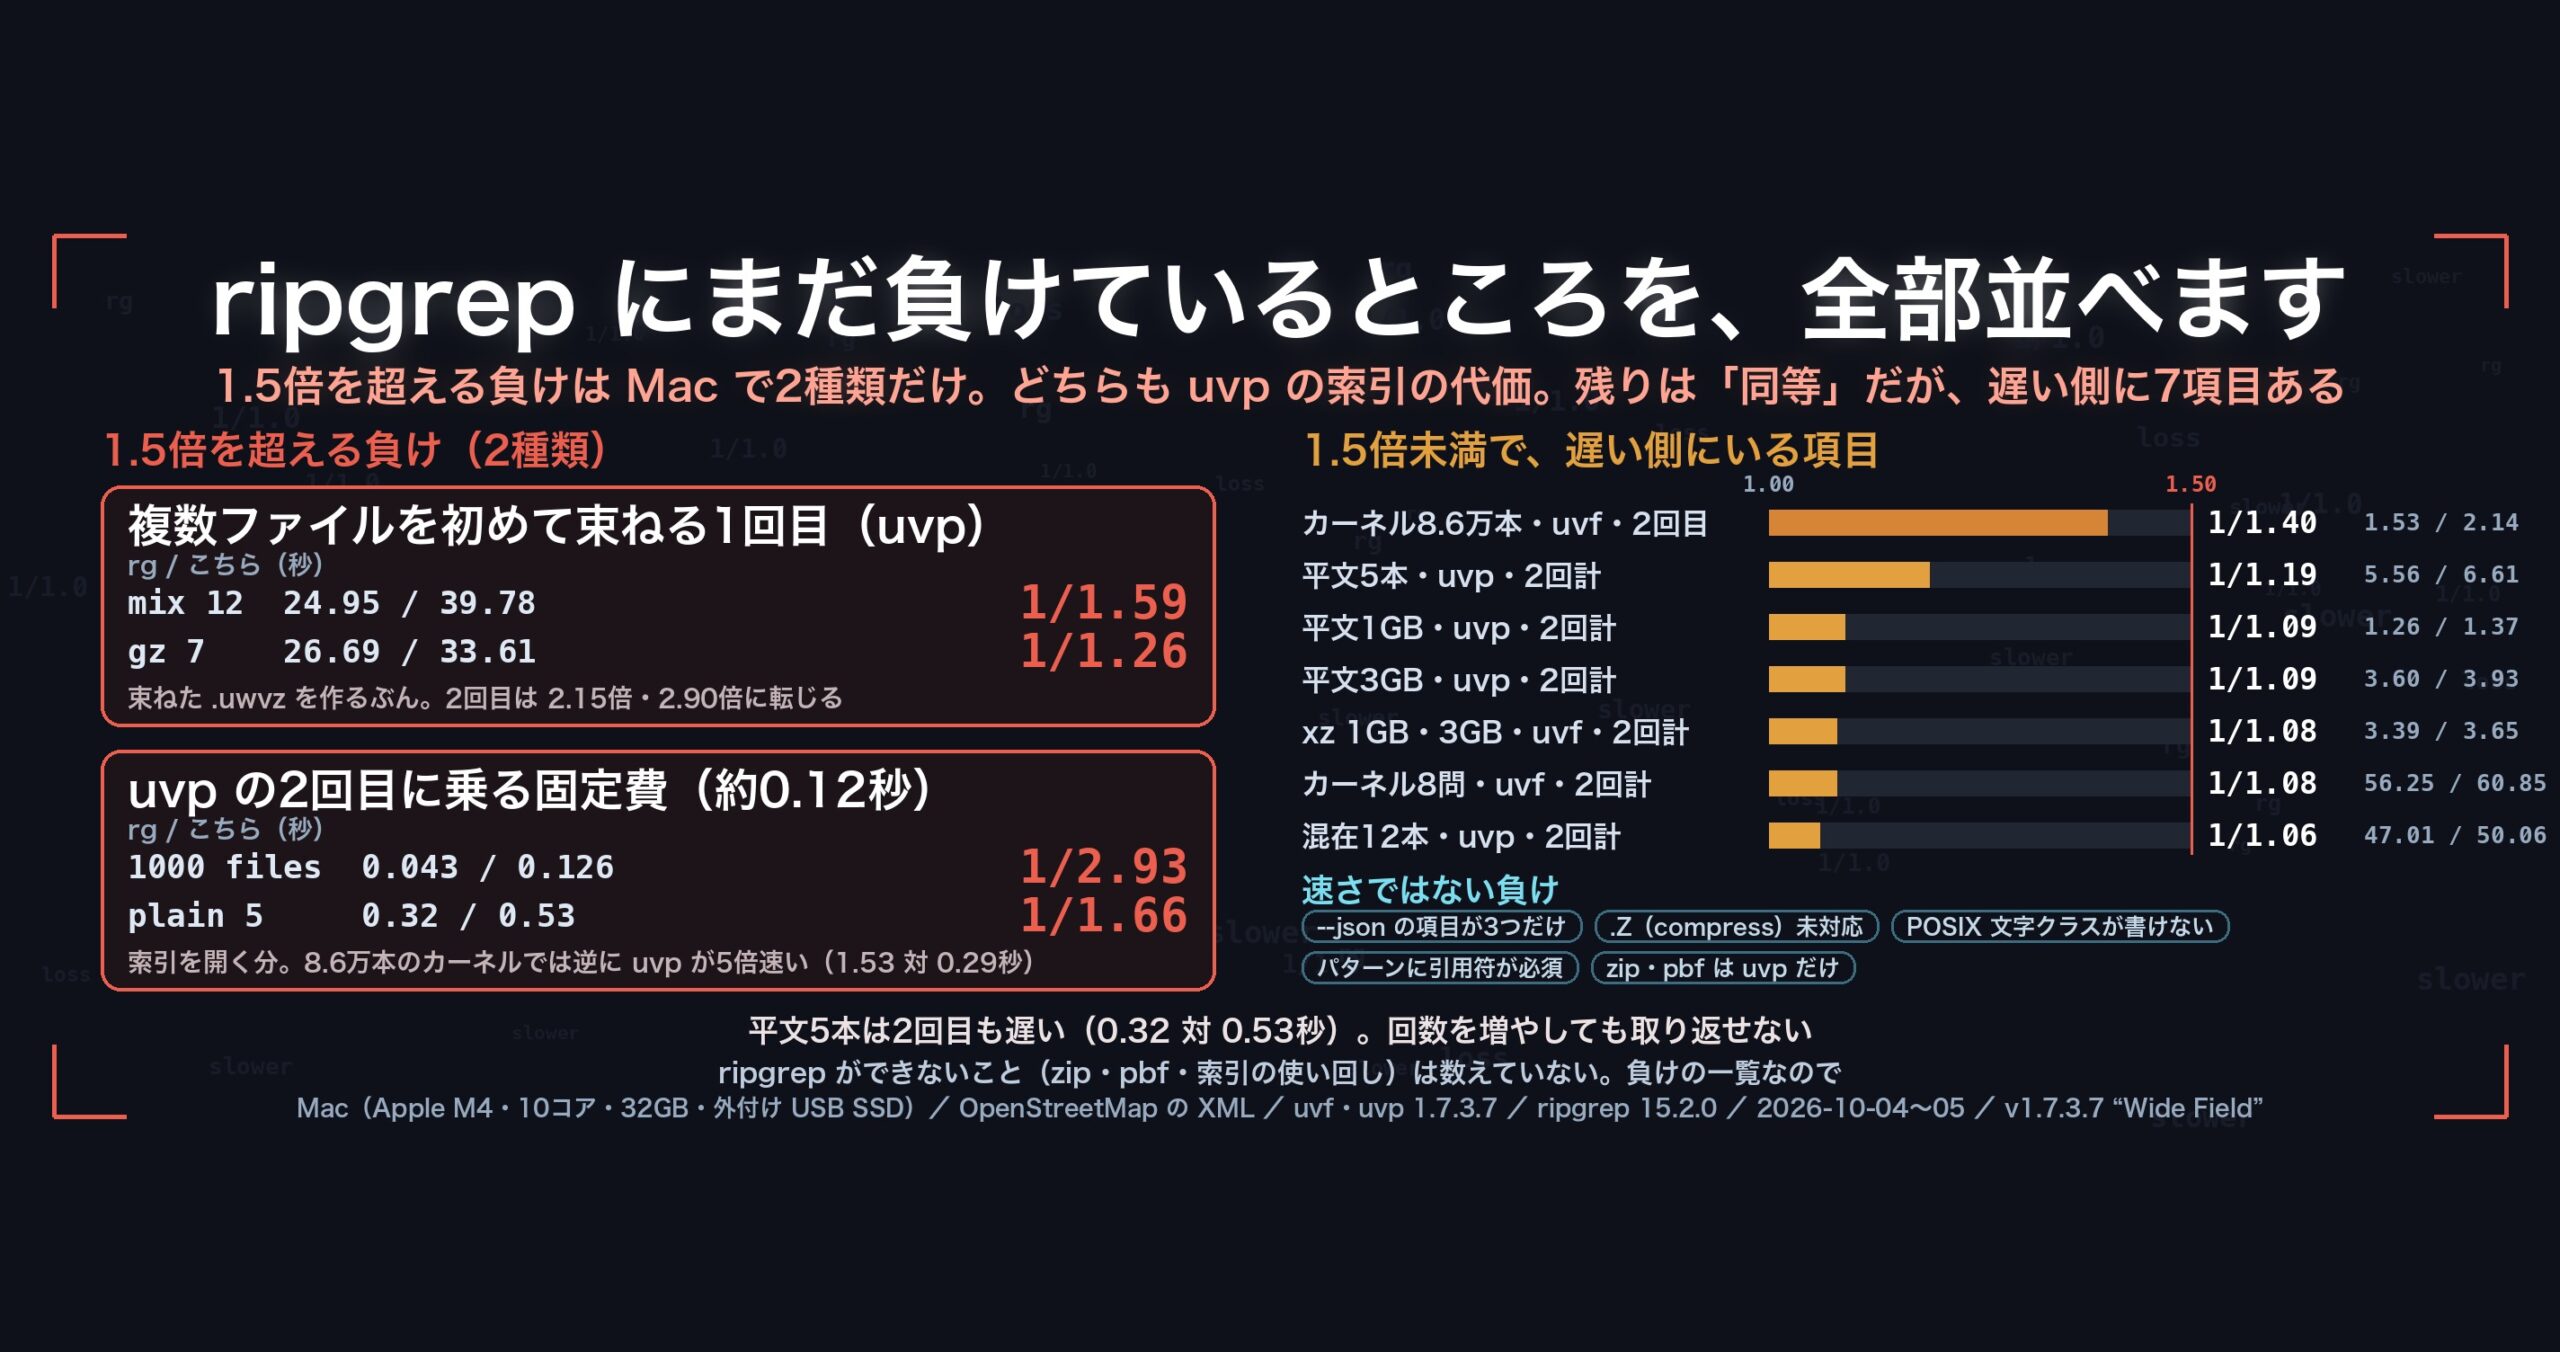
14回かけて、ripgrep に負けている場所を全部数え直したら、1.5倍を超える負けは2種類でした。どちらも有料版 uvp が索引を持つ代価です。
探せる入口を7つ増やしておいて、速さの負けが2種類で済んだ。その理由は、実装の工夫ではなく、1つの決めごとでした。
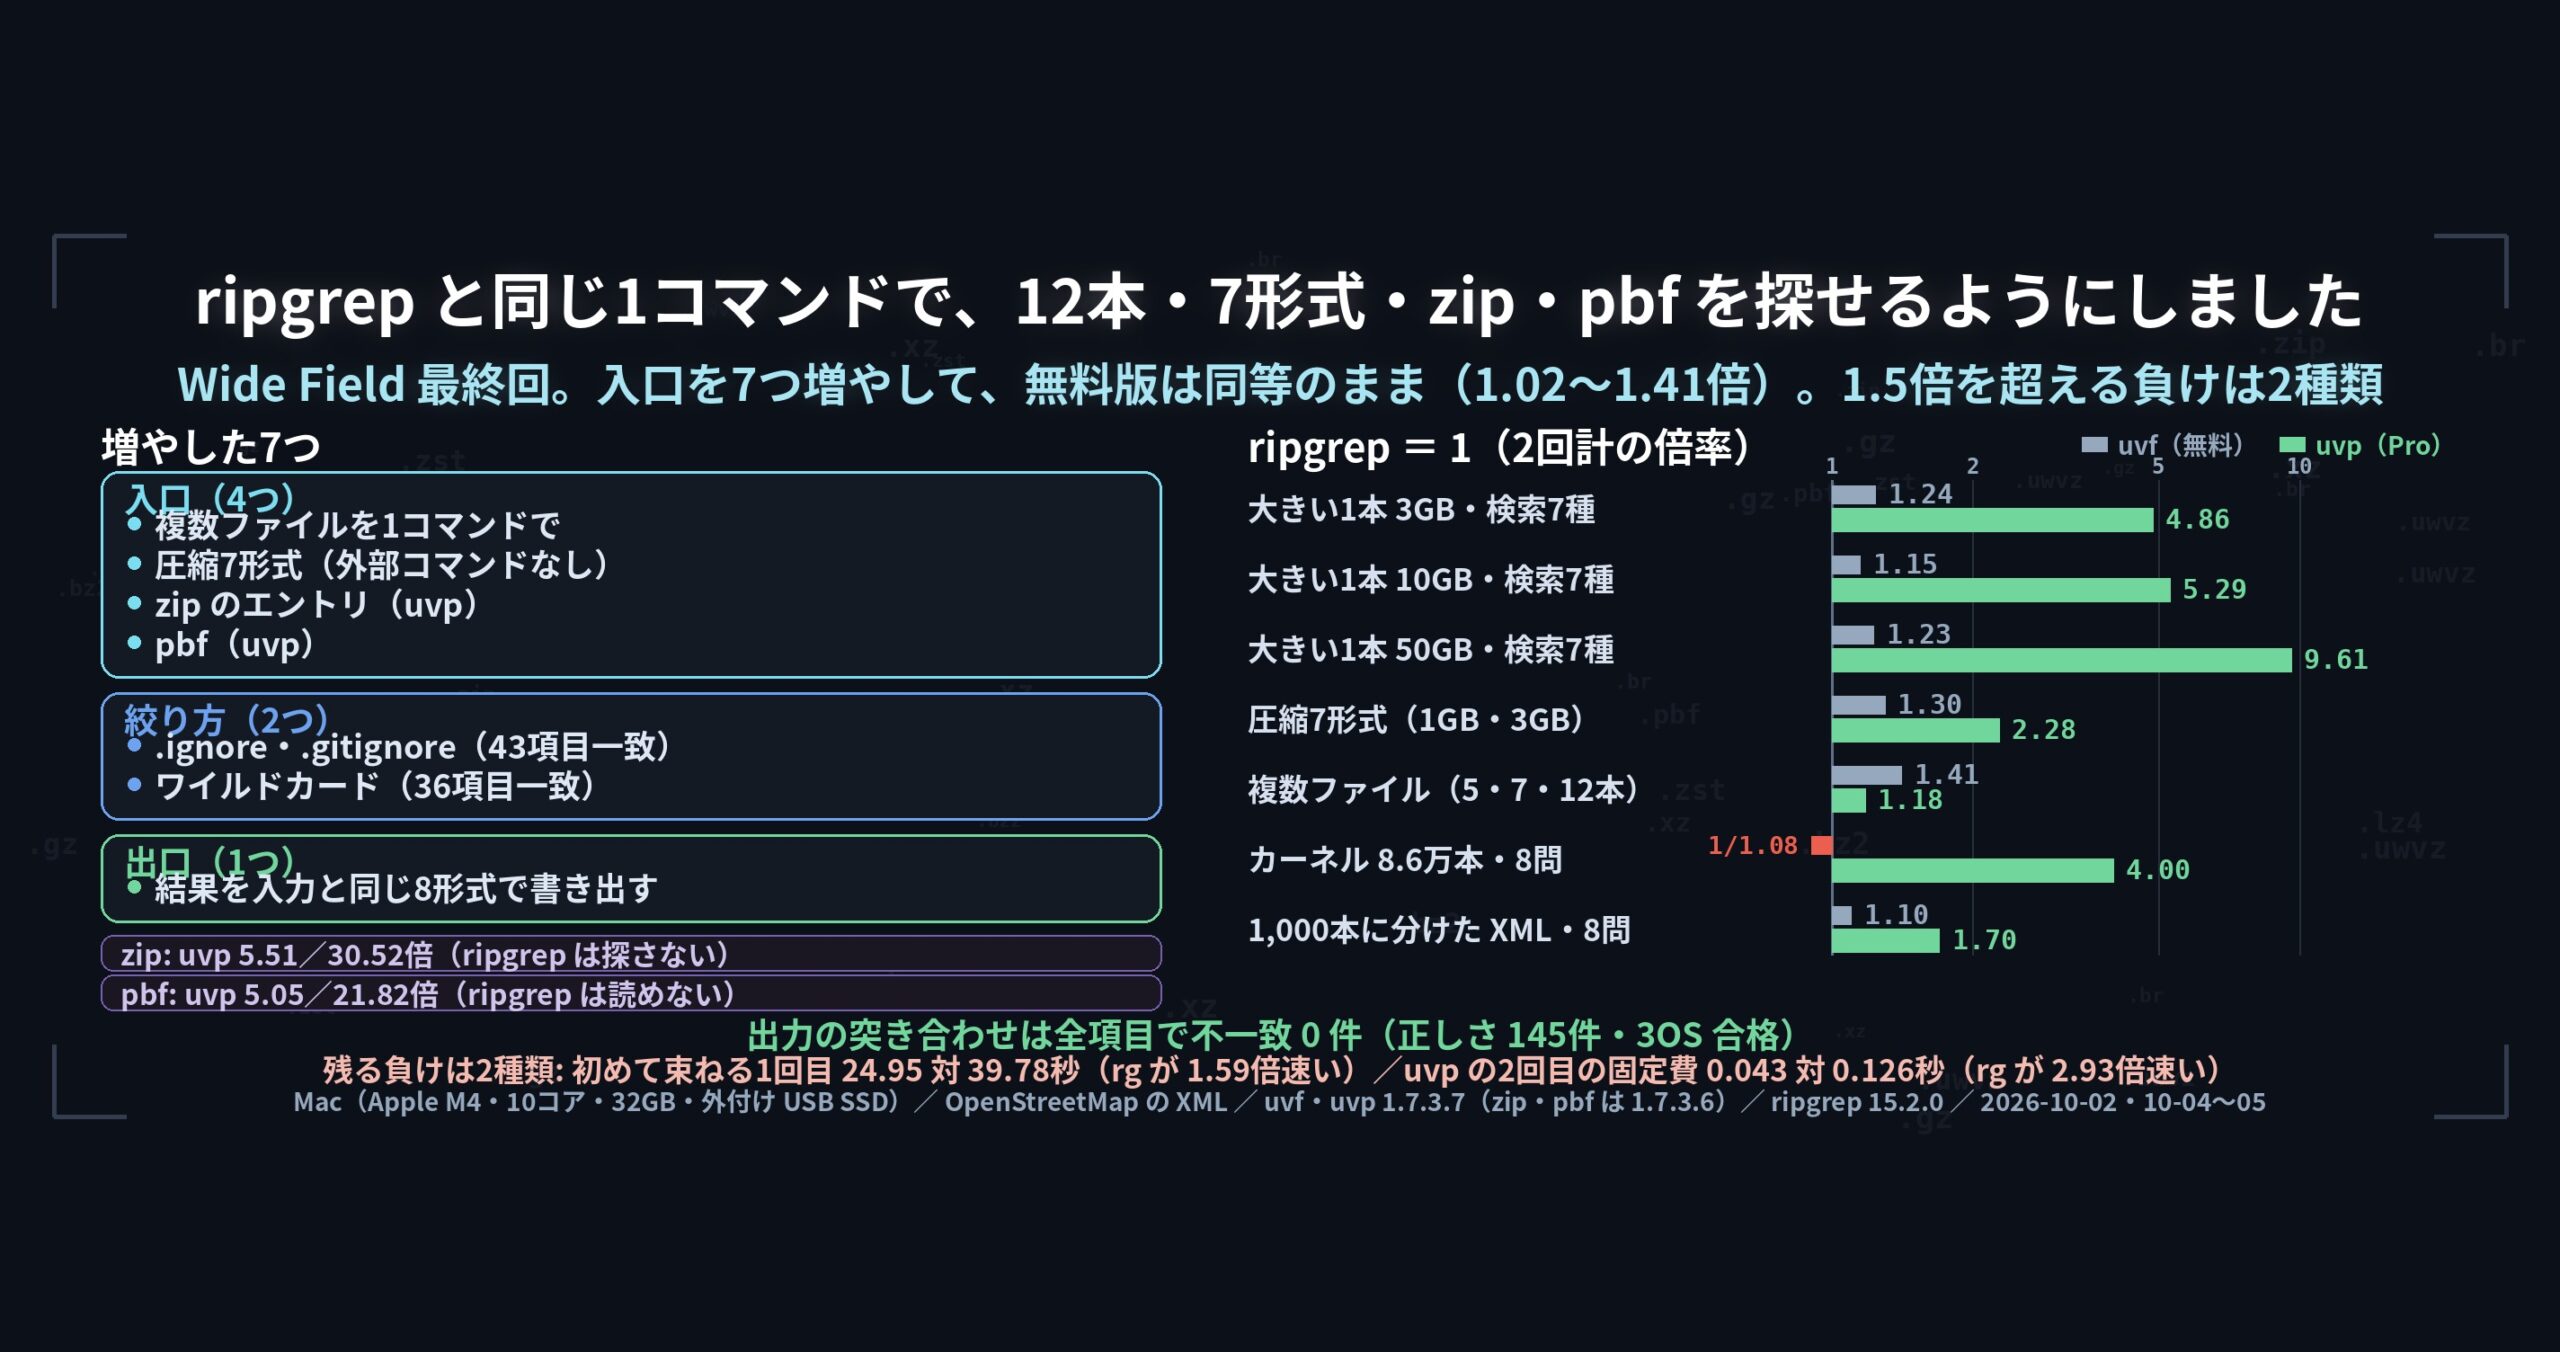
先に結論: 増えた機能は全部「索引を持つ側」に寄せたので、無料版は ripgrep と同等(1.02〜1.41倍)のまま
この連載で増やしたのは、複数ファイル・圧縮7形式・zip・pbf・除外規則・ワイルドカード・8形式の書き出しの7つです。増やしたあとで測り直して、無料版 uvf には 1.5倍を超える負けが1つもありません(複数ファイル 1.02〜1.41倍・圧縮7形式 1.02〜1.30倍。遅い側は xz の 1/1.08 とカーネル8.6万本の 1/1.08 で、どちらも同等の範囲)。有料版 uvp は Linux カーネルのソース 8.6万本の8問で 4.0倍、50GB の検索で 1.68〜9.61倍。そして負けは2種類だけで、複数ファイルを初めて束ねる1回目(混在12本で 24.95秒 対 39.78秒=ripgrep の方が 1.59倍速い)と、uvp の2回目に毎回乗る約 0.12秒の固定費(1,000本に分けたファイルで 0.043秒 対 0.126秒=ripgrep の方が 2.93倍速い)です。出力の突き合わせは全項目で不一致 0 件。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML。詳細は記事末尾。
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この連載が追ってきたのは v1.7.3.6 “Wide Field”(2026年9月28日公開)からの系列で、いま配布している安定版は v1.7.3.6.9(2026年10月4日・brew/scoop/Snap/GitHub Releases)、v1.7.3.7 は Mac だけの先行版(GitHub Releases)です。この記事の数字は、ことわりのある行以外は 1.7.3.7 を2026年10月4〜5日に測ったものです。
出発点: First Light は「1本・平文」しか相手にしていなかった
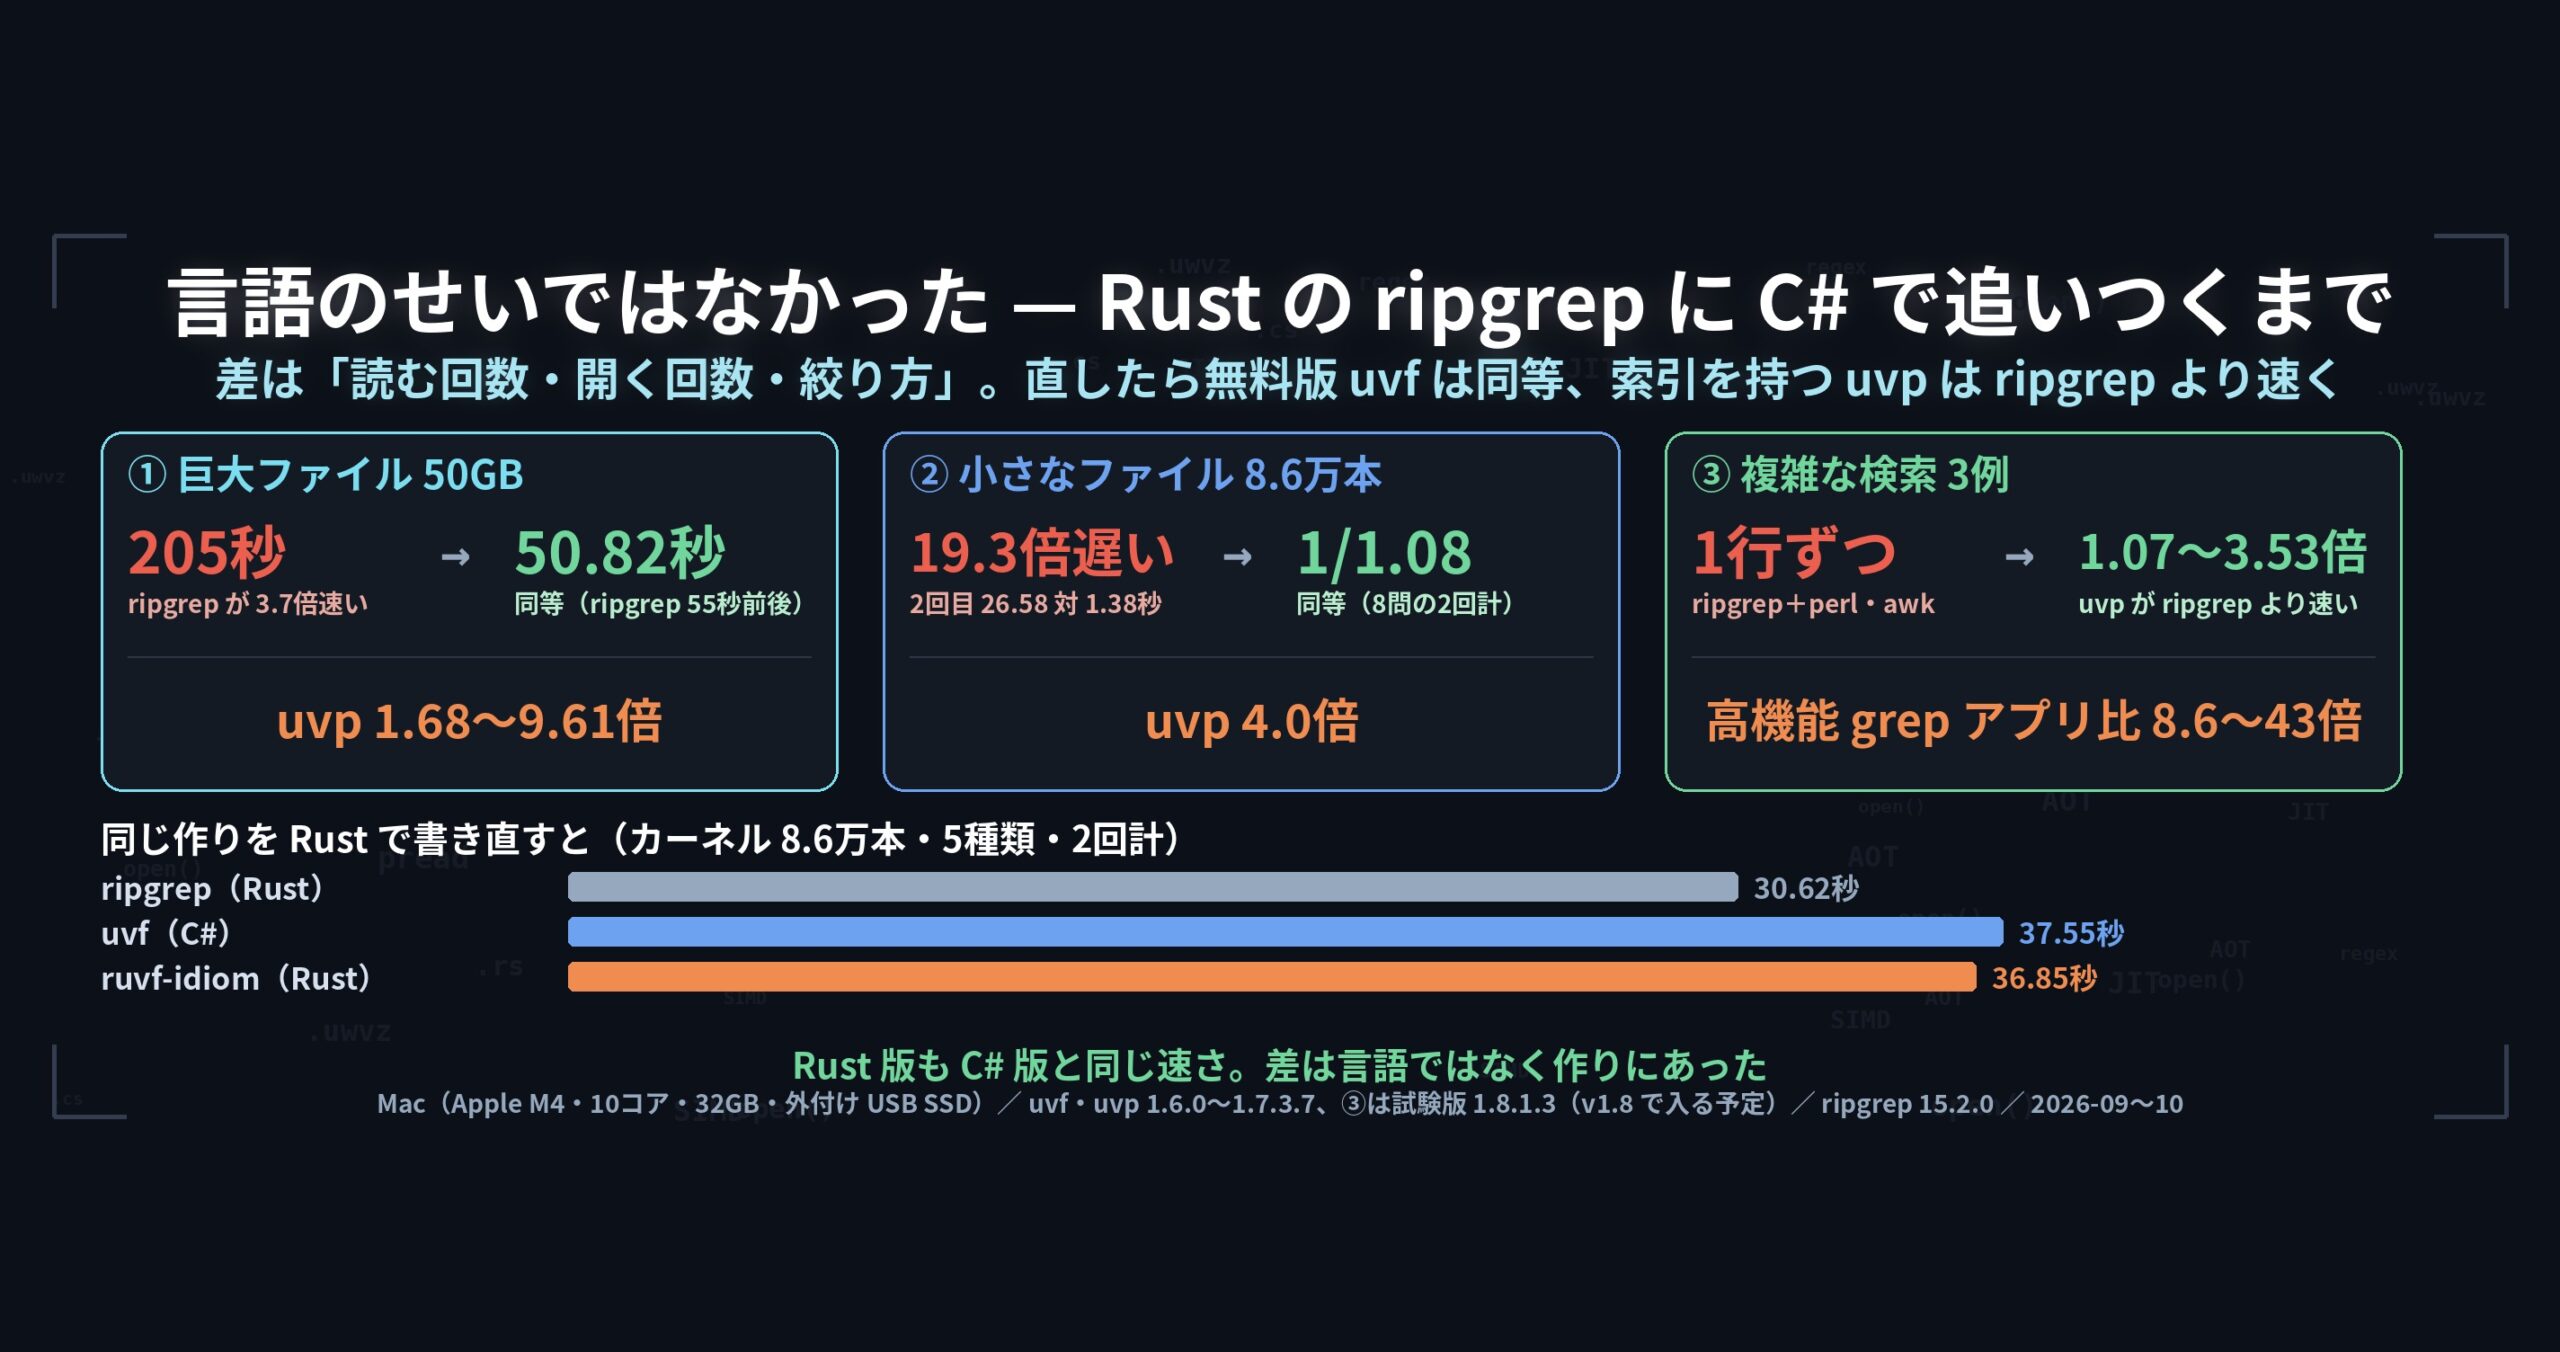
前の連載(First Light・v1.6.6)で詰めたのは、1本の大きい平文ファイルを読む回数でした。50GB の検索が 205秒から 51.70秒になり、読み出しが媒体の素読み速度(950〜970MB/s)に当たって止まった、というところで終わっています。
ただ、終わってみると使える場面が狭すぎました。
- ログは1本では来ません。
logrotateが毎日切るので、app.logとapp.log.1.gz以下が並びます - 届くログは zip で固めてあることがあります
- 探したい中身が、そもそもテキストではないことがあります(OpenStreetMap の pbf など)
ripgrep は 1本目と2本目をすでに持っていました。rg -z で gz・bz2・xz・zst・lz4 を読み、-g でファイルを絞ります。こちらには無かった。 Wide Field は、ここを埋める版です。
14回でやったことを、入口の数で並べる
入口を4つ増やしました。
- 複数ファイルを1コマンドで(①)。
uvf 'logs/*.log,err/*.gz' ERRORのように、平文と圧縮を混ぜて渡せます。混在12本(11.9GiB)でuvfは ripgrep の 1.20倍、ヒット件数 127,886 件は ripgrep と一致 - 外部コマンドを呼ばずに7形式(②)。gz・bz2・xz・lzma・zst・lz4・br を自分で展開します。
rg -zは外部の展開コマンドが入っていないと黙って飛ばすので、ここは挙動の違いでもあります。途中、.xzだけrg -zに 6.19倍負けていて、ブロック単位の並列展開を入れて 309MB/s → 1020MB/s にしました - zip のエントリを直接(⑤・
uvpのみ)。unzipで 4.77GiB を書き出してからrgにかけると cold 18.41秒、uvpは1回目 3.21秒・2回目 0.55秒(5.51倍/30.52倍。2026年10月2日・v1.7.3.6)。ripgrep は書庫の中を探しません - pbf を直接(⑥・
uvpのみ)。osmium cat … -f osm | rgが cold 148.17秒かかるところ、uvpは1回目 29.32秒・2回目 6.79秒(5.05倍/21.82倍。同日・同版)。「東京」94,979 件が XML 版と一致
絞り方を2つ増やしました。
- 除外の規則を ripgrep に合わせた(⑦)。
.ignore・.gitignoreを読む順番・!の取り消し・親フォルダーへのさかのぼりまで ripgrep 15 に合わせ、rg --filesとの突き合わせ 43項目が Mac・Windows・Linux の3つとも一致。合わせなかったのは.rgignoreだけです - ワイルドカードの指定を1つの引数に決めた(⑧)。
*がフォルダーの区切りをまたがないようにし、**と[ ]の扱いを直し、複数ファイルの突き合わせ 36項目が一致。引用符を必須にしたのは、その文字列そのものが束ねた索引の名前になるからです
出口を1つ増やしました。
- 探した結果を入力と同じ8形式で書き出す(⑩)。
rg -n -F … | gzip -6 >の代わりに-out1つで済みます。索引がある 50GB では 117.20秒 対 11.89秒ですが、キャッシュに乗った 3GB・10GB では ripgrep と同等(0.33秒 対 0.31秒/1.02秒 対 0.98秒)。速いのは索引を読んでいるからで、書き出しが速いわけではありません
残りの回は、増やしたものを測るか正直に並べるための回でした。--json と --tune(⑪)、hot の改行の数え方を 0.15秒 → 0.028秒にした回(⑫)、同じテスト一式を3つの OS で流した回(⑬)、ripgrep への負けを全部並べた回(⑭)。束ねた .uwvz(uvp 用の圧縮形式+索引)を使い回す設計の回(④)と、正規表現が .NET なので ripgrep と書けるものが違う話(⑨)も、増えた入口の裏側です。
数字: 到達点(ripgrep=1・2回計)
2回(cold+hot)の合計で、ripgrep または同じ結果を出すコマンドの組み合わせと比べた倍率です。1/x は ripgrep の方が x 倍速いことを表します。
| 土俵 | uvf(無料・倍) |
uvp(Pro・倍) |
|---|---|---|
| 大きい1本 3GB・検索7種 | 1.05〜1.24(-E -v だけ 1/1.10) |
1/1.05〜4.86 |
| 大きい1本 10GB・検索7種 | 1/1.01〜1.15 | 1/1.10〜5.29 |
| 大きい1本 50GB・検索7種 | 1.06〜1.23 | 1.68〜9.61 |
| 圧縮7形式(1GB・3GB) | 1.02〜1.30(xz だけ 1/1.08) | 1.21〜2.28(平文だけ 1/1.09) |
| 複数ファイル(平文5本・gz7本・混在12本) | 1.02〜1.41 | 1/1.19〜1.18 |
| Linux カーネル 8.6万本・8問 | 1/1.08 | 4.0 |
| 1,000本に分けた XML・8問 | 1.1 | 1.7 |
zip(unzip -d + rg 相手) |
読めない | 5.51(1回目)/30.52(2回目) |
pbf(osmium cat + rg 相手) |
読めない(案内して終了) | 5.05(1回目)/21.82(2回目) |
出典は末尾にまとめます。zip と pbf の行だけ 2026年10月2日・v1.7.3.6 の測定で、ほかは 1.7.3.7(2026年10月4〜5日)です。
この表のいちばん大事な行は、いちばん地味な「圧縮7形式」と「複数ファイル」だと思っています。入口を増やす改修は、たいてい既存の経路を遅くします。7形式を自分で展開するようにして、複数ファイルを束ねるようにして、それでも無料版が 1.02〜1.41倍に収まった。ここが崩れていたら、増やした入口は売り物になりませんでした。
カーネル 8.6万本の 4.0倍は、何の数字か
いちばん大きい倍率なので、分解しておきます。Linux カーネルのソース 8.6万本(1.9GB)に8種類の検索を投げて、2回ぶんの合計が ripgrep 56.25秒 対 uvp 14.02秒。このうち索引を作る時間が 8.4秒(1問目の検索を含む)で、2回目からは1問 0.29〜0.38秒です。ripgrep は毎回 1.5〜1.6秒かかります。
つまり 8問のうち 1問目で負けて、2問目以降で取り返した形です。1問しか投げないなら ripgrep の方が速い。この土俵の 4.0倍は「同じ場所に何度も聞く」前提の数字で、そう書かないと誤解されます。
残っている負け: 2種類
⑭で全部並べたので要点だけです。どちらも uvp が索引を持つ代価で、無料版 uvf には 1.5倍を超える負けがありません。
(1)複数ファイルを初めて束ねる1回目。 混在12本で ripgrep 24.95秒 対 uvp 39.78秒(ripgrep の方が 1.59倍速い)。2回目は 2.15倍に転じ、3回の合計では ripgrep 69.07秒 対 uvp 60.34秒で追い越します。gz 7本は2問目で追い越します。
ただし平文5本だけは取り返せません。 2回目も 0.32秒 対 0.53秒で遅い側です。回数を増やしても逆転しないので、これは設計上の代価ではなくただの負けです。平文だけを何度も探すなら、uvf か ripgrep の方が速い。
(2)2回目に毎回乗る約 0.12秒の固定費。 索引を開く分です。1,000本に分けたファイルで 0.043秒 対 0.126秒(ripgrep の方が 2.93倍速い)。ripgrep が 0.04秒で読み切る大きさだと、固定費が丸ごと見えます。同じ固定費が、8.6万本のカーネルでは 1.53秒 対 0.29秒の勝ちに変わります(相手の固定費の方が大きいので)。
1.5倍未満で遅い側にいる項目は 7つあります(カーネルの uvf 2回目 1/1.40、3GB の [ぁ-ん]{3,} の uvf 2回目 1/1.43、平文5本の uvp 1/1.19、平文1本の uvp 1/1.09、xz の uvf 1/1.08、カーネル8問の uvf 1/1.08、混在12本の uvp 1/1.06)。この連載の決まりでは「同等」ですが、遅い側なので数字を出します。
速さではない負けも残っています。.Z(compress)は未対応、POSIX 文字クラスは書けない、--json が出す項目は ripgrep より少ない(file・n・line の3つ)、-g にある除外指定(!)がまだ無い、zip と pbf は uvp だけ。
正しさの方に、時間はかかっていた
書いてきた記事は速さの話が多いのですが、手間がかかったのは正しさの方でした。
入口を増やすと、確かめることが掛け算で増えます。7形式 × 1本/複数 × cold/hot、除外規則 43項目、ワイルドカード 36項目、書き出し 8形式 × 2つの経路。しかも圧縮を展開した結果と平文の結果が1件でも違えば、速さの数字は全部意味を失います。
- 正しさのテスト 145件が Mac・Windows・Linux の3台とも合格(⑬)
- 速さの比較 96項目でも、出力の突き合わせは不一致 0 件
- 複数ファイルのヒット件数(5,445/122,441/127,886)、zip の 5,445/1,145、pbf の 94,979 は、すべて ripgrep や XML 版と一致
この「不一致 0 件」が無いと、上の表は出せません。 連載中に数字を全面的に差し替えた回が1つあります(①。測定に混ぜるべきでないファイルが入っていました)。そのときに主張まで変わった——「平文の2回目は速い」が「平文の2回目も遅い」になった——のは、正直なところ痛かったです。
持ち帰れる一般論
(1)機能を増やすときは、増えない側を先に決める。 Wide Field で増えた7つのうち、無料版 uvf に入ったのは「複数ファイル・7形式・除外規則・ワイルドカード・書き出し」で、状態(索引)を持つ機能は全部 uvp 側です。この線を先に引いたので、uvf の経路は「ファイルを順に読む」から変わらずに済みました。遅くならなかったのは、工夫ではなく、触らなかったからです。
(2)「相手ができないこと」を勝ちに数えない。 zip と pbf は ripgrep が探さないので、比較相手は unzip や osmium とのパイプになります。相手を自分で選べる比較は、選び方で数字が動きます。 だから倍率と一緒に「相手のコマンド」を必ず書く。相手がそもそも居ない機能(-seq など)は、倍率を書かずに「同義なし」と書いています。
(3)固定費は、入力の大きさで勝ち負けが反転する。 uvp の 0.12秒は、1,000本の小さいファイルでは 1/2.93 の負け、8.6万本のカーネルでは 5倍の勝ちです。同じ実装が、同じ日に、両方の顔を見せます。 「このツールは速い/遅い」と一言で言える道具は、たぶん測り方が足りていません。
(4)取り返せない負けは、取り返せないと書く。 平文5本は2回目も遅い。これを「1回目の代価」と書けば読み物としては通りますが、嘘になります。代価と呼べるのは、回数で取り返せる形になっているときだけです。
正直に書いておくこと
- 数字はすべて Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML(カーネルの行だけ Linux カーネルのソース)での測定例です。Windows・Linux の秒数はこの記事に持ち込んでいません(機械が違うので秒を比べられません)。3つの OS の比だけを扱った回は⑬です
- 1.5倍未満を「同等」と呼ぶのは、この連載が自分で決めた線です(理由は改善記⑨)。自分に有利な線引きに見える方は、表の秒数をそのまま読んでください
- 1回ずつの測定です。ぶれた所は測り直して確かめたものだけ注記しています。とくに複数ファイルの1回目は ripgrep の側も回によって揺れます(gz 7本で 22.39〜26.69秒)
- 表によってビルドが違います(1.7.3.7 の 26.10.04.23〜26.10.05.14)。1回の実行で 3GB・10GB・50GB が全部そろっている 1.7.3.7 のデータが無いためです。zip・pbf の行は v1.7.3.6(2026年10月2日)
- 50GB はメモリに収まらないので、2回目もディスクから読みます。3GB・10GB の2回目はメモリから読んでいます
--tuneの数字(⑪)だけは 2026年9月22日の開発版(1.7.0 台)で測ったもので、測り直していません- 50GB の gz と、bz2・xz・lzma・zst・lz4・br・zip の書き出しの速さは未計測です(正しさだけ確認しています)
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
uvp ならこう書く
この連載で増えた入口を、1行ずつ並べておきます。
uvf 'logs/*.log,err/*.gz' ERROR      # 複数ファイルを1コマンドで(引用符は必須)
uvf app.log.1.xz ERROR               # 圧縮7形式をそのまま(外部コマンドを呼ばない)
uvp logs.zip ERROR                   # zip のエントリを直接(uvp のみ)
uvp japan-latest.osm.pbf 東京        # pbf を直接(uvp のみ)
uvf 'src/**/*.log' ERROR --no-ignore # .ignore・.gitignore を無視して探す
uvp big.log ERROR -out hits.log.gz   # 結果を入力と同じ形式で書き出す
uvf big.log ERROR --json             # JSON Lines(file・n・line の3つ)
uvf --tune                           # この機械に合うスレッド数を測る(--apply で保存)
uvf big.log 'ZZZ-not-found'; echo $? # 終了コードを見る
終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)、Linux は Snap でも入ります。
正直に書くと、複数ファイルを初めて束ねる1回目は uvp が ripgrep より遅くなります——混在12本で 39.78秒 対 24.95秒。効いてくるのは2問目からで、同じ12本が 10.28秒、3問目までの合計で追い越します。平文だけを1回探すなら、無料の uvf か ripgrep の方が速いです。
リンク
Wide Field 連載の全14回です(③は②に統合しました)。
- ① 平文と gz の12本を1コマンドで: https://uvp.y42u.net/blog/uwview-wf01-multi-file-one-command/
- ② 外部コマンドを呼ばずに7形式(xz の並列展開も): https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- ④ 束ねた
.uwvzを使い回す(ファイルが消えても作り直さない): https://uvp.y42u.net/blog/uwview-wf04-bundle-keep/ - ⑤ zip の中を探す: https://uvp.y42u.net/blog/uwview-wf05-zip-entries/
- ⑥ pbf を探す: https://uvp.y42u.net/blog/uwview-wf06-pbf-osm/
- ⑦ 除外の規則(
.ignore・.gitignore): https://uvp.y42u.net/blog/uwview-wf07-ignore-rules/ - ⑧ ファイルの指定の仕方(引用符が必須な理由): https://uvp.y42u.net/blog/uwview-wf08-file-globs/
- ⑨ 正規表現の比較(.NET と Rust で書けるもの・書けないもの): https://uvp.y42u.net/blog/uwview-wf09-regex-vs-ripgrep/
- ⑩ 結果を入力と同じ形式で書き出す: https://uvp.y42u.net/blog/uwview-wf10-output-same-format/
- ⑪
--jsonと--tune: https://uvp.y42u.net/blog/uwview-wf11-json-and-tune/ - ⑫ 改行の数え方が2回目の検索の4割を占めていた: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- ⑬ 同じテスト一式を mac・Windows・Linux で流した: https://uvp.y42u.net/blog/uwview-wf13-three-os/
- ⑭ ripgrep にまだ負けているところを、全部並べる: https://uvp.y42u.net/blog/uwview-wf14-where-ripgrep-wins/
- 前の連載の総集編(First Light・読む回数だけを減らした): https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- ugrep・ripgrep・zgrep と7形式・12本を比べた記事: https://uvp.y42u.net/blog/uwview-ugrep-ripgrep-zgrep-compressed-logs/
- 保管する形式の選び方: https://uvp.y42u.net/blog/log-compression-format-choice/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。