【追記 2026-10-04】Windows では、圧縮の一部の形式で ripgrep の方が速い結果でした
この記事の「1.5倍以上の負けは 0 項目」は Mac での結果で、今も正しいです。同じテスト一式を Windows でも流すと(v1.7.3.6.8・2026年10月3日)、1回目+2回目の合計で xz(3GB で 1/1.69)・zst(1GB で 1/1.61)・lz4(1GB で 1/2.09、3GB で 1/1.51)の4か所で
uvfが ripgrep より遅い結果でした。原因は調べている途中です。Linux(2コア)では、これらの形式も同等以上でした。3つの OS の結果は Wide Field⑬ 同じテスト一式を mac・Windows・Linux で流したら、Windows で負けが見つかりました にあります。
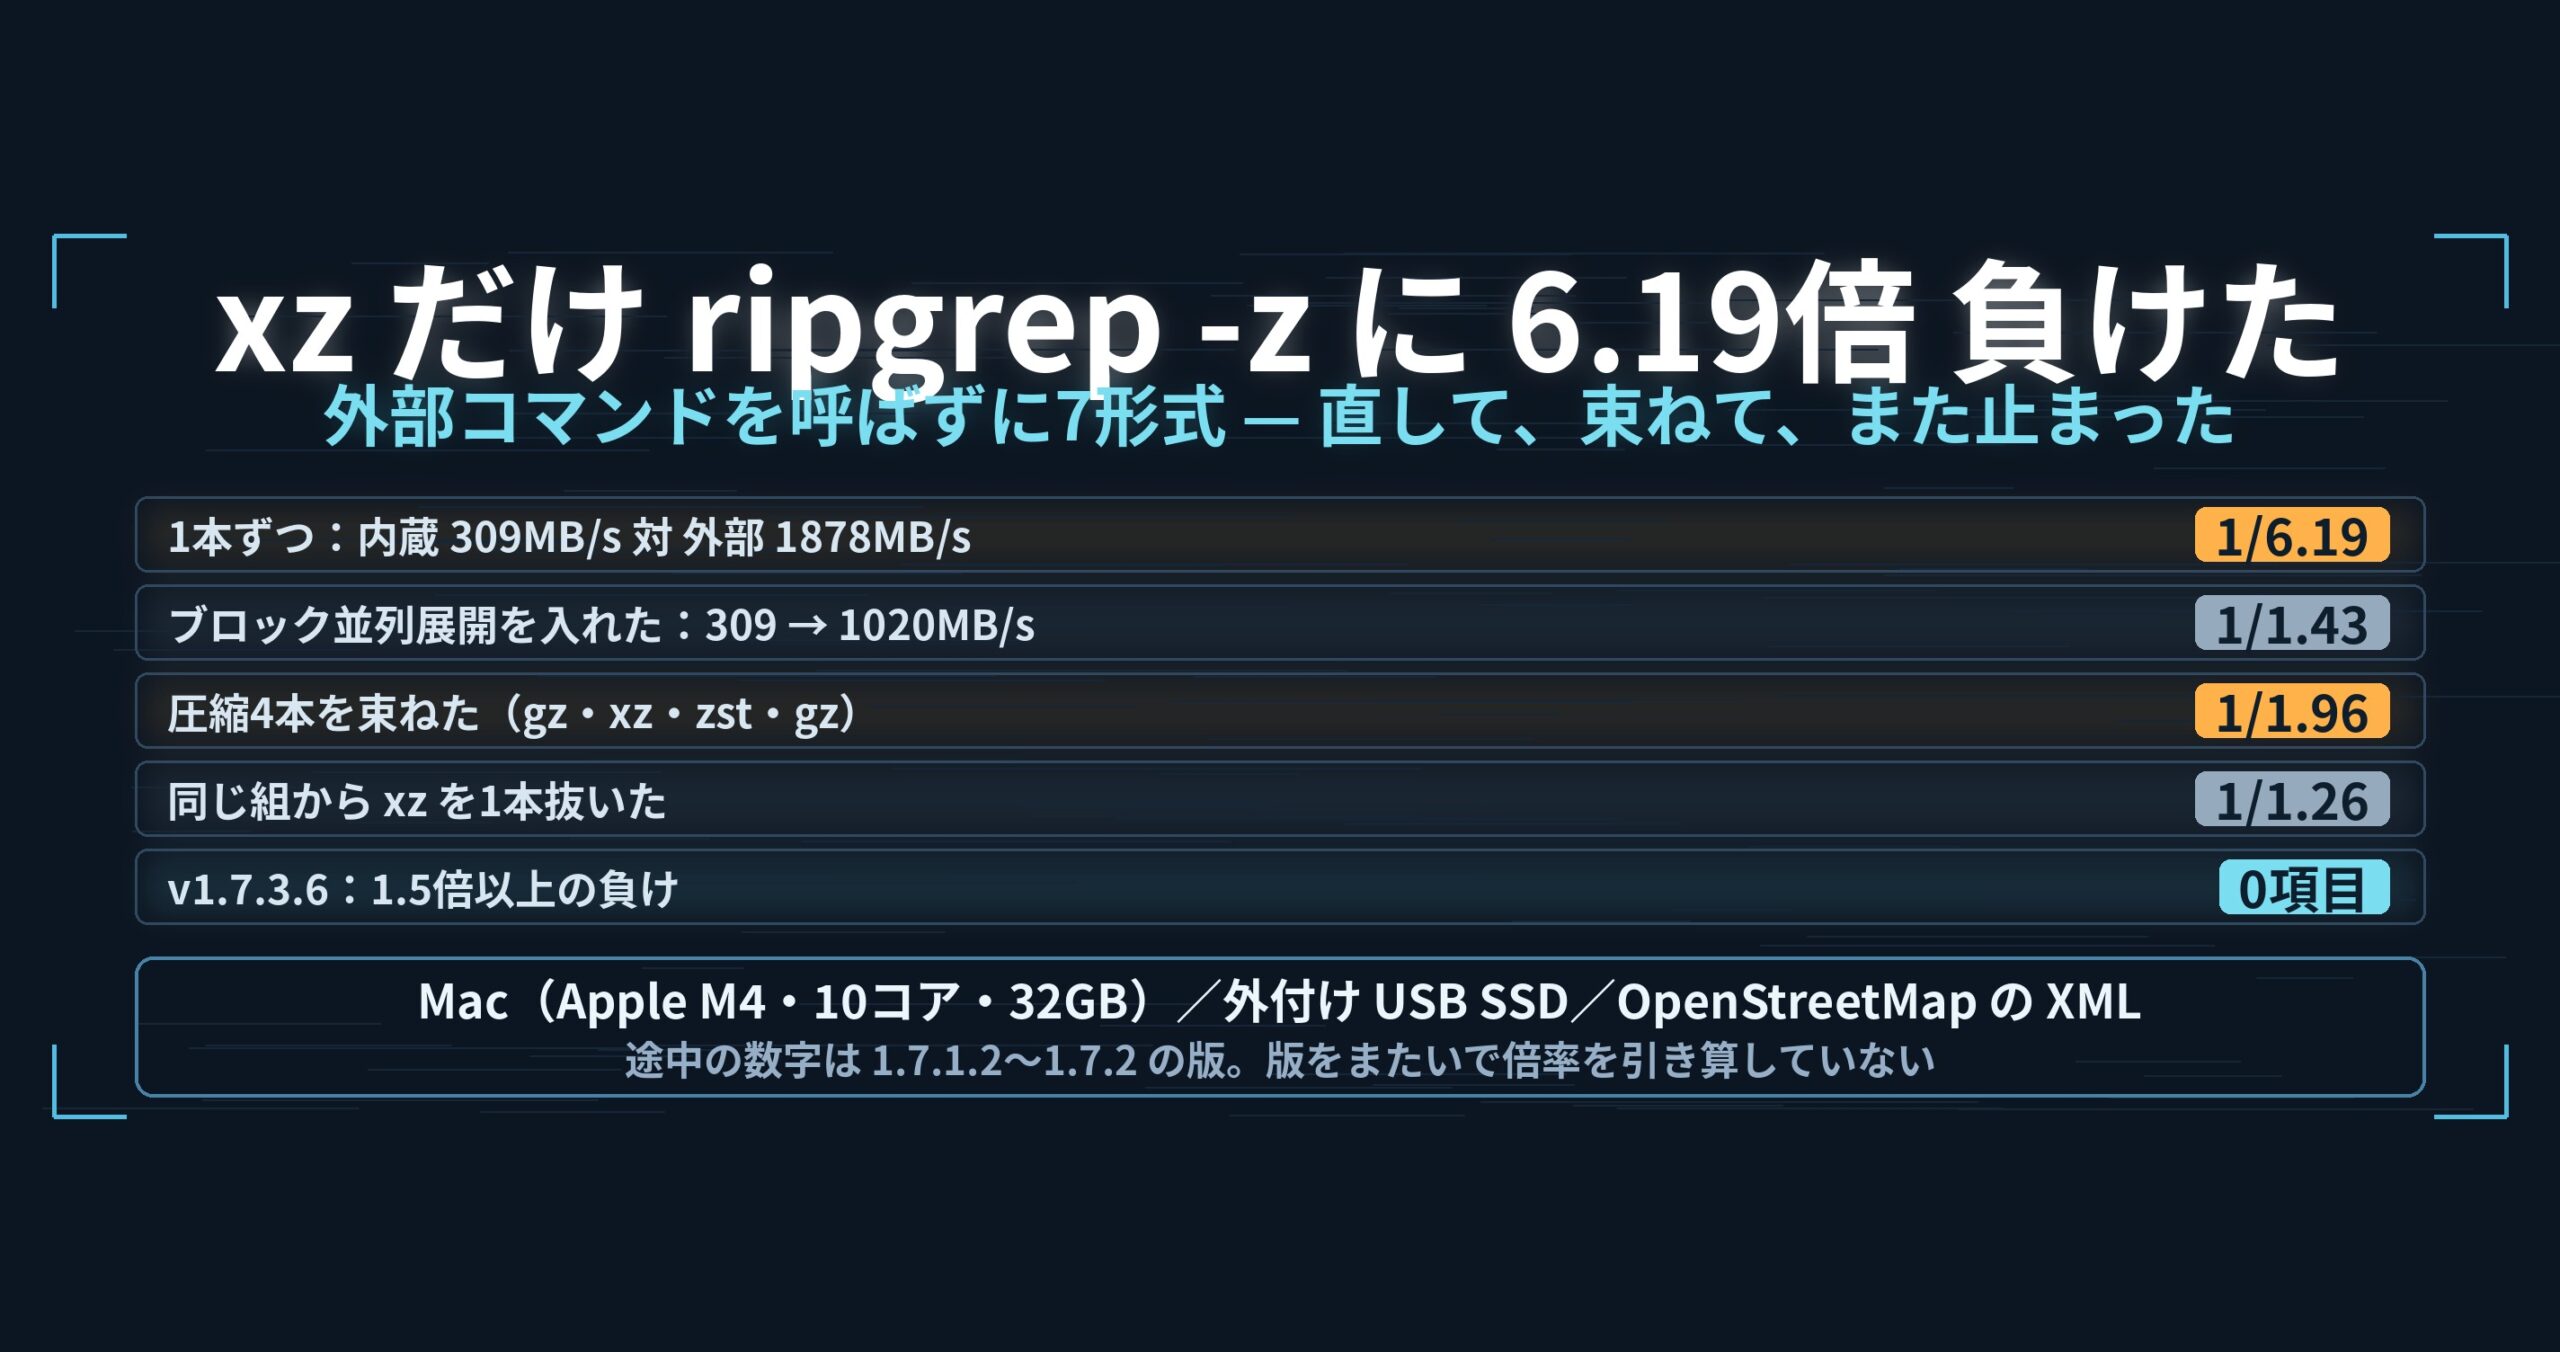
xz だけ、6倍でした。
同じ lzma2 を展開しているはずなのに、rg -z は 1878MB/s、こちらは 309MB/s。他の6形式は同等なのに、xz だけが桁違いに遅い。アルゴリズムは同じはずです。
では、何が違ったのか。
先に結論: 差はアルゴリズムではなく並列度。ブロック単位の並列展開を入れて内蔵の展開を 309→1020MB/s(3.3倍)にしたが、今度は4本を束ねると並列が止まり rg -z の 1/1.96 に戻った。原因は「xz が1本混ざること」だと切り分けで確定し、いまは解消
.xz は複数のブロックに分かれていることがあり、外部の xz コマンドはそれをスレッドで並列展開します。こちらは単スレッドで逐次に読んでいました。同じデコーダが .lzma(単一ストリーム)では 1.27倍速いのに .xz で 6.19倍負ける——ここから並列度の差だと当たりを付け、ブロックを見て並列展開するようにしました。内蔵の展開は 309MB/s → 1020MB/s。ところが圧縮4本をまとめて探すと uvf が rg -z の 1/1.96(3G・hot は 1/2.03)まで落ち、xz の部品を抜くと 1/1.26(同等)に戻ったので、原因は xz だと確定しました。いまは解消していて、v1.7.3.6 の統合テストでは Mac の圧縮形式テスト(1G・3G)に 1.5倍以上の負けが 0 項目です。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。この記事は改善の経過を追うので、途中の数字は測った開発版(1.7.1.2〜1.7.2)の値、現在地だけが v1.7.3.6 です。
先に負けを書きます
.Z(compress)には対応していません。rg -zは対応しているので、対応形式を並べるときは空欄にせず「未対応」と書いています。uvpの1回目は、どの形式でも.uwvzを作るぶんuvfより遅くなります。 Mac の 3G ではrg -zに対して xz で 1/1.37、平文を含む8本で 1/1.49 まで落ちます(どちらも1.5倍未満)。速いのは2回目からです。- この記事の途中経過は、版も元ファイルも違う計測をつないだものです。 あとで書きますが、「6.19倍から1.43倍に改善」という引き算はしていません。できないからです。
そもそも rg -z は、外部コマンドを呼んでいる
前提を1つ。rg -z の圧縮対応は、外部の展開コマンドを起動して、その出力を読む作りです。gzip・bzip2・xz・zstd・lz4・brotli を、必要に応じて呼びます。
これは強い作りです。展開はそれぞれの本家の実装で、しかも別プロセスなので、展開と検索が自然に並びます。一方で弱点もあります。そのコマンドが入っていないと、黙って飛ばします。エラーにはならず、0件で速く終わります。
こちらは外部コマンドを呼びません。7形式(gz・bz2・xz・lzma・zst・lz4・br)の展開を中に持っています。入っていない環境でも同じ結果になるかわり、展開の速さは自分の実装の責任になります。そこで最初に出たのが、冒頭の 6.19倍でした。
1幕目: xz だけが 6.19倍遅かった
7形式を1本ずつ測った最初の回(2892.3MB の XML・uvf 1.7.1.2)の結果です。2回分の合計で rg -z を1としたとき——
- gz 1.05 / bz2 1.01 / lzma 1.27 / br 1.13 / zst 1/1.06 / lz4 1/1.24 = すべて同等
- xz だけ 1/6.19
結果の一致は 16項目すべて取れていて、探せていないから速いという類の話ではありません。展開の速さに直すと、rg -z が 1878MB/s、こちらが 309MB/s でした。
なぜ「アルゴリズムではない」と言えたのか
.xz と .lzma は、中身の圧縮アルゴリズムが同じ系統です。そして同じデコーダを使う .lzma では、こちらが 1.27倍速かった。
同じ実装が、片方で勝って片方で6倍負ける。なら差はアルゴリズムの外側にある——そう考えるのが自然です。
外側で思い当たるのは、容れ物の構造でした。.lzma は単一のストリームで、途中から読み始められないので並列化できません。.xz は複数のブロックに分かれていることがあり、xz コマンドは 5.4 以降、マルチブロックの .xz をスレッドで並列に展開します。テストデータのブロック数を数えたら 82 ありました。
外部の xz は82ブロックを分担して展開し、こちらは82ブロックを順番に展開していた。 それだけの話でした。
手当て: ブロックを見て、分担する
.xz のブロックヘッダを読んで、複数あれば分担して展開する形にしました(uvf 1.7.1.3)。
内蔵の展開は 309MB/s → 1020MB/s。同じ機械・同じ指標で 約3.3倍です。
「6.19倍が1.43倍になった」とは書けません
ここは自分に都合のいい引き算ができてしまう場所なので、見出しを立てて書きます。
直したあとの計測では、xz の uvf 対 rg -z は 1/1.43(同等)でした。6.19 から 1.43 へ。この2つの数字を並べて「4.3倍の改善」と書くのは誤りです。
理由は単純で、元ファイルが違うからです。1回目は 2892.3MB の XML、直したあとは 979.2MB の XML で測っています。実際、rg -z 側の展開速度も 1878MB/s から 1554MB/s へ動いています。相手が動いている以上、倍率の差は実装の改善量ではありません。
同じ機械で比べられるのは、サイズで割った MB/s だけです。 だから書けるのは「内蔵の展開が 309 から 1020MB/s になった(3.3倍)」と「rg -z との差が同等の範囲に収まった」の2つだけ。秒数と倍率の前後比は、使いません。
2幕目: 束ねたら、並列が止まった
1本ずつは片付きました。ところが Wide Field の主題は複数ファイルです。圧縮4本(gz・xz・zst・gz)をまとめて1コマンドで探すと、こうなりました。
- 1G:
rg -z0.59秒 対uvf1.09秒=1/1.85 - 3G: 1/1.96(hot だけ見ると 1/2.03)
1本ずつのときは全形式が同等だったのに、束ねると 2倍近く負ける。同じ部品を、同じデコーダで読んでいるのに。
ここで使ったのが、「順に読んだ場合の見積もり」と実測の突き合わせです。1本ずつ測った hot の値を足して部品数で割れば、「並列していない場合はこのくらい」という目安が出ます。
- 圧縮4本(3G)の見積もり 1.34秒に対し、
uvfの実測 1.52秒 = ほぼ順番に読んでいる - 同じ見積もりで
rgは 1.49秒のところ、実測 0.75秒 = 2本ぶんくらい並んでいる - 一方、平文を含む別の組(平文+gz+zst+br)では、見積もり 1.23秒に対し
uvfの実測 0.61秒 = こちらも並列できている
並列できる組と、できない組がある。 2つの組の違いは、xz の部品があるかどうかでした。
切り分け: xz を1本抜く
仮説は仮説なので、部品を1つ入れ替えて測り直しました。xz を lz4 に替えた4本(gz・zst・lz4・gz)です。
- gz+xz+zst+gz … 1/1.85
- gz+zst+lz4+gz … 1/1.26(同等)
入れ替えた後の hot 0.22秒は、「順に読んだ場合」の見積もり 0.38秒より速い。つまり部品間の並列が効いています。
xz が1本混ざるだけで、部品間の並列が止まる。 1本の中を並列展開するようにしたせいで、スレッドを使い切っていたのでした。1幕目の手当てが、2幕目の原因になっていたわけです。
スレッドの配り方を直したあとの計測では、同じ形の圧縮4本で uvf が rg -z の 1.06(3G)・1.05(1G)です。ただしこのときは部品の中身が gz・xz・zst・bz2 に変わっているので、1/1.96 と 1.06 を直接引き算することもできません。組み合わせが違います。
現在地: v1.7.3.6
2026年9月29日に、公開版 v1.7.3.6 で3つの OS の統合テストを通し、Mac では圧縮形式ごとの速さ(3G)を測り直しました。ここでは Mac の値だけを書きます。
3G(2,937.7MB の XML を各形式で圧縮・「東京」3,435件)。キャッシュを捨てた直後の1回目と、続けて2回目の合計(秒)です。
| 形式 | rg -z |
uvf |
対 rg -z |
uvp(1回目+2回目) |
uvp の2回目 |
|---|---|---|---|---|---|
| gz | 2.66 | 2.07 | 1.29 | 1.50 | 0.34 |
| bz2 | 47.26 | 45.53 | 1.04 | 23.41 | 0.33 |
| xz | 3.53 | 3.81 | 1/1.08 | 2.80 | 0.34 |
| lzma | 20.80 | 16.99 | 1.22 | 9.03 | 0.33 |
| zst | 3.26 | 3.04 | 1.07 | 2.10 | 0.33 |
| lz4 | 1.87 | 1.70 | 1.10 | 1.44 | 0.34 |
| br | 5.05 | 4.13 | 1.22 | 2.56 | 0.33 |
| 平文4本+gz・xz・zst・bz2(8本) | 6.63 | 6.47 | 1.02 | 5.38 | 0.37 |
| 圧縮4本(gz・xz・zst・bz2) | 13.31 | 12.13 | 1.10 | 7.09 | 0.36 |
uvfは7形式と2つの混在のすべてでrg -zと同等です(1/1.08〜1.29)。xz は今もrg -zがわずかに速い(1/1.08)のですが、1.5倍未満です。- 2幕目で問題になった圧縮4本(gz・xz・zst・bz2)は 1.10。xz が混ざっても、部品間の並列は止まっていません。
uvpの1回目は.uwvzを作るぶん遅く、rg -zに対して xz で 1/1.37・平文を含む8本で 1/1.49(どちらも1.5倍未満)。2回目は形式によらず 0.33〜0.37秒です。- 統合テストの 1G でも、1.5倍以上の負けは 0 項目でした(
uvpの2回目は 0.14〜0.18秒、ただし bz2 だけ 0.72秒)。 - 入力の種類 66項目・複数ファイル 36項目の判定はすべて合格、不一致 0 件
持ち帰れる一般論
(1)同じ実装が勝ったり負けたりするなら、原因はアルゴリズムの外にある。 .lzma で勝ち .xz で6倍負ける、という非対称が最初の手がかりでした。片方だけ遅いのではなく、両方あるのに差がつくとき、差は容れ物や環境の側にあります。
(2)改善幅は、条件を固定できた指標だけで言う。 秒も倍率も、元ファイルが変われば動きます。今回それに耐えたのは MB/s だけでした。「何倍速くなった」と書く前に、その倍率の分母が動いていないかを見る。
(3)並列化は、局所最適が全体の足を引っ張ることがある。 1本の中を並列にしたら、複数本の並列が止まりました。上の層が同じ資源を使っているなら、下の層の最適化は上の層の性能を下げます。層をまたいで測らないと見えません。
(4)仮説は、部品を1つ入れ替えて確かめる。 「xz のせいかもしれない」で止めずに、xz だけ lz4 に替えて測り直したので確定できました。原因の候補が1つに絞れたら、それだけを動かす。
正直に書いておくこと
- 数字はすべて Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XMLでの測定例です。環境が変われば変わります
- 途中経過は版も元ファイルも違います。 6.19倍は 1.7.1.2(2892.3MB)、1.43倍と 1020MB/s は 1.7.1.3(979.2MB)、束ねの 1/1.85・1/1.96 は 1.7.1.4、1.06 は 1.7.2、現在地は v1.7.3.6。秒数と倍率を version 間で引き算していません
- 束ねの組み合わせも途中で変わりました(gz・xz・zst・gz → gz・xz・zst・bz2)。
1/1.96と1.06は別の組の値です - 「3G」は 979MB の同じ中身を3回つないだファイルです。実際の3GBのログとは性質が違います
- 1.5倍未満は「差」と呼んでいません。この基準は 2026年9月25日に 2倍から 1.5倍へ厳しくしたもので、それ以前の記録もこの基準で読み直しています(
1/1.85は当時「2倍未満」でしたが、いまの基準では負けです) - Windows と Linux の結果は持ち込んでいません。 同じ日の統合テストで3 OS とも不一致 0 件でしたが、機械も媒体も違うので秒数は OS をまたいで比べません
.Z(compress)は未対応です- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、7つの圧縮形式を外部コマンドなしで読み、複数ファイルを1回で探せます。
uvp ならこう書く
# 圧縮ファイルを、展開せずにそのまま探す(無料)
uvf app.log.xz ERROR

# 形式が混ざっていても、1回で(無料)
uvf 'app.log,app.log.*.gz,archive/*.xz' ERROR

# 探した結果を、そのまま画面で開く(無料)
uvf 'archive/*.xz' ERROR -open

# 束ねた .uwvz を作りながら探す(1回目・UwView Pro)
uvp 'archive/*.xz' ERROR

# 2回目以降は .uwvz を使う(同じコマンド・UwView Pro)
uvp 'archive/*.xz' ERROR

# 束ねた .uwvz から取り出す(平文・gz・zip は元の形、他は平文になる)
uvp archive.uwvz -extract -out ./restored/
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- 圧縮ログの検索を ugrep・ripgrep・zgrep と比べた(7形式・6つの道具の一覧): https://uvp.y42u.net/blog/uwview-ugrep-ripgrep-zgrep-compressed-logs/
- ログは圧縮したほうが、速く探せます(形式の選び方・縮み方と作る時間): https://uvp.y42u.net/blog/log-compression-format-choice/
- gz を展開せずに探す(パイプと CRC を外した話): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
.uwvzを作って、中を探して、取り出す: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。