秒間3,000行は、読めない。
人の目が追えるのは、せいぜい毎秒十数行です。その200倍の速さで画面を通り過ぎていった ERROR は、どこへ行ったのでしょうか。
流れ続けるログには、止まったログと違う難しさがあります。障害の最中、夜通しの負荷試験、組み込みのシリアルコンソール、TRACEに上げた開発機——場面は違うのに、行き止まりが同じ形をしています。順に4つ並べます。
- 先に結論: UwView Pro は索引と圧縮を保存するので、伸び続けているログでも「開き直して最新まで読む」を2回目以降0.02〜0.07秒で繰り返せ(47.73GBのテキストでの実測。特定環境での測定例で、環境により異なります)、保存した検索条件をそのまま当て直せます。なお、書き込み中のファイルへ自動で追従する表示(リアルタイム Tail)は無料版 UwView の側にあります(詳細は記事末尾)
- 1. 画面は「今」しか映さない — ERROR が流れ去ったあと
- 2. 夜通しの負荷試験 — 朝いちで「昨日の続き」から
- 3. シリアルコンソールのキャプチャを、数日分通しで読む
- 4. TRACEに上げたら1時間で40GB — 流量そのものを前提にする
- 4つに共通していたもの
- 使っている道具
- リンク
先に結論: UwView Pro は索引と圧縮を保存するので、伸び続けているログでも「開き直して最新まで読む」を2回目以降0.02〜0.07秒で繰り返せ(47.73GBのテキストでの実測。特定環境での測定例で、環境により異なります)、保存した検索条件をそのまま当て直せます。なお、書き込み中のファイルへ自動で追従する表示(リアルタイム Tail)は無料版 UwView の側にあります(詳細は記事末尾)
1. 画面は「今」しか映さない — ERROR が流れ去ったあと
状況
障害の最中です。tail -f でアプリケーションログを流しています。
滝のように流れます。ERROR が見えた気がして目で追いましたが、もう画面の外です。Ctrl+C で止めると、今度はそこから先の行が画面に出なくなります。ファイルの方は伸び続けています。
スクロールバックを上へ戻しても、遡れるのは数千行。秒間3,000行なら、数秒ぶんです。
なぜ起きるか
tail -f は「末尾への追記を転送する道具」で、遡る機能を持っていないからです。
ここに人の読む速度が掛かります。目で追えるのは毎秒十数行、意味を取りながらなら数行。毎秒3,000行との差は2桁以上あり、「全部を目で追う」は成立しません。
絞ろうとしてパイプを足すと別の問題も出ます。grep は標準出力がパイプやファイルのときブロックバッファリングに切り替わるので、数KBたまるまで手元に届きません。障害対応中の数秒の遅延は、判断の遅延になります。
汎用ツールでの対処と限界
まずバッファリングを外して、絞って流します。
# 行単位で流す(--line-buffered / stdbuf は実装依存)
tail -f app.log | grep --line-buffered -E 'ERROR|FATAL'

# 手元で見つつ、あとで読み返すために控える
tail -f app.log | stdbuf -oL grep -E 'ERROR' | tee triage.log

# 少しだけ過去から始める
tail -n 200000 -f app.log

# ローテーションで作り直されても追う
tail -F app.log
--line-buffered も stdbuf も GNU coreutils / GNU grep 前提の書き方です。BSD 系や busybox では挙動が違うので、手元の man で確かめてください。
限界は3つ。
ひとつめ、条件を先に決めなければならないこと。grep 'ERROR' で流し始めたあと「WARN も要る」と気づいても、あいだの WARN はもう画面に出ません。流れは待ってくれないので、やり直しが効きません。
ふたつめ、過去へ遡れないこと。-n 200000 で戻れるのは開始した瞬間の位置だけです。あとから「10分前を見たい」と思ったら tail -f を止めるしかなく、止めればその間は見えません。
みっつめ、行番号が無いこと。tail の出力に原本の行番号は付きません。後ろに grep -n を置いても出るのは「パイプに流れてきた何行目」です。報告書に「原本の何行目から様子が変わる」と書けない問題は、第16回の切り出しとまったく同じ形です。
2. 夜通しの負荷試験 — 朝いちで「昨日の続き」から
状況
24時間の負荷試験です。夜間は無人で回します。
朝に来ると、ログは18GBになっています。監視のグラフを見ると、レイテンシが跳ねたのは午前3時台らしい。夜のうちに tail -f を流していた端末を見ると——セッションが切れています。スクロールバックも、とうに溢れています。
その日の夕方、開発者から「別の観点で同じ時刻を見たい」と言われます。もう一度18GBに向き合うことになります。
なぜ起きるか
理由が3つ重なっています。
端末のスクロールバックは行数で回ること。 既定値は数千行から数万行。秒間数百行なら数分で一周し、「見ていたはずの画面」は残りません。
ssh セッションは落ちること。 ネットワークの瞬断、ノートPCのスリープ、VPN の再接続。無人の8時間を生き延びる前提で設計されていません。
そして「どこまで見たか」の座標が残らないこと。 これがいちばん効きます。翌日の再開も夕方の再調査も、前回どこを見ていたかが分からないので毎回ゼロからです。同じ18GBを1日に何度も開き直す構図は、第10回の「1日10回の開き直し」が夜間試験に出てきたものです。
汎用ツールでの対処と限界
画面を残す仕掛けと、時刻で切る仕掛けを用意します。
# セッションが切れても残るところで流す
tmux new -s load -d 'tail -f run.log | tee -a session.log'

# 午前3時台だけを取り出す
sed -n '/2026-09-13T03:/,/2026-09-13T04:/p' run.log > 3am.log

# 文字列比較で範囲を取る(ISO8601なら辞書順=時刻順)
awk '$0 >= "2026-09-13T03:00" && $0 < "2026-09-13T04:00"' run.log
限界は3つ。
ひとつめ、tee -a は二重保管になること。18GBの横にもう1本増えます。毎晩回すなら、増え方も毎晩ぶんです(保管は第8回)。
ふたつめ、切り出すと行番号が1から振り直されること。3am.log の500行目は原本の何行目でしょうか。試験レポートに貼る段でこの座標が要ります。
みっつめ、sed -n も awk も毎回頭から走ること。18GBの1走査で数分、「3時台」と「4時台」を見比べれば2回走ります。時刻で飛ぶ話は第7回に書きましたが、対象が伸び続けている最中のファイルだと、走っているあいだにも末尾が伸びていきます。
3. シリアルコンソールのキャプチャを、数日分通しで読む
状況
組み込みの基板を3日連続で動かし、シリアル出力を全部キャプチャしました。2.4GBのテキストです。
途中で再起動が何回か入っています。予定した再起動と、そうでない再起動が混ざっています。どれが「異常な」再起動なのかを知りたい。
開こうとすると、テキストエディタが固まります。less で開けましたが、画面が妙な色に染まって表示が崩れます。
なぜ起きるか
シリアルのキャプチャは「人が読むテキスト」ではなく「端末に流れたバイト列そのまま」だからです。
- 制御文字とエスケープシーケンスが生で混ざる —
ESC[32m(ESCは0x1B)のような色指定、カーソル移動、\rによる行頭復帰。ブートローダやカーネルは端末に向けて書いているので、当然こうなります - 改行コードが混在する —
CR単独・CRLF・LFが混ざります(picocom/minicom/screenの設定でも変わる)。CR単独だと「1行」の数え方がツールごとに食い違います(第18回の製造ログと同じ事故です) - タイムスタンプが無い、あっても相対値 — 基板側は起動からの経過ミリ秒しか持っていないことがあります。3日分の「いつ」に答えるには、起動時刻との対応を別に持つ必要があります
- 文字化けが2種類ある — ボーレート不一致による1バイト単位の化けと、ベンダーのメッセージが Shift_JIS で出ている化け。後者は切り替えれば読めますが、前者は元に戻りません(第3回)
汎用ツールでの対処と限界
まず何が混ざっているかを見て、それから数えます。
# 制御文字を可視化して中身を確かめる
cat -v capture.log | head -40

# ANSIエスケープを落とす(sed の \x 表記は実装依存なので perl の \e を使う)
perl -pe 's/\e\[[0-9;]*[a-zA-Z]//g' capture.log > clean.log

# 再起動が何回あったか
grep -c 'Booting Linux' capture.log

# CRを落として行数を数え直す
tr -d '\r' < capture.log | wc -l
限界は3つ。
ひとつめ、掃除した瞬間に別のファイルになること。clean.log は読みやすいですが原本ではなく、CR を落とせば行数まで変わります。ベンダーへ「原本のこの行から」と伝える座標が、掃除の段で失われます。
ふたつめ、ボーレート化けは検索で当たらないこと。Booting の o が1バイト化けていれば、grep 'Booting Linux' はその再起動を数えません。数えた結果が「4回」でも、本当は5回かもしれないという状態です。検索語の工夫では解けず、目で通して確かめるしかありません。
みっつめ、「いつ」に答えられないこと。相対ミリ秒しかないログでは、grep で場所は出ても時刻は出ません。「2日目の夕方」を探すには、結局前後を目で読んで見当をつけることになります。
4. TRACEに上げたら1時間で40GB — 流量そのものを前提にする
状況
再現しないバグを捕まえるため、ログレベルを TRACE に上げて回し始めました。
1時間で40GB。ディスクの警告が出ます。しかも肝心のバグは、まだ出ていません。あと何時間か回したい。回すには、出たぶんを片付ける必要があります。
なぜ起きるか
ログレベルは足し算ではなく掛け算で効くからです。
1リクエストあたり1行だったものが TRACE では200行になります。秒間100リクエストなら毎秒2万行。DEBUG のときの体感から線形に見積もると、必ず桁を外します。
そして、周りの設定が DEBUG 前提のまま残っています。
- ローテーションの設定が追いつかない — 「100MB×10世代」なら1時間で世代が何度も回り、いちばん見たい最初のほうから消えます(rotate の狭間で証拠が消える話は第16回)
- 圧縮がCPUを食う — rotate 後の
gzipがアプリと同じホストで走り、レイテンシの計測結果を汚します - 開発機のディスクが足りない — 本番と同じ流量を手元で再現できません(第17回の摩擦です)
汎用ツールでの対処と限界
出す量を絞る、保管を先に決める、流しながら捨てる。この3つを組み合わせます。
<!-- 疑っている範囲だけ TRACE にする(logback の例) -->
<logger name="com.example.payment" level="TRACE"/>
<root level="INFO"/>
# 保管ルールを先に当てておく(設定ファイルはシステムの logrotate.d 配下)
logrotate -f "$LOGROTATE_CONF"

# 流しながら、必要な語だけ残す
tail -F app.log | grep --line-buffered 'txnId=7f3a' > trace-7f3a.log

# ディスクの減り方を見張る
watch -n 60 'df -h /var/log; ls -l --block-size=M /var/log/app.log'
限界は3つ。
ひとつめ、絞ると「関係ないと思った行」が消えること。これが今回いちばん厄介です。com.example.payment だけ TRACE にしたのに、原因は別モジュールとの競合だった——というとき、証拠は最初から出力されていません。何が関係あるか分からないからレベルを上げたのに、上げた範囲を絞れと言われています。順序が逆です(同じ矛盾は第5回の printf デバッグにも出ます)
ふたつめ、rotate を待つあいだに消えること。世代数を増やせばディスクが持たず、減らせば古いほうが消えます。どちらに振っても、判断する前に選択させられます。
みっつめ、「40GBを開ける」前提が無いと、出したログを読まずに捨てることになること。開ける道具が無いので grep で数行だけ抜いて、残りは消す。出力量を増やした意味が、読めないことで消えます(第1回の「開けない」がここに戻ってきます)
4つに共通していたもの
| 状況 | 流れ方 | 汎用ツールでの対処 | 残る問題 |
|---|---|---|---|
| 障害中の追尾 | 秒間数千行・読速と2桁差 | tail -f \| grep --line-buffered |
条件を先に決めさせられる。遡れない。行番号が無い |
| 夜通しの負荷試験 | 8時間無人・18GB | tmux + tee、sed -n で時刻切り出し |
二重保管。行番号が振り直される。翌日再開の座標が無い |
| シリアルコンソール | 3日連続・2.4GB・制御文字混在 | cat -v/sed でANSI除去/grep -c |
掃除で原本と別物になる。化けた語は検索に当たらない |
| TRACEに上げた開発機 | 1時間40GB・掛け算で増える | ロガー単位のレベル分け/logrotate/絞って tee |
絞ると証拠が出ない。rotateで消える。読めないと出した意味が消える |
場面は4つともばらばらです。それでも同じところで詰まるのは、流れているログには次の3つが揃っているからです。
- 「今」と「さっき」が同じ画面に入らない — 追尾は末尾に張り付く道具で、遡る役を持ちません。逆に遡る道具(
less・sed -n)は、そのあいだ末尾を見ていません。片方を選ぶと、もう片方が見えなくなります - やり直しが効かない — 止まったファイルなら条件を変えて何度でも試せます。流れている最中は、条件を変えているあいだの行が視界から抜けます。だから先に正しい条件を決めろと言われる。無理な要求です
- 座標が残らない — 追尾の出力にも、パイプの先にも、掃除したファイルにも、原本の行番号がありません
この3つが揃うと、「流しながら読む」と「あとで遡って読む」が別の作業に分かれます。前者に tail -f、後者に less や sed。道具が2つに分かれること自体は問題ありませんが、その2つのあいだで座標が引き継げないのが行き止まりです。
必要なのは、後者を軽くすることです。
- 伸び続けているファイルでも、今ある分をそのまま全部開ける — 追尾を止めずに、別の窓で過去を見る
- 開き直しが軽い — 流量が速いほど「最新まで読み直す」回数が増えます。1回の待ちが短ければ、回数は問題になりません
- 条件を組み直さなくていい — 昨夜の条件をそのまま今朝に当てられる
冒頭の「流れ去った ERROR」に戻ります。あの ERROR は消えたわけではありません。ファイルの中に、行番号付きで残っています。画面から消えただけです。追いつけなかったのは目の速さで、記録の側は落ちていません。
使っている道具
私が開発している UwView(無料)は、巨大なテキストを開いた瞬間から表示・スクロール・検索できるビューアです。ファイル全体をメモリへ読み込まないので、RAMより大きいファイルでも開けます。索引はバックグラウンドで作られ、完成すると行番号が付きます。
流れているログについて、無料版が受け持つのはこの部分です。
- 書き込み中のファイルを開けます。 共有読み取りで開くので、アプリがログを書き続けている最中でも読めます。1章の「
tail -fを止めずに、別の窓で10分前を見る」ができます - リアルタイム Tail(追尾表示)は、この無料版にあります。 追記を検知して末尾へ自動スクロールします。後述しますが、Pro にはありません(デスクトップ版のみ。ブラウザ版では動きません)
- 読める大きさがRAMで決まりません。 4章の40GB、2章の18GB、3章の2.4GBを分割せず開けます(無料版での実測上限は47.73GB・約8.9億行。特定環境での測定例です)
- 原本に書き込まず、切り出しも分割もしません。 3章の
clean.logも2章の3am.logも作らずに読めるので、行番号が原本のままです - 文字コードは開いたまま切り替えられます(UTF-8 / Shift-JIS(CP932) / EUC-JP / UTF-16 を自動判定)。3章のベンダーメッセージだけ Shift_JIS という状況に、中間ファイルなしで対応できます
- ハイライトは行を消さずに色を付けます。 1章の
ERROR|FATALを色で浮かせれば、絞り込まずに流れの中から拾えます。行が消えないので、その前後も同じ画面に残ります
2章の「翌日の続きから」と、4章の「40GBの保管」は UwView Pro の領分です。
- 索引と圧縮を保存する: 一度開いたファイルは2回目以降行番号付きのまま瞬時に開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。流れているログでは「開き直して最新まで読む」の回数がそのままコストになります。2章の朝と夕方がここです
- 検索条件を保存して当て直せる: 昨夜の条件をそのまま今朝に当てられ、2章の「毎回ゼロから」が消えます(フィルタPopupの記事)
- 多段階検索(ドリルダウン): 絞った結果をさらに別の語で絞れます。原本の行番号は最後の段まで保持されます。1章の「
ERRORで始めて、あとからWARNも足したい」を、流れを止めずにあとからやれます(多段階検索の記事) - ±N は段ごとに独立: 絞る段は±1、読む段は±200。3章の「再起動の行は見つけたが、その前100行を読みたい」ができます(無料版は±1固定、可変の±N は Pro)
- シーケンシャル検索:
w1 → w2 → w3がこの順に現れる箇所だけを拾います。3章の予定した再起動とそうでない再起動を、直前のメッセージの並びで分けられます(実装記事)。正直に書くと、各段は前段の位置から本文を走査するので、所要時間は全文検索と同程度かかります - 集計(頻度ランキング): 正規表現に当たった値ごとの件数を出し、行をクリックするとその出現位置へ降ります。3章の再起動カウントに相当しますが、数えたあとで現物へ戻れるぶんが違います
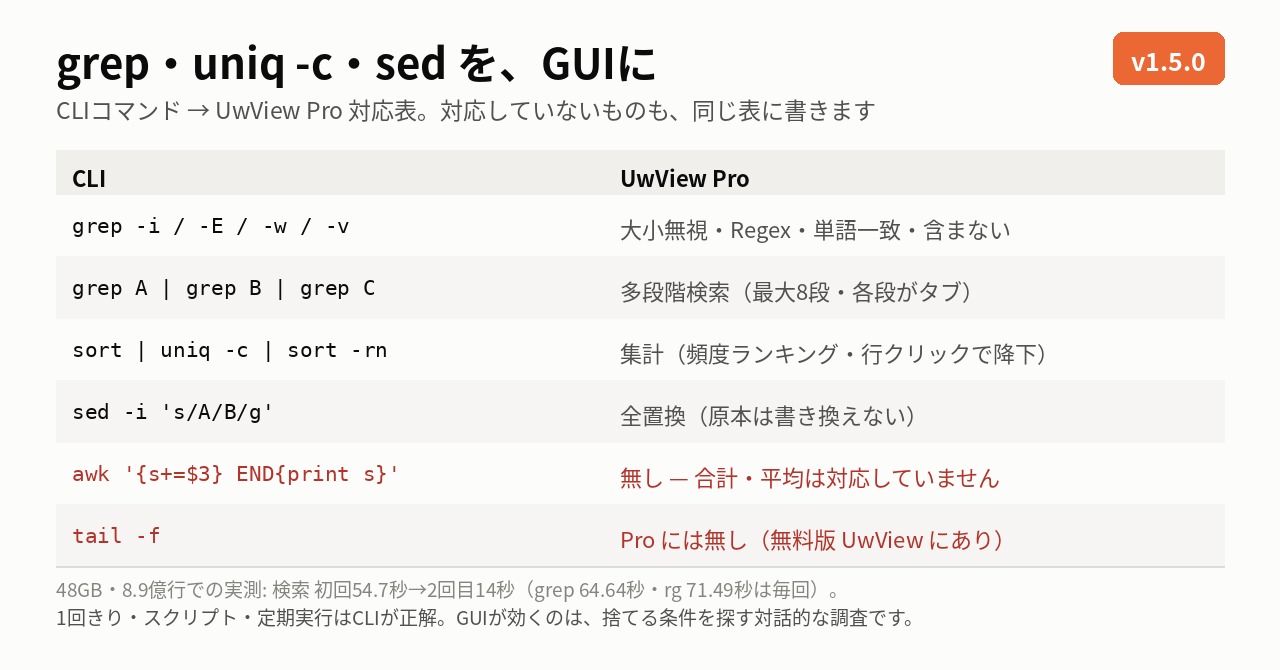
- 約1/9で保管しつつ検索できる: 4章の毎時40GBを、圧縮したまま検索できます。
zgrepのように毎回展開しながら走る必要がありません(第8回) - より大きなファイルを扱えます: Pro での実測は258.68GB・45億行です(特定環境での測定例で、環境により異なります)
正直な限界
この記事の主題は追尾なので、いちばん大事な制限から書きます。
- UwView Pro に、リアルタイム Tail(追尾表示)はありません。 追記を追いかける機能は無料版 UwView の側にあります。Pro は編集を差分ファイル(
.ewvz)で管理する都合上、原本が書き換わり続ける状態と相性が悪いため搭載していません。書き込み中のログを追い続けたいなら無料版を、開き直して最新まで読むだけなら Pro でも行えます。ご購入前にご確認ください - アラートも通知もしません。 「
FATALが出たら鳴らす」は監視の仕事です。1章で必要なのは人が見ている前提です - 複数ログの自動突き合わせはありません。 2章の試験ログと監視のグラフを並べて相関を取るところは、別の道具です
- 制御文字やANSIエスケープの自動除去はしません。 3章のキャプチャは、混ざったまま表示します(可視化して色を消すのではなく、そのまま読む形です)
- ログレベルやローテーションの設定には関与しません。 4章の出す量を決めるのはアプリ側の仕事です
- 1行の表示は先頭8,192文字までです。 3章の CR 単独キャプチャのように1行が極端に長くなるファイルでは、続きが省略されます
- 対象はテキストです。 バイナリで記録するキャプチャは、先にテキストへ書き出す必要があります
この記事の4項目はすべて読み取りだけの仕事です。非破壊の差分編集(Edit Upgrade)は別ライセンスとして存在しますが、ここで要るのは View 側です。
コマンドラインから同じことをする
v1.6.0 で uvp コマンドが付きました(無料版には uvf)。GUI と同じ .uwvz を使うので、CLI で作った索引はそのまま GUI でも効きます。この記事の4章に対応させると、こう書きます。
# 1章: 流れ去った ERROR を、あとからファイルの側で拾う(原本の行番号つき)
uvp app.log -E 'ERROR|FATAL' -C 5

# 1章の続き: 「WARN も要る」はあとから足せる。やり直しても行が抜けない
uvp app.log -E 'ERROR|WARN|FATAL' 'txnId=7f3a' -C 5

# 2章: 午前3時台を、翌朝そのまま同じ条件で取り直す。結果は圧縮して残せる
uvp run.log '2026-09-13T03:' 'latency' -C 10 -out 3am-latency.txt.gz

# 3章: 予定した再起動と、そうでない再起動を、直前の並びで分ける
uvp capture.log -seq 'reboot: Restarting system,Booting Linux' -C 10

# 4章: 40GB の TRACE を .uwvz のまま数える(展開しない)
uvp app.log.uwvz -uniq 'txnId=([0-9a-f]+)' -head 20

# 4章の続き: 当たりが付いたら GUI へ渡して、その前後を読む
uvp app.log.uwvz 'txnId=7f3a' -open
終了コードは grep と同じ 0=あり・1=なしに、2=上限に当たって打ち切った(既定は無制限。-limit N で上限を決めたときだけ)が加わります。2章の夜間ジョブの終わりに if uvp run.log 'FATAL'; then を置いておけば、朝いちで見るべきかどうかだけ先に分かります。ただしここも正直に書けば、CLI にも tail 相当の追従はありません。書き込み中のログを追い続けるのは無料版 UwView のリアルタイム Tail の役で、uvp が受け持つのは「流れ去ったあとを、保存できる形で速く取り直す」側です。
正直に書くと、1問目は ripgrep のほうが 15〜20% 速いです(uvp は先に索引を作るため)。3GB程度でメモリに収まるファイルなら、2問目以降も rg のほうが速いままです。uvp が効くのは10GBを超えて、同じファイルに2回以上聞くときです(実測記事。Mac M4・外付けUSB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約1/9保管で、開き直しも検索も一段速くなります(全OS対応・買い切り/月額プランあり)。
リンク
- 第1回: 巨大ファイルに沈む4つの定番ツールと、その先: https://uvp.y42u.net/blog/uwview-ps01-huge-file-tool-limits/
- 第3回: 文字コード4つの罠と切り分け手順: https://uvp.y42u.net/blog/uwview-ps03-japanese-encoding-traps/
- 第5回: 開発ログとの正しい付き合い方4選: https://uvp.y42u.net/blog/uwview-ps05-debug-log-practices/
- 第7回: タイムスタンプを武器にする4つの読み方: https://uvp.y42u.net/blog/uwview-ps07-timestamp-driven-triage/
- 第8回: 圧縮保管と検索の両立: https://uvp.y42u.net/blog/uwview-ps08-compressed-archive-search/
- 第10回: 深夜2時の自分を助ける4つの仕込み: https://uvp.y42u.net/blog/uwview-ps10-oncall-night-preparation/
- 第16回: 保全・切り出し・改ざん対策の4原則: https://uvp.y42u.net/blog/uwview-ps16-log-as-evidence/
- 第17回: 開発環境とログの4つの摩擦: https://uvp.y42u.net/blog/uwview-ps17-dev-env-log-friction/
- 第18回: 機器が吐くログの現場4例: https://uvp.y42u.net/blog/uwview-ps18-device-generated-logs/
- 検索結果を別窓に切り出した理由(フィルタPopup): https://uvp.y42u.net/blog/uwview-filter-popup-jump-save-context/
- uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- 絞り込んだ先からさらに絞り込む(多段階検索): https://uvp.y42u.net/blog/uvp-drilldown-search/
- その順に現れる箇所だけを探す(シーケンシャル検索): https://uvp.y42u.net/blog/uvp-sequence-search/
- ソースコード(GitHub): https://github.com/amru195704/UwView
開発者より: アプリ・Kindle本・オープンソースの一覧は GitHub: amru195704 にまとめています。
お願い
本記事の情報は参考目的で掲載しており、正確性・完全性を保証するものではありません。行数・容量・ファイル名・ログの文面・設定値はすべて説明のための例であり、特定の製品や事案を指すものではありません。tail・grep・sed・awk・tr・cat・stdbuf・tee・logrotate・tmux・watch等の挙動は実装(GNU/BSD/busybox)・バージョン・ビルドオプションにより異なり、オプション名や既定値も変わります。特にtail -fとtail -Fの違い、--line-bufferedやstdbufの可否は環境依存です。必ず手元のmanおよび公式ドキュメントで確認してください。本番環境でログレベルを変更する場合は、ディスク容量・ローテーション設定・性能への影響を事前に確認し、各組織の変更管理手順に従ってください。実測と明記した数値も特定の1環境での測定例であり、同じ結果を保証するものではありません。誤記・不正確な情報がございましたら、コメント欄よりご指摘いただければ、確認のうえ修正いたします。