6%、まだ負けています。
50GB のログを1問目に検索すると、ripgrep が 54.9〜55.8秒、こちらが 59.0秒。この連載を始めた時点では、205秒 対 56秒でした。
3.7倍の負けを 6% まで詰めて、それでも残った 6% は何なのか。この 6% だけは、速くする方法を探しても出てきませんでした。
先に結論: 12回で触ったのは「読む回数」だけで、到達点は「媒体の素読み速度」でした
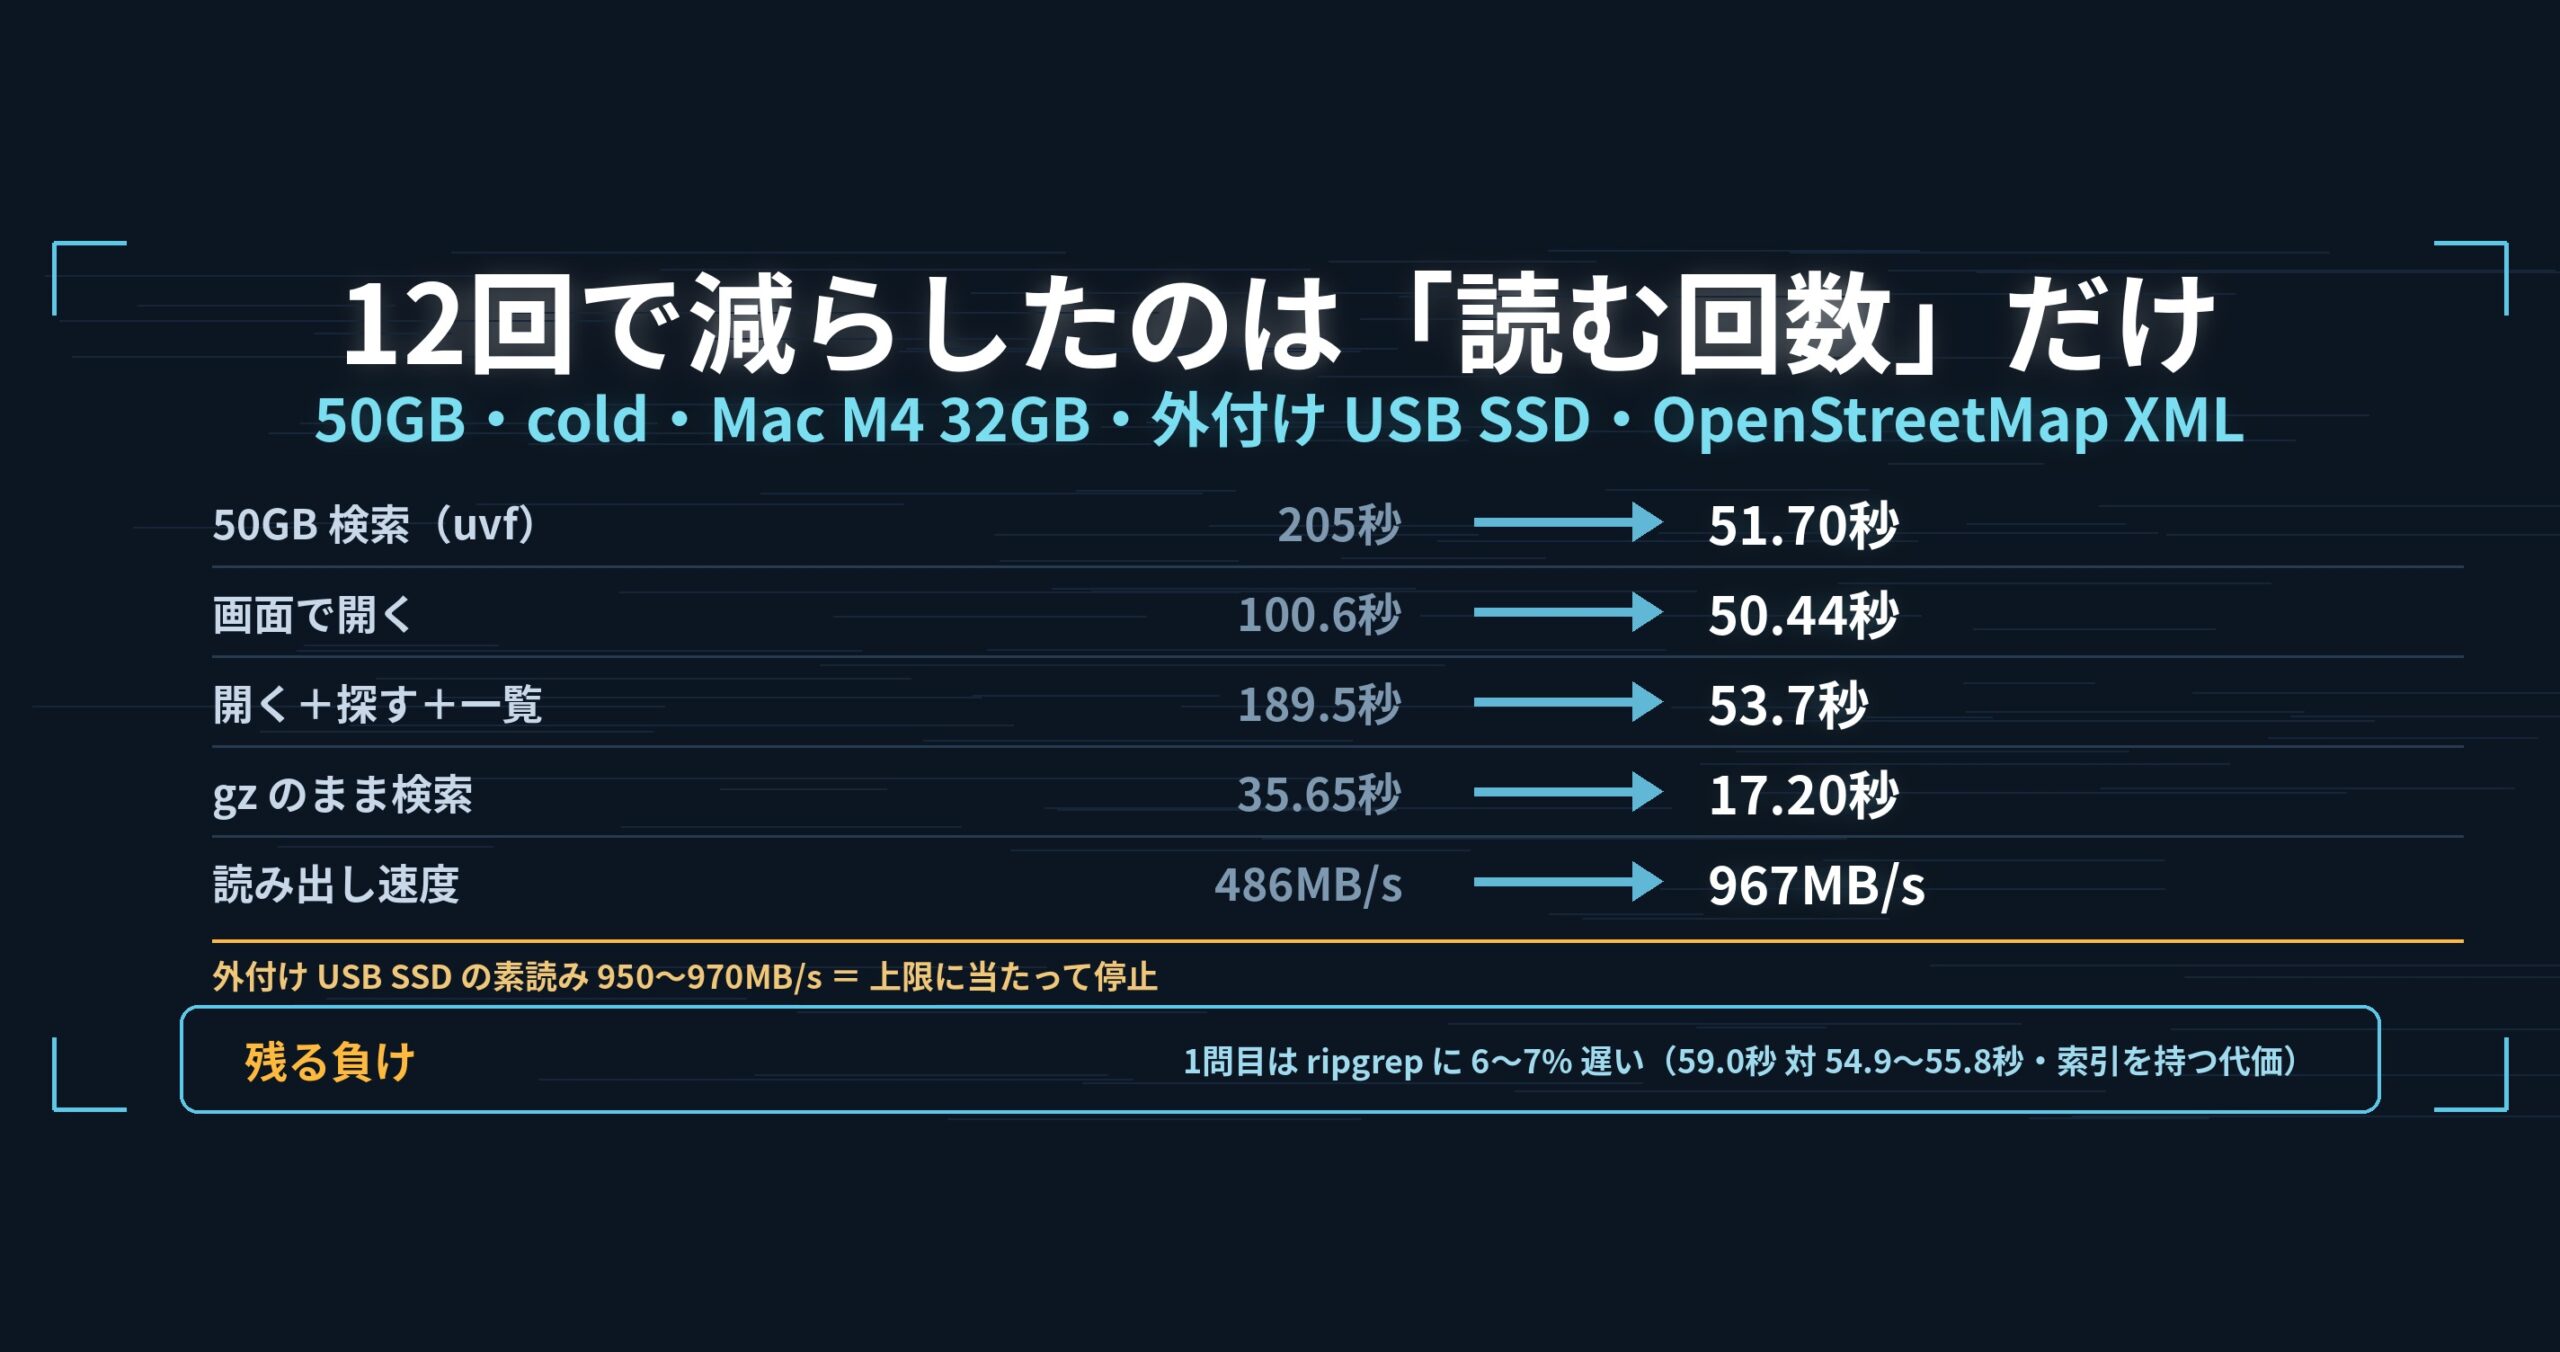
12回ぶんの改善で、50GB の検索(無料 CLI uvf・cold)は 205秒 → 51.70秒、画面で開くのは 100.6秒 → 50.44秒、開いて探して行番号つきの一覧が出るまでは 189.5秒 → 53.7秒。gz のままの検索は 35.65秒 → 17.20秒。読み出しの実効速度は 486MB/s → 967MB/s で、これはこの機械の外付け USB SSD の素読み速度(950〜970MB/s)そのものです。つまり上限に当たって止まっています。一方で uvp の1問目は ripgrep より 6〜7% 遅いまま(59.0秒 対 54.9〜55.8秒・v1.6.6.1)で、これは索引を持つ側が払う代価なので、設計を変えない限り消えません。アルゴリズムを賢くした回は1つもなく、やったのは同じファイルを何回読んでいるかを数えて、その回数を減らすことだけでした。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML・sudo purge 後の cold。詳細は記事末尾。
この記事は「First Light」連載の最終回(第 13 回)です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
出発点: 「速さの道具ではありません」と自分で書いていた
連載の第 1 回で書いたとおり、v1.6.0 の時点の説明文には「速さの道具ではありません」という一文がありました。嘘ではなく、事実の記述でした。
- 50GB の検索(
uvf)は 205秒。ripgrep は 56秒。3.7倍の負け - 画面で 50GB を開くのに 100.6秒。klogg は 52.55秒。1.9倍の負け
- 開いて、探して、行番号つきの一覧が出るまで通しで 189.5秒。klogg は 108.14秒
- 索引を作るときの読み出しは 486MB/s。媒体の素読みは 950〜970MB/s 出るのに、半分しか使えていなかった
売り物として出しているものの数字がこれでした。ここから 12 回、直した内容を1本ずつ書いてきました。
12回でやったことは、ぜんぶ同じ形をしていた
並べてみて自分でも意外だったのですが、新しいアルゴリズムを持ち込んだ回が1つもありません。全部が「読む回数を減らす」か「読み方を変える」かのどちらかでした。
- 2回半読んでいたのを1回にした(第 2 回)。行数を数えるために1回、一致を探すために1回、本文を書き出すためにもう半分。この3つを1パスに畳んで 203秒 → 50.82秒
-iを文字列に戻さずに済ませた(第 3 回)。大文字小文字を無視する検索でバイト列のまま畳み込む。例外はケルビン記号 U+212A だけ- 正規表現から必須リテラルを取り出した(第 4 回)。13.68秒 → 7.75秒。取りすぎるとヒットが消えるので、取り損ねる側に倒す
- CLI が探した結果を画面に渡した(第 6 回)。以前は CLI で探して画面で開くと 2回読んでいたのを1回に
- mmap をやめて pread にした(第 10 回)。順次読みでは mmap は pread の 57% しか帯域が出ませんでした
- gz をパイプなしで読んだ(第 8 回)。OS の zlib を直接呼び、8バイトの CRC 検査を外す。35.65秒 → 17.20秒
速くなった理由が「読む回数」で説明できてしまうのが、この連載で一番はっきりしたことでした。裏返すと、v1.6.0 の遅さは実装の粗さではなく、設計で決まっていたということです。
「CPU を速くする」側は、数字に出なかった
対照的に、CPU 側を速くした回は秒数を動かせませんでした(第 11 回)。
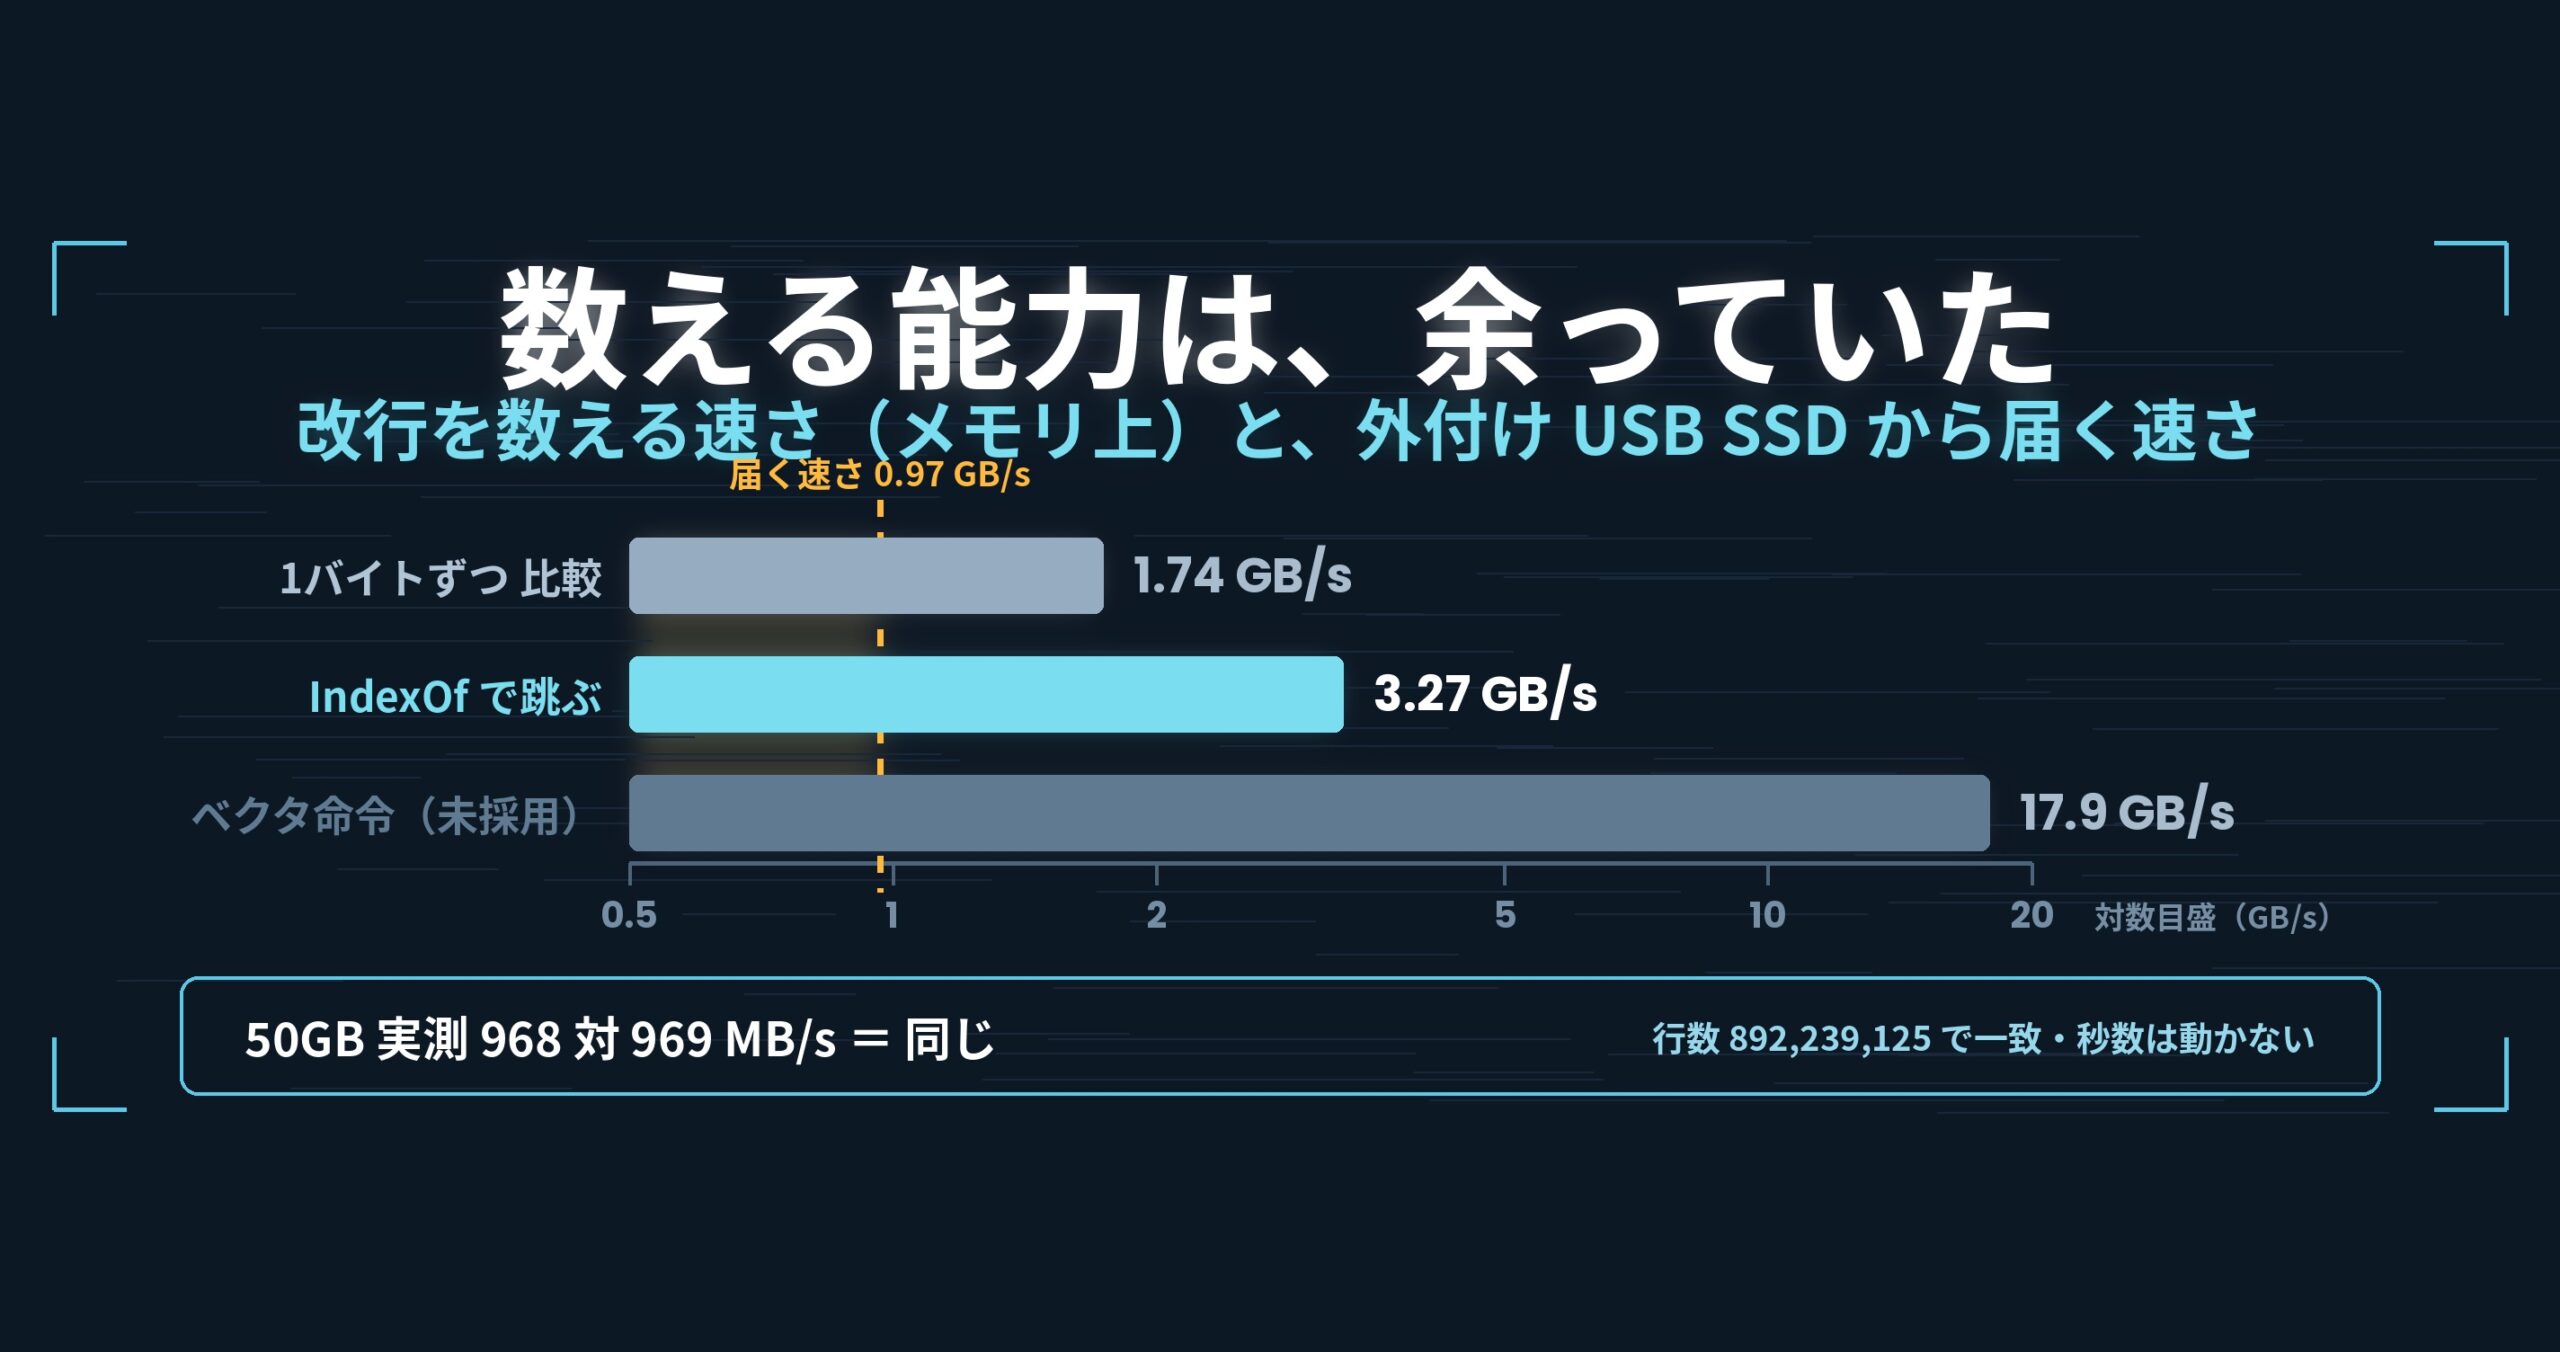
改行を数える処理は、1バイトずつ見る書き方で 1.74GB/s、標準の検索関数を使うと 3.27GB/s、SIMD を使うと 17.9GB/s。メモリ上では 10倍以上の差がつきます。ところが 50GB のファイルをディスクから読んで数えると、どの書き方でも 968〜969MB/s でした。
媒体が 968MB/s しか出さないので、CPU 側の 10倍は消えます。 索引作成が 486MB/s から 969MB/s になった主因も、数え方の改良ではなく pread 化でした。
数字: 到達点
50GB・cold・sudo purge 後
| 相手 | 指標 | 連載開始時点 | v1.6.6 “First Light” |
|---|---|---|---|
| ripgrep | 50GB 検索1回(uvf) |
205秒 対 56秒(1/3.7) | 51.70秒 対 54.94秒(1.06=同等) |
| klogg | 50GB 開くだけ(画面) | 100.6秒 対 52.55秒(1/1.91) | 50.44秒 対 52.55秒(1.04=同等) |
| klogg | 50GB 検索(画面) | 88.9秒 対 55.59秒(1/1.60) | 53.50秒 対 55.59秒(1.04=同等) |
| klogg | 開いて探して一覧(画面・通し) | 189.5秒 対 108.14秒(1/1.75) | 53.7秒 対 108.14秒(2.01倍) |
gzip -dc \| rg |
50GB 相当の gz 検索 | そもそも検索できない | 17.20秒 対 22.06秒(1.28=同等) |
| 媒体 | 読み出しの実効速度 | 486MB/s | 967/966/969MB/s(3サイズ同値) |
ここで一つ、書き方の注意があります。1.06 と 1.04 と 1.28 を「勝ち」と書いていません。 第 9 回で決めた基準——単項目は 1.5倍未満を「差」と呼ばない——に照らすと、これらは全部同等の範囲です。3.7倍負けていたものが同等になったのは十分な成果ですが、同等を勝ちに書き換えると、その先の数字が全部信用を失います。
差と書けるのは、通しの 2.01倍と、2問目以降の検索です。.uwvz(uvp 用の圧縮形式+索引)がある状態での 50GB 検索は 6.56秒で、klogg の 55.59秒に対して 8.5倍。ここは基準を大きく超えています。
読み出し速度の行がいちばん大事だと思っています。3サイズ(3GB・10GB・50GB)で 967/966/969MB/s と同じ値が出ました。ファイルの大きさで変わらない数字は、もう自分の実装の数字ではなく媒体の数字です。上限に当たったことが、上限に当たったという形で確認できたわけです。
残っている負け
同等になった話だけ並べると片側だけの絵になるので、今も負けている条件を書きます。
uvpの1問目は 6〜7% 遅い。50GB で 59.0秒 対 54.9〜55.8秒(v1.6.6.1)。基準で言えば同等の範囲ですが、遅い側なので数字を出します- 3GB の hot(2回目)の素の検索は、ripgrep 0.32秒 対
uvf0.54秒。1.69倍の負けで、これは基準を超える本物の負けです。小さいファイルでは起動の固定費が見えます(第 7 回) - 先頭だけ出す
-headは、rg | headに 1.5〜6倍負ける。相手は必要な分だけ読んで打ち切れますが、こちらは索引の都合で読む量が減りません - 2コアの Linux VM の 3GB は互角止まり(1/1.01)。
.uwvzの展開が CPU で律速するので、コアが少ない機械では索引を持つ利点が消えます(第 12 回) - 258GB の画面通しは未計測。予想はありますが、測っていない数字は書きません
なぜ 1問目の 6% は消えないのか
冒頭の 6% の答えです。これは実装の遅さではなく、索引を持つことと引き換えの費用でした。
第 12 回までで、1問目の中身は 3つに分解できています。50GB・cold で、.uwvz を作りながら探すのに 58.6秒、そのあとの検索が 0.03秒、合わせて 59.0秒。以前は「作ってから、作ったものを読み直して探す」の2段で 65.7秒かかっていました。読み直しの 6.8秒は、作りながら探す形にして消えています(v1.6.6.1)。
残った 58.6秒を読み出し換算すると 828MB/s。素読みの uvf は 962MB/s なので、差は 圧縮の計算と、5.74GB の書き込みです。
つまり——平文をもう一度読んでいるわけではありません。 平文は1回しか読んでいない。それでも遅いのは、読むついでに圧縮して書いているからです。ここを速くするには圧縮をやめるしかなく、圧縮をやめると 2問目の 6.56秒が消えます。
1問目の 6% は、2問目以降の 8.5倍を買うための代金でした。だから「直す」対象ではないと判断しています。もし 1問目しか投げないなら、素の uvf か ripgrep を使うほうが速い。それが正しい使い分けです。
持ち帰れる一般論
(1)遅さは「回数」で分解できることが多い。 205秒を見て最初にやったのは、プロファイラを回すことではなく、同じファイルを何回読んでいるかを数えることでした。索引に 100秒・検索に 82秒・出力に 20秒。この3つが別々にファイルを読んでいる、と分かった時点で直し方は決まっていました。アルゴリズムを疑う前に、回数を数える。
(2)上限を先に測っておくと、終わりが分かる。 媒体の素読みが 950〜970MB/s だと知っていたので、967MB/s に届いた時点で「この方向はもう伸びない」と判断できました。上限を知らないと、残り 3% を追って何週間も使うことになります。上限は自分の数字を疑うためにも効きます(第 12 回の「10GB を 2.65秒」は、上限を知っていたから測定ミスだと分かりました)。
(3)律速の外側の改善は、数字に出ない。 SIMD で改行を 10倍速く数えても、ディスクが 968MB/s なら秒数は動きません。どこが律速かを先に測る。逆に、内蔵 NVMe のように媒体が速い環境なら同じ改善が効きます——効く/効かないは環境の属性で、コードの属性ではありません。
(4)勝ち負けの基準を、結果を見る前に決める。 1.06倍を「勝ち」と書ける状況で書かないためには、測る前に決めた基準が必要でした。基準は自分を縛るためにあります。
(5)残る負けは、設計の選択として説明できるところまで持っていく。 「まだ遅いです」で終わるのと、「1問目が遅いのは索引を書いているからで、2問目以降を買うための代金です」と言えるのは別です。後者まで持っていけた負けは、隠す必要がありません。
正直に書いておくこと
- 数字はすべて Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML・
sudo purge後の cold(hot と書いた行だけ2回目)での測定例です。環境が変われば変わります - 秒数を OS またぎでは比べていません。Windows・Linux の値は各 OS の中での比だけを書いています(第 12 回)
- 「連載開始時点」の列は v1.6.0〜v1.6.5 の値が混在しています(画面側は v1.6.5、CLI 側は v1.6.0〜v1.6.2)。1つの版の一覧ではありません
- 1.5倍未満は「差」と呼んでいません。同等と書いた行は、環境が違えば逆転しうる幅です
- 比較相手は ripgrep 15.2.0・klogg 24.11.0.1685。相手の設定を詰め切れていない可能性は残ります
- 250GB/258GB の画面通しは未計測です。
uvf … -openの 250GB も v1.6.5 の値のままで、v1.6.6 では再計測していません - 3GB の「通し」は、検索語を打ち込んでいる間に開き終わるため測定が成立しません(表から落としています)
- ヒット件数は klogg と一致することを確認しています(11,274/11,393/94,979 件)が、一致を確認したのは主要な項目だけで全条件ではありません
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
この連載で測ってきた形を、そのまま並べておきます。
# 1問目(索引 .uwvz を作りながら探す)
uvp huge.log 'ERROR'

# 2問目以降(作った .uwvz を使う。ここが速くなる)
uvp huge.log 'ERROR'

# 索引を持たない素の検索(ripgrep と同等の条件)
uvf huge.log 'ERROR'

# 探した結果をそのまま画面で開く(2回読まない)
uvf huge.log 'ERROR' -open

# gz を展開せずに探す
uvf huge.log.gz 'ERROR'

# 大文字小文字を無視する
uvf huge.log 'error' -i

# 行だけ出す(sed -n p 相当)/終了コードの確認
uvf huge.log 'ERROR' -grep
uvf huge.log 'ZZZ-not-found'; echo $?
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
正直に書くと、1問目は uvp が ripgrep より少し遅くなります——.uwvz(uvp 用の圧縮形式+索引)を作りながら探すぶんで、50GB なら 59.0秒 対 54.9〜55.8秒=6〜7%(v1.6.6.1)。効いてくるのは2問目からで、同じ 50GB の検索が 6.56秒、klogg に対して 8.5倍速くなります。3GB のような小さいファイルでは同等です。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
連載の全 12 回です。
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳(205秒の分解): https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2回半読んでいた CLI を1回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 3 回:
-iを文字列に戻さずに(U+212A だけが例外): https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/ - 第 4 回: 正規表現を固定文字列と同じ速さに: https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- 第 5 回: 同じコマンドで件数が揺れた(打ち切りと終了コード): https://uvp.y42u.net/blog/uwview-fl05-deterministic-count/
- 第 6 回: CLI が探した結果を画面に渡す: https://uvp.y42u.net/blog/uwview-fl06-cli-to-gui-handoff/
- 第 7 回: 3GB でだけ負ける理由は固定費だった: https://uvp.y42u.net/blog/uwview-fl07-3gb-fixed-cost/
- 第 8 回: gz を展開せずに探す: https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
- 第 9 回: どこからを「差」と呼ぶかの基準: https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- 第 10 回: mmap は順次読みで帯域の6割しか出ない: https://uvp.y42u.net/blog/uwview-fl10-mmap-vs-pread/
- 第 11 回: 改行を速く数えても秒数が動かなかった: https://uvp.y42u.net/blog/uwview-fl11-newline-vs-media/
- 第 12 回: 同じハーネスを Mac・Windows・Linux で回す: https://uvp.y42u.net/blog/uwview-fl12-three-os-harness/
- 1問目の探し直しを消した話(v1.6.6.1): https://uvp.y42u.net/blog/uvp-v1661-search-while-building/
- 画面を CLI に追いつかせた話: https://uvp.y42u.net/blog/uvp-gui-catches-up-v166/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。