【追記 2026-10-04】続き:2回目(hot)では、改行の数え方が秒に出ました
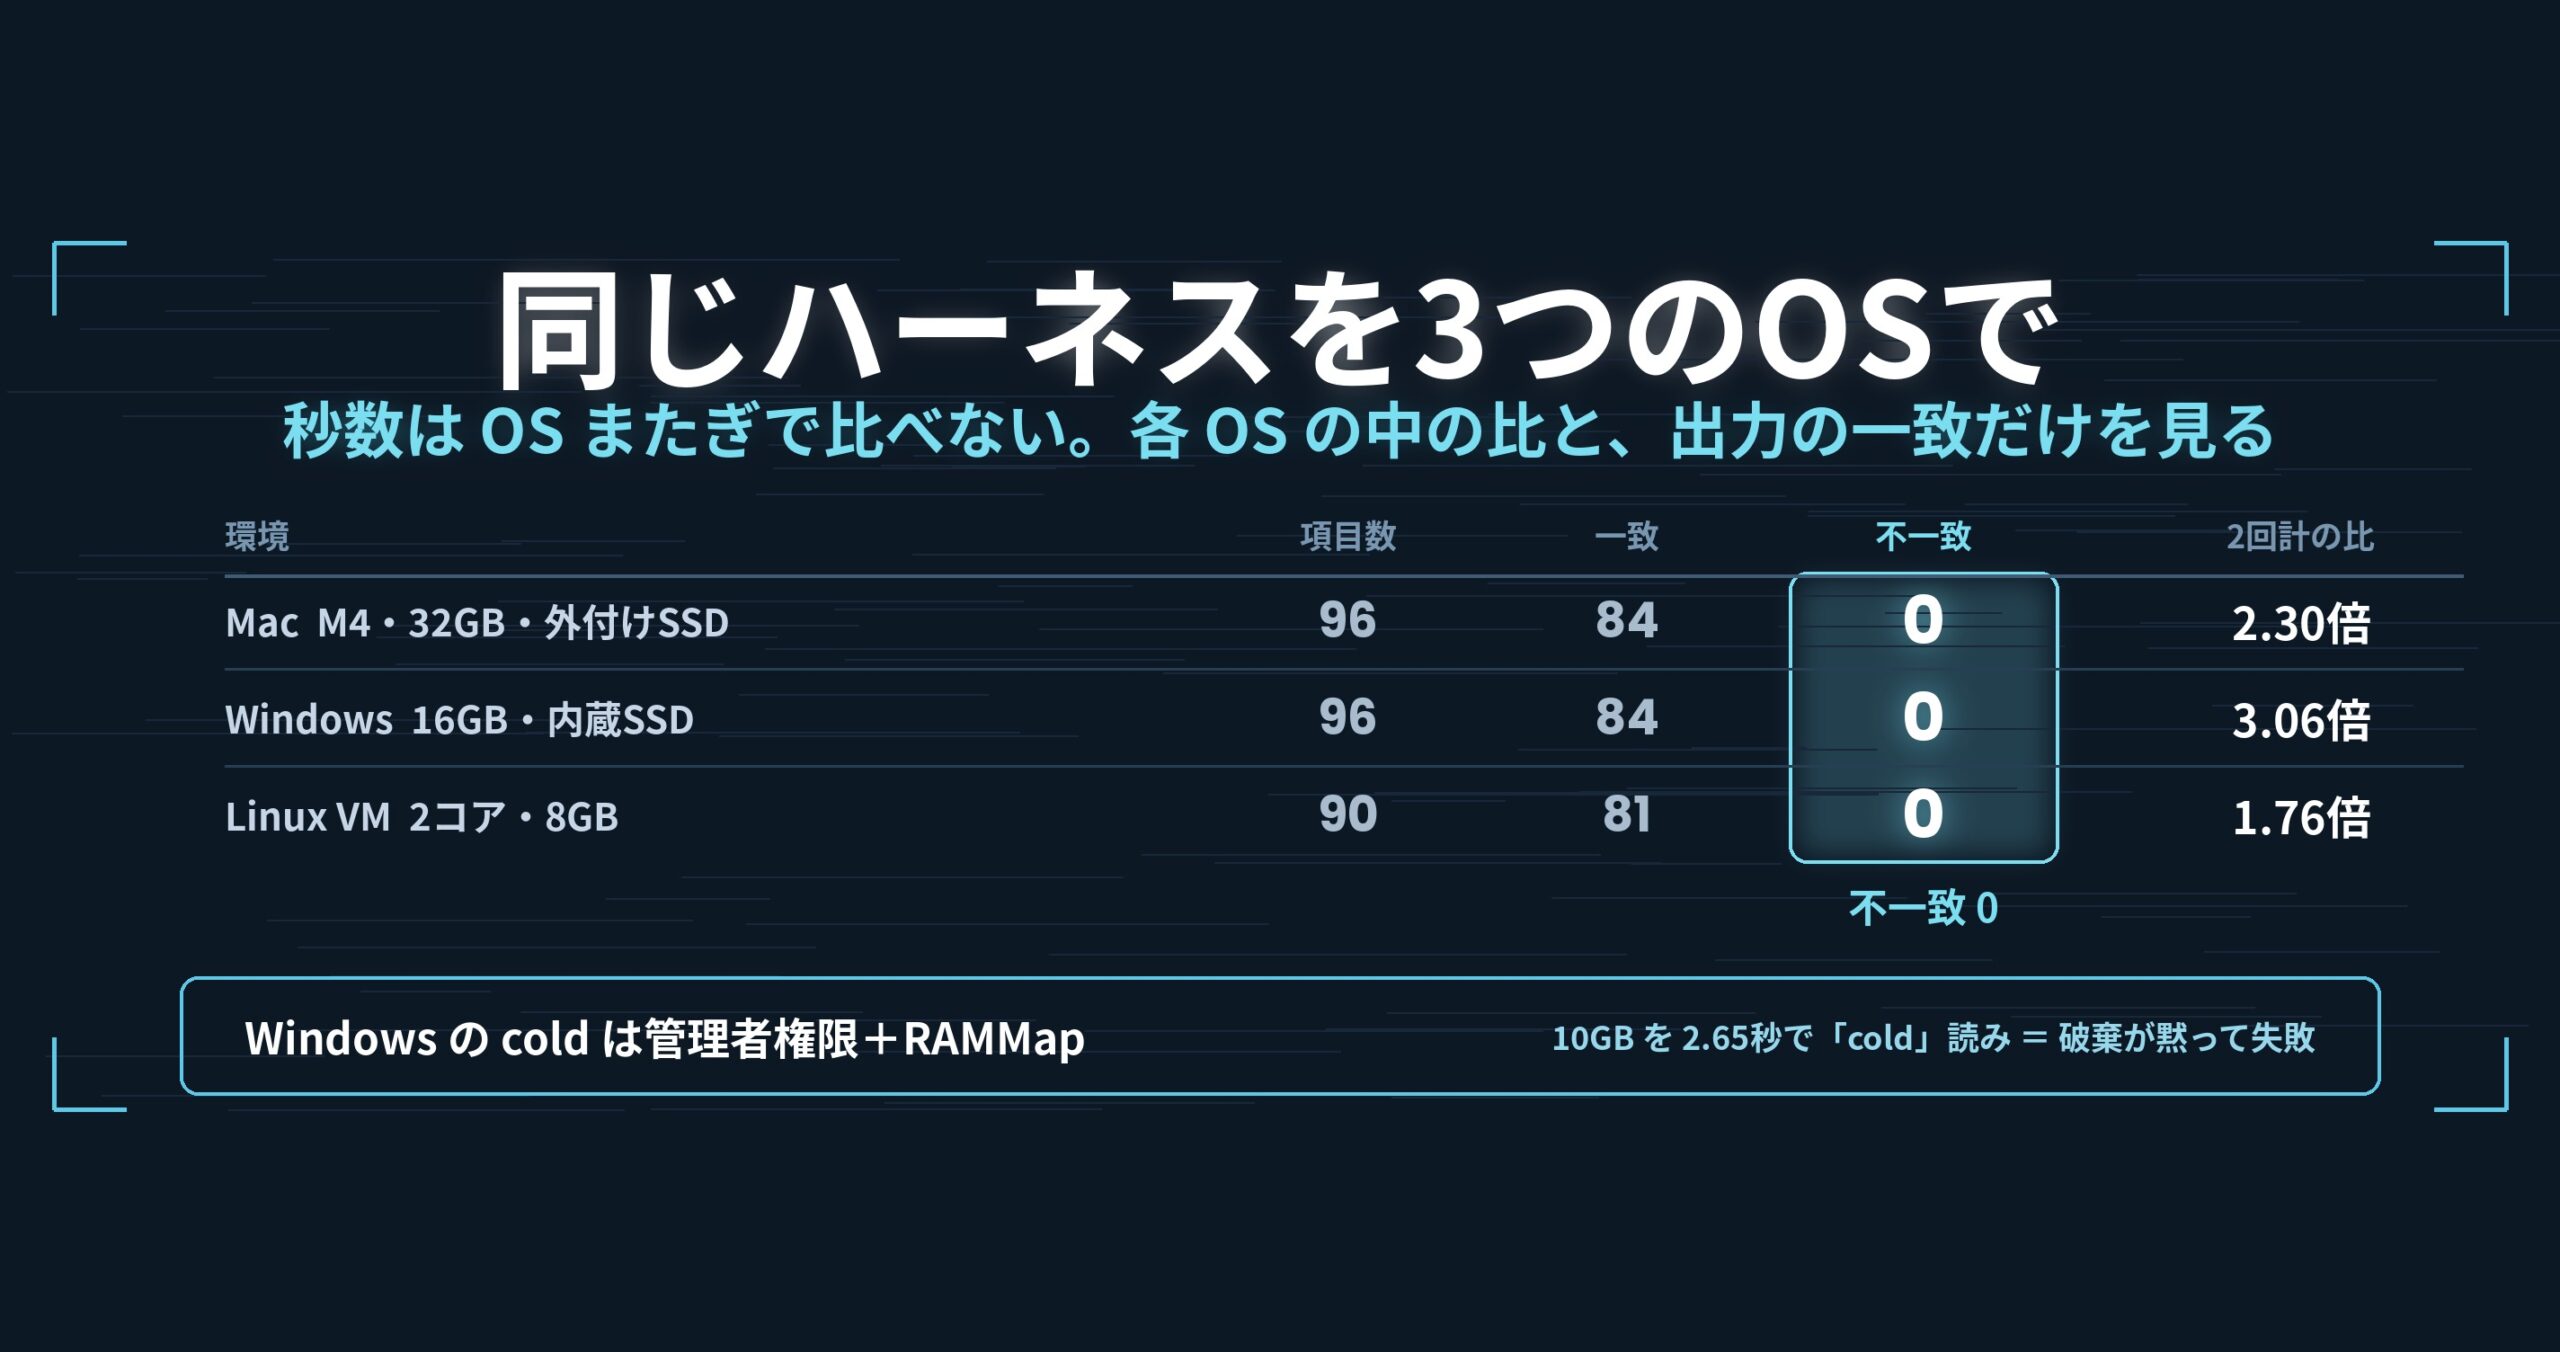
この記事の結論「改行を速く数えても、秒数は動かない」は、ディスクから読む1回目(cold)については今も正しいです。一方、ファイルが OS のキャッシュに載った2回目(hot)では、行番号のために改行を数える時間が検索全体の4割を占めていました(3GB で 0.38秒のうち 0.15秒)。v1.7.3.6.9 で 16バイトずつまとめて数える形にすると(3GB で 0.028秒)、2回目の素の検索は ripgrep より少し速くなりました(3GB 0.29秒 対 0.31秒、10GB 0.88秒 対 0.97秒。どちらも 1.5倍未満で同等の範囲)。詳しくは Wide Field⑫ 「秒に出ない」と書いた改行の数え方が、2回目の検索の4割を占めていました。本文は書いたときのまま残しています。
数えるのは、速くなりました。
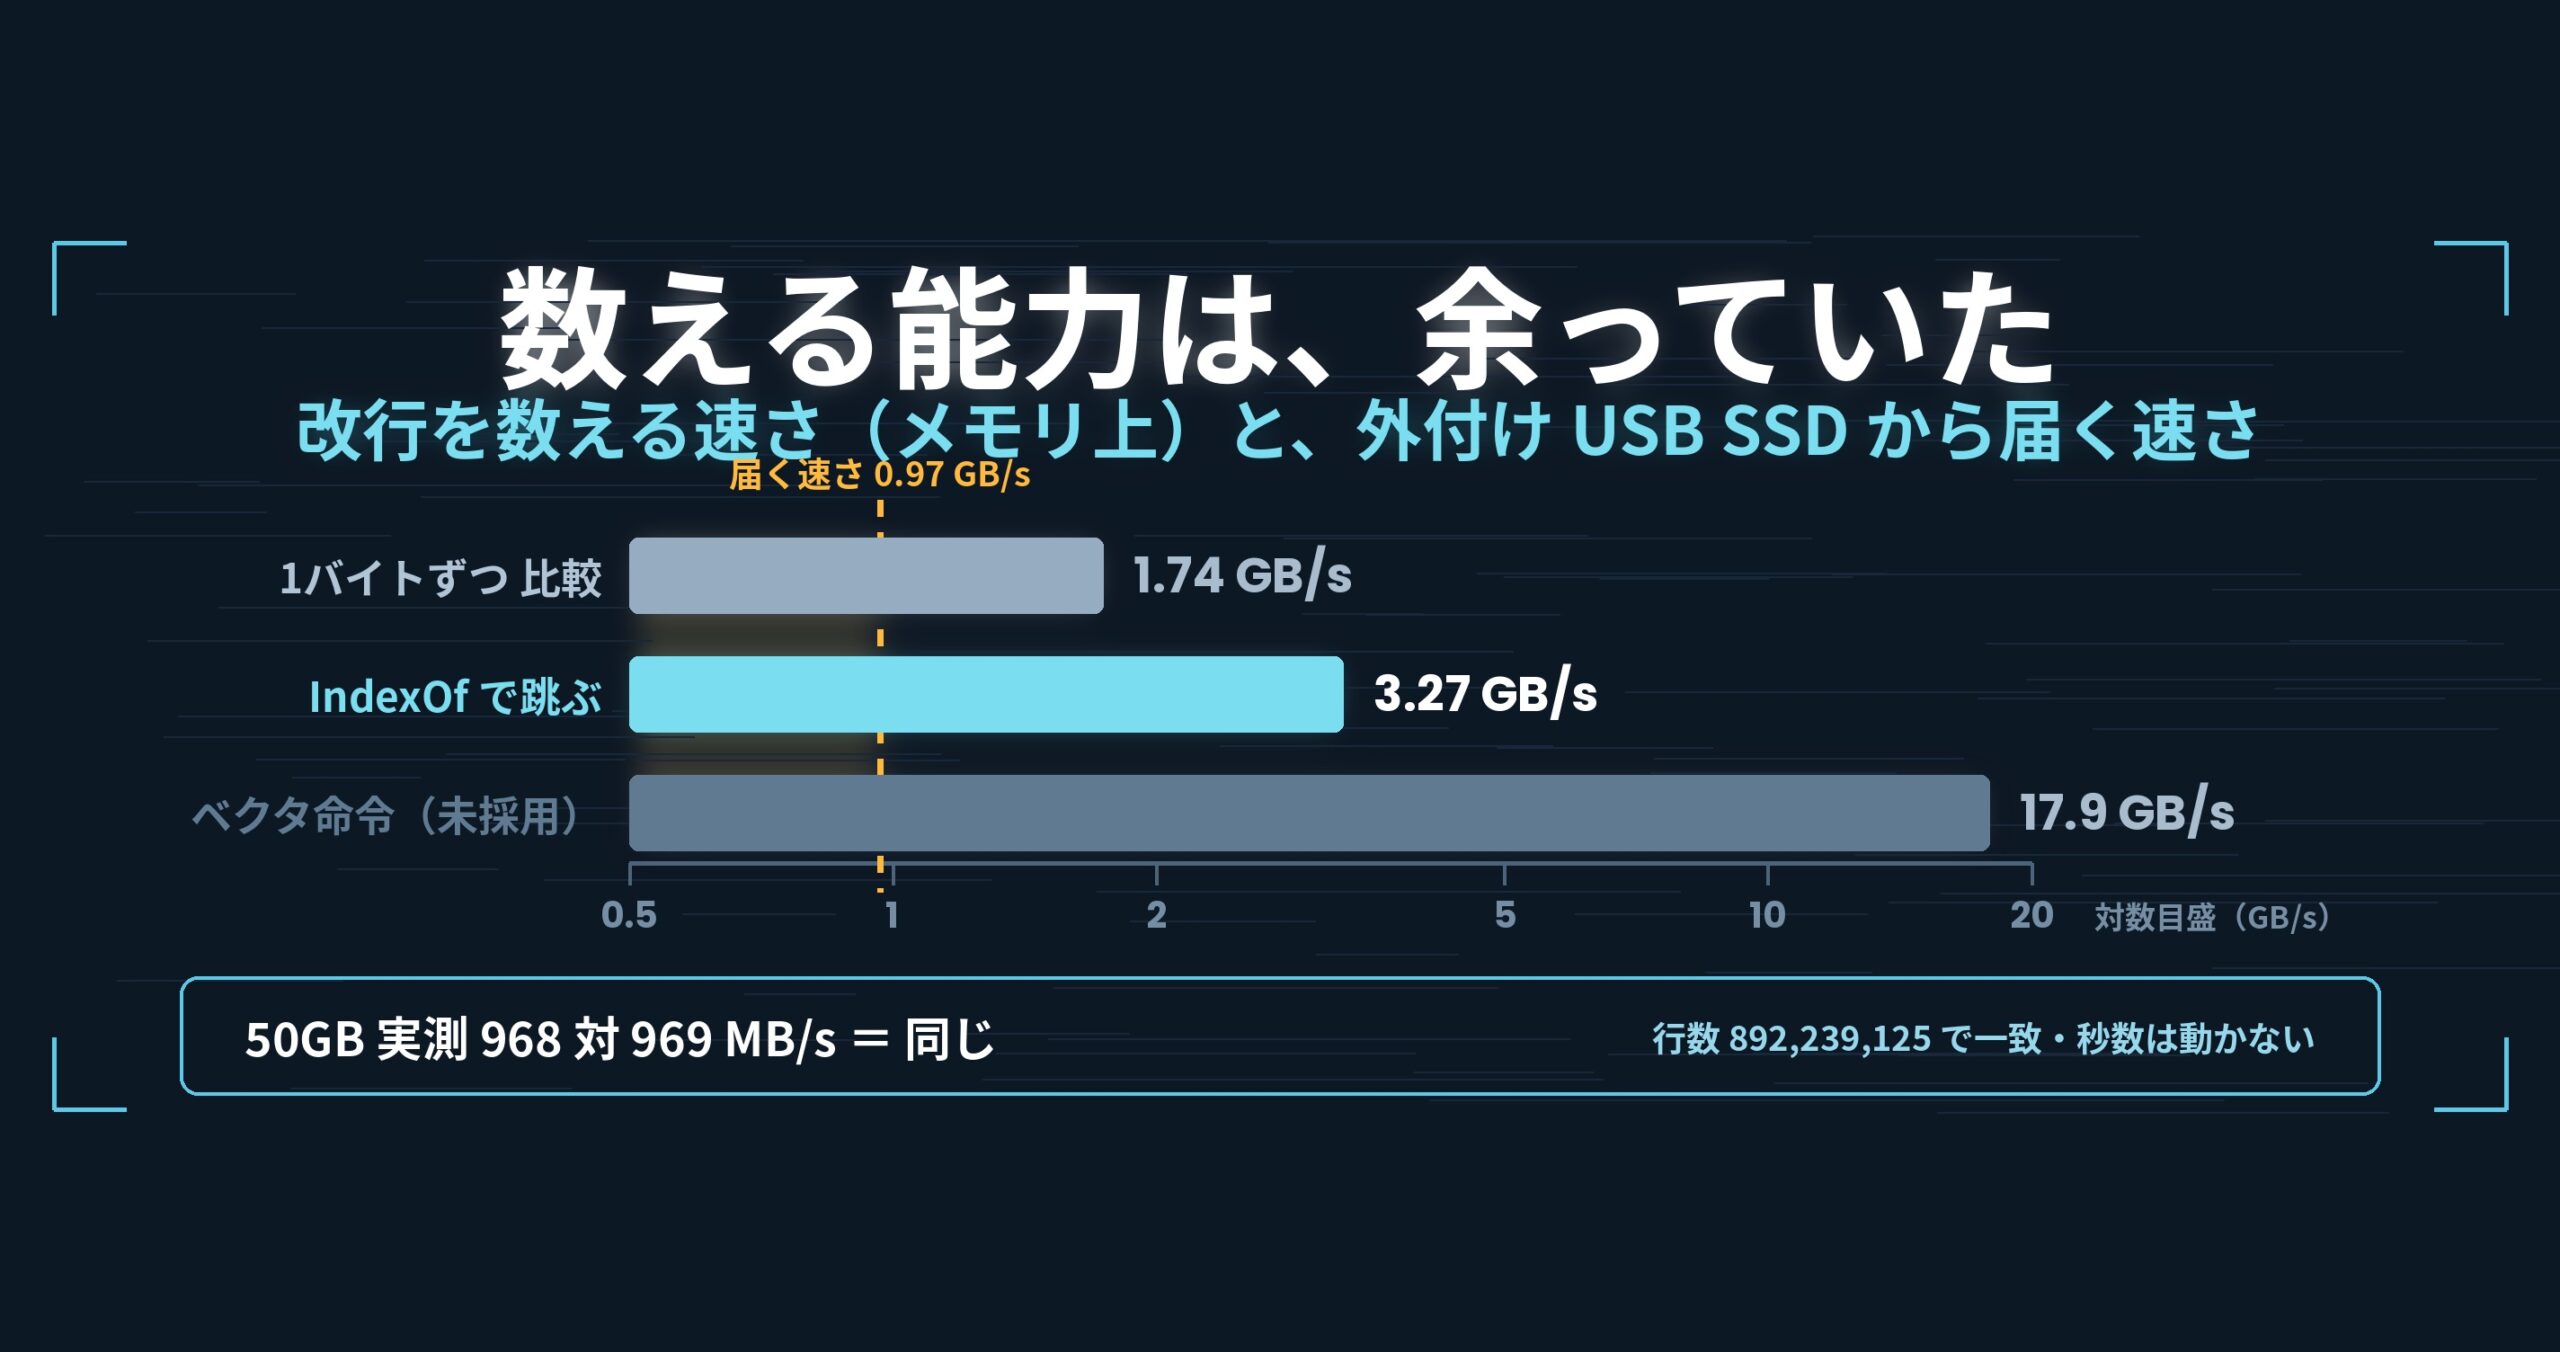
1バイトずつ == '\n' と比べていたところを、まとめて跳ぶ書き方に替えました。メモリの上で測ると 1.74GB/s が 3.27GB/s。1.88倍です。
それでも、ファイルを開く秒数は動きませんでした。この改修は、無駄だったのか。
- 先に結論: 改行の数え方を 1バイトずつから IndexOf に替えて、メモリ上では 1.74GB/s → 3.27GB/s(1.88倍)になりました。ところが外付け USB SSD 上の 50GB を実際に数えると、どちらも 968〜969MB/s で同じです(行数はどちらも 892,239,125 行で一致)。つまりこの回の変更だけでは秒数は動いていません。索引作成が 486MB/s → 969MB/s になった主因は、前回(第 10 回)の mmap → pread であって、この SIMD 化ではありません。それでも入れたのは、媒体が速くなったときに初めて効く「準備」だからです。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML。詳細は記事末尾。
- 問題: 改行を数えるのが、いちばん地味で、いちばん避けられない
- 原因を疑う前に、上限を測る
- 手当て: IndexOf で跳ぶ
- 数字: ディスクからは、どちらも 968MB/s
- では、なぜ入れたのか
- 正直に書いておくこと
- 持ち帰れる一般論: 律速を先に測らないと、努力の向き先が決まらない
- 使っている道具
- リンク
先に結論: 改行の数え方を 1バイトずつから IndexOf に替えて、メモリ上では 1.74GB/s → 3.27GB/s(1.88倍)になりました。ところが外付け USB SSD 上の 50GB を実際に数えると、どちらも 968〜969MB/s で同じです(行数はどちらも 892,239,125 行で一致)。つまりこの回の変更だけでは秒数は動いていません。索引作成が 486MB/s → 969MB/s になった主因は、前回(第 10 回)の mmap → pread であって、この SIMD 化ではありません。それでも入れたのは、媒体が速くなったときに初めて効く「準備」だからです。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML。詳細は記事末尾。
この記事は「First Light」連載の第 11 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
問題: 改行を数えるのが、いちばん地味で、いちばん避けられない
巨大なテキストを画面で扱うには、「何行目がファイルの何バイト目から始まるか」の目印が要ります。9億行の目印を全部持つと巨大になるので、一定行ごとに間引いて持ちます。
その目印を作るには、結局ファイルを通しで読んで \n を数えるしかありません。中身の意味は一切使わない、ただ 1種類のバイトを探すだけの仕事です。
v1.6.0 のコードは、いちばん素直な形で書かれていました。
for (int i = 0; i < span.Length; i++)
    if (span[i] == (byte)'\n') { /* 位置を控える */ }
これが遅いのではないか、という疑いは早くからありました。50GB あれば 512 億回ループします。1回あたり数命令でも、積めば効くはずです。
原因を疑う前に、上限を測る
前回(第 10 回)で書いたとおり、この手の疑いは先に上限を測ってからでないと意味がありません。そこで、ディスクを一切使わずに、メモリに載せたバッファに対して 3 通りの数え方を測りました。
| 数え方 | メモリ上の速度 |
|---|---|
1 バイトずつ == '\n' |
1.74 GB/s |
Span.IndexOf で次の \n まで跳ぶ |
3.27 GB/s |
| ベクタ命令(SIMD)で 1 度に比べる | 17.9 GB/s |
差は、はっきり出ました。IndexOf で 1.88倍、ベクタなら 10倍です。
ここで 1つ、事前の見積りが外れています。もともと社内のメモに「1バイトずつの走査は 1GB/s で頭打ち」と書いてありました。実際は 1.74GB/s で、思っていたより速い。素直なループを遅いと決めつけていたわけです。
とはいえ 1.88倍の差はあります。では、その 1.88倍は秒数のどこに出るのか。
手当て: IndexOf で跳ぶ
SparseLineIndex の走査を Span.IndexOf に替えました(commit 64f80c7)。読み出しのブロックも 1MB から 4MB に広げています。
IndexOf が速い理由は、1バイトずつ比べるのをやめて、16バイトなり 32バイトなりをまとめて比較し、見つかった位置だけを取り出すからです。\n は行の中にただ 1つしかないので、次の \n までの数十バイトは「比べる」のではなく「跳ばす」ことができます。やらない仕事を増やすのが高速化という、よくある形です。
書き換え自体は数行です。難しいのは、ここから先でした。
数字: ディスクからは、どちらも 968MB/s
同じ 3通りの数え方で、今度は外付け USB SSD 上の 50GB のファイルを通しで数えました。
| 数え方 | 50GB のファイルに対して | 数えた行数 |
|---|---|---|
| 1 バイトずつ | 968 MB/s | 892,239,125 |
IndexOf |
969 MB/s | 892,239,125 |
1.88倍の差が、消えました。 968 と 969 です。誤差の幅にも届きません。
理由は単純です。pread で 4MB ずつ読んだときの実効レートが 966〜968MB/s(第 10 回)。つまりバイトが手元に届く速さが 0.97GB/s 程度しかありません。片方は 1.74GB/s で数えられ、もう片方は 3.27GB/s で数えられる——どちらも、届く速さより速い。余った能力は、待ち時間になるだけです。
数えた行数が完全に一致しているのは、別の意味で重要です。速さを変える書き換えで結果が変わっていないことの確認になります。9億行で 1行もずれていません。
では、索引作成が 486 → 969MB/s になったのは何のおかげか
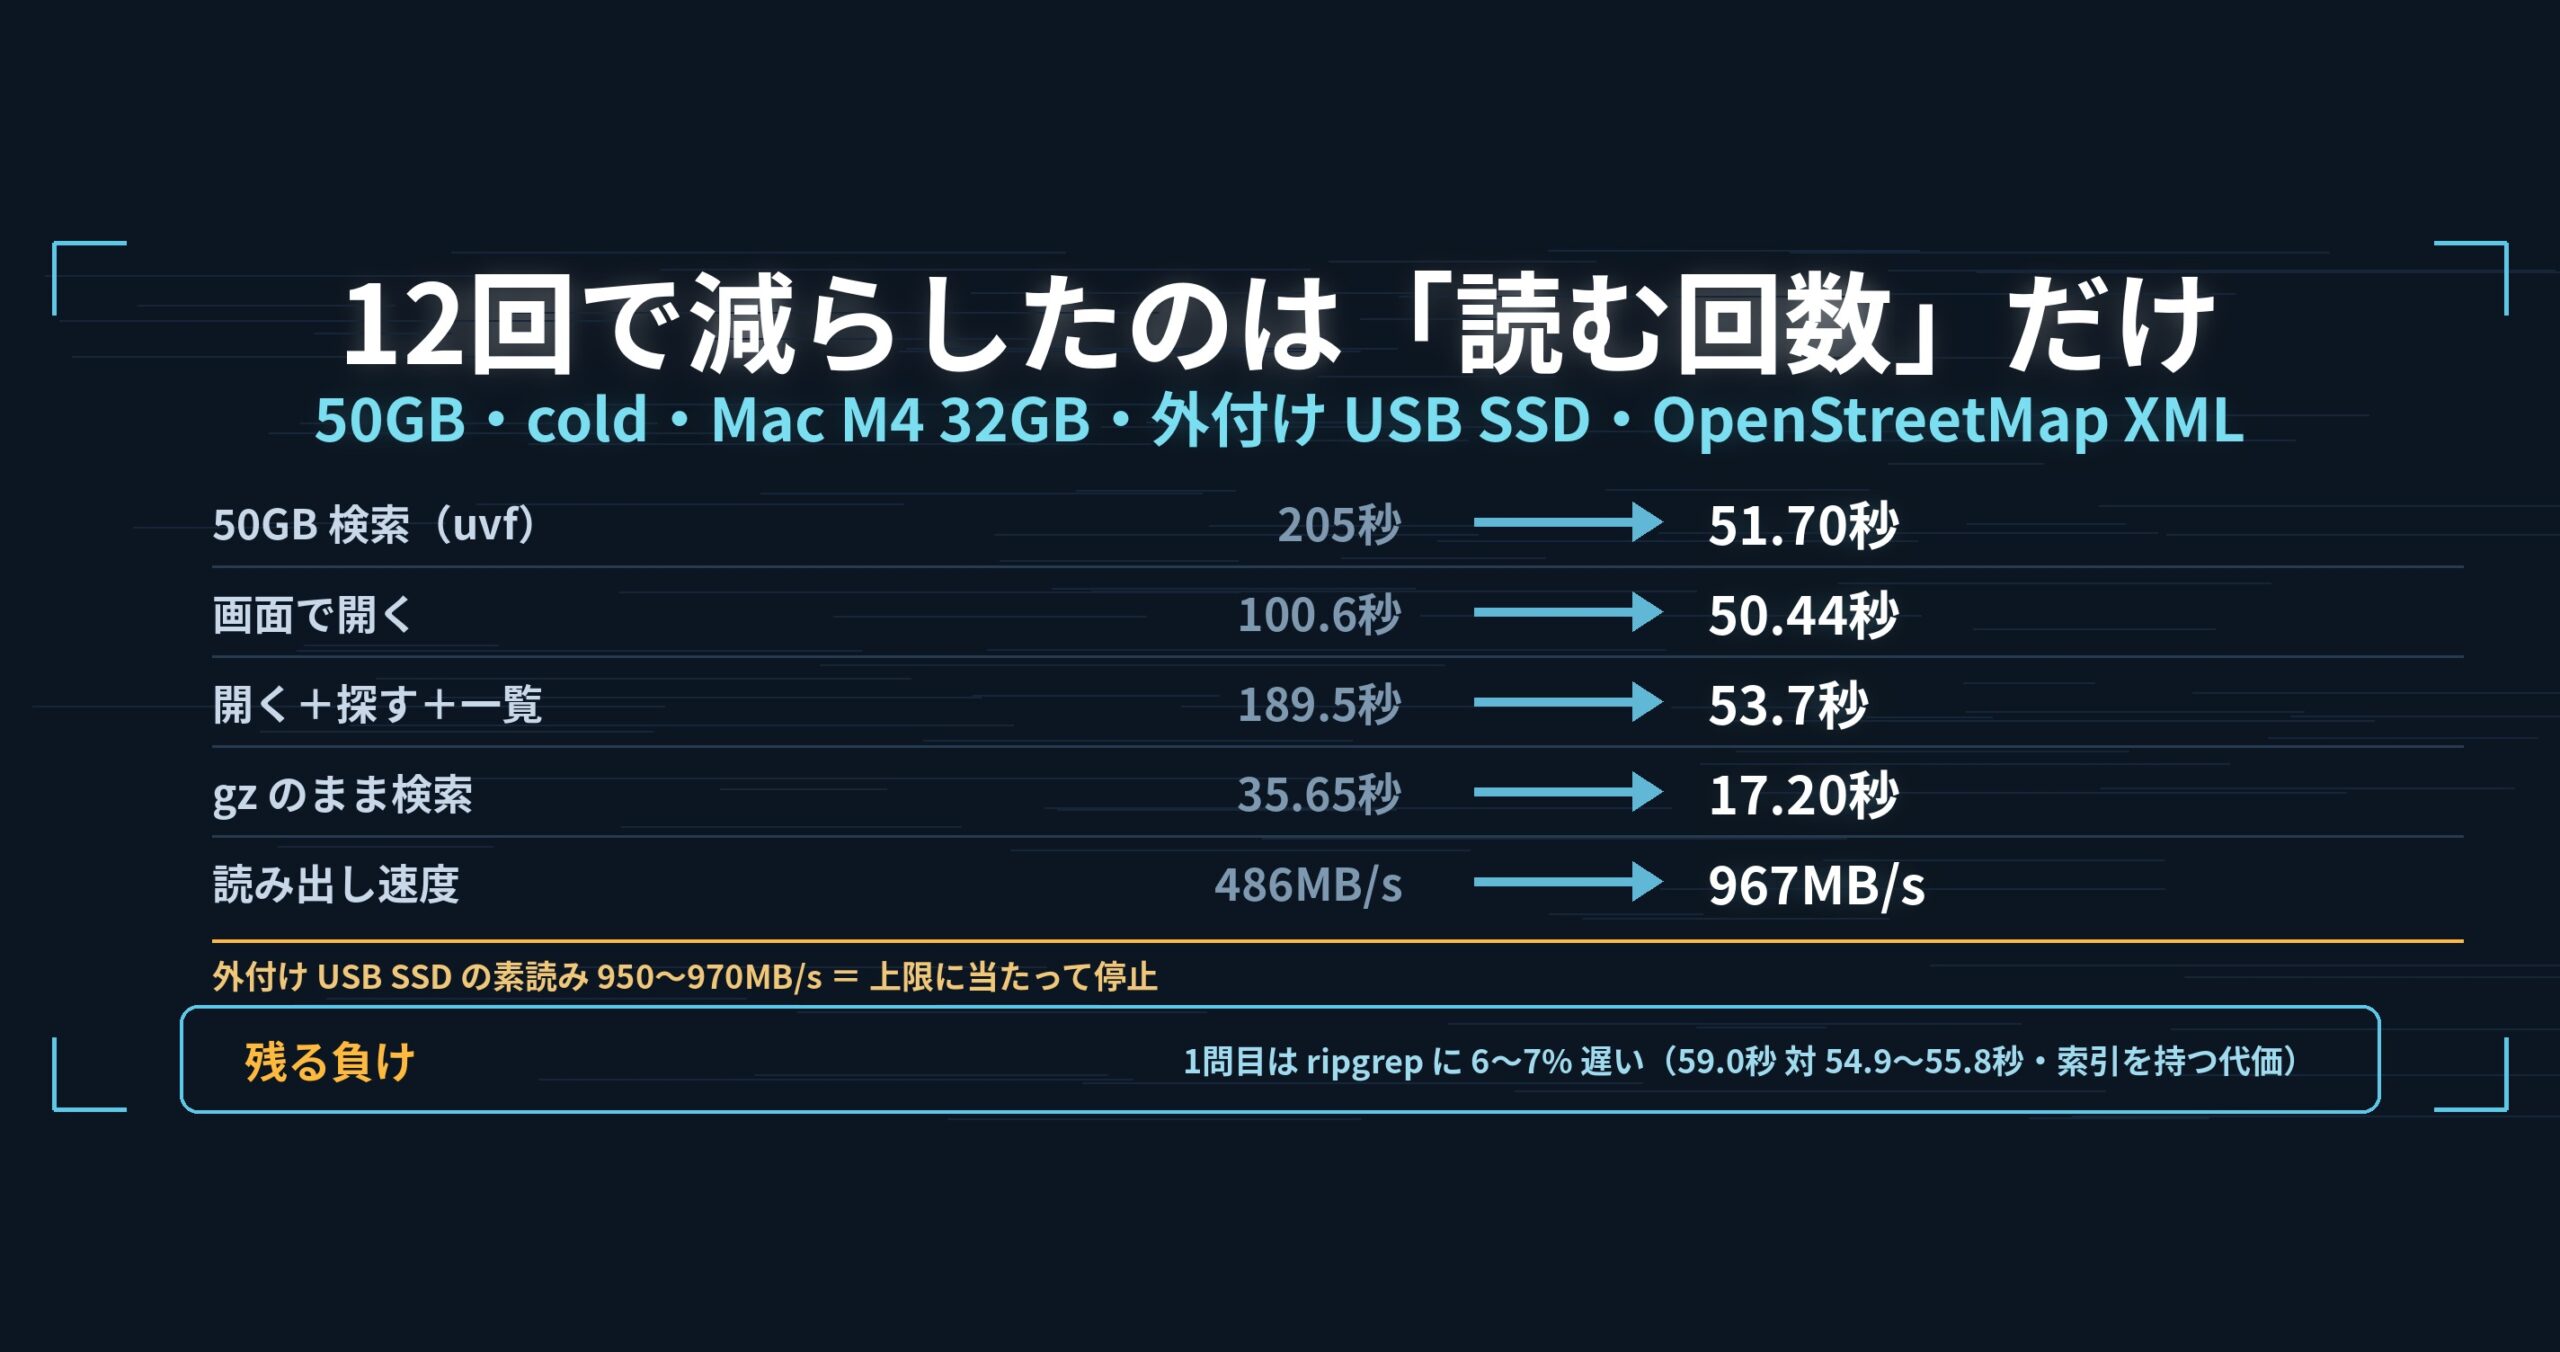
50GB を開く時間は 100.6秒(486MB/s)から 50.44秒(969MB/s)になりました。この 1.99倍を、SIMD 化の成果として書きたくなります。
書けません。 上の実測が、書けない理由そのものです。ディスクから読む限り 1バイトずつでも 968MB/s 出るのだから、486MB/s だった原因は数え方ではありません。mmap で読んでいたこと(上限 551MB/s)と、その上限よりさらに下にいた分です。主因は前回の mmap → pread でした。
この切り分けを間違えると、次に同じ問題が起きたときにまた数え方を磨いてしまいます。改善の成果を正しい原因に帰属させることは、記事の誠実さのためだけではなく、次に何を直すかを間違えないための作業です。
では、なぜ入れたのか
秒数が動かない変更を、それでも入れて出荷しました。理由は 2つあります。
(1)媒体は速くなるから。 外付け USB SSD で 0.97GB/s、内蔵の NVMe なら数 GB/s の世界です。届く速さが 2GB/s を超えた時点で、1バイトずつの 1.74GB/s は律速に変わります。そのとき IndexOf の 3.27GB/s なら、まだ余裕があります。
言い換えると、いまの計測では見えない差が、機材が変わると見える差になります。第 9 回で「1.5倍未満を差と呼ばない」と決めましたが、これは条件が固定されているときの話です。条件のほうが動く見込みがあるなら、いま差に見えないものにも意味があります。
(2)CPU 側の余裕は、別の仕事に使えるから。 読み出しを待っている間、CPU は暇です。その暇を使って、通しで読むついでに何を数えておくか——第 6 回で書いた「行番号の索引をついでに作る」も、第 2 回の「数える・探す・書くを 1パスに畳む」も、同じ枠を使っています。1つの処理を軽くすることは、その枠を他に回せるようにすることでもあります。
正直に書くと、ベクタ命令の 17.9GB/s までは入れていません。IndexOf で十分に余裕があり、いまの媒体では 3.27 と 17.9 の区別がつかないからです。区別がつく機材を手に入れてから考えます。
正直に書いておくこと
- この回に、秒数の改善はありません。 50GB では 968 対 969MB/s で同じです。連載の中で唯一、数字が動かなかった回です
- 10GB のファイルで測ったときは 1,026MB/s という値が出ています。50GB の 969MB/s より速いのですが、10GB はメモリ 32GB の機械なので一部がキャッシュに残ります。50GB(メモリの 1.6倍)とは条件が違うので、この 2つを並べて比べることはできません
- メモリ上の 3 値(1.74/3.27/17.9 GB/s)はディスクを使わない測定です。実運用の秒数ではなく、能力の上限を見るための数字です
- 「1バイトずつは 1GB/s で頭打ち」という以前のメモは、この機械では再現しませんでした(1.74GB/s)。古い見積りを根拠に使わない、という反省がこの回にあります
- 媒体が速い環境で
IndexOfが効くはずだ、というのは予測であって実測ではありません。内蔵 NVMe での再測定はまだしていません - 数字はすべて Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML(51,254,526,392 バイト)での測定例です。秒数を OS またぎで比べていません
- 私は自分の製品について書いています。その分は割り引いてお読みください
持ち帰れる一般論: 律速を先に測らないと、努力の向き先が決まらない
(1)「速くなった」は、どこで測ったかで意味が変わります。 メモリの上では 1.88倍、ディスクからは 1.00倍。同じ変更、同じ機械、同じ日の測定です。どちらも本当で、どちらを書くかは書き手が決めてしまえます。だから両方書くのがいちばん誠実だと思っています。
(2)成果の帰属を間違えないこと。 索引作成が 2倍速くなった事実と、SIMD 化を入れた事実が同じ版に入っていると、片方をもう片方の原因にしたくなります。時間的に近いことは原因ではありません。 切り分けるには、変更を 1つずつ分けて測るしかありませんでした。
(3)いま効かない改善を入れてよい条件は、「何が変われば効くか」を言えることです。 この回は「届く速さが 2GB/s を超えたら」と言えます。言えないなら、それは単なる好みの書き換えです。効く条件を書いて出荷すると、将来それを検証できます。
(4)結果の一致を必ず確かめる。 速くするための書き換えでいちばん怖いのは、速くなって答えが変わることです。9億行の行数が 1行もずれないことを、毎回突き合わせています。速さの比較より先に、同じ答えが出ているかを見ます。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
行を数える仕事は、コマンド側からも同じように叩けます。
# 総行数だけを知る(通しで1回読む)
/usr/bin/time -p uvf huge.log -lines

# 件数だけ(ヒット行の本文は持たない)
uvf huge.log 'ERROR' -count

# 媒体の素の帯域と比べてみる
dd if=huge.log of=/dev/null bs=4m count=5000

# 同じ答えが出ているかを先に確かめる
uvf huge.log 'ERROR' -out mine.txt
rg 'ERROR' huge.log > theirs.txt
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
正直に書くと、1問目は uvp が ripgrep より少し遅くなります——.uwvz(uvp 用の圧縮形式+索引)を先に作るぶんで、50GB なら 59.0秒 対 54.9〜55.8秒=6〜7%(v1.6.6.1)。効いてくるのは 2問目からで、同じ 50GB の検索が 6.56秒、ripgrep に対して 8.4倍速くなります。3GB のような小さいファイルでは同等です。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 2 回: 2回半読んでいたコマンドを1回にした話: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 6 回: 通しで読むついでに行番号の索引を作る: https://uvp.y42u.net/blog/uwview-fl06-cli-to-gui-handoff/
- 第 7 回: 効かないはずの相手に同じ変更を入れて確かめる: https://uvp.y42u.net/blog/uwview-fl07-3gb-fixed-cost/
- 第 9 回: どこからを「差」と呼ぶかの基準: https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。