2分半、待ちました。
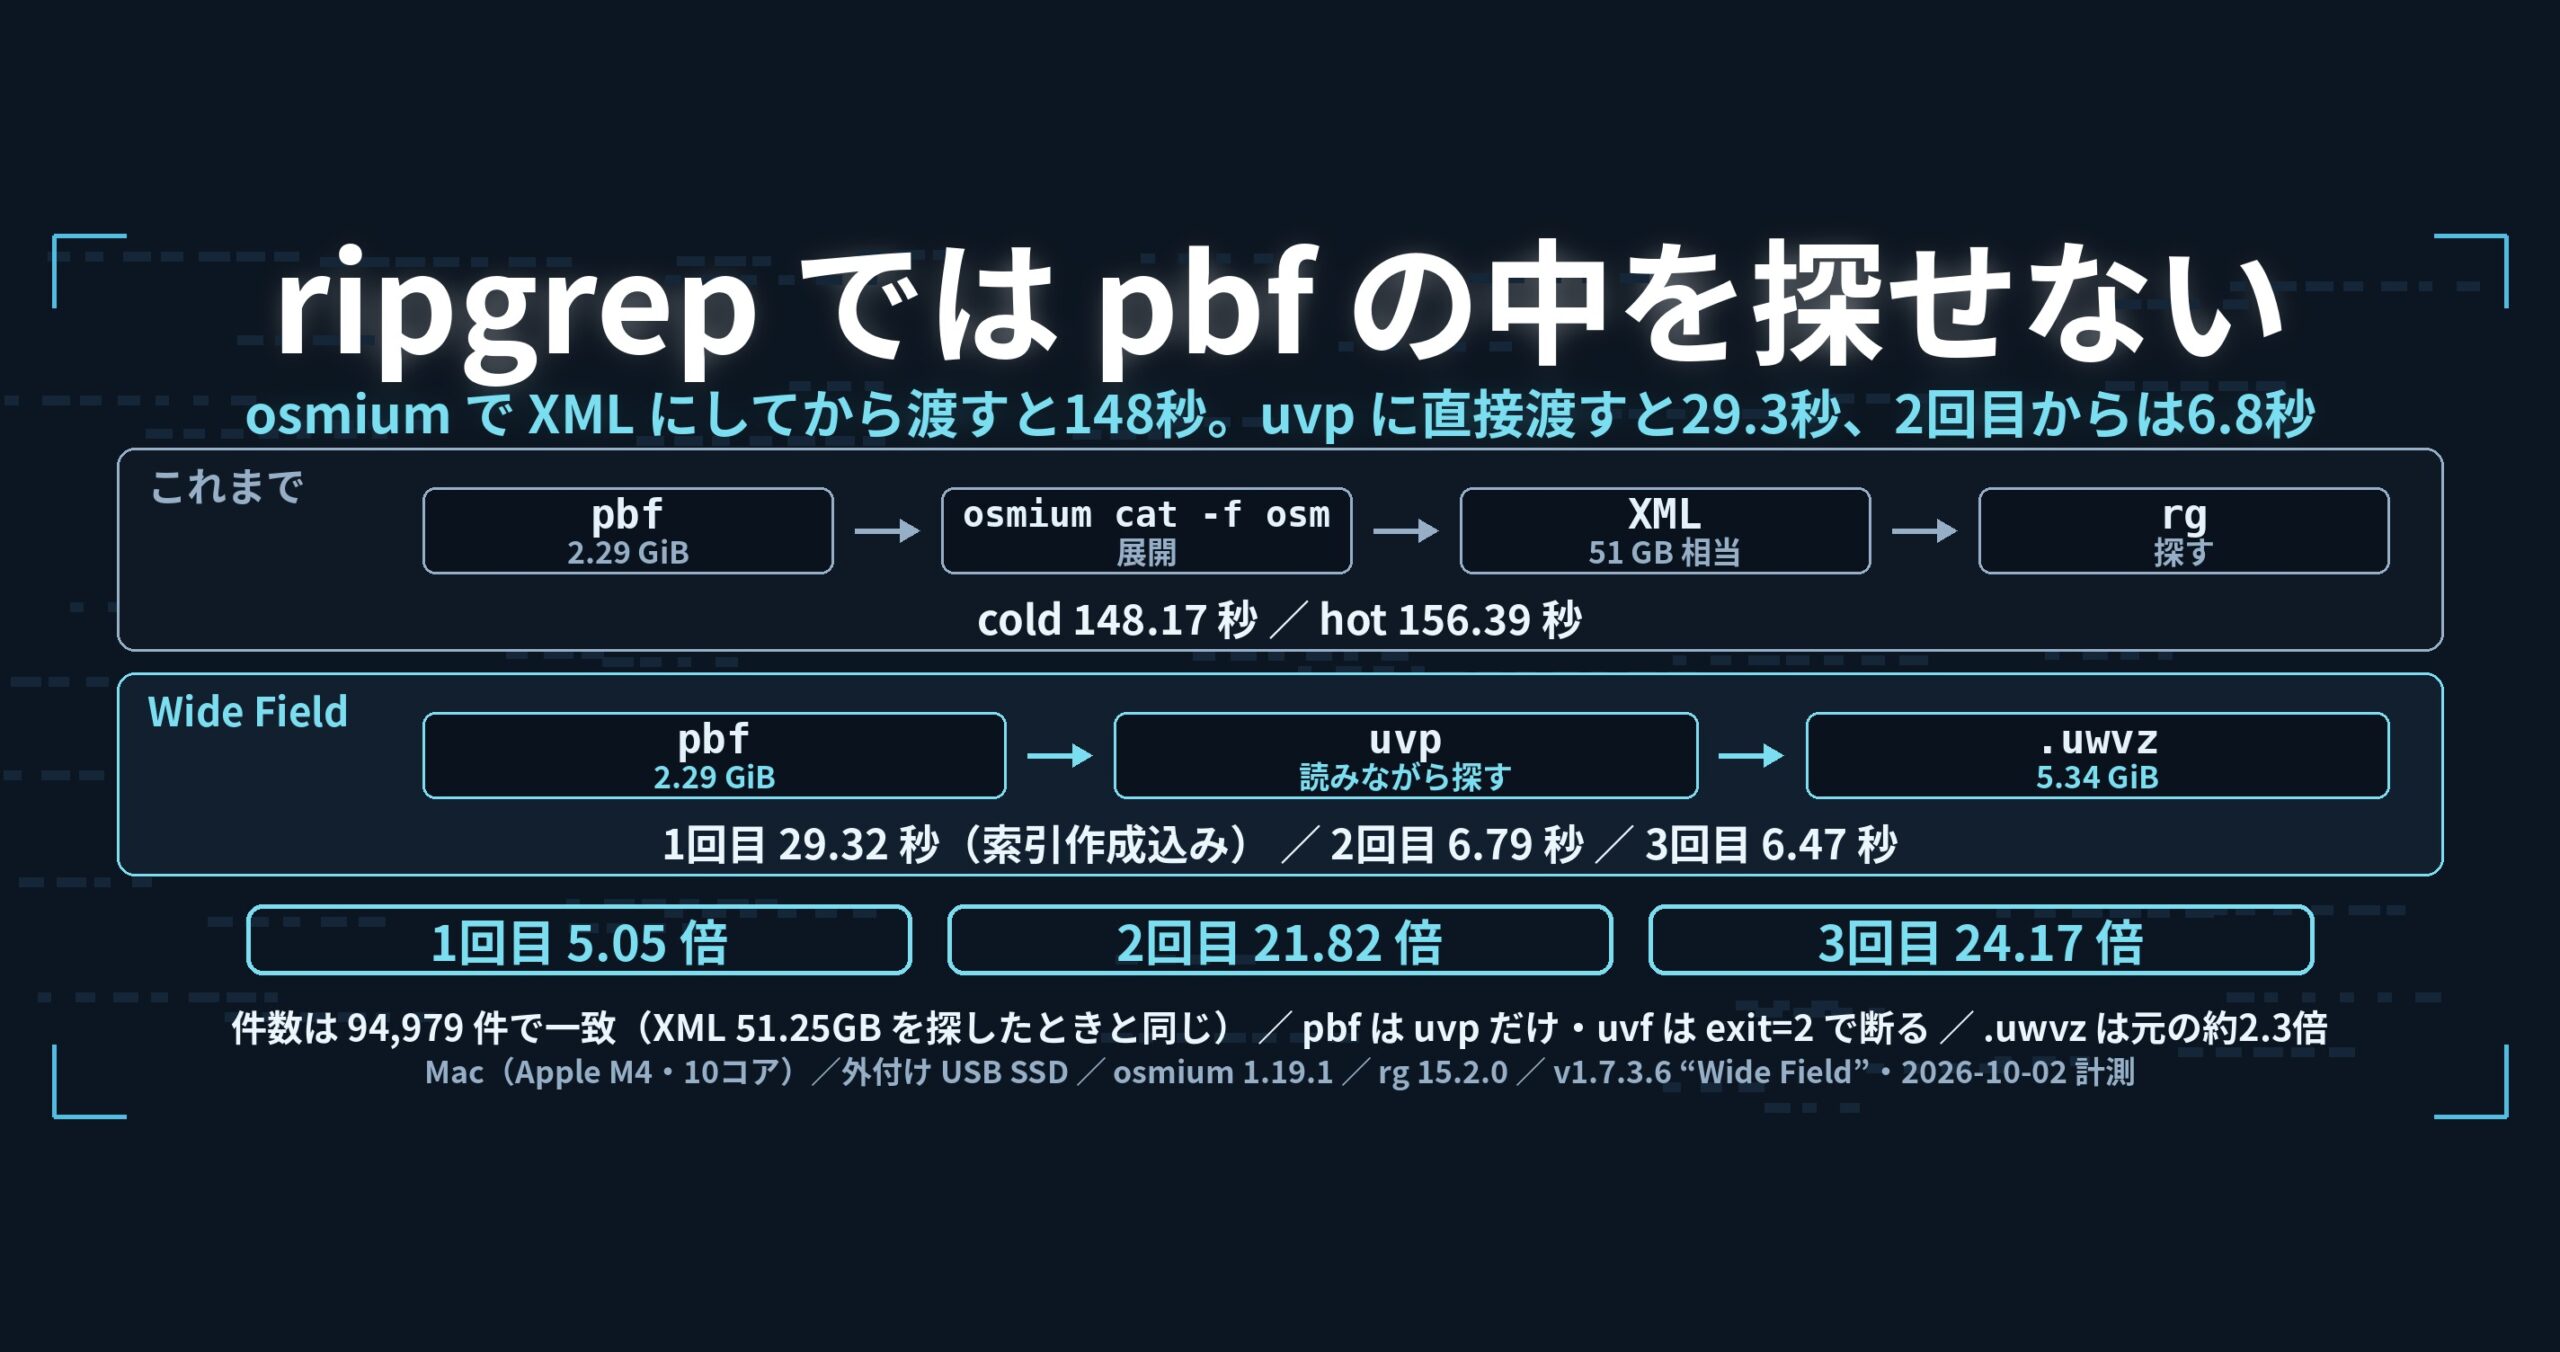
osmium cat で OpenStreetMap の pbf を XML に展開し、rg に流す。これで1回の検索に148秒です。pbf は地図データの圧縮形式なので、rg にそのまま渡しても中身は見えません。
展開しないと探せない、というのは本当でしょうか。
- 先に結論: uvp は pbf を直接読みます。osmium cat … -f osm | rg が cold 148.17秒・hot 156.39秒かかるところ、uvp は 1回目(.uwvz 作成込み)29.32秒・2回目 6.79秒・3回目 6.47秒(5.05倍/21.82倍/24.17倍)。件数は 94,979件で一致。ただし pbf を読めるのは有料版の uvp だけで、無料版の uvf は名指しで断ります
- 先に、できないことと代価を書きます
- なぜ rg に渡せないのか
- 数字
- 「1バイトも違わない XML」を出す、と決めた
- protobuf を自前で読んだ理由
- 無料版が「断る」のも、設計のうち
- 確かめ方
- 持ち帰れる一般論
- 正直に書いておくこと
- 使っている道具
- リンク
先に結論: uvp は pbf を直接読みます。osmium cat … -f osm | rg が cold 148.17秒・hot 156.39秒かかるところ、uvp は 1回目(.uwvz 作成込み)29.32秒・2回目 6.79秒・3回目 6.47秒(5.05倍/21.82倍/24.17倍)。件数は 94,979件で一致。ただし pbf を読めるのは有料版の uvp だけで、無料版の uvf は名指しで断ります
対象は japan-latest.osm.pbf 2.29GiB(node 3億1,227万・way 4,469万・relation 22万)。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD、相手は osmium 1.19.1 と ripgrep 15.2.0。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。pbf 対応は v1.7.6 相当の実装で、この記事の秒数は v1.7.3.6 の実物を2026年10月2日に測った値です。
先に、できないことと代価を書きます
この回は速さで負けている項目がありません。なので、負けの代わりに限界を先に並べます。
- 無料版では読めません。 pbf を扱えるのは
uvpだけです。uvfに渡すと、テキストとして走査して「1件も無い」と答えるのではなく、名指しで断って終了コード2で終わります。 .uwvzの置き場所が要ります。 できあがりは 5.34GiB。元の pbf 2.29GiB の約2.3倍です。圧縮形式を読んで、索引つきの別の圧縮形式に書き直しているので、元より大きくなります。- pbf には戻せません。
-extractが出すのは中身の XML(<名前>.osm)です。要素の並べ替えと文字列表の作り直しが要るので、pbf として書き戻すことはしていません。そして先にそう言うようにしました。.pbfという名前で XML を書いて「開けないファイル」を作るほうが悪いからです。 - 相手は ripgrep 単体ではありません。
rgは pbf を読まないので、比べているのはosmium catとの組み合わせです。つまりこれは「同じ土俵で速い」という話ではなく、土俵が1つ少なくて済むという話です。 - zlib 以外の blob は断ります。 pbf の中の圧縮は実物ではまず zlib ですが、lzma・lz4・bzip2 の blob もあり得ます。無理に対応せず、当たったときに名指しで断る形にしました。
なぜ rg に渡せないのか
pbf(.osm.pbf)は、OpenStreetMap のデータを protobuf で詰めたバイナリです。XML と同じ内容が、ずっと小さく入っています。実際、ここで使う 2.29GiB の pbf は、XML にすると 51GB 相当になります。
テキストではないので、rg で 東京 を探しても意味のある結果は出ません。だから、これまでは先に展開するのが普通の手順でした。
osmium cat japan-latest.osm.pbf -f osm | rg -n -F '東京'
osmium は OpenStreetMap のデータを扱う定番の道具です。-f osm で XML を標準出力に流し、それを rg が受けます。ファイルには書かないので、ディスクは要りません。
その代わり、毎回ぜんぶ展開します。
数字
キャッシュを捨てて10秒待ってから1回目(cold)、続けて2回目(hot)。相手は osmium 1.19.1 + ripgrep 15.2.0。
| 1回目 | 2回目 | 3回目 | 件数 | |
|---|---|---|---|---|
osmium cat … -f osm \| rg |
148.17秒(cold) | 156.39秒(hot) | — | 94,979 |
uvp japan-latest.osm.pbf 東京 |
29.32秒(.uwvz 作成込み) |
6.79秒(再利用・cold) | 6.47秒(hot) | 94,979 |
| 倍率 | 5.05倍 | 21.82倍 | 24.17倍 | 一致 |
※ファイル容量の表記について:pbf は 2.29GiB(バイト÷1024³)で、macOS の容量表示(SI・÷1000³)では 2.46GB です。中身を XML にすると、過去記事で「48GB」「51.25GB」と書いている
japan-latest.osm(51,254,526,392バイト)と同じ内容になります。
94,979件は、XML 51.25GB を探したときの件数と一致します。入力の形が変わっても答えが変わらないことを、ここで確かめています。
相手は、2回目のほうが遅い
表の2行目に注目してください。osmium cat | rg は cold 148.17秒 → hot 156.39秒で、温まったほうが遅くなっています。
ディスクの読み込みが律速なら、2回目はキャッシュが効いて速くなるはずです。そうならないのは、時間のほとんどが展開と XML の組み立てに使われているからです。2.29GiB を読む時間は、51GB 分の XML を作る時間に比べれば小さい。読み直しの節約が効く場所が、そもそも無いわけです。
同じことは、First Light の第8回で gz を調べたときにも出ました。展開が律速のとき、cold と hot はほとんど同じになります。ここではわずかに逆転していますが、これは測定の揺れの範囲と見ています。
1回で済ませるなら、どこを見るか
uvp の1回目(29.32秒)には .uwvz を作る時間が入っています。1回しか探さないなら、比べるのはこの29.32秒と相手の148.17秒です。それでも5.05倍。
2回目以降が21.82倍・24.17倍になるのは、.uwvz(uvp 用の圧縮形式+索引)を読んでいるからで、読む量そのものが違います。
この値は、9月28日に別の版(1.7.3.5)で測った①27.34秒・②6.43秒・③5.01秒とも大きくずれていません。
「1バイトも違わない XML」を出す、と決めた
pbf から XML を作るとき、形には幅があります。属性の順番、空白の入れ方、どこで改行するか——どれも「だいたい同じ」で済ませられます。
済ませませんでした。出す XML は、osmium の XML 出力と1バイトも同じ(generator 属性だけが uvp)にしています。
理由は、これまでの実測と記事が全部その形に対するものだからです。51.25GB の XML を探して 94,979件。pbf から探しても 94,979件。この2つを並べて「一致した」と言うには、途中の形まで同じでなければ意味がありません。「だいたい同じ」では、件数が合ったときに運なのか正しいのか分かりません。
確かめ方は単純で、osmium が出した XML と cmp で突き合わせるだけです。小さな実物(東京・127 node)はテストに入れて毎回照合し、6.94GB になる関東の pbf でも1バイトも違わないことを確かめています。
protobuf を自前で読んだ理由
pbf を読む部分は、外部のライブラリを足さずに自分で書きました。
protobuf のライブラリを入れれば速く済みます。それでもやらなかったのは、2つあります。
使う型が、数えるほどしかない。 OSM の pbf は仕様が小さく、読む必要があるメッセージは限られています。汎用の実装を抱え込む必要がありません。
読めない入力の断り方を、自分で決めたかった。 zlib 以外の blob、途中で切れたファイル、バージョンの違う header——こうしたものに当たったとき、何と言って止まるかは利用者の体験そのものです。ライブラリの例外をそのまま出すのではなく、何が起きたか・どうすればよいかを書いて止めるようにしています。
展開は blob 単位(約8,000要素のかたまり)で並列にしています。pbf の blob はそれぞれ独立に展開できるので、入力が1本でも CPU を使い切れる。1回目の29.32秒は、この並列があっての値です。
無料版が「断る」のも、設計のうち
uvf に pbf を渡すと、こう言って止まります。
uvf: japan-latest.osm.pbf は OSM の pbf です。UwView Pro(uvp)が扱います:
     uvp osm17/japan-latest.osm.pbf 語
終了コードは2です。
ここで黙って走査しないことが大事でした。テキストとして 東京 を探せば、pbf の中は圧縮されているので1件も見つかりません。そして「0件」は、正しい答えの顔をしています。利用者は「このデータには東京が無いのか」と受け取ってしまう。
見分けは名前ではなく、先頭の [長さ4バイト][BlobHeader("OSMHeader")] で行います。.pbf は protobuf 一般の名前でもあるので、拡張子では決められません。しかもこの判定は uvf と uvp で共有しています。無料版と有料版で「これは pbf か」の答えが食い違ったら、案内そのものが信用できなくなるからです。
確かめ方
- 相手: osmium 1.19.1(
osmium cat PBF -f osm)+ ripgrep 15.2.0(rg -n -F)。XML はファイルに出さず、パイプで流しています - 版:
uvf・uvpとも v1.7.3.6 “Wide Field” - データ:
japan-latest.osm.pbf2.29GiB(node 312,270,548/way 44,696,689/relation 226,670)。中身は XML 51.25GB と同じ - 測り方:
sync→ キャッシュ破棄 → 10秒待機 → 1回目 → 続けて2回目。uvpは.uwvzを消してから1回目を取り、2回目の前にもう一度キャッシュを捨てています - 機械: Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD
- 照合: 件数だけでなく、本文の集合(行番号を落として並べ替えたもの)で突き合わせて一致。一致しなければ倍率は出しません
- OS をまたいだ秒数の比較はしていません。この記事の数字はすべて Mac のものです
持ち帰れる一般論
(1)展開が律速のとき、キャッシュは効かない。 相手の2回目が1回目より遅かったのは、時間が「読む」ではなく「作る」に使われていたからです。どこが律速かを先に測らないと、キャッシュを足しても何も速くなりません。逆に言えば、律速が展開なら、展開の回数を減らす以外に手はありません。
(2)変換の形は、1バイト単位で決めておく。 「だいたい同じ XML」を出していたら、件数が一致しても、それが正しさの証拠になりません。あとで突き合わせたいなら、突き合わせられる形で出す。出力の形を決めるのは、速さではなく検証可能性の話です。
(3)読めない入力は、黙って0件にしない。 0件は正しい答えの顔をしています。走査して0件を返すより、名指しで断って終了コードを立てるほうが親切です。そして、その判定は無料版と有料版で共有しないと、案内が食い違います。
(4)土俵が1つ少ない、と正直に言う。 この回の5.05倍は「同じことを速くやった」数字ではありません。相手は展開してから探し、こちらは展開せずに探している。比較の意味が違うときは、倍率より先にそれを書くべきです。
正直に書いておくこと
- この記事に速さの負けはありません。代わりに、無料版では読めないこと・
.uwvzが元の約2.3倍(5.34GiB)になること・pbf には戻せないことが代価です - 相手は ripgrep 単体ではありません。
rgは pbf を読まないので、osmium catとの組み合わせと比べています。同じ土俵の比較ではありません - osmium の設定を詰め切れていない可能性は残ります。
osmium cat … -f osmの既定のまま測りました - 展開してファイルに出してから探す形は測っていません。51GB の XML をディスクに書く形は、空き容量の都合で測っていません
- 相手の hot が cold より遅かった件(148.17→156.39)は、展開が律速で読み直しの節約が効かないためと見ていますが、切り分けた計測はしていません
- 1回目の内訳(pbf→
.uwvzの変換と検索)を、この実行では分けて測っていません。9月28日の別の計測では変換21.6秒+検索5.61秒でした .uwvzの大きさ(5.34GiB)は pbf より大きくなります。保管の節約にはなりません。速く何度も探すための形です- zlib 以外の blob(lzma・lz4・bzip2)には対応していません。当たったら名指しで断ります
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと7つの圧縮形式、zip、そして OpenStreetMap の pbf を、外部のコマンドなしで探せます。
uvp ならこう書く
# pbf を直接探す。1回目に .uwvz を作り、2回目からはそれを読む(UwView Pro)
uvp japan-latest.osm.pbf '東京'

# 大文字小文字を区別しない/正規表現として
uvp japan-latest.osm.pbf 'TOKYO' -i
uvp japan-latest.osm.pbf 'k="name[^"]*"' -E

# 2語で絞る/前後3行つき
uvp japan-latest.osm.pbf k="amenity" v="parking"
uvp japan-latest.osm.pbf k="amenity" -C 3 k="name"

# 捕まえたところを数える
uvp japan-latest.osm.pbf 'k="amenity"' -uniq 'v="([^"]+)"' -sort count -head 20

# 結果を画面で読む(GUI へ渡す)
uvp japan-latest.osm.pbf '東京' -open

# 索引が何を束ねたものか見る(無料)
uvp japan-latest.osm.pbf.uwvz --info

# 中身の XML を書き出す(pbf には戻せません)
uvp japan-latest.osm.pbf.uwvz -extract -out out/
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。無料版の uvf に pbf を渡した場合も2で終わり、uvp を案内します。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- gz を展開せずに探す(展開律速は cold と hot が同じ): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
- 外部コマンドを呼ばずに7形式を探す: https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- 束ねた索引を使い回す(1本消えても作り直さない): https://uvp.y42u.net/blog/uwview-wf04-bundle-keep/
- 複数ファイルを1コマンドで探す: https://uvp.y42u.net/blog/uwview-wf01-multi-file-one-command/
.uwvzを作って、中を探して、取り出す: https://uvp.y42u.net/blog/uwvz-compressed-archive-search-extract/- 読む回数だけを減らした13回のまとめ: https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。