-i を付けると4倍遅い。
同じファイル、同じ語、違うのは「大文字小文字を無視するかどうか」だけ。それだけで秒数が4倍になります。探し方の問題だと思って探索のコードを読んでいましたが、犯人はそこにいませんでした。
速い道を通すには、その前にある1文字を確かめる必要がありました。
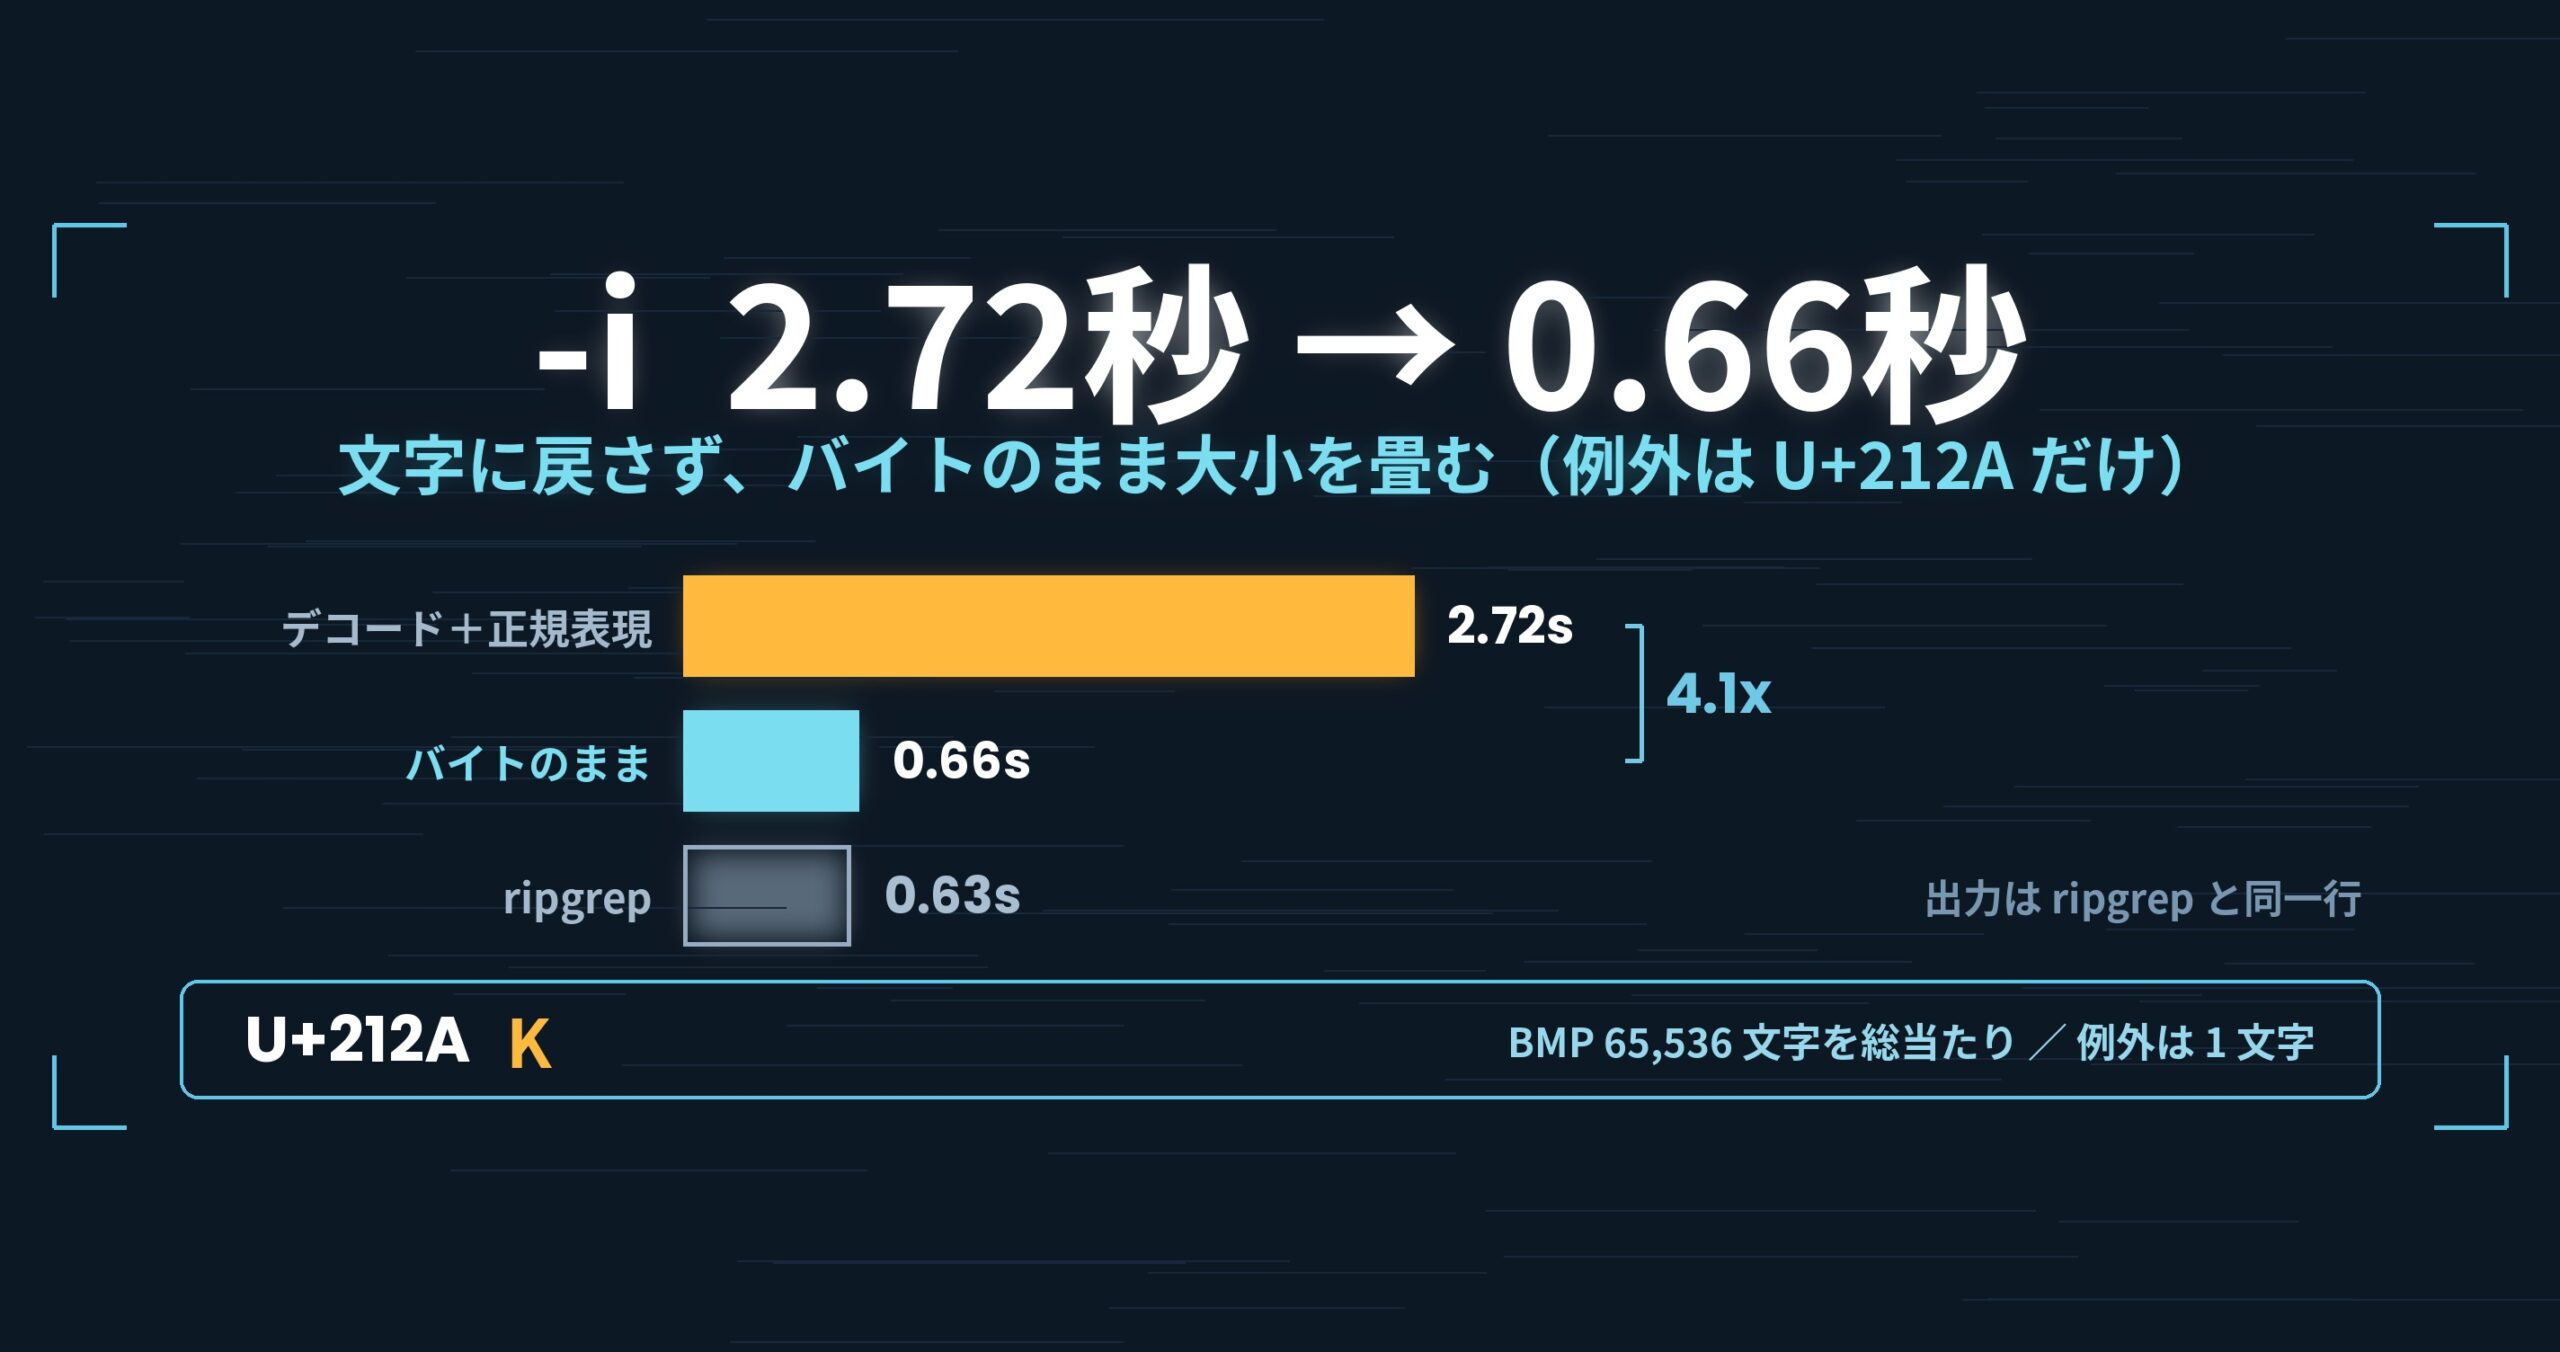
- 先に結論: -i の一致判定を「行を UTF-16 にデコードして IgnoreCase の正規表現に当てる」形から「バイト列のまま ASCII の大小だけ畳む」形に変え、3GB のホット検索が 2.72 秒 → 0.66 秒(ripgrep 0.63 秒=同等)になりました。バイトで畳んでよい根拠は実測で、.NET の IgnoreCase | CultureInvariant が ASCII 英字に一致させる非 ASCII 文字は、BMP 全域で U+212A(ケルビン記号)ただ 1 文字でした。50GB では ripgrep 113.85 秒 対 uvf 108.58 秒(cold+hot の 2 回計・1.05 倍=同等)。ただし -E -i の併用にはまだ負けが残ります(3GB ホットで ripgrep 0.60 秒 対 1.67 秒=2.8 倍)。いずれも特定環境での測定例です。詳細は記事末尾。
- 問題: 大文字小文字を無視した瞬間、同じ検索が4倍かかった
- 原因: 探す前に、全部の行を作り直していた
- なぜ「バイトのまま a↔A を畳む」だけでは済まないのか
- 測って数えた: 全 65,536 文字のうち、例外は 1 文字だった
- 手当て: 2段構えにして、k/K のときだけ遅い道へ
- もう1つの罠: バイトのまま探してよい文字コードは限られる
- 数字: 2.72 → 0.66 秒、50GB は同等、-E -i はまだ負ける
- 持ち帰れる一般論: 「例外は何個あるか」は、たいてい数えられる
- 使っている道具
- リンク
先に結論: -i の一致判定を「行を UTF-16 にデコードして IgnoreCase の正規表現に当てる」形から「バイト列のまま ASCII の大小だけ畳む」形に変え、3GB のホット検索が 2.72 秒 → 0.66 秒(ripgrep 0.63 秒=同等)になりました。バイトで畳んでよい根拠は実測で、.NET の IgnoreCase | CultureInvariant が ASCII 英字に一致させる非 ASCII 文字は、BMP 全域で U+212A(ケルビン記号)ただ 1 文字でした。50GB では ripgrep 113.85 秒 対 uvf 108.58 秒(cold+hot の 2 回計・1.05 倍=同等)。ただし -E -i の併用にはまだ負けが残ります(3GB ホットで ripgrep 0.60 秒 対 1.67 秒=2.8 倍)。いずれも特定環境での測定例です。詳細は記事末尾。
この記事は「First Light」連載の第 3 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。今回扱うのは、その 1 回読みに乗った
-iの中身(v1.6.3)です。
問題: 大文字小文字を無視した瞬間、同じ検索が4倍かかった
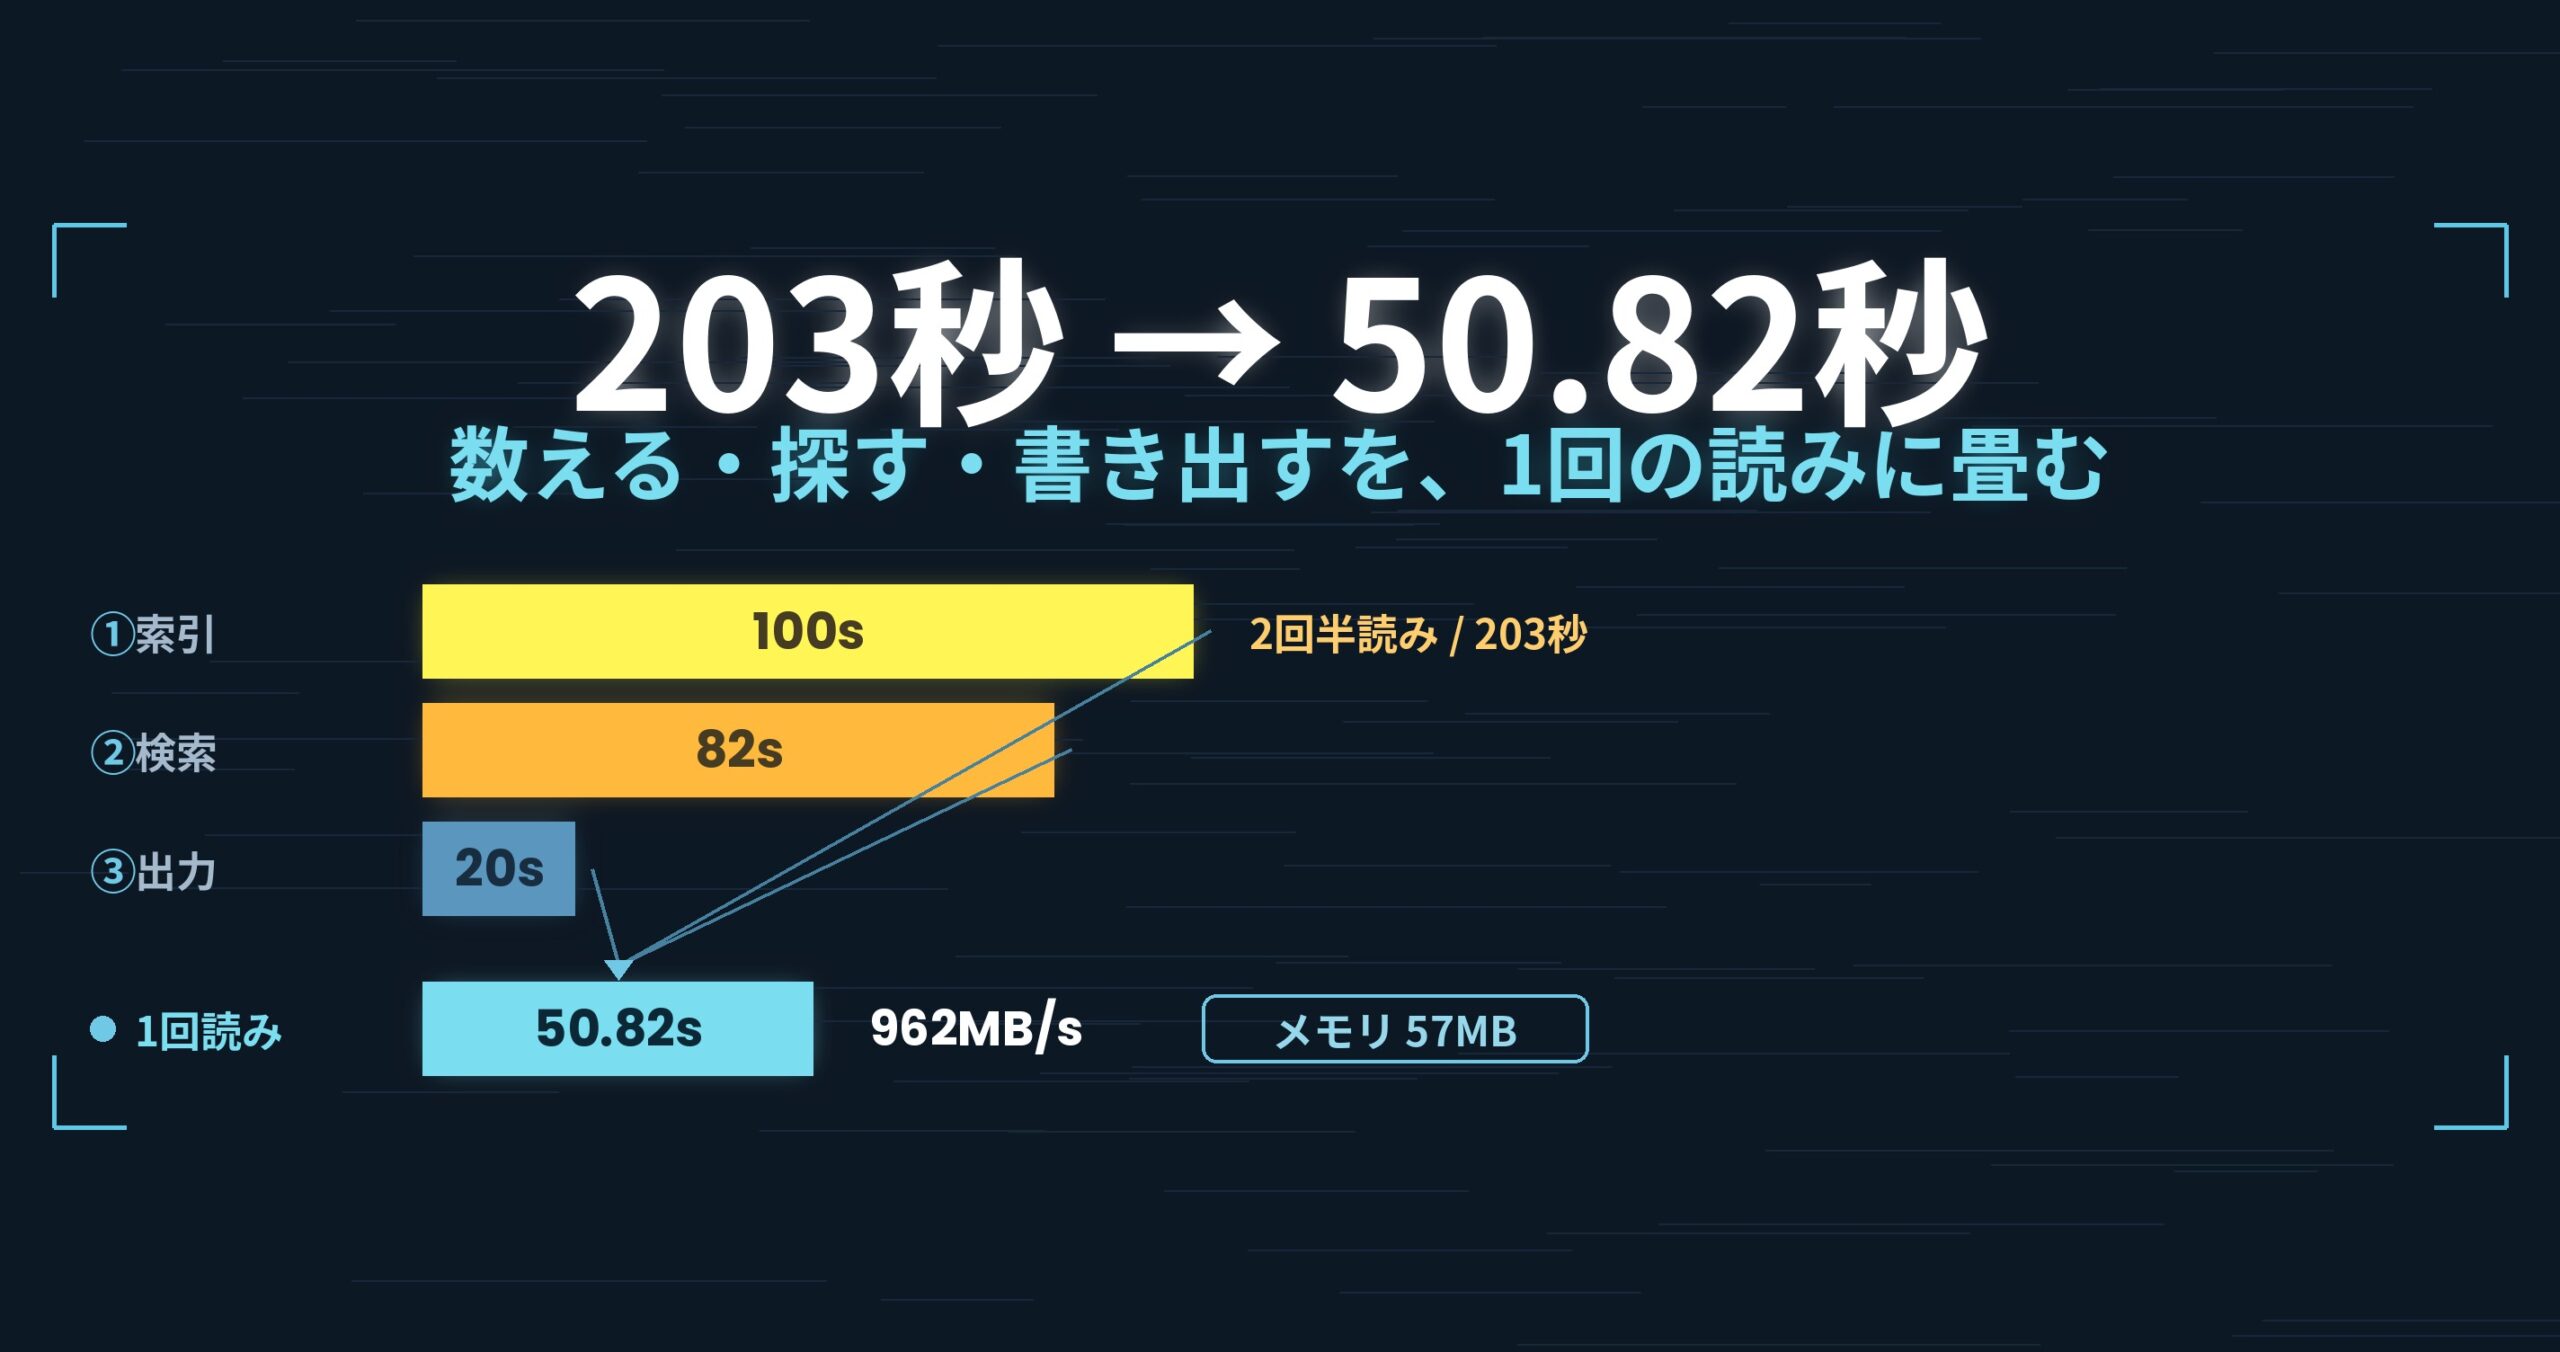
第 2 回で、ファイルを読む回数を 2 回半から 1 回に畳みました。読む回数が減ると、こんどは読む時間に隠れていたものが表に出てきます。
3GB のファイルを 2 回続けて検索したときの、2 回目(ホット=ファイルがメモリに載っている状態)の秒数です。
| 3GB・ホット | uvf(当時) |
ripgrep |
|---|---|---|
| 素の検索 | 1.20 秒 | 0.33 秒 |
-i(大小無視) |
2.72 秒 | 0.63 秒 |
素の検索も負けてはいますが、-i の 2.72 秒は別格です。ripgrep に対して 4.3 倍。単項目の基準(1.5 倍)をはっきり超えているので、これは自信を持って「負け」と書けます。
そしてコールド(sudo purge 直後)では、この差がほとんど見えません。同じ -i が 3.36 秒、ripgrep が 3.25 秒。冷えている間は媒体から読む時間が支配的で、CPU が何をしていようと秒数に出ないからです。CPU 側の無駄は、I/O を削った後にだけ姿を現す——第 2 回の 1 パス化が、この回の問題を掘り出したとも言えます。
原因: 探す前に、全部の行を作り直していた
-i の判定はこう書かれていました。
- 行のバイト列を UTF-16 の文字列にデコードする
- その文字列を
IgnoreCase | CultureInvariantを付けた正規表現に当てる
正しくはあります。画面側の検索と同じ規則なので、答えも揃います。問題はどの行に対してこれをやっていたかでした。
一致する行は、ふつうごく一部です。それなのに、デコードは全部の行に走ります。3GB・9,200 万行なら 9,200 万回。素の検索にはこの工程が無いので、1.20 秒と 2.72 秒の差はまるごとこの前処理の代金でした。
遅かったのは一致判定そのものではなく、一致判定にたどり着くまでの準備です。準備を全行に払っていたのだから、行数に比例して効いてきます。
なぜ「バイトのまま a↔A を畳む」だけでは済まないのか
素直な速い道はすぐ思いつきます。A(0x41) と a(0x61) はビットが 1 つ違うだけなので、デコードせずにバイトのまま大小を畳んで比べればいい。デコードも正規表現も要りません。
ただ、ここには落とし穴があります。Unicode の大小無視は ASCII に閉じていません。 たとえば ı(ドットなしの i)や ſ(長い s)のように、ASCII の英字と「同じ文字」とみなされ得る非 ASCII 文字が存在します。もしそういう文字を含む行を取りこぼせば、-i の答えが画面の検索と食い違うことになります。速くなっても、答えが変われば使えません。
なので、先に決めなければならない問いは 1 つでした。「.NET の IgnoreCase | CultureInvariant が ASCII 英字と一致させる非 ASCII 文字は、実際いくつあるのか」。
測って数えた: 全 65,536 文字のうち、例外は 1 文字だった
見積もらずに数えました。BMP(U+0000〜U+FFFF)の全 65,536 文字を、a〜z・A〜Z と総当たりで突き合わせるだけです。定義域が有限なら、勘で決める理由はありません。
出てきたのは、1 文字でした。
'k' ← U+212A(ケルビン記号 K)だけ
これで方針が決まります。k も K も含まない語なら、ASCII の中だけで畳み込みが閉じる——つまりバイトのまま探しても、正規表現の経路と完全に同じ行が出ます。
ついでに、比較相手の挙動も測りました。ripgrep の -i も U+212A を畳みます(rg -i kilo はケルビン記号の行を拾う)。一方 grep -i は拾いません。同じ -i でも道具によって範囲が違う、ということです。
ここは正直に書いておきます。Pro 側(uvp)のソースには、以前から次の趣旨のコメントが入っていました。
ケルビン記号 U+212A と
kは、このパスではヒットしない(意図的な仕様。ripgrep 等のバイト指向検索と同じ割り切り)
測ったら逆でした。 ripgrep は畳んでいたので、uvp の -i は ripgrep とも自分の画面とも違う答えを返し得る状態だったことになります。「他のツールと同じ割り切りです」というコメントは、根拠ではなく思い込みの言い換えでした。
手当て: 2段構えにして、k/K のときだけ遅い道へ
判定・折り畳み・目印選びを AsciiCaseFold(UwView.Core/AsciiCaseFold.cs)に一本化し、語の種類で経路を分けました。
| 語の種類 | 経路 |
|---|---|
ASCII だけ・k/K を含まない |
バイトのまま大小を無視して探す(デコードも正規表現もなし)。畳み込みが ASCII 内で閉じるので、正規表現の経路と完全に同一 |
k/K を含む |
前チェック(k 以外の 1 文字を SIMD で先に探す)→ 通った行だけデコードして正規表現。U+212A を取りこぼさない |
| 非 ASCII を含む/UTF-8 以外 | 従来どおりデコード経路 |
2 段目の前チェックは、「k 以外の文字が 1 つも無い行は、そもそも候補ですらない」という当たり前を使っています。目印に選ぶ文字は記号・数字を優先します。英字より現れにくいぶん、空振りが減るからです。kilo なら i・l・o のどれかを先に SIMD で走らせ、当たった行だけデコードします。
あわせて、改行を数える側も直しました。行番号のために全改行を数える処理が IndexOf の繰り返しになっていたのを MemoryExtensions.Count(SIMD)に変えています。1GB・改行 3,350 万本で 0.302 秒 → 0.055 秒(3,386MB/s → 18,593MB/s)。-i の判定を速くしても、隣で改行を 1 本ずつ数えていたら頭打ちになるので、これは同時にやる必要がありました。
もう1つの罠: バイトのまま探してよい文字コードは限られる
バイト列のまま探せるのは、バイトと文字が 1 対 1 で、ASCII がそのままのバイトで現れる文字コードだけです。これを外すと、速いどころか間違った場所に当たります。
- Shift_JIS:
ソは83 5C。2 バイト目の5Cは ASCII の\と同じバイトです。バイトで\を探すと、ソの途中に当たってしまいます - UTF-16: 改行は
0A 00。1 バイトの0Aを改行として数えると、行の切れ目が狂います
そこで AsciiCaseFold.IsAsciiCompatible(encoding) で文字コードを判定し、当てはまらないものは迷わずデコード経路へ落とすようにしました。同じ判定を Pro の並列検索(ParallelSearchService)にも入れて、画面・無料 CLI・Pro の 3 つで一致の意味を揃えています。
副産物もありました。外部レビューで挙がっていた「大小無視で長大行を探すと、索引の有無で結果が 1 件と 0 件に割れる」という不具合が、画面側にも同じバイト経路を入れたことで消えています。長大行をデコードして先頭 64KB だけ見る経路に落ちなくなったためで、速くする変更が、そのまま答えを揃える変更になった形です。
数字: 2.72 → 0.66 秒、50GB は同等、-E -i はまだ負ける
3GB・ホット(同じファイルへの 2 回目)
| 修正前 | 修正後 | ripgrep | |
|---|---|---|---|
| 素の検索 | 1.20 秒 | 0.50 秒 | 0.33 秒 |
-i |
2.72 秒 | 0.66 秒 | 0.63 秒 |
-E -i |
9.36 秒 | 1.67 秒 | 0.60 秒 |
50GB・cold と hot を 1 回ずつ計った合計(v1.6.6・Mac)
| 50GB・2 回計 | ripgrep | uvf |
比 |
|---|---|---|---|
| 素の検索 | 110.30 秒 | 103.31 秒 | 1.07 |
-i |
113.85 秒 | 108.58 秒 | 1.05 |
-E -i |
113.29 秒 | 103.25 秒 | 1.10 |
50GB はどれも 1.05〜1.10 倍。これを「勝った」とは書きません——単項目で 1.5 倍未満は差と呼ばない、と自分たちで決めているので、ここは「同等になった」が正しい書き方です。もともと 50GB は媒体律速なので、CPU 側の改善が秒数に出ないのは想定どおりです。この改修が効くのはファイルがメモリに載る大きさで、同じファイルに続けて聞くときに限られます。
速さより大事なのは、答えが変わっていないことです。3 サイズ × 7 パターンで ripgrep と出力行を突き合わせ、同一行であることを確認しています(ハーネスでは Mac 84 項目一致・不一致 0)。k を含む語でケルビン記号の行を拾うこと、前チェックが候補行を落とさないことも、個別のテストにしてあります。
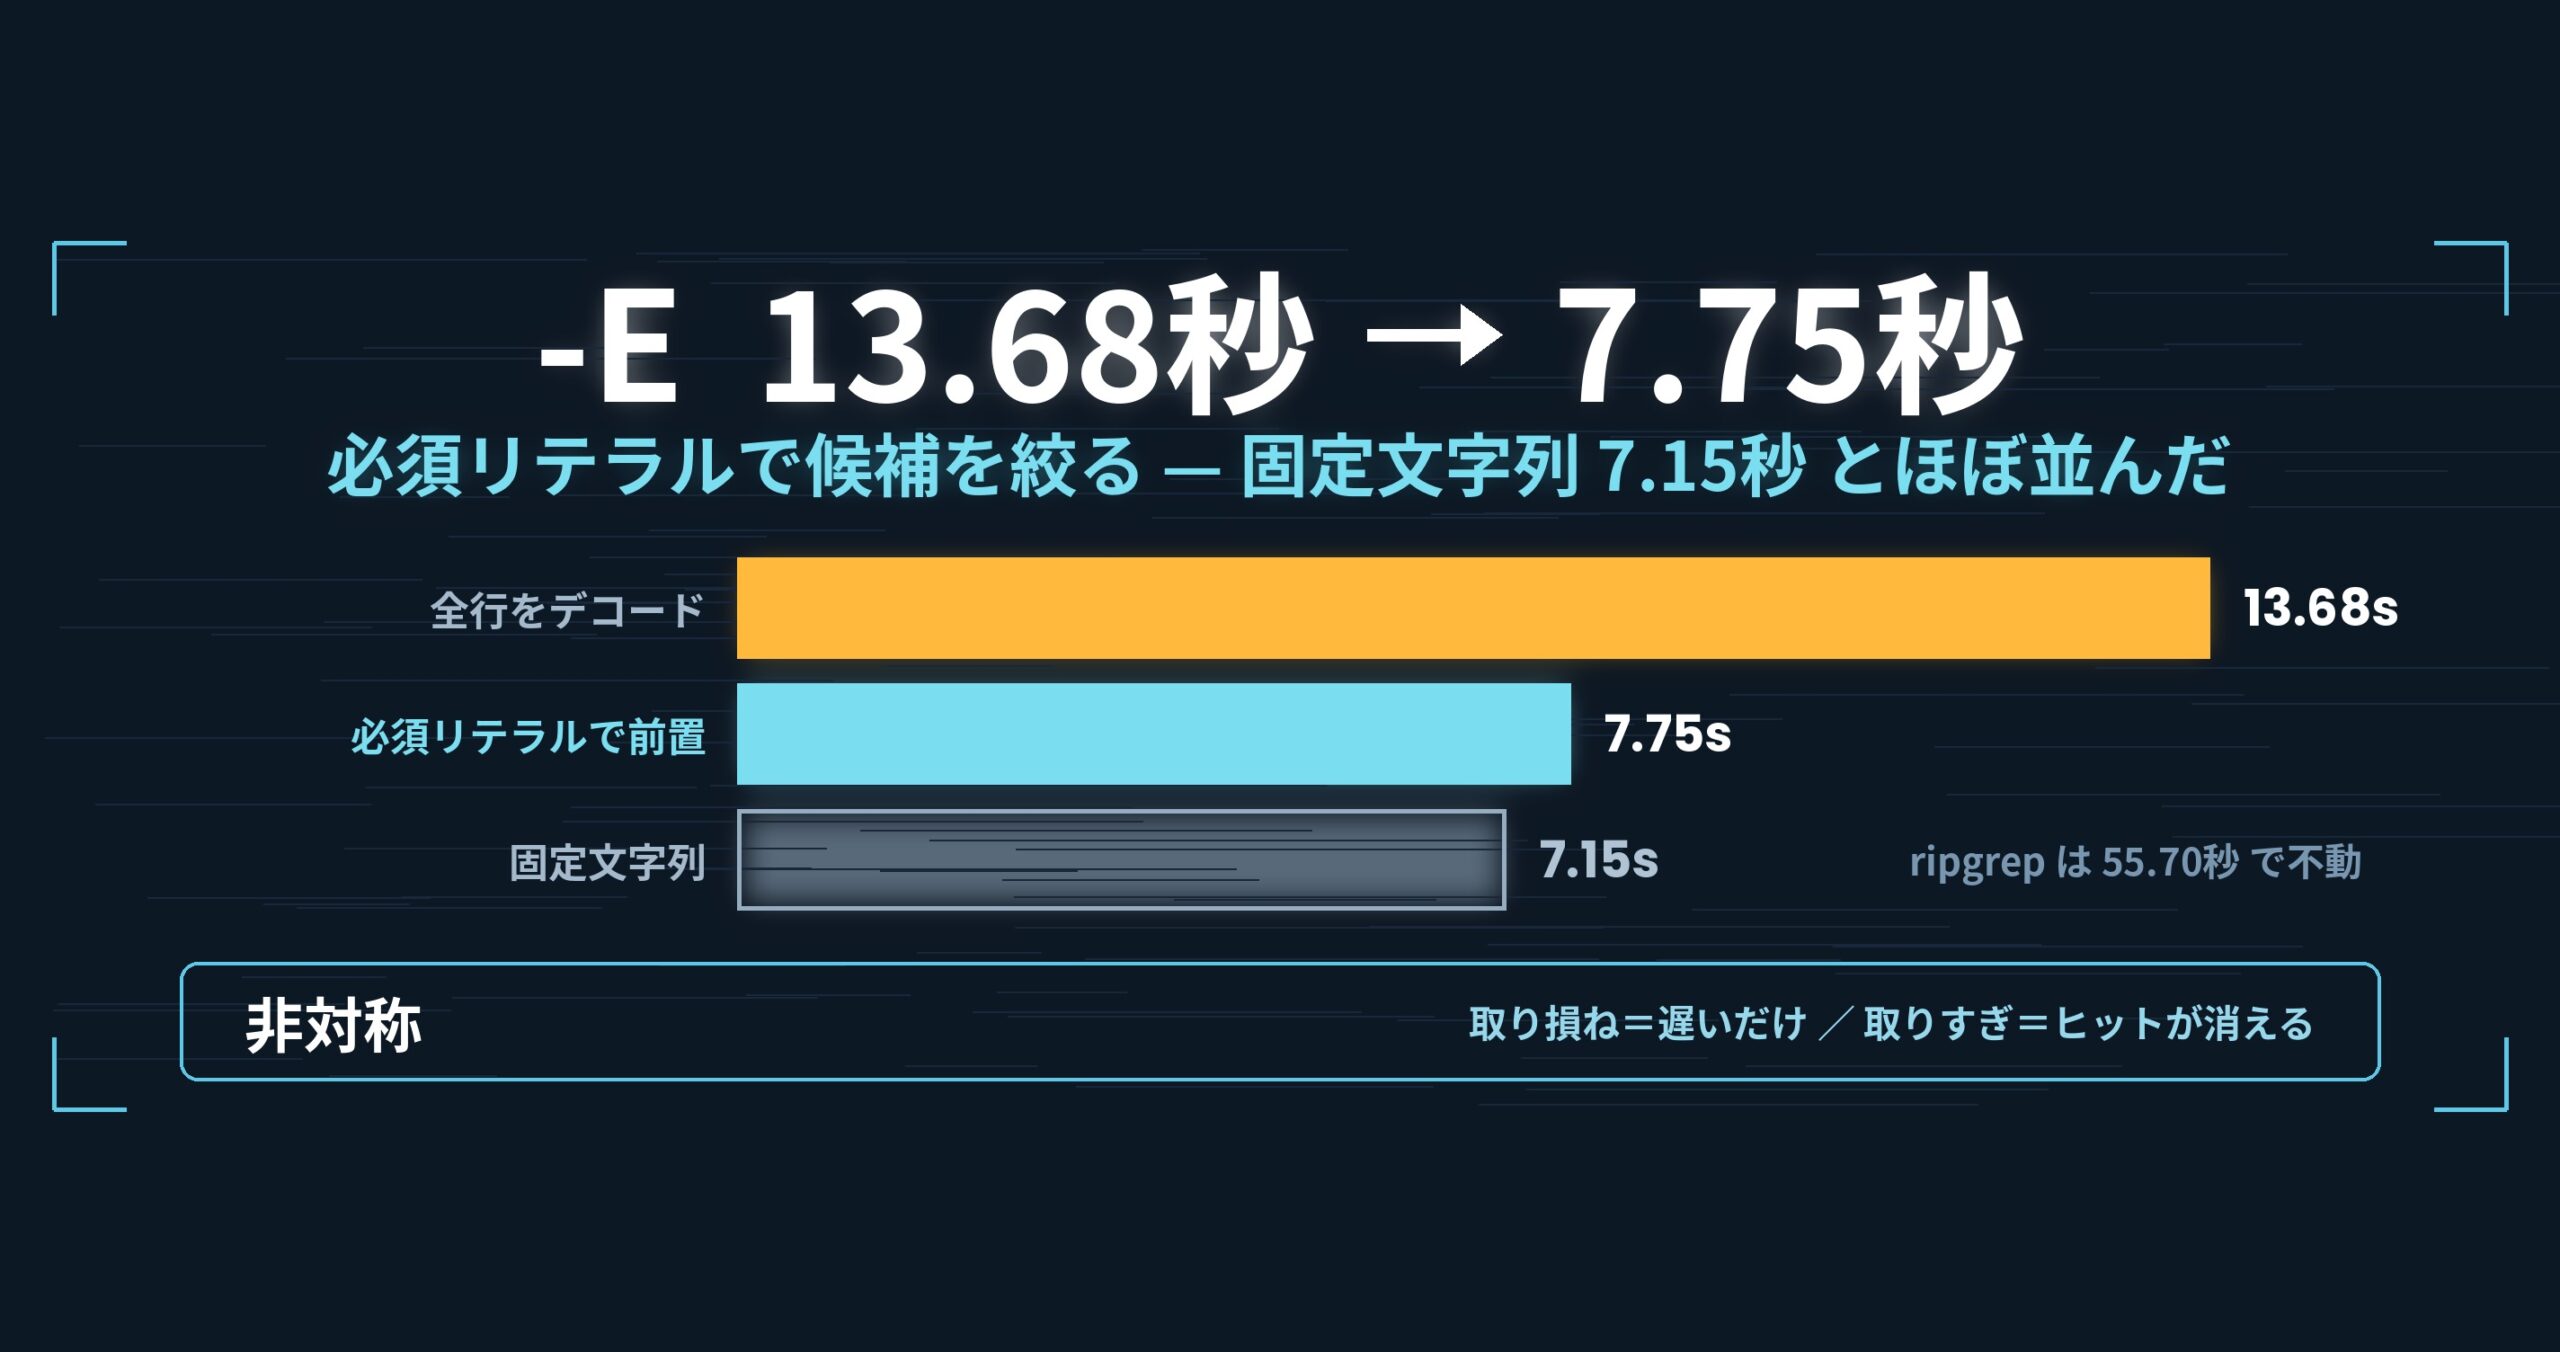
残っている負けも書きます。 -E -i(正規表現+大小無視)は 3GB ホットで ripgrep 0.60 秒 対 1.67 秒。2.8 倍負けです。原因は手がかりの弱さで、-E -i では必須リテラル(この正規表現に当たる行が必ず含む文字列)が取り出せないため、代わりに「k を含まない最長の連続部分」を目印にしています。必須リテラルの連続した一部もまた必須なので取りこぼしはありませんが、絞り込みの力は本物の必須リテラルより落ちます。必須リテラルそのものの話は次回(第 4 回)で扱います。
もう一点。10GB の -E -i だけは 2 回計で ripgrep 12.83 秒 対 uvf 16.05 秒。1.5 倍未満なので「差」とは書きませんが、7 項目のうちここだけこちらが遅い側に振れています。
持ち帰れる一般論: 「例外は何個あるか」は、たいてい数えられる
速い特殊経路を入れるときに怖いのは、速さではなくまれな入力で答えが変わることです。だから多くの場合、「例外がありそうだ」という感触だけで特殊経路を諦めます。
ですが、「まれ」を感覚で見積もる必要はありません。定義域が有限なら、総当たりで数えられます。 今回は 65,536 通り。手元の機械なら一瞬です。数えた結果が 1 個だったので、その 1 個だけを別扱いにすれば、残り全部を速い道に通せる——この形に持ち込めたのが本質でした。
もう 1 つ。「他のツールと同じ割り切りです」というコメントは、根拠ではありません。 測ったら逆でした。自分のコードの中で、いちばん検証されていない主張は、たいていコメントの中の「〜と同じ」です。仕様を他人に預けた箇所こそ、実際に動かして確かめる価値があります。
使っている道具
この記事の題材はコマンドそのものなので、末尾にも実際の書き方を置いておきます。
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 2章: 大文字小文字を無視して探す(無料版・v1.6.3 で uvf にも追加)
uvf app.log 'error' -i

# 5章: ケルビン記号を含む行も拾う(k を含む語は自動で前チェック経路へ)
uvf app.log 'kilo' -i

# 6章: 正規表現と併用する
uvf app.log -E 'timeout|refused' -i

# 6章: 2語で絞り込む(1語目の結果の中から2語目を探す)
uvf app.log 'ERROR' 'payment'

# 7章: 前後の文脈ごと見る/結果をファイルに書き出す
uvf huge.log 'FATAL' -C 5
uvf huge.log 'FATAL' -out fatal.txt

# 7章: CLI で探した結果を、そのまま GUI に渡して開く
uvf access.log ' 503 ' -open
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvf access.log ' 503 '; then がそのまま書けます。
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2 回半読んでいた CLI を 1 回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 画面側も同じ 1 回読みにした話(v1.6.6): https://uvp.y42u.net/blog/uvp-gui-catches-up-v166/
- uvp コマンドを付けました(ripgrep との実測比較・3GB コールドの
-iは 3.30 秒 対 1.58 秒): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/ - ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。