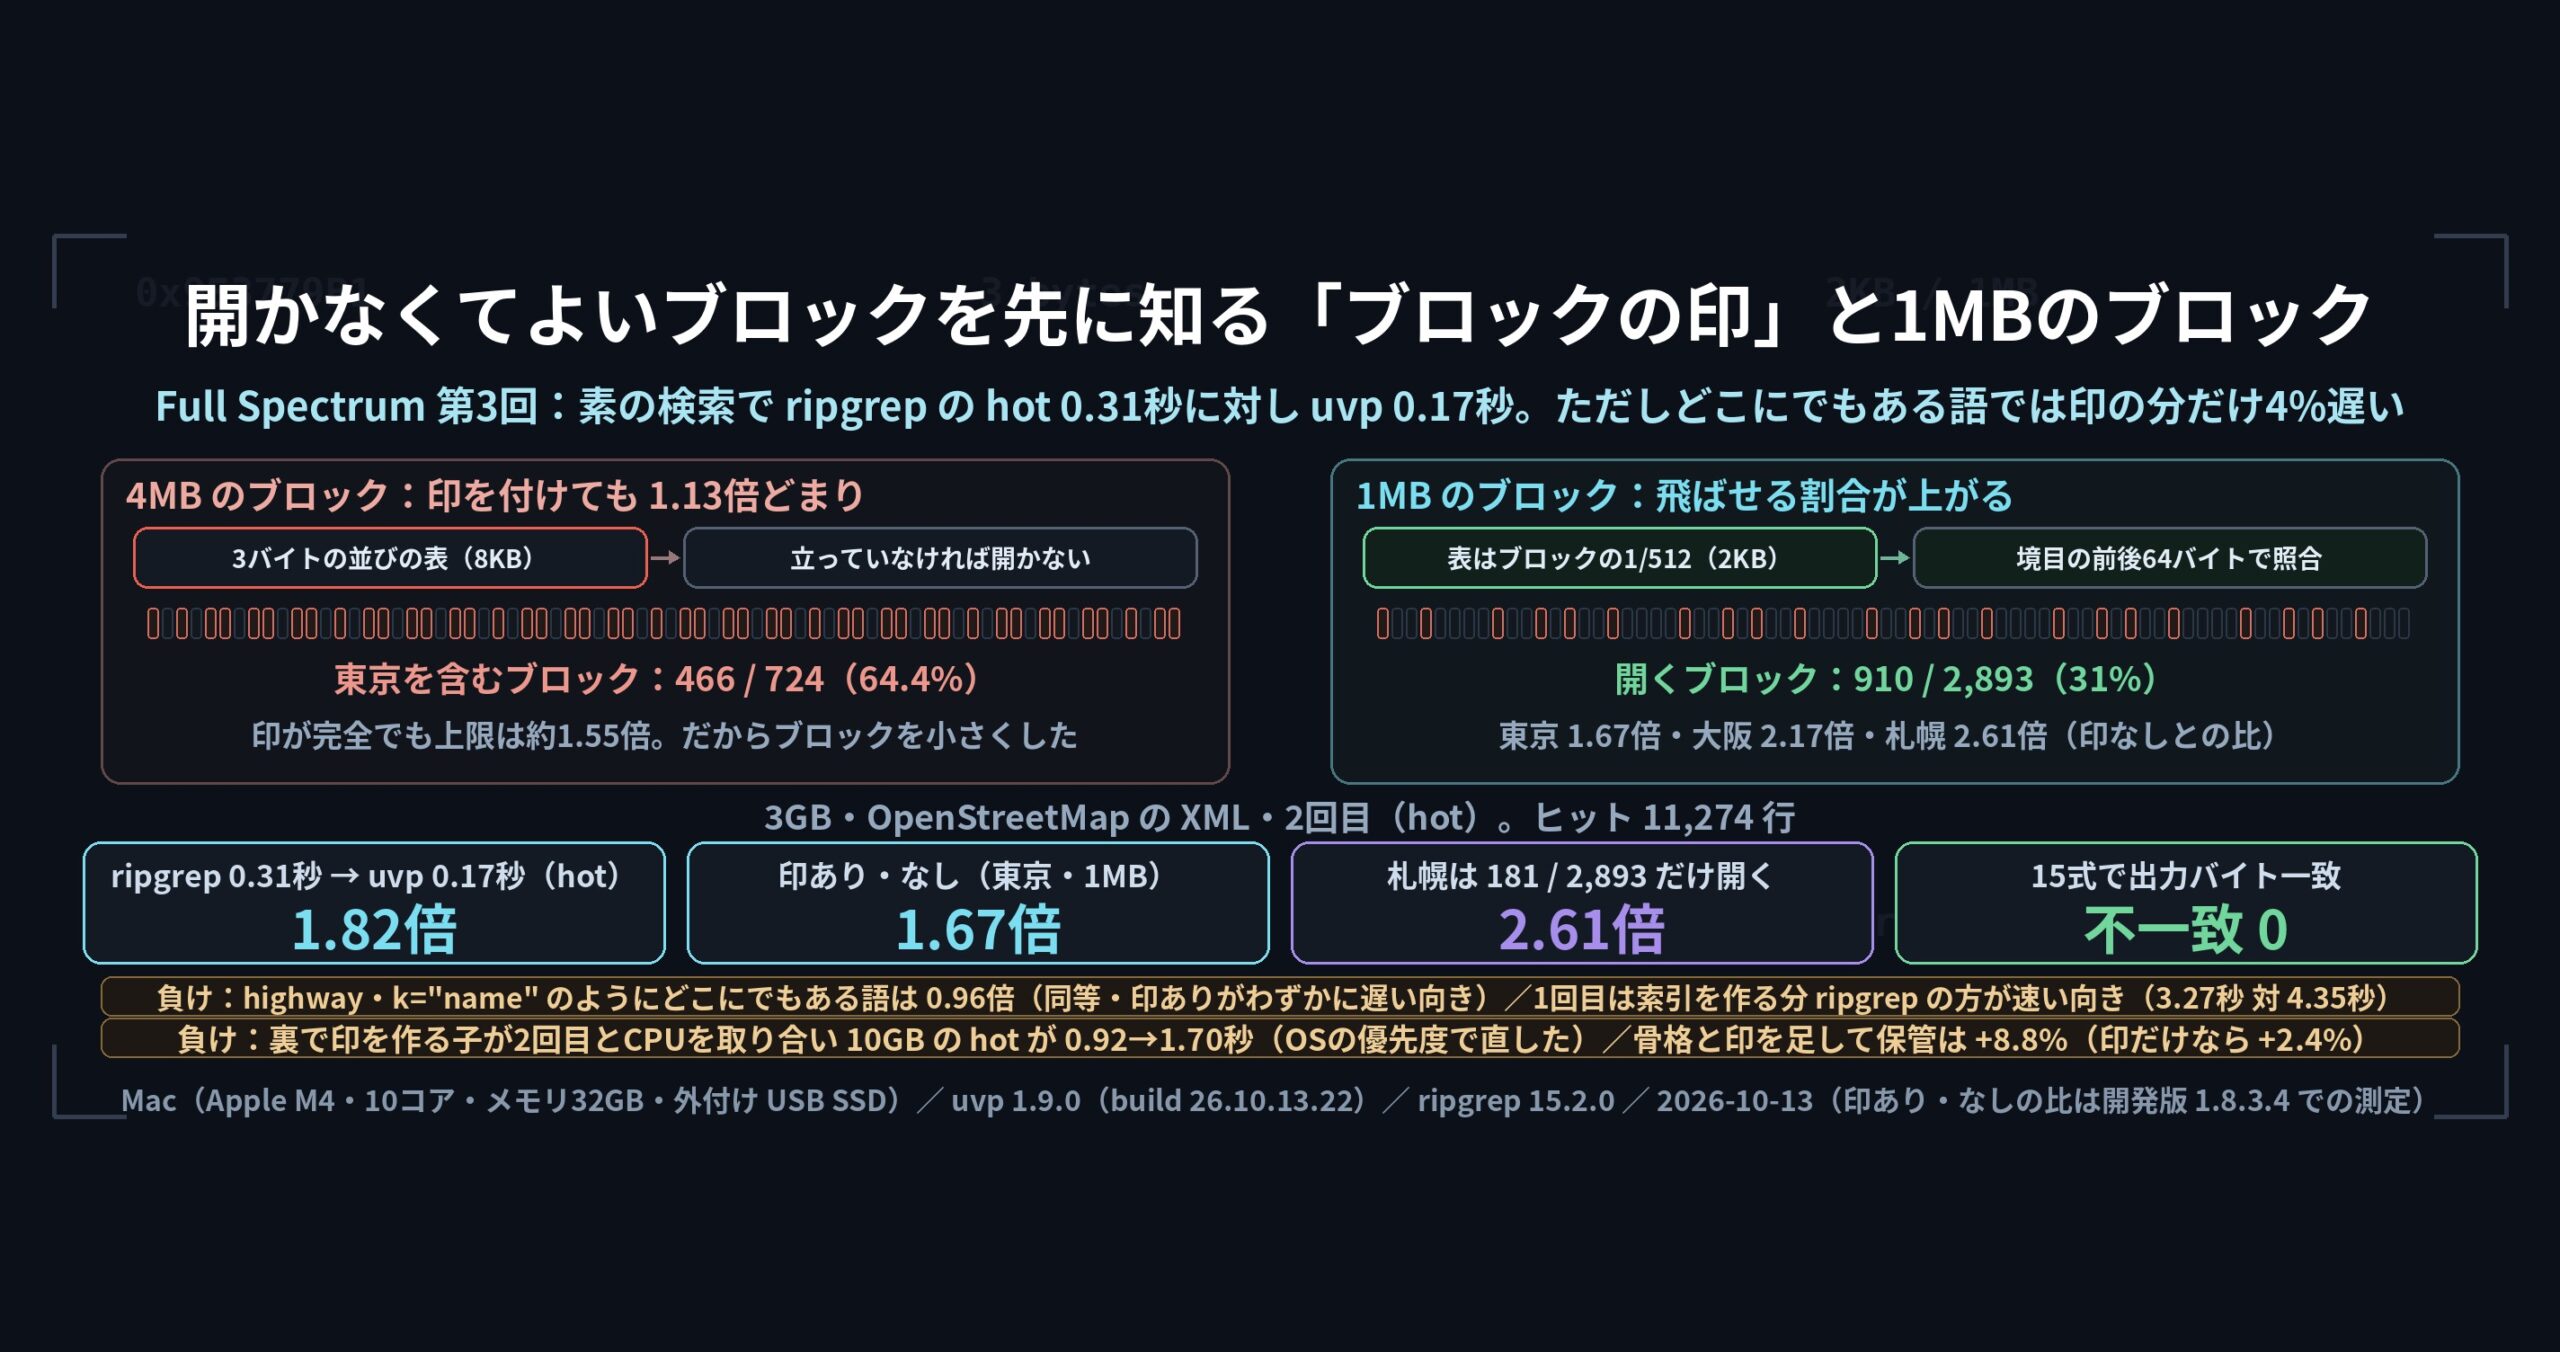
3GB の OpenStreetMap の XML を 1MB ずつに切ると 2,893 個のブロックになり、そのうち 東京 が入っているのは 910 個でした。
残りの約 7 割は、開く必要がありません。けれど「開かなくてよかった」と分かるのは、たいてい開いて中を見た後です。開く前に分かるようにするには、ブロックごとに何を持っておけばいいか。 そして、ブロックをいくつに切るのが良いのか。今回はその 2 つの話です。
- 先に結論: 3GB の 東京 が 2 回目で ripgrep 0.31秒 対 uvp 0.17秒。印あり・なしでは 1.67倍、札幌 なら 2.61倍。ただし highway のようにどこにでもある語は 4% 遅い
- 問題: 範囲は絞れても、1 つのブロックの中身は開くまで分からなかった
- 考え: 3 バイトの並びを、ブロックごとの小さな表に落とす
- 境目の前後 64 バイト — 最初の作りで 612/724 まで膨らんだ話
- ブロックを 4MB から 1MB へ — 印だけでは届かなかった
- 数字: ripgrep と比べて(v1.9.0 の全体テスト・3GB)
- 数字: 印あり・なし(仕組みだけを切り出して見る)
- 負け: どこにでもある語、cold、裏の子と CPU の取り合い
- 正しさ: 15 式でバイト一致、.uwvz は 1 バイトも変わらない
- 持ち帰れる一般論: 要約の精度より先に、かたまりの大きさを見る
- uvp ならこう書く
- リンク
先に結論: 3GB の 東京 が 2 回目で ripgrep 0.31秒 対 uvp 0.17秒。印あり・なしでは 1.67倍、札幌 なら 2.61倍。ただし highway のようにどこにでもある語は 4% 遅い
.uwvz(uvp 用の圧縮形式+索引)のブロックごとに、そのブロックに現れる「3 バイトの並び」の要約を置きました。これを印と呼びます。表の大きさはブロックの 1/512(1MB なら 2KB)で、探す語を 3 バイトずつに分けて表を見れば、開く前に「このブロックには無い」と確定できます。立っていても偶然ぶつかっている場合(偽陽性)はあるので、立っているブロックだけ開いて確かめます。つまり飛ばす方向にだけ効く仕組みです。
同時に、ブロックの大きさを 4MB から 1MB に変えました。これは印と対になる変更です(理由は後の節に書きます)。
v1.9.0 の全体テスト(Mac・3GB・素の検索 東京・11,274 行ヒット)で、2 回目は ripgrep 0.31秒 対 uvp 0.17秒(1.82倍)。仕組みだけを切り出して印あり・なしで比べると、東京 が 1.67倍、大阪 が 2.17倍、札幌 が 2.61倍になりました。
負けを先に書きます。highway や k="name" のように、どのブロックにも入っている語には効きません。 印を確かめる手間だけが足されて 0.96倍(1.5倍未満なので同等。印ありがわずかに遅い向き) です。1 回目は ripgrep の方が速い向きで、.uwvz を作る時間を含む uvp の cold は 4.35秒、ripgrep は 3.27秒(1.33倍・同等の範囲)でした。そして 裏で印を作る子プロセスが 2 回目と CPU を取り合い、10GB の 2 回目が 0.92秒 → 1.70秒 に落ちました。これは OS の優先度を使って直しています。
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この記事の数字は v1.9.0 “Full Spectrum”(2026年10月14日公開・build 26.10.13.22)を Mac(Apple M4・10コア・メモリ32GB・外付け USB SSD)で 2026年10月13日に測ったものです。印あり・なしの比だけは開発版 1.8.3.4 での測定です。v1.9 には「Full Spectrum」というペットネームを付けました。Shift_JIS・EUC-JP・UTF-16 のファイルも中を UTF-8 にそろえ、文字コードやファイルの種類を問わず、同じ速さで探せるようになった版だからです。
問題: 範囲は絞れても、1 つのブロックの中身は開くまで分からなかった
uvp は 2 回目以降、元のファイルではなく .uwvz を読みます。どのバイトから何行目が始まるかを持っているので、ファイルを 1 回読むだけで行番号付きの結果が出せます(この一回読みの話は この回 に書きました)。
ただ、ブロックを開くかどうかの判断材料は無いままでした。探す範囲が決まったら、その範囲のブロックを順に展開して、中をバイトのまま探す。東京 のように 3GB 中の 1 割にも満たないヒットでも、ブロックは全部開いていました。展開には 1MB あたり 0.44 ミリ秒ほどかかるので、開いた枚数がそのまま時間になります。
やりたいことは単純です。「このブロックには答えが無い」と、開く前に言えるようにする。 間違えてよい方向は 1 つだけで、「無いのに有ると言う」(開いて空振り=遅くなるだけ)は許せても、「有るのに無いと言う」(答えが静かに欠ける)は許せません。
考え: 3 バイトの並びを、ブロックごとの小さな表に落とす
ブロックの中身を要約するのに、語の一覧は使えません。語を切り出すには文章の構造が要るし、巨大なログや XML に出てくる「語」は数が読めません。そこで位置も回数も捨てて、「3 バイトの並びが出てきたか」だけを記録します。
- 連続する 3 バイト
a b cを(a<<16 | b<<8 | c) * 0x9E3779B1の上位ビットに畳み、ビットの表に立てる。 - ASCII の大文字は小文字に畳んでから立てる(大小無視の検索でも同じ表が使えるように)。
- 表の大きさはブロックの 1/512(1MB に 2KB、4MB に 8KB)。
探すときは、語を 3 バイトずつに分けて表を見ます。1 つでも立っていなければ、その語はそのブロックに無いと確定します。立っていれば開いて確かめます。使うのは次の場合です。
- 素の文字列(大小無視を含む)と、大小区別ありの正規表現から取り出した「必ず含む文字列」(この取り出しの話は この回 に書きました)。どちらも 3 バイト以上のとき。
-v(当てはまらない行)と、大小無視の正規表現では使いません。-vは「含まないブロック」を飛ばせないからで、こちらは前回の「行の骨格」が受け持ちます。
大小無視には細工が要りました。.NET の大小無視は、k をケルビン記号(U+212A)、s を ſ(U+017F)とも同じに見ます(この落とし穴は この回 に書きました)。そのため k と s を含む位置で手がかりを切り、残った英字・記号・かな・漢字の並びだけを使っています。
境目の前後 64 バイト — 最初の作りで 612/724 まで膨らんだ話
最初の実装は、ブロックをまたぐ行で間違えていました。.uwvz のブロックの境目で切れた最後の 1 行は、続きが次のブロックにあります。その行を確かめるのに、次のブロックの表を見ていたのです。すると「次のブロックのどこかに語がある」だけで通ってしまい、3GB の 東京 で開くブロックが 612 / 724 まで膨らみました(実際に 東京 を含むのは 466)。
直し方は、表ではなく生のバイトを持つことでした。境目の前後 64 バイトをブロックごとに持ち、またぐ行はそのバイトで確かめます。直した後は 482(4MB・表 8KB)。Python で同じ印を独立に作り直して突き合わせ、表を 32KB にしたときの 474 まで、計算どおりに下がることを確かめました。
ブロックを 4MB から 1MB へ — 印だけでは届かなかった
印を入れても、4MB のままでは 東京 が 1.13倍(同等)どまりでした。理由は計算すると分かります。4MB のブロック 724 個のうち、実際に 東京 を含むのは 466 個(64.4%)。印が完全でも開かずに済むのは 35.6% で、最大でも約 1.55倍しか縮みません。
かたまりを小さくすれば、この比率が下がります。1MB にすると 2,893 個中 910 個(31%)。札幌 なら 181 個(6.3%)です。
| 語 | 開くブロック(4MB・個) | 4MB の全体(個) | 開くブロック(1MB・個) | 1MB の全体(個) |
|---|---|---|---|---|
東京 |
482 | 724 | 910 | 2,893 |
大阪 |
394 | 724 | 750 | 2,893 |
札幌 |
127 | 724 | 181 | 2,893 |
表を大きくすれば偽陽性は減りますが、減り方はすぐ鈍ります。4MB で 東京 の実数は 466 なのに、表 8KB で 482・16KB で 475・32KB で 474。1MB では 2KB で 910・4KB で 893。4 倍の保管を使って 1〜2% 減るだけなので、1/512 で止めました。
ブロックを小さくしても .uwvz 本体はほとんど増えません(3GB で 251.8MB → 252.4MB・+0.22%)。印を使わない 15 項目で 1MB と 4MB を比べると、遅くなったのは -seq(+2%)と -tail(+4%)の 2 つだけで、どちらも 5% 以内でした。印ありの 1MB(表 2KB)は、印ありの 4MB(表 8KB)より速いか同じです(東京 1.56倍・大阪 1.77倍・-tail 1.66倍、そのほかは 1.00〜1.09倍)。
数字: ripgrep と比べて(v1.9.0 の全体テスト・3GB)
相手は ripgrep 15.2.0。同じ式・同じヒット数を確かめた上での値です。cold はキャッシュを破棄して 10 秒待ってから、hot はその直後に測りました。uvp の cold は .uwvz を消してから測っているので、索引を作る時間を含みます。
| 式 | ヒット(行) | ripgrep cold(秒) | ripgrep hot(秒) | uvp cold(秒) | uvp hot(秒) | hot の倍率(倍) |
|---|---|---|---|---|---|---|
東京(素の検索) |
11,274 | 3.27 | 0.31 | 4.35 | 0.17 | 1.82 |
- 2 回目は 1.82倍。印で 2,893 ブロック中 910 しか開かないので、展開する量が 3 割弱で済みます。
- 1 回目は ripgrep の方が速い向き(3.27秒 対 4.35秒・1.33倍で同等の範囲)。索引を作る分です。索引を作らない無料版
uvfは cold 3.06秒・hot 0.29秒で、ripgrep とほぼ同じでした(cold 1.07倍・hot 1.07倍)。 - この項目には計測側の hot の警告は付いていません(
東京の rg は cold 3.27 に対し hot 0.31 で、キャッシュが効いています)。
数字: 印あり・なし(仕組みだけを切り出して見る)
UVP_MARKS=0 を付けると、同じ .uwvz で印を使わずに探せます。以下は開発版 1.8.3.4 での測定です(v1.9.0 の全体テストには、印を切った条件がないため)。3GB・hot・3 回の中央値・出力は /dev/null に捨てた時間です。
| 語 | 印なしに対して印ありが何倍速いか(1MB・倍) | 同(4MB・倍) |
|---|---|---|
東京 |
1.67 | 1.13 |
大阪 |
2.17 | 1.26 |
札幌 |
2.61 | 2.35 |
Main St を -i |
2.24 | 1.24 |
highway |
0.96 | 0.99 |
k="name" |
0.96 | 0.99 |
読み方は 2 つに分かれます。ヒットが散らばっていない語(東京・大阪・札幌・Main St)は、1MB にすると 1.67〜2.61倍。どのブロックにもある語(highway・k="name")は 0.96倍で、印ありがわずかに遅い向きです。札幌 だけ 4MB でも 2.35倍なのは、4MB でも 724 個中 121 個しか含まないからです。効き方はデータの偏りで決まり、仕組みの出来では決まりません。
負け: どこにでもある語、cold、裏の子と CPU の取り合い
1. どこにでもある語では 4% 遅くなります。 highway・k="name" は、印を見ても 1 つも飛ばせないので、表を読んで確かめる手間だけが足されます。0.96倍なので「同等」と書く範囲ですが、速くなっていないことは確かです。なお、それまでの既定だった 4MB・印なしと比べれば 0.336秒 → 0.315秒で速くなっています(ブロックを小さくした分)。効かないときに「わずかに遅いだけ」で済むことが、既定で入れっぱなしにできる条件でした。
2. 1 回目(cold)は速くなりません。 索引を作る分、ripgrep の方が速い向きです。さらに、1MB にして節を読むようになった分、10GB の -i・正規表現・集計の cold が 0.15〜0.2秒 遅くなりました。印の表をブロックごとに読まず 8MB ずつまとめて読む・骨格と印の節はその式で使うときだけ読む、に直しましたが、cold の測り直しはキャッシュの破棄に sudo が要るため、手元では未測定です。次の全体テストで確かめます。
3. 裏で印を作る子が、2 回目と CPU を取り合いました。 印と骨格は検索が終わった後に別プロセスで作ります。10GB で 1 回目の直後に 2 回目を測ると、0.92秒 → 1.70秒に落ちました。直し方は、子を OS の優先度で後回しにすることでした(mac は taskpolicy -b、Linux は nice 19 + ionice -c 3、Windows は Idle)。3GB では、作っている最中の 2 回目が 0.305秒(何も走っていないとき 0.291秒)で、全部のスレッドを使っても邪魔にならず 27 秒で作り終わります(2 スレッドに絞ると 54 秒かかりました)。画面側の裏のスレッドは OS の優先度を下げられないので、使うコアを 1/4 に抑えたままです。
4. 保管は増えます。 .uwvz 本体は +0.22% ですが、骨格と印は隣の .uwvz.x(3GB で 21.6MB=骨格 15.5MB+印 6.1MB)に置くので、それまでの 4MB の .uwvz に対して合計 +8.8%(印だけなら +2.4%)です。保管の小ささを売りにしている道具なので、ここは正直に書いておきます。
正しさ: 15 式でバイト一致、.uwvz は 1 バイトも変わらない
「無い」と決めて開かない仕組みなので、判定を 1 回間違えると答えが静かに欠けます。
- 出力のバイト一致: 印あり・なしで 1 バイトも違わないことを 15 式(素の文字列・
-i・正規表現・選択・$・-w)で照合しました。わざとブロックの境目をまたぐ語・64KB を超える行・CRLF を混ぜたものを入れ、探しながら書く道と、集めてから書く道(--csv)の両方で確かめています。 - 独立の作り直し: Python で同じ印を作って突き合わせ、通るブロック数が計算どおりになることを確かめました。
- 元の索引を触らない: 印は隣の
.uwvz.xに書き、.uwvzが 1 バイトも変わらないことを確かめました。作っている最中に同じ.uwvzを探しても結果が変わらないこと(同時に 3 回)、途中で止まった跡があっても次に作り直せることも確かめています。照合の鍵(元の長さ・ブロックの大きさと数・ブロック位置表のハッシュ)が合わない.uwvz.xは使いません。 - 試験:
Pro.Core1,054件・画面 372件・Editor 167件が通りました。
持ち帰れる一般論: 要約の精度より先に、かたまりの大きさを見る
「ここには無い」と言える要約は、使い道の広い道具です。作るときに考えることは、3 つだと思います。
粒度が効き方を決めます。 同じ印でも、4MB で 1.13倍・1MB で 1.67倍。要約の精度を上げる前に、かたまりの大きさを見直すほうが効くことがあります。上限は計算できます。「かたまりのうち何割が答えを含むか」が分かれば、要約が完璧なときの倍率が出るので、作る前に見積もれます(4MB の 64.4% から、上限 約1.55倍)。
取引になっている先を数えます。 表を 4 倍にしても偽陽性は 1〜2% しか減らない。かたまりを小さくすると飛ばせる率は上がるが、読み出しが小刻みになって 1 回目が遅くなる(まとめ読みで戻しました)。どちらも「効く方向」はあるのに、別のところで払っています。
効かないときのコストを先に測ります。 どこにでもある語に対しては、この印は何の役にも立ちません。それでも既定で入れられるのは、効かないときの代償が 4% だったからです。効くときの最大値より、効かないときの最小限のほうが、既定にできるかどうかを決めます。
uvp ならこう書く
uvp japan.osm '東京'                     # 印が効く素の検索
uvp japan.osm 'Main St' -i               # 大小無視でも印を使う(k・s は手がかりから外す)
uvp japan.osm '="' -v                    # -v では印を使わない(こちらは行の骨格が受け持つ)
uvp japan.osm.uwvz --build-extra         # 既存の .uwvz に骨格と印を後から足す
uvp japan.osm.uwvz --extra-status        # 節ができているか・作成中かを見る
UVP_MARKS=0 uvp japan.osm '東京'         # 印を作りも使いもしない(照合・測定用)
UVP_EXTRA=sync uvp japan.osm '東京'      # 裏に回さず同じプロセスで作り、所要時間を出す
UVP_EXTRA=0 uvp japan.osm '東京'         # 骨格も印も作らず使わない
uvf japan.osm '東京'                     # 無料版は索引を作らず、そのつど読む
ブロックの大きさは UVP_BLOCK_SIZE、印の表の大きさは UVP_MARK_BYTES で変えられます(測定用)。終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
リンク
- Full Spectrum①: 索引の中を UTF-8 にそろえた話: https://uvp.y42u.net/blog/uwview-fs01-sjis-utf8-index/
- v1.9.0「Full Spectrum」の公開告知(この版の全体像): https://uvp.y42u.net/blog/uwview-v190-full-spectrum/
- 正規表現から「必ず含む文字列」を取り出して絞る話: https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
- 大小無視で
kがケルビン記号と同じに見える話: https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/ - ファイルを1回読むだけで行番号付きの結果を出す話: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- ripgrep が勝つ条件をまとめた回: https://uvp.y42u.net/blog/uwview-wf14-where-ripgrep-wins/
- 2回目の検索の4割を占めていた改行の数え方: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- 前の連載の総まとめ(複数ファイル・圧縮7形式・zip・pbf): https://uvp.y42u.net/blog/uwview-wf15-wide-field-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、同じ語を何度も探す巨大なログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。