秒だけでは足りません。
「10GB のログが 0.3 秒で開きました」と書かれた記事を読んで、同じファイルを自分の機械で開いたら 12 秒かかった——そういう経験は、たぶん誰にでもあります。嘘をつかれたわけではありません。測り方が書いていなかっただけです。
では、何を書いておけば再現できるのでしょうか。今回から始まる連載は、巨大ファイル検索の uvf(無料版 UwView のコマンド)と uvp(有料版 UwView Pro のコマンド)を、macOS・Linux・Windows で同じデータ・同じ手順にかけていく16回です。その初回にあたる今日は、1つも秒を出しません。 代わりに、残り15回で出てくる数字の読み方を全部ここで決めます。そして決めた結果、この連載には最初から2つの穴が空いています。
先に結論: cold・hot・first の3通りで5回測って中央値、答えは終了コードとヒット数と行番号まで照合。ただし Linux は VMware 上の仮想機で、Windows には cold を作る標準の手段が無い
負けを先に書きます。
1つめ。Linux の値は VMware Fusion の仮想機の値で、「Linux 実機の性能」ではありません。 仮想化の分が全部乗っています。しかも仮想機の中でキャッシュを落としても、ホスト側の Mac には別のキャッシュが残ります。 この連載で Linux の秒を見るときは、毎回「VMware 上」と書きます。
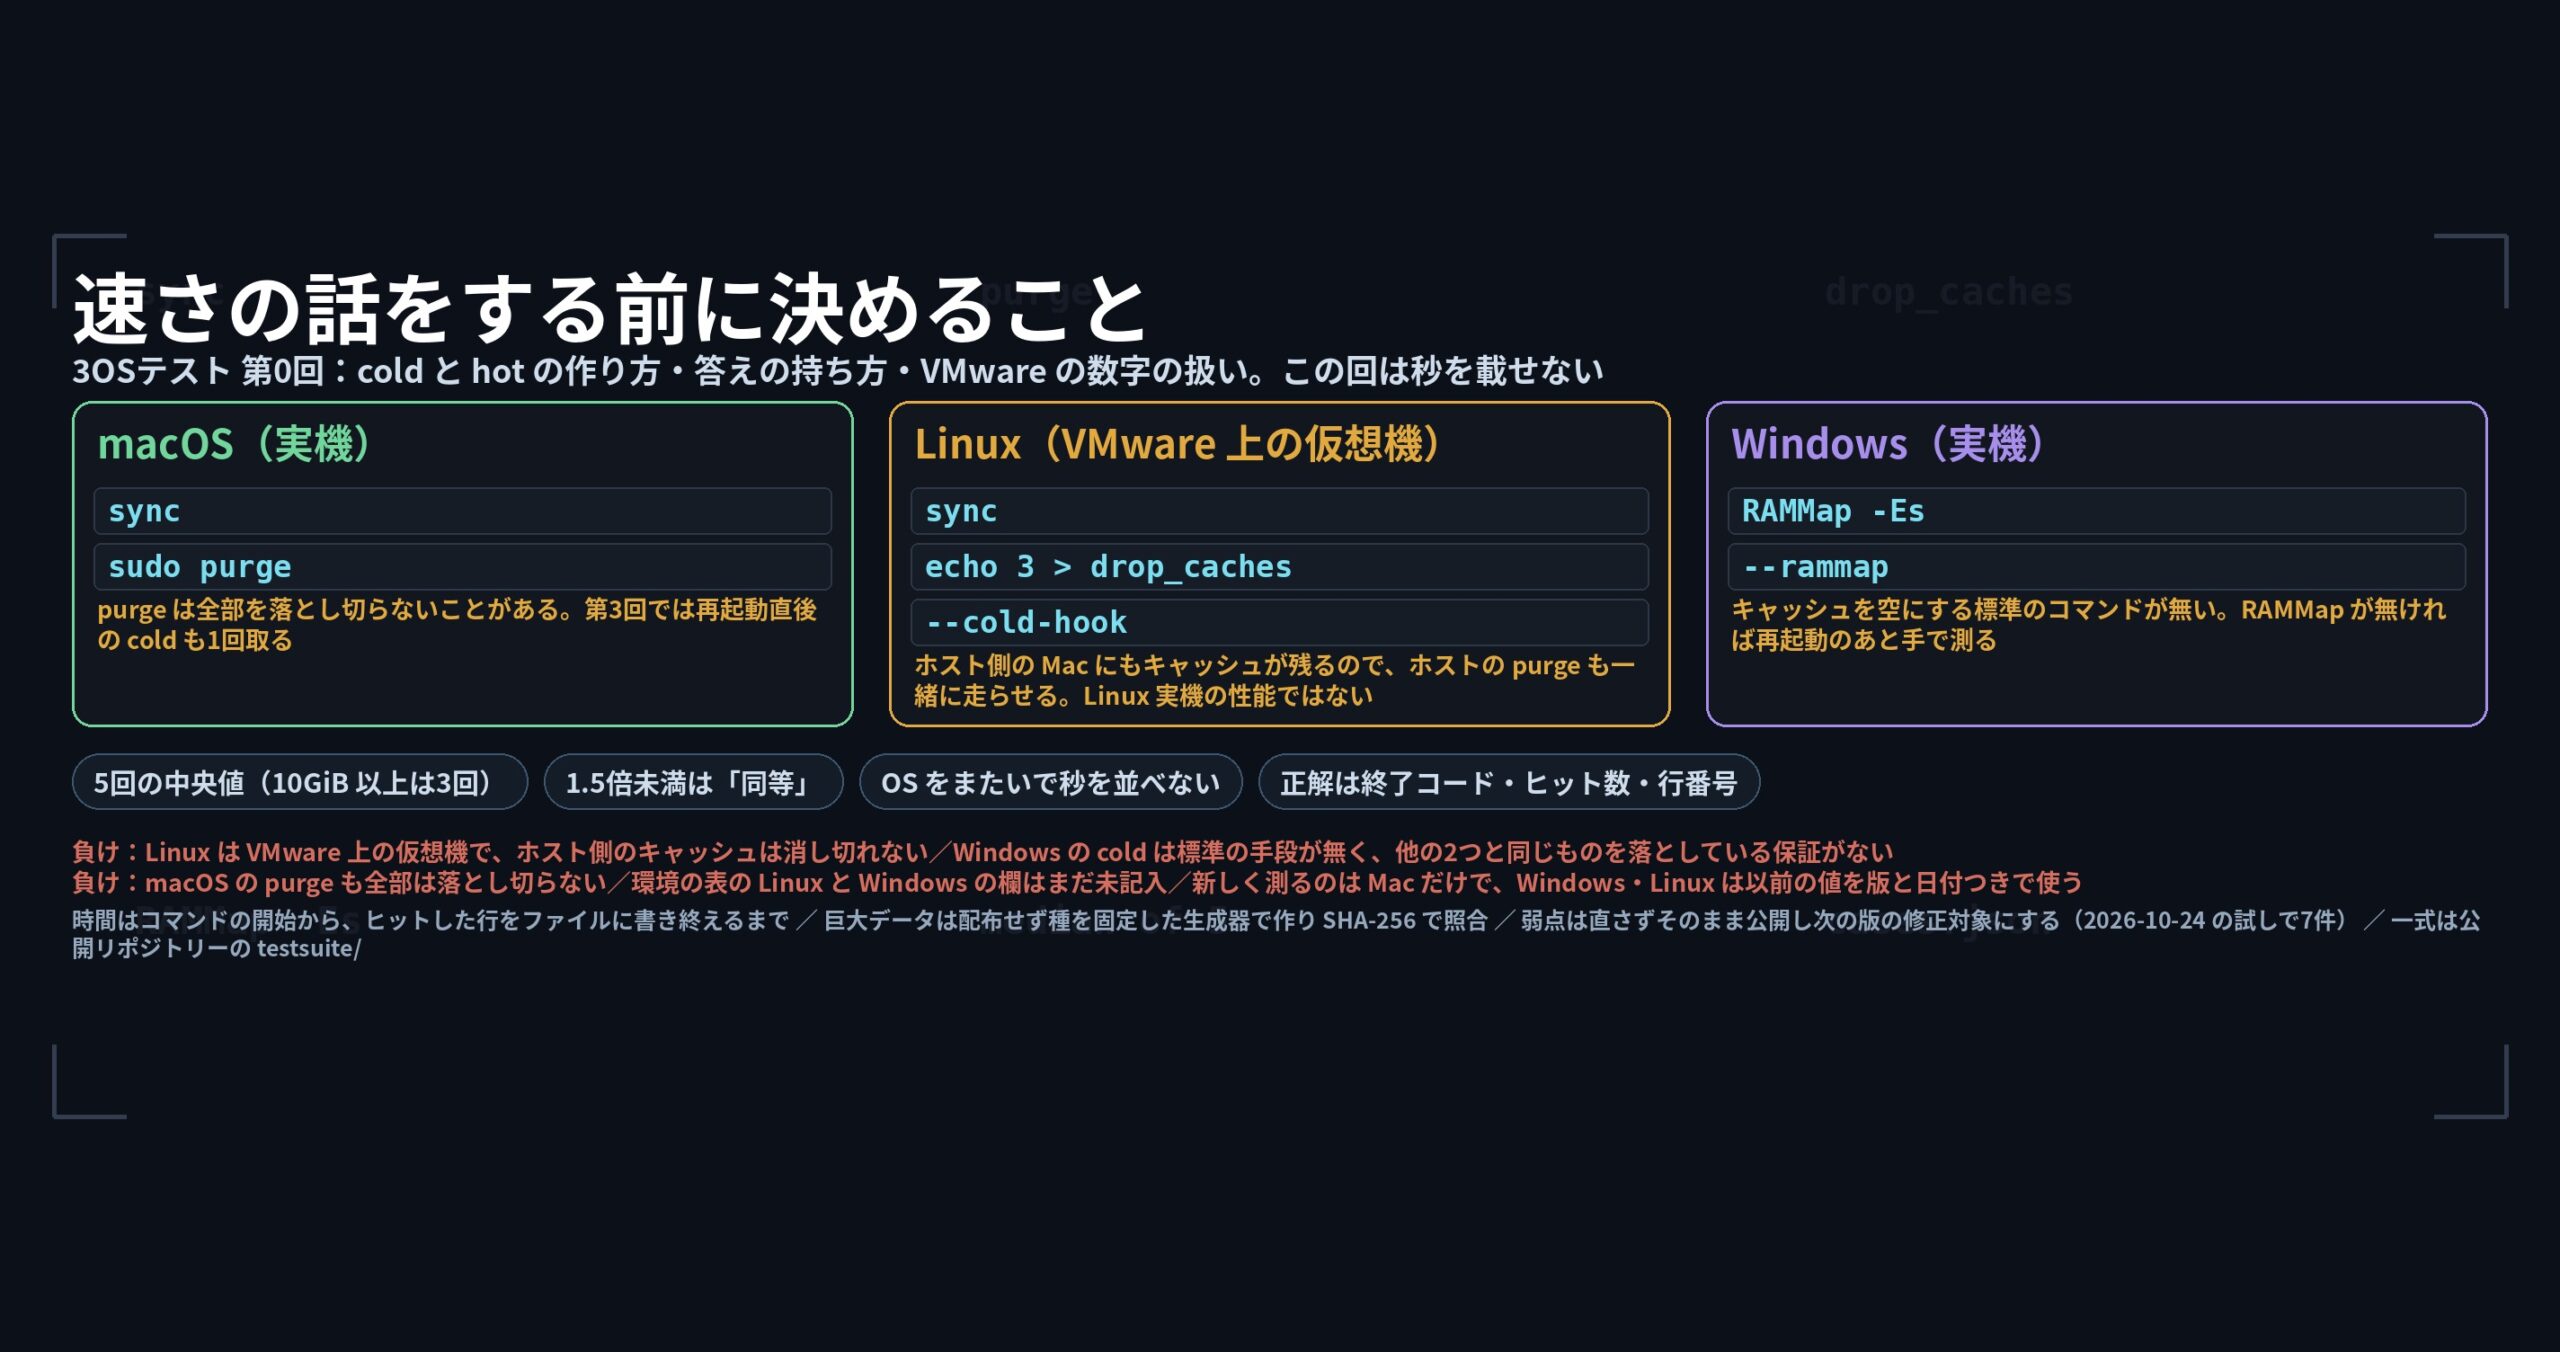
2つめ。Windows には、ファイルキャッシュを空にする標準のコマンドがありません。 macOS には purge、Linux には drop_caches がありますが、Windows は外部の道具(RAMMap)を持ってくるか、再起動して手で測るしかありません。同じ「cold」という言葉が、OS ごとに違う手順を指しています。
3つめ。macOS の purge も、全部を落とし切らないことがあります。 第3回(cold と hot)では、再起動した直後の cold も別に1回取ります。
そのうえで決めたことを並べます。
- 時間は、コマンドを起こしてから終わるまで。 ヒットした行をファイルに全部書き終えるところまで含めます。ピークメモリ(RSS)も一緒に記録します
- cold・hot・first の3通り。 first は「そのセッションでそのファイルを最初に探したとき」で、中央値から分けて出します
- 1件につき5回、10GiB 以上のファイルは3回。中央値を出し、最小と最大も残します
- 実メモリの6割を超えるファイルは cold だけ(hot にならないので)
- 答えは
cases.jsonが持っています。 終了コード・ヒットした行の数・(大事なところでは)行番号そのものまで。全部一致したときだけ正解です - 1.5倍未満の2つの値は「同等」と書きます。 向きだけ添えます
- 秒は同じ機械の中でだけ比べます。 OS をまたいで秒を並べません
- 見つかった弱点は、直さずにそのまま公開します
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この回の内容は、公開リポジトリーのtestsuite/にある手順書と結果の様式そのものです。この回は秒を載せません。 連載で新しく測るのは Mac だけで、Windows と Linux は以前に測った値を使います。その場合は測った版と日付を必ず添え、Mac の新しい値と同じ版の比較のようには書きません。
問題: 「速い」と書いた本人も、半年後には再現できない
ベンチマークの記事がもめるのは、たいてい数字そのものではありません。条件が足りないことです。
キャッシュが温まっていたのか、初回だったのか。何回測った中のどれなのか。ヒットが0件の検索なのか、ほぼ全行がヒットする検索なのか。そもそも答えが合っていたのか。最後のひとつが抜けている記事は、わりとあります。速く終わったけれど結果が間違っていた、は「速い」ではありません。
自分で測っているときも同じです。半年前の自分が残した「10GB が 0.3 秒」というメモは、条件が無ければ次に測ったとき合わない理由が分からないメモです。
だから、連載を始める前に手順を一式にして、公開リポジトリーに置きました。記事に出てくる秒は、すべてそこの CSV から持ってきます。 記事が先にあって数字を探すのではなく、数字が先にあって記事を書きます。
テスト条件
3台の機械
| 機械のラベル | 中身 | メモリ | 保存先 | ファイルシステム | 種類 |
|---|---|---|---|---|---|
mac-m4-32g-usbssd |
MacBook Air(Apple M4・10コア) | 32GB | 外付け USB SSD | APFS | 実機 |
linux-vmware-fusion |
上の Mac の上の VMware Fusion ゲスト | 未記入 | 仮想ディスク(置き場所は未記入) | ext4 | 仮想機 |
win11-16g |
Windows 11 ノート | 16GB | 内蔵 SSD | NTFS | 実機 |
未記入の欄は、まだ埋まっていません。 本番の測定を走らせると env.json が自動で書くので、埋まってから各回の表に出します。いま分かっている形だけを先に出しています。
版は uvf --version / uvp --version から読み取って、1回ごとの結果に一緒に保存します。OS の版・CPU・コア数・メモリ・ファイルシステム・仮想化の有無も同じところに入るので、手順書と CSV が食い違いません。
データ
巨大なデータは配布しません。tools/gen.py が種を固定して作るので、どの OS で作っても同じバイト列になります。作ったデータは tools/check.py data で SHA-256 を照合します(照合用の一覧は13分類ぶん置いてあります)。x86_64 と aarch64 で一致することは確認済みです。
小さいデータ(文字コード・改行・日本語の文字・壊れたファイル)は、そのまま読めるようにリポジトリーに入れてあります。
100GB の回を回すには、作業用に 250GB ほどの空きが要ります。作業フォルダーはリポジトリーの外に置きます。
cold の作り方(OS ごと)
ここが一番 OS で違うところです。同じ「cold」という言葉が、3通りの手順を指しています。
| OS | cold の作り方 | 注意 |
|---|---|---|
| macOS | sync のあと sudo purge |
purge が全部を落とし切らないことがある。第3回では再起動直後の cold も1回取る |
| Linux(VMware) | sync のあと drop_caches に 3 を書く |
ホスト側の Mac にもキャッシュが残る。 --cold-hook でホスト側の purge も一緒に走らせる |
| Windows | RAMMap の -Es(待機リストを空にする)を --rammap で指定 |
標準のコマンドが無い。 RAMMap が無ければ再起動のあと手で測る |
hot は「直前に一度読んだ状態」です。記録しない空回しを1回入れてから測ります。first は「そのセッションでそのファイルを最初に探したとき」で、uvp は最初の1回とその後で大きく違うので、中央値とは分けて両方出します。
画面の測り方
画面(UwView・UwView Pro・Web 版)の時間は、自動では測れないのでストップウォッチで手で測ります。 3回の中央値です。開くときは「開くを押した瞬間」から「状態表示の行数が動かなくなるまで」、末尾へ飛ぶときは Ctrl/Cmd+End から最後の行が出るまで、検索は検索欄で Enter を押してからヒット数が確定するまで、と始点と終点を決めてあります。
結果: 数字の読み方として決めた7つ
この回に秒はありません。代わりに、15回ぶんの数字をどう読むかの決まりです。
| 決まり | 中身 |
|---|---|
| 時間の範囲 | コマンドの開始から終了まで。ヒットした行をファイルに書き終えるところまで含む |
| 回数 | 1件につき5回(10GiB 以上は3回)。中央値を出し、最小と最大も残す |
| 大きすぎるファイル | 実メモリの6割を超えるものは cold だけ測る |
| 同等の線 | 1.5倍未満の2つの値は「同等」と書く。向きだけ添える |
| OS をまたがない | 秒は同じ機械の中だけで比べる。OS をまたいで並べない |
| 版と日付 | どの表にも製品の版と測った日を書く |
| 正解の定義 | 終了コード・ヒット数・(大事なところでは)行番号が全部一致したときだけ ok |
最後の行が、この一式で一番手間をかけたところです。速さだけを測るなら答え合わせは要りません。でも、間違った答えを速く返す道具に価値はありません。
結果は4つのファイルに分かれて出ます。1回ごとの生の行(runs.csv)、製品×ケース×キャッシュでまとめた中央値(summary.csv)、そのうち答えが違ったもの・落ちたもの・時間切れになったものだけを抜いたもの(failures.csv)、そして環境(env.json)です。記事に出す秒は summary.csv の中央値、記事に出す弱点は failures.csv から採ります。
終了コードは 0 がヒットあり、1 がヒットなし、2 がエラーまたは結果が不完全、です。
負け: 穴を3つ開けたまま始めます
1. Linux は仮想機です。 VMware Fusion のゲストなので、仮想化の分が秒に乗っています。「Linux 実機ならこうなる」とは書けません。 しかもホスト側のキャッシュという、Linux の中からは見えない変数があります。--cold-hook でホストの purge も走らせますが、ホスト側の揺れが完全に消えるとは言えません。
2. Windows の cold は、他の2つと手順が違います。 RAMMap を持ってきて待機リストを空にするか、再起動して手で測るか。どちらにしても、purge や drop_caches と同じものを落としている保証はありません。 Windows の cold だけは、他の OS の cold より条件が緩いと思って読んでください。
3. 環境の表が、まだ埋まり切っていません。 Linux の vCPU 数・メモリ・仮想ディスクの置き場所と、Windows の細かい条件は未記入です。本番で env.json が埋めますが、今日の時点では3台そろっていません。
そしてもう1つ、連載の作り方そのものの断り書きです。新しく測るのは Mac だけです。 Windows と Linux は以前に測った値を使います。版が違うので、Mac の新しい値と横に並べて「同じ版の比較」のようには書きません。 以前の値が無いテスト(日本語特有の回など)は Mac だけを出して「Windows・Linux は未測定」と書きます。
正しさ: 弱点は直さずに出します
この連載で一番はっきりさせておきたいのは、ここです。
間違った答え・落ちたもの・固まったものは、直してから公開しません。 見つかった版と一緒に弱点の一覧に載せ、次の版の修正対象にします。 直ったら続編を書きます。
スイートを組み立てている途中(2026年10月24日・Linux x86_64 と Mac での試し)で、すでに7件が記録されています。中身は第5回・第6回・第10回で扱うので、今日は件数だけにします。マニュアルに「対応していない」と書いてある組み合わせは「documented」として、弱点とは別に並べています。
ひとつだけ補足すると、7件のうち1件(UTF-32)は次の版で直る見込みとして記録済みです。無料版のコマンドと画面が、有料版と同じように UTF-32 を断るようになります。この「見つかった→直した」の往復を、そのまま連載に出すのが狙いです。
答えが1つに決まらないものは obs として、正解・不正解とは別に記録します。たとえば結合文字の正規化(NFC と NFD)は、どちらを正解とすべきか製品側の決めの問題なので、観測として残しています。
持ち帰れる一般論: 自分の測定でも、この3つを書いておくと後で助かる
この連載を見なくても使える話に落とします。何かの速さを測ってメモを残すとき、条件のうちどれを書くかです。
1つめ。キャッシュの状態を、言葉ではなく手順で書きます。 「cold で測った」は条件ではありません。「sync のあと sudo purge を打って2秒待ってから」までが条件です。同じ言葉が OS ごとに違う手順を指すなら、言葉のほうは当てになりません。
2つめ。何回測って、どれを採ったかを書きます。 1回だけ測った値は、速い方に寄っていることも遅い方に寄っていることもあります。中央値を採るなら最小と最大も残しておくと、後から「その日は揺れていた」と分かります。 揺れの幅を捨てると、次に測ったとき違う理由が分かりません。
3つめ。答えが合っていたかを、一緒に記録します。 速さの記録に正誤の列を1本足すだけで、「速くなったがおかしくなった」を測った瞬間に見つけられます。後から気づくと、どの変更が原因か分からなくなります。
4つめ。差と呼ぶ線を、先に決めておきます。 この連載は 1.5 倍にしました。線を先に決めておかないと、都合のよいときだけ「差がある」と書いてしまいます。自分に対しての歯止めです。
uvp ならこう書く
一式を自分の機械で回すところまで書いておきます。
# 小さいデータを作る(1分ほど)/trial・full もある
python3 tools/gen.py --work ~/uwtest --preset smoke

# 作ったデータの SHA-256 を照合する
python3 tools/check.py data --work ~/uwtest

# 測る(既定は hot・uvf)
python3 tools/run.py --work ~/uwtest --label my-machine

# cold と hot の両方を、無料版と有料版の両方で
python3 tools/run.py --work ~/uwtest --label my-machine \
  --product uvf --product uvp --cache cold,hot

# Linux(VMware)はホスト側のキャッシュも落とす
python3 tools/run.py --work ~/uwtest --label linux-vmware-fusion \
  --cache cold,hot --cold-hook 'ssh mac-host purge'

# Windows は RAMMap の場所を渡す
python3 tools\run.py --work C:\uwtest --label win11-16g ^
  --cache cold,hot --rammap C:\tools\RAMMap64.exe

# 結果をまとめる/答えが違ったものだけ見る
python3 tools/summarize.py ~/uwtest/results/<フォルダー名> --failures
検索そのものは、無料版も有料版も同じ書き方です。
uvf japan.osm '\d+\.\d{6,}' -E -H    # 無料版(索引を作らない)
uvp japan.osm '\d+\.\d{6,}' -E -H    # 有料版(索引を使う)
無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
再現方法
この回の内容は、すべて公開リポジトリーの testsuite/ にあります。記事のほうが間違っていたら、向こうが正しいと思ってください。
- 手順の正典(この記事の元): https://github.com/amru195704/UwView/blob/main/testsuite/docs/00-rules.md
- 日本語の入口: https://github.com/amru195704/UwView/blob/main/testsuite/README.ja.md
- 機械の一覧: https://github.com/amru195704/UwView/blob/main/testsuite/docs/environment.md
- 結果の CSV の様式: https://github.com/amru195704/UwView/blob/main/testsuite/schema/results.md
- 弱点の一覧: https://github.com/amru195704/UwView/blob/main/testsuite/weak-points.md
- 一式のフォルダー: https://github.com/amru195704/UwView/tree/main/testsuite
リンク
- 前の連載の最終回(無料版 uvf の3つの直し): https://uvp.y42u.net/blog/uwview-fs05-uvf-three-fixes/
- 索引の中を UTF-8 にそろえた話: https://uvp.y42u.net/blog/uwview-fs01-sjis-utf8-index/
- 10GB の2回目はどこで縮んだか: https://uvp.y42u.net/blog/uwview-fs04-10g-second-search/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
次回からは実際の数字が出ます。第1回は「1GB から 100GB まで、3OS で開いてみる」です。
そして、同じ語を何度も探す巨大なログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。