50GB の検索に、205 秒。
「速さの道具ではありません。ripgrep があるならそちらを」——v1.6.0 のリリース文に、自分でそう書きました。ripgrep の約 4 倍。けれど、その 205 秒が何でできているのかは、まだ測っていませんでした。
測ってみると、遅さの正体はアルゴリズムではありませんでした。同じファイルを、何度も読んでいたのです。
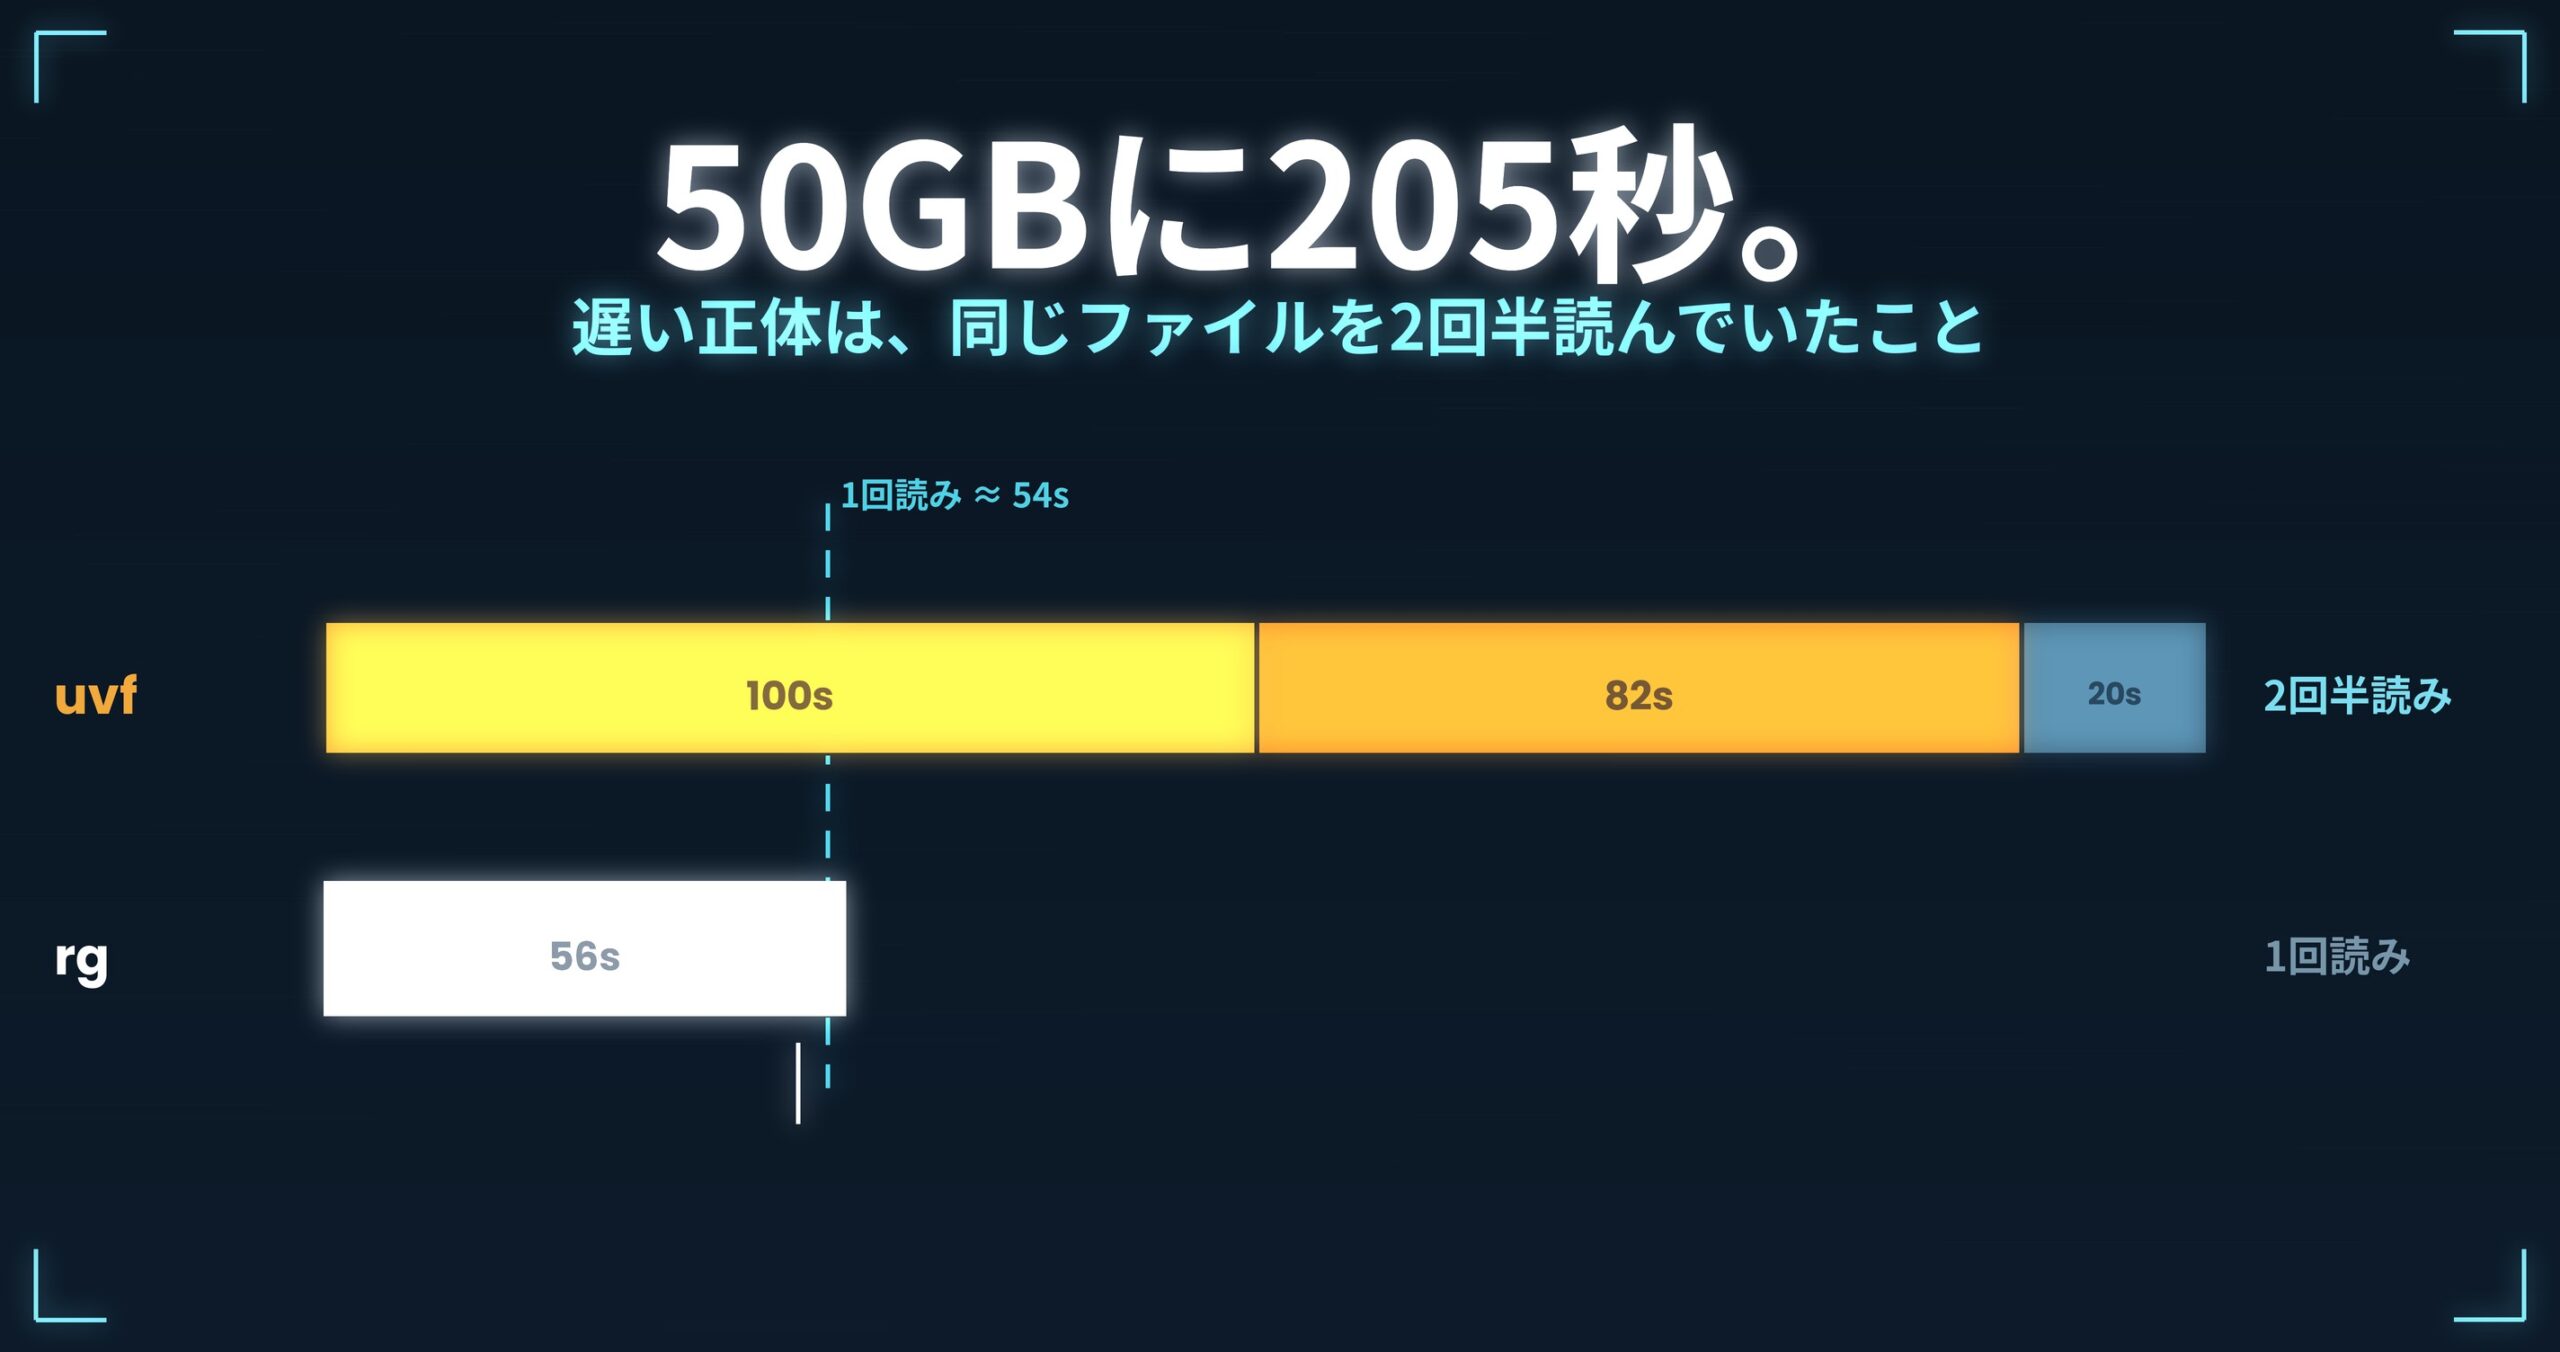
- 先に結論: 50GB の検索に 205 秒かかっていた CLI(uvf)は、ripgrep(56 秒)の約 4 倍遅い代物でした。その正体を測ると、遅いアルゴリズムではなく、同じファイルを「索引を作る 100 秒 → 検索する 82 秒 → ヒット行を読み直す 20 秒」と 2 回半も読んでいただけでした。読む回数を 1 回に畳むと 50.82 秒(962MB/s)。それでも 1 問目は今なお ripgrep に 6〜7% 負けます(索引を持つ代価)。いずれも特定環境での測定例です。詳細は記事末尾。
- 問題: 自分で「約 4 倍遅い」と書いていた
- 原因: 205 秒は「2 回半読み」だった
- 手当て: 読む回数を 1 回に畳む(次回の主題)
- 数字: 203 → 50.82 秒(1 回読み・962MB/s)
- 持ち帰れる一般論: 「遅い」には 2 種類ある
- 使っている道具
- リンク
先に結論: 50GB の検索に 205 秒かかっていた CLI(uvf)は、ripgrep(56 秒)の約 4 倍遅い代物でした。その正体を測ると、遅いアルゴリズムではなく、同じファイルを「索引を作る 100 秒 → 検索する 82 秒 → ヒット行を読み直す 20 秒」と 2 回半も読んでいただけでした。読む回数を 1 回に畳むと 50.82 秒(962MB/s)。それでも 1 問目は今なお ripgrep に 6〜7% 負けます(索引を持つ代価)。いずれも特定環境での測定例です。詳細は記事末尾。
この記事は「First Light」連載の第 1 回です。UwView という巨大ファイルビューアを、v1.6.0 から v1.6.6 まで「読む回数」だけを頼りに速くしていった記録を、1 本 1 テーマで書きます。数字はすべて同じ機械の実測で、勝っている数字も負けている数字もそのまま出します。
問題: 自分で「約 4 倍遅い」と書いていた
UwView は巨大テキスト・巨大ログのビューアです。v1.6.0 でコマンド(有料版 uvp/無料版 uvf)を付けたとき、リリース文にこう書きました。「これは速さの道具ではありません。ripgrep があるならそちらを使ってください」。
そう書くだけの理由はありました。51.25GB の 1 本のファイル(OpenStreetMap 日本の XML)を「東京」で検索させると、uvf は 205 秒(v1.6.2 以前は 203 秒)。同じ機械・同じファイルで ripgrep は 56 秒です。約 4 倍。正直に「負けています」と書くしかありませんでした。
ただ、「負けている」で止めると、次にどこを直せばいいのか分かりません。205 秒が何でできているのかを、まず分解しました。
原因: 205 秒は「2 回半読み」だった
処理を段に分けて時間を測ると、こうなっていました。
| 段 | やっていること | 時間 | 読んだ量 |
|---|---|---|---|
| ① 索引を作る | ファイルを頭から終わりまで読み、改行の位置を数える | 100 秒 | 全体を 1 回 |
| ② 検索する | もう一度ファイルを頭から読み、語に一致する行を探す | 82 秒 | 全体を 1 回 |
| ③ 出力する | 一致した行の本文を、また読み直して並べる | 20 秒 | ヒット行だけ(約半分ぶん) |
| 合計 | 約 205 秒 | 2 回半 |
遅さの正体は、アルゴリズムの賢さでも、言語(C#)の速さでもありませんでした。同じ 51.25GB を、索引で 1 回・検索で 1 回・出力でもう半分、合わせて 2 回半読んでいた——ただそれだけです。
ripgrep が速いのは、魔法だからではありません。読みながら探して、そのまま出す。ファイルを 1 回しか読まないからです。こちらは 3 つの仕事(数える・探す・書き出す)を、それぞれ別のパスに分けて実装していたので、そのぶん読む回数が増えていました。「速いコードを書く」以前に、「同じものを何度も読まない」という当たり前が抜けていたわけです。
ディスクの素読み速度には上限があります。この外付け USB SSD は素読みで約 950MB/s。51.25GB を 1 回読むだけでも約 54 秒はかかります。2 回半読めば、それだけで約 135 秒。205 秒の大半は、この「読み直し」でできていたという計算に合います。
手当て: 読む回数を 1 回に畳む(次回の主題)
直し方は「3 つのパスを 1 つにまとめる」——読んでいる最中に、改行を数え、語に一致するか確かめ、当たった行はその場で出力に回す。1 回読み切ったら、もう答えは手元にある、という形です。この 1 パス設計そのものは、次の第 2 回で詳しく書きます。
10 個の改善をまとめて 1 本にした版は、Qiita に置いてあります(50GB の検索が 205 秒→51 秒)。この連載では、そこで束ねた話を 1 テーマずつほどいていきます。
数字: 203 → 50.82 秒(1 回読み・962MB/s)
3 つのパスを 1 つに畳んだ結果、uvf の 50GB 検索は 203 秒 → 50.82 秒になりました。読み出しの速さに直すと 962MB/s——ディスクの素読み上限にほぼ届いています。作業メモリは 57MB(ファイルサイズに関係なく一定)。
やったことは「速いアルゴリズムに置き換えた」ではありません。読む回数を 2 回半から 1 回に減らしただけです。速さの正体が「読む回数」だったので、そこを削るのがいちばん効きました。
この 1 回読みは、後にコマンドだけでなく画面(GUI)にも広げ、v1.6.6 で「開く・探すがディスクの素読み速度に届く」ところまで来ました。
v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
そして正直に書くと、1 問目は今なお ripgrep に 6〜7% 負けます。索引(.uwvz)を残すぶんの代価で、これは消せません(詳しくは末尾の CLI の節と最終回で)。
持ち帰れる一般論: 「遅い」には 2 種類ある
自分のツールが遅かったとき、原因は大きく 2 つに分かれます。ひとつはアルゴリズムが遅い(計算のしかたが悪い)。もうひとつは同じデータを何度も読んでいる(I/O の回数が多い)。前者はコードの書き換えが要りますが、後者は「読む回数を数える」だけで見つかり、たいてい後者のほうが効きます。
巨大ファイルでは、ディスクの素読み速度が天井になります。天井が 950MB/s なら、50GB を 1 回読むのに約 54 秒。「何秒かかったか」を、まず「何回読んだか × 1 回ぶんの時間」に分解する。それだけで、直すべき場所が「コード」なのか「読み方」なのかが見えます。私の場合、答えは「読み方」でした。
使っている道具
この記事の題材はコマンドそのものなので、末尾にも実際の書き方を置いておきます。
コマンドラインから同じことをする
v1.6.0 で uvp コマンドが付きました(無料版には uvf)。GUI と同じ .uwvz を使うので、CLI で作った索引はそのまま GUI でも効きます。
# 1回読みで、語があるかだけ確かめる(無料版)
uvf japan-latest.osm '東京'

# 大文字小文字を無視して探す
uvf app.log 'error' -i

# 前後の文脈ごと見る
uvf huge.log 'FATAL' -C 5

# CLI で探した結果を、そのまま GUI に渡して開く
uvf access.log ' 503 ' -open
終了コードは grep と同じ 0=あり・1=なしで、if uvf access.log ' 503 '; then がそのまま書けます。
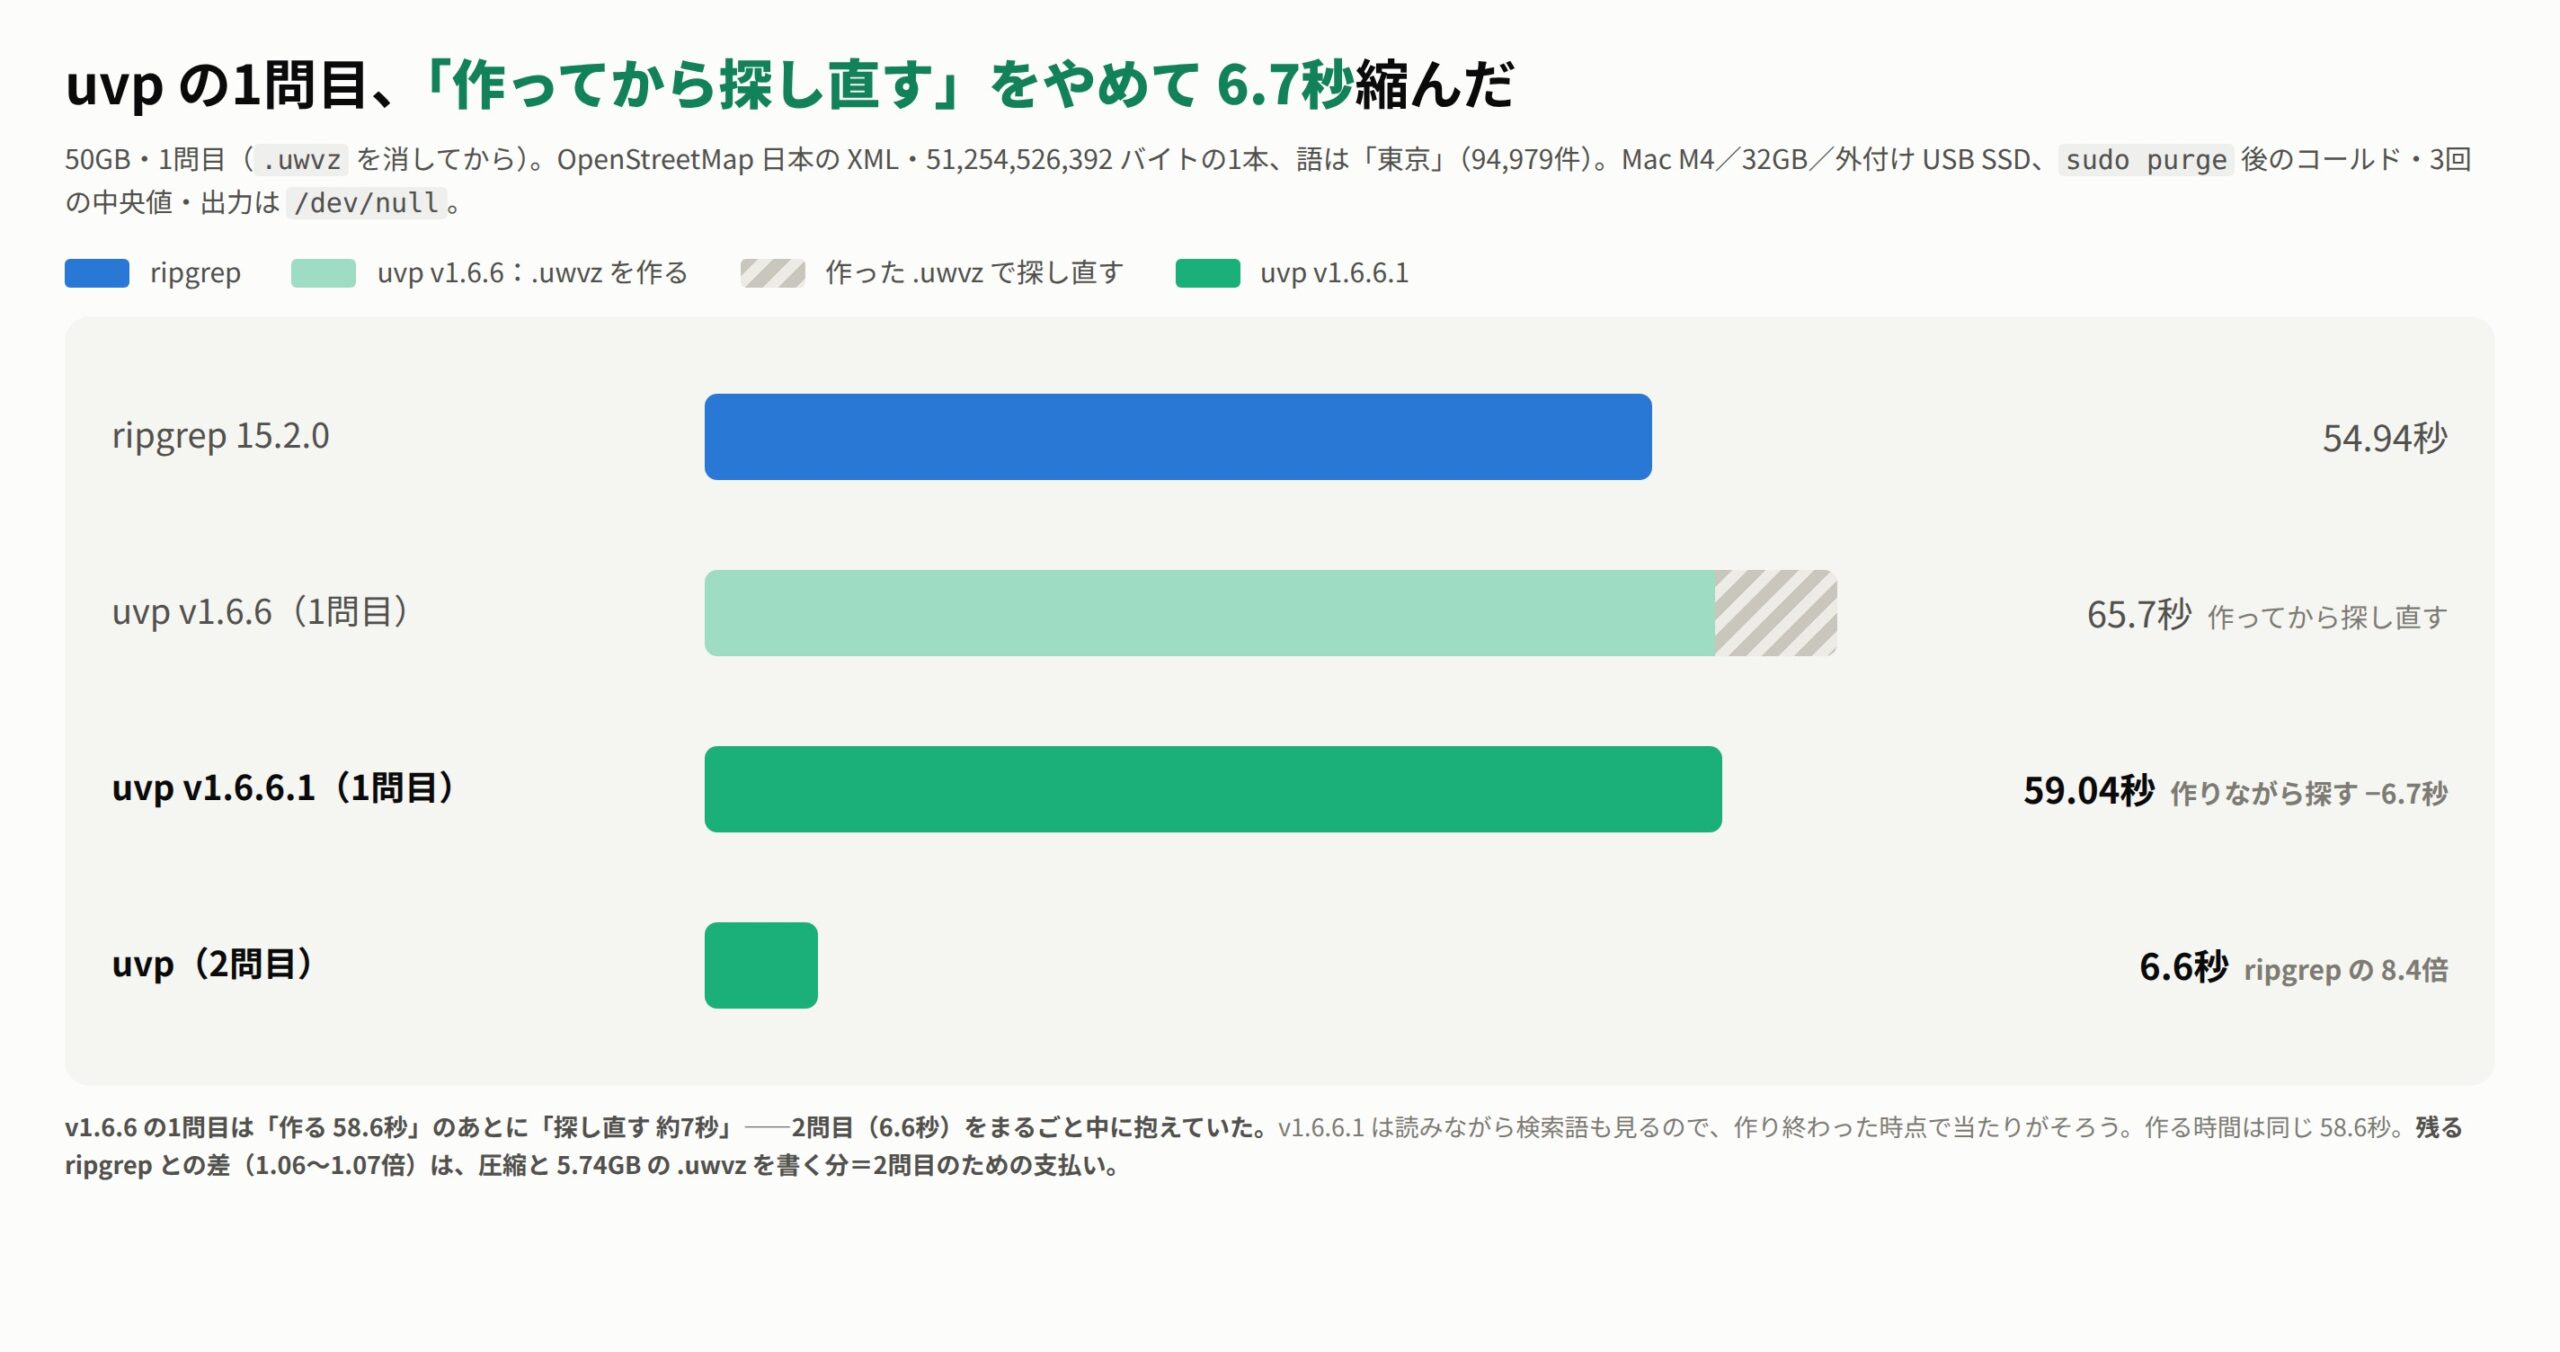
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.6 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- Qiita: 50GB の検索が 205 秒→51 秒(10 の改善をまとめた版): https://qiita.com/amru195704/items/3cb6451815624aeced73
- uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- 3 サイズでのベンチマーク: https://uvp.y42u.net/blog/uwview-pro-benchmark-3sizes/
- ソースコード(GitHub): https://github.com/amru195704/UwView
同じファイルを何度も開いて検索するなら、索引と圧縮を保存する UwView Pro が効いてきます。2 問目以降は行番号付きで瞬時に開き直せ、約 1/9 に圧縮したまま検索できます(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。