パフォーマンス

技術解説

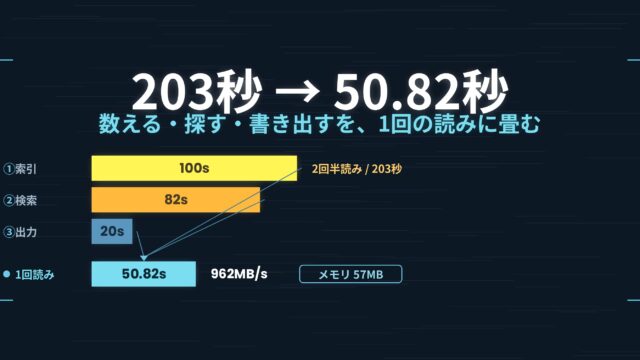
自作CLIを ripgrep 並みの速さにした — 改善記②:2回半読みを1回に畳んで 203秒→50.82秒

203 秒が 50.82 秒に。 コードを速く書き直したわけではありません。並列化もしていません。減らしたのは、同じファイルを読む回数だけです。では「数える・探す・書き出す」という 3 つの仕事を 1 回の読みに畳むと、…
技術解説
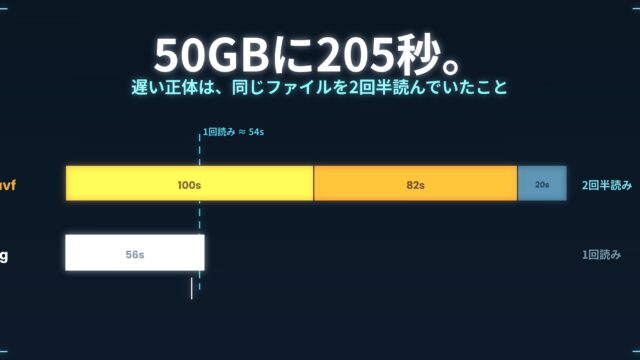
自作CLIが50GBの検索で ripgrep に3.7倍負けた — 改善記①:205秒の内訳を測る

50GB の検索に、205 秒。 「速さの道具ではありません。ripgrep があるならそちらを」——v1.6.0 のリリース文に、自分でそう書きました。ripgrep の約 4 倍。けれど、その 205 秒が何でできて…
技術解説

less で十分、が崩れる瞬間 — コマンドライン職人芸の限界線4本

【追記 2026-10-16】いまの速さ — 1問目は今も同等。2問目からと集計で差が出ます 本文の uvp と ripgrep の数字は、v1.6.6.1(2026年9月)に Mac(外付け USB SSD)で測った値…
技術解説

ファンレスMacでベンチを取ったら54%ブレた — サーマルスロットリングとラウンドロビン計測

検索エンジンのスレッド数スケーリングを実測したときの話です。本編の結果は別記事に書きました。今回はその裏側——最初の計測結果を丸ごと捨てた話をします。ベンチマークを取る人には他人事ではないはずです。 --- 1スレッドか…
技術解説

検索スレッドは何本が正解か — 8.9億行を1〜16スレッドで実測した

大きなテキストを並列検索するとき、スレッドは何本にすべきか。「コア数ぶん」「コア数×2」「物理コアまで」——通説はいろいろありますが、自分のアプリの、実物のデータで測った数字がいちばん信用できます。 UwView Pro…
技術解説

51GB・8.9億行を開いて、理論上どこまで開けるのか計算してみた — 実データと「約920京行」の話

大容量テキストビューア「UwView」をGitHubで公開した記事では「最大2億行クラスを高速に閲覧できる」とうたっていました。ただ、それまでの実測は行番号を振っただけの合成データでのもの。「実際の、しかも桁違いに大きい…
技術解説

8.9億行を開いたテキストビューアは、理論上どこまで開けるのか?

「最大2億行」とうたっていた自作の大容量テキストビューア「UwView」で、先日OpenStreetMap日本全域をXML化した51GB・約8.9億行のファイルが問題なく開けたことを確認しました。総行数はwc -lと1行…