2回目は OS が速い。
同じログを2回探すと、2回目が一瞬で終わることがあります。これを「このソフトは速い」と受け取ると、判断を1つ間違えます。実際に速くしているのは OS のファイルキャッシュで、ソフトは2回目も同じ仕事をしているだけです。
では、その差はどれくらいで、どこまで信じていいのでしょうか。そして、1回しか測らなかった cold の値は、どのくらい当てになるのでしょうか。
今回は 1GiB のログで cold と hot を5回ずつ測り、中央値だけでなく5回の幅まで並べます。差は大きく出ました。大きく出たせいで、測り方のほうに穴が1つ見つかりました。
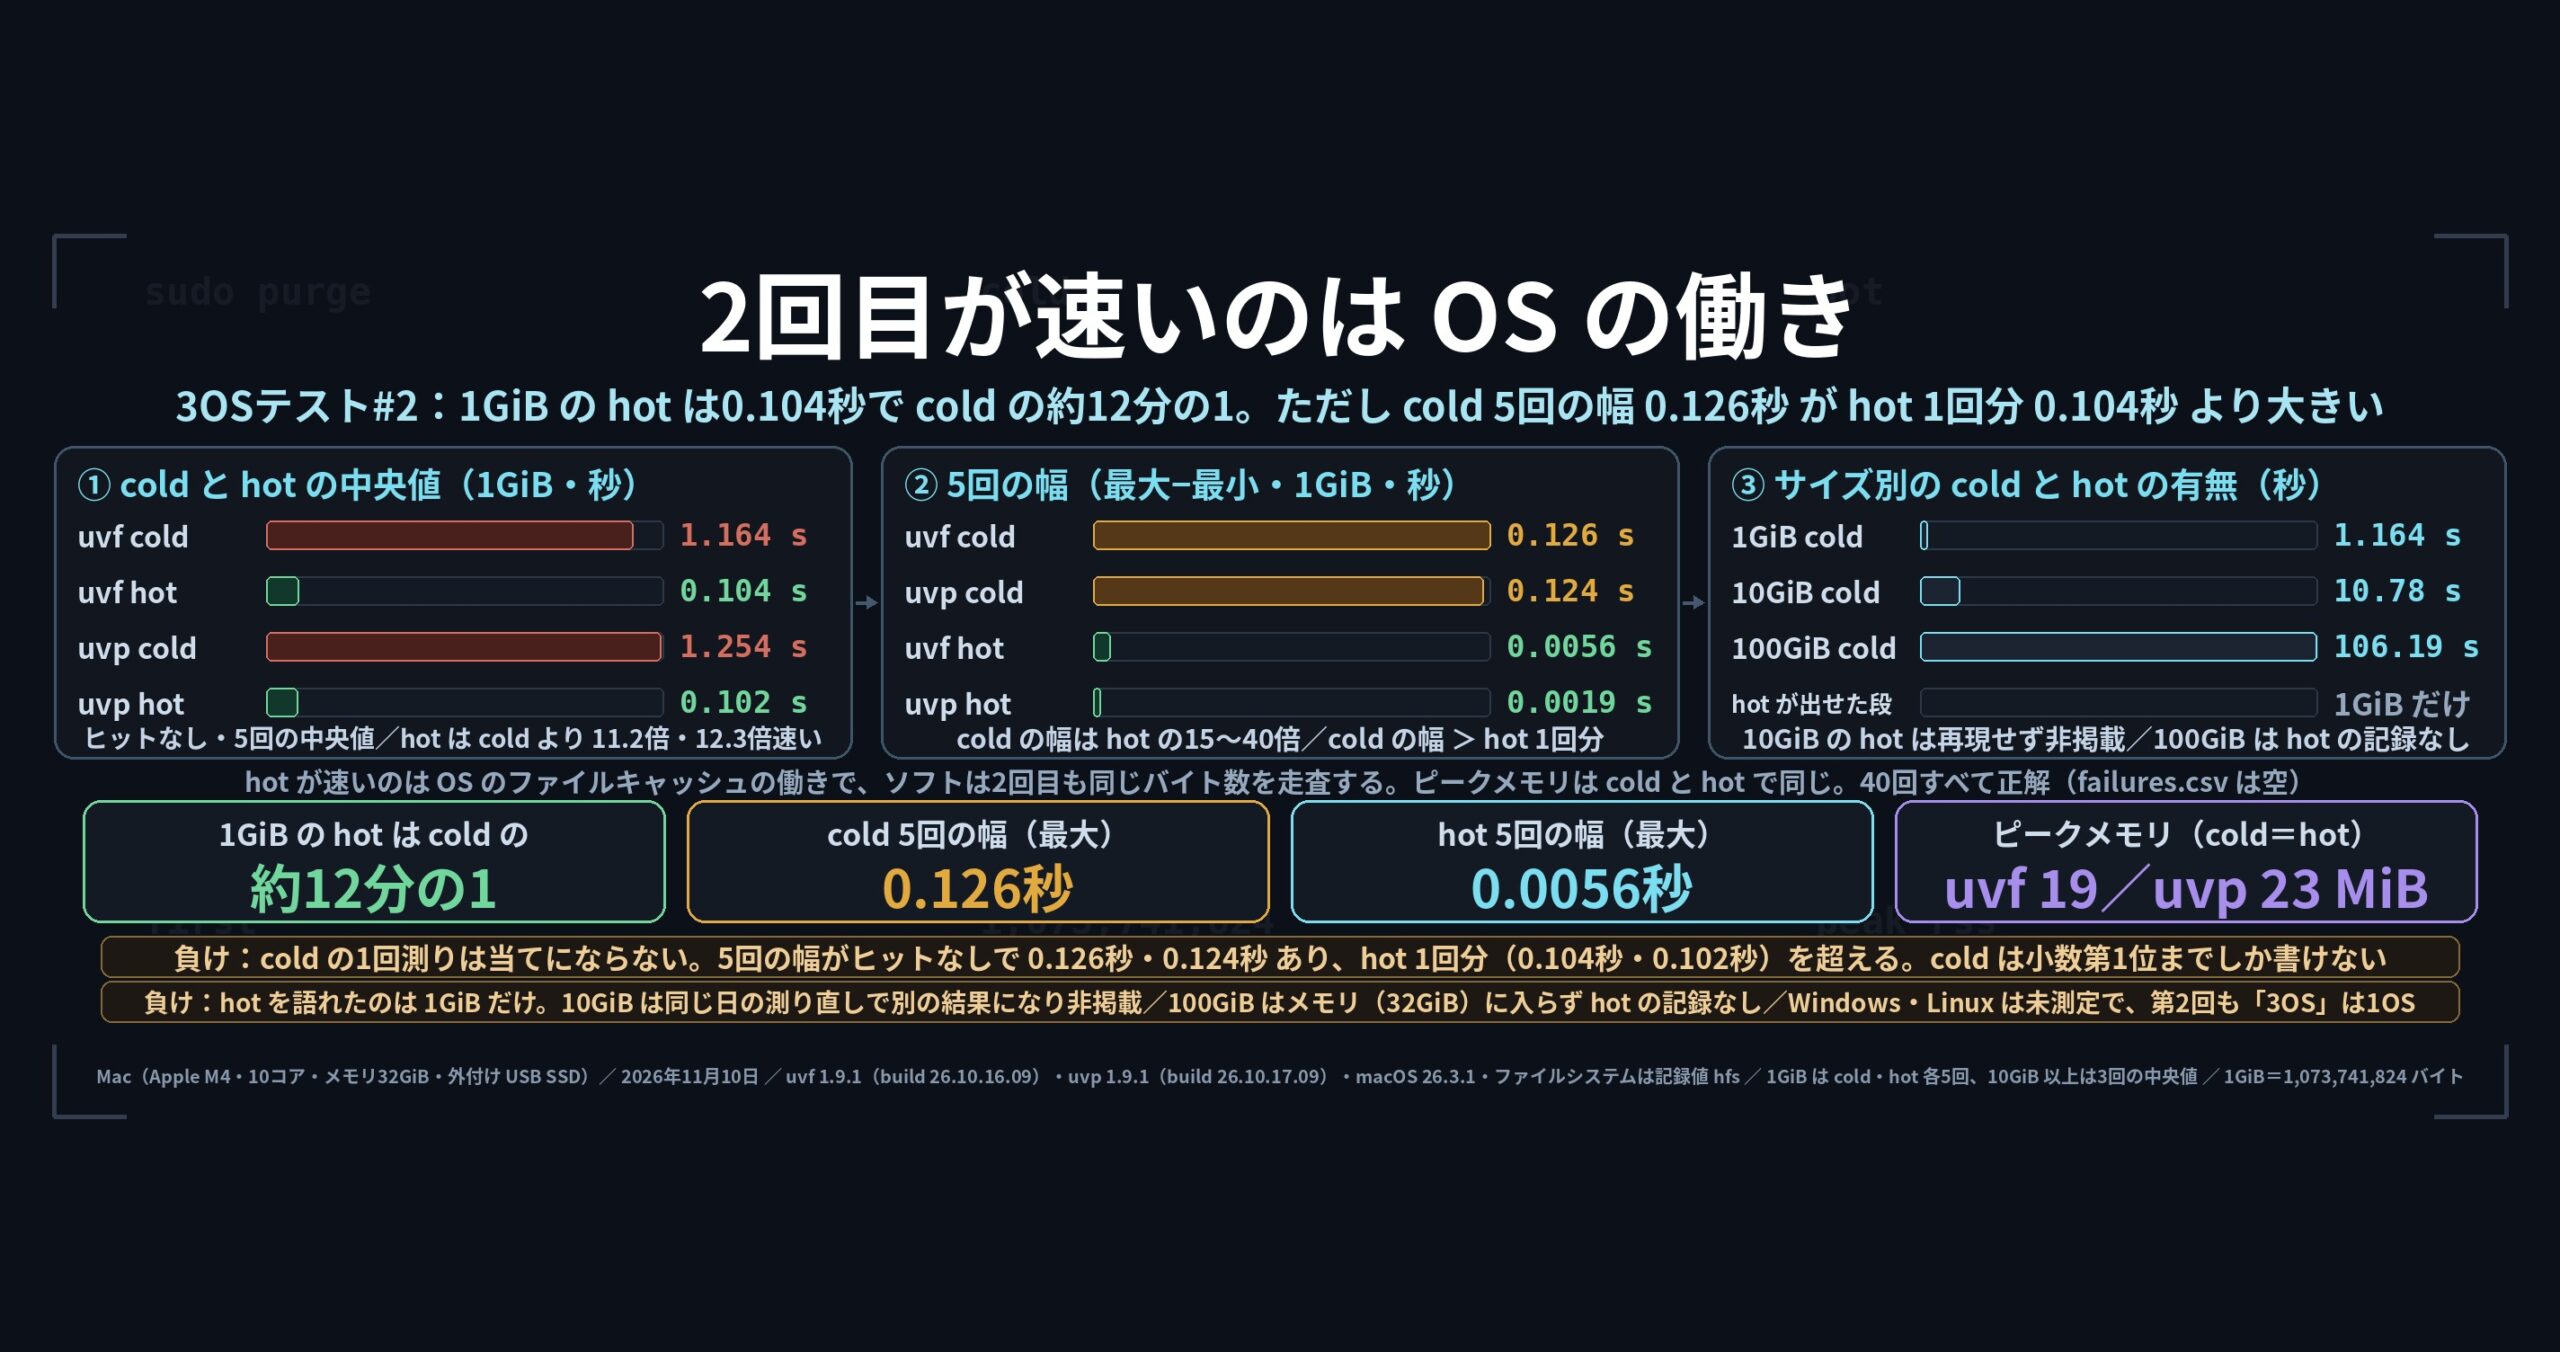
先に結論: hot は cold の約12分の1。ただし cold は5回で0.126秒ぶれ、その幅が hot 1回分より大きい
負けを先に書きます。
1つめ。cold の1回測りは当てになりません。 1GiB・ヒットなしの cold を5回測ると、uvf は 1.126〜1.251秒、uvp は 1.137〜1.261秒に散りました。幅は 0.126秒・0.124秒です。同じ条件の hot 1回分が約0.102〜0.104秒なので、cold の測定誤差だけで hot 1回分を超えています。 「cold 1.13秒」と1回だけ測って書いたら、中央値より 1.03 倍速い数字を出していたことになります。
2つめ。hot が使えるのは、メモリに収まるサイズだけです。 100GiB(107,374,182,400バイト)はメモリ(32GiB)に入らないので、結果の CSV に時間ではなく file does not fit in memory: hot is the same as cold という skip が記録されました。10GiB は同じ日に測り直したら別の結果になったので、この記事では数字を出しません。cold と hot の差を語れるのは 1GiB だけでした。
そのうえで、確かめられたことを並べます。
- 1GiB の hot は cold の約12分の1。 uvf は 1.16秒 → 0.104秒(cold より 11.2 倍速い)、uvp は 1.25秒 → 0.102秒(12.3 倍速い)。ヒット3件のケースでも 12.3 倍・12.1 倍で、ほぼ同じ比です
- hot は cold よりずっと安定しています。 hot 5回の幅は 0.0019〜0.0056秒で、cold の幅(0.082〜0.126秒)の 15分の1から40分の1でした。読む場所がディスクからメモリに変わるので、ばらつく余地が減ります
- ピークメモリは cold と hot で変わりません。 uvf は約19MiB、uvp は約23MiB で、2回目も同じでした。速くなったぶんをソフトが抱え込んでいるわけではないということです
- 「そのセッションで最初の1回」は cold と同等でした。 4つのケースで first と cold の中央値の差は 1.00〜1.09 倍。
sudo purgeで作った cold は、本当の初回と同じ状態を再現できていました - 無料版 uvf と有料版 uvp は、このテストでは同等でした。 最も開いたところで 1.08 倍(1GiB・ヒットなしの cold で uvf のほうが速い)で、この連載の「1.5倍未満は同等」の線の中です
uvfは無料版 UwView、uvpは有料版 UwView Pro の検索コマンドです。数字はすべて 2026年11月10日に Mac(Apple M4・10コア・メモリ32GiB・外付け USB SSD)で測った結果の CSV から採りました。版は uvf 1.9.1(build 26.10.16.09)・uvp 1.9.1(build 26.10.17.09)、macOS 26.3.1。この回は Mac だけで、Windows と Linux は未測定です。 cold・hot の作り方と数字の読み方は第0回で決めたとおりです。※ファイル容量の表記について:本記事の「1GiB」「10GiB」「100GiB」はバイト÷1024³の値で、それぞれ 1,073,741,824/10,737,418,240/107,374,182,400 バイトです。macOS の容量表示(SI・÷1000³)では 1.07GB/10.74GB/107.37GB と表示されます。
問題: 「2回目から速い」は、誰の性能なのか
ベンチマークを読むとき、cold と hot のどちらの数字を見ているかで結論が変わります。
hot が速いのは、1回目にディスクから読んだ内容が OS のファイルキャッシュに残っていて、2回目はメモリから読めるからです。ソフトは2回目も同じバイト数を同じように走査しています。 つまり hot の数字は、ソフトの性能というより「メモリから読んだときの上限」に近いものです。道具を選ぶときに hot だけを見ると、どの道具もだいたい同じという結論になりやすく、選ぶ役に立ちません。
逆に cold だけを見るのも危ないところがあります。cold はディスクの読み出しに張り付くので、こちらも道具の差が出にくいうえに、キャッシュを消す手順が1回ごとに入るため値がぶれます。どれくらいぶれるのかを知らないまま「1.13秒と1.25秒だから1割違う」と読むと、誤差を差だと思い込みます。
そこで今回は、1GiB の同じファイルに対して cold と hot を5回ずつかけ、中央値と一緒に最小・最大・幅を出しました。あわせて「そのセッションで最初の1回」(first)を中央値と分けて記録し、purge で作った cold が本当の初回と同じなのかも確かめています。
テスト条件
機械(この回は Mac だけ)
| 機械のラベル | 中身 | メモリ | 保存先 | ファイルシステム | 種類 |
|---|---|---|---|---|---|
mac-m4-32g-usbssd |
MacBook Air(Apple M4・10コア) | 32GiB | 外付け USB SSD | hfs(記録値) |
実機 |
linux-vmware-fusion |
— | — | — | — | 未測定 |
win11-16g |
— | — | — | — | 未測定 |
OS は macOS 26.3.1(arm64)、仮想化なし。ファイルシステムは結果の env.json に hfs と記録されました。
この回に Linux と Windows の値はありません。 連載の決まりで新しく測るのは Mac だけ、他の2つは以前に測った値を使うことにしていますが、cold と hot のこのテストには以前の値がありません。 したがって VMware の割り当ても今回は該当しません。題に「実機2OS と VMware」を入れていた当初の予定は、Mac 1台に改めました。
データ
日時・レベル・都市名・ID・状態・パスの入った UTF-8 のログ行を 1MiB 単位で並べたファイルです。UWTEST-NEEDLE という行が先頭・中ほど・末尾の1MiBに1本ずつ入っているものを「ヒット3件」、1本も入っていないものを「ヒットなし」として測りました。
| ファイル | バイト数 | GiB(÷1024³) | SHA-256 |
|---|---|---|---|
huge-1G.log |
1,073,741,824 | 1.00 | 984d3c2f49e9eaab… |
huge-10G.log |
10,737,418,240 | 10.00 | 4e223935919feedd… |
huge-100G.log |
107,374,182,400 | 100.00 | d9348a746b6a70eb… |
データは配布しません。種を固定した生成器が作るので、どの OS で作っても同じバイト列になります。作ったあと SHA-256 で照合してから測っています。
測り方
1GiB は cold・hot それぞれ5回、10GiB 以上は3回測って中央値を採りました。cold は毎回 sync のあと sudo purge、hot は記録しない空回しを1回入れてから5回です。「そのセッションで最初の1回」は first として中央値とは分けています。正解は、終了コードとヒットの数が期待どおりのときだけ ok です。
結果
表1: cold と hot の中央値(1GiB・Mac のみ・秒)
| ケース | uvf cold(秒) | uvf hot(秒) | uvp cold(秒) | uvp hot(秒) | 同じ製品で cold から hot へ何倍速いか |
|---|---|---|---|---|---|
| ヒットなし | 1.16 | 0.104 | 1.25 | 0.102 | uvf は 11.2 倍・uvp は 12.3 倍 |
| ヒット3件 | 1.24 | 0.101 | 1.24 | 0.103 | uvf は 12.3 倍・uvp は 12.1 倍 |
4つの組み合わせで 11.2〜12.3 倍。ヒットがあるかないかでも、製品が無料版か有料版でも、比はほとんど動きませんでした。
表2: 5回の幅(1GiB・Mac のみ・秒)
| ケース | cold 最小 | cold 中央値 | cold 最大 | cold の幅 | hot 最小 | hot 中央値 | hot 最大 | hot の幅 |
|---|---|---|---|---|---|---|---|---|
| uvf・ヒットなし | 1.126 | 1.164 | 1.251 | 0.126 | 0.1035 | 0.1040 | 0.1091 | 0.0056 |
| uvp・ヒットなし | 1.137 | 1.254 | 1.261 | 0.124 | 0.1014 | 0.1020 | 0.1033 | 0.0019 |
| uvf・ヒット3件 | 1.172 | 1.241 | 1.256 | 0.085 | 0.1007 | 0.1013 | 0.1028 | 0.0021 |
| uvp・ヒット3件 | 1.168 | 1.242 | 1.250 | 0.082 | 0.1004 | 0.1029 | 0.1053 | 0.0049 |
この表が今回の本題です。ヒットなしの2件では、cold の幅(0.126秒・0.124秒)が hot 1回分(0.104秒・0.102秒)より大きい。 ヒット3件の2件では幅が 0.082〜0.085秒で、hot 1回分の 0.8 倍ほどに収まりました。どちらにしても、cold を1回だけ測って小数第2位まで書くのは無理だと分かります。
hot の側は桁が違います。幅は最大でも 0.0056秒で、中央値の 5.4% です。cold の幅は中央値の 6.6〜10.8% でした。
表3: 「最初の1回」は cold と同じか(1GiB・Mac のみ・秒)
| ケース | first(1回・秒) | cold 中央値(秒) | 向き |
|---|---|---|---|
| uvf・ヒットなし | 1.14 | 1.16 | first のほうが 1.02 倍速い(同等) |
| uvp・ヒットなし | 1.31 | 1.25 | first のほうが 1.05 倍遅い(同等) |
| uvf・ヒット3件 | 1.24 | 1.24 | ほぼ同じ(1.00 倍) |
| uvp・ヒット3件 | 1.14 | 1.24 | first のほうが 1.09 倍速い(同等) |
4件とも、差は cold 自身の幅の中に収まっています。 速い向きと遅い向きが2件ずつで、偏りもありません。sudo purge でキャッシュを消す手順は、初回の状態を作り直せていると言ってよさそうです。測り方の確認なので地味ですが、ここが崩れると cold の数字が全部崩れます。
メモリは2回目も変わらない
ピークメモリは、cold でも hot でも uvf 約19.3〜19.4MiB・uvp 約23.3〜23.4MiB でした。5回のどの回でも同じ値です。2回目が12倍速くなっても、ソフトが使うメモリは1バイトも増えていません。 速くしているのが OS 側のキャッシュで、ソフトから見れば「読み出しが速いディスク」に見えているだけだからです。
10GiB と 100GiB について
| ケース | uvf cold(秒) | uvp cold(秒) | hot |
|---|---|---|---|
| 10GiB・ヒットなし | 10.78 | 10.75 | 数字を出しません |
| 10GiB・ヒット3件 | 10.68 | 10.67 | 数字を出しません |
| 100GiB・ヒットなし | 106.19 | 106.19 | 記録なし(skip) |
| 100GiB・ヒット3件 | 107.17 | 106.21 | 記録なし(skip) |
100GiB の hot は、CSV に時間の代わりに file does not fit in memory: hot is the same as cold と入っています。メモリに収まらないファイルでは hot という状態が作れないので、何度開いても毎回 cold です。
10GiB の hot は、同じ日に測り直したときに別の結果になりました。 32GiB のメモリに 10GiB のファイルは入るはずですが、入るかどうかはその時の OS の都合しだいで、こちらから決められません。どちらの値を書いても再現してもらえないので、この連載では出しません。
負け: 差が大きいほど、測り方の粗さが見えてしまう
1つめ。cold の1回測りは、書ける精度が小数第1位までです。
5回の幅が 0.082〜0.126秒ある数字を「1.16秒」と書くとき、本当に言えているのは「1.1秒台から1.2秒台」です。今回は5回測ったので中央値を出せましたが、1回で済ませたベンチマークの cold は、1割くらいずれていると思って読むのが安全です。これは他人の数字を読むときにも、自分が出すときにも当てはまります。
2つめ。この回は、連載の題から2つはみ出しました。
1つはサイズです。cold と hot の差を出せたのは 1GiB だけで、10GiB は再現できず、100GiB にはそもそも hot がありません。「2回目から速い」は、扱うファイルが実メモリに収まるときだけの話でした。
もう1つは OS です。この回は Mac 1台で、Windows と Linux は未測定です。本来なら「実機の macOS と Windows で cold の作り方がどう違うか」「VMware の Linux ではホスト側のキャッシュで値がどう揺れるか」を並べたい回でしたが、その値がまだありません。 第2回の時点でも、連載名の「3OS」はまだ1OS です。
3つめ。画面(GUI)と Web 版の数字がありません。 今回あるのはコマンドの時間だけです。「画面で開き直したときに2回目が速いか」は、この記事では答えられません。
正しさ: 40回すべて ok、失敗は0件
速さの前に、答えが合っていたかです。
1GiB の4つの組み合わせ(uvf/uvp × ヒットなし/ヒット3件)について、cold 5回・hot 5回の計40回すべてが ok でした。failures.csv は見出しの1行だけで、中身がありません。
- ヒットなしのケースは、終了コード1・出力0行。10回とも同じ
- ヒット3件のケースは、先頭・中ほど・末尾の1MiB にある行が3本とも出て、終了コードは0。10回とも同じ
- cold と hot で結果が変わった回はありません。 速くなっただけです
「速くなったが答えが変わった」はベンチマークで一番たちの悪い事故です。hot のように裏で別の経路を通る条件では、件数と終了コードを毎回照合しておかないと気づけません。今回はそこを40回ぶん確かめています。
なお、連載の弱点の一覧には現在10件が載っていますが、このテストからの追加はありません。 10件はすべて文字コード・改行・日本語の文字・異常系に関するもので、第4回以降で扱います。
持ち帰れる一般論: cold と hot の数字を読むときの4つ
1つめ。cold は「幅」で読みます。 中央値だけ出ている cold の数字を見たら、1割くらいの幅があると思って比べます。1.5倍未満の差は、幅の中かもしれません。自分で測るときは、せめて3回測って最小と最大を一緒に書きます。それだけで読む人が誤差と差を分けられます。
2つめ。hot はソフトの差が出にくい数字です。 2回目が速いのは OS のファイルキャッシュの働きで、どの道具でも同じように効きます。道具を選ぶための数字は cold のほうです。hot は「2回目以降の体感」を示すのに向いています。
3つめ。実メモリを超えるサイズを1つ混ぜます。 収まる範囲でだけ測ると「2回目から速い」という嘘をつきかねません。実メモリより大きいファイルではキャッシュの効果は基本的に消えるので、そのサイズを扱うなら速いのは cold の値のほうだと思っておくのが安全です。境目のサイズ(今回の 10GiB のような、入るかもしれないサイズ)は値が安定しないので、そもそも数字を出さないという選択もあります。
4つめ。ピークメモリを cold と hot の両方で見ます。 2回目が速くなったときに、それが OS のキャッシュなのかソフトが抱えたのかは、ピークメモリを見れば分かります。増えていなければ OS 側です。/usr/bin/time -l(macOS)や /usr/bin/time -v(Linux)で見られます。
uvp ならこう書く
今回のテストで実際に使った書き方そのものです。cold と hot のためのオプションはありません。同じコマンドを、キャッシュの状態を変えて回すだけです。
まず、キャッシュを消して cold を作る側の手順です(macOS の場合)。
# cold: キャッシュを消してから1回測る
sync && sudo purge
/usr/bin/time -l uvf huge-1G.log UWTEST-NEEDLE
同じことを有料版で書くと、コマンド名だけが変わります。
# cold(有料版)
sync && sudo purge
/usr/bin/time -l uvp huge-1G.log UWTEST-NEEDLE

# hot: 空回しを1回入れてから測る
uvp huge-1G.log UWTEST-NEEDLE > /dev/null
/usr/bin/time -l uvp huge-1G.log UWTEST-NEEDLE
ヒットなしのケースは、ファイルに入っていない語を渡すだけです。終了コードは1になります。
uvf huge-1G.log UWTEST-ABSENT; echo "exit=$?"
uvp huge-1G.log UWTEST-ABSENT; echo "exit=$?"
正規表現で探すときは -E を付けます(-H はヒットした行にファイル名を付ける指定です)。
uvf huge-1G.log 'UWTEST-[A-Z]+' -E -H
uvp huge-1G.log 'UWTEST-[A-Z]+' -E -H
無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
再現方法
この回のテストの手順は、公開リポジトリーにあります。記事と食い違っていたら、向こうが正しいと思ってください。
- 数字の読み方と cold・hot の作り方の決まり: https://github.com/amru195704/UwView/blob/main/testsuite/docs/00-rules.md
- 巨大ファイルの回の手順(このテストの元): https://github.com/amru195704/UwView/blob/main/testsuite/docs/01-huge.md
- 弱点の一覧: https://github.com/amru195704/UwView/blob/main/testsuite/weak-points.md
- 一式のフォルダー: https://github.com/amru195704/UwView/tree/main/testsuite
自分の機械で回すなら、tools/gen.py でデータを作り、tools/check.py data で SHA-256 を照合してから tools/run.py を走らせます。1GiB の回だけなら作業用の空きは数GBで足ります。結果のフォルダー(results/ の下)そのものは、この記事の時点ではまだ公開されていません。公開されたらリンクを足します。
リンク
- 第0回(cold と hot の作り方・数字の読み方): https://uvp.y42u.net/blog/uwview-xt00-rules/
- 第1回(1GiB から 100GiB まで・1億行と10億行): https://uvp.y42u.net/blog/uwview-xt01-1gb-to-100gb/
- 10GB の2回目はどこで縮んだか: https://uvp.y42u.net/blog/uwview-fs04-10g-second-search/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
次回(第3回)は「改行のない巨大な1行」です。1行が100MB のファイルで、表示と検索がどうなるかを見ます。
そして、同じ語を何度も探す巨大なログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、OS のキャッシュに頼らずに開き直しも検索も速くなります(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。