UwView(ユーダブリュービュー) は、巨大なログ・テキストを開いて探す Windows・macOS・Linux 用のビューアです。ファイルをメモリに載せずに読むので、10GB・50GB・258GB でもすぐに開き、gz・zst など 7 形式の圧縮ファイルや Word・Excel・PDF の中も検索できます。無料版(CLI は uvf)と、索引で 2 回目以降の検索を速くする有料版 UwView Pro(uvp)、2 つのファイル・フォルダを比べる姉妹ツール UwDiff(uvd)があります。
grep ERROR big.log | grep -v healthcheck | grep timeout — ログ調査で誰もが打つこのパイプを、画面でどう組むか。コマンドで探した結果を、どう画面に渡すか。何本ものファイルを、1 つのコマンドでどう探すか。このサイトでは、絞り込みとコマンド(CLI)と画面(GUI)の使い分けについて、これまで 16 本の記事を書いてきました。
このページは、その 16 本の答えを 1 か所にまとめたものです。件数と秒数はすべて開発者本人の実測なので、その前提で読んでください。画面が向かない場面、ripgrep に負けている場面も、そのまま書きます。
先に結論: 何を捨てればいいかまだ分からない調査は、画面の多段階検索が向く。1 回きりの検索・スクリプト・定期実行はコマンドの領分。いまは両方を同じ製品の中で行き来できる
- パイプの各段が、件数付きのタブとして残ります。 UwView Pro(巨大ファイルを、いつでも瞬時に)の多段階検索は、
grep A | grep B | grep Cを最大 8 段まで画面で重ね、どの段にもクリック 1 回で戻れます。原本の行番号も消えません。 - grep の主なオプションは画面に載せました。
-v(含まない)・-w(単語一致)・-i(大小無視)・-E(正規表現)・-C N(前後の行)と、sort | uniq -cに近い「集計」です。awk の算術はできません。 - コマンドと画面は 1 回読みでつながります。
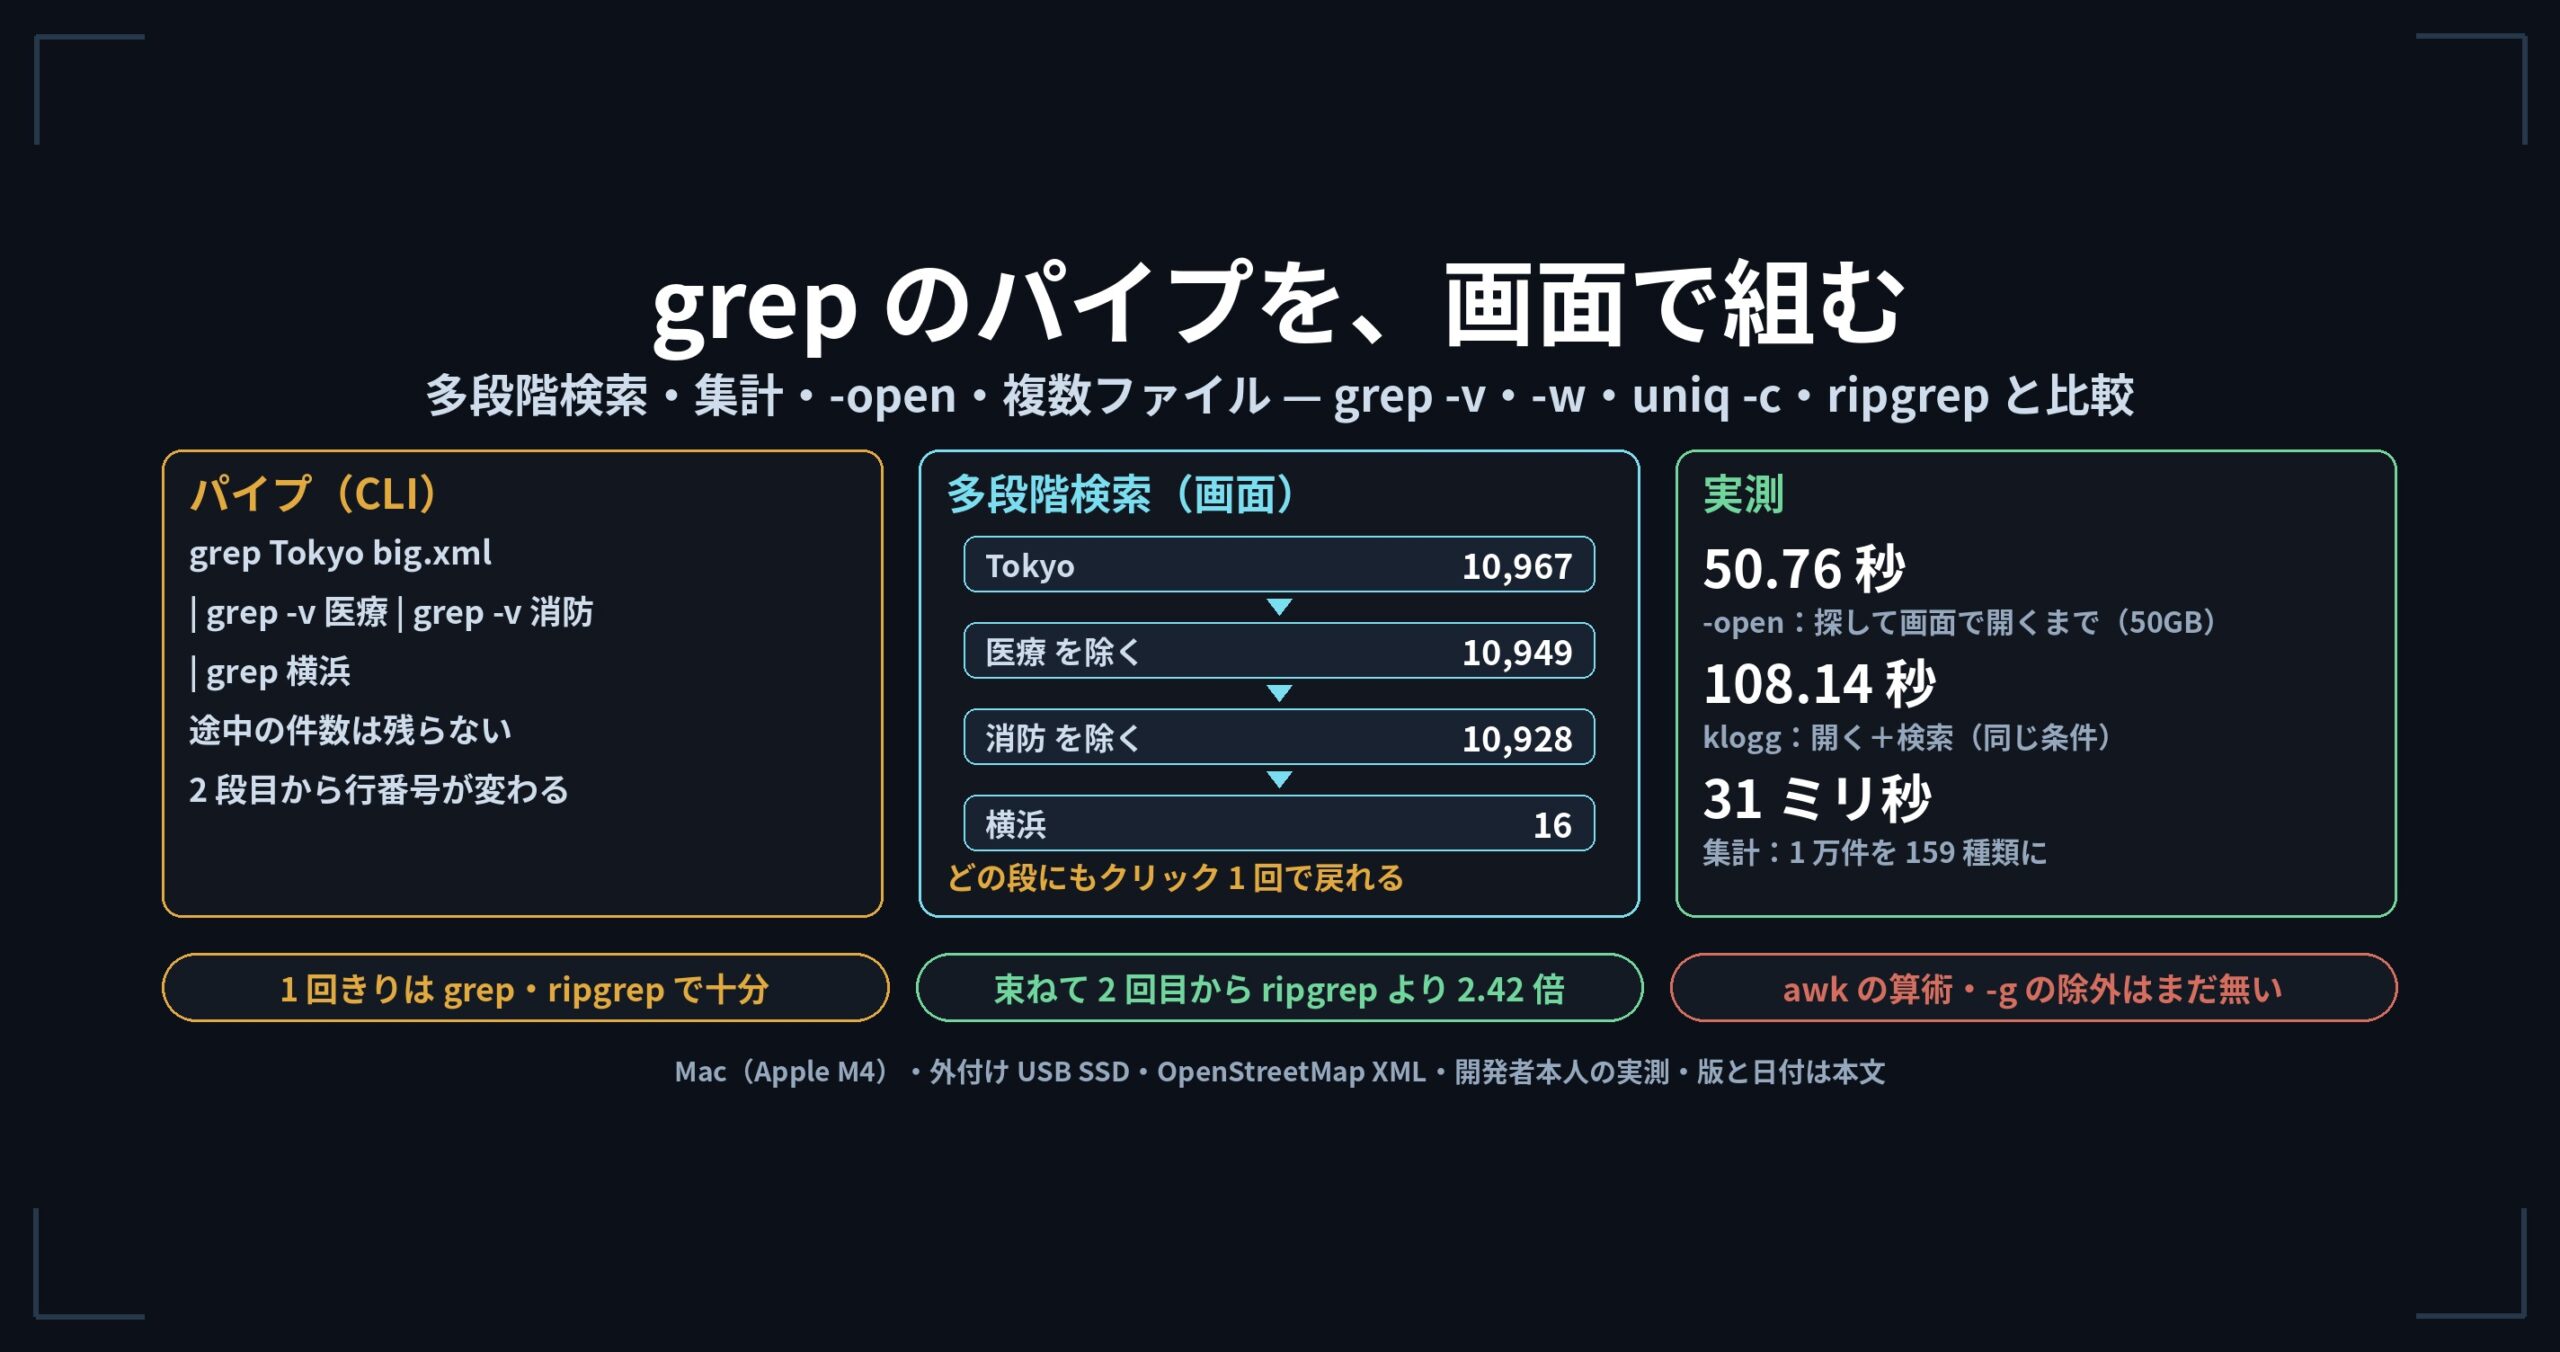
uvf … -openで探した結果を一時ファイル 1 つで画面に渡し、50GB の「探して画面で読むまで」が 50.76 秒になりました(klogg の開く+検索は 108.14 秒)。 - 1 回きりなら grep・ripgrep で足ります。 索引の無いファイルへの 1 回きりの検索では、grep・ripgrep のほうが速い場面があります。差が出るのは、同じファイルに何度も聞くときです。
1. パイプを画面に載せる — 多段階検索
ログ調査の定番は、grep をパイプでつないで絞っていく形です。UwView Pro の多段階検索は、このパイプを画面のタブで組みます。いつもの検索をすると結果一覧が出て、その上の絞り込みバーに次の語を入れると、前の結果の前後 ±N 行の範囲だけをさらに探します(多段階検索の記事)。
OpenStreetMap 日本全域(51GB・8.9 億行の XML)で試した例です。
| 絞り込みの段 | 件数 | 出典 |
|---|---|---|
東京 → 練馬 → 埼玉 |
94,979 → 184 → 54 | 多段階検索 |
Tokyo → 含まない 医療 → 含まない 消防 → 横浜 |
10,967 → 10,949 → 10,928 → 16 | grep -v の記事 |
Tokyo → 単語一致の Ariake → 有明 |
10,967 → 7 → 4 | grep -w の記事 |
「東京・練馬・埼玉」の 54 件を眺めると、東京都道・埼玉県道 24 号練馬所沢線(目白通り)が出てきます。3 つの語が 1 行にそろっていなくても、近くに一緒に現れる場所を拾えるのが、同じ行の中の and/or とは違うところです。
パイプでは落ちて、タブでは残るものが 3 つあります。
| grep のパイプ | 多段階検索 | |
|---|---|---|
| 段ごとの件数 | 最終結果しか出ない | タブに 語(件数) が並ぶ |
| 原本の行番号 | 2 段目以降は、流れてきたブロックの中の番号になる | 320,574,475 のまま残り、その行へ跳べる |
| 条件のやり直し | パイプを書き直して原本を最初から読み直す | 戻りたい段のタブをクリックする |
結果一覧の行を右クリックすると「履歴(絞り込みの経路)」が開き、その行がどの語で・原本の何行目で拾われたかが段の順に並びます。調査の条件そのものが記録として残る、ということです。
順番で探す「シーケンシャル検索」もあります。「ログイン → タイムアウト → 再起動」のように、w1 → w2 → w3 がこの順で並んだ場所だけを拾うモードです。OpenStreetMap 日本の 1 億行の XML で、東京(21,948)→ 横浜(874)→ 中町(60)まで絞れました。途中で前の語がまた出てきたら、そこから数え直します。所要時間は全文検索とほぼ同じです(シーケンシャル検索の記事)。
2. grep のオプションと uniq -c を画面に — 対応表
ここ数回で、grep の機能をひとつずつ画面に載せてきました。動作が近いものを並べます(CLI と画面の対応表)。厳密に同じ動作ではありません。 多段階検索は前後 ±N 行のかたまりで絞り、grep のパイプは行の流れで絞るので、端のところで結果が違うことがあります。
| CLI | UwView Pro の画面 |
|---|---|
grep PATTERN big.log |
検索(1 段目) |
grep -i |
「大小無視」チェック |
grep -E |
「Regex」チェック |
grep -w |
「単語一致」チェック |
grep -v |
「含まない」チェック(2 段目以降) |
grep -C N |
前後 ±N 行の文脈表示 |
grep A \| grep B \| grep C |
多段階検索(最大 8 段) |
... \| sort \| uniq -c \| sort -rn |
「集計」(正規表現の第 1 キャプチャ群で頻度ランキング) |
> hits.txt |
「保存…」(行番号・1 行目をヘッダーに・前後 ±N 行) |
「集計」は、ヒット行から値を切り出して頻度順に並べます。Tokyo の 10,967 件に k="([^"]+)" で集計をかけると、159 種類・31 ミリ秒で、1 位は name:en の 4,848 件(44.2%)でした。31 ミリ秒はヒット行 10,967 行を走査した時間で、8.9 億行を全部数えたわけではありません。大きな段では、48GB・8.9 億行の 139 万ヒットで 61.5 秒でした(開発ビルドでの実測。uniq -c の記事)。ランキングの行をクリックすると、その値で次の段へ降りられます。
同じ 48GB のファイルで、これまでの記事で出した値です(対応表の記事・2026 年 9 月)。
| 操作 | 実測 |
|---|---|
| 全文検索 | 初回 54.7 秒(索引作成と同時)/2 回目以降 14 秒。参考: grep 64.64 秒・ripgrep 71.49 秒(毎回) |
| 全置換(Edit Upgrade) | 置換 2 回で 47.0 秒 |
| 保存 | 途中終了は 0 秒(差分がすでにある)/最終テキストの出力は 1〜2 分 |
いまの版(v1.9.0・2026 年 10 月 14 日・Mac)で測り直した値は、対応表の記事の冒頭に追記しています。集計は rg+sort+uniq の 4.2〜4.9 倍(3GB・10GB)、画面の検索は uvp コマンドとほぼ同じ速さです。
3. コマンドで探して、画面で読む — -open と 1 回読み
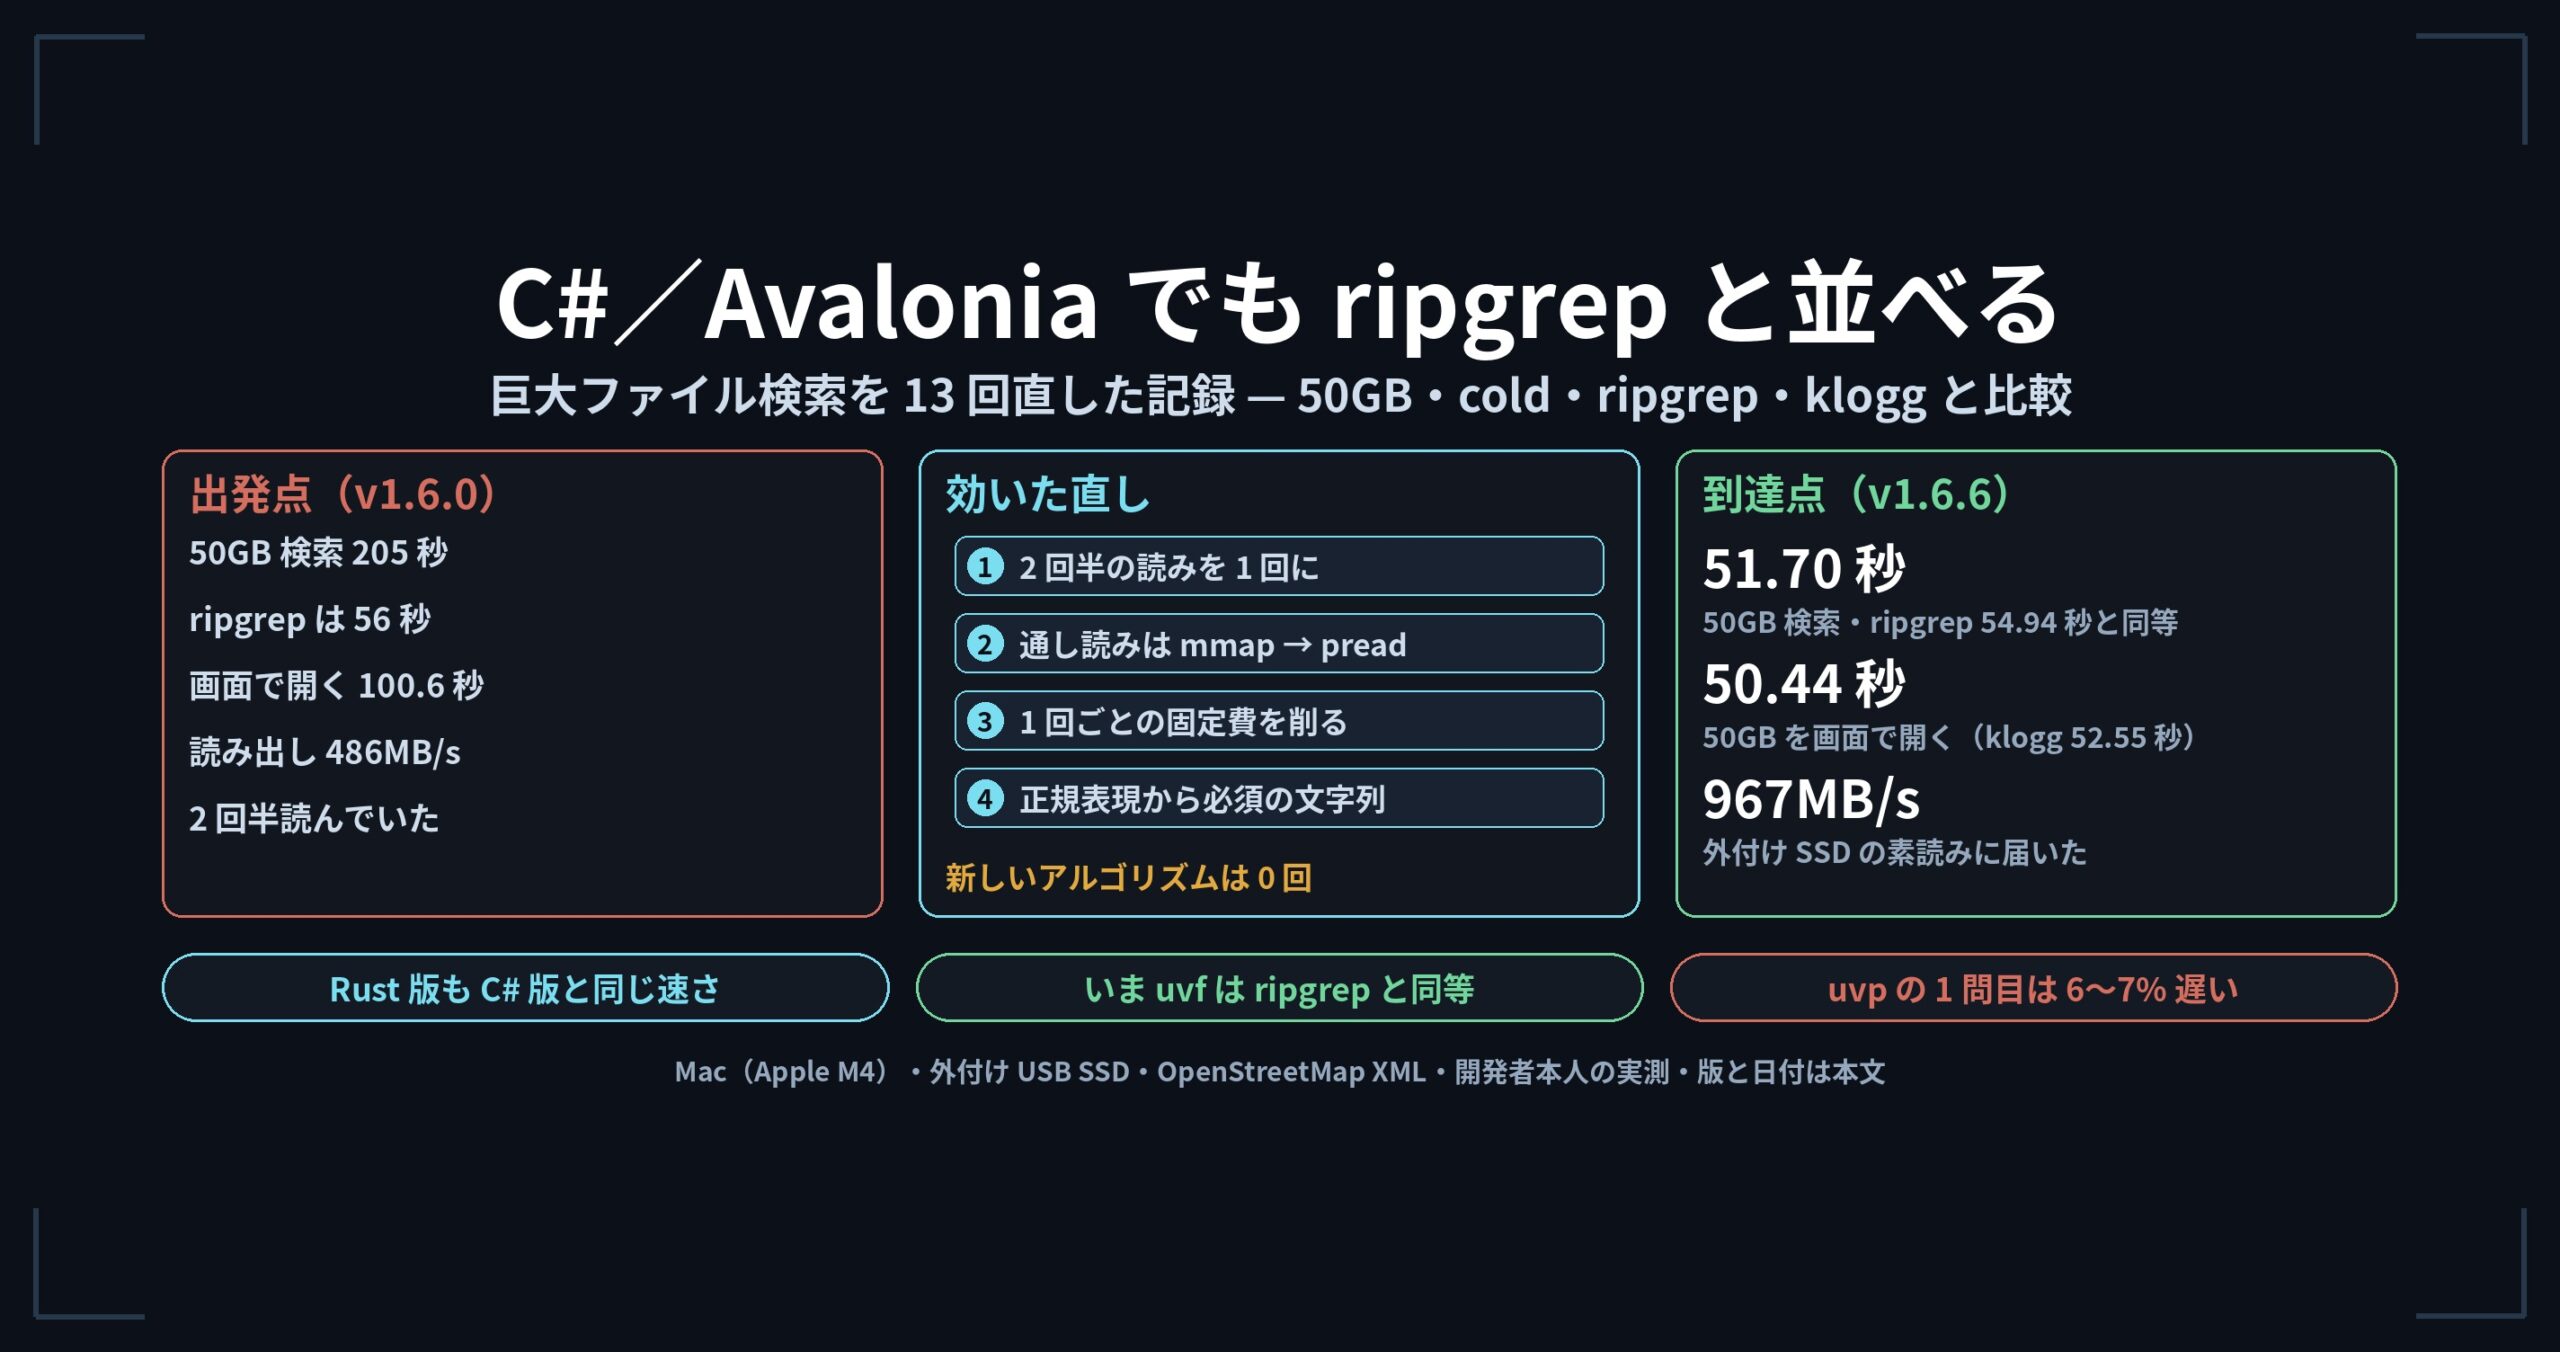
v1.6.0 から、画面と同じ検索をコマンドで打てる uvf(無料版)・uvp(有料版)が付きました。終了コードは grep と同じです。uvf huge.log 'ERROR' -open と打つと、コマンドが探した結果をそのまま画面で開きます。
当初は、コマンドから画面へ渡していたのが検索語だけでした。画面は起動すると自分でもう一度探すので、同じ 50GB を 2 回読んでいました。これを、ヒット行の位置と「索引の目印」を一時ファイル 1 つで渡す形に変えて、1 回読みにしました(改善記⑥)。
コールド(sudo purge 後)・v1.6.6・Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML の値です。
| 3GB(秒) | 10GB(秒) | 50GB(秒) | |
|---|---|---|---|
uvf 検索だけ |
3.27 | 10.40 | 51.70 |
uvf … -open(探して画面で開くまで) |
3.40 | 10.42 | 50.76 |
| klogg 24.11.0(開く+検索) | 4.21 | 22.73 | 108.14 |
| 対 klogg | 1.24 倍(同等) | 2.18 倍 | 2.13 倍 |
見てほしいのは上 2 行の近さです。画面を開いて行番号つきの一覧を出すところまで含めても、検索だけと誤差の範囲で並びました。3GB の 1.24 倍は 1.5 倍に届かないので「同等」です。
4. 何本ものファイルを 1 つのコマンドで — 束ね・除外・書き出し・JSON
v1.7(Wide Field)では、1 回に探せる範囲を広げました。数字は Mac(Apple M4・10 コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap の XML で、相手は ripgrep です。
| やったこと | ripgrep(秒) | UwView(秒) | 結果 | 出典 |
|---|---|---|---|---|
平文と gz の混在 12 本・1 回目(uvp) |
25.57 | 41.45 | ripgrep に 1.62 倍負け | Wide Field① |
同・2 回目(uvp) |
25.22 | 10.43 | ripgrep より 2.42 倍速い | 同上 |
平文 5 本・2 回目(uvp) |
0.37 | 0.55 | 縮まない(取り返せない) | 同上 |
3 つの組とも(uvf) |
— | — | 同等(1.00〜1.31) | 同上 |
| 50GB を gz で書き出す(索引あり) | 117.20(rg \| gzip) |
11.89 | 9.86 倍 | Wide Field⑩ |
| 3GB を gz で書き出す(hot) | 0.33 | 0.31 | 同等 | 同上 |
| 50GB・索引を作る 1 回目を含む | 66.01 | 61.17 | 同等(1.08 倍) | 同上 |
Wide Field①は 2026 年 10 月 1 日に v1.7.3.6 を測り直した値、Wide Field⑩は 2026 年 9 月 29 日の v1.7.3.6 統合テストの値です。混在 12 本は、2 回の合計ではまだ追いついていません(51.88 秒 対 50.79 秒)。追い越すのは 3 回目からです。
速さ以外にそろえたものもあります。
- 除外の規則:
.ignore・.gitignoreに ripgrep 15 と同じ規則で従い、rg --filesとの突き合わせ 43 項目が Mac・Linux・Windows の 3 つとも一致しました。除外は速さのためではなく、同じコマンドで同じ件数を返すための機能です(Wide Field⑦)。 - ファイルの指定:
uvf 'logs/*.log,err/*.log' ERRORのように、引用符でくるんだ 1 つの引数に決めました。その文字列が束ねた索引の名前になるからです。直した 5 か所で、Mac・Linux とも 36 項目が一致しました(Wide Field⑧)。 - JSON の出力と並列の本数:
--jsonは 1 行 1 オブジェクトの JSON Lines で、キーはfile・n・lineの 3 つだけです。並列の本数は--tuneが実測して勧め、Mac では 1 本 6.33 GB/s から 8 本 16.41 GB/s でした(Wide Field⑪)。
5. 画面で読む — 一覧と現場を行き来する
探したあとは、読む番です。無料版の UwView でも、検索結果は独立したポップアップに一覧で出て、行をダブルクリックすると本文の該当行へ跳びます。ポップアップは開いたままなので、一覧 → 現場 → 一覧と何度でも往復できます(フィルタ Popup の記事)。
| 無料版 UwView | UwView Pro | |
|---|---|---|
| 一覧から該当行へジャンプ | ○ | ○ |
| ヒット行の保存(前後を含める指定も可) | ○ | ○ |
| ポップアップの前後文脈 | 前後 1 行まで | 前後最大 64 行 |
| タブごとに独立したポップアップ | ― | ○ |
grep -B 20 -A 5 で抜き出した断片は「別のテキスト」で、そこから数千行さかのぼりたくなっても元の位置へは戻れません。ERROR の行から原本をそのままスクロールしてさかのぼる手順は前後の文脈を追う記事に、検索・色分け・ブックマーク・セッション復元をつないでアクセスログの 5xx を追う手順はアクセスログの記事に書きました。
数十 GB を「諦めて DB に入れる」前に、手元のノート PC でできることはDB に入れる前にの記事にまとめています。48GB 級(約 8.9 億行)では、grep 64.64 秒・rg 71.49 秒で、1 回きりの抽出なら十分実用的です。
6. コマンドと画面の使い分け
| やりたいこと | 向いているもの |
|---|---|
| 1 回だけ、1 つの語を探す | grep・ripgrep(または uvf) |
| スクリプトに組み込む・定期実行する・パイプで他の道具へ渡す | コマンド(grep・ripgrep・uvf・uvp) |
| 何を捨てればいいか試しながら絞る | UwView Pro の多段階検索 |
| ヒットの中身の傾向を見る | UwView Pro の「集計」 |
| コマンドで探して、前後を画面で読む | uvf … -open |
| 合計・平均などの算術、列の操作 | awk・cut など |
この「何問目から得になるか」は、258GB・45 億行での実測で数字にしています(巨大ファイルのまとめにも載せました)。
負けているところ・同等のところ
- 1 回きりの検索は、grep・ripgrep のほうが速い場面があります。 索引の無いファイルへの 1 回きりの検索は、対応表の記事の時点でも、v1.9.0 で測り直したときも同じ傾向でした(3GB で ripgrep の約 1/1.3・同等の範囲)。
- 束ねる 1 回目は ripgrep に負けます。 混在 12 本で 1.62 倍、gz 7 本で 1.52 倍。平文だけの組は 2 回目も縮まず、取り返せません。
uvfの 1.00〜1.31 倍は勝ちと書きません。 1.5 倍に届かないので同等です。書き出しも、キャッシュに乗った 3GB・10GB では同等でした。- JSON の項目は ripgrep の
--jsonより少ないです。 型・一致した位置・統計を出さず、前後の行とヒット行の区別も付けていません。 - ripgrep の
-gにある除外の指定が、まだありません。{a,b}や[a-z]も使えません。.rgignoreは意図して読みません。 - awk の算術、
tail -fは Pro の画面にありません。 集計でできるのは頻度ランキングまでです。追記の追尾は無料版の UwView の側にあります。 - 対応表は「近い動作」の例です。 多段階検索は前後 ±N 行のかたまりで絞るので、grep のパイプと端の結果が違うことがあります。
- 件数と秒は、そのファイル・その検索語・その環境での値です。 画面の画像は、記事を書いた時点の版のものです。
各回を読む
- 9万件のヒットを2回の絞り込みで54件に — UwView Pro に「多段階検索」を実装しました
- grep -v をGUIに載せた — 多段階検索に「含まない」を追加、1万件のノイズ退治が数クリックになった
- grep -w もGUIへ — 「単語一致」で、8.9億行から7件を狙い撃つ
- uniq -c もGUIへ — ヒット1万件の「よく出る値」を、31ミリ秒でランキング
- 「東京→横浜→中町」の順に現れる場所だけを探す — UwView Pro に「シーケンシャル検索」を実装しました
- grep・uniq -c・sed を、GUIに — CLIコマンド → UwView Pro 対応表
- CLIが探した結果を画面に渡して2回読みを1回にした — 改善記⑥
- 平文と gz の12本を1コマンドで — Wide Field①
- ripgrep と同じ除外規則にそろえた — Wide Field⑦
- ripgrep の -g にある除外指定が、まだありません — Wide Field⑧
- rg に gzip をつながずに gz で書き出す — Wide Field⑩
- ripgrep の –json に項目数で負ける JSON Lines — Wide Field⑪
- 1億行の巨大テキストを「諦めてDBに入れる」前に — 障害調査・AIデータ前処理のための現実解と実測
- 検索結果を独立ウィンドウに分離した理由 — ジャンプ・保存・前後文脈まで「見ながら」触れるフィルタPopup
- ERRORは見つかった。原因は「その前」にある — 巨大ログで前後の文脈を追う方法
- アクセスログの5xxエラーを1本の線でつなぐ — UwViewの検索・色分け・ブックマークを実戦でつないでみた
リンク
- UwView のダウンロード(Windows・macOS・Linux)
- UwView Pro(1 ライセンスで全 OS)
- ベンチマークのまとめ
※ 数字はすべて開発者本人が測ったもので、測った環境・版・日付の条件付きです。環境によって変わります。