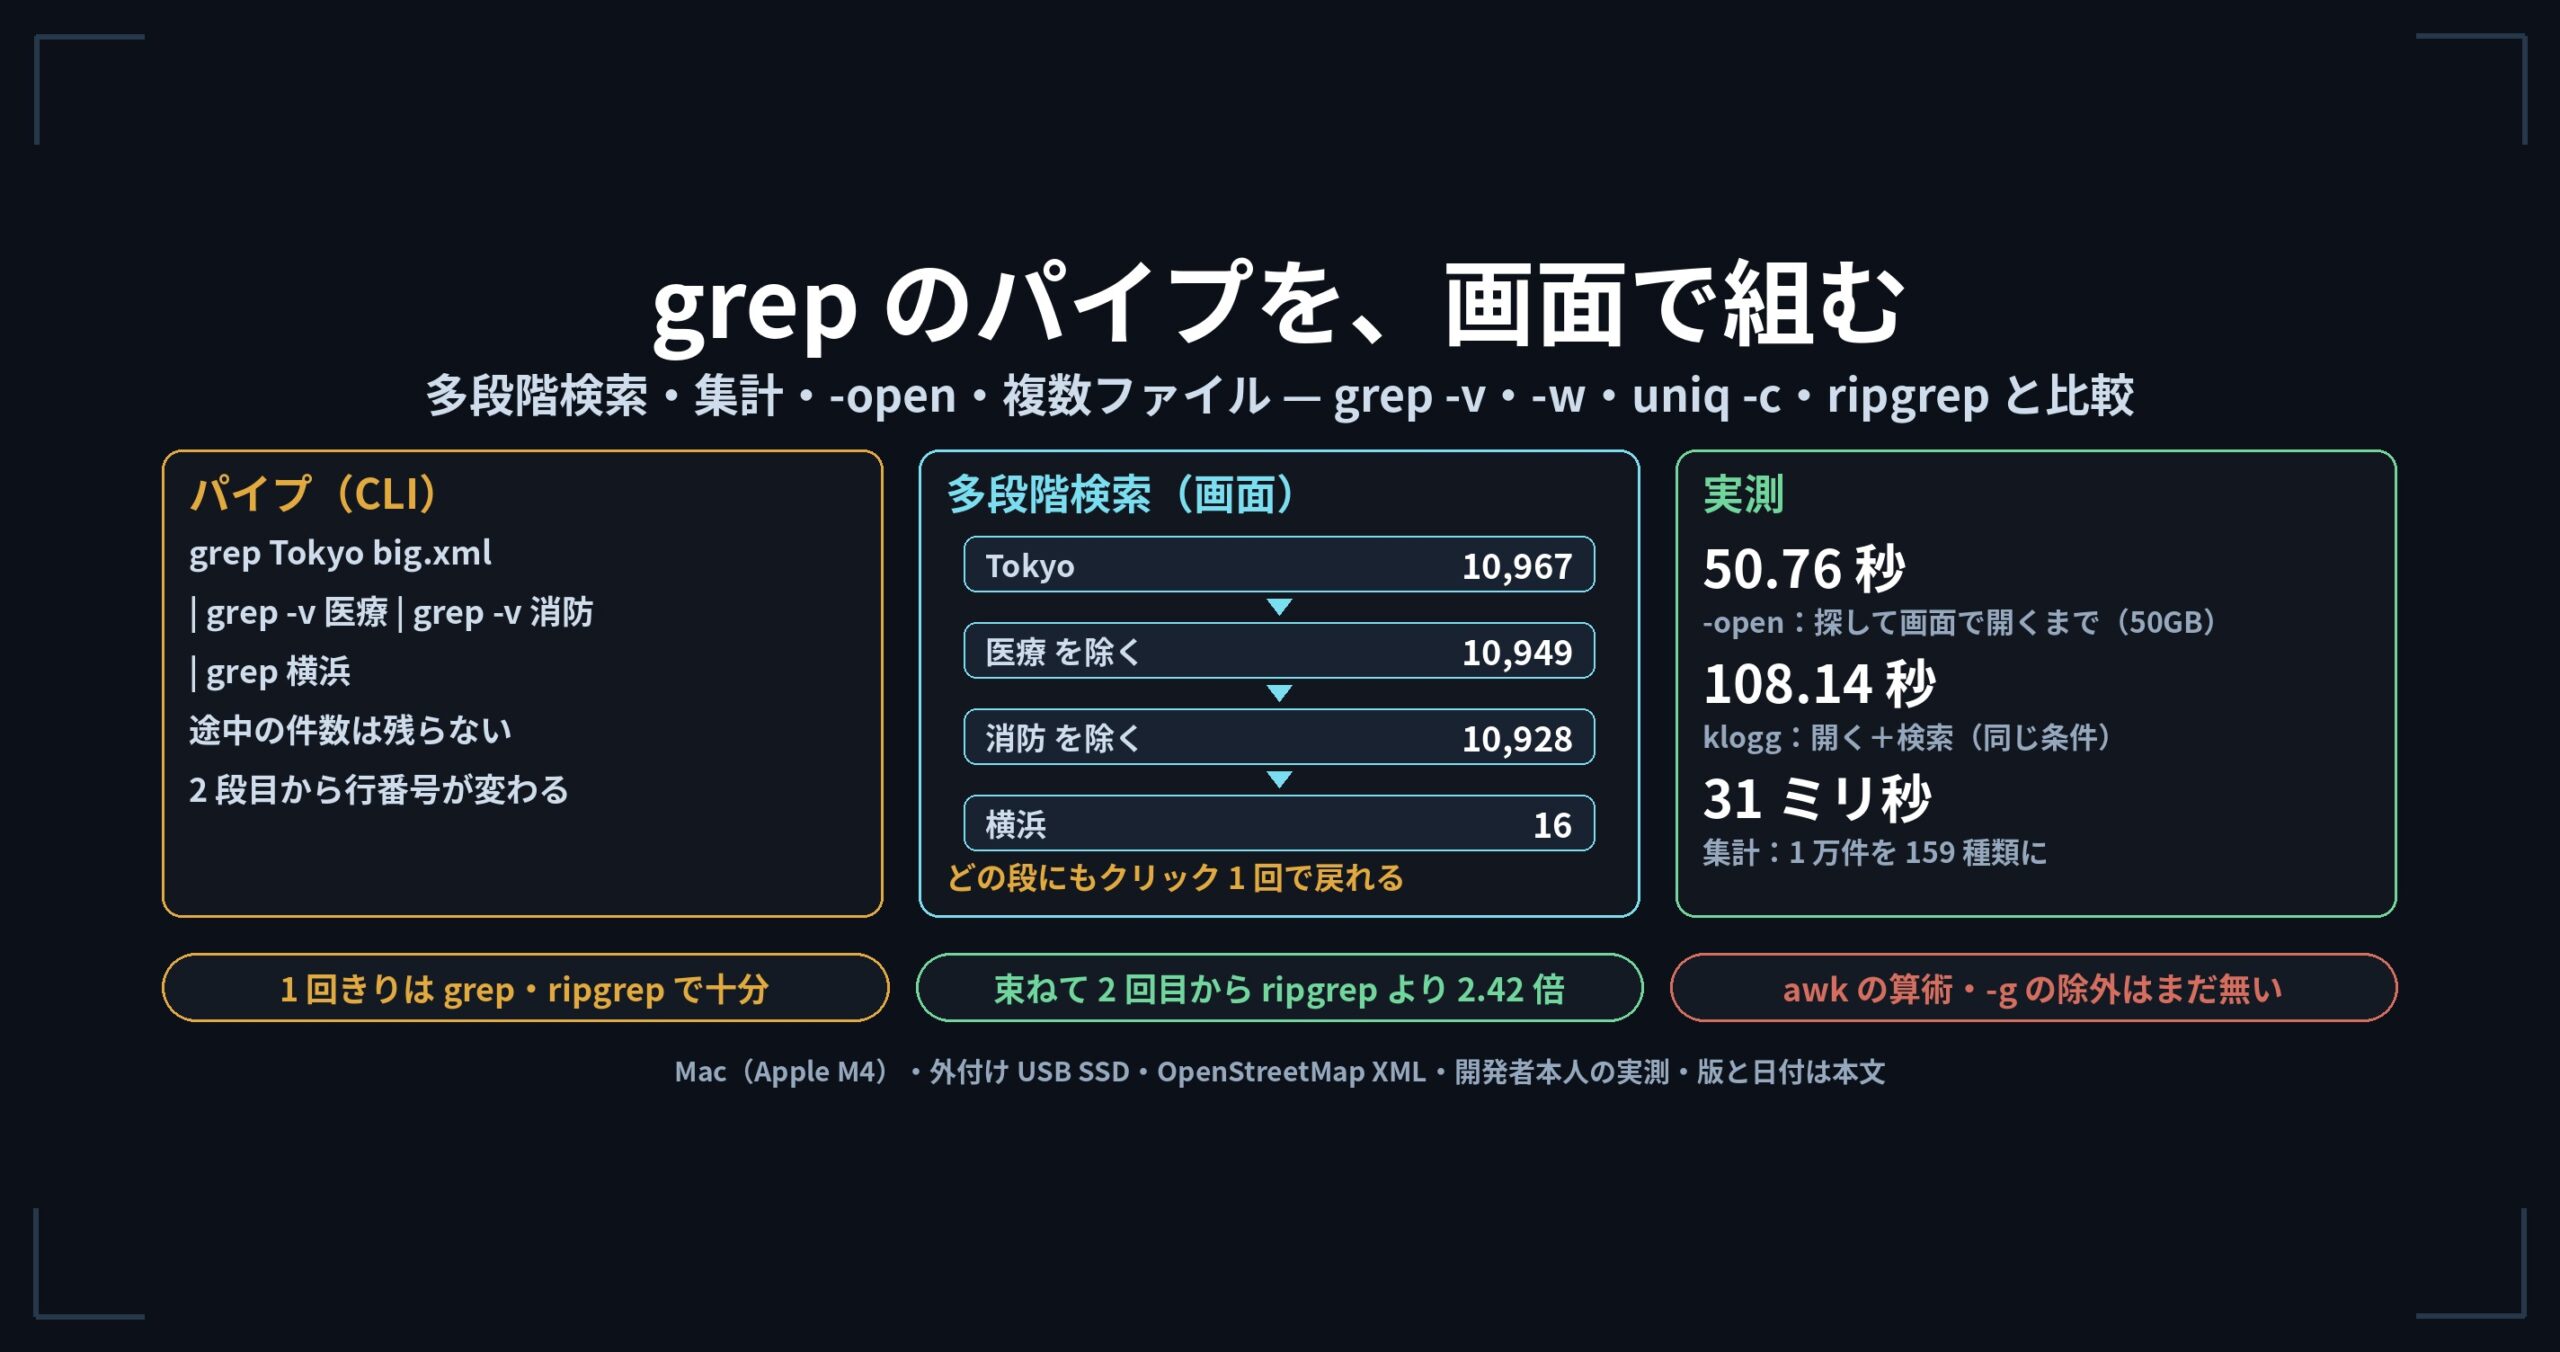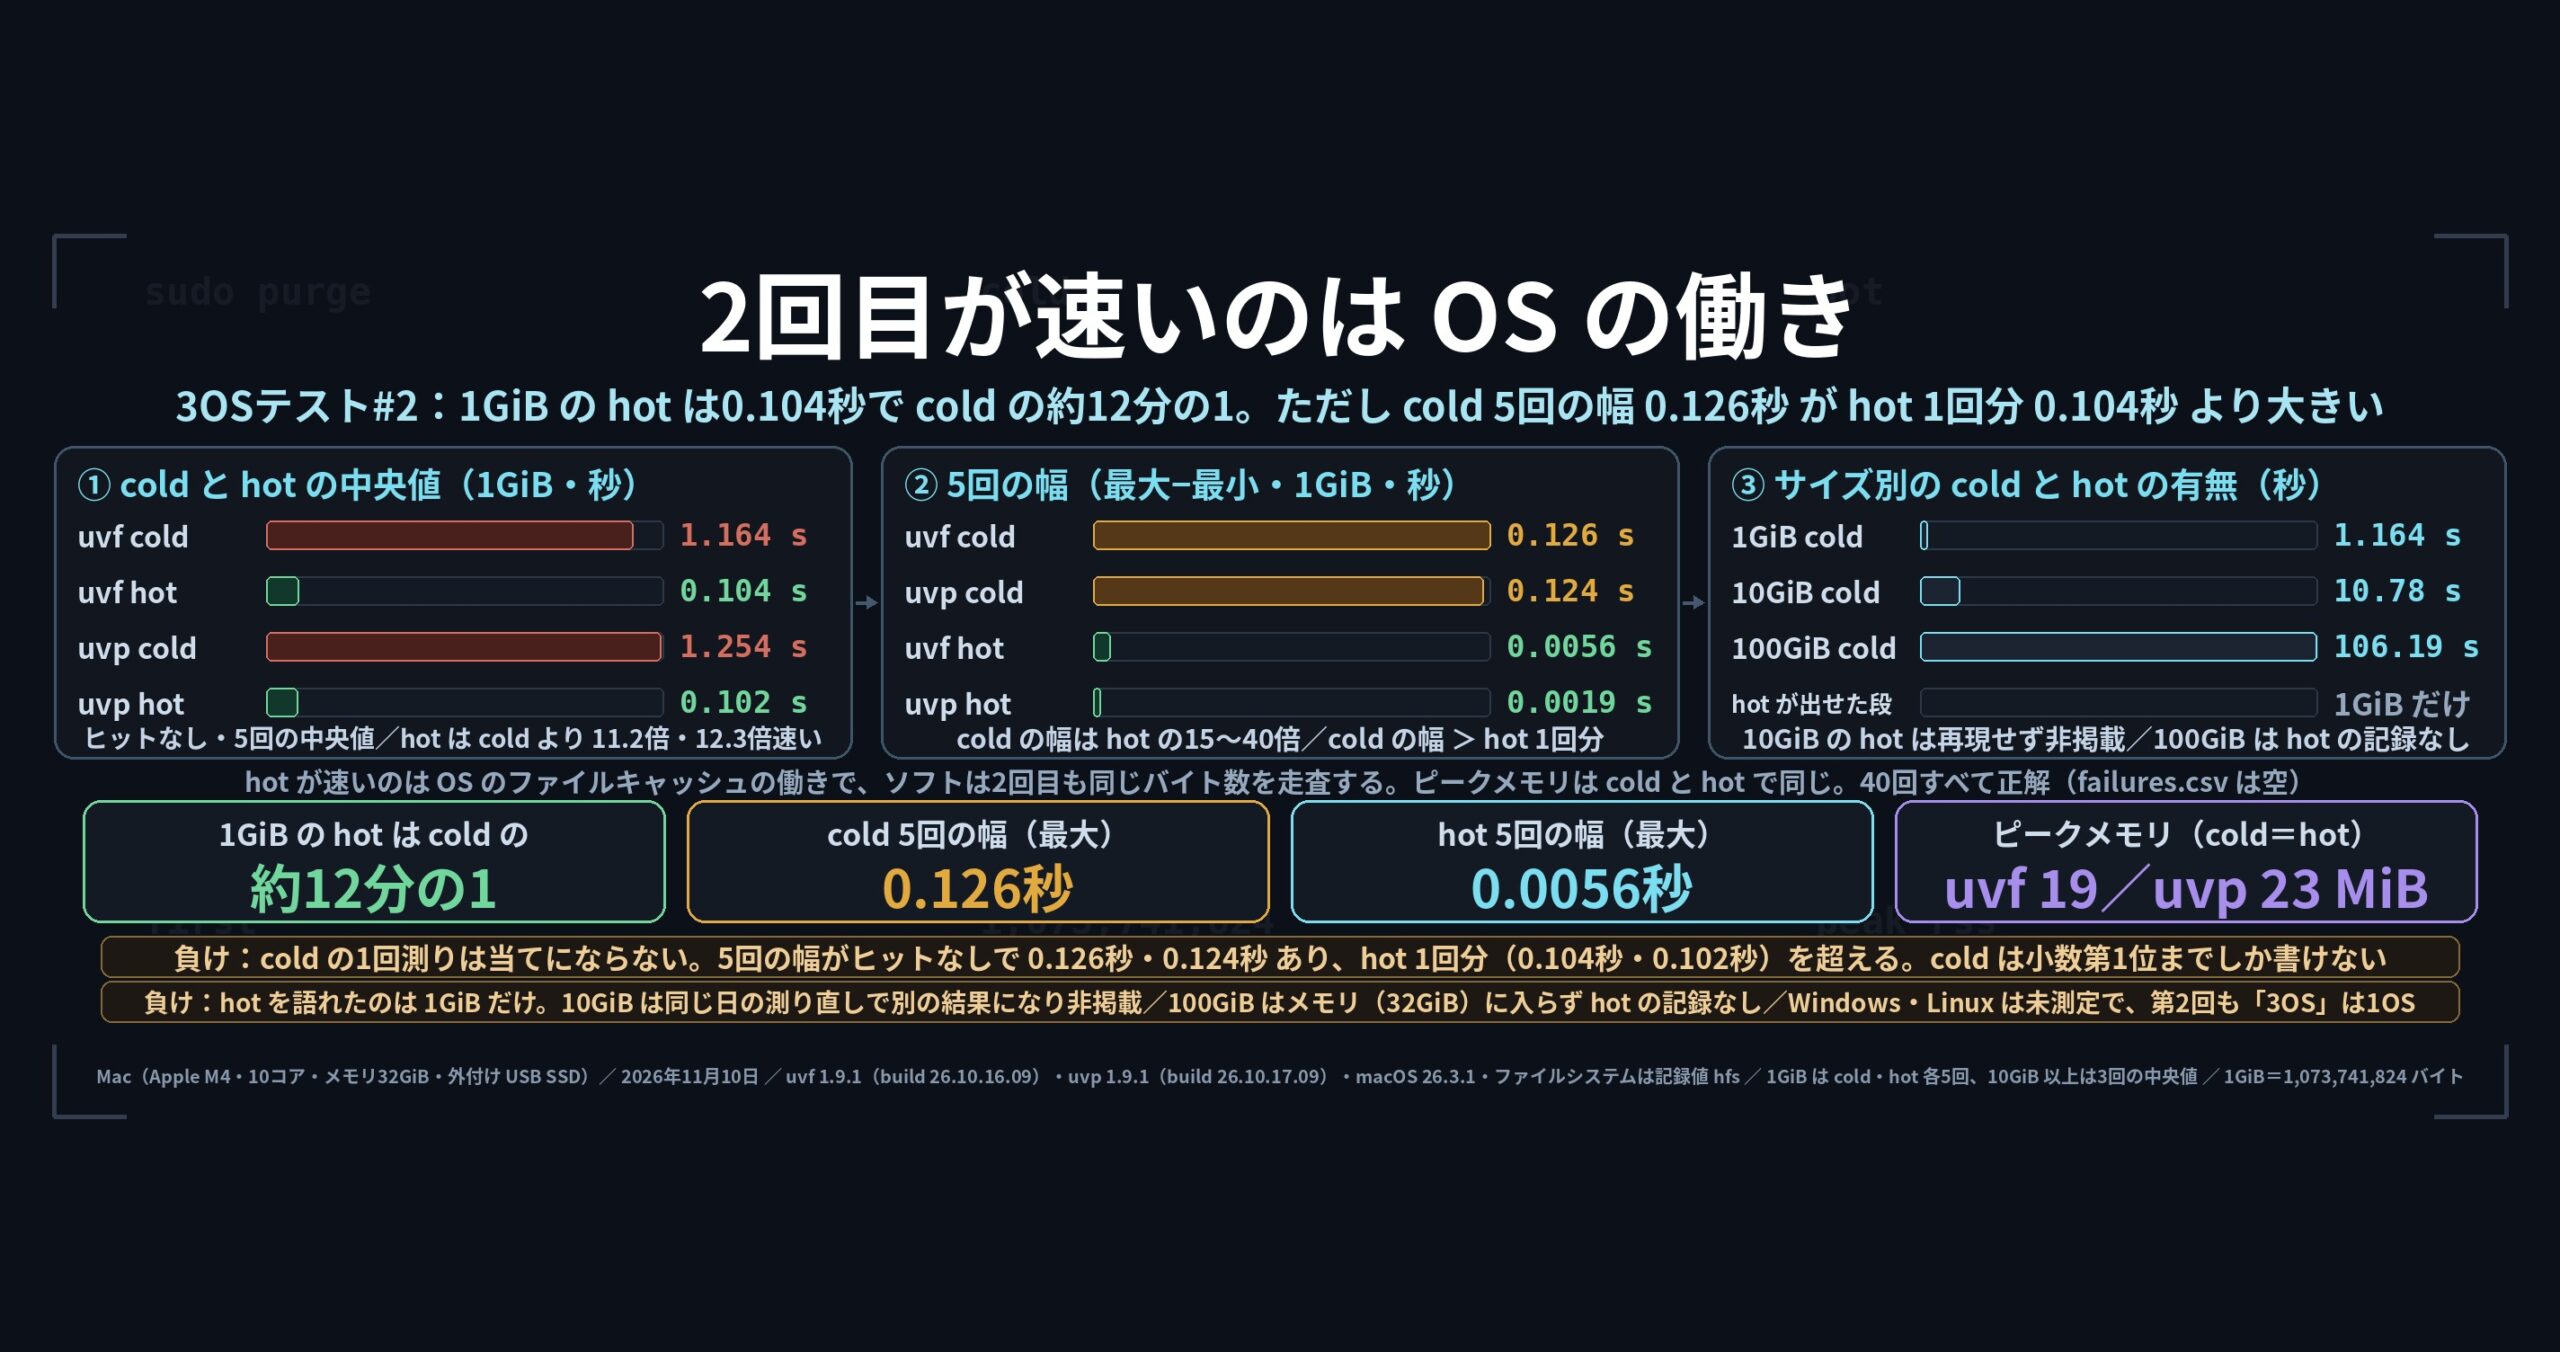
UwView(ユーダブリュービュー) は、巨大なログ・テキストを開いて探す Windows・macOS・Linux 用のビューアです。画面は Avalonia UI、中身は .NET 10(C#)で書いています。画面と同じ検索エンジンを使うコマンド(無料版は uvf、有料版 UwView Pro は uvp)も付いています。
問い: C#(.NET)と Avalonia で作ったアプリでも、Rust の ripgrep と同じくらいの速さで巨大なファイルを探せるのか。
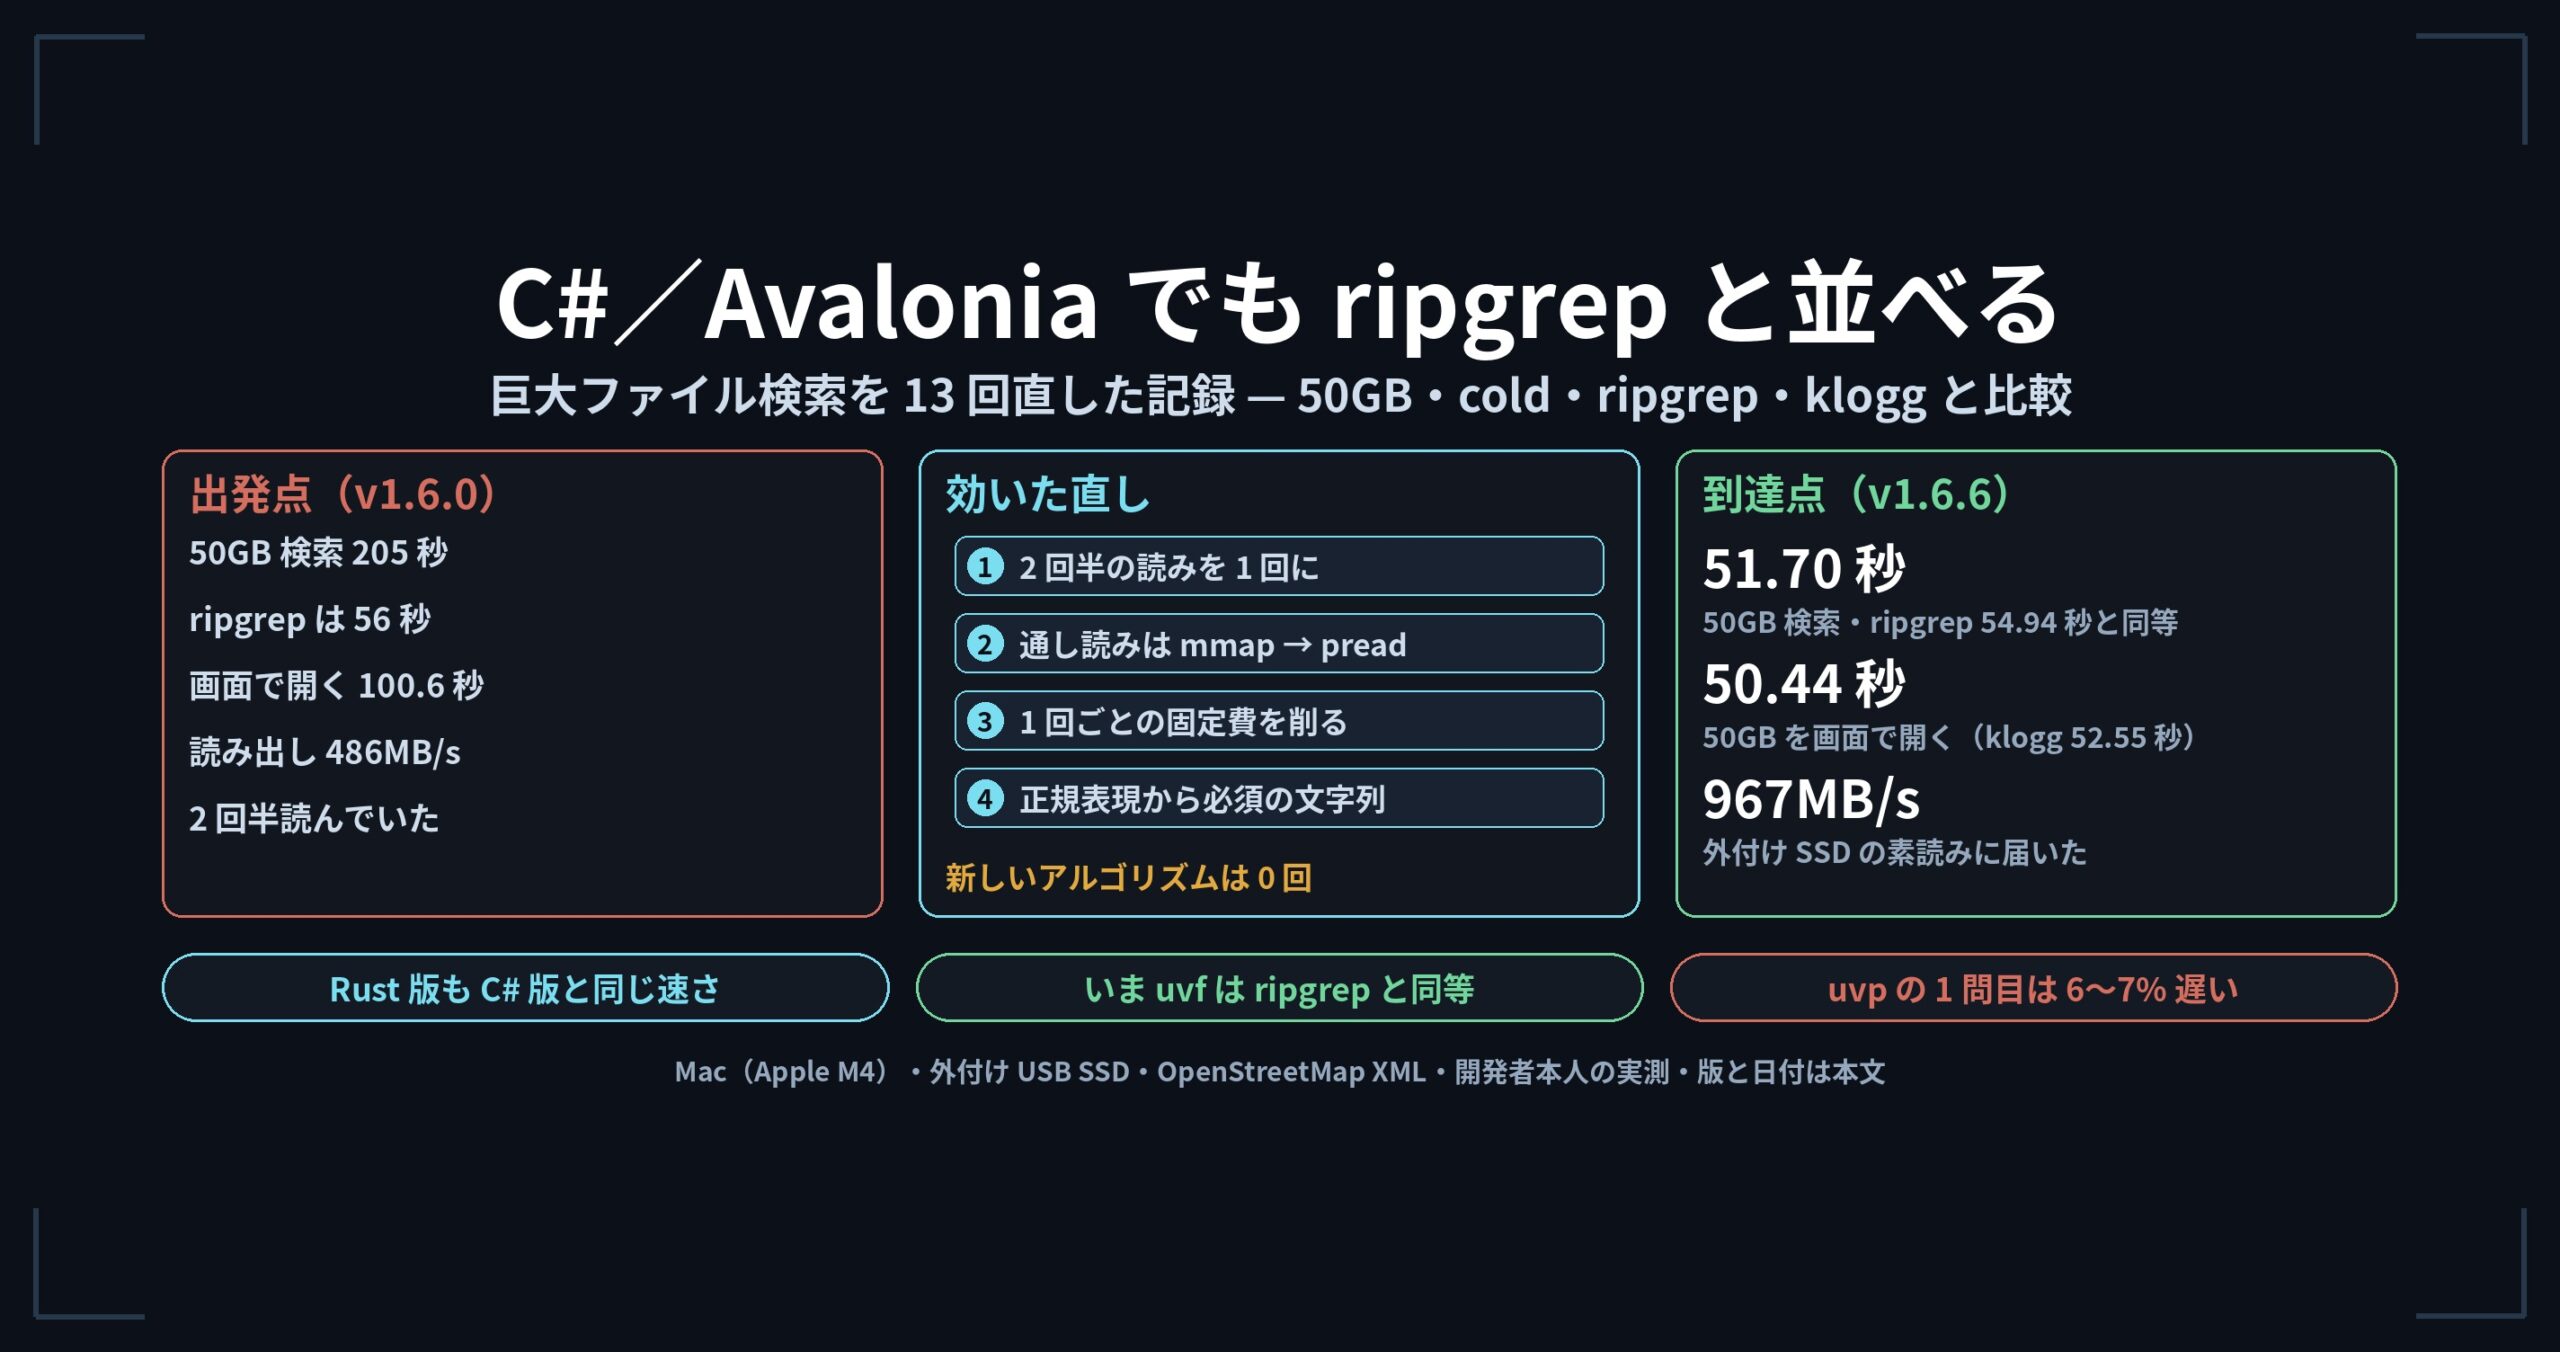
答え: 並べられました。50GB の検索は 205 秒から 51.70 秒になり、ripgrep の 54.94 秒と同等です。効いたのは言語ではなく「同じファイルを何回読むか」「どう読むか」「1 回ごとの固定費」でした。同じ作りを Rust で書き直した版も、C# 版と同じ速さでした。
このページは、2026 年 9 月の連載「First Light」(全 13 回)と、その後に書いた 2 本の記事の数字を、開発者向けに 1 か所へまとめ直したものです。数字は元の記事の実測値をそのまま使い、新しく測った値はありません。主に 1 台の Mac の値です。負けている所も、そのまま書きます。
※ファイル容量の表記について:このページの「50GB」は 51,254,526,392 バイト(47.73GiB)、「3GB」は 3,032,812,644 バイト、「10GB」は 10,255,315,281 バイトです。どれも OpenStreetMap を XML に展開したデータです。
v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
先に結論: 13 回で触ったのは「読む回数」と「読み方」と「固定費」だけ。アルゴリズムを賢くした回は 1 つもなかった
- 出発点は 3.7 倍の負けでした。 v1.6.0(2026 年 9 月 15 日)の時点で、50GB の検索が
uvf205 秒・ripgrep 56 秒。画面で開くのも 100.6 秒かかっていました。 - 直したのは「同じファイルを何回読んでいるか」でした。 行の位置を集める・探す・ヒットした行を読み直す、の 3 つが別々にファイルを読んでいて、合わせて 2 回半。これを 1 回にまとめて 203 秒 → 50.82 秒。続けて mmap を pread に替え、1 回ごとの固定費を削りました。
- 到達点は、外付け SSD の素読みの速さでした。 読み出しは 486MB/s → 967MB/s。これ以上は媒体の上限なので、この方向はもう伸びません。
- 「Rust だから速い」ではありませんでした。 検索部分を Rust に移した版は C# 版と同じ速さ(36.85 秒 対 37.55 秒)で、ripgrep との差は縮まりませんでした。
1. 出発点と到達点(50GB・cold)
Mac(Apple M4・10コア・メモリ 32GB・外付け USB SSD)で、sudo purge でキャッシュを捨てた直後(cold)に測った値です。「同等」は 1.5 倍未満の差を指します(3 章)。
| 比べたこと | 連載を始めた時点(秒) | v1.6.6 “First Light”(秒) | 相手(秒) | いまの結果 |
|---|---|---|---|---|
50GB を 1 回検索する(uvf) |
205 | 51.70 | ripgrep 54.94 | 同等(ripgrep より 1.06 倍速い) |
| 50GB を画面で開く | 100.6 | 50.44 | klogg 52.55 | 同等(klogg より 1.04 倍速い) |
| 50GB を開いて探して一覧を出す(画面・通し) | 189.5 | 53.7 | klogg 108.14 | klogg より 2.01 倍速い |
| 50GB 相当の gz を検索する | 35.65 | 17.20 | gzip -dc \| rg 22.06 |
同等(gzip -dc \| rg より 1.28 倍速い) |
| 読み出しの実効速度 | MB/s |
|---|---|
| 連載を始めた時点 | 486 |
| v1.6.6(3GB/10GB/50GB) | 967/966/969 |
| 外付け USB SSD の素読み | 950〜970 |
3 つの大きさで同じ値が出たのは、もう自分の実装ではなく媒体の速さを測っているからです。上限を先に測っておいたので、ここで止まったことが分かりました。
「連載を始めた時点」の列は、画面が v1.6.5、コマンドが v1.6.0〜v1.6.2 の値です。1 つの版の一覧ではありません。
2. 13 回の直し
| 回 | 直したこと | 前 → 後 |
|---|---|---|
| ① | 205 秒の内訳を測った。行の位置を集める約 100 秒・探す約 82 秒・ヒットした行を読み直す約 20 秒が、別々にファイルを読んでいた | (測っただけ) |
| ② | 3 つを 1 回の読みにまとめた | 50GB 203 秒 → 50.82 秒 |
| ③ | -i を文字列に戻さず、バイト列のまま ASCII の大小だけ畳む |
3GB の 2 回目 2.72 秒 → 0.66 秒(ripgrep 0.63 秒・同等) |
| ④ | 正規表現から「必ず含む文字列」を控えめに取り出し、先に行を絞る | 50GB の -E 13.68 秒 → 7.75 秒 |
| ⑤ | 同じコマンドで件数が毎回違った(並列で先に 100 万件集めたら打ち切っていた)。打ち切りの既定を無くし、打ち切ったときは終了コード 2 で知らせる | 速さより再現性を取った(50GB 1.24 秒 → 27.12 秒・ripgrep 60.35 秒) |
| ⑥ | コマンドが探した結果を一時ファイル 1 つで画面に渡し、2 回読みを 1 回に | 50GB の通し 50.76 秒(klogg 108.14 秒) |
| ⑦ | 3GB でだけ負けていた原因は固定費。段階的 JIT の設定を切り、ライセンス確認の外部コマンド(約 0.2 秒/回)をやめた | 3GB の 2 回目 7 項目 11.46 秒 → 7.95 秒。uvp は ripgrep の方が 1.48 倍速い → uvp が 1.16 倍速い |
| ⑧ | gz を外部コマンドなしで読む。macOS では OS の zlib を直接呼び、CRC32 を 8 バイトずつ照合 | 50GB 相当の gz 35.65 秒 → 17.20 秒 |
| ⑨ | 「差」と呼ぶ基準を測る前に決めた。1 項目なら 1.5 倍未満、7 項目以上の合計なら 1.3 倍未満は差と呼ばない | 下限を 2 倍から 1.5 倍に下げたら、ripgrep との判定が 6 行ひっくり返った |
| ⑩ | 画面の表示は mmap、通し読みは pread(4MB ずつ)に分けた | 読み出し 551 → 966MB/s、50GB を開く 100.6 秒 → 50.44 秒 |
| ⑪ | 改行を速く数えた(メモリ上 1.74 → 3.27GB/s) | ディスクから読むときは、どちらも 968〜969MB/s で 1 秒も動かなかった |
| ⑫ | 同じ計測の手順を Mac・Windows・Linux(仮想機)で回した。Windows の cold が効いていなかったので全部取り直した | ripgrep・sed との出力の不一致は 3 環境とも 0 件 |
| ⑬ | 総集編 | 上の 1 章の表 |
並べてみると、新しいアルゴリズムを持ち込んだ回が 1 つもありません。 全部が「読む回数を減らす」「読み方を変える」「1 回ごとに払う分を削る」のどれかでした。
⑪の「1 秒も動かなかった」改行の数え方は、後になって効きました。ファイルがメモリに載った 2 回目では、ディスクを待たないので改行を数える時間がそのまま見えます。16 バイトずつまとめて数えるようにすると、3GB で 0.15 秒 → 0.028 秒になり、2 回目の検索が ripgrep を少し追い越しました(3GB 0.29 秒 対 0.31 秒・v1.7.3.6.9)。ディスクが遅いうちは見えない遅さが、キャッシュに載ると前に出てくる、という形でした。
3. C#(.NET)と Avalonia ならではの所
言語やフレームワークのせいにできる所は、思っていたより少なかったです。それでも、.NET に固有の事情はいくつかありました。
- 段階的 JIT の設定(⑦): .NET はまず軽く機械語にしてから、よく通る所を作り直します。1 回で終わるコマンドではこの手間がそのまま固定費になり、3GB のように小さいファイルでだけ ripgrep に負けていました。設定(
TieredCompilationQuickJitForLoops)を切ると、3GB の 2 回目 7 項目が 11.46 秒 → 7.95 秒になりました。無料版のuvfに同じ設定を入れても 8.33 秒 → 8.23 秒(1.2%)しか動きません。こちらは読み出しで速さが決まっていたからです。 - NativeAOT と正規表現: 配布している
uvfは NativeAOT(前もって機械語にした形)です。この形では .NET の正規表現が解釈実行になり、全部の行に正規表現を当てる重い式だけ遅くなります。そういう式は、同じフォルダーにある画面の本体(JIT が効く)に任せています。 - 大小を無視した比較(③): .NET の
IgnoreCase | CultureInvariantが ASCII の英字に一致させる非 ASCII の文字は、BMP 全体を調べてケルビン記号 U+212A の 1 文字だけでした。だから、その 1 文字だけ別に扱えば、バイト列のまま畳んでも答えが変わりません。 - 画面(Avalonia)の側(⑥・⑩): 画面はスクロールに合わせて見える所だけを読むので mmap が向いていますが、ファイルを頭から終わりまで読む処理(行の位置を集める・検索)は pread の方が速く、mmap の順次読みは pread の 57% しか出ませんでした。表示と通し読みで読み方を分けて、50GB を開く時間が半分になりました。コマンドで探した結果は一時ファイル 1 つで画面に渡し、画面がもう 1 回読み直さないようにしています。
Rust で書き直したら、ripgrep に並んだか
「Rust だから速いのか」を確かめるため、uvf の検索部分を Rust に移した版を作りました。出力が uvf と 1 バイトも違わないことを確かめてから、Linux カーネルのソース 8.6 万本・5 種類の検索で測っています(cold+hot・3 回の中央値・2026 年 10 月 4 日)。
| ripgrep(秒) | uvf・C#(秒) |
Rust 版・regex crate に任せた形(秒) | Rust 版・1 対 1 で移した形(秒) |
|---|---|---|---|
| 30.62 | 37.55 | 36.85 | 42.89 |
Rust 版は C# 版と同じ速さでした(regex crate に任せた形が uvf より 1.02 倍速い)。1 対 1 で移した形が遅いのは、ファイルごとに正規表現を組み立て直す作りをそのまま移したからで、1 回だけ組み立てるようにすると同じ速さになりました。起動の時間も ruvf 1.7ms・ripgrep 2.7ms・uvf 4.7ms で、差は約 3ms です。
Rust 版がはっきり速かったのは、必須の文字列を取り出せない正規表現だけでした。Rust の regex は 1 文字やバイトの並びでも先に行を絞るからです。この絞り方を C# の uvf に入れると、その種類の式が 2.3〜6.1 倍速くなり、[0-9]{4}-[0-9]{2} は ripgrep と同じ(1.34 秒 対 1.33 秒)になりました。Rust から持ち帰ったのは、言語ではなく絞り方です。
4. いまの位置(v1.9.0・2026 年 10 月 14 日)
First Light の後も直しを続けました。いまの配布版での、検索 7 種(素の検索・-i・-E・行頭つきの -E・-E -i・-v・-E -v)の cold+hot の 2 回計です。
| 検索 7 種・2 回計 | 3GB | 10GB |
|---|---|---|
無料版 uvf |
ripgrep より 1.08 倍速い(同等) | ripgrep より 1.08 倍速い(同等) |
UwView Pro の uvp(索引を作る 1 回目を含む) |
ripgrep より 3.44 倍速い | ripgrep より 3.55 倍速い |
1 回だけ探すなら、ripgrep で十分です。 uvf は ripgrep を追い越す道具ではなく、並んだところまでです。uvp が速くなるのは、1 問目に索引(.uwvz、圧縮形式+索引)を作り、2 問目からはそれだけを読むからです。ripgrep と比べた全部の数字は、ripgrep・grep と比べた全記録のまとめにあります。
コマンドで書くと、こうなります。
# ripgrep で 1 回探す
rg '東京' big.xml

# uvf ならこう書く(索引を持たない。ripgrep と同じ条件)
uvf big.xml '東京'

# uvp ならこう書く(1 問目に索引を作り、2 問目から速くなる)
uvp big.xml '東京'
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
負けているところ・同等のところ
uvpの 1 問目は、ripgrep の方が 6〜7% 速いままです(50GB で 59.0 秒 対 54.9〜55.8 秒・v1.6.6.1)。索引を圧縮して書いている分で、2 問目以降を速くするための代金なので、設計を変えない限り消えません。v1.9.0 でも 3GB で ripgrep の方が 1.33 倍、10GB で 1.16 倍速い向き(どちらも同等の範囲)です。- First Light の時点では、3GB の 2 回目(素の検索)で ripgrep の方が 1.69 倍速かった(0.32 秒 対 0.54 秒)。v1.9.0 では
uvpが 0.17 秒・ripgrep 0.31 秒で入れ替わりました。 - 先頭だけ出す
-headは、rg | headの方が 1.5〜6 倍速いです。 相手は必要な分だけ読んで打ち切れますが、こちらは索引の都合で読む量が減りません。 - 2 コアの Linux(仮想機)の 3GB では互角止まり(ripgrep の方が 1.01 倍速い)。索引の展開が CPU で律速するので、コアの少ない機械では索引を持つ利点が消えます。
- .NET の正規表現なので、書けるものが ripgrep と違います。 POSIX の文字クラス(
[[:alpha:]])と\p{Han}は書けません。 - 秒は、ほとんどが 1 台の Mac の値です。Windows・Linux の値は、それぞれの機械の中での比だけを書いています(改善記⑫)。
持ち帰れること
- アルゴリズムを疑う前に、読む回数を数える。 205 秒を見て最初にやったのは、プロファイラーを回すことではなく、同じファイルを何回読んでいるかを数えることでした。
- 上限を先に測る。 媒体の素読みが 950〜970MB/s だと知っていたので、967MB/s で止めてよいと分かりました。上限を超える数字は、速い証拠ではなく測り間違いの証拠です。
- 律速の外側を速くしても、秒は動かない。 ただし、別の条件(2 回目・速い媒体)では効くことがあります。
- 「差」の基準は、結果を見る前に決める。 1.06 倍を「勝ち」と書かないためです。
- 言語やフレームワークを疑うのは最後でよい。 C#/Avalonia のままで、ripgrep と並ぶところまで来ました。
元の記事
First Light 連載(2026 年 9 月・v1.6)
- 自作CLIが50GBの検索で ripgrep に3.7倍負けた — 改善記①:205秒の内訳を測る
- 自作CLIを ripgrep 並みの速さにした — 改善記②:2回半読みを1回に畳んで 203秒→50.82秒
- 自作CLIの -i が ripgrep に4.3倍負けていた — 改善記③
- 正規表現だけ遅い自作CLIを ripgrep と同じ性質にした — 改善記④
- 自作CLIが同じコマンドで3回とも違う件数を返した(ripgrep は毎回同じ) — 改善記⑤
- CLIが探した結果を画面に渡して2回読みを1回にした — 改善記⑥
- 小さい3GBでだけ ripgrep に1.48倍負けていた — 改善記⑦
- 「gz は検索できません」と書いていた — 改善記⑧
- 自分に有利な数字を「差」と呼ばない基準を先に決めた — 改善記⑨
- 画面が klogg に約2倍負けていた原因は mmap だった — 改善記⑩
- 改行を1.88倍速く数えられるようにしたのに、秒数は1秒も動きませんでした — 改善記⑪
- Windows の「cold」が嘘だったので全部測り直した — 改善記⑫
- ripgrep に3.7倍・klogg に1.9倍負けていた自作ビューアが並びました — 改善記⑬(最終回)
その後の 2 本
- uvp コマンドを付けました — ripgrep と同じ答えを、10GBで7倍速く。3GBも、冷えていれば勝ちます
- Rust の ripgrep に C# で追いつくまで — 巨大ファイルは205秒から同等へ
UwView を試す
- UwView のダウンロード(Windows・macOS・Linux)/GitHub の Releases
- ソースコード(GitHub)
- 同じファイルに何度もたずねるなら、索引を持つ UwView Pro(1 ライセンスで全 OS)
- 2 つのファイル・フォルダーを比べるなら、同じエンジンを使う姉妹ツール UwDiff
※ 数字はすべて開発者本人が測ったもので、測った環境・版・日付の条件付きです。環境によって変わります。比べた ripgrep は 15.2.0(Linux の一部は 15.1.0)、klogg は 24.11.0.1685 です。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。