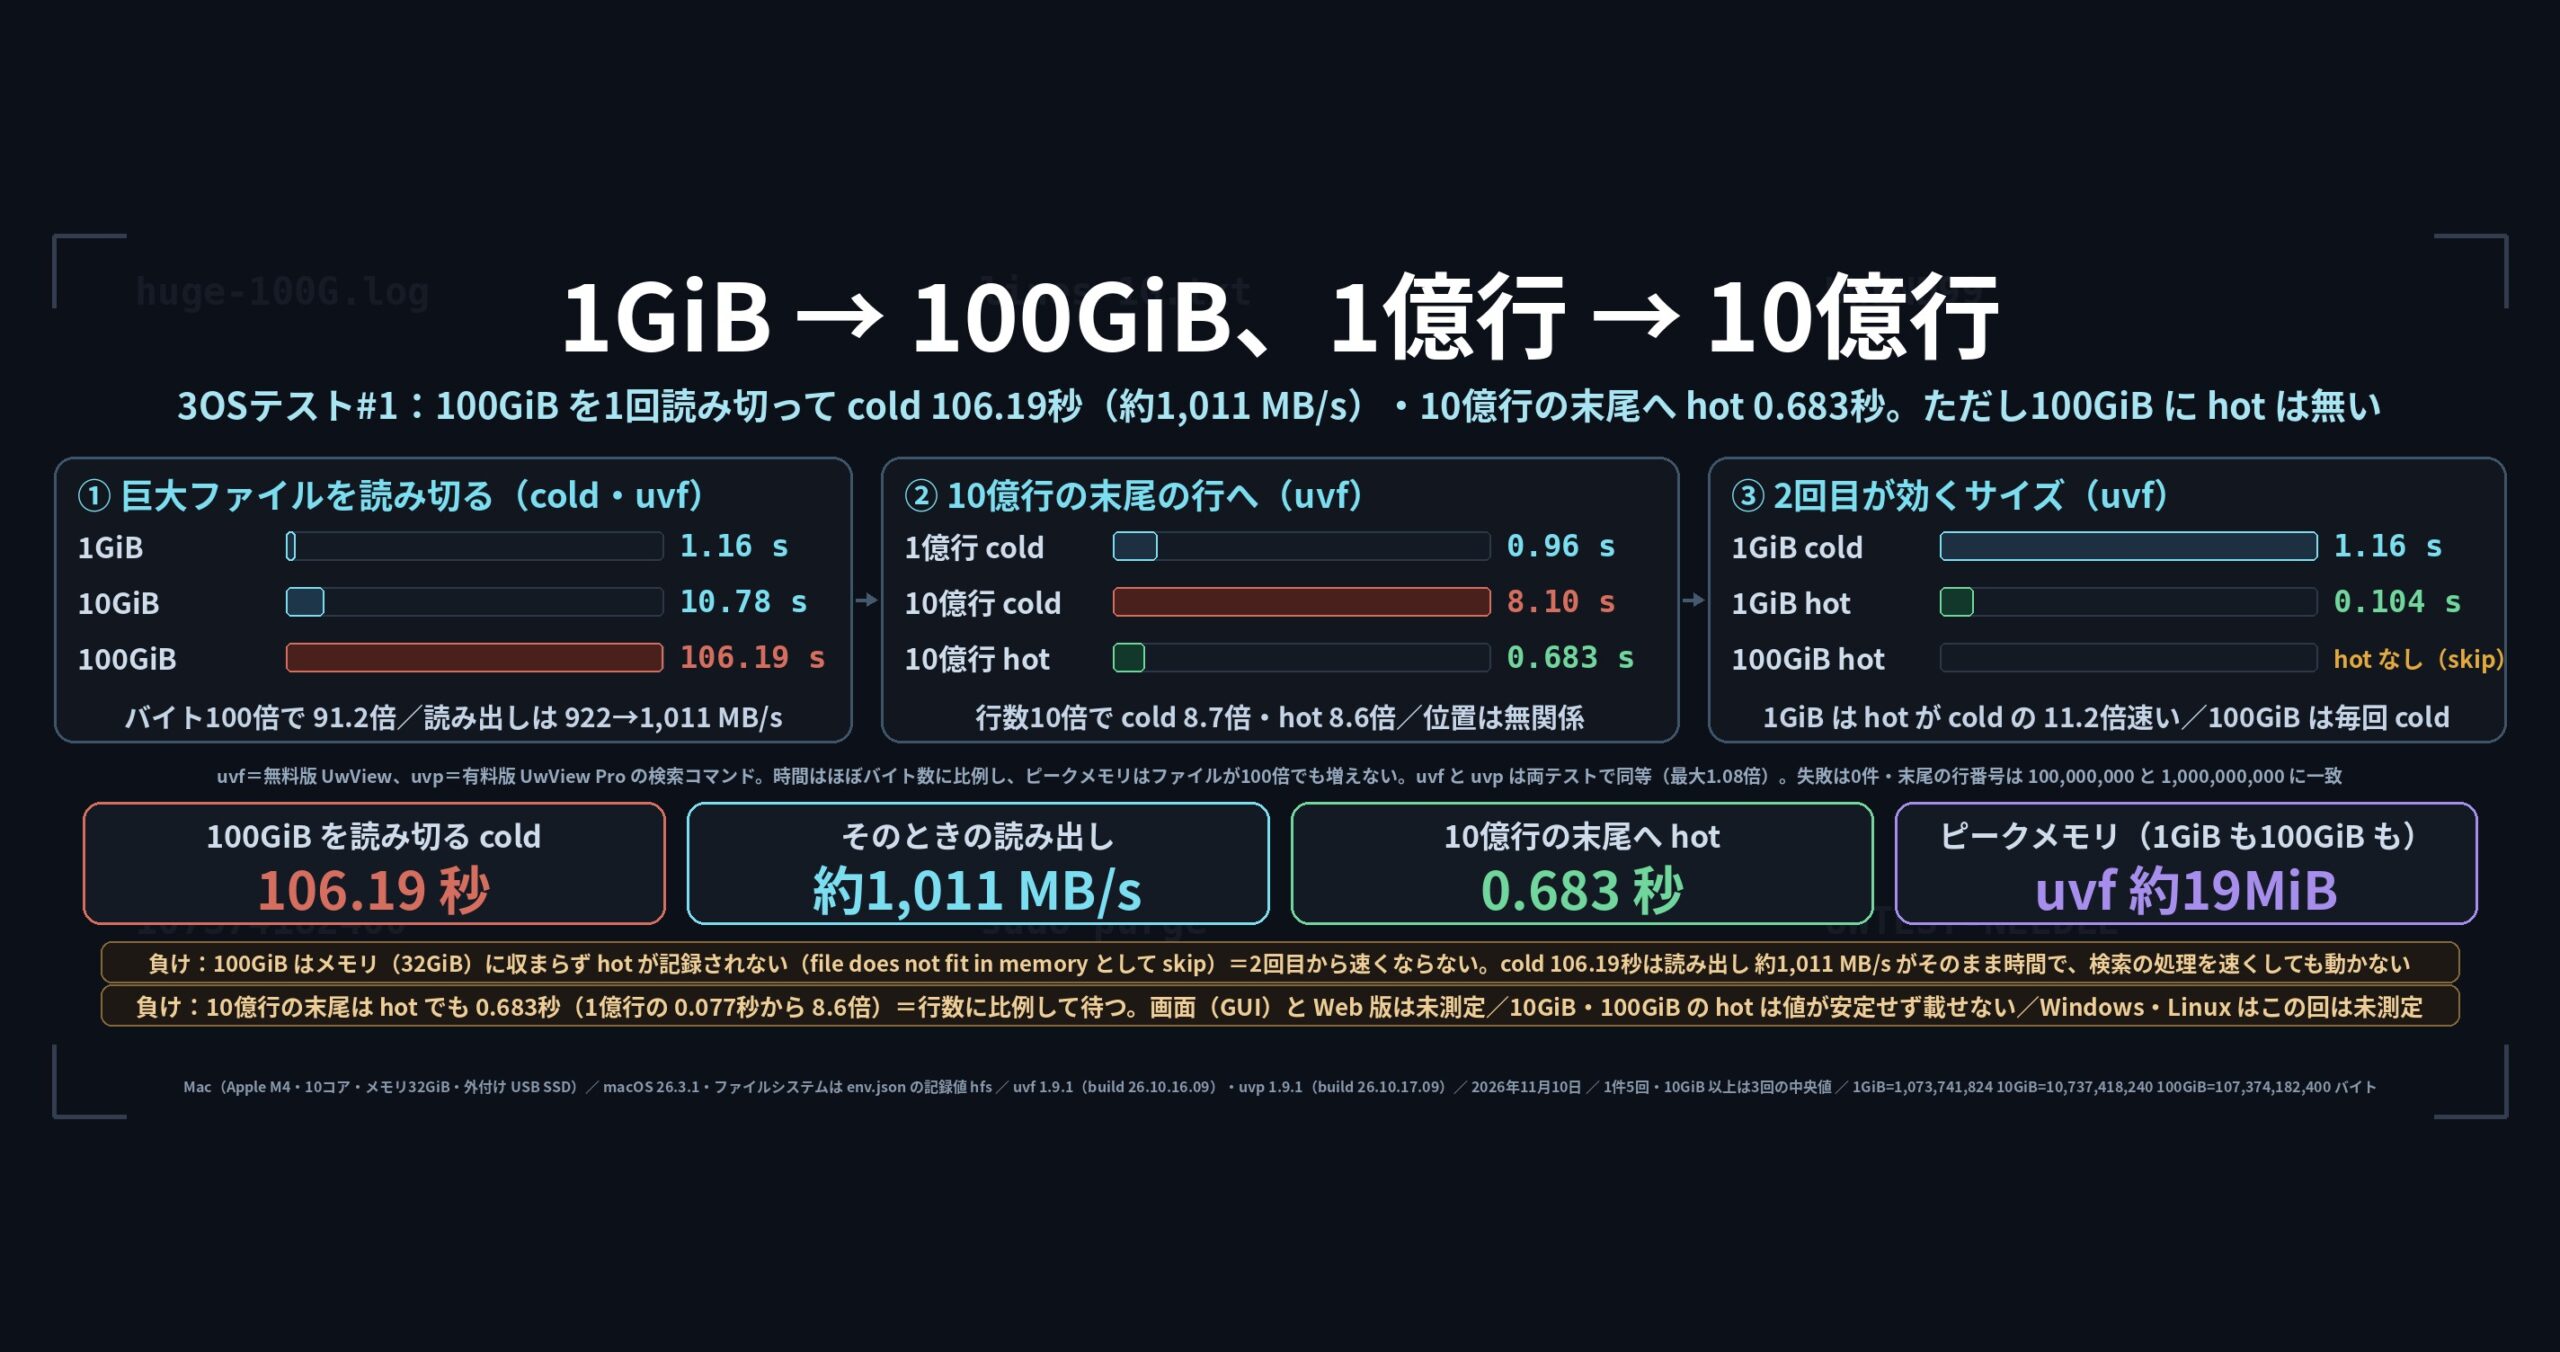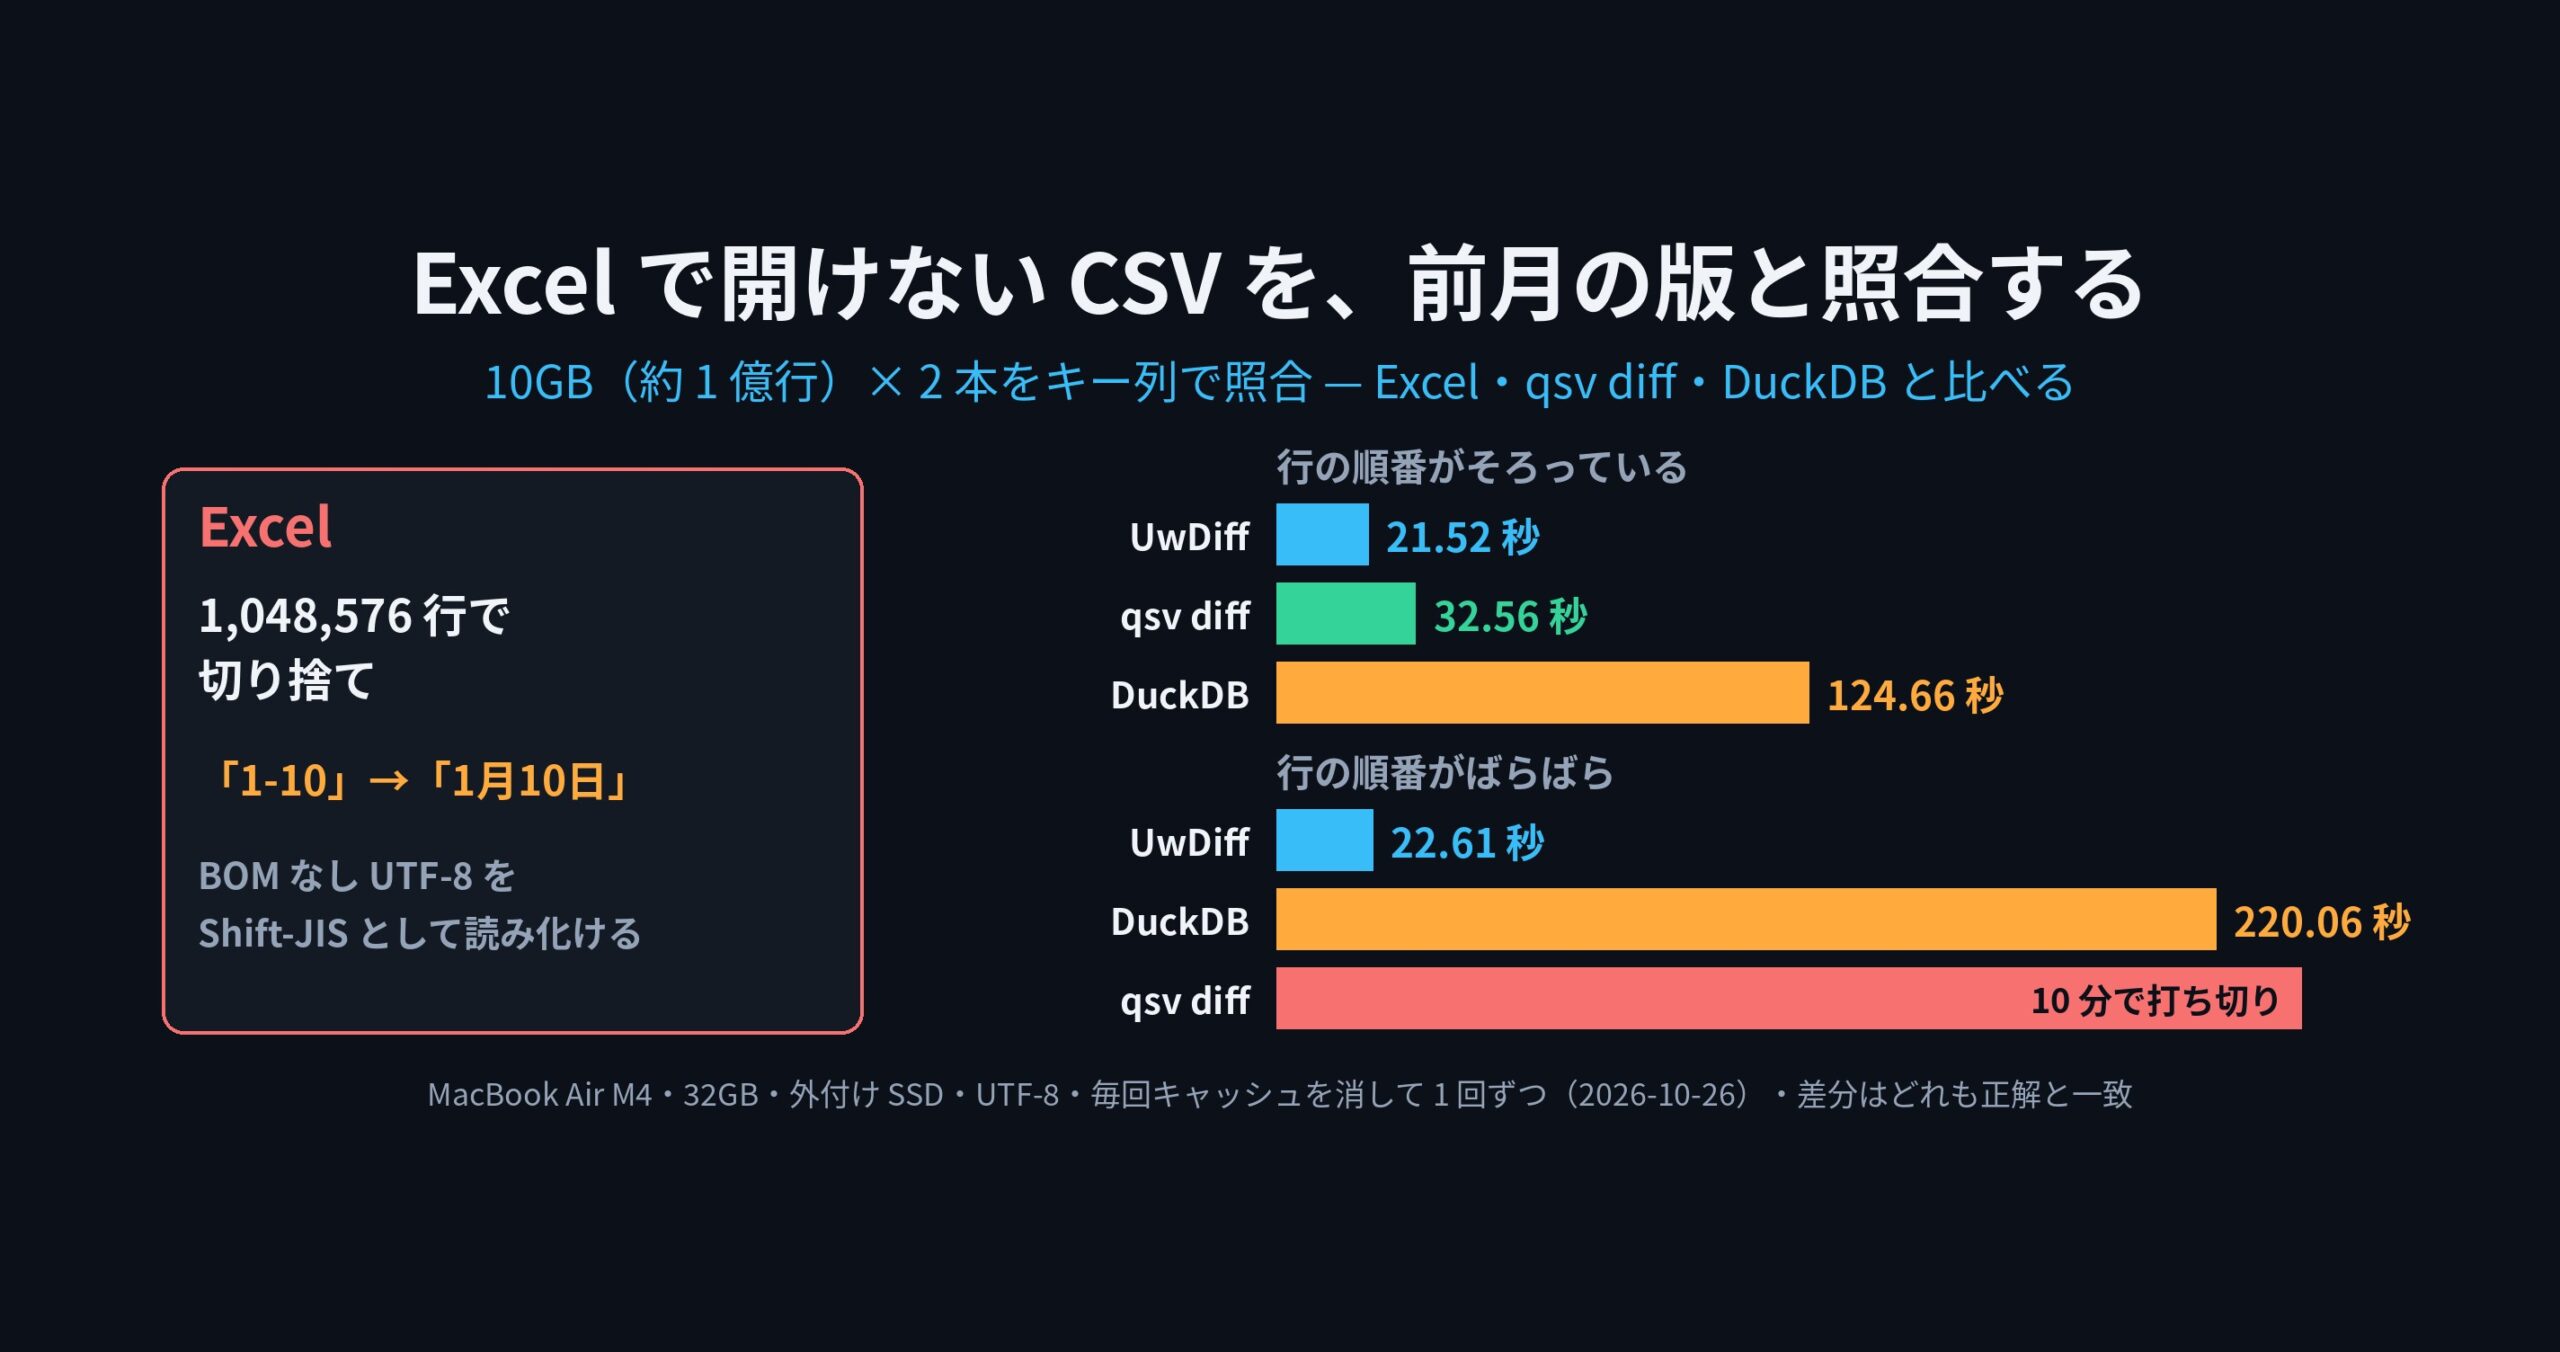
UwView(ユーダブリュービュー) は、巨大なログ・テキストを開いて探す Windows・macOS・Linux 用のビューアです。ファイルをメモリに載せずに読むので、10GB・50GB・258GB でもすぐに開き、gz・zst など 7 形式の圧縮ファイルや Word・Excel・PDF の中も検索できます。無料版(CLI は uvf)と、索引で 2 回目以降の検索を速くする有料版 UwView Pro(uvp)、2 つのファイル・フォルダを比べる姉妹ツール UwDiff(uvd)があります。
「巨大なファイルを grep するなら ripgrep」。それは今も正しい答えです。このサイトでは 2026 年 9 月から 10 月にかけて、ripgrep と grep を相手に巨大ファイルの検索を測った記事を 25 本書きました。最初は 50GB の検索で ripgrep に 3.7 倍負けていました。
このページは、その 25 本の数字と、速くなった理由を 1 か所にまとめたものです。いまの数字とそこに至る経緯を分けて書きます。数字はすべて開発者本人の実測で、主に 1 台の Mac の値です。その前提で読んでください。負けている場面も、そのまま書きます。
※ファイル容量の表記について:このページでは、ファイルの大きさを GB(SI・÷1000³)で書きます。「3GB」は 3,032,812,644 バイト、「10GB」は 10,255,315,281 バイト、「50GB」は 51,254,526,392 バイト(過去の記事で「48GB」「51GB」と書いたものと同じファイル・47.73GiB)、「258GB」は 258,679,440,228 バイトです。どれも OpenStreetMap を XML に展開したデータです。
版の呼び名について:v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。v1.7 台は「Wide Field」(複数ファイル・圧縮 7 形式・zip・pbf)。v1.9 には「Full Spectrum」というペットネームを付けました。Shift_JIS・EUC-JP・UTF-16 のファイルも中を UTF-8 にそろえ、文字コードやファイルの種類を問わず、同じ速さで探せるようになった版だからです。いまの配布版は v1.9.0 “Full Spectrum” です。
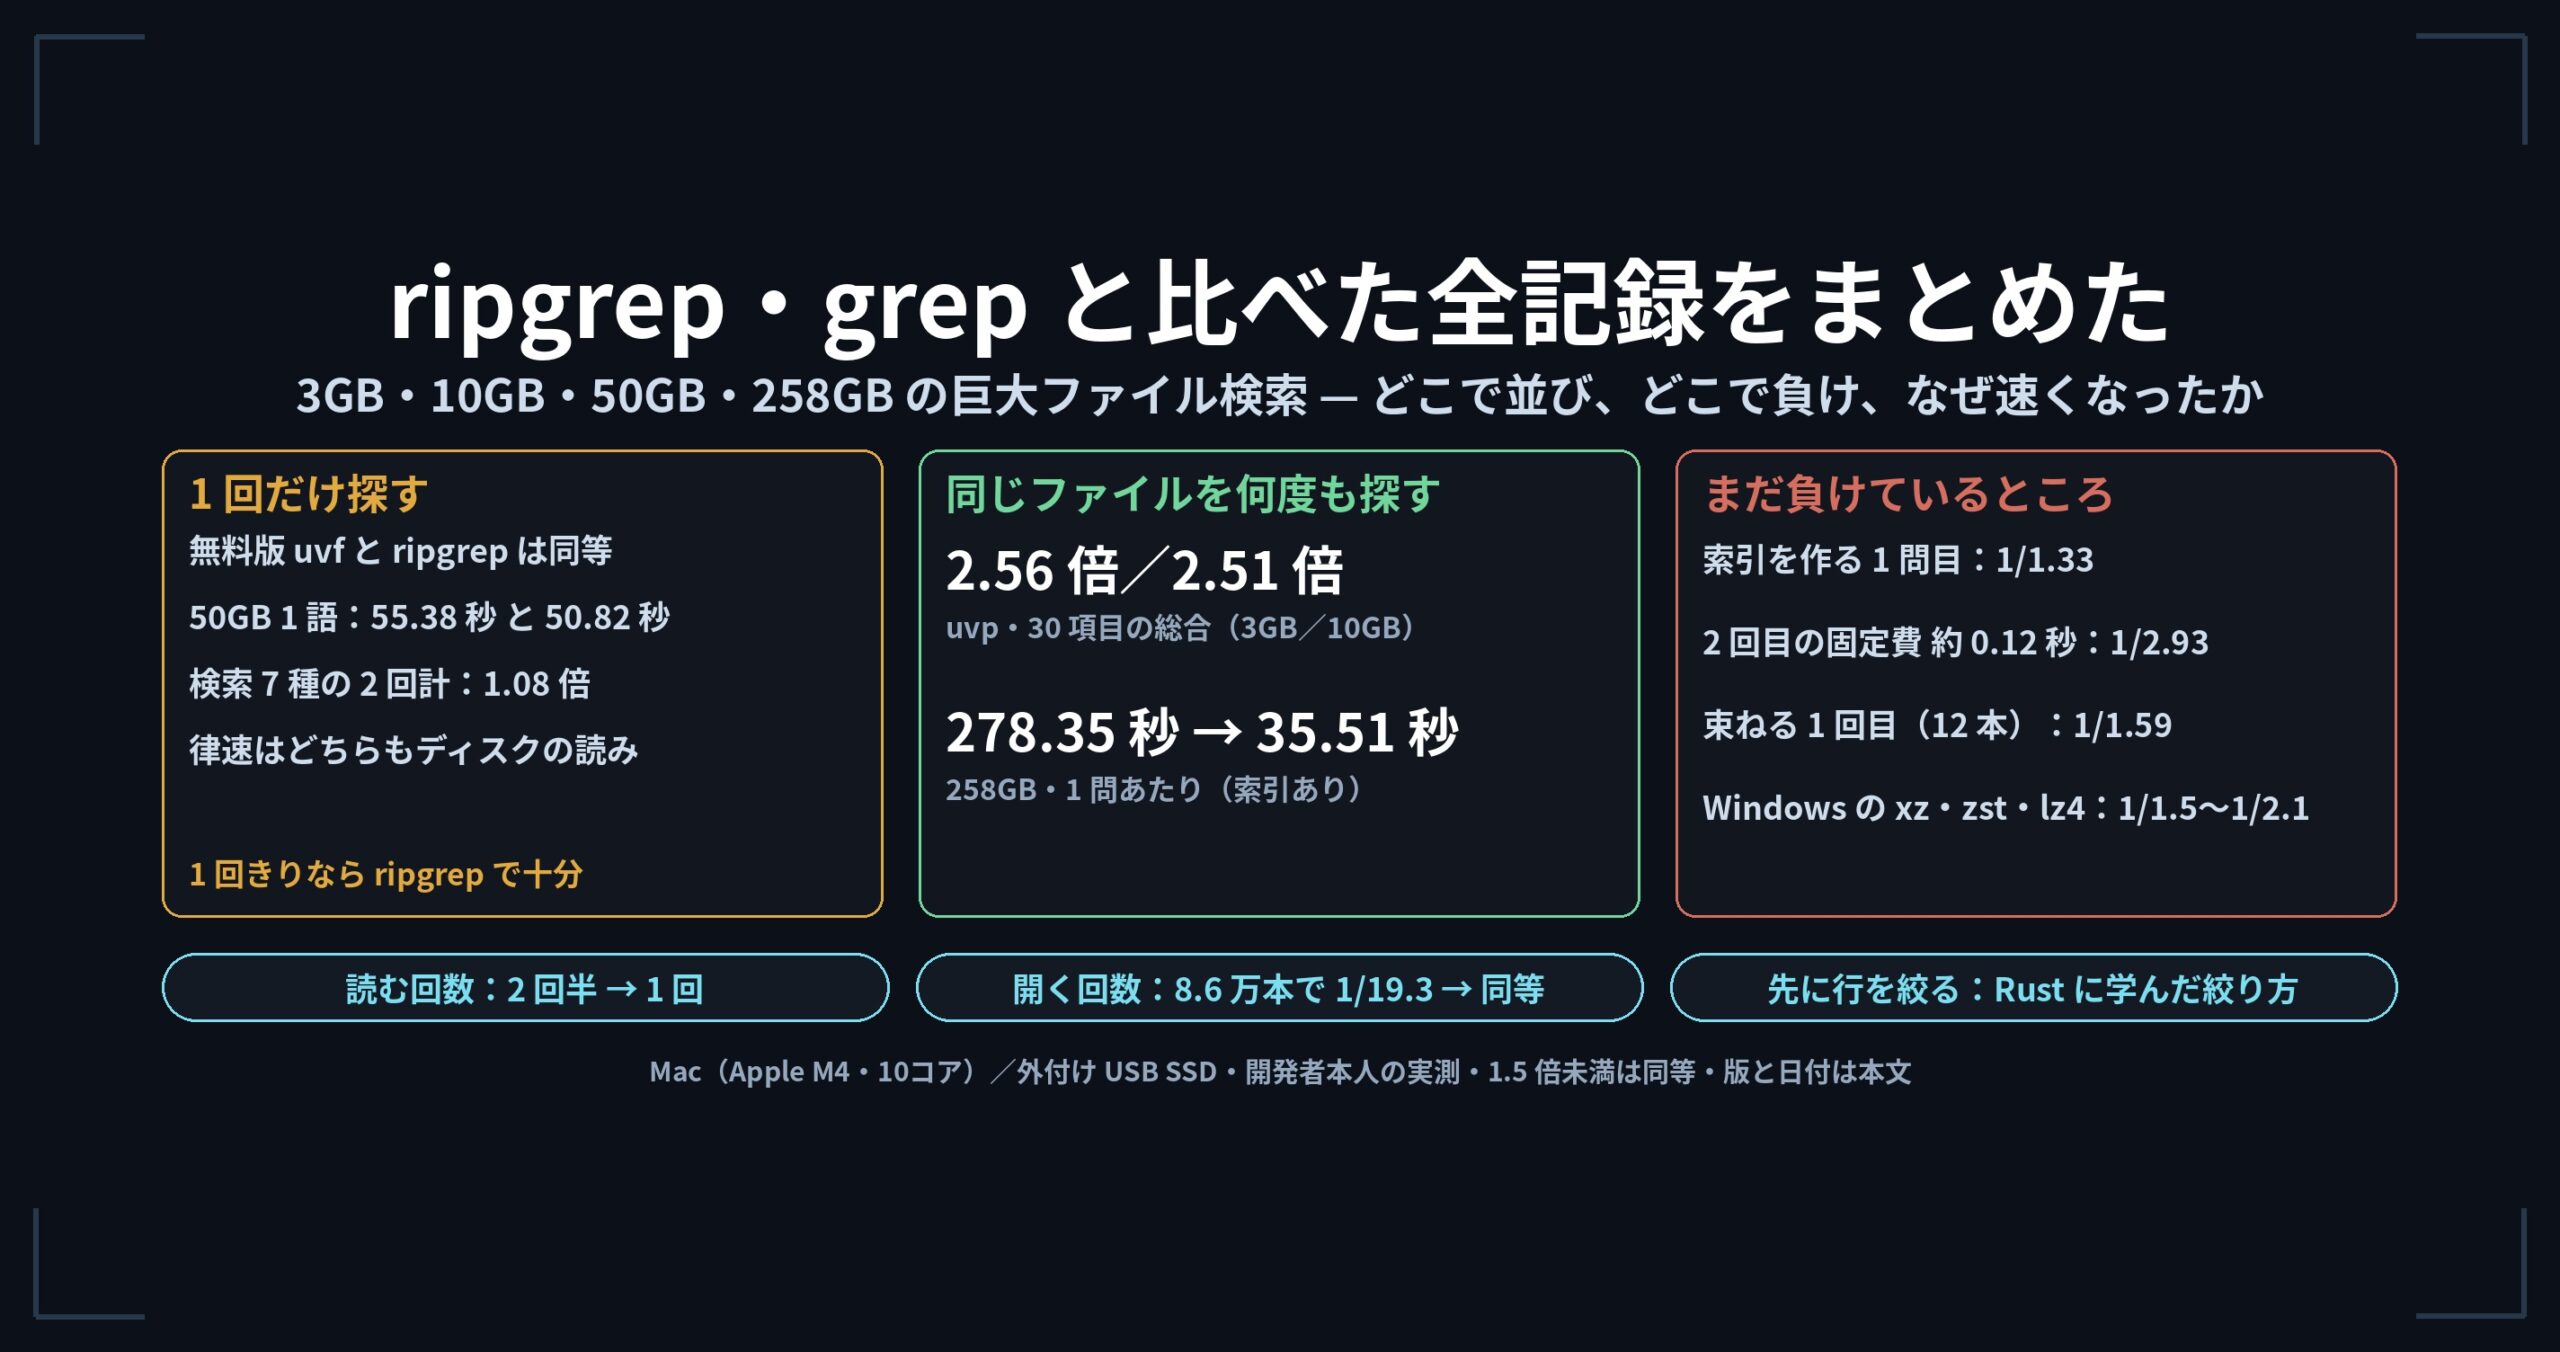
- 先に結論: 1 回だけ探すなら無料版 uvf と ripgrep は同等。同じファイルを何度も探すなら、索引を持つ uvp が ripgrep の 2.5 倍前後。差を生んだのは言語ではなく、読む回数・開く回数・絞り方だった
- 1. いまの数字 — v1.9.0(2026 年 10 月 13〜14 日・Mac)
- 2. 1 回だけ探す — 無料版 uvf と ripgrep
- 3. 何度も探す — 索引を持つ uvp と ripgrep
- 4. なぜ速くなったか — 205 秒から同等までの経緯
- 5. 3 つの OS で — Mac だけの結論になっていないか
- 6. 速さより先に決めていること — 答えが同じか、どこからを「差」と呼ぶか
- 負けているところ・同等のところ
- 各回を読む
- リンク
先に結論: 1 回だけ探すなら無料版 uvf と ripgrep は同等。同じファイルを何度も探すなら、索引を持つ uvp が ripgrep の 2.5 倍前後。差を生んだのは言語ではなく、読む回数・開く回数・絞り方だった
- 1 回だけ探すなら、ripgrep で十分です。 無料版の
uvfも、検索 7 種の 2 回計で ripgrep と 1.08 倍(3GB・10GB とも同等)に並んだところまでです。UwView(巨大ファイルを、いつでも瞬時に)の CLI は、ripgrep を追い越す道具ではありません。 - 同じファイルに何度も聞くなら、差が開きます。 UwView Pro(巨大ファイルを、いつでも瞬時に)の
uvpは、1 問目に索引(.uwvz、圧縮形式+索引)を作り、2 問目からはそれだけを読みます。v1.9.0 の 30 項目の総合は、索引を作る 1 問目を含めて 3GB で 2.56 倍・10GB で 2.51 倍でした。258GB では 1 問 278.35 秒 対 35.51 秒です。 - 速くなった理由は、Rust と C# の違いではありませんでした。 同じ作りを Rust で書き直しても C# 版と同じ速さでした。効いたのは、ファイルを読む回数(2 回半 → 1 回)、小さなファイルを開く回数、正規表現で先に行を絞る手がかりの 3 つです。
1. いまの数字 — v1.9.0(2026 年 10 月 13〜14 日・Mac)
同じ Mac(Apple M4・10コア・メモリ 32GB・外付け USB SSD)で、ripgrep と同じ式・同じファイルを測った値です。cold は sudo purge のあと 10 秒待った 1 回目、hot は続けた 2 回目です。倍率は「ripgrep の時間 ÷ こちらの時間」で、1 より大きければこちらが速く、1/○ はこちらが遅いことを表します。1.5 倍未満は「同等」と書きます。
| 比べたこと | ripgrep(秒) | こちら(秒) | 結果 | 出典 |
|---|---|---|---|---|
3GB・東京・2 回目(uvf) |
0.31 | 0.29 | 1.07 倍・同等 | Wide Field⑫ |
3GB・東京・2 回目(uvp) |
0.31 | 0.17 | 1.8 倍 | Full Spectrum③ |
3GB・東京・1 回目(uvp・索引を作る分を含む) |
3.27 | 4.35 | 1/1.33・同等(ripgrep が速い向き) | Full Spectrum③ |
3GB・-E -i・2 回目(uvf) |
0.56 | 0.48 | 1.17 倍・同等 | Wide Field⑨ |
10GB・-E -i・2 回目(uvf) |
1.75 | 1.38 | 1.27 倍・同等 | Wide Field⑨ |
3GB・-E -v(^ +<)・2 回目(uvp) |
3.10 | 0.11 | 28.2 倍 | Full Spectrum② |
10GB・前置できない正規表現・2 回目(uvp) |
13.54 | 0.73 | 18.55 倍 | Full Spectrum④ |
10GB・東京・2 回目(uvp) |
0.98 | 0.43 | 2.28 倍 | Full Spectrum④ |
10GB・東京・1 回目(uvp) |
10.96 | 12.72 | 1/1.16・同等(ripgrep が速い向き) | Full Spectrum④ |
1 回目と 2 回目を足した「2 回計」では、こうなりました(出典は Rust と C# の記事の追記・81 項目の記事の追記・Full Spectrum④)。
| 2 回計 | 結果 |
|---|---|
検索 7 種・3GB/10GB(uvf) |
1.08 倍/1.08 倍(同等) |
検索 7 種・3GB/10GB(uvp・索引を作る分を含む) |
3.44 倍/3.55 倍 |
30 項目の総合・3GB/10GB(uvp) |
2.56 倍/2.51 倍(出力は ripgrep と不一致 0) |
集計・並べ替え(uvp と rg+sort+uniq) |
4.2〜4.9 倍 |
複雑な検索 3 例・Linux カーネル約 6 万本(uvp) |
2.35〜4.56 倍 |
複雑な検索 3 例・1GB の 1 本(uvp) |
1.22〜2.13 倍 |
「検索 7 種」は、素の検索・-i・-E・行頭つきの -E・-E -i・-v・-E -v です。「複雑な検索」は、複数行のブロックを取り出して伏せ字にする・近い行の組み合わせを探す・CSV に整えて集める、の 3 例で、ripgrep 側は perl・awk をつないでいます。
2. 1 回だけ探す — 無料版 uvf と ripgrep
索引を作らない uvf は、ripgrep と同じく「ファイルを 1 回読んで探す」道具です。どちらもディスクの読み出しが速さを決めるので、大きなファイルでは横に並びます(3 つの土俵の記事・2026 年 9 月)。
50GB・東京・cold |
秒 |
|---|---|
| ripgrep 15.2.0 | 55.38 |
uvf |
50.82 |
1.09 倍で、同等です。検索 7 種の 2 回計も、Mac では 3GB 1/1.06(ripgrep が速い向き)・10GB 1.08 倍・50GB 1.07 倍と、すべて同等の範囲でした。
ただし、ripgrep の速さは OS と読み方で変わります。ripgrep は大きなファイルを既定で mmap で読みますが、--no-mmap を付けると Windows 11 の 50GB・正規表現+除外が 282.84 秒 → 97.83 秒(2.89 倍)になりました。macOS ではどちらも同じで、Linux(仮想機)では軽い検索は既定が速く、重い検索は --no-mmap が速いという結果です(mmap と no-mmap の記事)。Windows のノートで uvf が 2.57 倍と大きく出たのは、uvf が速いからではなく、Windows の ripgrep が既定の読み方で遅くなっていたからです。
ディスクが遅いと、全員が並びます。読み出し 0.41GB/s の外付けドライブで 51.25GB を探すと、grep 64.64 秒・ripgrep 71.49 秒で、grep の方が速く出ました(51GB の記事・2026 年 9 月)。
3. 何度も探す — 索引を持つ uvp と ripgrep
uvp が速くなるのは、2 問目から元のファイルではなく .uwvz(元の約 1/9 の大きさ)を読むからです。cold と hot を分けて測った値です(uvp コマンドの記事・uvp 1.6.3・ripgrep 15.2.0・.uwvz は作成済み)。
東京 |
ripgrep cold/hot(秒) | uvp cold/hot(秒) |
結果 cold/hot |
|---|---|---|---|
| 3GB | 3.26/0.33 | 1.25/1.01 | 2.6 倍/1/3.1 |
| 10GB | 10.96/10.89 | 2.37/1.55 | 4.6 倍/7.0 倍 |
| 50GB | 54.76/55.15 | 7.76/6.34 | 7.1 倍/8.7 倍 |
10GB 以上はメモリに収まらないので、ripgrep は何度読んでもディスクから読み直します。3GB だけは 32GB のメモリに収まり、2 回目の ripgrep がキャッシュの上を 0.33 秒で走りました。この 3GB の hot の負けは、v1.9.0 で 0.31 秒 対 0.17 秒(1.8 倍)に入れ替わりました(1 章の表)。
258GB・45 億行の 1 本では、ripgrep は 5 問の中央値が 278.35 秒で、1 回読み切るだけの時間(wc -l で 268.73 秒)の 1.04 倍でした。CPU は 275 秒のうち 11 秒しか使っていません。勝てる場所は「読むバイト数」だけで、索引と圧縮で 258.68GB を 28.6GB(1/9.04)にした uvp は 35.51 秒です。そのかわり、1 問目に索引を作る 333.67 秒がかかり、元を取るのは 1.37 問目からです(勝てる場所を 1 つだけ選ぶ記事)。
3GB でも、検索以外の操作が入ると話が変わります。置換は sed の 3.5 倍、抽出は 12.6 倍、gz で保管したファイルは「展開+ripgrep」6.47 秒 対 .uwvz を直接 0.68 秒でした(3GB の記事・uvp 1.6.3)。
4. なぜ速くなったか — 205 秒から同等までの経緯
ここからは経緯です。数字はそれぞれの時点の版の値で、いまの値ではありません。
| 時点・版 | 直したこと | 前 → 後 | 出典 |
|---|---|---|---|
| 2026-09-15・v1.6.0 | (出発点)50GB の uvf が 205 秒、ripgrep 56 秒 |
ripgrep が 3.7 倍速い | Rust と C# |
| v1.6.0 | 正規表現から「必ず含む文字列」を保守的に取り出し、先に候補の行を絞る | 50GB の -E 13.68 秒 → 7.75 秒 |
改善記④ |
| v1.6.2 | 件数が毎回違った(並列で先に 100 万件集めたら打ち切っていた)。既定を無制限にし、打ち切りは終了コード 2 で知らせる | 速さより再現性を取った(50GB 1.24 秒 → 27.12 秒・ripgrep 60.35 秒) | 改善記⑤ |
| v1.6.3 | 行番号を数える・一致を調べる・行を渡すを 1 回の読みにまとめた(2 回半読んでいた) | 50GB 203 秒 → 50.82 秒・作業メモリ 57MB | 改善記② |
| v1.6.6 | 1 回ごとの固定費(JIT の設定・外部コマンドの起動)を削った | 3GB hot 7 項目 11.46 秒 → 7.95 秒、uvp の対 ripgrep 1/1.48 → 1.16 |
改善記⑦ |
| v1.6.6 | 表示は mmap、通し読みは pread(4MB)に分けた | 読み出し 551 → 966MB/s、50GB を開く 100.6 秒 → 50.44 秒 | 改善記⑩ |
| First Light の途中 | 改行の数え方を速くした(メモリ上 1.74 → 3.27GB/s) | ディスクから読むときは 1 秒も動かなかった | 改善記⑪ |
| 1.7.3.6.7 | -E -i の目印に = と " を選んでいたのを英字に |
ripgrep の 1/1.68 → 1/1.07 | Rust と C# |
| 1.7.3.6.8 | 改行を 16 バイトずつまとめて数える(3GB で 0.15 秒 → 0.028 秒) | 3GB hot 0.40 秒 → 0.27 秒(ripgrep 0.29 秒) | Wide Field⑫ |
| 1.7.3.6.5 → 1.7.3.7 | Linux カーネル 8.6 万本を 1 本ずつ 3 回開いていたのを減らした | uvf の 2 回目 ripgrep の 1/19.3 → 8 問の 2 回計 1/1.08 |
Rust と C# |
| v1.8.1.9 | ヒットした行の書き出しで確保メモリが膨らんでいた | 3GB 4.70 秒 → 2.68 秒(ripgrep 2.83 秒)・確保 28GB → 0.4GB | Full Spectrum⑤ |
| v1.9.0 | 行の「形」の辞書(行の骨格)で、ヒットの無いブロックを開かない | 3GB -E -v 骨格なし 1.510 秒 → あり 0.062 秒 |
Full Spectrum② |
| v1.9.0 | ブロックごとに 3 バイトの並びの要約(ブロックの印)を持ち、ブロックを 4MB → 1MB に | 東京 1.67 倍・札幌 2.61 倍(印あり・なしの比。この比だけ開発版 1.8.3.4 で測定) |
Full Spectrum③ |
改善記⑪の「1 秒も動かなかった」改行の数え方は、後で効きました。ファイルがメモリに載った 2 回目では、3GB の 0.40 秒のうち 0.15 秒が改行を数える時間だったからです(Wide Field⑫)。ディスクが律速のうちは見えない遅さが、キャッシュに載ると前に出てくる、というのが何度も出てきた形でした。
Rust で書き直したら、ripgrep に並んだか
「Rust だから速いのか」を確かめるため、uvf の検索部分を Rust に移した版を作り、Linux カーネル 8.6 万本・5 種類の検索で測りました(cold+hot・3 回の中央値・2026 年 10 月 4 日)。
| ripgrep | uvf(C#) |
Rust 版(regex crate に任せた形) |
|---|---|---|
| 30.62 秒 | 37.55 秒 | 36.85 秒 |
Rust 版は C# 版と同じ速さでした(1.02 倍)。ripgrep との差は縮まりません。差は作りの側にあり、Rust から持ち帰ったのは言語ではなく「1 文字やバイトの並びでも先に行を絞る」絞り方でした。これを uvf に入れると、必須の文字列が取れない正規表現が 2.3〜6.1 倍速くなりました(Rust と C# の記事)。
ripgrep・grep・klogg などから何を取り入れ、何をあえて入れなかったかは、他のツールに学んだ機能の記事に一覧にしています。
5. 3 つの OS で — Mac だけの結論になっていないか
同じテスト一式を Mac・Windows・Linux の 3 台で流しました。機械がまったく違うので、秒は OS をまたいで比べず、それぞれの機械の上での ripgrep との比だけを並べます。
| Mac | Windows | Linux | |
|---|---|---|---|
| 総合(v1.7.3.6.8〜6.9・96 項目) | 2.49 倍 | 3.42 倍 | 1.88 倍 |
| 総合(v1.6.6・2 回計) | 2.30 倍 | 3.06 倍 | 1.76 倍(仮想機) |
| ripgrep・sed との出力の不一致 | 0 件 | 0 件 | 0 件 |
出典は Wide Field⑬(2026 年 10 月 4 日)と 改善記⑫。改善記⑫では、Windows の「cold」がキャッシュを落とし切れていなかった(10GB を 2.65 秒で読んだ記録)と気づき、全部を測り直しています。
Mac では出なかった負けが、Windows で見つかりました。 圧縮ファイルの xz(3GB)・zst(1GB)・lz4(1GB・3GB)で、uvf が ripgrep の 1/1.5〜1/2.1 です(Wide Field⑬)。2 コアの Linux では、uvp の 1 回目(索引を作る分)が重く、zst・lz4・平文の 2 回計で ripgrep の 1/1.2〜1/1.4 でした。
6. 速さより先に決めていること — 答えが同じか、どこからを「差」と呼ぶか
秒数を比べる前に、出力を 1 行ずつ突き合わせています。3GB・10GB・50GB で 東京 の件数は ripgrep と uvp で 11,274/11,393/94,979 件と一致し、大小無視・正規表現・除外・2 語の絞り込み・頻度の集計を含めて不一致は 0 件でした(uvp コマンドの記事)。ripgrep・sed と 81 項目を突き合わせたスクリプトの記録は 81 項目の記事にあります。
「差」と呼ぶ基準は、測る前に文章で決めました。1 項目なら 1.5 倍未満は差と呼ばない、7 項目以上の合計なら 1.3 倍未満は差と呼ばない。下限はもともと 2 倍でしたが、1.5 倍に下げたら ripgrep との判定が 6 行ひっくり返りました(改善記⑨)。このページの「同等」もこの基準です。
負けているところ・同等のところ
- 1 回だけ探すなら、ripgrep で十分です。
uvpの 1 問目は索引を作る分だけ遅く、v1.9.0 でも 3GB で 1/1.33、10GB で 1/1.16(どちらも同等の範囲で ripgrep が速い向き)です。 uvpの 2 回目には、約 0.12 秒の固定費が乗ります。 ripgrep が 0.04 秒で読み切る 1GB 前後の場面では、1,000 本に分けた XML で 0.043 秒 対 0.126 秒(1/2.93)と負けます(Wide Field⑭・v1.7.3.7)。- 複数のファイルを初めて束ねる 1 回目は遅いです。 平文と gz の混在 12 本で 24.95 秒 対 39.78 秒(1/1.59)。取り返すのは 3 回目からです。平文 5 本だけなら 2 回目も 0.32 秒 対 0.53 秒(1/1.66)で、回数を増やしても取り返せません。平文だけを繰り返し探すなら
uvfか ripgrep で足ります(Wide Field⑭)。 - Windows の xz・zst・lz4 で、
uvfが 1/1.5〜1/2.1 です(5 章)。原因はまだ確かめていません。 - どのブロックにもヒットがある式は、骨格でも印でも飛ばせません。
[0-9]{3}-[0-9]{4}"は骨格あり・なしで 0.92〜0.99 倍、highwayは印ありで 0.96 倍(どちらも同等で、新しい仕組みがわずかに遅い向き)。索引は骨格の分 6.3% 大きくなります(Full Spectrum②③)。 - ±N 行の中の 2 語目の突き合わせは 1.24 倍の同等どまり、集計の 2 回目は 1/1.13(同等・ripgrep が速い向き)です(Full Spectrum④)。
- 無料版
uvfの書き出しは、追いついただけです。 2.68 秒 対 ripgrep 2.83 秒(1.06 倍・同等)(Full Spectrum⑤)。 - 正規表現は .NET のものなので、書けるものが違います。 POSIX 文字クラス(
[[:alpha:]])と\p{Han}は書けず、書き換え先は一致範囲まで同じではありません。1 回の照合には 5 秒の上限があります(Wide Field⑨)。--jsonの項目も ripgrep より少なく、file・line・textの 3 つだけです(Wide Field⑭)。 - 過去の負けのうち、いまは入れ替わったもの: 3GB hot の素の検索(1/3.1 → 1.8 倍)、
-E -iの 2 回目(1/2.67〜1/3.06 → 1.17〜1.27 倍)。記事の本文は当時の記録として残し、冒頭に追記しています。 - ここに並べた秒は、ほとんどが 1 台の Mac の値です。 3 つの OS で同じ手順にかける連載を第 0 回から始めています。
各回を読む
いまの全体像
- Rust の ripgrep に C# で追いつくまで — 巨大ファイルは205秒から同等へ、8.6万本は19倍の負けから同等へ、複雑な検索は uvp が ripgrep の1.07〜3.5倍
- ripgrep にまだ負けているところを、全部並べます — Wide Field⑭
- 無料の uvf だけで ripgrep とも klogg とも渡り合えます。uvp が効くのは2問目から — 同じ 50GB を3つの土俵で測った
- klogg・ripgrep・grep・PowerGREP から何を取り入れたか — UwView が他のツールに学んだ機能と、あえて入れなかったもの
ripgrep と並べて測った記録(2026 年 9 月)
- ripgrep は巨大な 1 本のファイルでも速いのか — 51GB・8.9億行で rg / grep / UwView Pro を実測した
- uvp コマンドを付けました — ripgrep と同じ答えを、10GBで7倍速く。3GBも、冷えていれば勝ちます
- uvp と rg・sed の突き合わせ 81項目 — スクリプトの動作ログ(3GB / 10GB / 50GB)
- ripgrep に勝てる場所を1つだけ選ぶ — 読むバイト数を1/9にして、CLI から GUI へ渡す
- 3GBで負けたと思っていたら、勝っていた(ただし冷えていれば) — 単発 grep は譲って、調査の残り全部で勝つ
- ripgrep は no-mmap で2.9倍速くなる — 既定の mmap 読みと 50GB・3OS で比べた
改善記(First Light・v1.6)
- 自作CLIを ripgrep 並みの速さにした — 改善記②:2回半読みを1回に畳んで 203秒→50.82秒
- 正規表現だけ遅い自作CLIを ripgrep と同じ性質にした — 改善記④:必須リテラルを「保守的に」取り出して 50GB の -E を 13.68秒→7.75秒
- 自作CLIが同じコマンドで3回とも違う件数を返した(ripgrep は毎回同じ) — 改善記⑤
- 小さい3GBでだけ ripgrep に1.48倍負けていた — 改善記⑦:律速は読み出しではなく固定費
- 自分に有利な数字を「差」と呼ばない基準を先に決めた — 改善記⑨
- 画面が klogg に約2倍負けていた原因は mmap だった — 改善記⑩
- 改行を1.88倍速く数えられるようにしたのに、秒数は1秒も動きませんでした — 改善記⑪
- Windows の「cold」が嘘だったので全部測り直した — 改善記⑫
Wide Field(v1.7)
- -i 付きの正規表現が ripgrep に2.7〜3.1倍負ける — Wide Field⑨:.NET の正規表現がどこまで同じか
- 「秒に出ない」と書いた改行の数え方が、2回目の検索の4割を占めていました — Wide Field⑫
- 同じテスト一式を mac・Windows・Linux で流したら、Windows で負けが見つかりました — Wide Field⑬
Full Spectrum(v1.9)
- ヒットしない行のかたまりを読まずに飛ばす「行の骨格」 — Full Spectrum②
- 開かなくてよいブロックを先に知る「ブロックの印」と1MBのブロック — Full Spectrum③
- 10GBの2回目はどこで縮んだか — Full Spectrum④
- 無料版 uvf の3つの直し — Full Spectrum⑤
リンク
- 「巨大ファイルが開けない」の答えをまとめた(開く側のまとめ)
- UwView のダウンロード(Windows・macOS・Linux)
- UwView Pro(1 ライセンスで全 OS)
- ベンチマークのまとめ
- ソースコード(GitHub)
※ 数字はすべて開発者本人が測ったもので、測った環境・版・日付の条件付きです。環境によって変わります。比べた ripgrep は、記録のある回では 15.2.0(Linux の一部は 15.1.0)です。