負けを全部並べます。ただ、負けだけでは全体の形が見えないので、勝ち・負けの全体を先に1枚にしました。
この連載は毎回、「先に、負けているところを書きます」から始めてきました。13回ぶんたまったので、散らばった負けを1枚にします。
どこがまだ遅いのか。そしてその負けは、直せるものなのか、索引を持つことの代価なのか。
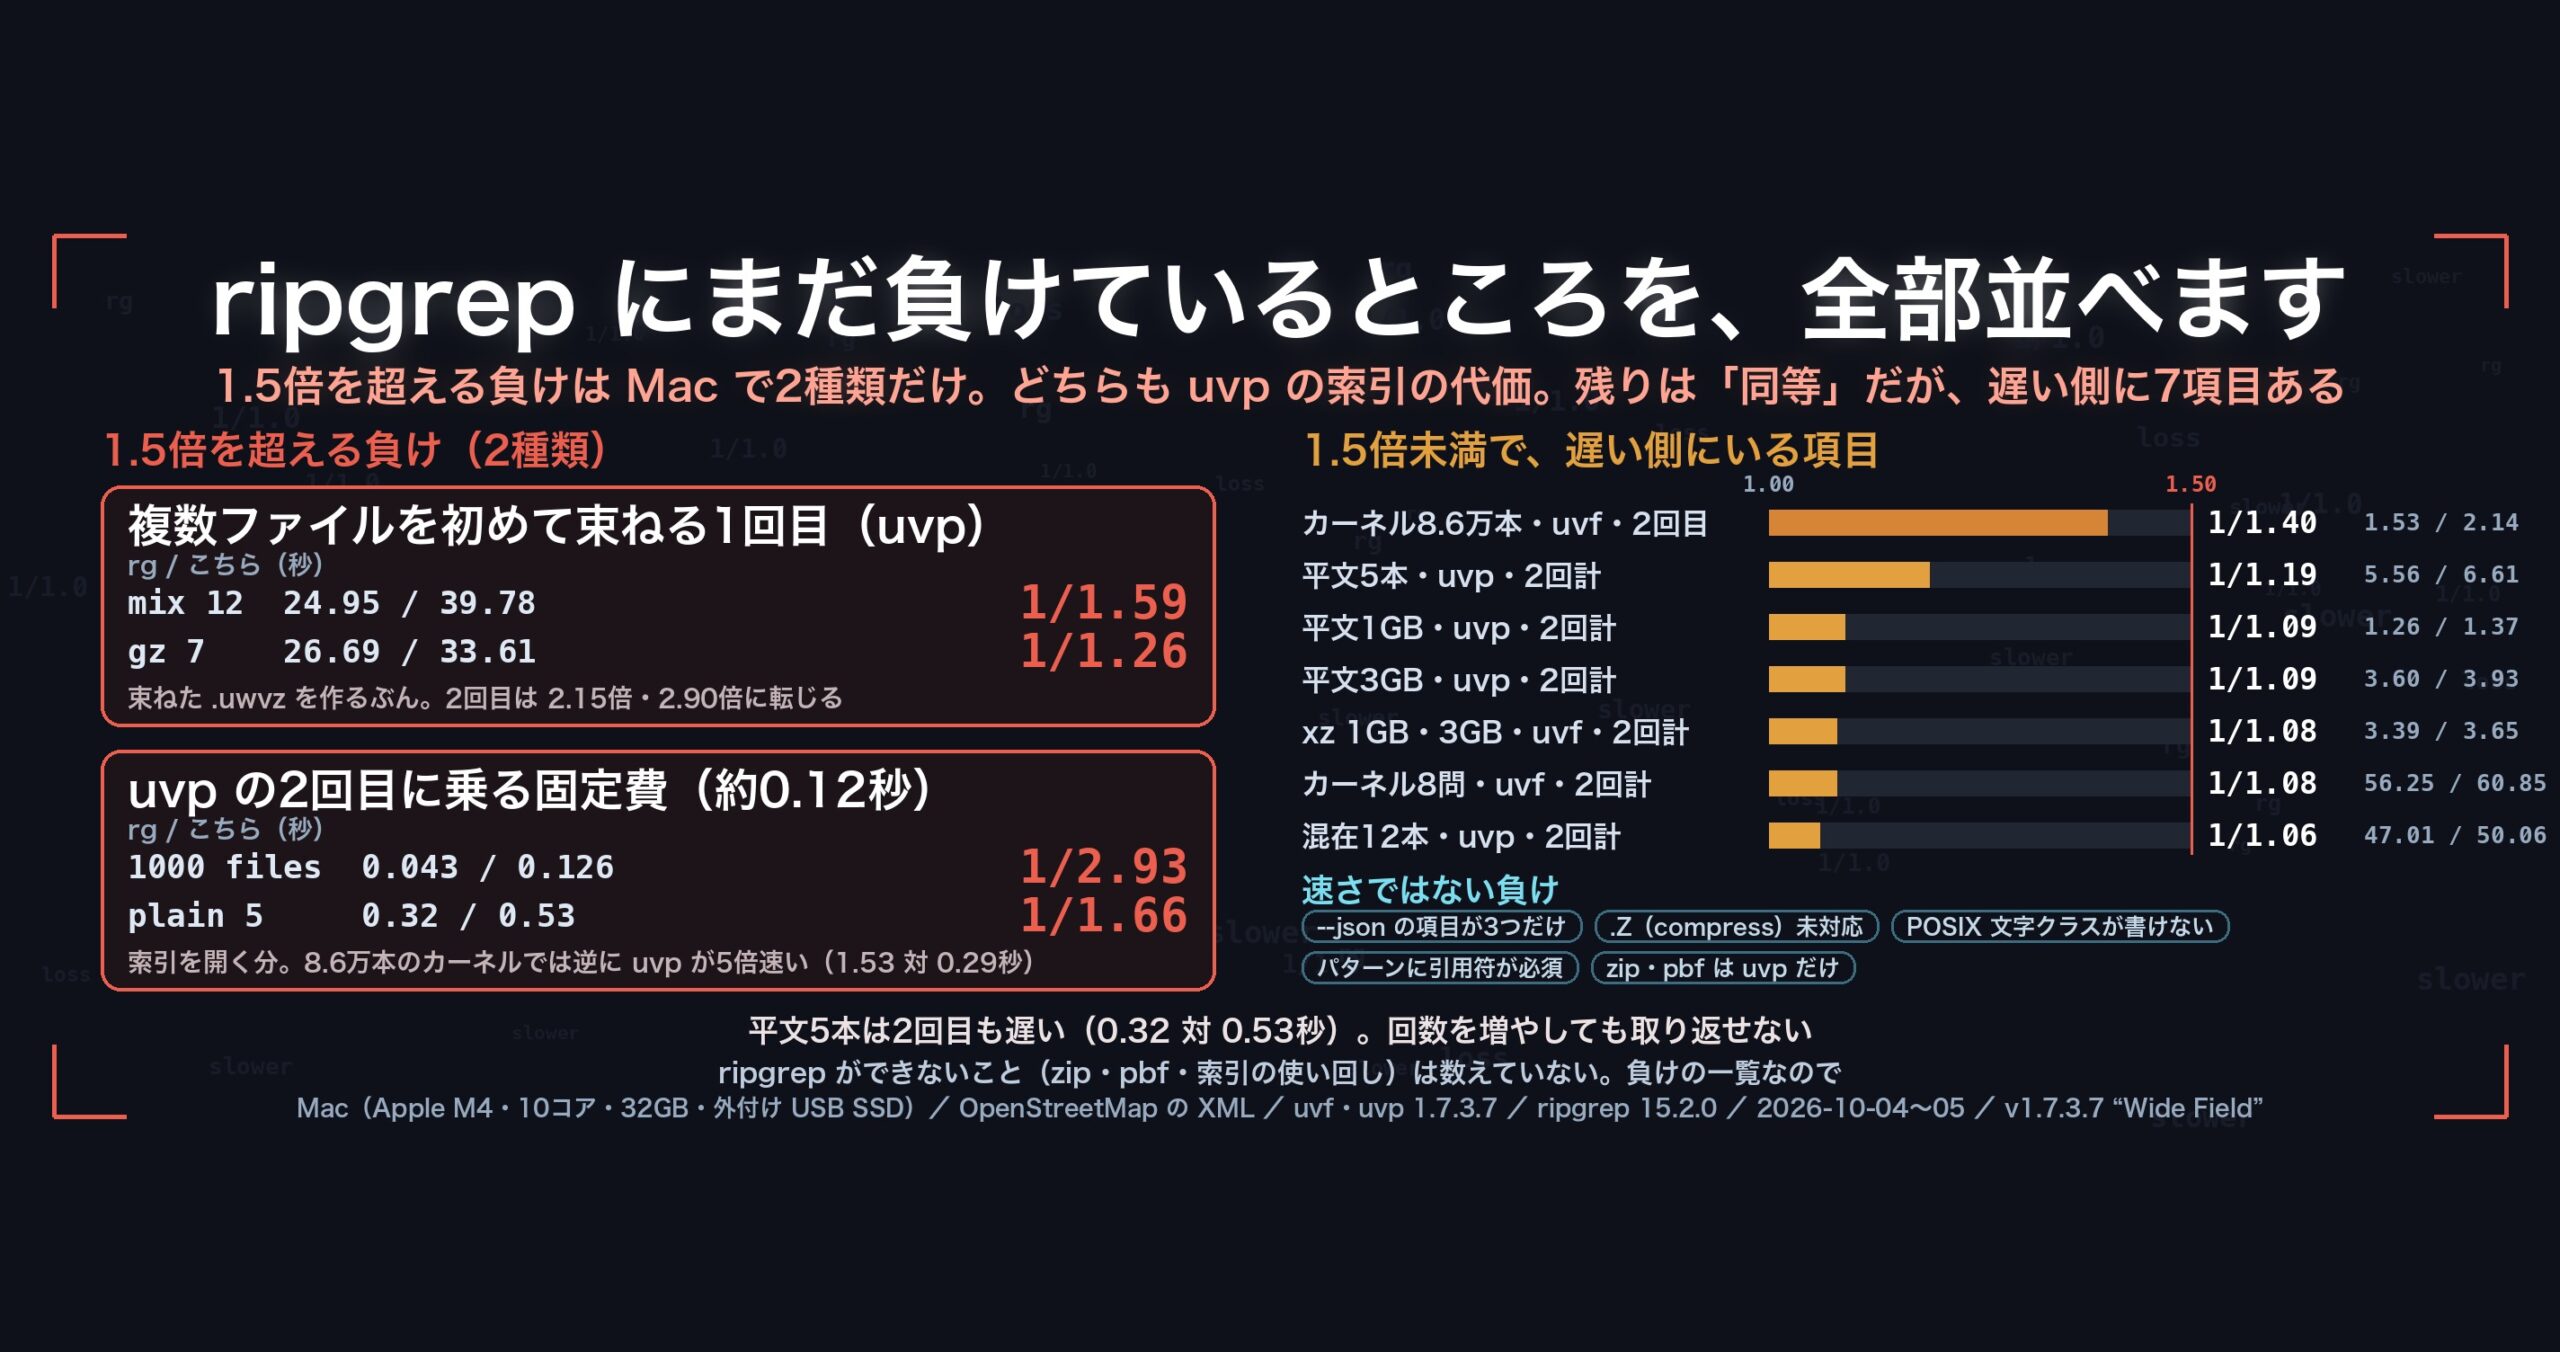
- 先に結論: 2026年10月4〜5日に測った Mac のテスト一式(大きい1本・複数ファイル・圧縮7形式・小さなファイルが大量にある場所)で、1.5倍を超えて ripgrep に負けているのは2種類だけで、どちらも有料版 uvp の索引の代価でした。ひとつは複数のファイルを初めて束ねる1回目(平文と gz の混在12本で 24.95秒 対 39.78秒=1/1.59)、もうひとつは2回目に毎回乗る約 0.12秒の固定費(1,000本に分けたファイルで 0.043秒 対 0.126秒=1/2.93、平文5本で 0.32秒 対 0.53秒=1/1.66)。無料版 uvf には、1.5倍を超える負けはありません。残りの負けはすべて 1.5倍未満で、この連載の決まりでは「同等」ですが、遅い側にいる項目は 7つあります
- 先に全体像: 勝ち・負けを1枚に(ripgrep=1)
- 測った条件
- 負け(1)複数ファイルを初めて束ねるとき — 1/1.59
- 負け(2)uvp の2回目に乗る固定費 — 約 0.12秒・1/2.93
- 1.5倍未満で、遅い側にいる項目(7つ)
- 速さではない負け
- まだ測っていないところ
- 直した負け(経緯)
- 正直に書いておくこと
- 持ち帰れる一般論: 負けを一覧にすると、2種類に分かれる
- 使っている道具
- リンク
先に結論: 2026年10月4〜5日に測った Mac のテスト一式(大きい1本・複数ファイル・圧縮7形式・小さなファイルが大量にある場所)で、1.5倍を超えて ripgrep に負けているのは2種類だけで、どちらも有料版 uvp の索引の代価でした。ひとつは複数のファイルを初めて束ねる1回目(平文と gz の混在12本で 24.95秒 対 39.78秒=1/1.59)、もうひとつは2回目に毎回乗る約 0.12秒の固定費(1,000本に分けたファイルで 0.043秒 対 0.126秒=1/2.93、平文5本で 0.32秒 対 0.53秒=1/1.66)。無料版 uvf には、1.5倍を超える負けはありません。残りの負けはすべて 1.5倍未満で、この連載の決まりでは「同等」ですが、遅い側にいる項目は 7つあります
uvf・uvpは私が作っている UwView(v1.7.3.7 “Wide Field”)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。数字は Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap の XML で測ったもので、Windows・Linux の結果はこの記事に持ち込みません(機械が違うので秒を比べられません)。
先に全体像: 勝ち・負けを1枚に(ripgrep=1)
負けだけを並べると、全体の形が見えません。そこで先に、2回探したときの合計時間を ripgrep を 1 として並べます。数字は「ripgrep の時間 ÷ こちらの時間」で、1 より大きければこちらが速く、1/○ はこちらが遅いことを表します。1.5倍未満は同等として扱い、どちら向きかを添えます。
| 場面(2回の合計) | ripgrep | 無料版 uvf |
有料版 uvp |
|---|---|---|---|
| Linux カーネル 8.6万本・8問 | 1(56.25秒) | 1/1.08(60.85秒)同等・遅い側 | 4.01倍(14.02秒) |
| 3GB 平文 1本・7問 | 1(31.49秒) | 1.06倍(29.66秒)同等・速い側 | 2.65倍(11.87秒) |
| 10GB 平文 1本・7問 | 1(89.42秒) | 1.08倍(83.02秒)同等・速い側 | 3.09倍(28.97秒) |
| 50GB 平文 1本・7問 | 1(821.43秒) | 1.12倍(732.54秒)同等・速い側 | 5.12倍(160.35秒) |
| 3GB の gz・2問 | 1(4.61秒) | (この測定では測っていません) | 3.05倍(1.51秒) |
| 10GB の gz・2問 | 1(17.38秒) | (同上) | 2.44倍(7.12秒) |
| 50GB の gz・2問 | (v1.7.3.7 の最終に近いビルドでは測っていません) | ||
| 1GB・3GB の圧縮7形式(各1問) | 1 | gz・bz2・lzma・zst・lz4・br の6形式で 1.02〜1.30倍(同等・速い側)、xz だけ 1/1.08(同等・遅い側) | 7形式すべてで 1.21〜2.28倍(gz 1.78倍・bz2 2.01倍・lzma 2.28倍など) |
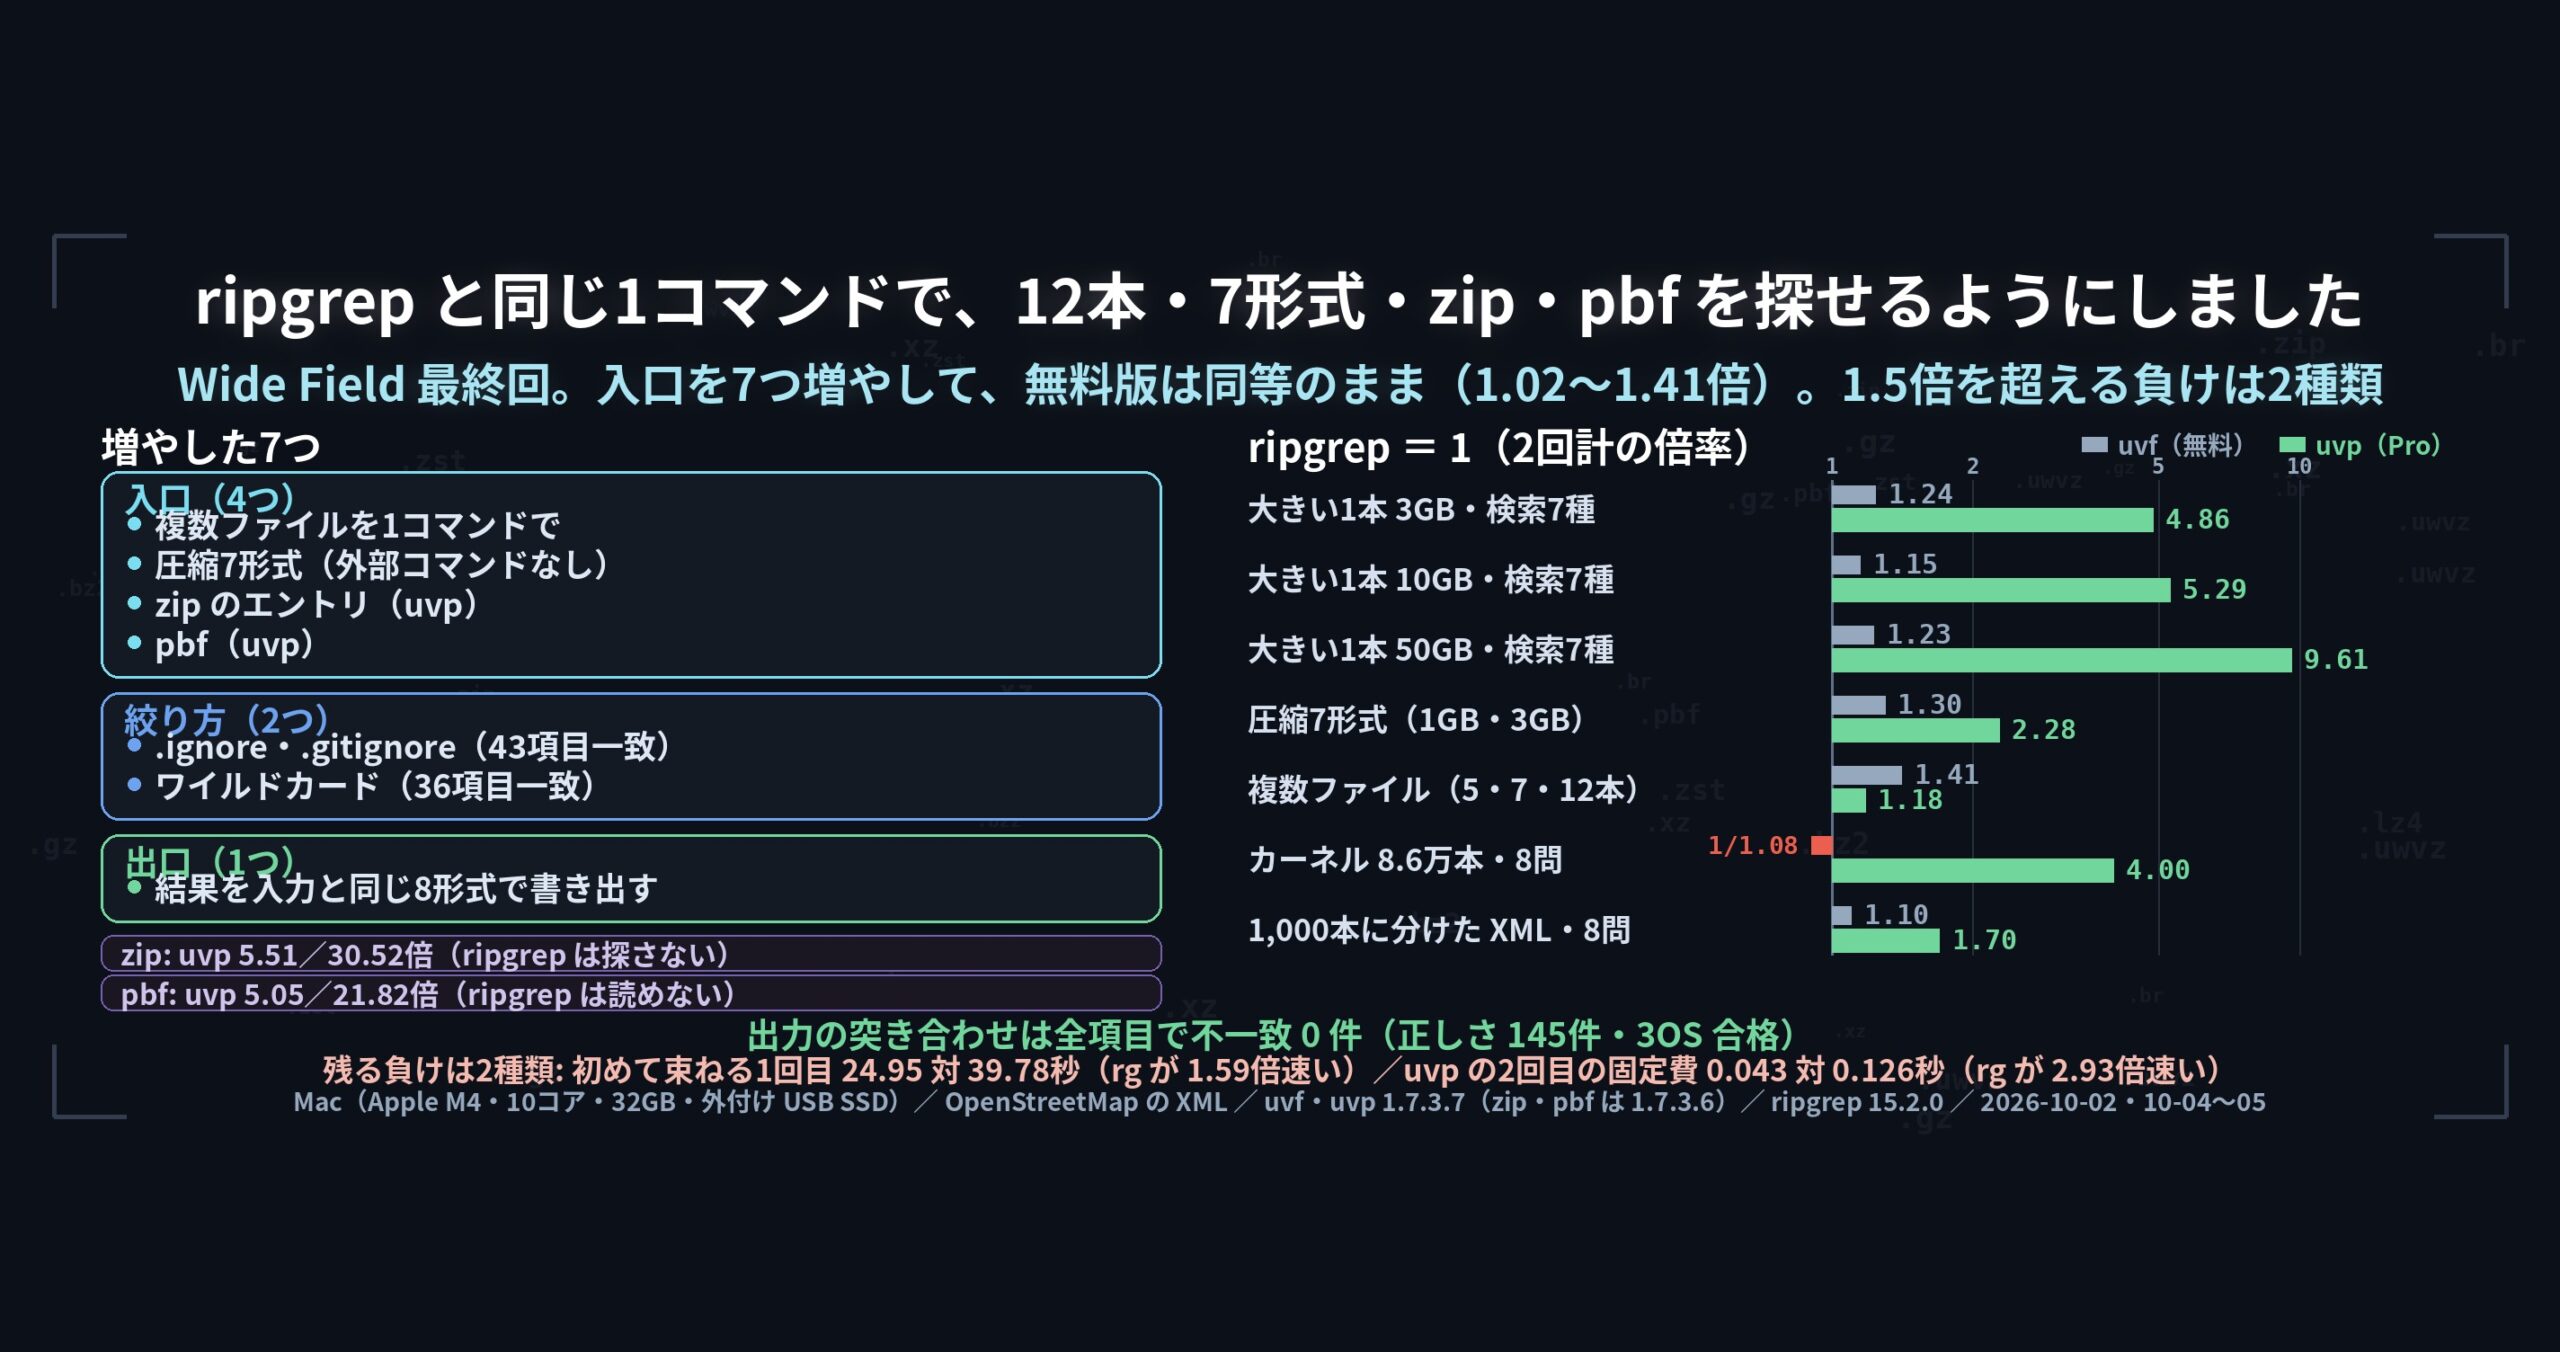
uvpは、この表のどの場面でも 2回の合計で ripgrep の 2.4〜5.1倍でした。1回目の索引づくりの時間も含めた数字です。uvfは、どの場面でも 1.5倍の内側(1/1.08〜1.30倍)で、ほぼ ripgrep と並んでいます。遅い側にいるのは、カーネルと xz の2つです。- 平文の「7問」は、素の検索・
-i・-E・行頭つき・-E -i・-v・-E -vの7つです。gz の「2問」は素の検索と-Eです。 uvpの平文の数字は、7問続けたときのものです。1問目で作った索引を2問目から使うので、大きく勝ちます。1問だけなら平文 3GB でも 1/1.09 で負けます(下の「1.5倍未満で、遅い側にいる項目」)。- 1.5倍を超える負けは、この表の数え方には出てきません。 出てくるのは「複数のファイルを初めて束ねる1回目」と「2回目だけを比べたとき」で、次の節から並べます。
- 版はすべて v1.7.3.7 の開発版です。ビルドは、カーネルが 26.10.05.14、3GB 平文と gz が 26.10.05.10、10GB と 50GB の平文は ripgrep・
uvfが 26.10.04.23・uvpが 26.10.05.10(10GB)と 26.10.05.08(50GB)、10GB の gz が 26.10.05.08、圧縮7形式が 26.10.04.23 です。10GB は、ほかのアプリにメモリを取られて2回目がキャッシュから外れた回を使っていません。機械はすべて Mac(Apple M4・10コア)です。
測った条件
| 項目 | 値 |
|---|---|
| 機械 | MacBook Air・Apple M4(10コア)・メモリ 32GB・外付け USB SSD |
| 版 | uvf/uvp 1.7.3.7 / ripgrep 15.2.0 |
| データ | OpenStreetMap の XML(1GB・3GB・10GB・50GB、同じ素材を分けた複数ファイル)と、Linux カーネルのソース(8.6万本) |
| 測り方 | sync → キャッシュ破棄 → 10秒待機 → 1回目(cold) → 続けて2回目(hot) |
| 判定 | 「相手の時間 ÷ こちらの時間」。1.5倍未満は同等と呼び、差とは言いません |
uvp の1回目には、圧縮キャッシュと索引(.uwvz。uvp 用の圧縮形式+索引)を作る時間が入っています。2回目はそれを読みます。
負け(1)複数ファイルを初めて束ねるとき — 1/1.59
uvp は複数のファイルをまとめて1つの .uwvz にします。その1回目は、読むだけの ripgrep より遅くなります。
| 1回目(cold)・秒 | ripgrep | uvp 1回目 |
比 | uvp 2回目 |
2回目の比 |
|---|---|---|---|---|---|
| 平文 5本(4.78GiB) | 5.24 | 6.08 | 1/1.16 | 0.53 | 1/1.66 |
| gz 7本(7.13GiB) | 26.69 | 33.61 | 1/1.26 | 7.57 | 2.90 |
| 平文+gz 12本 | 24.95 | 39.78 | 1/1.59 | 10.28 | 2.15 |
これは仕様どおりの負けです。展開して、圧縮し直して、索引を付けて書くのだから、読むだけより時間がかかります。取り返すのは2問目からで、gz 7本なら2回の合計で 1.18倍。混在12本は2回の合計ではまだ 1/1.06 ですが、3回目で追い越します(3回の合計で 69.07秒 対 60.34秒)。
ただし平文だけは例外です。平文5本は2回目も uvp のほうが遅く(0.32秒 対 0.53秒=1/1.66)、回数を増やしても取り返せません。平文は展開が要らないので、素読みのほうが素直に速いのです。平文だけを繰り返し探すなら、uvf か ripgrep で足ります。
負け(2)uvp の2回目に乗る固定費 — 約 0.12秒・1/2.93
uvp の2回目は、どんな小さな検索でも約 0.12秒かかります。索引を開いて、どこを読むかを決める分です。
| 2回目(hot)・秒 | ripgrep | uvp |
比 |
|---|---|---|---|
1,000本に分けた XML(981MB)・東京 |
0.043 | 0.126 | 1/2.93 |
| 同・見つからない語 | 0.041 | 0.124 | 1/3.02 |
1本の XML(979MB)・東京 |
0.108 | 0.122 | 1/1.13 |
Linux カーネル 8.6万本・EXPORT_SYMBOL |
1.608 | 0.286 | 5.62(uvp が速い) |
固定費なので、相手の読む量が小さいほど目立ちます。 1GB を ripgrep が 0.04秒で読み切れる場面では、0.12秒は3倍の差になります。ripgrep が1本ずつ開くのに時間のかかる8.6万本では、逆に uvp が5倍以上速くなります。
1.5倍未満で、遅い側にいる項目(7つ)
「同等」と呼んでいますが、向きは負けです。隠さずに並べます。
| 項目 | ripgrep | こちら | 比 |
|---|---|---|---|
Linux カーネル 8.6万本・uvf・2回目 |
1.53 | 2.14 | 1/1.40 |
平文 5本・uvp・2回の合計 |
5.56 | 6.61 | 1/1.19 |
3GB [ぁ-ん]{3,}・uvf・2回目 |
0.285 | 0.408 | 1/1.43 |
平文 1本 1GB・3GB・uvp・2回の合計 |
1.26/3.60 | 1.37/3.93 | 1/1.09 |
xz 1GB・3GB・uvf・2回の合計 |
1.20/3.39 | 1.29/3.65 | 1/1.08 |
Linux カーネル 8問・uvf・2回の合計 |
56.25 | 60.85 | 1/1.08 |
平文+gz 12本・uvp・2回の合計 |
47.01 | 50.06 | 1/1.06 |
読みどころは3つあります。
小さなファイルが大量にある場所では、uvf の2回目がまだ遅い側です。 8.6万本を開くだけで時間がかかり、1回の検索に 2.1秒ほどの固定費が乗ります(ripgrep は 1.5秒)。1回目は uvf が速いので、2回の合計では 1/1.08 まで縮みます。
xz は、Mac で uvf が遅い唯一の形式です。 ほかの6形式(gz・bz2・lzma・zst・lz4・br)は 1.02〜1.30倍で uvf が速いのに、xz だけ 1/1.08 で負けます。外部の xz コマンドの並列展開が、こちらの内蔵デコーダより速いためです。③で 1/6.19 まで負けていたところを並列展開で詰めましたが、追い越してはいません。
uvp は平文で必ず少し負けます。 1GB でも 3GB でも 1/1.09。圧縮キャッシュを書くぶんです。圧縮ファイルなら gz 1.78倍・bz2 2.01倍・lzma 2.28倍と大きく勝つのに、平文では勝てません。uvp が効くのは「圧縮されている」か「何度も探す」かのどちらかで、平文を1回だけ探す場面では効きません。
速さではない負け
数字にならない負けもあります。
--jsonの項目が ripgrep より少ない。 こちらが出すのはfile・line・textの3つだけで、type(種別)・submatches(一致の位置)・末尾の統計・バイナリ用の base64 を出しません。jqで一致位置を取る書き方は、そのままでは動きません(⑪).Z(compress)に対応していません。 対応しているのは gz・bz2・xz・lzma・zst・lz4・br の7形式です(②)- POSIX 文字クラスと用字名が書けません。
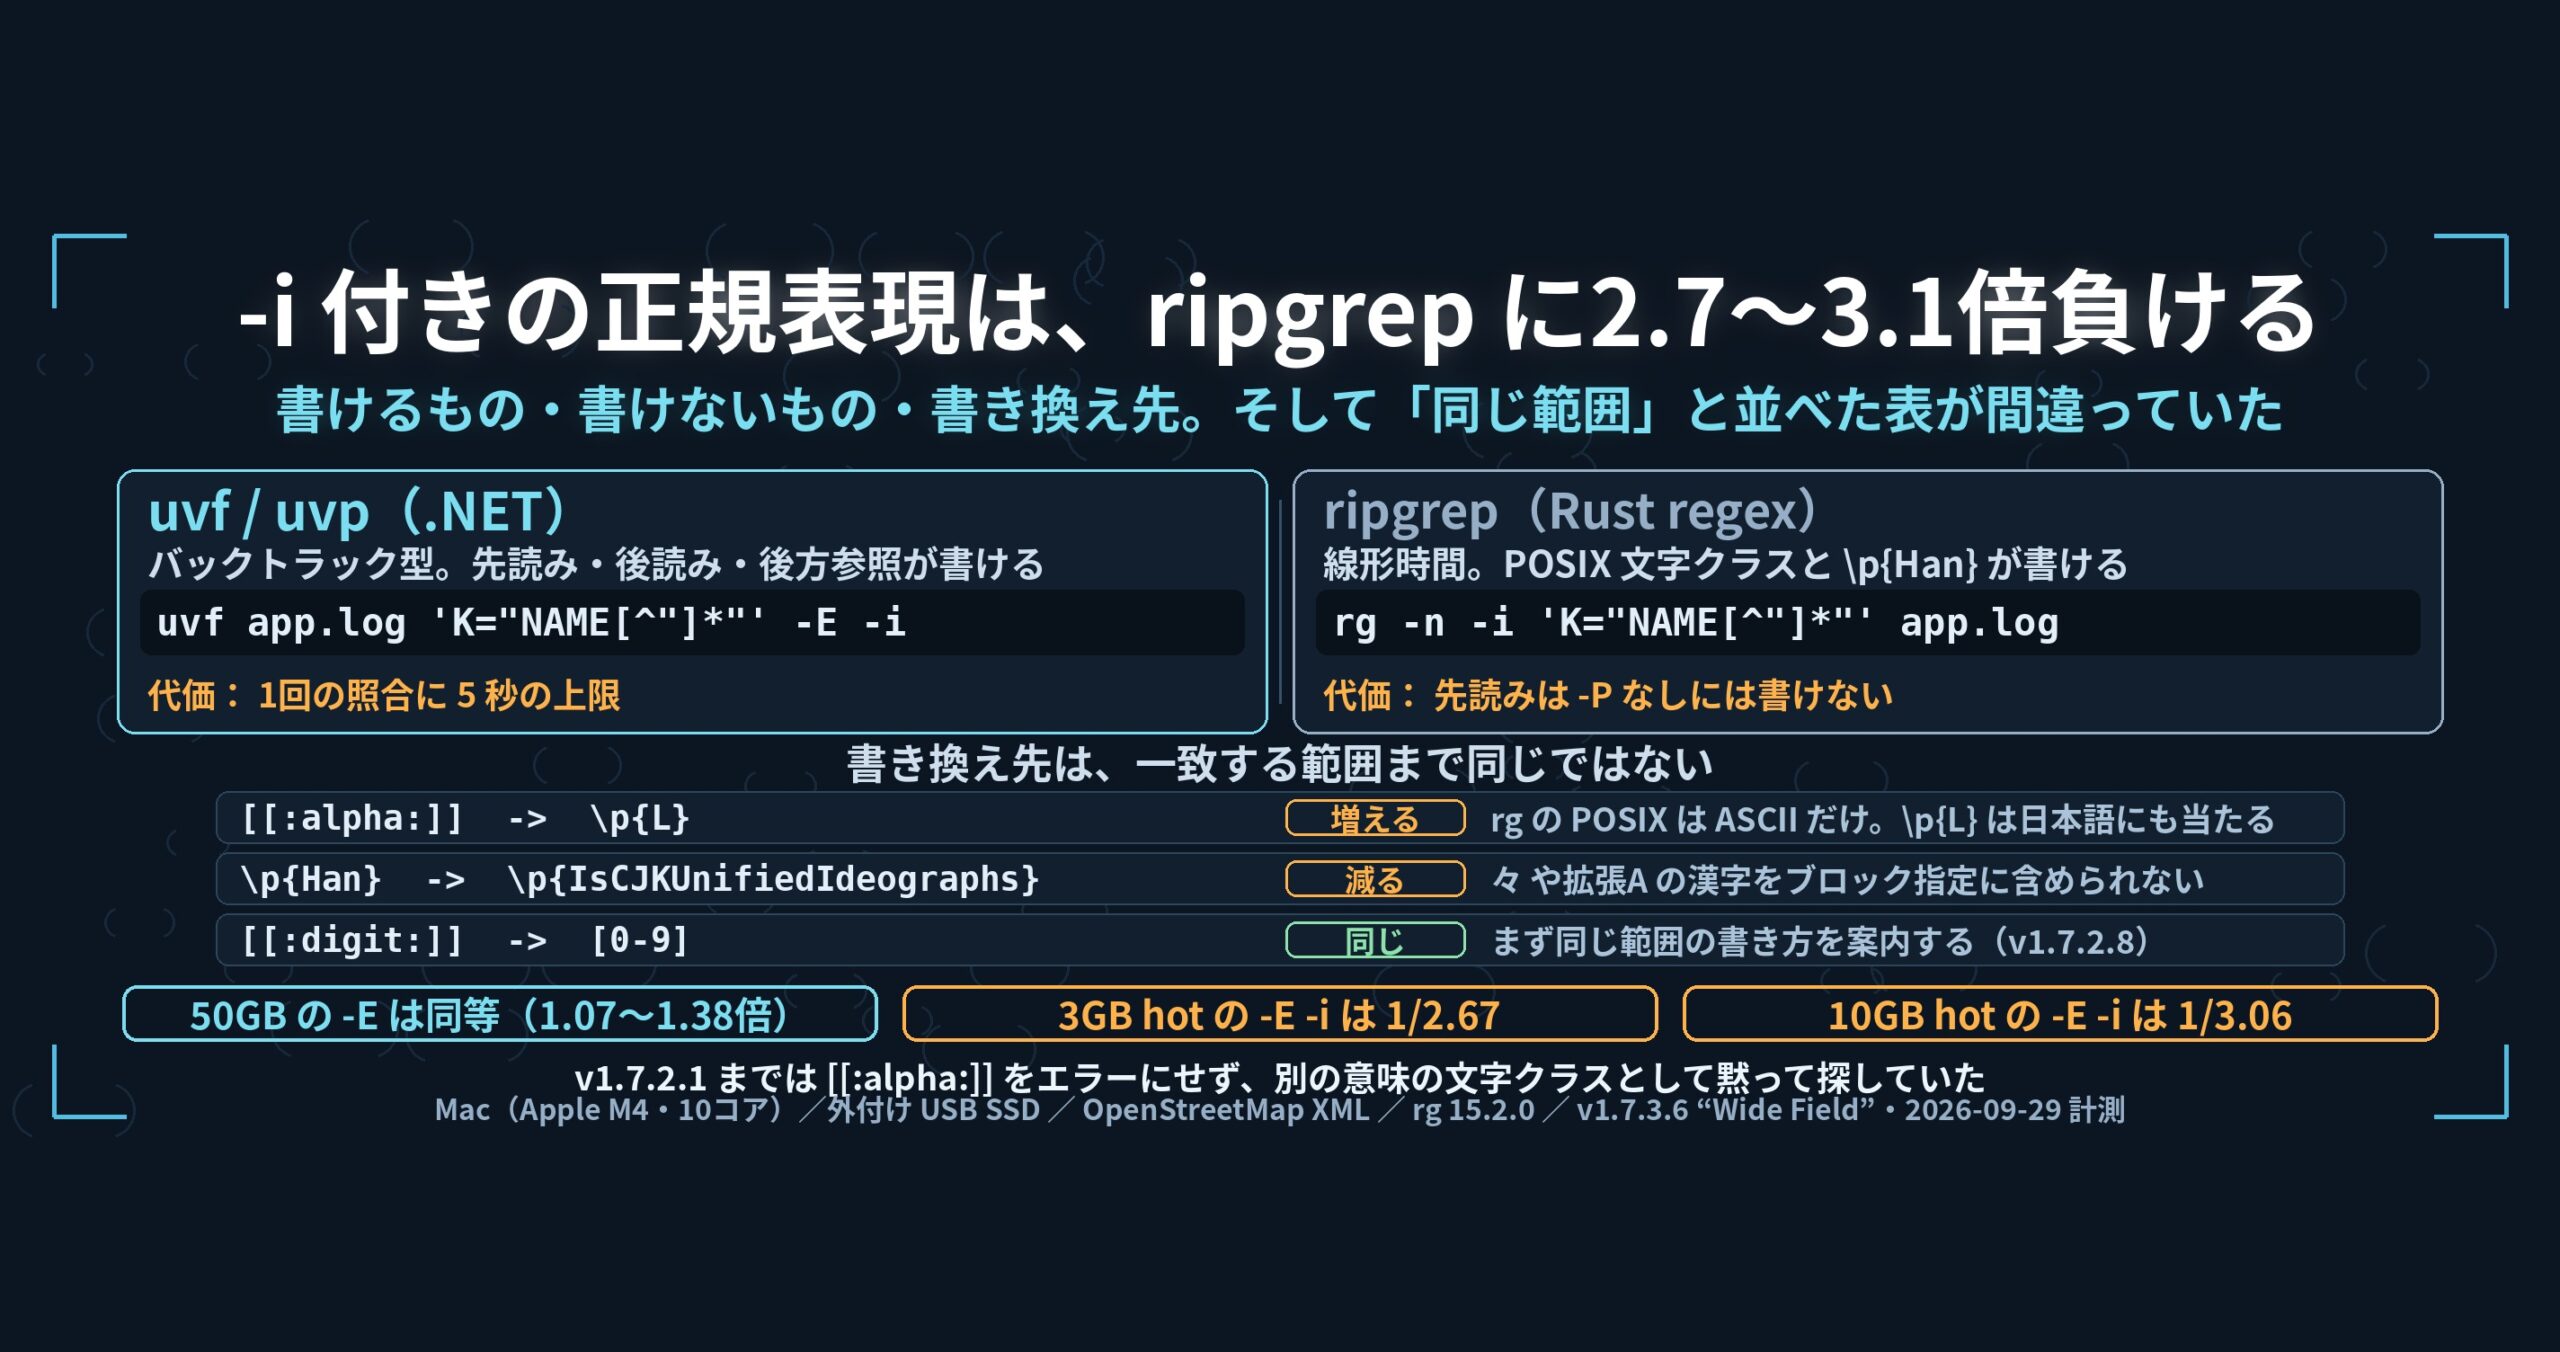
[[:alpha:]]や\p{Han}は .NET の正規表現では書けないので、[a-zA-Z]などへの書き換えを案内しています。ただし書き換え先は一致範囲まで同じではありません(⑨) - 複数ファイルのパターンは、1つの引数にまとめて渡します。 ripgrep の
-gとは形が違い、*を含むので引用符が必須です。付け忘れるとシェルが展開してしまいます(⑧) --no-ignoreの扱いに仕様の誤りがありました。(⑦)- zip の中と OpenStreetMap の pbf は
uvpだけです。無料のuvfは、案内を出して終わります(⑤・⑥)
ripgrep ができないこと(zip の中を探す・pbf を読む・入力と同じ形式で書き出す・索引を使い回す)は、この記事では数えていません。負けの一覧なので。
まだ測っていないところ
「負けていない」とは書けない項目もあります。正しさは確かめたが、速さを測っていないところです。
- 入力と同じ形式で書き出す機能(
-out)のうち、速さを測ったのは平文と gz だけです。bz2・xz・lzma・zst・lz4・br・zip の書き出しは、正しさ(66項目)だけ確かめています(⑩) - 束ねた
.uwvzに「増えた分だけ足す」速さを測っていません。仕様としては動きますが、秒数を出していないので記事でも書いていません(④) uvp --tune(.uwvzを使う経路のスレッド数)と--jsonの速さを測っていません(⑪)
測っていないところを「同等」と書かないのが、この連載のいちばんの決まりです。
直した負け(経緯)
| いつ | 何が | どうなった |
|---|---|---|
| ⑨のあと | -E -i(正規表現+大文字小文字を無視)の2回目が、3GB で 0.58秒 対 1.55秒(1/2.67)・10GB で 1/3.06 |
大小を無視しても、ヒットする行に必ず入る文字列の一部を、大小を畳んで先に探すようにした。3GB 0.56秒 対 0.49秒(1.14倍)・10GB 1.72秒 対 1.37秒(1.26倍)。追い越した |
| ⑫ | 2回目の検索が 1/1.36〜1/1.43 | 行番号用に改行を数える処理を 0.15秒→0.028秒にして、3GB で ripgrep 0.31秒 対 0.29秒。追い越した |
| ②③(1.7.2) | xz の展開が 1/6.19 | 並列展開を入れて 1/1.08 まで。同等 |
| First Light(v1.6.6.1) | 50GB の1問目が 59.0秒 対 54.9〜55.8秒(6〜7%遅い) | 索引を作りながら探すぶんの代価。Wide Field ではこの項目を測り直していません |
正直に書いておくこと
- 1.5倍未満を「同等」と呼ぶのは、この連載が自分で決めた線です(⑨で理由を書きました)。自分に有利な線引きに見える方は、上の表の秒数をそのまま読んでください。
- この一覧は Mac 1台の結果です。⑬で書いたとおり、Windows では Mac に出ない負けが4か所見つかりました。環境が変われば、負けの場所も変わります。
- 50GB はメモリに収まりません。2回目もディスクから読みます。3GB・10GB の2回目はメモリから読んでいます。
- 1回ずつの測定です。とくに複数ファイルの1回目は、ripgrep の側も回によって揺れます(gz 7本で 22.39〜26.69秒)。gz 7本の 1/1.26 は、揺れの小さいほうの回では 1/1.5 前後になります。
- 私は自分の製品について書いています。その分は割り引いてお読みください。
持ち帰れる一般論: 負けを一覧にすると、2種類に分かれる
(1)固定費の負けは、入力が小さいほど目立つ。 uvp の2回目の 0.12秒、平文の uvp(1/1.09)、カーネルでの uvf の2回目(1/1.40)は、どれも「毎回払う分」です。入力が大きくなるほど比は 1 に近づき、uvp の 0.12秒は 8.6万本では逆に5倍の勝ちに変わります。直すなら固定費そのものを削ります。
(2)代価の負けは、回数で取り返す形になっているかを見る。 索引を作る1回目の負けは、2問目から取り返せるなら設計として成立しています。gz 7本は2問目で、混在12本は3問目で取り返せました。平文5本は取り返せませんでした。ここは「設計上の代価」ではなく、ただの負けです。
(3)総合の数字では、負けが見えない。 大きい1本 3GB の32項目の総合は 2.50倍です。この数字だけ出せば負けは1つも見えません。項目を分けて、負けている向きのものを数えないと、どこを直すべきか分かりません。
(4)負けの一覧は、直す順番の一覧になる。 上から順に、複数ファイルを束ねる1回目(1/1.59)→ uvp の2回目の固定費(0.12秒)→ 平文の uvp(固定費)→ xz(相手のほうが素直に速い)。この順で手を付けます。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
uvf big.log ERROR                    # 1本を探す(平文・圧縮7形式)
uvf 'logs/*.gz' ERROR                # 複数ファイルを1コマンドで(引用符は必須)
uvf -E -i 'error[0-9]+' big.log      # 正規表現+大文字小文字を無視
uvf --json big.log ERROR             # JSON Lines(file・line・text の3つ)
uvf --tune                           # この機械に合うスレッド数を測る(--apply で保存)
終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)、Linux は Snap でも入ります。
リンク
- ⑬ 同じテスト一式を mac・Windows・Linux で流した: https://uvp.y42u.net/blog/uwview-wf13-three-os/
- ⑫ 「秒に出ない」と書いた改行の数え方が、2回目の検索の4割を占めていた: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- ⑪
--jsonと--tune: https://uvp.y42u.net/blog/uwview-wf11-json-and-tune/ - ⑨ 正規表現の比較(.NET と Rust で書けるもの・書けないもの): https://uvp.y42u.net/blog/uwview-wf09-regex-vs-ripgrep/
- ⑧ ファイルの指定の仕方(引用符が必須な理由): https://uvp.y42u.net/blog/uwview-wf08-file-globs/
- ⑦ 除外の規則(
.ignore・.gitignore): https://uvp.y42u.net/blog/uwview-wf07-ignore-rules/ - ⑥ pbf を探す: https://uvp.y42u.net/blog/uwview-wf06-pbf-osm/
- ⑤ zip の中を探す: https://uvp.y42u.net/blog/uwview-wf05-zip-entries/
- ② 外部コマンドを呼ばずに7形式(xz の並列展開も): https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- ① 平文と gz の12本を1コマンドで: https://uvp.y42u.net/blog/uwview-wf01-multi-file-one-command/
- 測って分かった「差」の下限(1.5倍未満を差と呼ばない理由): https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- First Light 総集編(6つの版で「読む回数」だけを減らした): https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。