提出期限は2週間。
保管はしてあります。では、取り出すのに何日かかるか、答えられますか。
保管期間と取り出し時間は、別々に設計しないと片方が破綻します。
監査・内部統制・規制対応でログを求められる場面には、障害対応とは違う時間軸があります。障害は「いま」を追いますが、監査は「3年前」を、しかも他人が決めた形式で要求します。今回はその4場面——期間指定の要求、SIEM取り込み前の確認、保管コストの設計、そして数年単位の長期保管——を、それぞれ「何が詰まるのか」から順に見ます。
- 先に結論: UwView Pro のシーケンシャル検索は「この順に現れる箇所」だけを拾えるので、監査でよくある「申請 → 承認 → 実行」の並びをそのまま条件にできます。多段階検索は絞り込みを重ねても原本の行番号を最後の段まで保持するため、提出資料に「何行目」と書ける形で引用できます。索引と圧縮はサイドカーに保存され、2回目以降は行番号付きのまま開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。処理はすべて手元のマシンで完結し、対象ログを外部へ送りません(詳細は記事末尾)
- 1. 期間は満たしている、取り出し方を決めていない
- 2. 取り込みルールを書く前に、実物を見る
- 3. 圧縮率と取り出しやすさは、同じ予算を取り合う
- 4. 7年後に、それは読めるか
- 4つに共通していたもの
- 使っている道具
- リンク
先に結論: UwView Pro のシーケンシャル検索は「この順に現れる箇所」だけを拾えるので、監査でよくある「申請 → 承認 → 実行」の並びをそのまま条件にできます。多段階検索は絞り込みを重ねても原本の行番号を最後の段まで保持するため、提出資料に「何行目」と書ける形で引用できます。索引と圧縮はサイドカーに保存され、2回目以降は行番号付きのまま開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。処理はすべて手元のマシンで完結し、対象ログを外部へ送りません(詳細は記事末尾)
本記事は「求められたログを手元で取り出し、確認する」段階の話です。何をどれだけ保管すべきか、提出物が要件を満たすかの判断そのものは、各組織の規程と適用される法令・所管の指針に従ってください。
1. 期間は満たしている、取り出し方を決めていない
状況
監査の依頼が来ます。「2023年10月の、特定アカウントの操作ログを提出してください」。
保管規程は3年です。条件は満たしています。ストレージにもファイルはあります。安心して開きに行って、そこで止まります。
該当月のアーカイブは、日次で圧縮された31ファイル。1ファイルあたり数GB。ファイル名は連番で、中身の日付は開いてみるまで分かりません。そして、そのアカウントがどのファイルのどこに出てくるかを知る方法が、いまここにありません。
31ファイルを順に展開して grep することにします。展開先の空き容量を確認し、1本ずつ回し、結果を眺め、消す。1日では終わりません。
なぜ起きるか
保管規程が「期間」しか決めていないからです。
規程に書いてあるのはたいてい「◯年保管」だけで、「◯時間以内に取り出せること」は書かれていません。書かれていないので、設計もされません。結果、保管は自動化され、取り出しは手作業のまま残ります。
もうひとつ、監査の要求は保管の単位と一致しません。保管はホスト別・日付別・サービス別に切られていますが、要求は「このアカウント」「この取引ID」「この期間」という、保管の切り口を横断する形で来ます。保管したときの並べ方が、取り出すときの索引になっていない——これが詰まりの正体です。
汎用ツールでの対処と限界
まず、どのファイルが対象かを絞ります。
# ファイル名の日付で絞る(dateext で日付が名前に入っている前提)
ls /archive/app-202310*.log.gz

# 名前が当てにならないなら、中身の先頭行で判定する
for f in /archive/*.log.gz; do
  printf '%s\t' "$f"; gzip -dc "$f" | head -1
done
そのうえで、展開せずに横断検索します。
zgrep -h 'user_id=A1B2C3' /archive/app-202310*.log.gz > hits.txt
zgrep は展開せずに書けますが、中でやっているのは展開しながらの逐次走査です。数十GB分を回せば、それ相応の時間がかかります(第8回で扱ったとおりです)。
限界は3つ。
ひとつめ、-h を付けるとファイル名が消え、付けないと行頭がファイル名で汚れること。提出資料には「どのファイルの何行目か」が要るのに、zgrep は原本の行番号を出せません(-n は付きますが、展開後のストリーム上の番号です)。
ふたつめ、条件が複数になると回数が増えること。「そのアカウントが、10月のどこかで、設定変更をした」を確認するには、まず該当アカウントで絞り、その中から設定変更を探します。zgrep A | grep B のように繋げば1回で済みそうですが、絞り直すたびに元の圧縮ファイルを頭から読み直すのが現実です。
みっつめが実務でいちばん痛い。grep の出力は文脈を持たないこと。ヒット行だけを見せても「この操作の前に何があったか」に答えられないので、結局±20行が要ります。-C 20 を付けると出力が20倍に膨らみ、31ファイル分を人間が読む作業に戻ります。
2. 取り込みルールを書く前に、実物を見る
状況
ログ基盤にアプリケーションログを取り込むことになりました。パース定義を書きます。
仕様書にはログ形式が書いてあります。そのとおりに正規表現を組み、投入します。取り込みは走ります。数日後、ダッシュボードを見ると、件数が想定の6割しかありません。
パースに失敗した行は捨てられていました。どんな行が捨てられたのかは、捨てられているので分かりません。
なぜ起きるか
仕様書に書いてあるのは「正常時の1行」だけだからです。
実際のログには、仕様書に載らない行が混ざります。
- スタックトレース — 1件の例外が数十行にわたります。2行目以降はタイムスタンプを持たないので、行単位のパーサは全部を捨てるか、全部を別イベントとして数えます
- ログレベルごとに形の違う行 —
DEBUGだけ追加フィールドがある、といった差異は仕様書に書かれません - フォーマットが変わった日 — ライブラリを上げた日を境に区切り文字が変わっている。移行期間はどちらの形式も混在します
- 文字コードの混在 — 外部システムから流れ込んだ行だけがShift_JISのまま、といった状況は実際にあります(第3回)
- 壊れた行 — ローテーションの狭間で切れた行、書き込み途中でプロセスが死んだ行
監査の文脈でこれが効いてくるのは、「取り込めなかった行がある」こと自体が指摘対象になるからです。完全性を問われる場面で「6割入っています」は答えになりません。
汎用ツールでの対処と限界
投入前に、実物の形を数えます。
# 行頭のパターンを分類して数える(タイムスタンプで始まらない行を可視化する)
grep -cv '^[0-9]\{4\}-[0-9]\{2\}-[0-9]\{2\}' app.log

# フィールド数の分布を見る(区切りがタブの場合)
awk -F'\t' '{print NF}' app.log | sort | uniq -c | sort -rn | head

# 1行の長さの分布(極端に長い行=埋め込みJSONやトレースの疑い)
awk '{print length}' app.log | sort -n | tail -5
2本目のフィールド数分布が効きます。想定が8フィールドなのに7と9が混ざっていれば、その時点で定義は破綻していることが分かります。
限界は3つ。
ひとつめ、数えられるのは「数え方を思いついたもの」だけだということ。フィールド数は数えられますが、「7フィールドの行はどんな行か」は、実物を目で見ないと分かりません。awk 'NF==7' で抜けば見られますが、それは抜き出すたびにファイルを1周するということです。数十GBで、思いつくたびに1周。
ふたつめ、分布の端に意味があること。100万行のうち3行だけ形が違う、という場合、その3行こそが調べるべきものです。sort | uniq -c は件数の多い順には強いですが、少数の異常を「見つける」用途では、結局その3行の中身を見に行くことになります。
みっつめ、サンプリングでは足りない場面があること。head -10000 で形を確かめても、問題の行が何十GB目にいるなら見えません。第13回に書いたとおり、検品は「全量を見られること」が前提になる場面があります。
3. 圧縮率と取り出しやすさは、同じ予算を取り合う
状況
保管容量の見直しをします。圧縮率を上げれば、置ける年数が増えます。
方針を決めます。直近1か月は非圧縮、1年分は通常圧縮、それ以前は高圧縮でアーカイブへ。容量は目に見えて減りました。
半年後、監査で2年前のログを求められます。高圧縮の層です。展開に時間がかかります。展開先の一時領域が足りず、分割して展開します。保管費を削ったぶんが、取り出し工数として戻ってきました。
なぜ起きるか
削ったコストと増えたコストが、別々の帳簿に載るからです。
保管容量は月次で請求され、目に見えます。取り出し工数は、監査が来た月に、担当者の残業として現れます。どちらもコストですが、同じ表に並ばないので、片方だけを最適化する判断になりがちです。
そしてトレードオフは単純な二択ではありません。少なくとも3つの軸があります。
- 圧縮率(保管費に効く)
- 展開速度(取り出し時間に効く。高圧縮ほど遅い傾向があります)
- ランダムアクセスの可否(いちばん見落とされます)
3つめが要点です。多くの圧縮形式はストリームとして作られているため、「真ん中だけ展開する」ができません。1GB目を読むには、先頭から1GB分を展開する必要があります。これがある限り、「必要な箇所だけ取り出す」は原理的に成立しません。
つまり本当のトレードオフは「圧縮率 対 検索可能性」ではなく、「圧縮形式が索引を持っているかどうか」です。索引があれば、圧縮率を上げても取り出しは速いままにできます。
汎用ツールでの対処と限界
自分の環境で測るのが先です。
# 圧縮率と所要時間を並べて比べる(time の出力も一緒に見る)
for lv in 1 6 9; do
  time gzip -"$lv" -c app.log > "/tmp/t-$lv.gz"
  ls -l "/tmp/t-$lv.gz"
done

# 展開だけの時間を測る(出力は捨てる)
time gzip -dc /tmp/t-9.gz > /dev/null
一般論として、圧縮レベルを上げると圧縮は大きく遅くなり、展開速度はそれほど変わらない、という傾向があります。保管は一度きり、取り出しは何度もという前提なら、この非対称性は味方につけられます。
ただし数値は形式・実装・データの性質で大きく変わります。ログのように繰り返しの多いテキストと、すでに圧縮済みのデータでは結果が違います。上の表を自分のデータで作ること自体が、この項目の実務です。
限界は2つ。
ひとつめ、ブロック単位の索引を持つ仕組みは、追加の運用を要すること。分割して圧縮し、どのブロックに何が入っているかの目録を別に持てば、ランダムアクセスは実現できます。ただしその目録を作り、更新し、保管する手間は、削った容量とは別の場所で発生します。
ふたつめ、削除の判断と取り出しの判断が同じ人にないこと。容量を見ているのは基盤の担当者で、取り出すのは監査対応の担当者です。片方の都合で決めた圧縮方針を、もう片方が半年後に引き受けます。第4回の「消す・残す・圧縮する」は、この分断を前提に決める必要があります。
4. 7年後に、それは読めるか
状況
金融系のシステムで、取引ログの保管期間が7年と決まっています。
粛々と溜めます。5年が経ちます。監査で古い年度分を求められ、取り出します。ファイルはあります。開きます。
読めません。
文字コードが違います。当時のシステムはShift_JISで書いていました。区切り文字も、いまのフォーマットと違います。当時これを読んでいた社内ツールは、対応OSのサポートが切れて動きません。書いた人は、もういません。
なぜ起きるか
保管期間が、周辺のあらゆるものの寿命より長いからです。
7年の間に変わるものを並べると、問題の大きさが見えます。
- 文字コード — 社内標準がShift_JISからUTF-8へ移った年がどこかにあります。その前後で、同じ名前のログの中身が違います
- フォーマット — フィールドが増え、区切りが変わり、タイムスタンプの形式が変わります
- 読むためのツール — 専用ビューアは、OSのバージョンアップで動かなくなります。ランタイムのサポートが切れれば、それを動かすための環境ごと維持する話になります
- 人 — 「このフィールドが何を意味するか」を知っている人が、7年後の組織にいる保証はありません
- メディア — 光学メディアも磁気テープも、規格そのものが読み取り装置ごと退役します
そして最後の1つが本質的です。7年後に必要なのは「当時のツールで読むこと」ではなく、「その中身を人間が読めること」です。 ログはテキストです。テキストである限り、原理的には読めます。読めなくしているのは、たいてい周辺の何かのほうです。
汎用ツールでの対処と限界
長期保管では、ログ本体と同じ場所に「読み方」を置きます。
# アーカイブと同じディレクトリに README を置く
cat > /archive/2019/README.txt <<'EOF'
encoding : Shift_JIS (CP932)
delimiter: TAB
fields   : 1=timestamp(JST, yyyy/MM/dd HH:mm:ss) 2=account 3=action 4=result
note     : 2019-08-01 以降はフィールド5(session_id)が追加されている
EOF

# 文字コードの見当を付ける(推定であって断定ではない)
file -i old.log
head -c 3 old.log | od -An -tx1        # BOM の有無を目で見る

# 変換は「読むため」に限り、原本には書き戻さない
iconv -f CP932 -t UTF-8 old.log > /tmp/old-utf8.log
README.txt は素朴ですが、7年後に効く可能性がいちばん高い対策です。プレーンテキストは、自分自身を読むためのツールを必要としません。
限界は3つ。
ひとつめ、iconv はコピーを作ること。原本を変えないのは正しい作法ですが(第16回)、そのぶん容量が倍になり、「どちらが原本か」を管理する手間が増えます。監査の場で変換後のファイルを出せば、「変換の過程で何かが失われていないか」を説明する必要が生じます。
ふたつめ、混在ファイルは一括変換できないこと。1つのファイルの中でShift_JISとUTF-8が混ざっていれば、iconv はどこかで止まるか、化けた結果を出します(第11回で扱った状況です)。
みっつめ、README.txt を書く動機が、書く時点には存在しないこと。7年後に困るのは別の人です。だからこれは個人の心がけではなく、アーカイブを作る手順の中に組み込むべきものです。
4つに共通していたもの
| 場面 | 要求の形 | 詰まる原因 | 汎用ツールでの対処 | 残る問題 |
|---|---|---|---|---|
| 期間指定の提出 | 「3年前の、この対象を」 | 保管の単位と要求の単位が違う | zgrep で横断検索 |
原本の行番号が出ない。絞り直すたび読み直し |
| 取り込み前確認 | 「取りこぼしはないか」 | 仕様書にない行が実物に混ざる | フィールド数・行長の分布を数える | 数え方を思いつかないものは数えられない |
| 保管コスト設計 | 「容量を減らせ」 | 削った費用と増えた工数が別帳簿 | 圧縮レベルごとに実測 | 索引がなければランダムアクセスは不可能 |
| 長期保管 | 「7年前のものを」 | 保管期間が周辺の寿命より長い | 読み方を同梱・iconv は読むためだけ |
変換はコピーを作る。混在は一括変換できない |
4つは担当部署も時間軸も違います。それでも右端の列が似た形をしているのは、4つとも「保管したときの前提が、取り出すときには失われている」からです。
保管した人は、ファイルの切り方も、文字コードも、フィールドの意味も知っていました。取り出す人は知りません。7年後の他人が、条件も文脈も持たずに、圧縮された数十GBの前に立つ——監査対応とは、そういう構図です。
必要な条件を3つに整理します。
- 圧縮したまま、展開せずに読めること — 一時領域の確保と展開待ちが挟まる限り、取り出しは工数として残り続けます
- 絞り込んでも原本の座標が残ること — 提出資料に必要なのは断片ではなく、「原本のどこか」という対応関係です。段を重ねるたびに番号が振り直されるなら、それは作れません
- 手元で完結すること — 監査対象のログを外部サービスへ送れるかどうかは、技術ではなく規程の問題です。送れないと決まっている組織では、この条件が最初の足切りになります
冒頭の2週間に戻ります。あれは保管期間の問題ではありません。保管したときに、取り出す人のことを考えていなかった時間です。
使っている道具
私が開発している UwView(無料)は、巨大なテキストを開いた瞬間から表示・スクロール・検索できるビューアです。ファイル全体をメモリへ読み込まないので、RAM より大きいファイルでも開けます。索引はバックグラウンドで作られ、完成すると行番号が付きます。
無料版が満たすのは、上の3条件のうち3つめです。
- 処理はすべて手元のマシンで完結します。 対象ファイルを外部へ送りません。監査対象ログの持ち出し可否が問題になる場面では、ここが前提条件になることがあります
- 原本に書き込みません。 分割も切り出しもしないので、アーカイブから取り出したファイルを1本のまま・無改変のまま読めます
- 文字コードは開いたまま切り替えられます(UTF-8 / Shift-JIS(CP932) / EUC-JP / UTF-16 を自動判定)。4章の
iconvが作る第二のコピーが、読むだけなら不要になります
1つめと2つめが UwView Pro の領分です。
- シーケンシャル検索:
w1 → w2 → w3がこの順に現れる箇所だけを拾います。監査でよくある「申請 → 承認 → 実行」「ログイン → 権限変更 → ログアウト」のような手続きの並びを、そのまま検索条件にできます(実装記事)。正直に書くと、各段は前段の位置から本文を走査するので、所要時間は全文検索と同程度かかります - 多段階検索(ドリルダウン): 絞り込んだ結果をさらに別の語で絞れます。1章の「アカウントで絞ってから設定変更を探す」が、原本を読み直さずに段として重なります。タブに
語(件数)が並び、原本の行番号は最後の段まで保持されます(多段階検索の記事) - ±N は段ごとに独立: 絞り込む段は±1、実際に読む段は±20、というふうに幅をあとから変えられます。1章の「
-C 20を付けると出力が20倍になる」が起きません(無料版は±1固定、可変の±N は Pro) - 集計(頻度ランキング): 正規表現で拾った値の出現回数を並べ、行をクリックすればその箇所へ降ります。2章の「フィールド数の分布を数える」に近いことを、ファイルを何周もせずに行えます。ただし合計や平均のような数値計算はしません——系譜は
grep -oE | sort | uniq -cの側です - 索引と圧縮を保存する: 一度開いたファイルは2回目以降行番号付きのまま瞬時に開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。監査対応は「1回読んで終わり」になりません。照会、追加質問、報告書の作成と、同じファイルを何日も開き直します
- 約1/9で保管しつつ検索できる: 3章の「索引を持たない圧縮形式ではランダムアクセスができない」に直接効きます。Pro のサイドカー(
.uwvz)はブロック単位のオフセット表を持つので、圧縮したまま必要な箇所へ飛べます。zgrepのように毎回先頭から展開しながら走る必要がありません(第8回)
サイドカーは圧縮ブロックごとに XxHash3 の表を持ち、展開のたびに検証します。長期保管中のビット化けや、コピーが途中で切れている状態に、気づかないまま読み進めることにはなりません。ただしこれは改ざん検出ではありません。 XxHash3 は速度のための非暗号学的ハッシュです。改ざん対策に要るのは sha256sum と分離保管であって、この検証は事故に気づくためのものです(第16回)。
正直な限界
UwView はビューアです。SIEM でもログ管理基盤でもなく、監査証跡の管理システムでもありません。
- 2章の取り込み定義は書きません。パース定義の検証も、投入も、取りこぼしの自動検出もしません
- 3章の保管方針の自動化はしません。世代管理も、削除も、棚卸しレポートもありません
- 4章の
README.txtを書くのはあなたの仕事です。メタデータの管理機能はありません - 保管の証跡(誰がいつ何を開いたか)は記録しません。閲覧ログを要件に持つ監査には、この道具単体では答えられません
- 複数ログの自動突き合わせ、アラート、レポートの自動生成、脅威情報との照合——いずれもありません
- 対応するのはテキストです。データベースのバイナリダンプやディスクイメージは対象外です
もうひとつ、保管領域を触る人に関わる制約を正直に書きます。Pro のサイドカー(.uwvz)は、元ファイルの隣に新しいファイルとして作られます。 原本そのものは1バイトも変わりませんが、アーカイブ領域の中身を増やさない運用をしているなら、コピーを別の作業領域へ置いてから開いてください(サイドカーは「元ファイルの長さ+最終更新時刻」を検証キーに持つので、原本が変われば自動的に無効になります)。
この道具が担うのは、その手前の一歩です。保管された生ログを、そのまま・手元で・原本の座標を保ったまま、自分の目で読む。相関分析やアラートが必要な規模なら、それは別の製品の仕事です。
参考までに、非破壊の差分編集(Edit Upgrade)は別ライセンスとして存在しますが、この記事の4項目はすべて読み取りだけの仕事です。ここで要るのは View 側です。
コマンドラインから同じことをする
v1.6.0 で uvp コマンドが付きました(無料版には uvf)。GUI と同じ .uwvz を使うので、CLI で作った索引はそのまま GUI でも効きます。この記事の4章に対応させると、こう書きます。
# 1章: アカウントで絞ってから設定変更を探す。行番号付きのまま提出用に落とす
uvp /archive/app-20231015.log 'user_id=A1B2C3' 'config.change' -C 20 -out audit-202310.txt

# 1章の続き: 手続きの並びをそのまま条件にする(申請 → 承認 → 実行)
uvp /archive/app-20231015.log -seq 'REQUEST,APPROVE,EXECUTE' -C 5

# 2章: 行頭10文字の分布を出す。タイムスタンプで始まらない行がここに浮く
uvp app.log -uniq '^(.{0,10})' -head 20

# 3章: .uwvz なら展開せずに探せる。一時領域も展開待ちも要らない
uvp /archive/2023/app-20231015.log.uwvz 'user_id=A1B2C3'

# 4章: 原本が無くても .uwvz だけで読め、元の形へはバイト一致で戻せる(無料機能)
uvp /archive/2019/old.log.uwvz -extract -out /tmp/restore/
終了コードは grep と同じ 0=あり・1=なしに、2=上限に当たって打ち切った(既定は無制限。-limit N で上限を決めたときだけ)が加わります。1章の「31ファイルを順に当たる」は for f in /archive/app-202310*.log; do ... done の中に uvp を1行置けば済み、どのファイルに当たりがあったかを終了コードで振り分けられます。ただしここも正直に書けば、uvp も閲覧の証跡は記録しません。誰がいつ何を開いたかを要件に持つ監査には、この道具単体では答えられないままです。
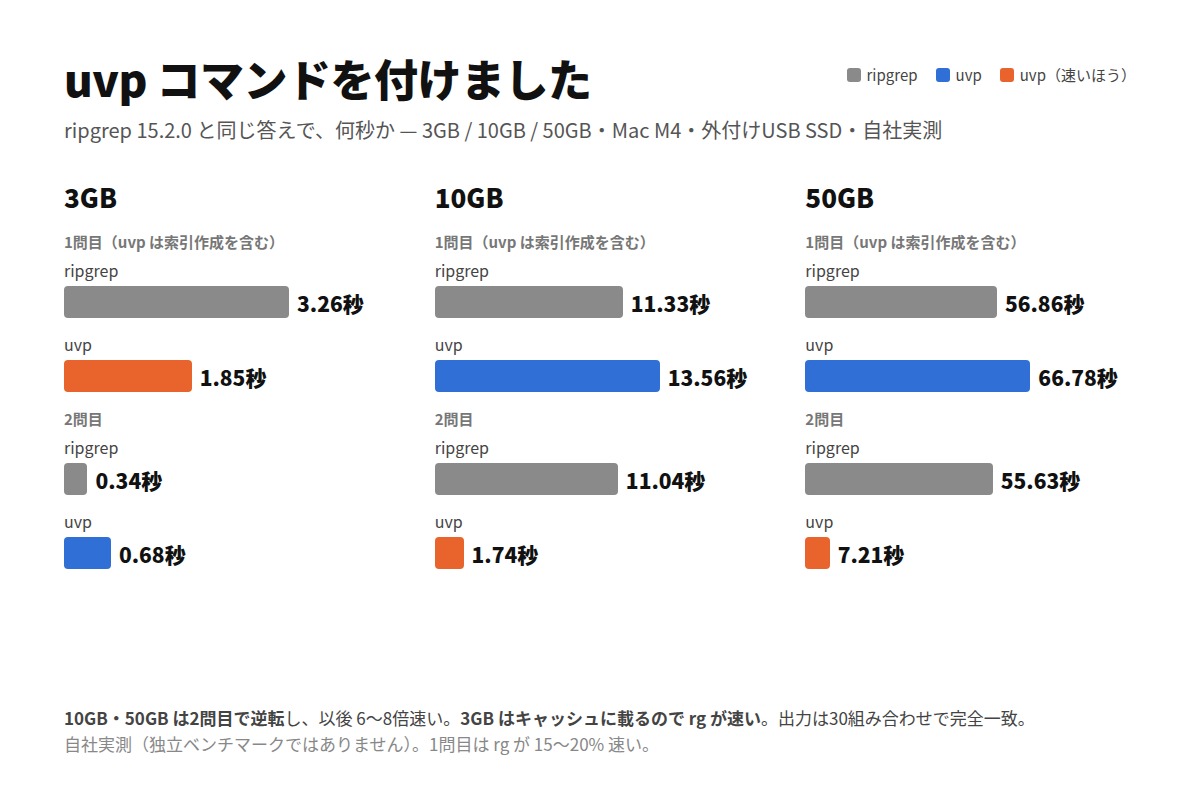
正直に書くと、1問目は ripgrep のほうが 15〜20% 速いです(uvp は先に索引を作るため)。3GB程度でメモリに収まるファイルなら、2問目以降も rg のほうが速いままです。uvp が効くのは10GBを超えて、同じファイルに2回以上聞くときです(実測記事。Mac M4・外付けUSB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約1/9保管で、開き直しも検索も一段速くなります(全OS対応・買い切り/月額プランあり)。
リンク
- 第1回: 巨大ファイルに沈む4つの定番ツールと、その先: https://uvp.y42u.net/blog/uwview-ps01-huge-file-tool-limits/
- 第3回: 文字コード4つの罠と切り分け手順: https://uvp.y42u.net/blog/uwview-ps03-japanese-encoding-traps/
- 第4回: 消す・残す・圧縮するの判断基準: https://uvp.y42u.net/blog/uwview-ps04-log-retention-decision/
- 第8回: 圧縮保管と検索の両立: https://uvp.y42u.net/blog/uwview-ps08-compressed-archive-search/
- 第11回: レガシー文字コードを2026年に読む: https://uvp.y42u.net/blog/uwview-ps11-legacy-encoding-euc-utf16/
- 第13回: 巨大データ検品の4技法: https://uvp.y42u.net/blog/uwview-ps13-huge-data-inspection/
- 第14回: 攻撃の痕跡は生ログにある: https://uvp.y42u.net/blog/uwview-ps14-attack-traces-raw-logs/
- 第16回: 保全・切り出し・改ざん対策の4原則: https://uvp.y42u.net/blog/uwview-ps16-log-as-evidence/
- 第19回: tail -f が追いつかない4つの状況: https://uvp.y42u.net/blog/uwview-ps19-streaming-log-follow/
- uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- 絞り込んだ先からさらに絞り込む(多段階検索): https://uvp.y42u.net/blog/uvp-drilldown-search/
- その順に現れる箇所だけを探す(シーケンシャル検索): https://uvp.y42u.net/blog/uvp-sequence-search/
- アーカイブ×セッション復元の実務フロー: https://uvp.y42u.net/blog/uwview-archive-session-restore-workflow/
- ソースコード(GitHub): https://github.com/amru195704/UwView
開発者より: アプリ・Kindle本・オープンソースの一覧は GitHub: amru195704 にまとめています。
お願い
本記事の情報は参考目的で掲載しており、正確性・完全性を保証するものではありません。実際の監査対応・内部統制・ログ保管方針の策定は、各組織の規程および適用される法令・所管の指針に従ってください。本記事は法令上の保管義務や提出物の要件について助言するものではありません。記事中の保管年数・日付・アカウント名・ファイル名・フィールド構成はすべて説明のための例であり、特定の制度・組織・事案を指すものではありません。gzip・zgrep・grep・awk・iconv・file・od等の挙動は、実装(GNU/BSD/busybox)・バージョン・ビルドオプション・ディストリビューションの既定設定により異なります。オプション名や既定値は必ず手元のmanで確認してください。圧縮率・展開速度の傾向は一般的な記述であり、データの性質・形式・実装により結果は変わります。実測と明記した数値も特定の1環境での測定例であり、同じ結果を保証するものではありません。ディスクの種類・ファイルシステム・断片化・暗号化・ページキャッシュの状態・同時に動いている他のプロセスにより、結果は大きく変わります。誤記・不正確な情報がございましたら、コメント欄よりご指摘いただければ、確認のうえ修正いたします。