件数が毎回違う。
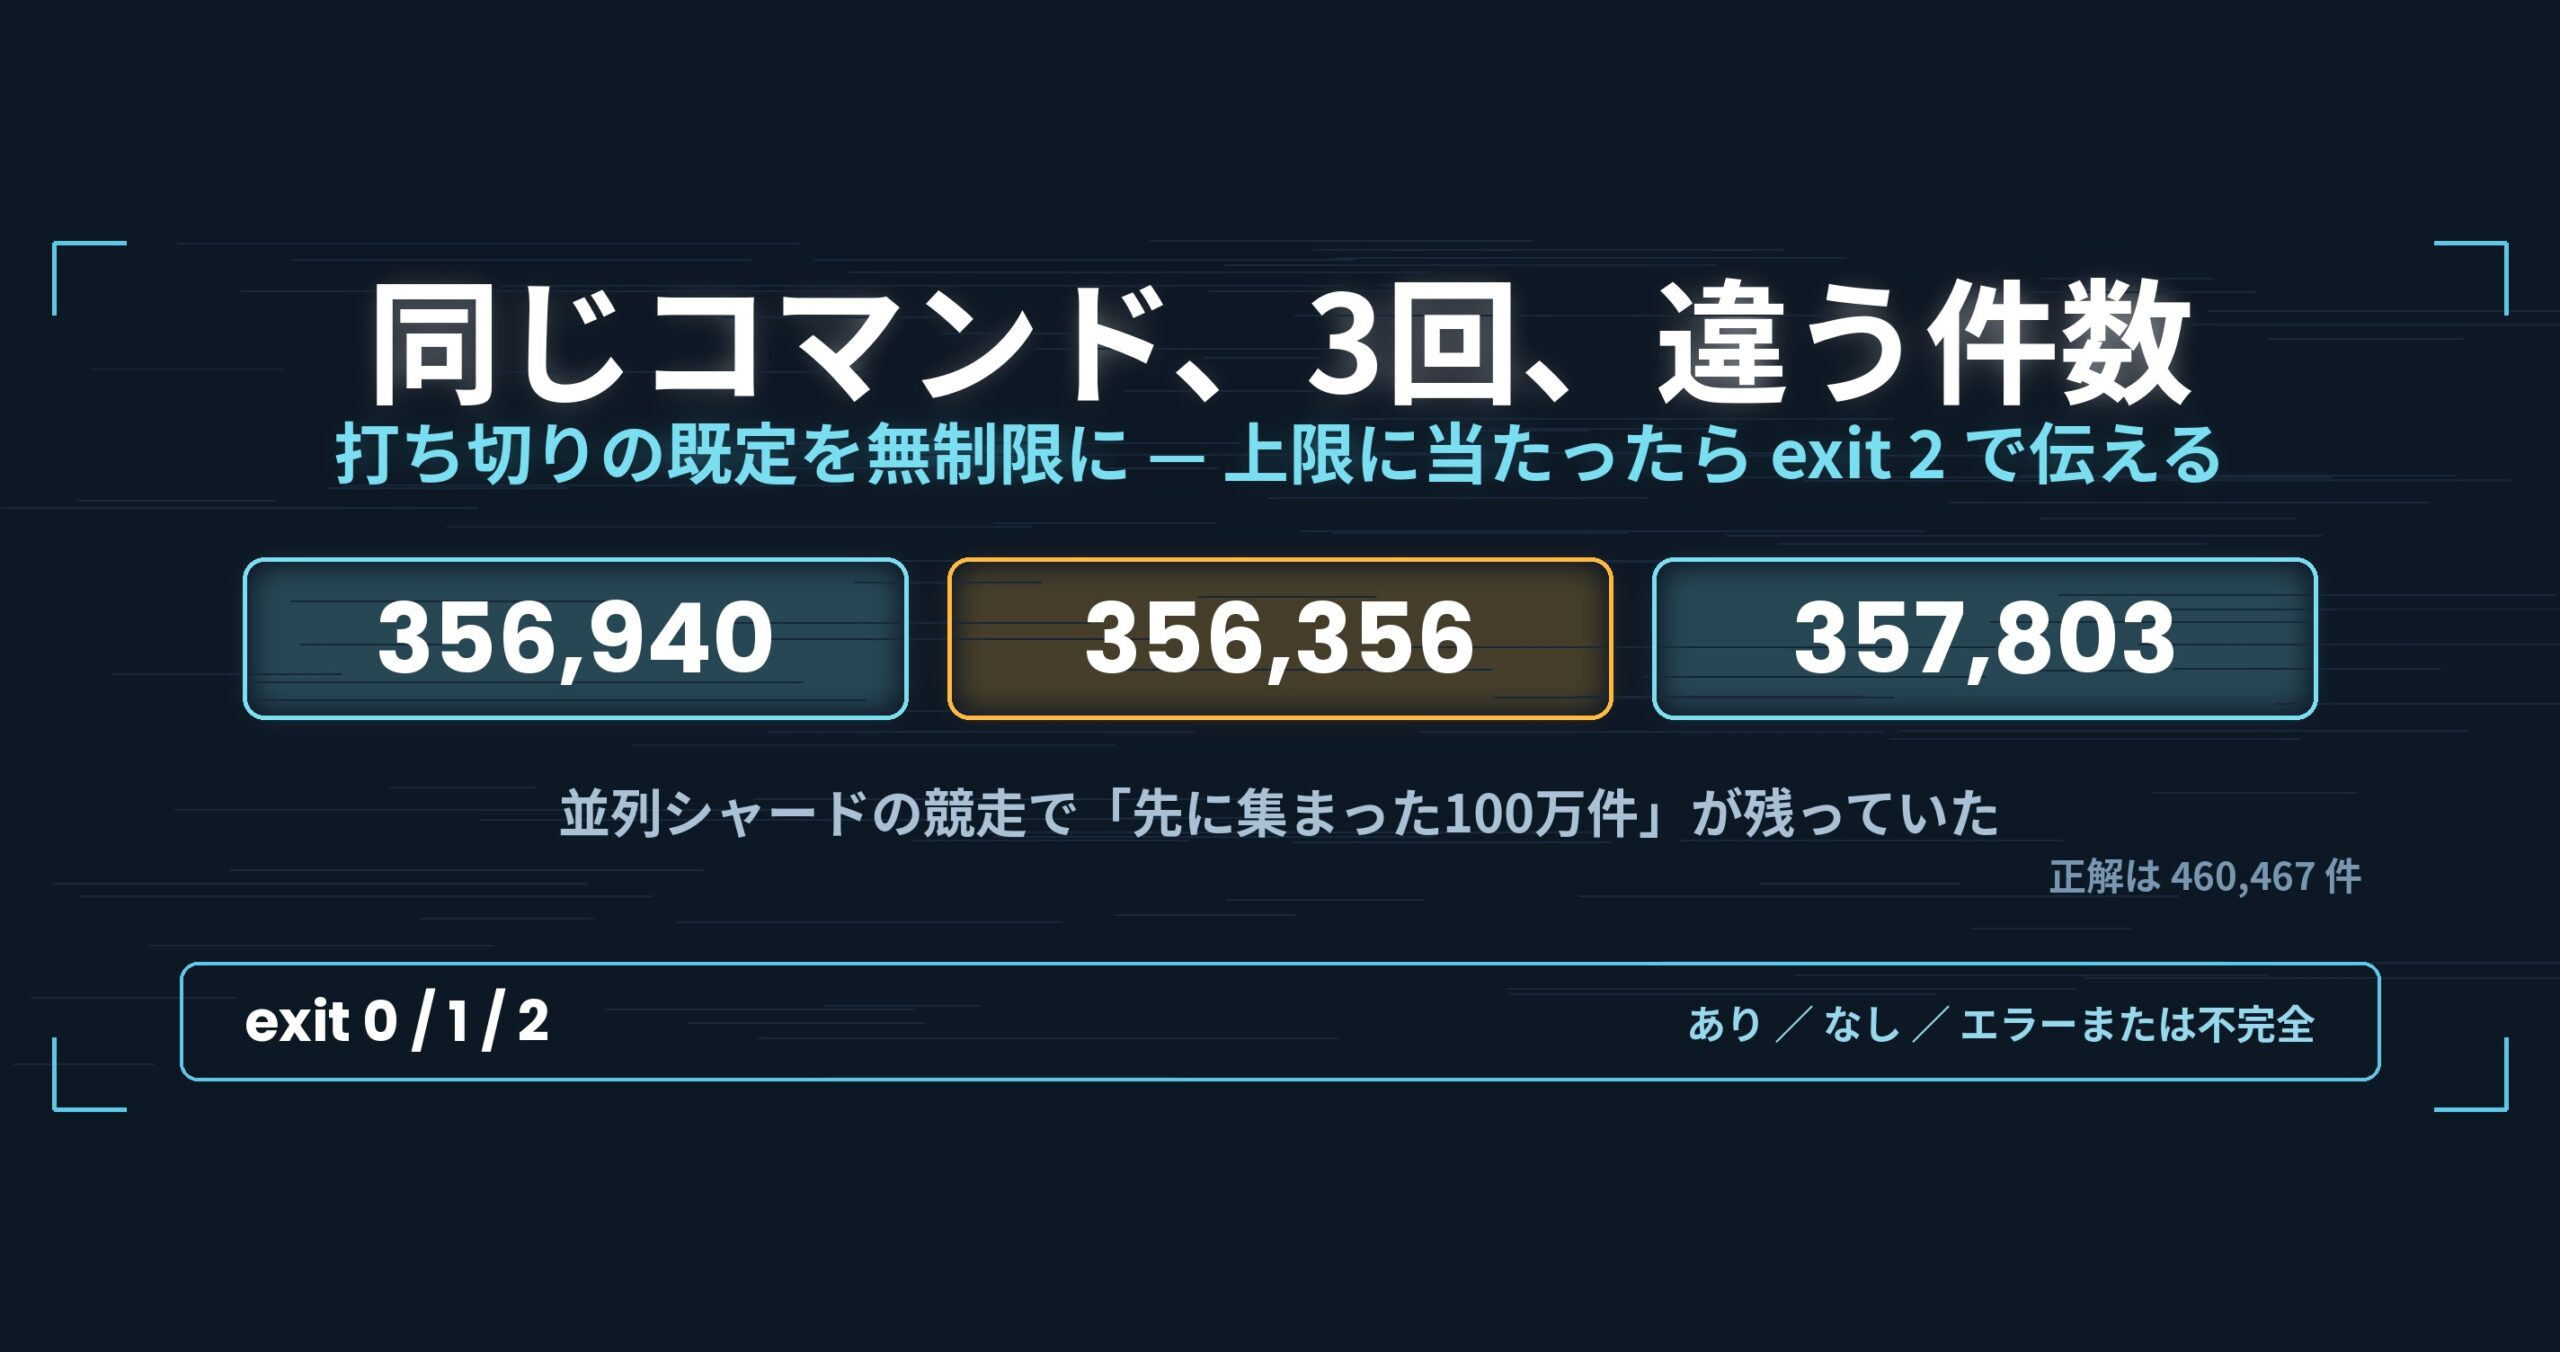
同じファイル、同じコマンド、同じ機械。3 回続けて実行して、356,940 件・356,356 件・357,803 件。どれも「エラー」ではなく、正常に終わって数字を返してきます。
これは速度の話ではありません。調査の道具として、いちばん壊れてはいけないものが壊れていました。
- 先に結論: 件数が揺れた原因は「並列で分割して探したとき、先に 100 万件集まったところで打ち切る」という既定にありました。どのシャードが先に埋めるかは毎回違うので、残る部分集合が非決定になります。既定を無制限に変え、上限を明示したときだけ打ち切って 終了コード 2(結果が不完全) で知らせる形にしました。代償は速度で、50GB の同じ調査が打ち切りありの 1.24 秒から無制限で 27.12 秒になります(同じ条件で ripgrep は 60.35 秒)。速さより再現性を取った変更です。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
- 問題: 3 回実行して、3 回とも違う数字が返ってきた
- 原因: 「先頭 100 万件」ではなく「先に集まった 100 万件」だった
- 「仕様どおり」は、直さない理由にならない
- 手当て: 既定を無制限にして、打ち切ったことを終了コードで伝える
- 数字: 速さを 21.9 倍捨てて、決定性を買った
- 持ち帰れる一般論: 「速い」と「毎回同じ」は、しばしば取り引きになる
- 使っている道具
- リンク
先に結論: 件数が揺れた原因は「並列で分割して探したとき、先に 100 万件集まったところで打ち切る」という既定にありました。どのシャードが先に埋めるかは毎回違うので、残る部分集合が非決定になります。既定を無制限に変え、上限を明示したときだけ打ち切って 終了コード 2(結果が不完全) で知らせる形にしました。代償は速度で、50GB の同じ調査が打ち切りありの 1.24 秒から無制限で 27.12 秒になります(同じ条件で ripgrep は 60.35 秒)。速さより再現性を取った変更です。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
この記事は「First Light」連載の第 5 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。今回扱うのは速度ではなく、その途中(v1.6.2)で直したCLI の仕様の話です。
問題: 3 回実行して、3 回とも違う数字が返ってきた
見つかったのは、ripgrep と出力を突き合わせる自動テストの不一致を調べている最中でした。
50GB の OpenStreetMap XML に対して、2 段階の絞り込みをかけます。1 段目で k="amenity" を含む行を集め、その中から 2 段目で parking を探す——調査ではよくやる形です。正解(全件を数えたときの値)は 460,467 件。
ところが返ってきた数字は、実行のたびに違いました。
- 1 回目: 356,940 件
- 2 回目: 356,356 件
- 3 回目: 357,803 件
全部足りません。そして全部違います。
不一致そのものには説明が付きました。1 段目の k="amenity" は 50GB では 100 万件を超えるので、当時の既定だった「100 万件で打ち切り」に当たっています。打ち切られた部分集合に対して 2 段目が走れば、当然 460,467 件には届きません。終了コードもちゃんと 2(上限到達)を返していました。仕様どおりです。
問題は、打ち切られ方でした。ここで問いが立ちます。仕様どおりに打ち切っているのなら、なぜ 3 回とも違う 100 万件が残るのか。
原因: 「先頭 100 万件」ではなく「先に集まった 100 万件」だった
巨大ファイルの検索は、ファイルを何本かに割って並列に走らせます(シャード)。uvp も同じです。
当時の打ち切りは、全シャードの結果が流れ込む共有の入れ物が 100 万件に達したら止めるという作りでした。一見まっとうに見えますが、ここに時間が混ざっています。
- どのシャードがどれだけ速く進むかは、その時のディスクの調子・キャッシュの当たり方・スレッドの割り当てで変わる
- 先に進んだシャードのヒットが、入れ物の枠を多く取る
- 100 万件に達した瞬間にどこまで進んでいたかは、毎回違う
つまり残るのは「ファイルの先頭から 100 万件」ではなく「その回のレースで先に集まった 100 万件」でした。だから 2 段目の母集団が毎回違い、356,940 と 356,356 と 357,803 が出ます。
同じ根から、もう 1 つの食い違いも出ていました。-limit 10 を付けたときの結果です。
3GB・-limit 10 |
1 件目のヒット位置 |
|---|---|
rg \| head -10 |
57,159 行目 |
uvp -limit 10(当時) |
71,004,000 行目 |
どちらも 10 件ちょうど返しますが、中身がまるで違います。uvp の 1 件目は、たまたま先に走り終えた後方シャードのヒットでした。当時の -limit は「保持件数の上限=メモリ保護」であって「先頭 N 件」を約束していなかったので、これも仕様どおりです。ただ、使う人の直感は確実に head の側にあります。テストを書いた本人がそう期待していたことが、何よりの証拠でした。
「仕様どおり」は、直さない理由にならない
ここが今回いちばん考えた場所なので、独立した見出しにします。
調べた結果はどれも「仕様どおり」でした。100 万件で打ち切るのも、-limit が先頭を約束しないのも、事前にそう決めたとおりに動いています。検索結果そのものが間違っていた例は 0 件でした。
それでも直すと決めたのは、この道具が調査のための道具だからです。調査では、同じコマンドを何度も打ちます。条件を変えながら打って、数字の動きから当たりを付けていく。そのとき条件を変えていないのに数字が動くと、何を見ているのか分からなくなります。
再現性(同じコマンドなら同じ結果)は、性能や機能と並ぶ「あったら良いもの」ではなく、それが無いと他のすべての数字が信用できなくなる土台です。仕様として筋が通っていても、土台を崩すなら仕様のほうを変える——そう裁定しました。
手当て: 既定を無制限にして、打ち切ったことを終了コードで伝える
v1.6.2 で入れた変更は 3 つです。
1. -limit の既定を無制限にした。 何も指定しなければ、最後まで探して全部返します。100 万件という既定値が消えたので、「知らないうちに打ち切られていた」が起きません。上の 2 段絞り込みも 460,467 件を返すようになりました。
2. 上限に当たったことは、終了コードで伝える。 -limit N を明示して N 件に達したら、結果を返したうえで終了コード 2 を返します。uvp の終了コードは grep と同じ約束にしてあります。
| 終了コード | 意味 |
|---|---|
| 0 | 見つかった |
| 1 | 見つからなかった |
| 2 | エラー、または結果が不完全(上限に当たって打ち切った) |
grep の 2 は本来「エラー」ですが、「この出力を信用してよいか」を問う点では打ち切りもエラーと同じです。スクリプトから使うとき、if uvp huge.log 'ERROR'; then がそのまま書けて、しかも不完全な結果を成功として飲み込まない——この 2 つを同時に満たす置き場所は 2 しかありませんでした。
3. -head を作り直した。 「先頭 N 件だけ見たい」という要求は正当なので、-limit とは別に用意しました。旧実装は全件探してから先頭 N 件を切るという作りで、50GB の -head 10 に 7.01 秒かかっていました。新しい -head は 1 スレッドで先頭から読み、N 件に達したら止めます。7.01 秒 → 0.32 秒。結果は決定的で、rg | head とバイト単位で一致します(9/9 一致・終了コード 0)。
そのうえで、-limit の仕様を文書に書き下しました。保持件数の上限であること・先頭 N 件を保証しないこと・上限に当たれば終了コード 2 を返すこと。 「先頭 N 件が欲しいなら -head」と並べて書いてあります。暗黙の既定値をやめた以上、残った仕様は明示しておかないと同じことが起きます。
数字: 速さを 21.9 倍捨てて、決定性を買った
50GB・.uwvz 再利用(Mac M4・メモリ 32GB・外付け USB SSD・ripgrep 15.2.0・2026-09-15 の計測)
| 50GB の同じ調査 | uvp |
ripgrep |
|---|---|---|
| 旧既定(100 万件で打ち切り) | 1.24 秒 | 60.35 秒 |
-limit 1000(明示) |
0.52 秒 | — |
| 新既定(無制限・29,114,490 件) | 27.12 秒 | 60.35 秒 |
1.24 秒から 27.12 秒。21.9 倍遅くなっています。これは改善記に載せるには珍しい向きの数字ですが、隠すところではありません。打ち切りは速いのです。「途中で止めていいなら速い」は当たり前で、問題は止まる場所が毎回違ったことでした。
代わりに手に入ったものを書きます。
- 同じコマンドが同じ件数を返す。 460,467 件が毎回返ります
- ripgrep との自動突き合わせが全項目で通る。
-limit noneを付けて回していた 81 項目が、既定のまま 81 項目一致・不一致 0 になりました -headは速く、かつ決定的になった。 7.01 秒 → 0.32 秒
なお、無制限の 27.12 秒でも ripgrep の 60.35 秒より速いので、決定性を買った結果として遅くなったが、相手には負けていないという着地です。ここは運が良かった部分で、もし逆だったら同じ判断ができたかは分かりません。
正直に書いておくこと
-headは決定的になりましたが、rg | headにはまだ負けます。50GB で 0.32 秒 対 0.20 秒。残りのほとんどは .NET の起動に 0.24 秒かかる分で、検索の中身ではありません。サブ秒どうしの勝負なので実用上は同じですが、負けは負けです- 上の秒数は
.uwvz(圧縮キャッシュと索引)が既にある 2 回目以降の値です。1 回目は.uwvzを作るぶん 50GB で ripgrep より 6〜7% 遅くなります(59.0 秒 対 54.9〜55.8 秒・v1.6.6.1) - 356,940/356,356/357,803 の 3 値は v1.6.1 時点の実行で観測したものです。3 回しか試していません。非決定性の存在を示すには足りますが、揺れ幅の分布を語れるデータではありません
- 終了コード 2 を「不完全」に使う設計は、grep の慣習からは少しずれます。
rg | headは打ち切っても 0 を返すので、そちらに揃える選択肢もありました。スクリプトの書きやすさと、静かに欠けた結果を渡さないことを天秤にかけて、後者を取っています
持ち帰れる一般論: 「速い」と「毎回同じ」は、しばしば取り引きになる
並列で走らせて、先に集まったぶんで打ち切る——この形はとても速く、そして時間が結果に混ざります。速さのために増やした並列度が、そのまま非決定性の入口になります。
見分け方は単純で、「途中で止める」条件に、進み方の速い遅いが関わっていないかを見ます。関わっているなら、その出力は実行ごとに変わります。件数の上限、時間の上限、メモリの上限——どれも同じ罠を持っています。
もう 1 つ。壊れていることは、たいてい「不一致」ではなく「不安定」として現れます。 今回も、テストが落ちたから見つかったのではありません。テストの不一致には「打ち切りだから」という説明が付いていて、そこで終わらせることもできました。見つかったのは、同じ調査を何度か流したときに数字が揃わなかったからです。
だから、自動テストに 1 つ足しておくと安い保険になります。同じ入力で 2 回走らせて、出力が一致するか。期待値を用意する必要すらありません。この 1 項目は、期待値を書く手間がゼロなのに、時間が混ざった設計を片端から捕まえます。
そして最後に。既定値は仕様です。 「安全のために 100 万件で止めておく」という善意の既定が、利用者にとっては「理由の分からない欠損」になっていました。黙って効く上限より、明示して初めて効く上限のほうが安全です——止まったことが伝わる限りにおいて。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 2章: 2語で絞り込む(1語目の結果の中から2語目を探す)
uvp huge.osm 'k="amenity"' 'parking'

# 4章: 保持件数の上限を明示する(当たると終了コード 2)
uvp huge.log 'ERROR' -limit 1000

# 4章: 先頭 N 件だけ見る(決定的・早期終了)
uvp huge.log 'ERROR' -head 10

# 4章: 終了コードで分岐する(0=あり / 1=なし / 2=エラーまたは不完全)
if uvp huge.log 'FATAL'; then echo "found"; fi

# 5章: 値ごとに件数を数える/前後の文脈ごと見る
uvp huge.log -uniq 'status=([0-9]+)'
uvp huge.log 'FATAL' -C 5

# 5章: 結果をファイルに書き出す/そのまま画面に渡して開く
uvp huge.log 'FATAL' -out fatal.txt
uvp huge.log 'FATAL' -open
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvp huge.log 'FATAL'; then がそのまま書けます。
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2 回半読んでいた CLI を 1 回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 3 回:
-iを文字に戻さずバイトのまま畳む: https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/ - uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- ripgrep・sed と 81 項目を突き合わせた話: https://uvp.y42u.net/blog/uvp-vs-ripgrep-sed-81-checks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。