探した結果を、捨てていた。
コマンドで 50GB を探して、当たった行を画面で開く。よくやる流れです。ところがこのとき、コマンドが見つけたヒットの位置は画面に渡っていませんでした。渡っていたのは検索語だけ。
つまり画面は、同じ 50GB をもう一度読み直していたことになります。
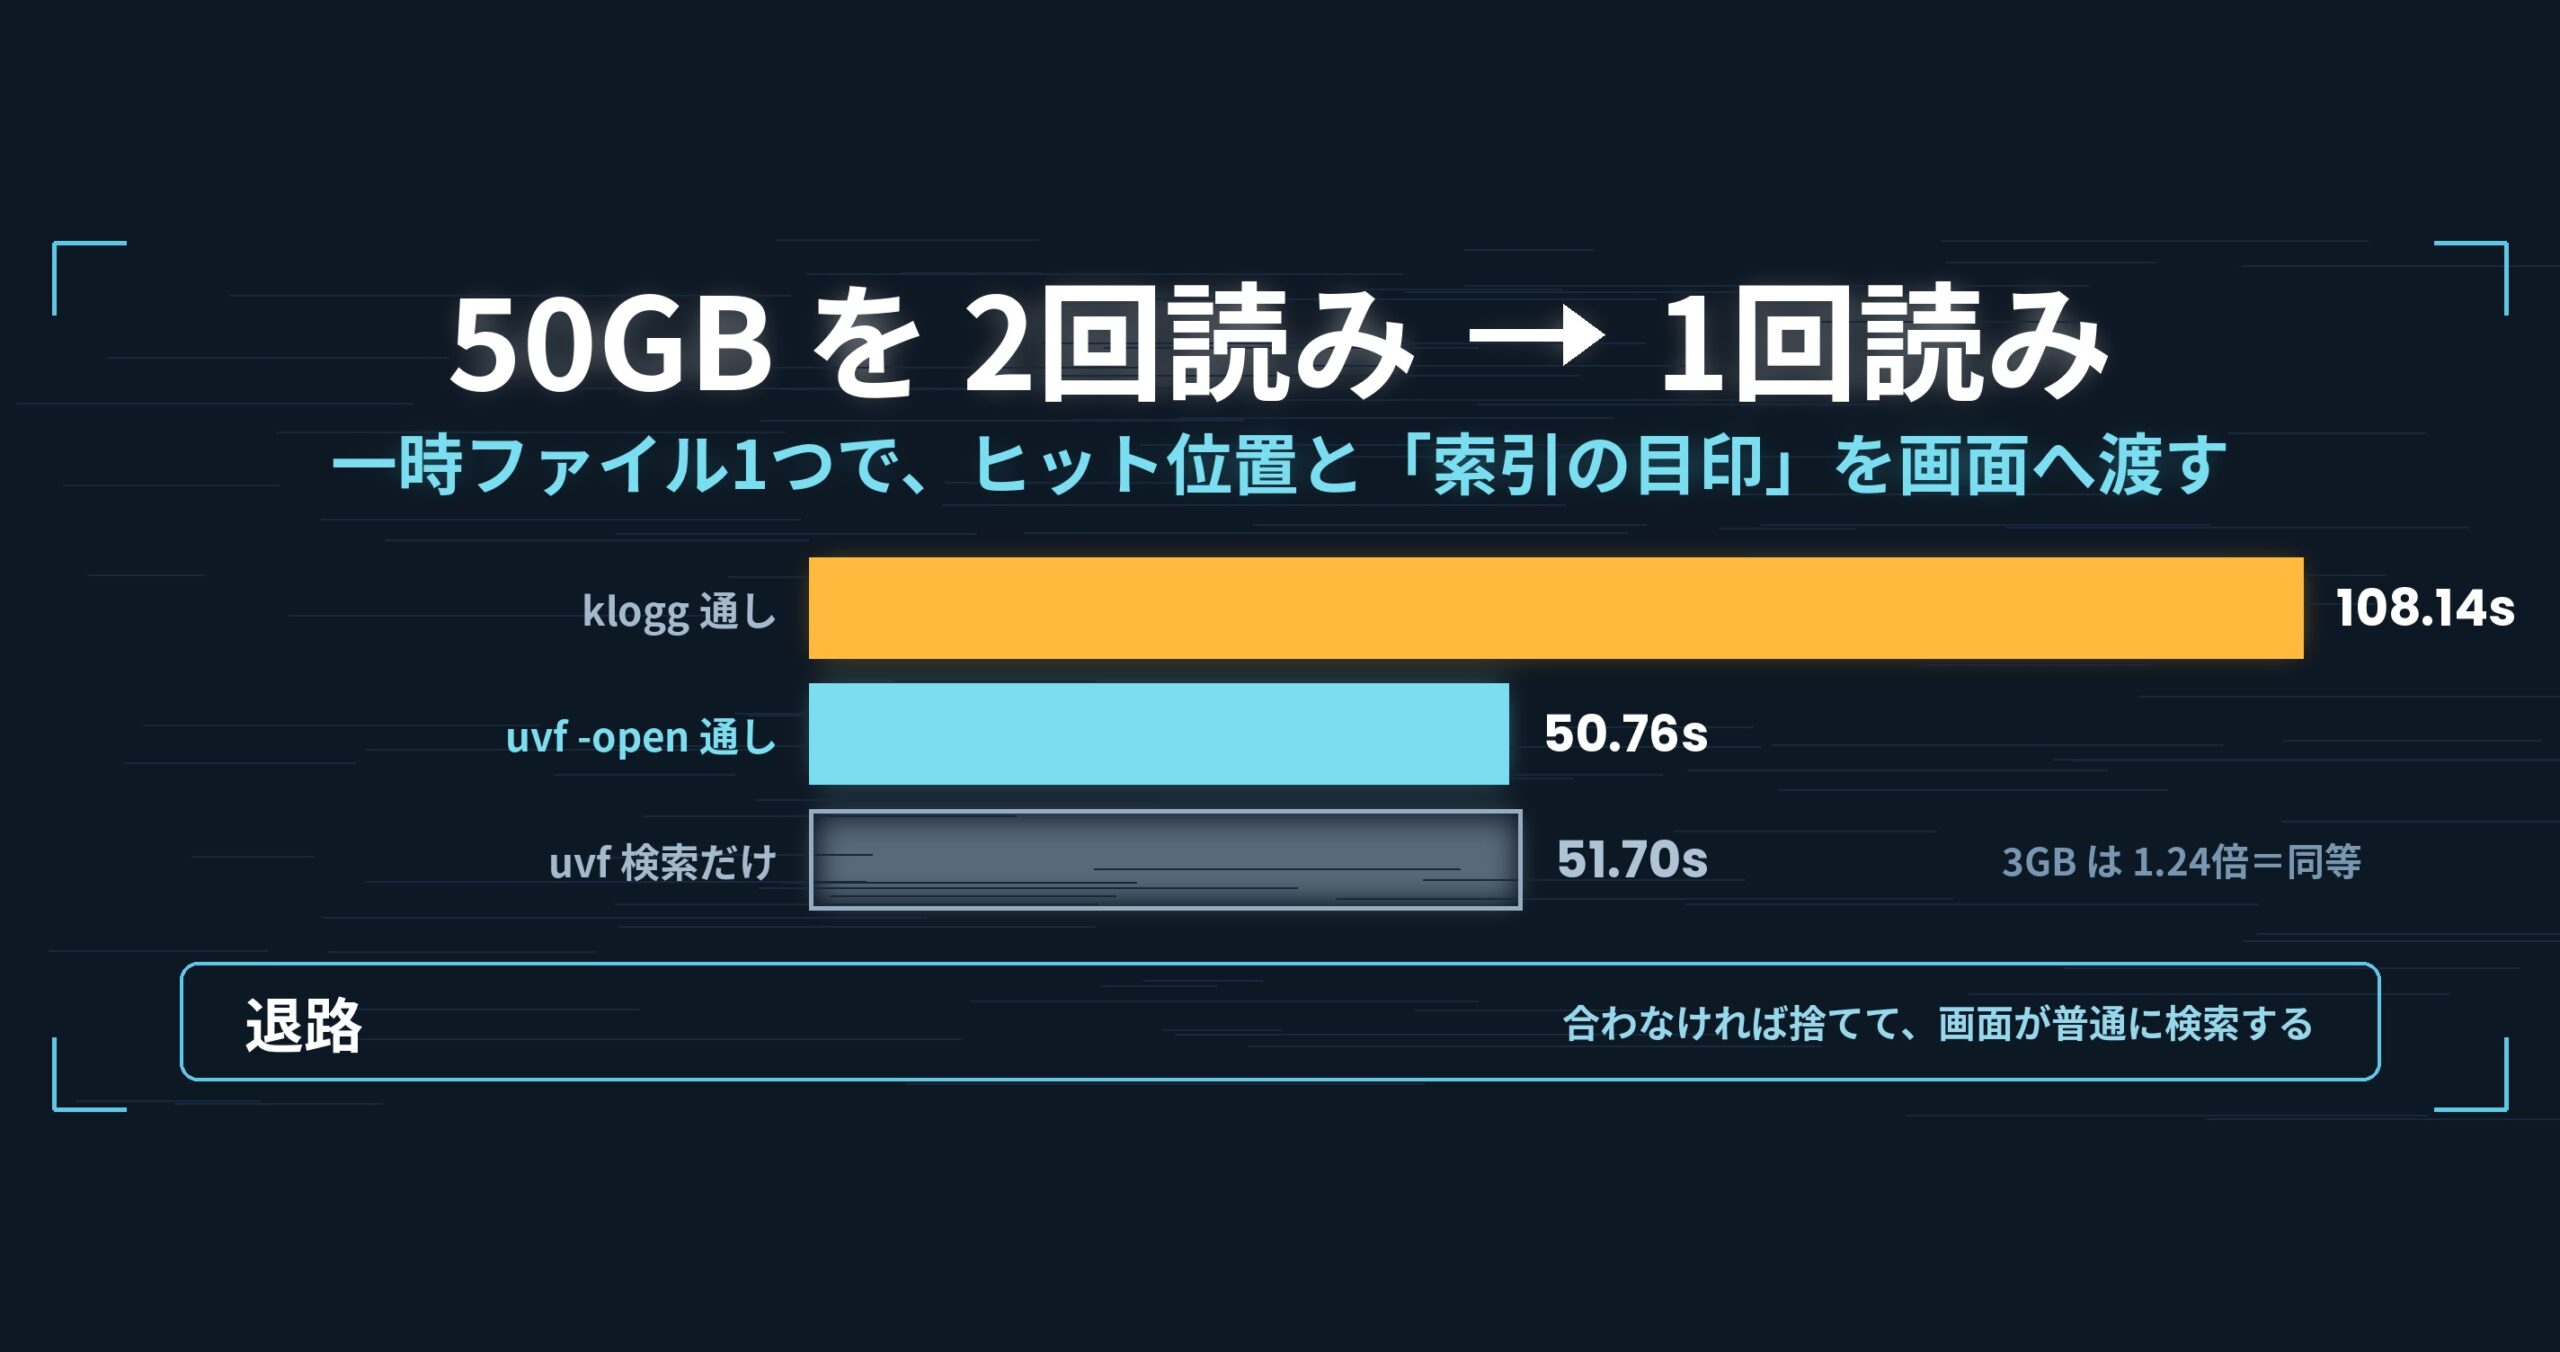
- 先に結論: -open(コマンドで探して、その結果を画面で開く)が、CLI の検索と画面の検索で同じファイルを 2 回読んでいた状態を、一時ファイル 1 つでヒット行の位置と「索引の目印」を渡す形に変えて 1 回にしました。50GB の通しは 50.76 秒。同じ条件で検索だけが 51.70 秒なので、画面を開いて行番号つきの一覧を出すところまで含めて上乗せは誤差の範囲です。klogg の通し(開く+検索)108.14 秒に対して 2.13 倍。ただし 3GB では klogg 4.21 秒 対 3.40 秒=1.24 倍で、これは「同等」です。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・コールド(sudo purge 後)での測定例。詳細は記事末尾。
- 問題: -open を付けると、同じ 50GB を 2 回通し読みしていた
- 設計: 一時ファイル 1 つ、読んだら消す、合わなければ捨てる
- 手当て: ついでに「索引の目印」も渡す
- 数字: 通しの上乗せが誤差の範囲に収まった
- 持ち帰れる一般論: 「どのみち読むなら、数えるものを増やす」
- 使っている道具
- リンク
先に結論: -open(コマンドで探して、その結果を画面で開く)が、CLI の検索と画面の検索で同じファイルを 2 回読んでいた状態を、一時ファイル 1 つでヒット行の位置と「索引の目印」を渡す形に変えて 1 回にしました。50GB の通しは 50.76 秒。同じ条件で検索だけが 51.70 秒なので、画面を開いて行番号つきの一覧を出すところまで含めて上乗せは誤差の範囲です。klogg の通し(開く+検索)108.14 秒に対して 2.13 倍。ただし 3GB では klogg 4.21 秒 対 3.40 秒=1.24 倍で、これは「同等」です。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・コールド(sudo purge 後)での測定例。詳細は記事末尾。
この記事は「First Light」連載の第 6 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。今回扱う受け渡しは v1.6.4・v1.6.5 で入ったもので、画面側が 1 回読みになる前の橋渡しにあたります。
問題: -open を付けると、同じ 50GB を 2 回通し読みしていた
uvf huge.log 'ERROR' -open と打つと、コマンドが検索して、そのあと画面(GUI)が立ち上がってファイルを開きます。調査の入口としてよく使う形です。
当時、この間で受け渡されていたのは検索語だけでした。画面は起動すると、渡された語で自分でもう一度検索します。
- コマンドが 50GB を通しで読む(約 50 秒)
- 画面が 50GB をもう一度通しで読む(約 50 秒)
コマンドが持っている「どの行が当たったか」は、プロセスが終わると一緒に消えます。すでに払った 50 秒ぶんの答えを、毎回捨てていたわけです。
なぜそうなっていたかというと、渡す口が無かったからでした。コマンドから画面へ渡せるのはコマンドライン引数だけで、そこに載るのはファイルパスと検索語です。数十万件のヒット位置を引数に載せることはできません。
問いはこうです。プロセスをまたいで「探した結果」を渡すのに、いちばん壊れにくい方法は何か。
設計: 一時ファイル 1 つ、読んだら消す、合わなければ捨てる
選んだのは、いちばん素朴な形でした。コマンドが結果を一時ファイル(uvf-open-*.uvfh)に書き、そのパスを画面に渡す。画面は読んだら消す。それだけです。
共有メモリやプロセス間通信も候補でしたが、ここには失敗したときに何が起きるかという基準を当てました。
| 起こりうること | この設計での結果 |
|---|---|
| 画面が起動しなかった | 一時ファイルが残る。次回の起動時に古いものを掃除する |
| 一時ファイルが壊れていた | 読めない時点で捨てて、画面が普通に検索する |
| 渡している間にファイルが書き換わった | 長さの突き合わせで気づいて捨て、普通に検索する |
最後の行が肝心です。コマンドはファイルを読む前と後でファイル長を記録し、一時ファイルに一緒に書きます。画面は開く直前にもう一度ファイル長を見て、3 つが揃っていなければ渡されたヒット位置を全部捨てます。ログファイルは追記され続けるものなので、これは珍しい事態ではありません。
渡す仕組みが失敗しても、機能は失われない。遅くなるだけで、答えは変わらない——第 4 回で必須リテラルの抽出に持たせたのと同じ形の退路です。速度のための仕掛けは、こう作れる限りこう作ります。
手当て: ついでに「索引の目印」も渡す
ここまでで 2 回読みは 1 回になりますが、画面側にはもう 1 つ待ち時間がありました。行番号の索引です。
巨大ファイルの画面では、スクロールバーを動かすために「何行目がファイルの何バイト目から始まるか」を持つ必要があります。全部持つと巨大になるので、N 行ごとに間引いた目印を持ちます。これを作るには、結局ファイルを通しで読んで改行を数えなければなりません。
そこで気づいたのは、コマンドはすでに全部読んでいるという事実でした。
コマンドは 1 回読みの最中に、改行を数えて行番号を出しています(第 2 回)。数えているのだから、N 行ごとの行頭位置を控えておくのは、ほとんど無料です。読み出しはすでに走っていて、増えるのは配列に値を 1 つ書く手間だけ。
そこで一時ファイルの形式に、ヒット行の位置だけでなく次の 2 つを足しました(形式 v2)。
- N 行ごとの行頭バイト位置(間引いた索引そのもの)
- 総改行数(ファイル全体の行数)
これで画面側は、索引を作るのではなく組み立てるだけになります。起動して、渡された数字を並べて、そのまま使える。索引の完成待ちが消え、結果一覧は最初から行番号つきで出ます。
あわせて、-open と -i/-E/-v の併用も解けました。以前は「画面がもう一度検索する」設計だったので、条件の種類を画面側に正しく伝える必要があって併用を止めていました。結果そのものを渡す形になったので、コマンド側で条件を解決してから渡し、種類も一緒に伝えるだけで済みます。
数字: 通しの上乗せが誤差の範囲に収まった
コールド(sudo purge 後)・v1.6.6・Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML
| 3GB | 10GB | 50GB | |
|---|---|---|---|
uvf 検索だけ |
3.27 秒 | 10.40 秒 | 51.70 秒 |
uvf … -open(通し) |
3.40 秒 | 10.42 秒 | 50.76 秒 |
| klogg 24.11.0(開く+検索) | 4.21 秒 | 22.73 秒 | 108.14 秒 |
| 対 klogg | 1.24 倍 | 2.18 倍 | 2.13 倍 |
いちばん見てほしいのは、上 2 行の近さです。検索だけ 51.70 秒に対して、画面を開いて行番号つき一覧まで出す通しが 50.76 秒。50GB では -open のほうが 0.94 秒速く出ていますが、これは -open が検索より速いという意味ではありません。外付け USB SSD は同じ測定を繰り返しても 1 秒前後は揺れるので、上乗せが測定のばらつきに埋もれたと読むのが正しい読み方です。
言い換えると、画面を開く工程の値段が、ほぼゼロになったということです。読み出しが 1 回に畳まれ、索引が組み立てるだけになったので、残っているのは画面を立ち上げる時間だけになりました。
klogg との比較は、サイズによって書き方を変えます。
- 50GB は 2.13 倍・10GB は 2.18 倍。 基準(単項目 1.5 倍)をはっきり超えているので、ここは「速い」と書きます
- 3GB は 1.24 倍。これは「同等」です。 単項目で 1.5 倍未満を差と呼ばない、と自分たちで決めているので、ここを勝ちとは書きません。小さいファイルでは読み出しがすぐ終わるため、起動やウィンドウ表示の固定費が支配的になります
正直に書いておくこと
- 上の値はすべて Mac での測定です。Windows・Linux は媒体も OS のキャッシュの作法も違うので、秒数を OS またぎで比べないでください
- klogg の「通し」は、開く操作から検索の件数が確定するまでをストップウォッチ 1 本で測った値です。人間が操作する時間が入ります。
uvf … -openも同じ測り方で揃えていますが、自動計測ではありません - 一時ファイルの受け渡しは、同じ機械の中でしか使えません。ネットワーク越しのファイルや、コマンドと画面が別のマシンにある構成では素直に働きません
- 250GB の
-openは v1.6.5 時点の 265.21 秒のままで、v1.6.6 での再計測がまだです - この回で速くなったのは
-openの通しだけです。画面を単独で使ったときの「開く」「検索」が同じ 1 回読みになるのは、この次(v1.6.6)でした(画面側を追いつかせた話)
持ち帰れる一般論: 「どのみち読むなら、数えるものを増やす」
この回の要点は、速いアルゴリズムではありません。すでに払っているコストに、無料で相乗りできるものを探したことです。
巨大ファイルの処理では、時間のほとんどが読み出しに消えます。1 バイトを手元に持ってきている間に、CPU は大量に余っています。だから「通しで読んでいる最中に、ついでに何を数えておくか」は、ほぼタダで増やせる枠になります。行番号の索引はその枠にぴったり収まりました。
逆に言うと、同じデータを 2 回読む設計は、その枠を丸ごと捨てています。どちらのパスも読み出しで律速しているので、2 回読めば単純に 2 倍かかる。ここを削るのに賢さは要らず、「1 回目のときに何を残しておけば、2 回目が要らなくなるか」を数えるだけで済みます。
もう 1 つ。プロセスをまたぐ最適化は、失敗したときの挙動から設計すると小さくなります。 今回は「壊れていたら捨てて、普通に検索する」が最初に決まりました。すると受け渡しの形式には、厳密な排他も、バージョン交渉も、整合性の証明も要らなくなります。要るのは捨ててよいと判断できる材料(ここではファイル長)だけです。
速くするための仕組みが、正しさの前提になってはいけません。 前提になった瞬間、その仕組みは絶対に壊れてはいけないものになり、設計が重くなります。捨てられる仕組みは、軽く作れます。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 2章: コマンドで探した結果を、そのまま画面で開く(無料版)
uvf huge.log 'ERROR' -open

# 4章: 大小無視・正規表現・除外と併用する(v1.6.5 で解禁)
uvf huge.log 'error' -i -open
uvf huge.log -E 'timeout|refused' -open

# 5章: 画面を使わず、結果だけファイルに書き出す
uvf huge.log 'FATAL' -out fatal.txt

# 5章: 前後の文脈ごと見る
uvf huge.log 'FATAL' -C 5

# 5章: 2語で絞り込む(1語目の結果の中から2語目を探す)
uvf huge.log 'ERROR' 'payment'
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvf huge.log 'FATAL'; then がそのまま書けます。
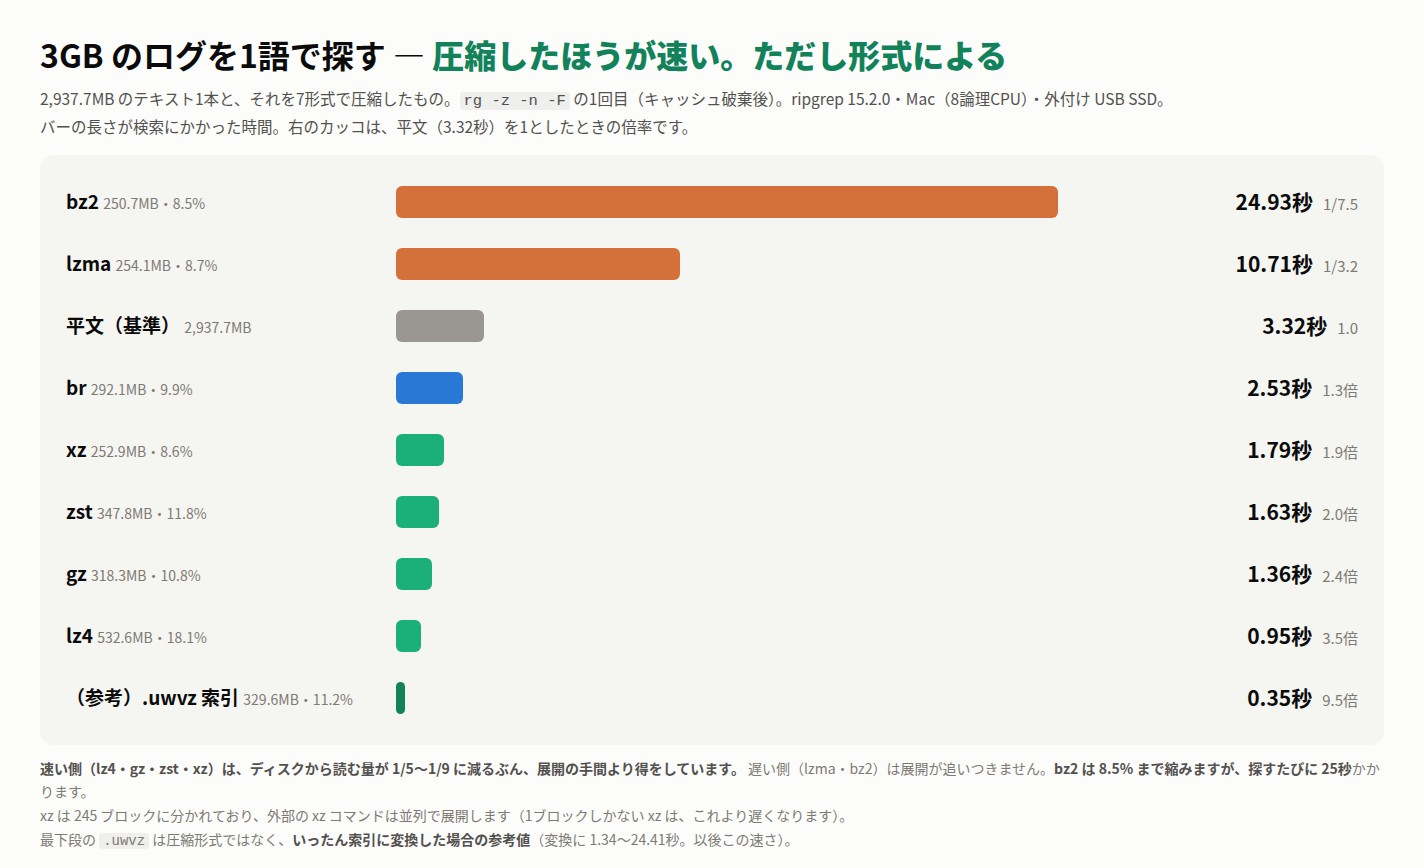
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2 回半読んでいた CLI を 1 回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 3 回:
-iを文字に戻さずバイトのまま畳む: https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/ - 画面側も同じ 1 回読みにした話(v1.6.6): https://uvp.y42u.net/blog/uvp-gui-catches-up-v166/
- klogg と「開く」を比べ直した実測: https://uvp.y42u.net/blog/uvp-klogg-open-lose-flow-win/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。