1.28 倍は、勝ちではありません。
自分のツールが相手より 1.28 倍速い数字が出たとき、それを「速くなった」と書くかどうか。ここを測る前に決めておかないと、結果を見てから基準が動きます。
では、いくつからなら書いてよいのか。
- 先に結論: 性能比較の判定基準を、測定より先に文章として固定しました。単項目は 1.5 倍未満を「差」と呼ばない/7 項目以上の合計は 1.3 倍未満を「差」と呼ばない/それ未満は、独立した裏付け(事前予測と実測の一致・サイズ間で倍率が揃う・対照群が動かない)があるときだけ差として扱う——の 3 行です。下限はもともと 2 倍でしたが、2026-09-25 に 1.5 倍へ下げました。下げた結果、自分たちの圧縮形式の計測データで判定が 6 行ひっくり返り、うち 2 か所は公開文書の文言を訂正することになりました。基準の話なので、この回に速くなった数字はありません。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
- 問題: ベンチマークの数字は、いくらでも都合よく読める
- 手当て: 3 行の基準を、性能レポートの中に書き置く
- 実際に効いた場面: 3 つの裏付けが全部使われた
- 下限を 2 倍から 1.5 倍へ下げた
- 環境のほうが基準より先に壊れる
- 持ち帰れる一般論: 基準は、結果を見る前にしか作れない
- 使っている道具
- リンク
先に結論: 性能比較の判定基準を、測定より先に文章として固定しました。単項目は 1.5 倍未満を「差」と呼ばない/7 項目以上の合計は 1.3 倍未満を「差」と呼ばない/それ未満は、独立した裏付け(事前予測と実測の一致・サイズ間で倍率が揃う・対照群が動かない)があるときだけ差として扱う——の 3 行です。下限はもともと 2 倍でしたが、2026-09-25 に 1.5 倍へ下げました。下げた結果、自分たちの圧縮形式の計測データで判定が 6 行ひっくり返り、うち 2 か所は公開文書の文言を訂正することになりました。基準の話なので、この回に速くなった数字はありません。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例。詳細は記事末尾。
この記事は「First Light」連載の第 9 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。連載でここまで並べてきた数字は、すべてこの回の基準を通したものです。
問題: ベンチマークの数字は、いくらでも都合よく読める
性能改善を続けていると、必ずこの状況になります。
改修をした。測った。1.3 倍速くなっている。これは成果か、測定のばらつきか。
厄介なのは、どちらとも言えるところです。同じコマンドを 3 回流せば秒数は毎回違います。外付け USB SSD なら 1 秒前後は平気で揺れる。だから 1.3 倍という数字を見た瞬間、人は自分に都合のよい説明を選べます。
- 速くしたかった人は「効いた」と読む
- 疑っている人は「誤差」と読む
そしてどちらも嘘をついていません。基準が無いからです。
自分のツールの記事を書く立場だと、この曖昧さは致命的になります。比較相手(ripgrep や klogg)は自分では反論してきません。読者が持っている検算の材料は、こちらが書いた数字だけです。判定の自由が書き手の側に全部ある構図で、都合のよい読み方を積み上げていくと、最後に残るのは信用できない記事の山です。
問いはこうです。どこからを「差」と呼ぶかを、測定より先に決められるか。
手当て: 3 行の基準を、性能レポートの中に書き置く
決めたのはこの 3 行です。
- 単項目は 1.5 倍未満を「差」と呼ばない(ある 1 つの項目、たとえば「50GB の大小無視検索」の秒数を比べるとき)
- 7 項目以上の合計は 1.3 倍未満を「差」と呼ばない(たくさん足せば個々のばらつきは打ち消されるので、下限は下げてよい)
- それ未満でも、独立した裏付けが 1 つあれば差として扱う。裏付けとして認めるのは次の 3 つだけ
- 事前予測と実測の一致: 直す前に「これで何秒縮むはず」と数字で書いておき、その値で動いた
- サイズ間で倍率が揃う: 3GB・10GB・50GB で同じ比になる(ばらつきなら散る)
- 対照群が動かない: 手を触れていない比較相手が同じ秒数を返す
大事なのは 3 番の書き方です。「裏付けがあれば例外を認める」だけだと、例外は無限に作れます。認める裏付けの種類を 3 つに固定して、それ以外は認めない。これで「気持ちとしては効いている」という理由が使えなくなります。
置き場所も決めました。この 3 行は記事の中ではなく、性能レポートの「以後の判断基準」という節に書いてあります。記事を書くときに毎回思い出すのではなく、測定の記録の側に置いて、記事がそれを参照する形です。
実際に効いた場面: 3 つの裏付けが全部使われた
基準を決めてから今日までに、3 種類の裏付けをそれぞれ 1 回ずつ使いました。連載で書いてきた回と対応しています。
(1)サイズ間で倍率が揃う — gz の直接検索(本連載の第 8 回)
| 元ファイル相当 | 改善前 | 改善後 | 倍率 |
|---|---|---|---|
| 3GB | 2.18 秒 | 1.16 秒 | 1.88 倍 |
| 10GB | 7.27 秒 | 3.66 秒 | 1.99 倍 |
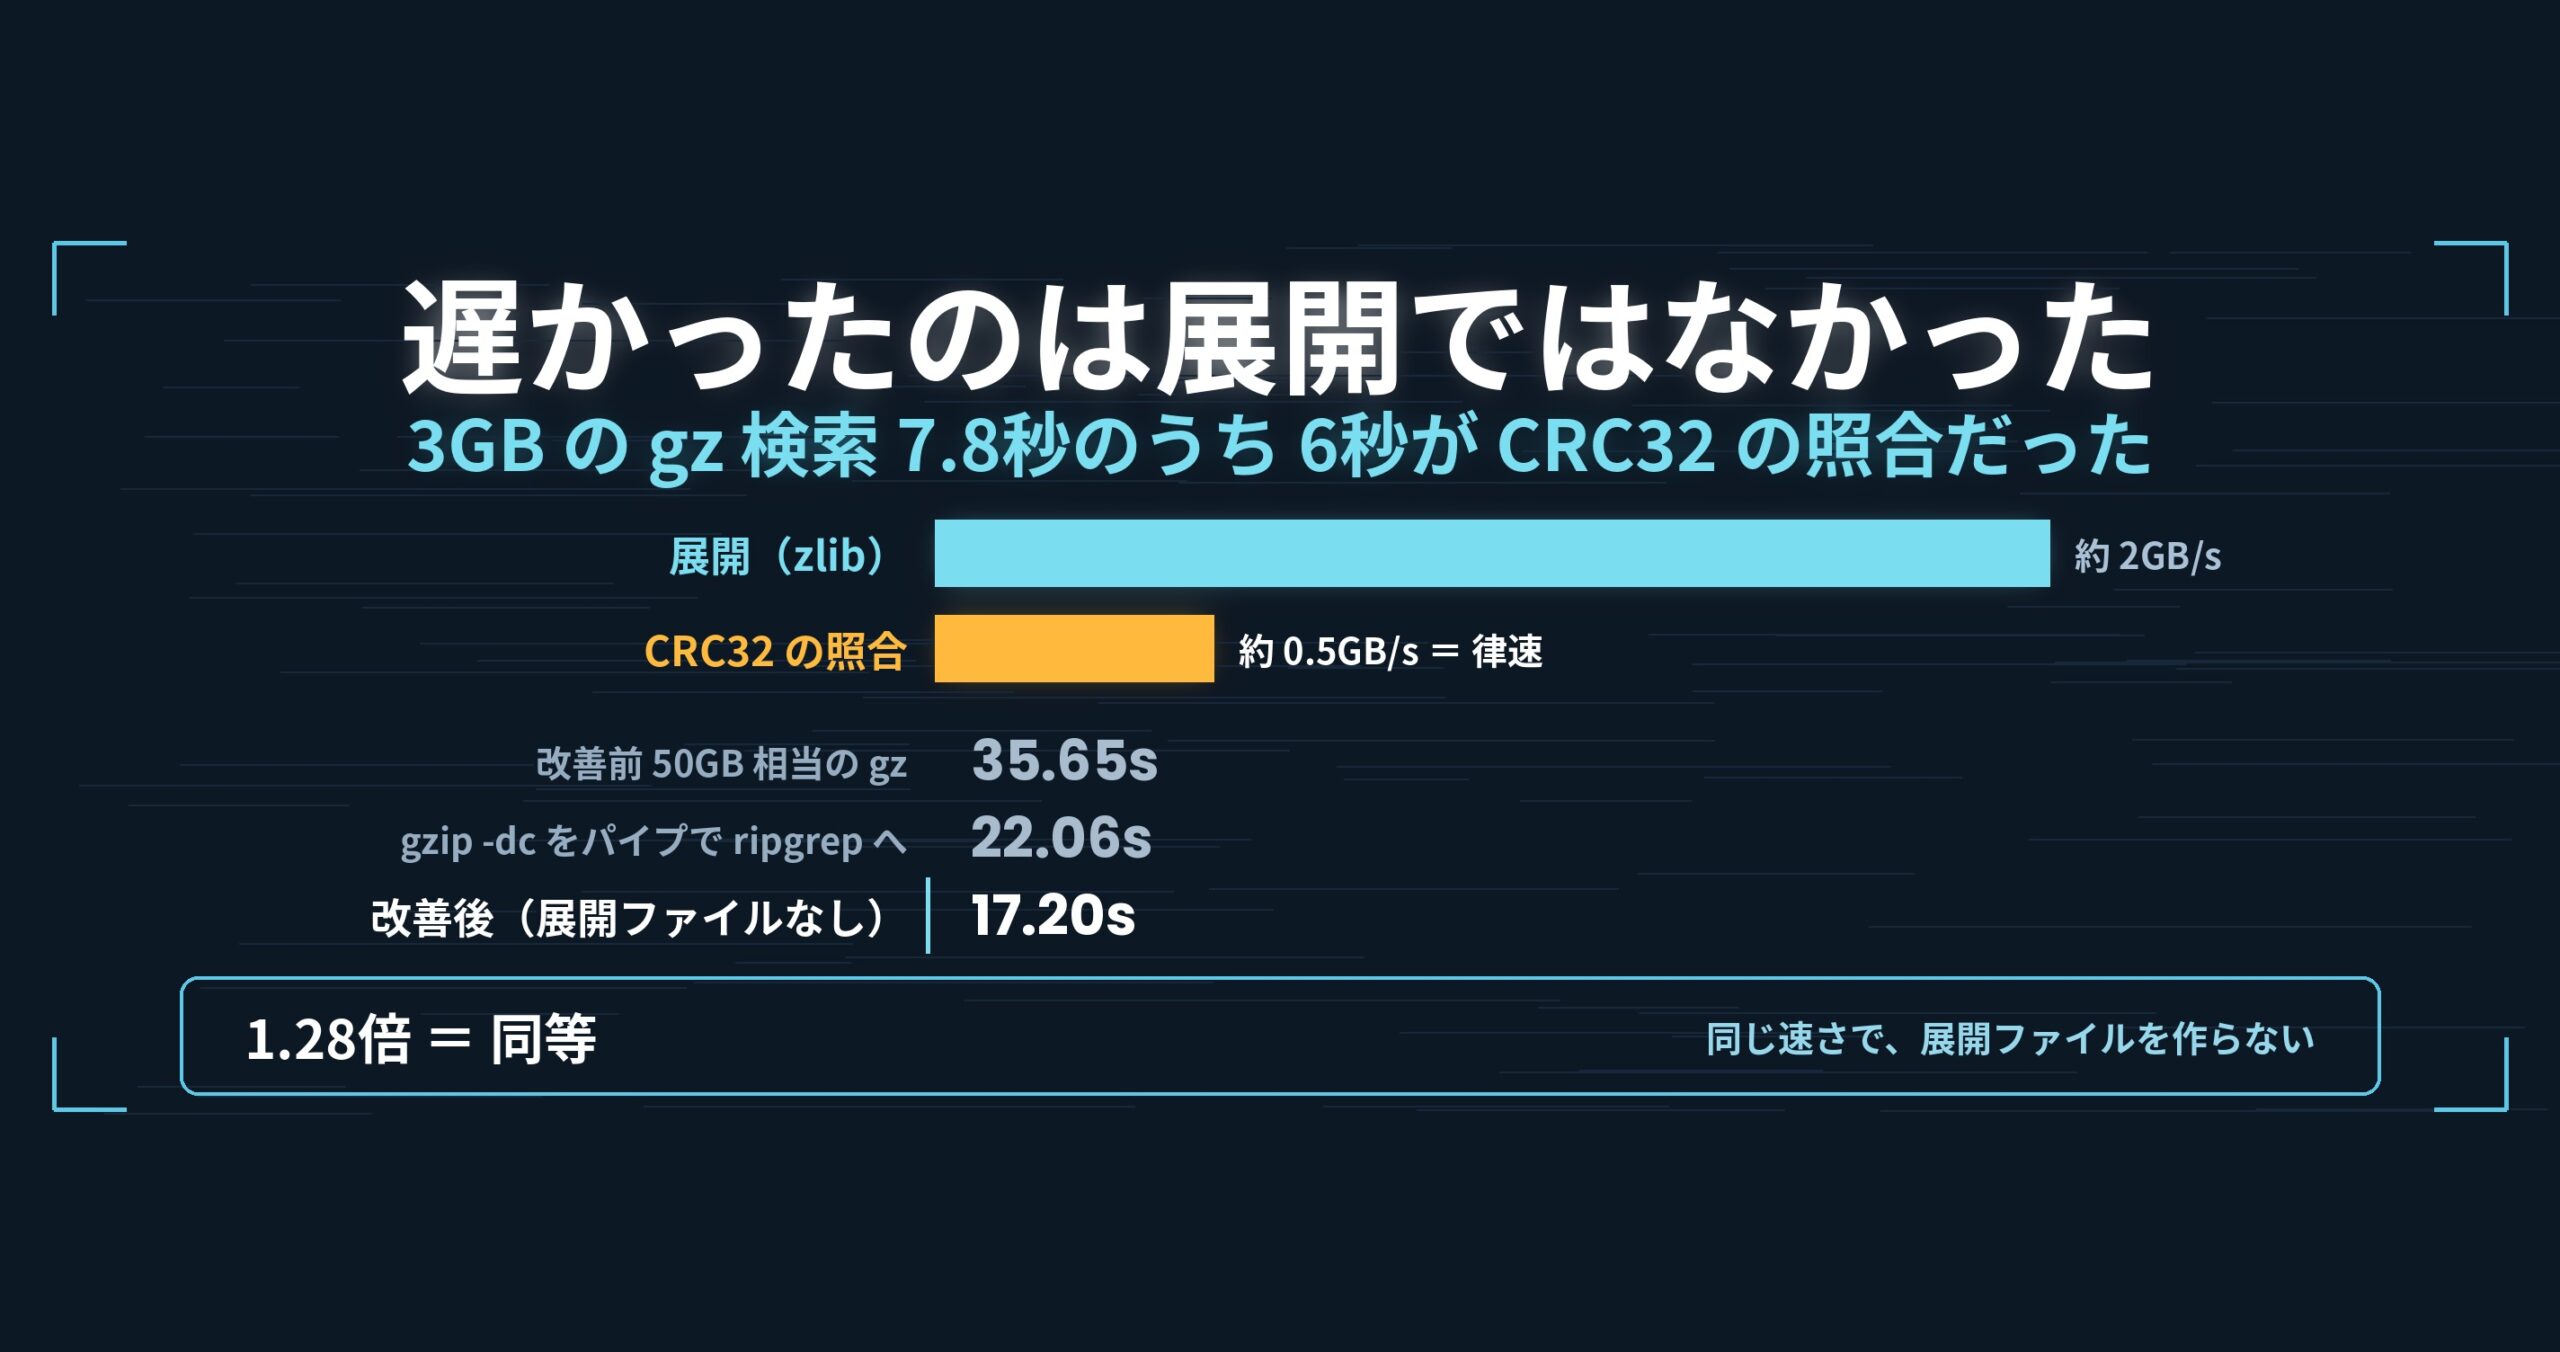
| 50GB | 35.65 秒 | 17.20 秒 | 2.07 倍 |
単項目で 1.5 倍を超えているので、この 3 つはそもそも基準を通ります。それでも倍率が 1.88/1.99/2.07 と揃っていることに意味があります。全バイトに同じ割合でかかっていた工程を削った、という説明と形が合うからです。
(2)対照群が動かない — JIT 設定(本連載の第 7 回)
3GB・メモリに載った状態の 7 項目合計で 11.46 秒 → 7.95 秒。1.44 倍です。単項目の基準 1.5 倍には届きませんが、7 項目の合計なので基準は 1.3 倍で、これは通ります。加えて、同じ機械・同じ時間帯で ripgrep が 7.81 秒から動きませんでした。片方だけが動いて相手が動かないなら、環境が揺れた説明は使えません。
(3)事前予測と実測の一致 — 索引の相乗り
こちらがいちばん気に入っている形です。調査の段階で、50GB の 1 問目の内訳をこう分解していました。
- 索引(
.uwvz)を作る: 58.6 秒 - 作った索引を読んで探し直す: 6.8 秒
- 合計 65.5 秒
そして「作りながら探せれば、この 6.8 秒がそのまま消えるはず」と先に書きました。実装後の実測は 65.7 秒 → 59.04 秒で、減ったのは 6.7 秒。予測 6.8 秒に対して 6.7 秒です。
この一致は、単に速くなったよりずっと強い主張を許します。時間の内訳を正しく理解していたことの証拠になるからです。逆に、もし 3 秒しか減らなかったら、削ったつもりの工程は別のものと重なっていたことになり、そちらを調べ直す必要があります。予測を先に書くと、外れたときにも学べます。
下限を 2 倍から 1.5 倍へ下げた
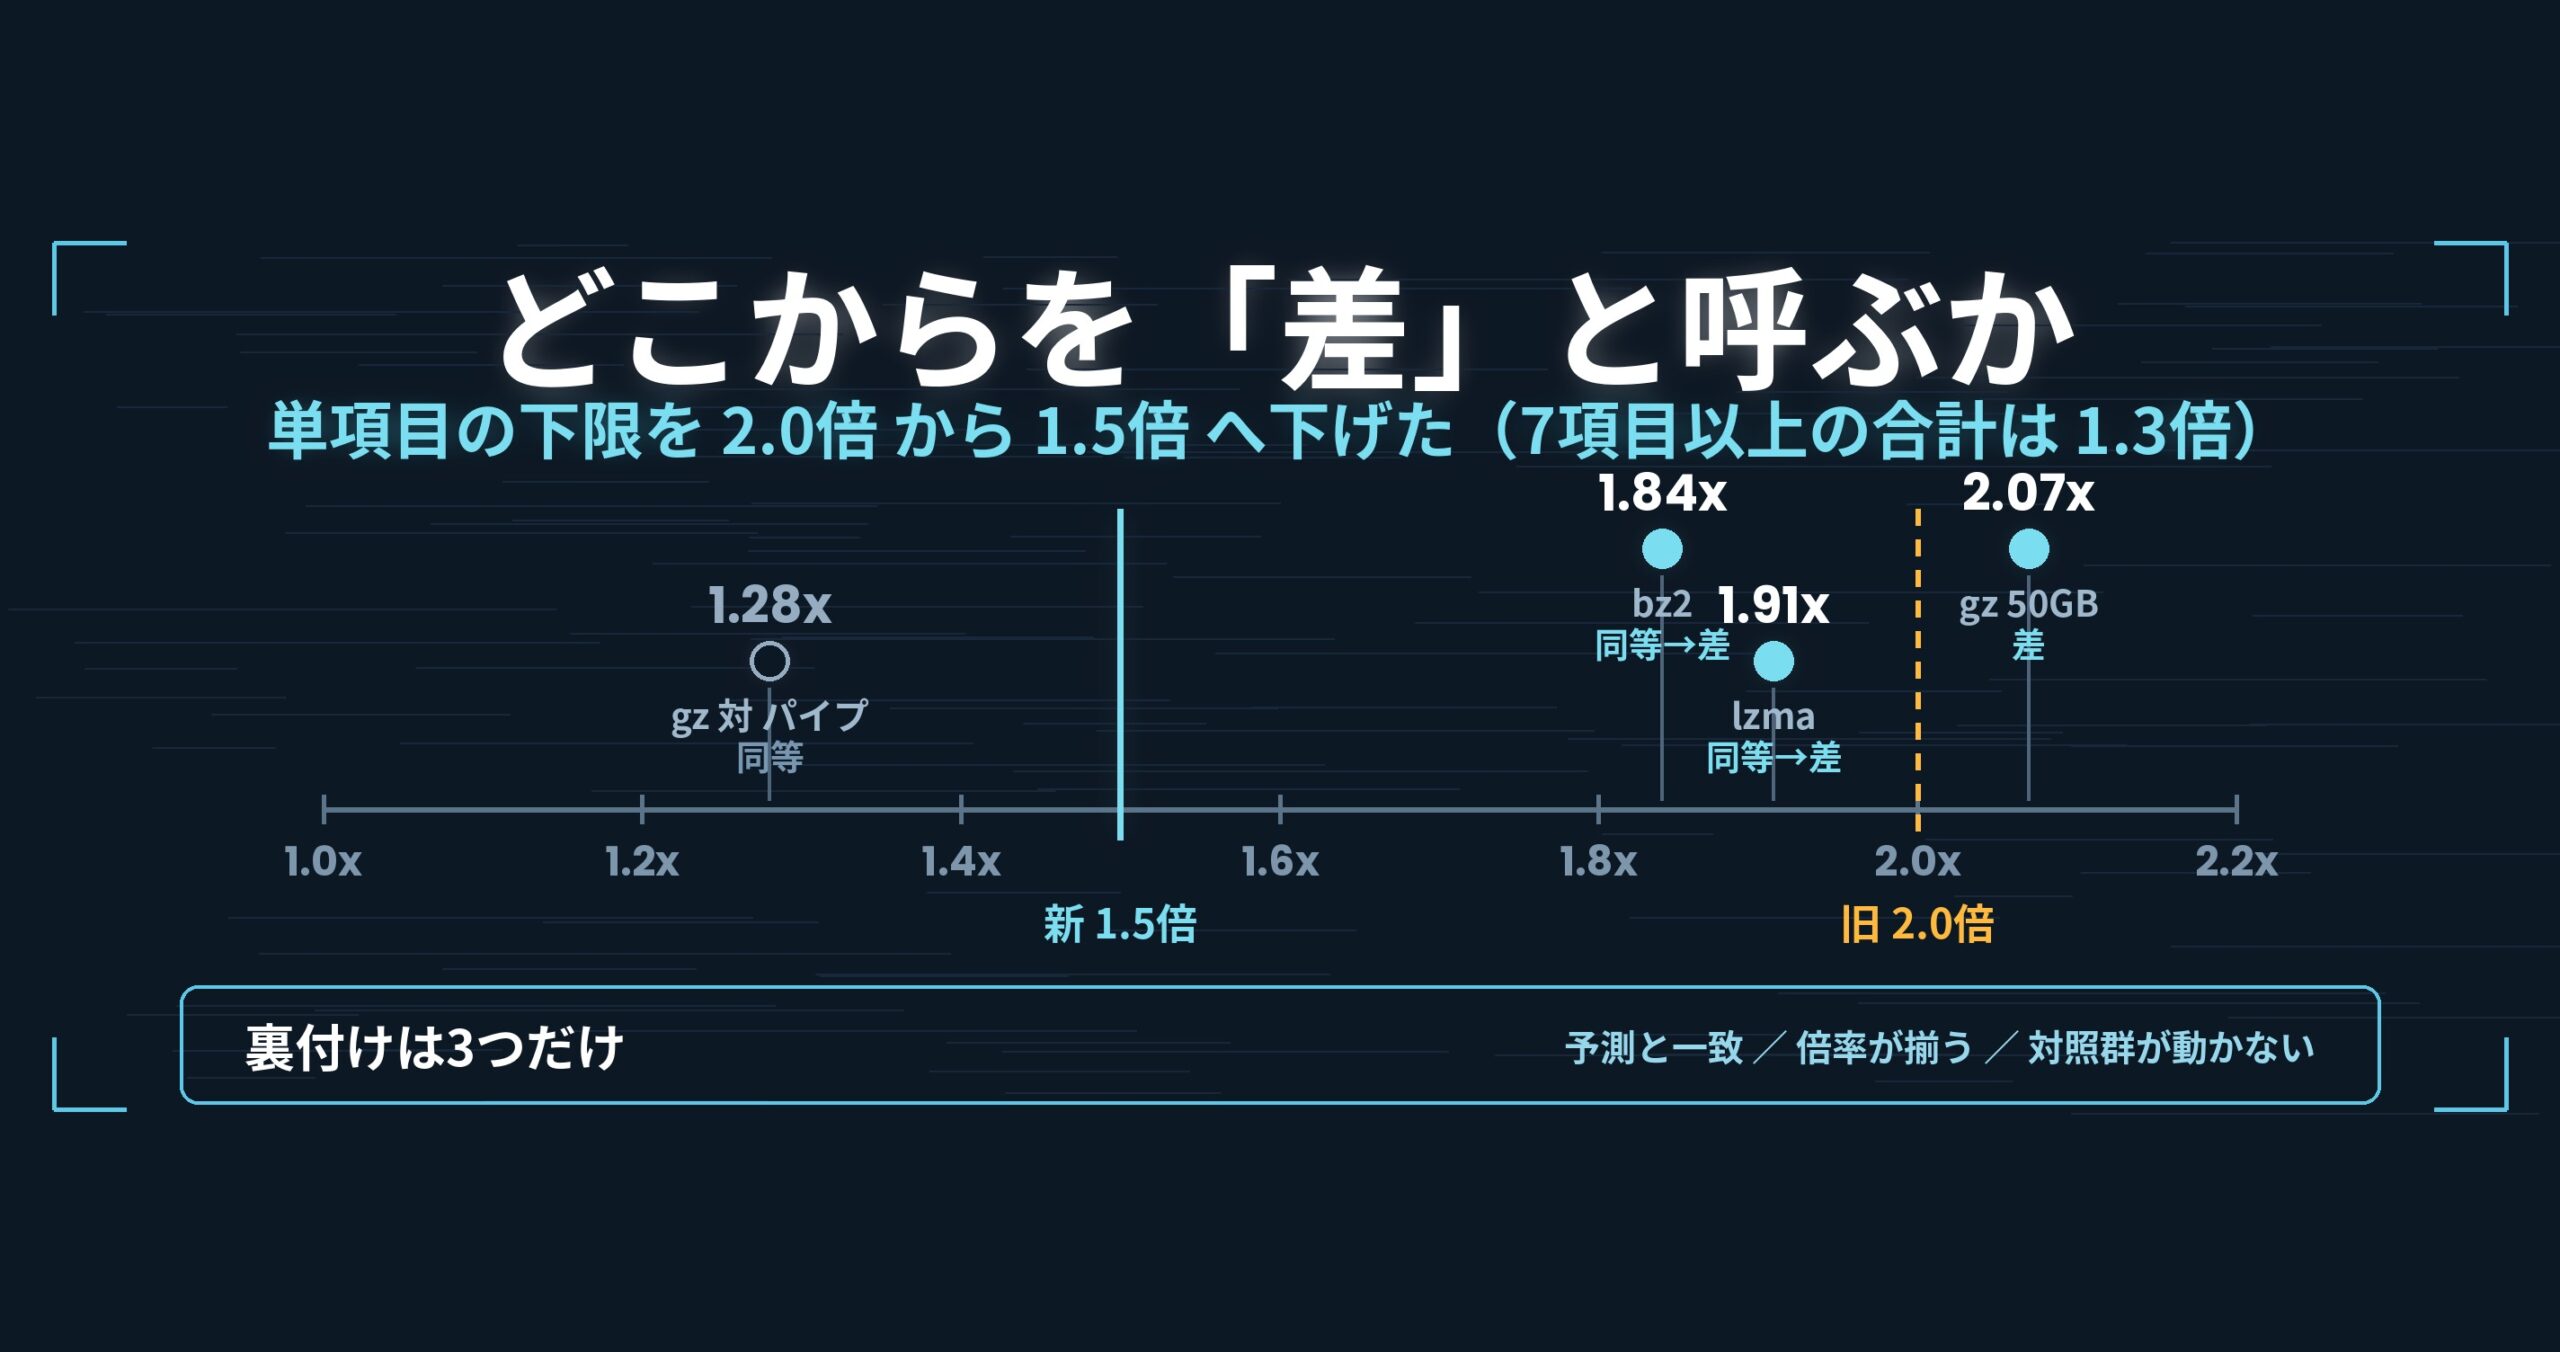
ここまでの基準は、単項目の下限が 2 倍でした。2026-09-25 に 1.5 倍へ下げています。
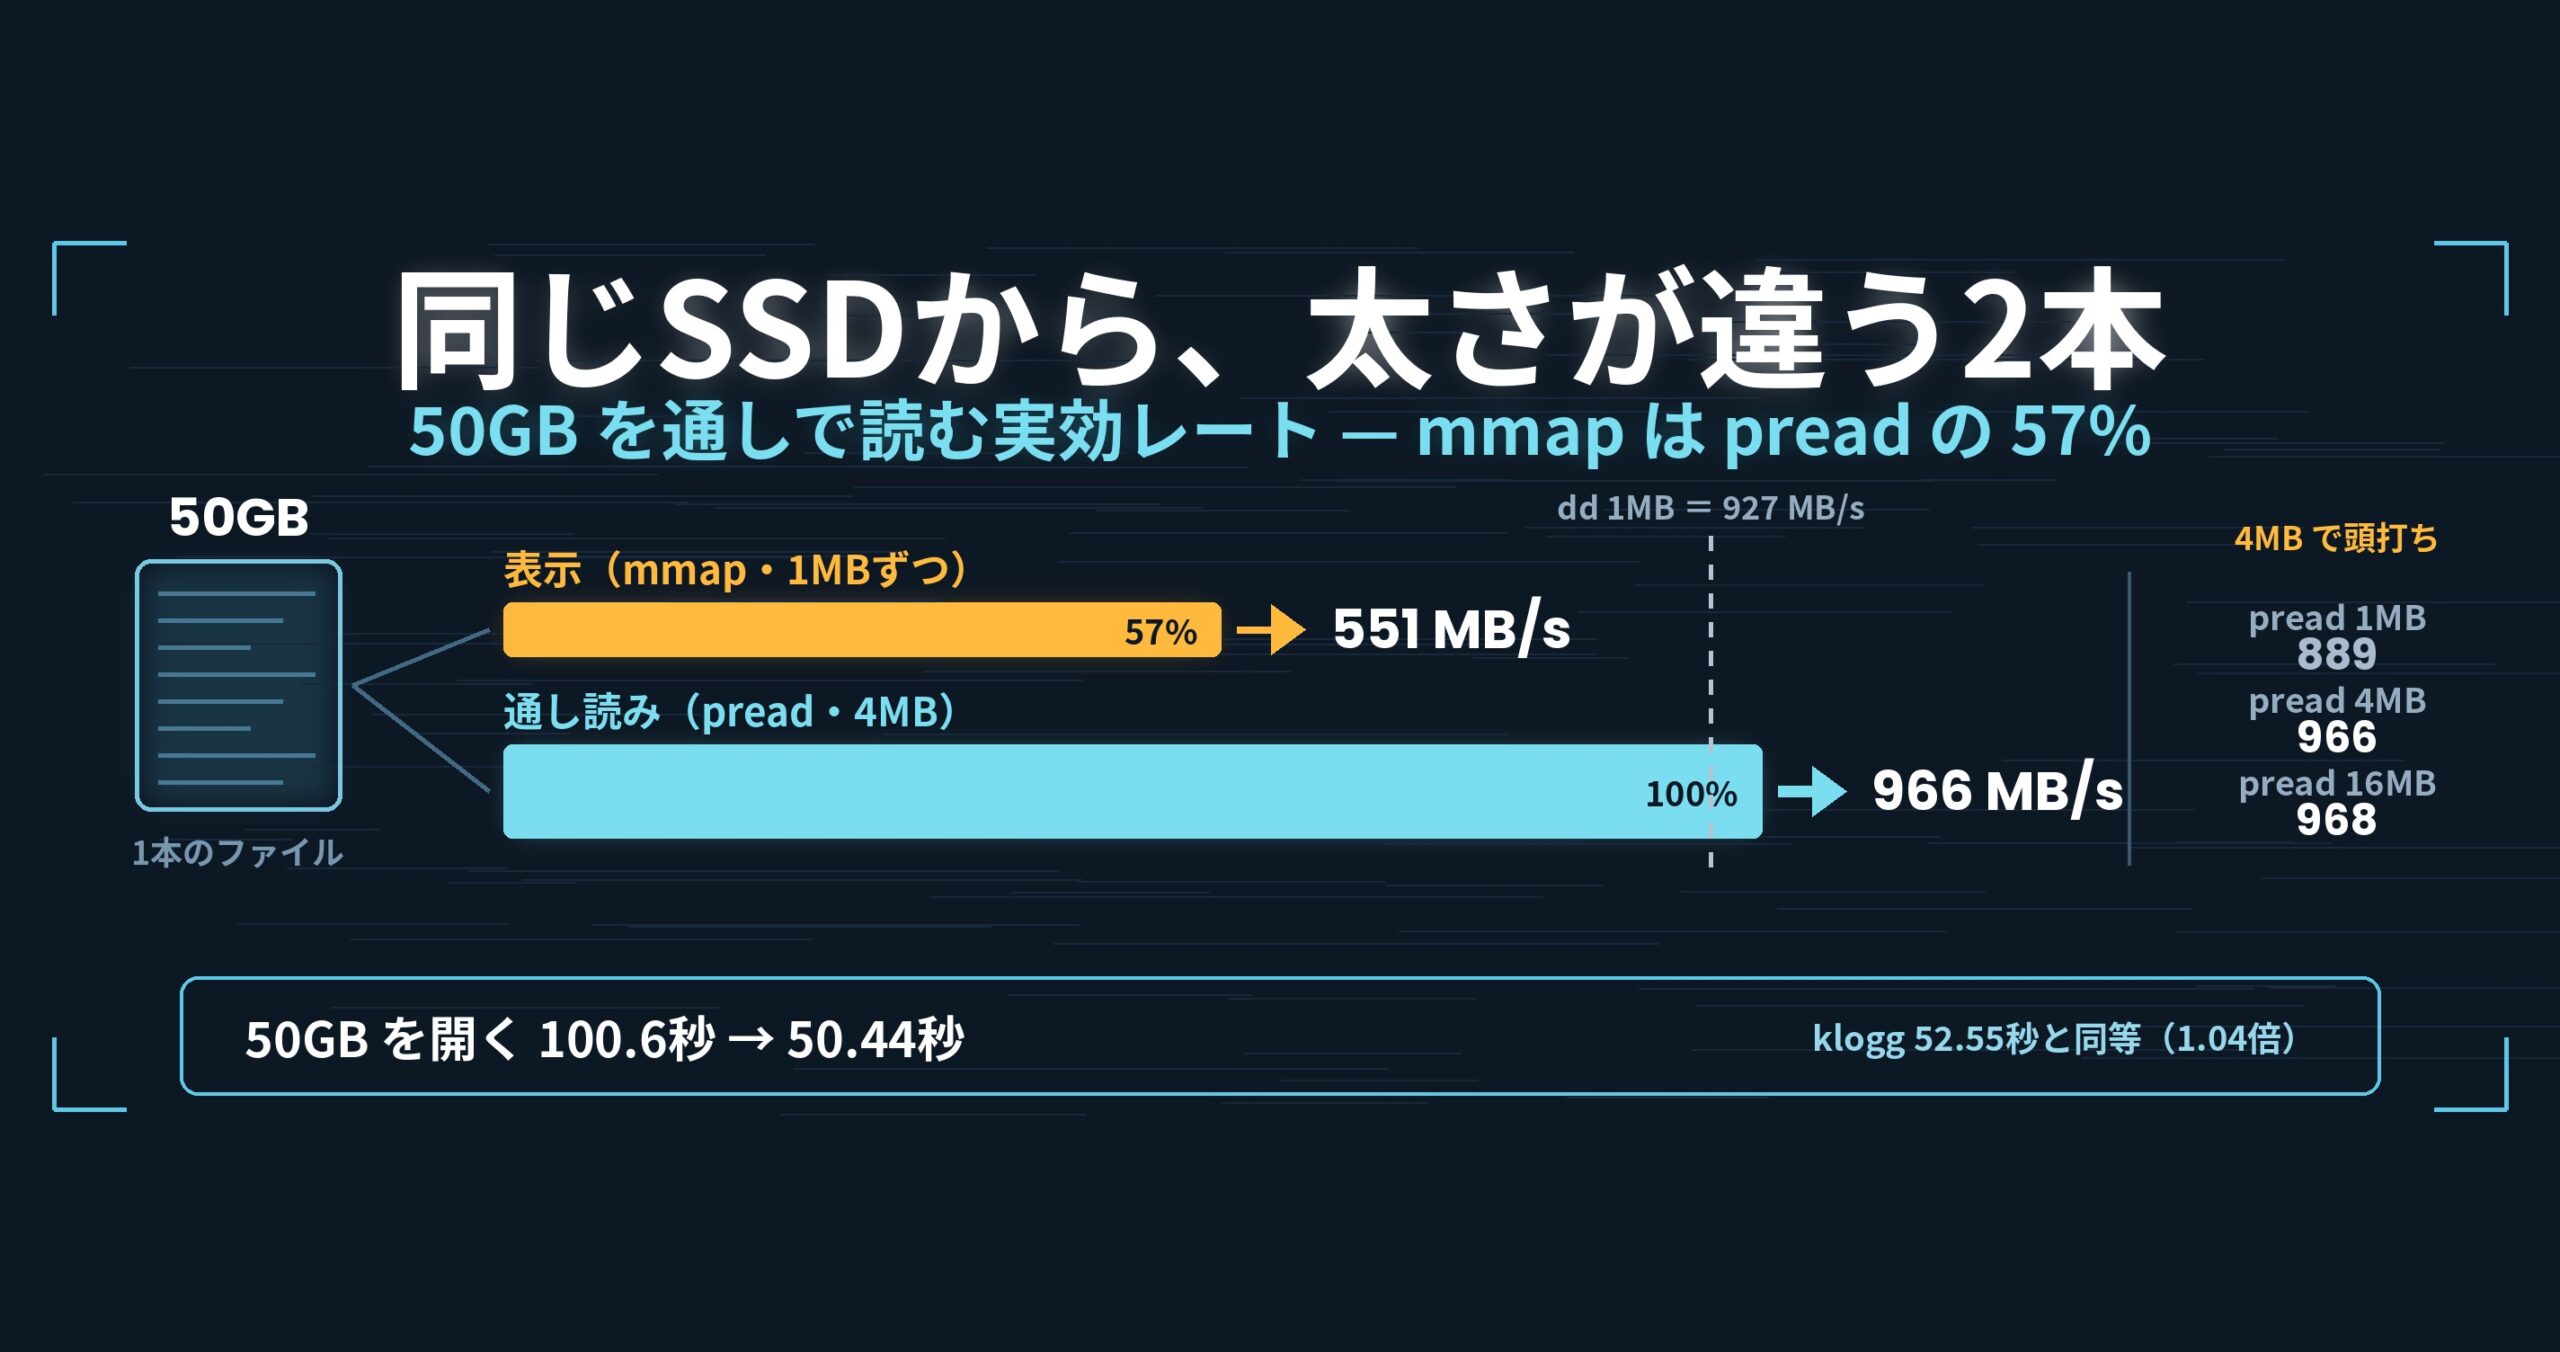
下げた理由は、2 倍が厳しすぎて実在する改善を捨てていたことです。読み出しで律速している処理では、そもそも 2 倍は出ません。媒体の帯域が上限なので、CPU 側をどれだけ速くしても秒数は動かない——第 7 回で uvf が 1.2% しか動かなかった、あの構造です。その世界で「2 倍未満は見ない」と決めると、見るべき対象がほとんど残りません。
下げると何が起きるかも書いておきます。1.5〜2.0 倍の帯が「同等」から「差」に移るので、拾えるものが増える代わりに、誤検出も増えます。1.6 倍くらいは、条件(ディスクの空き、キャッシュの状態)が違えば出てしまう幅です。だから下げた分、3 番の裏付けを求める頻度が上がります。基準を下げることは、裏付けを増やす約束と引き換えです。
自分の書いたものが 6 行ひっくり返った
基準を下げると、過去の判定も動きます。自分たちの圧縮形式の計測データで、「同等」から「差」に変わったのが 6 行(値では 7 か所)ありました。
| 箇所 | 比 | 旧判定(2 倍基準) | 新判定(1.5 倍基準) |
|---|---|---|---|
| bz2 のPro側 | 1.84 倍 | 同等 | 差(こちらが速い) |
| lzma のPro側 | 1.91 倍 | 同等 | 差(こちらが速い) |
| 平文のPro側 | 1/1.51 倍 | 同等 | 差(こちらが遅い) |
| 混在パターンA のPro側 | 1/1.55・1/1.53 倍 | 同等 | 差(こちらが遅い) |
| 混在パターンB の無料版 | 1/1.57 倍 | 同等 | 差(こちらが遅い) |
| 同(別の実行) | 1/1.85 倍 | 同等 | 差(こちらが遅い) |
6 行のうち 4 行は、こちらが負ける側に倒れました。 基準を下げることは、自分に有利な数字を拾う話ではなかったわけです。
さらに、公開していた文書の文言を 2 か所訂正しました。
- 「7 形式すべてで ripgrep の圧縮対応と同等(どれも 2 倍未満)」→ もう書けません。bz2 1.84・lzma 1.91・平文 1/1.51 は、新基準では「差」です
- 「正直表示ルールで読むと全形式が『同等』」→ 同じ理由で訂正しました
訂正のやり方にも決めごとを置きました。計測の表のセルは書き換えません。 当時の測定として残し、文書の冒頭に日付つきで「この基準変更でここがひっくり返る」という一覧を足す形にしています。セルを書き換えると、いつ何を測ってどう判定したかの履歴が消えるからです。数字は記録、判定は解釈——混ぜて保存すると、後から解釈だけを直せなくなります。
環境のほうが基準より先に壊れる
基準を作ってから分かったのは、判定より手前で測定が壊れていることのほうが多いという事実でした。実際に踏んだものを 3 つ書きます。
- ディスクの空き容量で、出力の多い検索だけ 2 倍遅く出た。 除外検索(
-v)は数百万行を書き出すので、空きが少ないと書き込み側が詰まります。検索が遅くなったのではなく、書くのが遅くなっていた。読み出しの比較をしているつもりで、書き込みを測っていたわけです - 10GB の ripgrep のメモリに載った状態の値が、空きメモリ次第で 11 秒にも 3 秒にもなった。 同じコマンド、同じファイル、同じ版です。「hot」と一言で書ける状態ではなく、どのくらいメモリに残っているかという連続量でした。ここを固定しないと、hot の比較は成立しません
- 素読みの帯域を超える数字が出たら、キャッシュを疑ってやり直す。 258GB のファイルで 250.68 秒という値が出たことがあります。媒体の素読みから計算すると、それより速いのはあり得ません。
sudo purgeからやり直したら 265.21 秒でした。物理の上限を超えた数字は、速い証拠ではなく測定ミスの証拠です
この 3 つに共通するのは、基準の話ではないことです。1.5 倍か 2 倍かを議論する前に、その秒数が何を測った秒数なのかを確かめる必要があります。順番としては、環境の固定が先、判定の基準はその後です。
正直に書いておくこと
- 上の基準は自分たちで決めたもので、業界の標準ではありません。統計的な有意差の検定でもありません。分布を取らずに倍率だけで判定しているので、厳密さでは検定に劣ります。測るたびに検定できるほどの実行回数を取れていないのが実情です
- 実行回数が少ない項目があります。件数の非決定性(第 5 回)は 3 回の実行しか記録がありません。3 回で「揺れる」と言うのは弱く、本来は回数を増やすべきところです
- 1.5 倍へ下げたのは 2026-09-25 です。それ以前に公開した記事の文言には、2 倍基準で書いたものが残っています。数字と結論は変えず、基準値の表記だけを揃える形で直しています
- 基準は比についてのものです。絶対値は別で見る必要があります。0.2 秒が 0.1 秒になれば 2 倍ですが、体感は変わりません。逆に 250 秒が 200 秒になるのは 1.25 倍で「同等」ですが、待つ人には大きい違いです
- 秒数を OS またぎで比べていません。Windows・Linux の値は、それぞれの OS の中での比だけを書いています
持ち帰れる一般論: 基準は、結果を見る前にしか作れない
この回に技術的な工夫はありません。それでも連載に入れているのは、残りの回の数字が全部この 1 回に乗っているからです。
要点は 3 つです。
(1)判定の基準は、測定の前に書く。 結果を見てから「これは差と言えるか」を考え始めると、答えは必ず自分の希望に寄ります。悪意は要りません。1.3 倍を見て「効いた」と読む判断と「誤差」と読む判断の両方に理由が付くとき、人は自然に片方を選びます。先に書いた基準だけが、この選択を防げます。
(2)例外の作り方を、例外そのものより先に決める。 「裏付けがあれば例外」では緩すぎます。認める裏付けの種類を列挙して、それ以外を認めない形にすると、例外は使えるのに増えません。今回は「予測一致・倍率の揃い・対照群不動」の 3 つに固定しました。3 つのどれもが、自分の主観を外側に出す性質を持っているのが選んだ理由です。
(3)基準を変えたら、過去の判定を洗い直して、記録は書き換えない。 基準を下げたのに古い判定を放置すると、同じ文書の中で違う基準が並びます。かといって計測表のセルを新基準で書き換えると、当時の測定が消えます。セルは残し、基準変更の日付と反転一覧を追記する——これが両方を守る唯一の形でした。
最後に、この基準がいちばん効いた瞬間について。自分に有利な数字を捨てる場面です。 第 8 回で、gzip と ripgrep をパイプでつないだ形(22.06 秒)に対して 17.20 秒という数字が出ました。1.28 倍です。書きたくなります。でも基準は 1.5 倍なので、書けるのは「並んだ」までです。
この 1 行を守れるかどうかが、他の全部の数字の値段を決めていると思っています。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
自分の環境で測り直すときの形です。同じコマンドを 2 回流して、1 回目と 2 回目を別々に記録するのが最小の作法になります。
# 3章: 1問目(索引を作る)と2問目(索引を使う)を分けて測る
/usr/bin/time -p uvp huge.log 'ERROR' > /dev/null
/usr/bin/time -p uvp huge.log 'ERROR' > /dev/null

# 5章: 出力の量が測定に混ざらないよう、結果はファイルか /dev/null へ
uvp huge.log 'ERROR' -out hits.txt

# 6章: 出力が多い条件(除外検索)は書き込み側が律速することがある
uvp huge.log 'ERROR' -E 'health|ping'

# 6章: 相手と同じ行が出ているかを確かめる(速さより先に)
uvp huge.log 'ERROR' -out mine.txt
rg 'ERROR' huge.log > theirs.txt
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。2 が返った測定値は採用しません(打ち切りが起きた実行の秒数は、完走した秒数と比べられません)。
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 5 回: 同じコマンドで件数が揺れた話: https://uvp.y42u.net/blog/uwview-fl05-deterministic-count/
- 第 6 回: 探した結果を画面に渡して 2 回読みを 1 回に: https://uvp.y42u.net/blog/uwview-fl06-cli-to-gui-handoff/
- 81 項目を ripgrep・sed と 1 行ずつ突き合わせた話: https://uvp.y42u.net/blog/uvp-vs-ripgrep-sed-81-checks/
- 3 つの土俵に分けて 50GB を比べた話: https://uvp.y42u.net/blog/uvp-three-arenas-50gb/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。