【追記 2026-10-16】いまの速さ —
-E -iの2回目は、1/2.7〜1/3.1 の負けから ripgrep より速いに変わりました本文の秒数は v1.7.3.6(2026年9月29日)のものです。同じ Mac(Apple M4・外付け USB SSD)・同じ式で、いまの版 v1.9.0(2026年10月13日)を測りました。
ripgrep ÷ 無料版 uvf(2回目・キャッシュに乗った状態)本文(v1.7.3.6) いま(v1.9.0) 3GB -E -i 'K="NAME[^"]*"'0.58秒 対 1.55秒(1/2.67・負け) 0.56秒 対 0.48秒(1.17倍) 10GB 同じ式 1.78秒 対 5.44秒(1/3.06・負け) 1.75秒 対 1.38秒(1.27倍) 1回目+2回目の合計でも、3GB で 1.08倍(同等)です。索引を持つ
uvpなら、同じ式が 3GB で ripgrep の 4.97倍です。下の本文の「負け」は、当時の記録として残します。詳しくはベンチマークとv1.9.0「Full Spectrum」の記事。
件数が変わりました。
[[:alpha:]] は書けないので \p{L} に直してください——そう案内したのです。言われたとおりに書き換えた手元で、当たる行の数が変わります。
書き換え先は、本当に同じものを探しているのでしょうか。
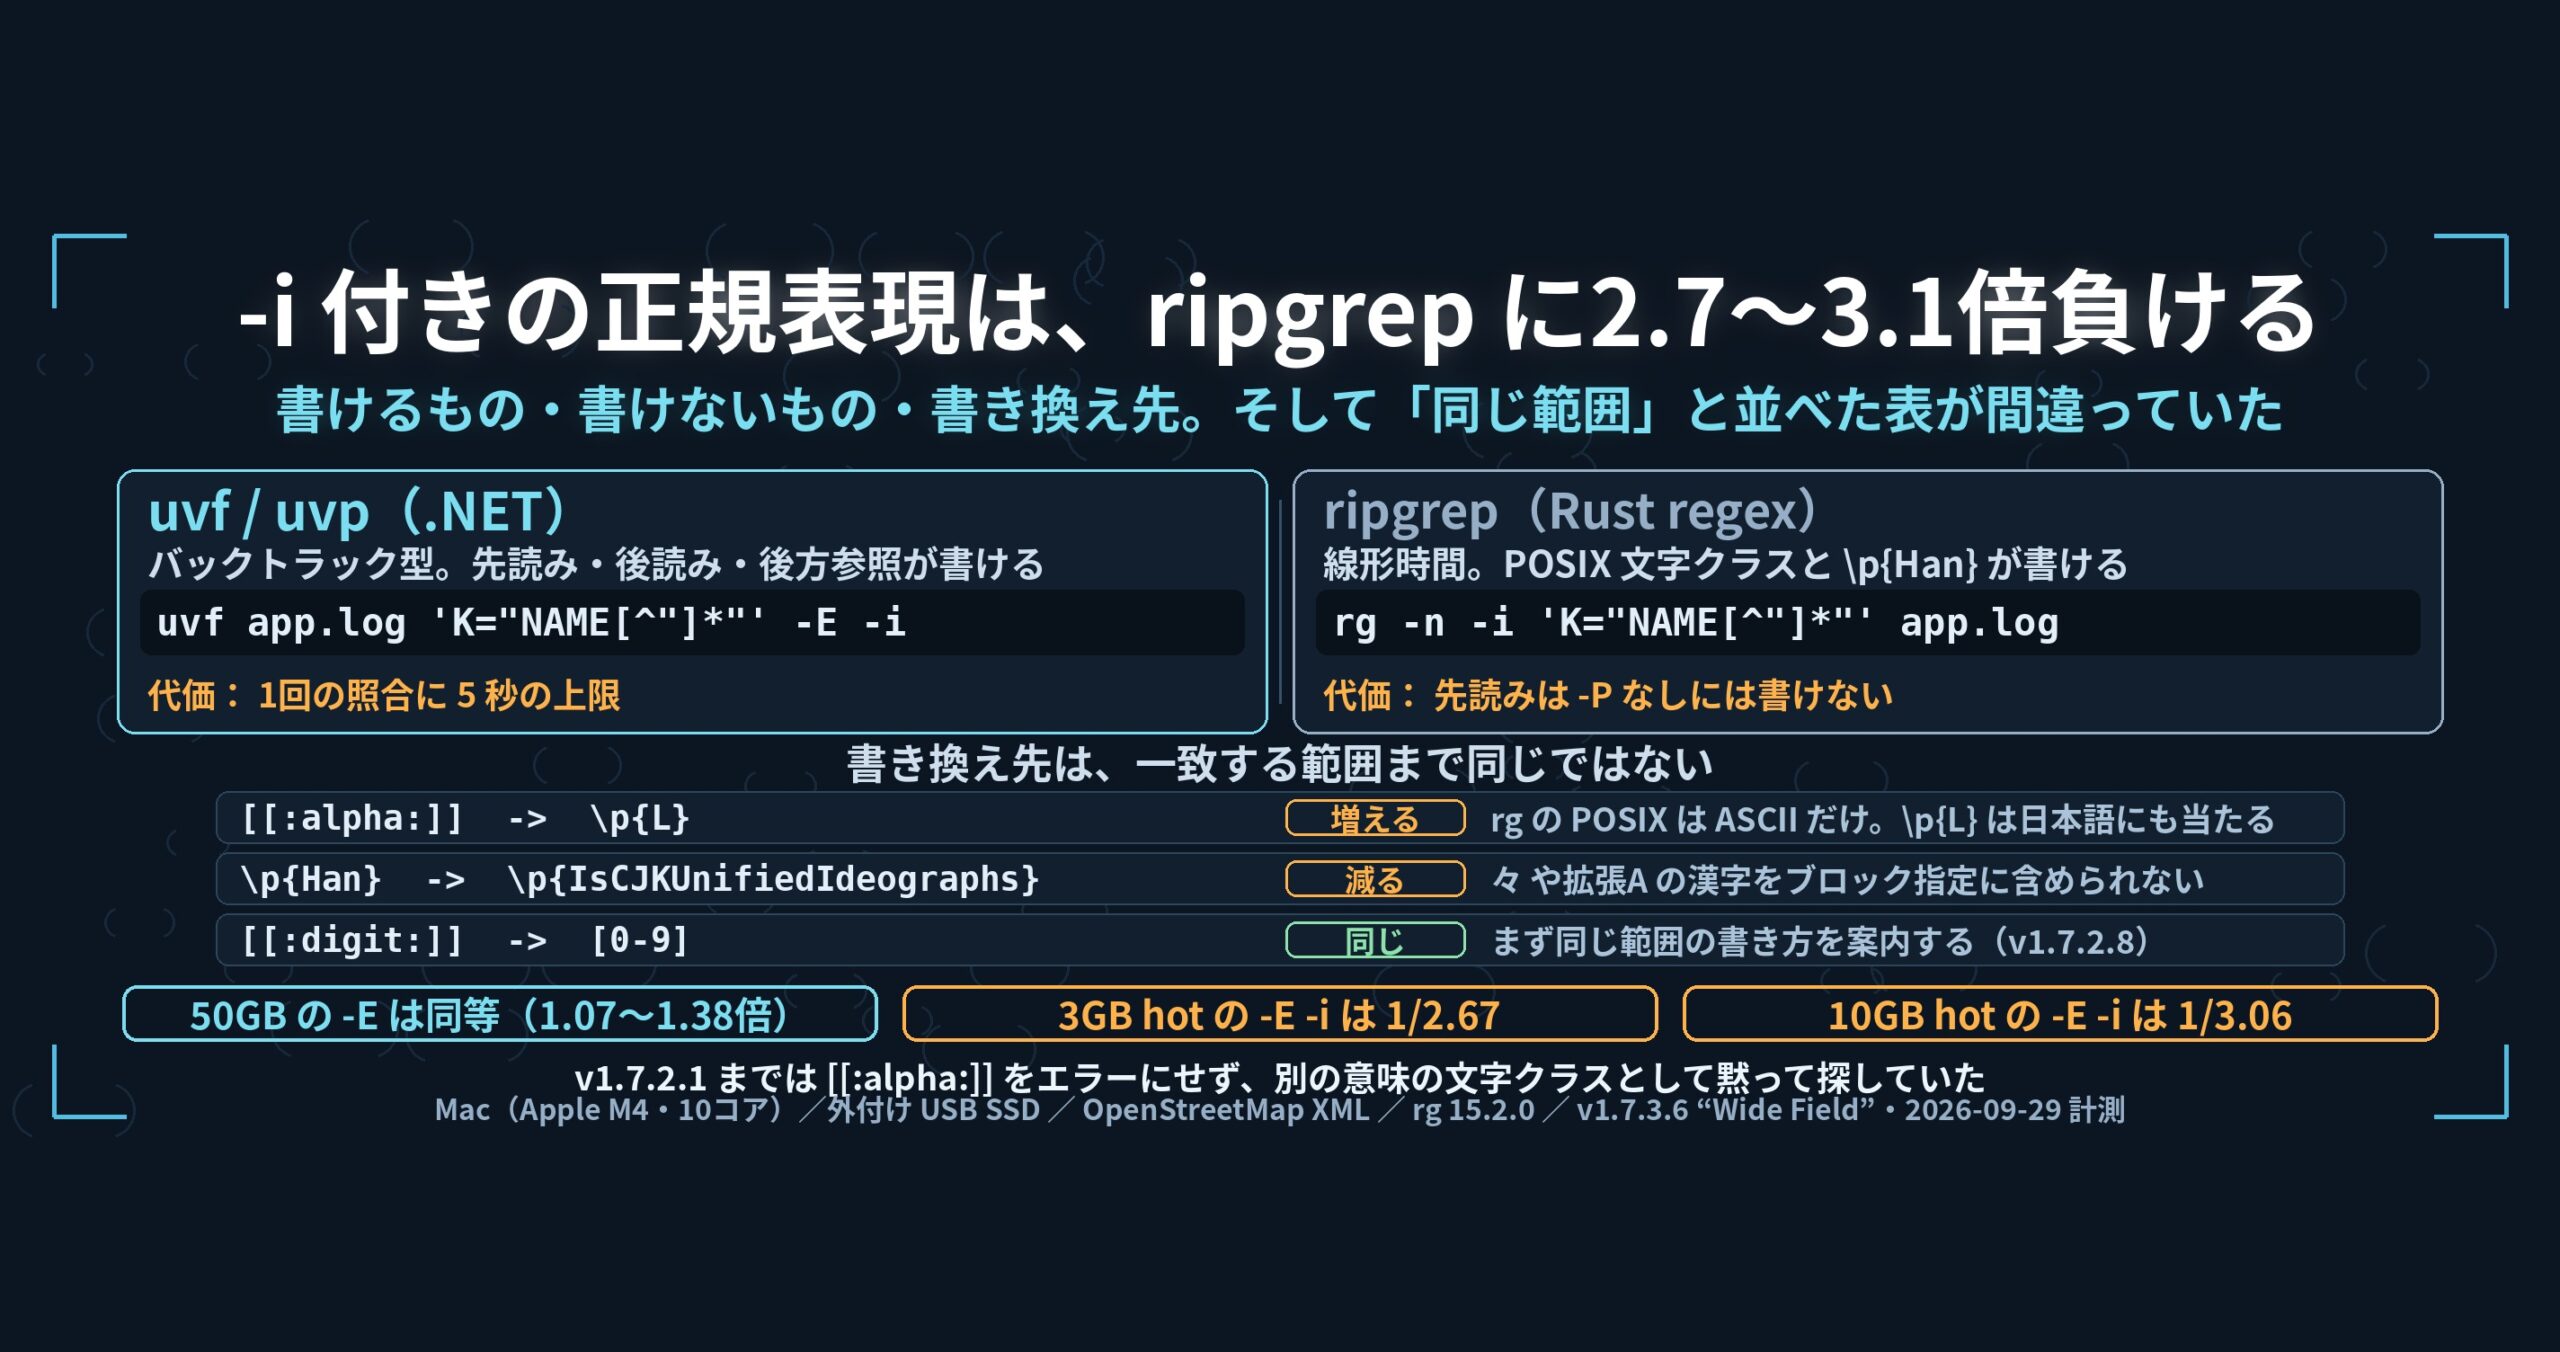
- 先に結論: -E の正規表現は .NET のものなので、ripgrep と書けるものが違う。先読みと後方参照はこちらで書けて ripgrep では書けず、POSIX 文字クラスと \p{Han} はこちらで書けない。書き換え先は一致範囲まで同じではないので、案内を2つの表に分けた。速さは 50GB では ripgrep と同等だが、キャッシュに乗った 3GB・10GB の -E -i では 1.55秒 対 0.58秒(2.67倍)・5.44秒 対 1.78秒(3.06倍)で負けます
- 先に、負けているところを書きます
- 既定が逆、というところから違います
- ripgrep に無くて、こちらにあるもの
- こちらに無いもの——黙って別の意味で探していました
- 書き換え先は、一致する範囲まで同じではありません
- 数字——50GBでは同等、キャッシュに乗ると負ける
- 正規表現をコンパイルできなくなった版がありました
- 確かめ方
- 持ち帰れる一般論
- 正直に書いておくこと
- 使っている道具
- リンク
先に結論: -E の正規表現は .NET のものなので、ripgrep と書けるものが違う。先読みと後方参照はこちらで書けて ripgrep では書けず、POSIX 文字クラスと \p{Han} はこちらで書けない。書き換え先は一致範囲まで同じではないので、案内を2つの表に分けた。速さは 50GB では ripgrep と同等だが、キャッシュに乗った 3GB・10GB の -E -i では 1.55秒 対 0.58秒(2.67倍)・5.44秒 対 1.78秒(3.06倍)で負けます
uvf・uvp の既定は正規表現ではなく文字列そのままで、-E を付けたときだけ正規表現になります(ripgrep は逆で、既定が正規表現・-F で文字列)。Mac(Apple M4・10コア)・メモリ32GB・外付け USB SSD・OpenStreetMap の XML。
uvf・uvpは私が作っている UwView(v1.7.3.6 “Wide Field”・2026年9月28日公開)の検索コマンドです。uvfは無料版、uvpは有料版 UwView Pro のものです。書き換え先の案内と(?P<名前>)の読み替えは v1.7.2.2、案内を2つの表に分けたのは v1.7.2.8 で入れ、秒数は2026年9月29日の v1.7.3.6 統合テストの値です。
先に、負けているところを書きます
- キャッシュに乗った状態の
-E -iが遅い。-iを付けない正規表現なら ripgrep と同等ですが、-iを足すとuvf側だけ時間が伸びます。3GB で 1.55秒 対 0.58秒(2.67倍)、10GB で 5.44秒 対 1.78秒(3.06倍)。50GB では同等になりますが、それは媒体が律速になって CPU の差が見えなくなるからで、速くなったわけではありません。 - 1回の照合に5秒の上限があります。 超えると「正規表現の処理に時間がかかりすぎました」で止まります。ripgrep の正規表現は線形時間なので、こうした上限がそもそも要りません。上限が必要なのは、こちらがバックトラック型のエンジンを使っているからです。
- POSIX 文字クラス(
[[:alpha:]]など)が書けません。 v1.7.2.1 までは、エラーにもならず別の意味の文字クラスとして黙って探していました。 - 用字名(
\p{Han}・\p{Hiragana})が書けません。 書き換え先はありますが、一致する範囲が同じではありません(後述)。 - 複数行にまたがる検索ができません。 照合は1行ずつです。
- 展開が必要な経路では、1行の先頭64KBまでで判定します。 長い1行の後ろは見ていません。
-E -iが遅い原因を、切り分けた計測は持っていません。 設計上の説明(次節)はできますが、どの処理に何秒使っているかの内訳は測っていません。
既定が逆、というところから違います
ripgrep の既定は正規表現で、文字列として探したいときに -F を付けます。uvf・uvp は逆で、既定は文字列そのまま、正規表現にしたいときに -E を付けます。
rg -n 'k="highway[^"]*"' app.log      # 既定で正規表現
rg -n -F 'ERROR' app.log              # 文字列として

uvf app.log 'ERROR'                   # 既定で文字列
uvf app.log 'k="highway[^"]*"' -E     # 正規表現として
この向きにした理由は速さです。ログを探す人が打つ語の多くは ERROR のような素の文字列で、そのとき正規表現のエンジンに通す必要はありません。既定を文字列にしておけば、-E を付けなかったコマンドは全部バイト列の照合で済みます。
ただし、既定が逆だということ自体が差です。ripgrep のつもりで uvf app.log 'ERROR|WARN' と打つと、縦棒を含む文字列を探しに行きます。
ripgrep に無くて、こちらにあるもの
.NET の正規表現はバックトラック型なので、ripgrep の既定のエンジンでは書けないものが書けます。
| 書き方 | uvf・uvp(.NET) |
ripgrep(Rust regex) |
|---|---|---|
先読み (?=…) (?!…) |
使える | -P を付けないと使えない |
後読み (?<=…) (?<!…) |
使える | -P を付けないと使えない |
後方参照 \1 \k<名前> |
使える | -P を付けないと使えない |
文字クラスの差 [a-z-[aeiou]] |
使える(.NET 独自の書き方) | [a-z&&[^aeiou]] と書く |
独占的量指定子 a*+ |
使えない((?>…) で書く) |
使えない |
「ERROR を含むが ERROR_IGNORED ではない行」のような条件を、1つの式で書けるのはこちら側です。**そして、そのために5秒の上限を背負っています。**バックトラック型は書き方しだいで時間が爆発するので、止める仕組みが要る。線形時間のエンジンは爆発しないので上限が要らない。どちらが優れているという話ではなく、取り引きの向きが違うだけです。
名前付きグループは、書き方が違うだけで両方使えます。.NET は (?<名前>…)、ripgrep は (?P<名前>…) も (?<名前>…) も通ります。ripgrep から持ってきた式がそのまま動くほうがよいので、v1.7.2.2 で (?P<名前> を (?<名前> と同じ意味に読み替えるようにしました。費用はほぼ無く、移ってくる人の手間だけが減ります。
こちらに無いもの——黙って別の意味で探していました
逆方向です。
| 書き方 | uvf・uvp(.NET) |
ripgrep |
|---|---|---|
POSIX 文字クラス [[:alpha:]] |
書けない | 使える |
用字 \p{Han} \p{Hiragana} |
書けない | 使える |
Unicode の文字種 \p{L} \p{Lu} |
使える | 使える |
\d の範囲 |
全角数字(0〜9)にも当たる | 同じ |
いちばん悪かったのは1行目です。[[:alpha:]] は .NET でも構文としては通ってしまう。[・:・a・l・p・h・] のいずれか1文字、という別の意味の文字クラスとして解釈され、エラーも出ないまま探し始めます。
つまり **0件になるのではなく、間違った件数が返っていました。**止まってくれるほうがよほどましです。
そこで v1.7.2.2 で、[[: を見つけたら探し始める前にエラーにし、書き換え先を添えて終了コード2で終わるようにしました。\p{Han} のような用字名も、.NET 側のエラーを受けて書き換え先を案内します。
書き換え先は、一致する範囲まで同じではありません
ここが、この回でいちばん書きたかったところです。自社に都合の悪い話なので、独立した見出しにします。
外部レビューで指摘されました。**「ripgrep と同じ範囲」として並べた表に、同じではないものが混ざっている。**実物で確かめたら、指摘のとおりでした。
- ripgrep の
[[:alpha:]]は ASCII の英字だけに当たります。\p{L}は日本語にも当たります。つまり[[:alpha:]]→\p{L}の書き換えは、当たる行を増やします - .NET の
\dは全角数字にも当たります。[0-9]のつもりで書くと、全角の並びも拾います \p{Han}→\p{IsCJKUnifiedIdeographs}の書き換えは、々 や 㐀 に当たりません。前者はブロックではなく用字の指定なので、ブロック指定では含められない文字が残ります
なので v1.7.2.6 と v1.7.2.8 で、案内を2つの表に分けました。
- 同じ範囲になる書き方を先に出す(
[[:alpha:]]→[A-Za-z]、[[:digit:]]→[0-9]) - そのうえで、日本語も含めたいときの書き方を別の表で添える(
\p{L}・\p{IsCJKUnifiedIdeographs})
エラーの文面も、マニュアルも、--help regex の文面も同じ順にそろえました。「拡張Bは書けません」という言い方も、**「このブロック指定では含められません」**に直しています。書けないのはブロック指定の限界であって、文字そのものが扱えないわけではないからです。
**「書き換えてください」と案内するなら、書き換えた結果が同じかどうかまで言う責任がある。**ここを曖昧にすると、こちらは親切なつもりで読者の件数を黙って変えることになります。
数字——50GBでは同等、キャッシュに乗ると負ける
2026年9月29日の v1.7.3.6 統合テストから、-E を使う4項目を抜きます。キャッシュを捨てて10秒待ってから cold、続けて hot。相手は ripgrep 15.2.0。
50GB(47.73GiB・51,254,526,392バイト)
| 項目 | ripgrep cold/hot | uvf cold/hot |
uvp cold/hot |
|---|---|---|---|
-E 'k="highway[^"]*"' |
57.05 / 56.01 | 51.26 / 52.21(同等) | 15.53 / 14.73(3.67倍 / 3.80倍) |
-E '^ *<tag k="name"' |
56.43 / 56.59 | 51.69 / 50.76(同等) | 7.07 / 6.12(7.98倍 / 9.25倍) |
-E -i 'K="NAME[^"]*"' |
55.88 / 64.37 | 50.94 / 50.95(同等) | 11.53 / 10.62(4.85倍 / 6.06倍) |
-E -v '^ +<' |
74.22 / 57.65 | 53.85 / 54.50(同等) | 12.97 / 12.23(5.72倍 / 4.71倍) |
※ファイル容量の表記について:本記事の「50GB」は 47.73GiB(バイト÷1024³)のファイルです。macOS の容量表示(SI・÷1000³)では 51.25GB と表示されます。過去記事では同じファイルを「48GB」と書いています。いずれも同一ファイル(51,254,526,392バイト)です。
uvf はどの項目も1.07〜1.38倍で、**1.5倍未満なので「差」とは呼びません。**この大きさでは媒体の素読み速度(この機械では約950MB/s)が律速になり、どちらも同じ壁に当たっています。uvp が3.67〜9.25倍になるのは、2回目以降は .uwvz(uvp 用の圧縮形式+索引)を読んでいて、読む量そのものが違うからです。
3GB・10GB——-i を足したときだけ負ける
| 項目(hot) | ripgrep | uvf |
倍率 |
|---|---|---|---|
3GB -E 'k="highway[^"]*"' |
0.52 | 0.56 | 同等 |
3GB -E -i 'K="NAME[^"]*"' |
0.58 | 1.55 | 1/2.67(負け) |
10GB -E 'k="highway[^"]*"' |
1.07 | 1.42 | 1/1.33(同等) |
10GB -E -i 'K="NAME[^"]*"' |
1.78 | 5.44 | 1/3.06(負け) |
2つのサイズで向きと大きさがそろっているので、外乱ではないと見ています。
設計からの説明はこうです。-i を付けただけの文字列検索は、First Light の第3回で書いたとおりバイトのまま畳んで比べています。ところが -E -i では .NET の正規表現エンジンに IgnoreCase を渡す形になり、**バイトのまま畳む経路を通りません。**1文字ずつ大文字小文字を畳みながら照合する分だけ時間が伸びる、という筋です。
**ただし、これは設計から言っているだけです。**内訳を切り出して測ってはいません。50GB で同等に見えるのも「速くなった」のではなく「媒体に隠れた」だけで、SSD が今より速くなれば、この負けは 50GB でも見えるようになります。
正規表現をコンパイルできなくなった版がありました
経緯として書いておきます。いまの版の話ではありません。
Wide Field の途中、1.7.1.4 から Mac の CLI を NativeAOT(事前コンパイル)で作るようにしました。起動が 0.30秒から 0.01秒になる、という効き目のある変更です。
ところが NativeAOT は実行時にコードを作れません。つまり正規表現をコンパイルできず、解釈実行になります。
-E -v '^ +<'(3GB・hot)で測った経緯の値です。
- v1.6.6.1: 2.85秒
- 1.7.1.6(NativeAOT・退行していた版): 5.56秒
- 1.7.1.7(直した版): 2.75秒
2.02倍の退行でした。いまの v1.7.3.6 の同じ項目は 2.78秒(上の表の 3GB -E -v の hot)で、1.7.1.7 の値とそろっています。
遅くなったのは必須の文字列で候補行を絞れない正規表現だけでした。^ +< は必須の文字が < 1文字で、ほぼ全行に当たってしまう。逆に k="highway… や ^ *<tag k="name" は先に絞れるので当たる行が少なく、NativeAOT のほうがむしろ少し速かったのです。
直し方は、分岐を1つ置くことでした。「正規表現で」「必須の文字列で絞れず」「入力が256MB以上」のときだけ、JIT で動く本体に任せる(起動が約0.1秒上乗せになる)。それ以外は NativeAOT のまま 0.01秒を保つ。NonBacktracking エンジンも試しましたが速くなりませんでした(書き方によってはむしろ遅い)。
必須リテラルをどう取り出しているかは First Light の第4回に書きました。**同じ仕組みが、2つの回で別の形で効いています。**1つは正規表現を固定文字列と同じ速さにするために、もう1つは「どちらのエンジンに任せるか」を決めるために。
確かめ方
- 相手: ripgrep 15.2.0(
-Pを付けない既定のエンジンで比べています) - 版:
uvf・uvpとも v1.7.3.6 “Wide Field”。書き換え先の案内は v1.7.2.2・v1.7.2.6・v1.7.2.8、NativeAOT の分岐は 1.7.1.7 - 秒数: 2026年9月29日の v1.7.3.6 統合テスト(全体テスト・各測定は
sync→ キャッシュ破棄 → 10秒待機 → cold → 続けて hot) - データ: OpenStreetMap の XML(3GB=3,032,812,644バイト/10GB/50GB=51,254,526,392バイト)
- 機械: Mac(Apple M4・10コア・メモリ32GB)/外付け USB SSD
- 比較の正本: 書けるもの・書けないものの表は
uvf --help regexとマニュアルに同じ内容で入っています - **OS をまたいだ秒数の比較はしていません。**この記事の数字はすべて Mac のものです
持ち帰れる一般論
(1)「同じにした」と言う前に、一致範囲を確かめる。 書き方の対応表は作りやすく、だから危ない。[[:alpha:]] → \p{L} は綴りの置き換えとしては正しくても、当たる行が増えます。対応表を配る側は、対応が「書ける/書けない」の話なのか「同じ結果になる」話なのかを、表の時点で分けておく必要があります。
(2)黙って別の意味で動くのが、いちばん悪い。 [[:alpha:]] がエラーにならずに通っていたとき、利用者には何も起きていないように見えます。0件なら疑いますが、間違った件数は疑われません。構文として通ってしまう誤りは、通らない誤りよりコストが高い。
(3)エンジンの型が、機能と上限の両方を決める。 バックトラック型だから先読みと後方参照が書け、バックトラック型だから5秒の上限が要る。線形時間だから上限が要らず、線形時間だから先読みが書けない。片方だけを真似ることはできません。
(4)事前コンパイルは、実行時にコードを作る仕組みを道連れにする。 起動 0.30秒 → 0.01秒 は小さいファイルでは大きな勝ちですが、その代償が正規表現の解釈実行でした。**勝ちと負けが別の項目に出るとき、総合の数字では見えません。**項目を分けて測って、入力の大きさで分岐を置くところまでやらないと、片方を踏み潰します。
正直に書いておくこと
- **
-E -iで負けています。**キャッシュに乗った 3GB で2.67倍、10GB で3.06倍。50GB で同等に見えるのは媒体に隠れているだけです - **その原因を切り分けた計測はありません。**バイトのまま畳む経路を通らないから、という設計の説明までです
- **1回の照合に5秒の上限があります。**重い式では途中で止まります。ripgrep にこの制限はありません
- **POSIX 文字クラスと用字名が書けません。**書き換え先はありますが、一致範囲は同じではありません
- **v1.7.2.1 までは
[[:alpha:]]を黙って別の意味で探していました。**その間に出した件数は正しくありません - **「ripgrep と同じ範囲」と並べた表が間違っていました。**外部レビューで指摘され、実物で確かめて2つに分けました
- **複数行にまたがる検索ができません。**展開が要る経路では1行の先頭64KBまでで判定します
- 10GB の hot は、過去の測定でキャッシュ依存の揺れが大きかった項目です。今回は10秒待機を入れた同一条件で測っていますが、3GB の2.67倍のほうを主な根拠と見ています
- NativeAOT の退行を直したとき、どの分岐がどれだけ効いたかの内訳は測っていません
- 私は比較の一方の開発者です。その分は割り引いてお読みください
使っている道具
UwView は、巨大なテキストファイル・巨大ログを調べるための CLI/GUI ツールです。v1.7.3.6 “Wide Field” では、複数のファイルと7つの圧縮形式を、外部のコマンドなしで1回で探せます。
uvp ならこう書く
# 既定は文字列そのまま(ripgrep の -F と同じ)
uvf app.log 'ERROR'

# 正規表現として探す
uvf app.log 'k="highway[^"]*"' -E

# 大文字小文字を区別しない(文字列・正規表現とも)
uvf app.log 'HIGHWAY' -i
uvf app.log 'K="NAME[^"]*"' -E -i

# 当てはまらない行(正規表現と併用できる)
uvf app.log '^ +<' -E -v

# 郵便番号の形を探す
uvp app.log '[0-9]{3}-[0-9]{4}' -E

# 書けるもの・書けないもの・書き換え先
uvf --help regex

# 捕まえたところだけ数える(正規表現で取り出す)
uvp app.log 'k="amenity"' -uniq 'v="([^"]+)"' -sort count -head 20

# 2語で絞る/前後3行つき
uvp app.log k="amenity" v="parking"
uvp app.log k="amenity" -C 3 k="name"

# 結果を画面で読む(GUI へ渡す)
uvp app.log 'k="highway[^"]*"' -E -open
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。[[:alpha:]] のような書けない式は、探し始める前に書き換え先を出して2で終わります。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- 正規表現を固定文字列と同じ速さに(必須リテラルの取り出し): https://uvp.y42u.net/blog/uwview-fl04-regex-required-literal/
-iの一致範囲と、ケルビン記号 U+212A だけが例外だった話: https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/- CPU を速くしても外付け SSD では数字に出ない: https://uvp.y42u.net/blog/uwview-fl11-newline-vs-media/
- ファイル指定を引用符ひとつに決めた理由: https://uvp.y42u.net/blog/uwview-wf08-file-globs/
- ripgrep と同じ除外規則にそろえた(
.ignore・.gitignore): https://uvp.y42u.net/blog/uwview-wf07-ignore-rules/ - 外部コマンドを呼ばずに7形式を探す: https://uvp.y42u.net/blog/uwview-wf02-seven-formats-no-external/
- 読む回数だけを減らした13回のまとめ: https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。