全部の行が「違う」。
取引先から届いた Shift-JIS の CSV を、社内の UTF-8 の CSV と diff で比べたら、日本語を含む行がすべて「違う」と出た。そんな経験はありませんか? 中身は 1 セルしか変わっていないのに、です。
いつもの解決は「変換してから比べる」です。では、変換せずに、そのまま比べる方法はあるのでしょうか。10GB(約 1 億行)の CSV で、両方の手順の時間を測りました。
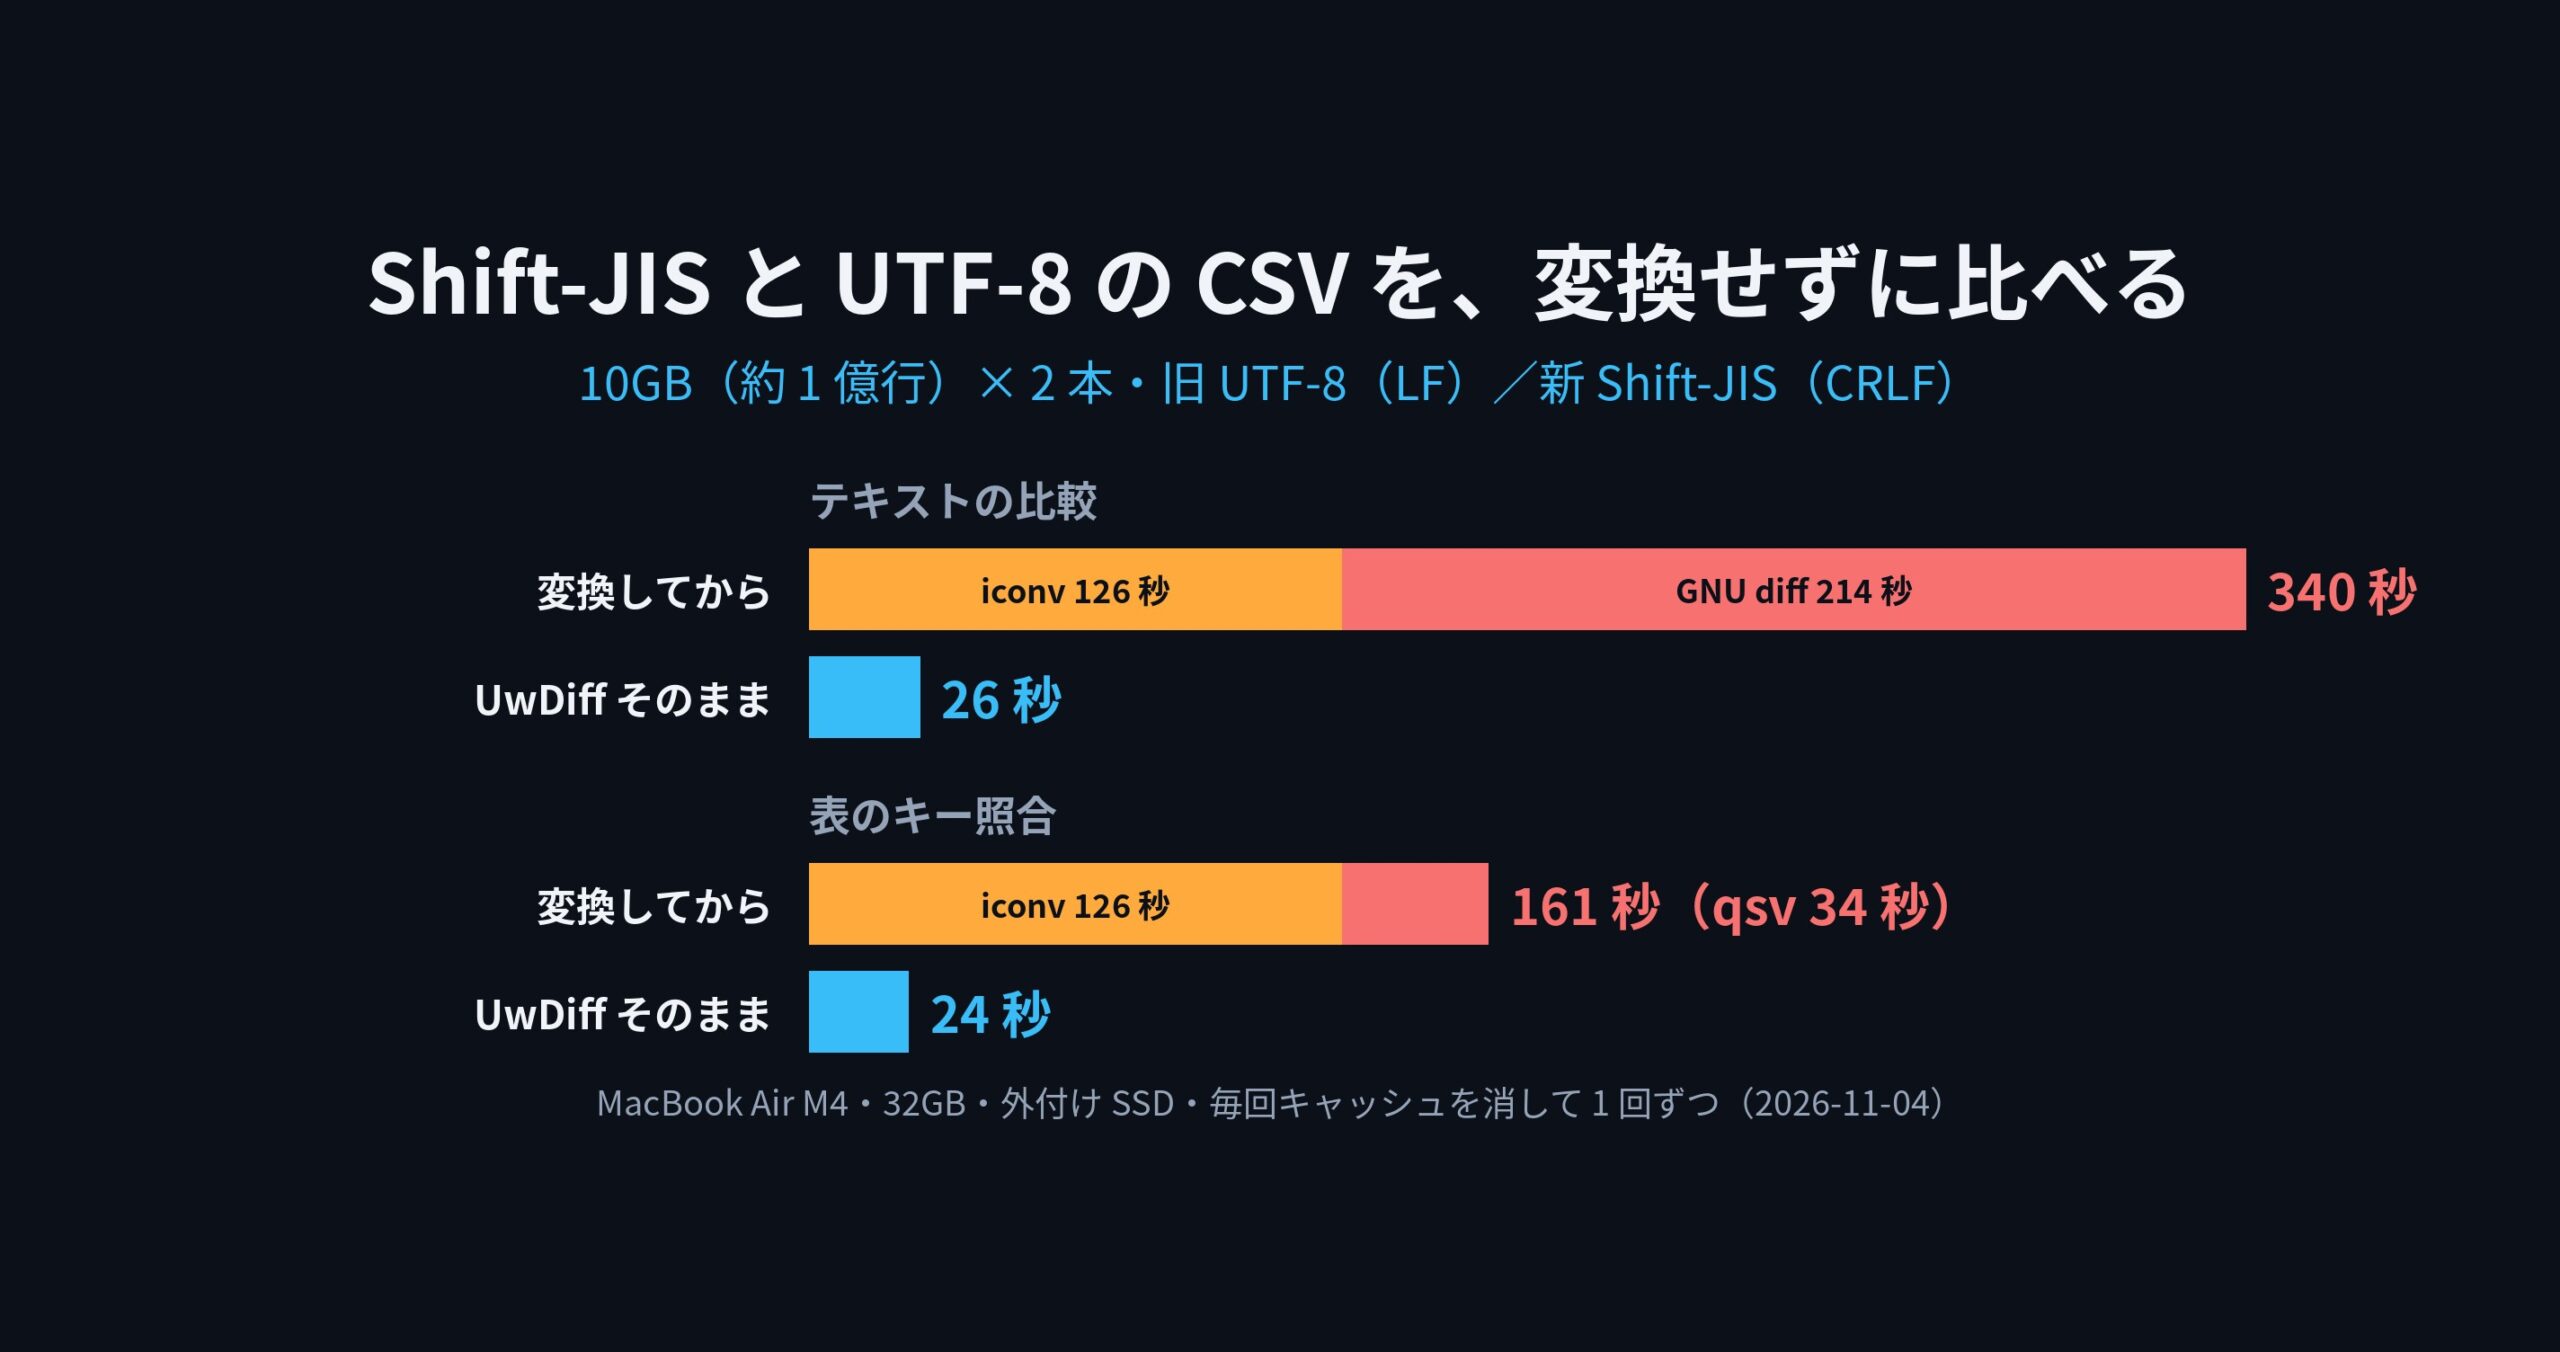
先に結論: 変換してから比べると 10GB で 5 分 40 秒。UwDiff はそのまま渡して 26 秒
- diff は、文字ではなくバイトを比べます。 同じ「点名」でも、UTF-8 と Shift-JIS ではバイトが違うので、日本語を含む行はすべて「違う」になります。Windows で作った Shift-JIS の CSV は改行も CRLF なので、さらに全行が違って見えることがあります。
- 画面の比較ツール(KDiff3・P4Merge)も、既定のままでは文字化けします。 文字コードを手で指定すれば読めますが、ファイルごとに文字コードを知っている必要があります。
- いつもの手順は、
iconvで UTF-8 に変換し、diff --strip-trailing-crで改行の違いを無視して比べる、です。10GB(約 1 億行)では、変換に 126.11 秒、比較に 213.55 秒、合わせて 339.66 秒(5 分 40 秒)かかり、変換したファイルの分(9.4GB)の空きも要りました。表として qsv でキー照合しても、変換を含めて 160.58 秒です。 - UwDiff は、旧と新の文字コードを自動で見分け、違えば UTF-8 にそろえながら比べます。改行の違いも既定で無視します。10GB を 2 本そのまま渡して、テキストの比較が 26.15 秒、表のキー照合が 23.57 秒でした(キー照合の差分は正解と完全に一致)。
なぜ「全部違う」になるのか
試しに、中身が同じ 4 行の CSV を、UTF-8 と Shift-JIS で保存して diff で比べます。
$ diff utf8.csv sjis.csv
1,4c1,4
< 点名,X,Y,標高,種別
< T001,-11938.113,-34915.764,24.495,基準点
< T002,-11876.579,-34890.524,27.537,境界点
< T003,-11905.204,-34902.118,26.011,引照点
---
> �_��,X,Y,�W��,���
> T001,-11938.113,-34915.764,24.495,��_
> T002,-11876.579,-34890.524,27.537,���E�_
> T003,-11905.204,-34902.118,26.011,���Ɠ_
diff は文字コードを知りません。行のバイトが 1 つでも違えば「違う」です。そして、Shift-JIS のバイトを UTF-8 の端末に出すので、右側は文字化けします。
日本語の無い行(数字だけの行など)はバイトが同じなので「同じ」になります。日本語の列が 1 つでもある表なら、ほぼ全行が「違う」です。
画面の比較ツールも、既定のままでは化ける
画面で比べる無料の道具 2 つで、Shift-JIS(CP932)の 10MB の CSV を開いてみました(MacBook Air M4・macOS 26.3.1)。
| 道具 | 既定のまま開くと | 読めるようにするには |
|---|---|---|
| KDiff3 1.12.6 | 文字化け(UTF-8 として読む) | 設定の「地域と言語」で A・B を Shift_JIS にし、Unicode の自動検出を外す |
| P4Merge 2026.3 | 文字化け(「System」のまま) | 起動時に -C shiftjis を付ける |
| UwDiff 1.0.0 | 読める(自動で判定) | 指定は要らない |
KDiff3 の文字コードの設定は保存されて残るので、次に UTF-8 のファイルを開くときは元に戻す必要があります。つまり、ファイルを開く前に、そのファイルの文字コードを知っていなければなりません。
いつもの手順: 変換してから比べる
文字コードがそろわないなら、そろえてから比べる。これがいつもの手順です。
iconv -f CP932 -t UTF-8 新.csv > 新_utf8.csv             # 新を UTF-8 に直す
diff -u --strip-trailing-cr 旧.csv 新_utf8.csv > 差分.diff  # 改行の違い(CRLF と LF)は無視して比べる
10GB(約 1 億行)の CSV 2 本(旧は UTF-8・LF、新は Shift-JIS・CRLF)で、この手順の時間を測りました。
同じ MacBook Air(Apple M4・メモリ 32GB)・外付け SSD・macOS 標準の iconv。毎回キャッシュを消してから(sudo purge)1 回ずつ測りました。
| 手順 | 1GB(1,053 万行)× 2 本 | 10GB(1 億 534 万行)× 2 本 |
|---|---|---|
| ① iconv で新を UTF-8 に変換 | 12.46 秒 | 126.11 秒 |
② GNU diff 3.12(-u --strip-trailing-cr) |
8.70 秒・3.16GiB | 213.55 秒・12.62GiB |
| テキストの比較の合計(①+②) | 21.16 秒 | 339.66 秒(5 分 40 秒) |
| ③ qsv diff 26.0.0(キー照合。変換したファイルで) | 2.89 秒・0.20GiB | 34.47 秒・2.36GiB |
| 表のキー照合の合計(①+③) | 15.35 秒 | 160.58 秒(2 分 41 秒) |
| 変換したファイルの大きさ | 954MB | 9.4GB |
時間の多くは、比べる前の変換でした。 10GB では、変換だけで 2 分を超えています。
変換は 1 回で済みますが、変換したファイルの分の空き(10GB)と、その書き出しの時間が要ります。比べ終わったら消す、という後始末も残ります。
UwDiff なら: 2 本をそのまま渡す
UwDiff は、ファイルの先頭を読んで文字コードを見分けます(BOM → UTF-16 → UTF-8 → Shift-JIS と EUC-JP の順)。旧と新で文字コードが違えば、読みながら UTF-8 にそろえて比べます。改行コードの違いも既定で無視します。
画面で比べる
- UwDiff を開き、「旧」に UTF-8 の CSV、「新」に Shift-JIS の CSV を入れる(ドラッグでもよい)。
- 表として比べるなら、「キー列」に
点名のような列の名前を入れる。行の順番が違っていても、キーで対応付けます。 - 「比べる」を押す。
文字コードを指定する必要はありません。変わったセルだけが、旧の値と新の値の組で並びます。
コマンドで比べる
$ uvd 旧_utf8.csv 新_sjis.csv -key 点名 -o 差分.csv
旧 3 行(UTF-8・カンマ・0 MB)/新 3 行(CP932・カンマ・0 MB)  キー: 点名
  文字コードが違う(または UTF-16 の)ため、UTF-8 にそろえて比べた
追加 0/削除 0/変更 1 行(1 セル)/同じ 2

$ cat 差分.csv
区分,点名,列,旧値,新値
変更,T002,X,-11876.579,-11876.601
片方が gzip で圧縮されていても、そのまま渡せます(新_sjis.csv.gz)。
10GB(約 1 億行)での実測
上と同じ 10GB の 2 本(旧 UTF-8・LF、新 Shift-JIS・CRLF)を、そのまま uvd に渡しました。
同じ機械・同じ測り方です(2026-11-04・uvd 1.0.0 build 26.10.25.20)。右の列は、同じ試験データを同じ文字コードどうしで比べたときの値です(10/26・実測のページ)。
| 比べ方 | 1GB × 2 本 | 10GB × 2 本 | 参考: 同じ文字コードどうし(10GB。UTF-8/CP932) |
|---|---|---|---|
| テキストの比較 | 2.82 秒・0.36GiB | 26.15 秒・0.37GiB | 21.23 秒/20.77 秒 |
| 表のキー照合(行順そろい) | 3.32 秒・1.82GiB | 23.57 秒・4.15GiB | 21.52 秒/20.35 秒 |
| 表のキー照合(行順ばらばら) | 3.09 秒・2.02GiB | 29.09 秒・9.80GiB | 22.61 秒/21.90 秒 |
キー照合の差分は、1GB(25.7 万行)も 10GB(255.9 万行)も、正解と完全に一致しました。
いつもの手順と並べると、10GB でテキストの比較は 339.66 秒と 26.15 秒(13.0 倍)、表のキー照合は 160.58 秒と 23.57 秒(6.8 倍)です。違いの大半は、変換を別にするか、読みながらそろえるかです。
画面でも、Shift-JIS どうしの 10GB の 2 本は 19.51 秒で表示まで進みました(10/27・同じ機械。KDiff3 と P4Merge は、同じ Shift-JIS の 1GB で 600 秒たっても表示されませんでした)。
負けと、できないこと
- 文字コードが違うと、そろえる分だけ遅くなります。 同じ文字コードどうしなら変換せずにバイトのまま比べるので、10GB で 1.1〜1.3 倍の差が出ました(キー照合・行順そろい 23.57 秒と 21.52 秒、テキスト 26.15 秒と 21.23 秒)。
- 変換を済ませたあとなら、qsv は同等です。 変換したファイルどうしの qsv のキー照合は、10GB で 34.47 秒(uvd の 23.57 秒の 1.5 倍未満=同等)、1GB では 2.89 秒で uvd(3.32 秒)より速く、メモリも少なく済みました(10GB で 2.36GiB と 4.15GiB)。同じ 2 本を何度も比べるなら、一度変換してしまうのも手です。
- 行の順番がばらばらな巨大な表は、メモリを使います。 10GB で 9.80GiB でした。
-memで上限を決めると、一時ファイルへ逃がして最後まで通ります(そのぶん遅くなります)。 - 差分の出力は UTF-8 になります。 旧と新の文字コードが違うときは、差分(
差分.csv・差分.diff)は UTF-8 で書きます。Shift-JIS のまま欲しいときは、出力を変換してください(表の差分を旧に反映するuvd applyは、旧の文字コードを保ちます)。 - 見分けは自動なので、万一文字化けしたら固定してください。
-enc-old cp932-enc-new utf8のように、旧と新それぞれの文字コードを指定できます(utf8・cp932・eucjp・utf16le・utf16be)。 - Shift-JIS で書けない文字は、反映できません。 新の値に Shift-JIS に無い文字(絵文字など)があると、
uvd applyで旧(Shift-JIS)に当てるときに当てずに知らせます。
試すには
# Mac(Homebrew)
brew install --cask amru195704/uwview/uwdiff
# Windows(Scoop)
scoop bucket add uwview https://github.com/amru195704/scoop-uwview
scoop install uwdiff
# Linux(Snap)
sudo snap install uwdiff
Scoop が入っていない場合の入れ方や、手で入れる方法はダウンロードのページにあります。
次に確認する
- UwDiff の操作説明(文字コードの節) — 自動で見分ける順と、
-enc-old・-enc-newで固定する方法 - UwDiff の実測(条件つき・負けも含めて) — UTF-8 と CP932 で、1GB・5GB・10GB を比べた全部の表
- diff や grep で比べられないファイルはなぜ多いのか — 文字コード・圧縮・Word・大きさのつまずきと、UwDiff を作った理由
- 姉妹の道具 UwView — 巨大なログや CSV を開いて、grep のように探す道具
- note で連載中: 巨大ファイルを比べる——UwDiff 開発と使い方
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。