サイズは壁ではありません。
100GB の障害ログを渡されて、まず困るのは「開くかどうか」です。開かないなら分割するしかなく、分割すれば行番号がずれて、障害の時刻とログの行が合わなくなります。だから最初に確かめたいのは、どこまでなら1本のまま扱えるのかです。
では、ファイルが10倍になったとき、時間とメモリは何倍になるのでしょうか。そして「行数が多い」のは「サイズが大きい」のとは別の壁なのでしょうか。
今回は1GiB から 100GiB までを1回ずつ読み切るテストと、1億行・10億行の末尾の行へ飛ぶテストをまとめて出します。どちらも素直に伸びました。素直に伸びたからこそ、伸びなかった所が1つだけ残りました。
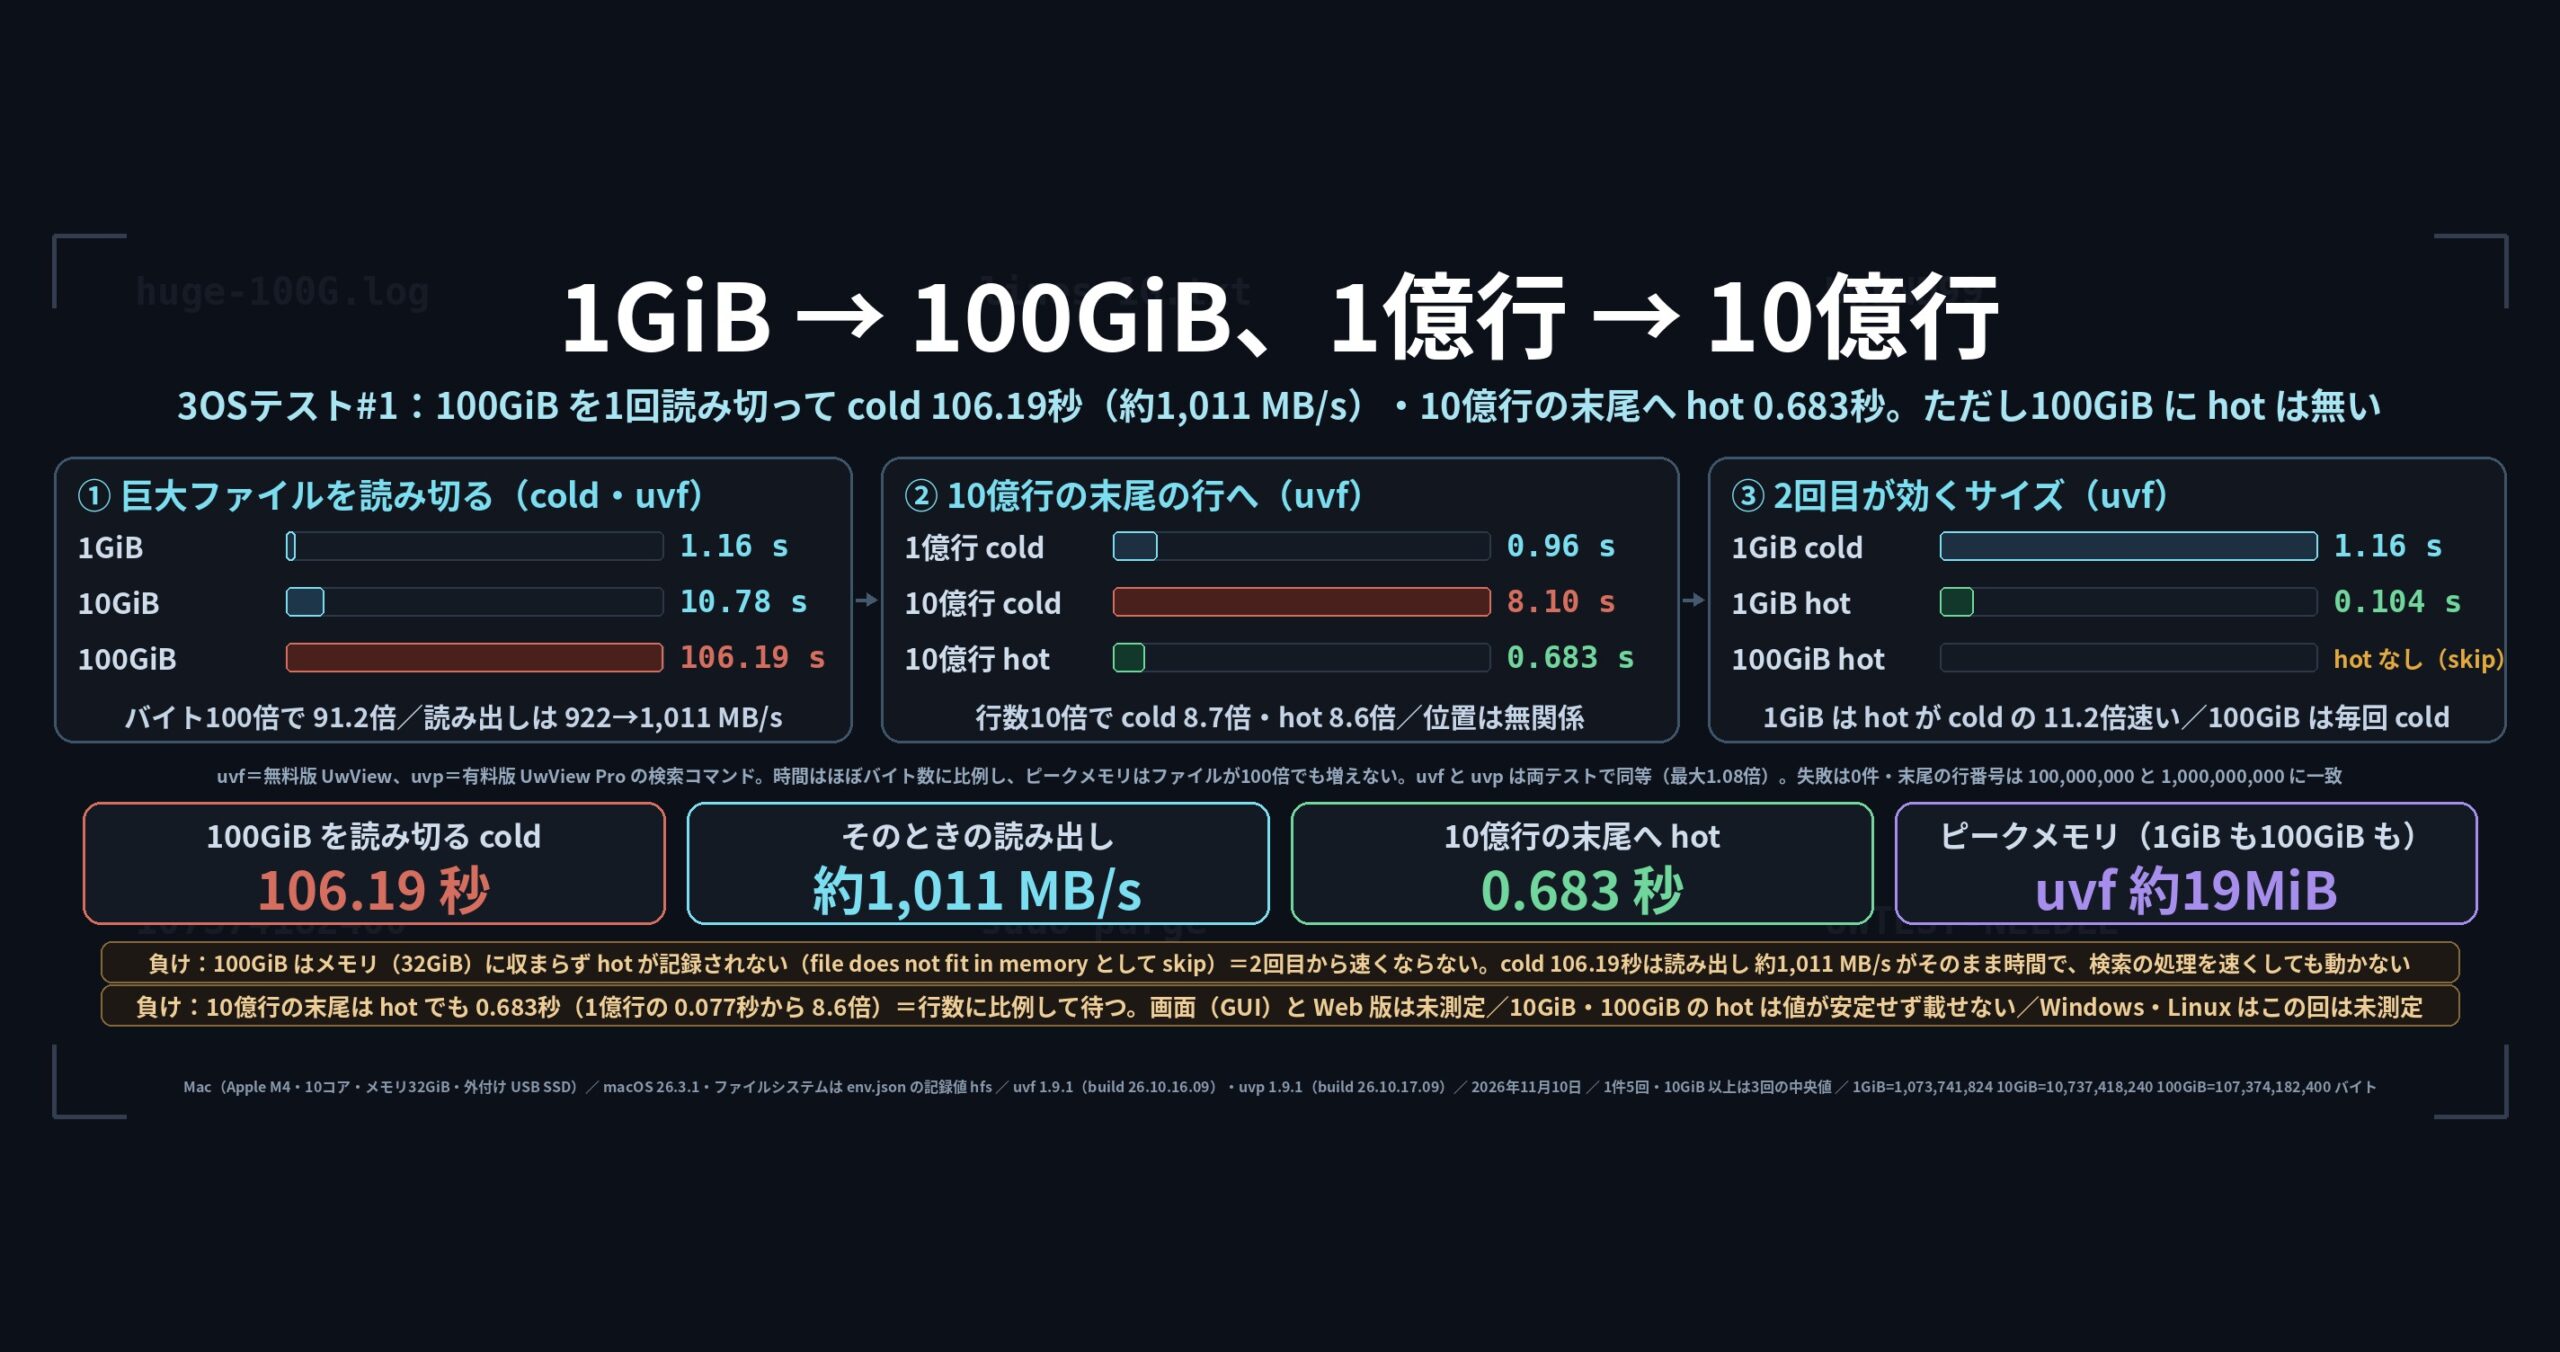
先に結論: 時間はほぼバイト数に比例し、メモリは増えない。ただし100GiB には hot が無く、10億行の末尾は hot でも約0.68秒かかる
負けを先に書きます。
1つめ。100GiB には hot がありません。 メモリ(32GiB)に収まらないので、結果の CSV には時間ではなく file does not fit in memory: hot is the same as cold という skip が記録されました。「2回目から速い」が効かないサイズがあるということです。しかも cold の速さは外付け USB SSD の読み出し(この機械では約 1,011 MB/s)にほぼ張り付いていて、ソフト側で縮める余地はほとんどありません。
2つめ。10億行の末尾へ飛ぶのは、hot でも約0.68秒かかります。 1億行の約0.077秒から8.6倍です。末尾の行番号を出すには、そこまでの改行を数え終わるまで待つしかありません。「末尾へ一瞬で飛ぶ」ではなく、「行数に比例した時間だけ待つ」が正しい言い方です。
そのうえで、確かめられたことを並べます。
- 時間はほぼバイト数に比例します。 1GiB から 100GiB(バイト100倍)で、cold は 1.16秒 → 106.19秒(91.2倍)。線形より少し良いのは、1GiB のほうが読み出しの速さを出し切れていないためです
- ピークメモリは、ファイルが100倍になっても増えません。 uvf は約19MiB、uvp は約23MiB で、1GiB でも 100GiB でも同じでした
- 行数は壁ではありません。 1億行(763MiB)の cold は約0.93〜0.99秒で、1GiB のログ(1,024MiB)の約1.16〜1.25秒と同じ水準です。効いているのは行数ではなくバイト数でした
- 末尾の行・中央の行・ヒットなしで、時間は変わりません。 10億行の cold はどれも約8.1秒で、どこにヒットがあるかは時間に影響しませんでした
- 1GiB の hot は cold の約11分の1(uvf 1.16秒 → 0.104秒)。メモリに収まるサイズでは、2回目が効きます
- 無料版 uvf と有料版 uvp は、この2つのテストでは同等でした。 最も開いたところでも1.08倍(1GiB・ヒットなしの cold で uvf のほうが速い)で、この連載の「1.5倍未満は同等」の線の中です
uvfは無料版 UwView、uvpは有料版 UwView Pro の検索コマンドです。数字はすべて 2026年11月10日に Mac(Apple M4・10コア・メモリ32GiB・外付け USB SSD)で測った結果の CSV から採りました。版は uvf 1.9.1(build 26.10.16.09)・uvp 1.9.1(build 26.10.17.09)、macOS 26.3.1。この回は Mac だけで、Windows と Linux は未測定です。 cold・hot の作り方と数字の読み方は第0回で決めたとおりです。※ファイル容量の表記について:本記事の「1GiB」「10GiB」「100GiB」はバイト÷1024³の値で、それぞれ 1,073,741,824/10,737,418,240/107,374,182,400 バイトです。macOS の容量表示(SI・÷1000³)では 1.07GB/10.74GB/107.37GB と表示されます。題の「100GB」はこの SI 表記に合わせたものです。
問題: 「開けた」と「使える」は別の話
巨大なログに対して、道具が答えるべきことは2つあります。開けるかと、開いたあと目的の行に辿り着けるかです。
前者だけなら話は単純で、全部をメモリに読まない作りにすれば、ファイルがいくら大きくても開けます。問題は後者です。「障害が起きた時刻の前後を見たい」なら末尾に近い行へ行きたいわけですが、行番号は先頭から改行を数えないと分かりません。 だから「末尾へ飛ぶ」は、実は「ファイル全体を一度なめる」のと同じ仕事です。
もう1つ見落としやすいのがメモリです。裏で実メモリを食い尽くしていればスワップが始まり、同じ機械の他の作業が止まります。開けたかどうかと同じくらい、何MiB で開けたかが大事です。
そこで今回は、サイズを10倍ずつ上げる系列と行数を10倍に上げる系列を同じ手順にかけ、サイズと行数のどちらが効くのかを切り分けました。
テスト条件
機械(この回は Mac だけ)
| 機械のラベル | 中身 | メモリ | 保存先 | ファイルシステム | 種類 |
|---|---|---|---|---|---|
mac-m4-32g-usbssd |
MacBook Air(Apple M4・10コア) | 32GiB | 外付け USB SSD | hfs(記録値) |
実機 |
linux-vmware-fusion |
— | — | — | — | 未測定 |
win11-16g |
— | — | — | — | 未測定 |
OS は macOS 26.3.1(arm64)、仮想化なし。ファイルシステムは結果の env.json に hfs と記録されました(第0回の表では APFS と書きましたが、記録された値をそのまま出します)。
この回に Linux と Windows の値はありません。 連載の決まりで新しく測るのは Mac だけ、他の2つは以前に測った値を使うことにしていますが、この2つのテストには以前の値がありません。 したがって VMware の割り当ても今回は該当しません。
データ
巨大ファイルの系列(huge)は、日時・レベル・都市名・ID・状態・パスの入った UTF-8 のログ行を 1MiB 単位で並べたものです。UWTEST-NEEDLE という行が先頭・中ほど・末尾の1MiBに1本ずつ入っていて、行番号が分かっています。行数の系列(lines)は 1行8バイト(ランダムな英字7文字+改行)だけのファイルで、中ほどの行が UWMID01、いちばん最後の行が UWEND99 です。
| ファイル | バイト数 | GiB(÷1024³) | 行数 | SHA-256 |
|---|---|---|---|---|
huge-1G.log |
1,073,741,824 | 1.00 | — | 984d3c2f49e9eaab… |
huge-10G.log |
10,737,418,240 | 10.00 | — | 4e223935919feedd… |
huge-100G.log |
107,374,182,400 | 100.00 | — | d9348a746b6a70eb… |
lines-100M.txt |
800,000,000 | 0.75 | 100,000,000 | 09dea7a0ea3abb51… |
lines-1G.txt |
8,000,000,000 | 7.45 | 1,000,000,000 | 4f17fc251f46d3cc… |
データは配布しません。種を固定した生成器が作るので、どの OS で作っても同じバイト列になります。作ったあと SHA-256 で照合してから測っています。
測り方
1件につき5回、10GiB 以上のファイルは3回測って中央値を採りました。cold は sync のあと sudo purge、hot は記録しない空回しを1回入れてから。「そのセッションで最初の1回」は first として中央値とは分けています。正解は、終了コード・ヒットの数・(末尾と中ほどの行では)行番号そのものまで一致したときだけ ok です。
結果
表1: 1GiB から 100GiB まで(cold・Mac のみ・秒)
| ケース | uvf 1.9.1(秒) | uvp 1.9.1(秒) | uvf(MB/s) | uvp(MB/s) |
|---|---|---|---|---|
| 1GiB・ヒットなし | 1.16 | 1.25 | 922 | 856 |
| 1GiB・ヒット3件 | 1.24 | 1.24 | 865 | 864 |
| 10GiB・ヒットなし | 10.78 | 10.75 | 996 | 999 |
| 10GiB・ヒット3件 | 10.68 | 10.67 | 1,006 | 1,006 |
| 100GiB・ヒットなし | 106.19 | 106.19 | 1,011 | 1,011 |
| 100GiB・ヒット3件 | 107.17 | 106.21 | 1,002 | 1,011 |
hot が出せたのは 1GiB だけです。
| ケース | uvf 1.9.1(秒) | uvp 1.9.1(秒) | 同じ製品の cold から何倍速いか |
|---|---|---|---|
| 1GiB・ヒットなし(hot) | 0.104 | 0.102 | uvf は cold より 11.2 倍速い/uvp は 12.3 倍速い |
| 1GiB・ヒット3件(hot) | 0.101 | 0.103 | uvf は cold より 12.3 倍速い/uvp は 12.1 倍速い |
ピークメモリは、どのサイズでも uvf 約19MiB・uvp 約23MiB で変わりませんでした(uvp のほうが約4MiB 多く、1.2倍=同等です)。100GiB を読んでも増えません。
10GiB と 100GiB の hot は、この記事には載せません。 100GiB はメモリに収まらないので hot がそもそも記録されず(file does not fit in memory として skip)、10GiB は測り直したときに値が変わったためです。この連載は安定して再現できる数字だけを出す方針です。
表2: 1億行と10億行(Mac のみ・秒)
| ケース | uvf cold(秒) | uvp cold(秒) | uvf hot(秒) | uvp hot(秒) |
|---|---|---|---|---|
| 1億行・末尾の行へ | 0.96 | 0.99 | 0.077 | 0.077 |
| 1億行・中ほどの行へ | 0.95 | 0.97 | 0.077 | 0.077 |
| 1億行・ヒットなし | 0.93 | 0.98 | 0.080 | 0.078 |
| 10億行・末尾の行へ | 8.10 | 8.00 | 0.683 | 0.676 |
| 10億行・中ほどの行へ | 8.09 | 8.09 | 0.688 | 0.672 |
| 10億行・ヒットなし | 8.10 | 8.12 | 0.686 | 0.674 |
この表でいちばん言いたいのは、縦に見てどの行もほぼ同じということです。末尾の行を取るのと、中ほどの行を取るのと、1件もヒットしないのが同じ時間で終わっています。ヒットの位置は時間に関係しませんでした。
そして 1億行 → 10億行(バイト10倍・行数10倍)で、cold は 0.93秒 → 8.10秒(8.7倍)、hot は 0.080秒 → 0.686秒(8.6倍)。cold も hot も同じ倍率で伸びています。
1億行のファイルは 800,000,000 バイト(763MiB)で、表1の 1GiB(1,024MiB)より小さいファイルです。その cold が約0.93〜0.99秒、1GiB のログの cold が約1.16〜1.25秒で、バイト数の比(1.34倍)とほぼ同じ比です。つまり効いているのは行数ではなくバイト数でした。1行8バイトのファイルと1行100バイト前後のログで、1バイトあたりの時間がほぼ同じだったということです。
「そのセッションで最初の1回」(first)は、ほぼ cold と同じでした。1つだけ、uvp の10億行・ヒットなしの first が9.01秒で、cold の中央値8.12秒より1.1倍遅くなっています。
負け: 「2回目から速い」が効かないサイズと、行数に比例する待ち時間
1つめ。100GiB は、何度開いても毎回 cold です。
ファイルが実メモリ(32GiB)を超えると OS のファイルキャッシュに丸ごと載らないので、hot という状態が作れません。結果の CSV には時間の代わりに skip の理由が入りました。同じ100GiB のログを午前と午後に探したら、午後も106秒かかります。
さらに、この106秒はソフトの都合ではありません。 107,374,182,400 バイトを 1,011 MB/s で読めば、それだけで約106秒です。検索の処理をどれだけ速くしても、この数字はほとんど動きません。 表1の100GiB の行で uvf と uvp が小数第1位まで揃っているのは、両方とも同じ上限に当たっているからです。
2つめ。10億行の末尾へ飛ぶのは、hot でも約0.68秒かかります。
1億行では約0.077秒だったので、8.6倍です。行数が10倍になれば待ち時間も10倍近くになります。0.68秒は人が待てる時間ですが、行数に比例して伸びることは変わりません。
そしてこの回には画面(GUI)の数字がありません。 コマンドの時間だけで、画面は手でストップウォッチを押すことになっていて今回は測っていません。Web 版も未測定です。「100GiB を画面で開いて末尾までスクロールすると何秒か」は、この記事では答えられません。
そしてこの回は、3OS テスト連載なのに Mac 1台です。 Windows と Linux はこの2つのテストについて以前の値が無く、連載の決まりでは新しく測るのは Mac だけです。第1回の時点で、連載名の「3OS」はまだ1OSです。
正しさ: 2つのテストで失敗は0件、行番号も一致
速さの前に、答えが合っていたかです。
今回の2つのテスト(巨大・行数)で、失敗は0件でした。 failures.csv は見出しの1行だけで、中身がありません。内訳はこうです。
- ヒットなしのケースは、終了コード1・出力0行。全件
ok - 巨大ファイルのヒット3件は、先頭・中ほど・末尾の1MiBにある行が3本とも出て、行番号も一致
- 1億行の末尾の行番号は 100,000,000、10億行の末尾は 1,000,000,000。中ほどの行も期待した行番号と一致
末尾の行番号が行数とぴったり合うのは地味ですが大事なところです。改行の数え方を1つ間違えると、ここが1だけずれます。 末尾改行をどう数えるかは流派が分かれるので、10億個の改行を数えて1もずれないことを毎回確かめています。
なお、連載の弱点の一覧には現在7件が載っていますが、この2つのテストからの追加はありません。 7件はすべて文字コード・改行・日本語の文字に関するもので、第4回以降で扱います。
持ち帰れる一般論: 巨大ファイルの道具を選ぶときに、自分で確かめられる3つ
巨大なファイルを扱う道具を評価するとき、サイズを変えて2回測るだけでかなり分かります。
1つめ。10倍のファイルで、時間が10倍を大きく超えないかを見ます。 30倍100倍になるなら、どこかでファイル全体を何度も触っているか、メモリに載せようとしています。逆に10倍でちょうど10倍前後なら、読み出しの速さで決まっているということで、それ以上はディスクの話です。手元の機械の読み出しの速さ(MB/s)を先に測っておけば、「この時間は妥当か」をその場で判断できます。
2つめ。ピークメモリを、サイズを変えて2点取ります。 1点では分かりません。2点取って増えていなければ、ファイルサイズに依存しない作りだと分かります。/usr/bin/time -l(macOS)や /usr/bin/time -v(Linux)で見られます。
3つめ。実メモリを超えるサイズを1つ混ぜます。 今回いちばん効いた確認です。収まる範囲でだけ測ると、「2回目から速い」という嘘をつきかねません。実メモリより大きいファイルでは、キャッシュの効果は基本的に消えます。 そのサイズを扱うなら、速いのは cold の値のほうだと思っておくのが安全です。
4つめ。答え合わせの列を1本足します。 速さのメモに「正解と一致したか」を並べて書くだけで、「速くなったが結果が変わった」をその場で見つけられます。行番号を使う道具なら、末尾の行番号が行数と一致するかが一番手軽です。
uvp ならこう書く
今回の2つのテストで実際に使った書き方そのものです。オプションはありません。
# 巨大なログの中を探す(無料版)
uvf huge-100G.log UWTEST-NEEDLE

# 同じことを有料版で
uvp huge-100G.log UWTEST-NEEDLE

# 10億行のファイルの最後の行と、その行番号を出す
uvf lines-1G.txt UWEND99
uvp lines-1G.txt UWEND99
正規表現で探すときは -E を付けます(-H はヒットした行にファイル名を付ける指定です)。
uvf huge-100G.log 'UWTEST-[A-Z]+' -E -H
uvp huge-100G.log 'UWTEST-[A-Z]+' -E -H
無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
再現方法
この回のテストの手順は、公開リポジトリーにあります。記事と食い違っていたら、向こうが正しいと思ってください。
- 巨大ファイルの回の手順: https://github.com/amru195704/UwView/blob/main/testsuite/docs/01-huge.md
- 行数の回の手順: https://github.com/amru195704/UwView/blob/main/testsuite/docs/02-lines.md
- 数字の読み方の決まり(第0回の元): https://github.com/amru195704/UwView/blob/main/testsuite/docs/00-rules.md
- 弱点の一覧: https://github.com/amru195704/UwView/blob/main/testsuite/weak-points.md
- 一式のフォルダー: https://github.com/amru195704/UwView/tree/main/testsuite
自分の機械で回すなら、tools/gen.py でデータを作り、tools/check.py data で SHA-256 を照合してから tools/run.py を走らせます。100GiB の回を入れるなら作業用に 250GB ほどの空きを見ておいてください。結果のフォルダー(results/ の下)そのものは、この記事の時点ではまだ公開されていません。公開されたらリンクを足します。
リンク
- 第0回(cold と hot の作り方・数字の読み方): https://uvp.y42u.net/blog/uwview-xt00-rules/
- 10GB の2回目はどこで縮んだか: https://uvp.y42u.net/blog/uwview-fs04-10g-second-search/
- 258GB を1本のまま扱った話: https://uvp.y42u.net/blog/uvp-258gb-cli-vs-gui/
- 「巨大ファイルが開けない」の答えをまとめたもの: https://uvp.y42u.net/blog/uvp-huge-file-open-summary/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
次回(第2回)は「cold と hot はどれだけ違うか」です。今回 1GiB だけで見えた11倍を、もう少しきちんと見ます。
そして、同じ語を何度も探す巨大なログを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。