UwView(ユーダブリュービュー) は、巨大なログ・テキストを開いて探す Windows・macOS・Linux 用のビューアです。画面は Avalonia UI、中身は .NET 10(C#)で、画面と同じ検索エンジンを使うコマンド(無料版は uvf、有料版 UwView Pro は uvp)も付いています。速さはいつも ripgrep と並べて測っています。
問い: 同じテスト一式を mac・Windows・Linux で流すと、何が違ってくるのか。
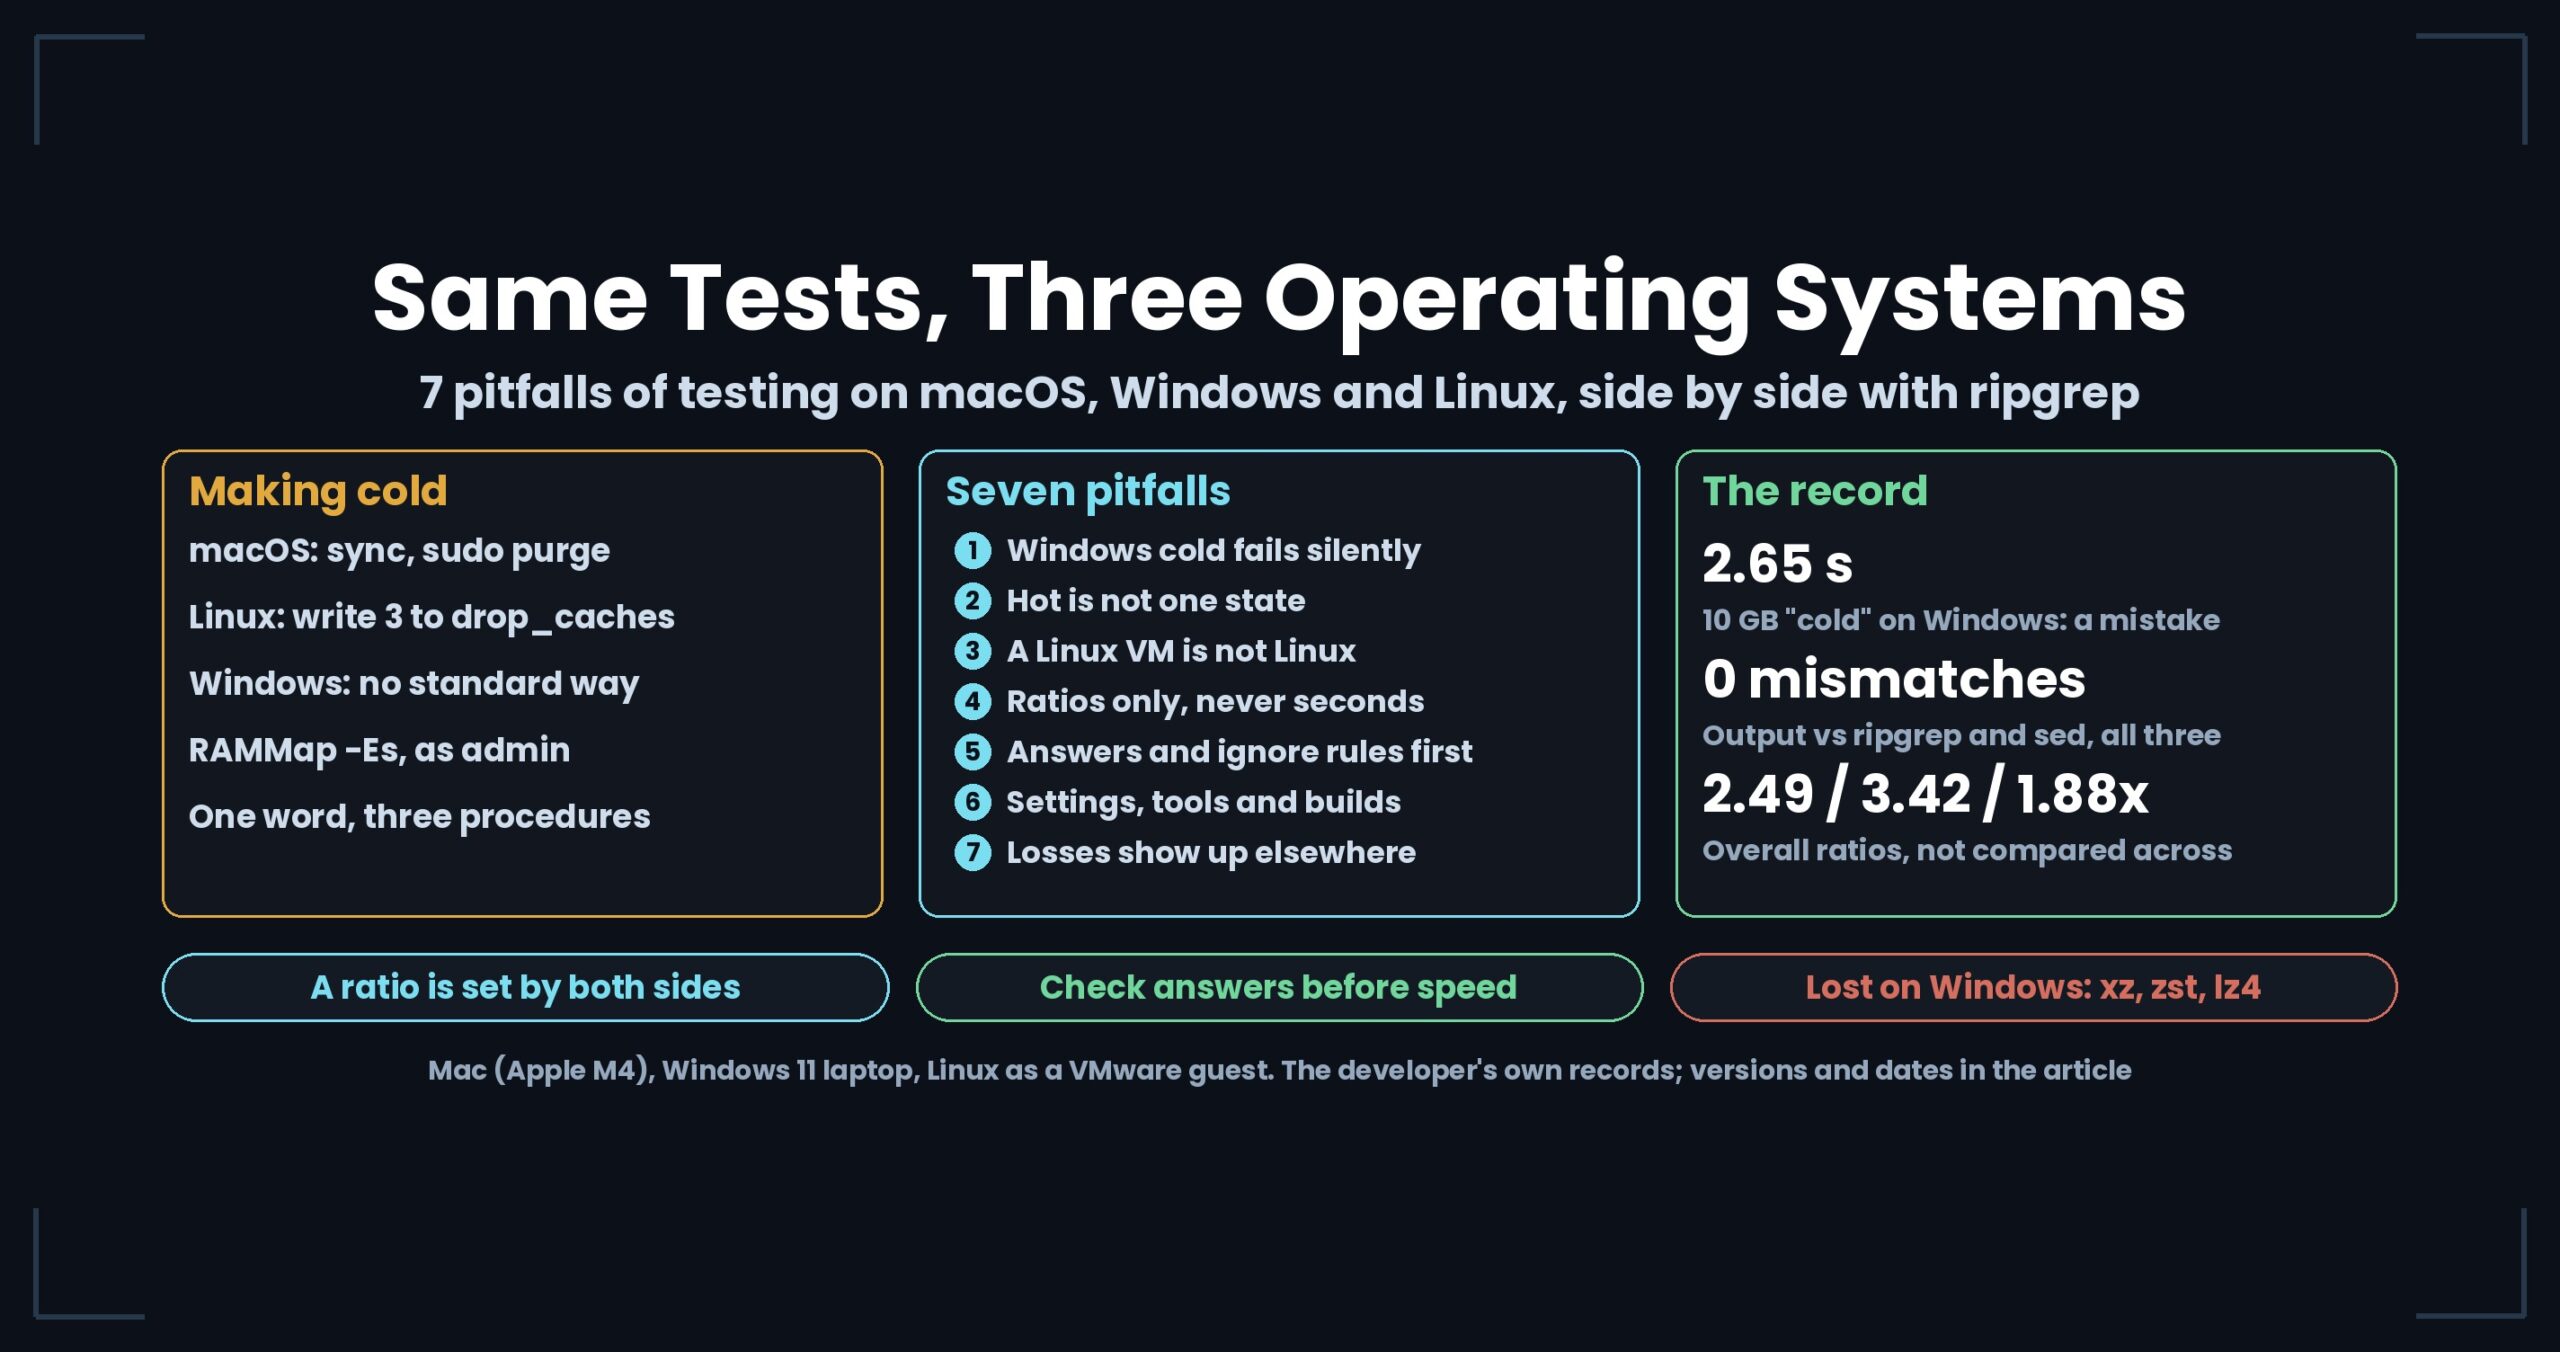
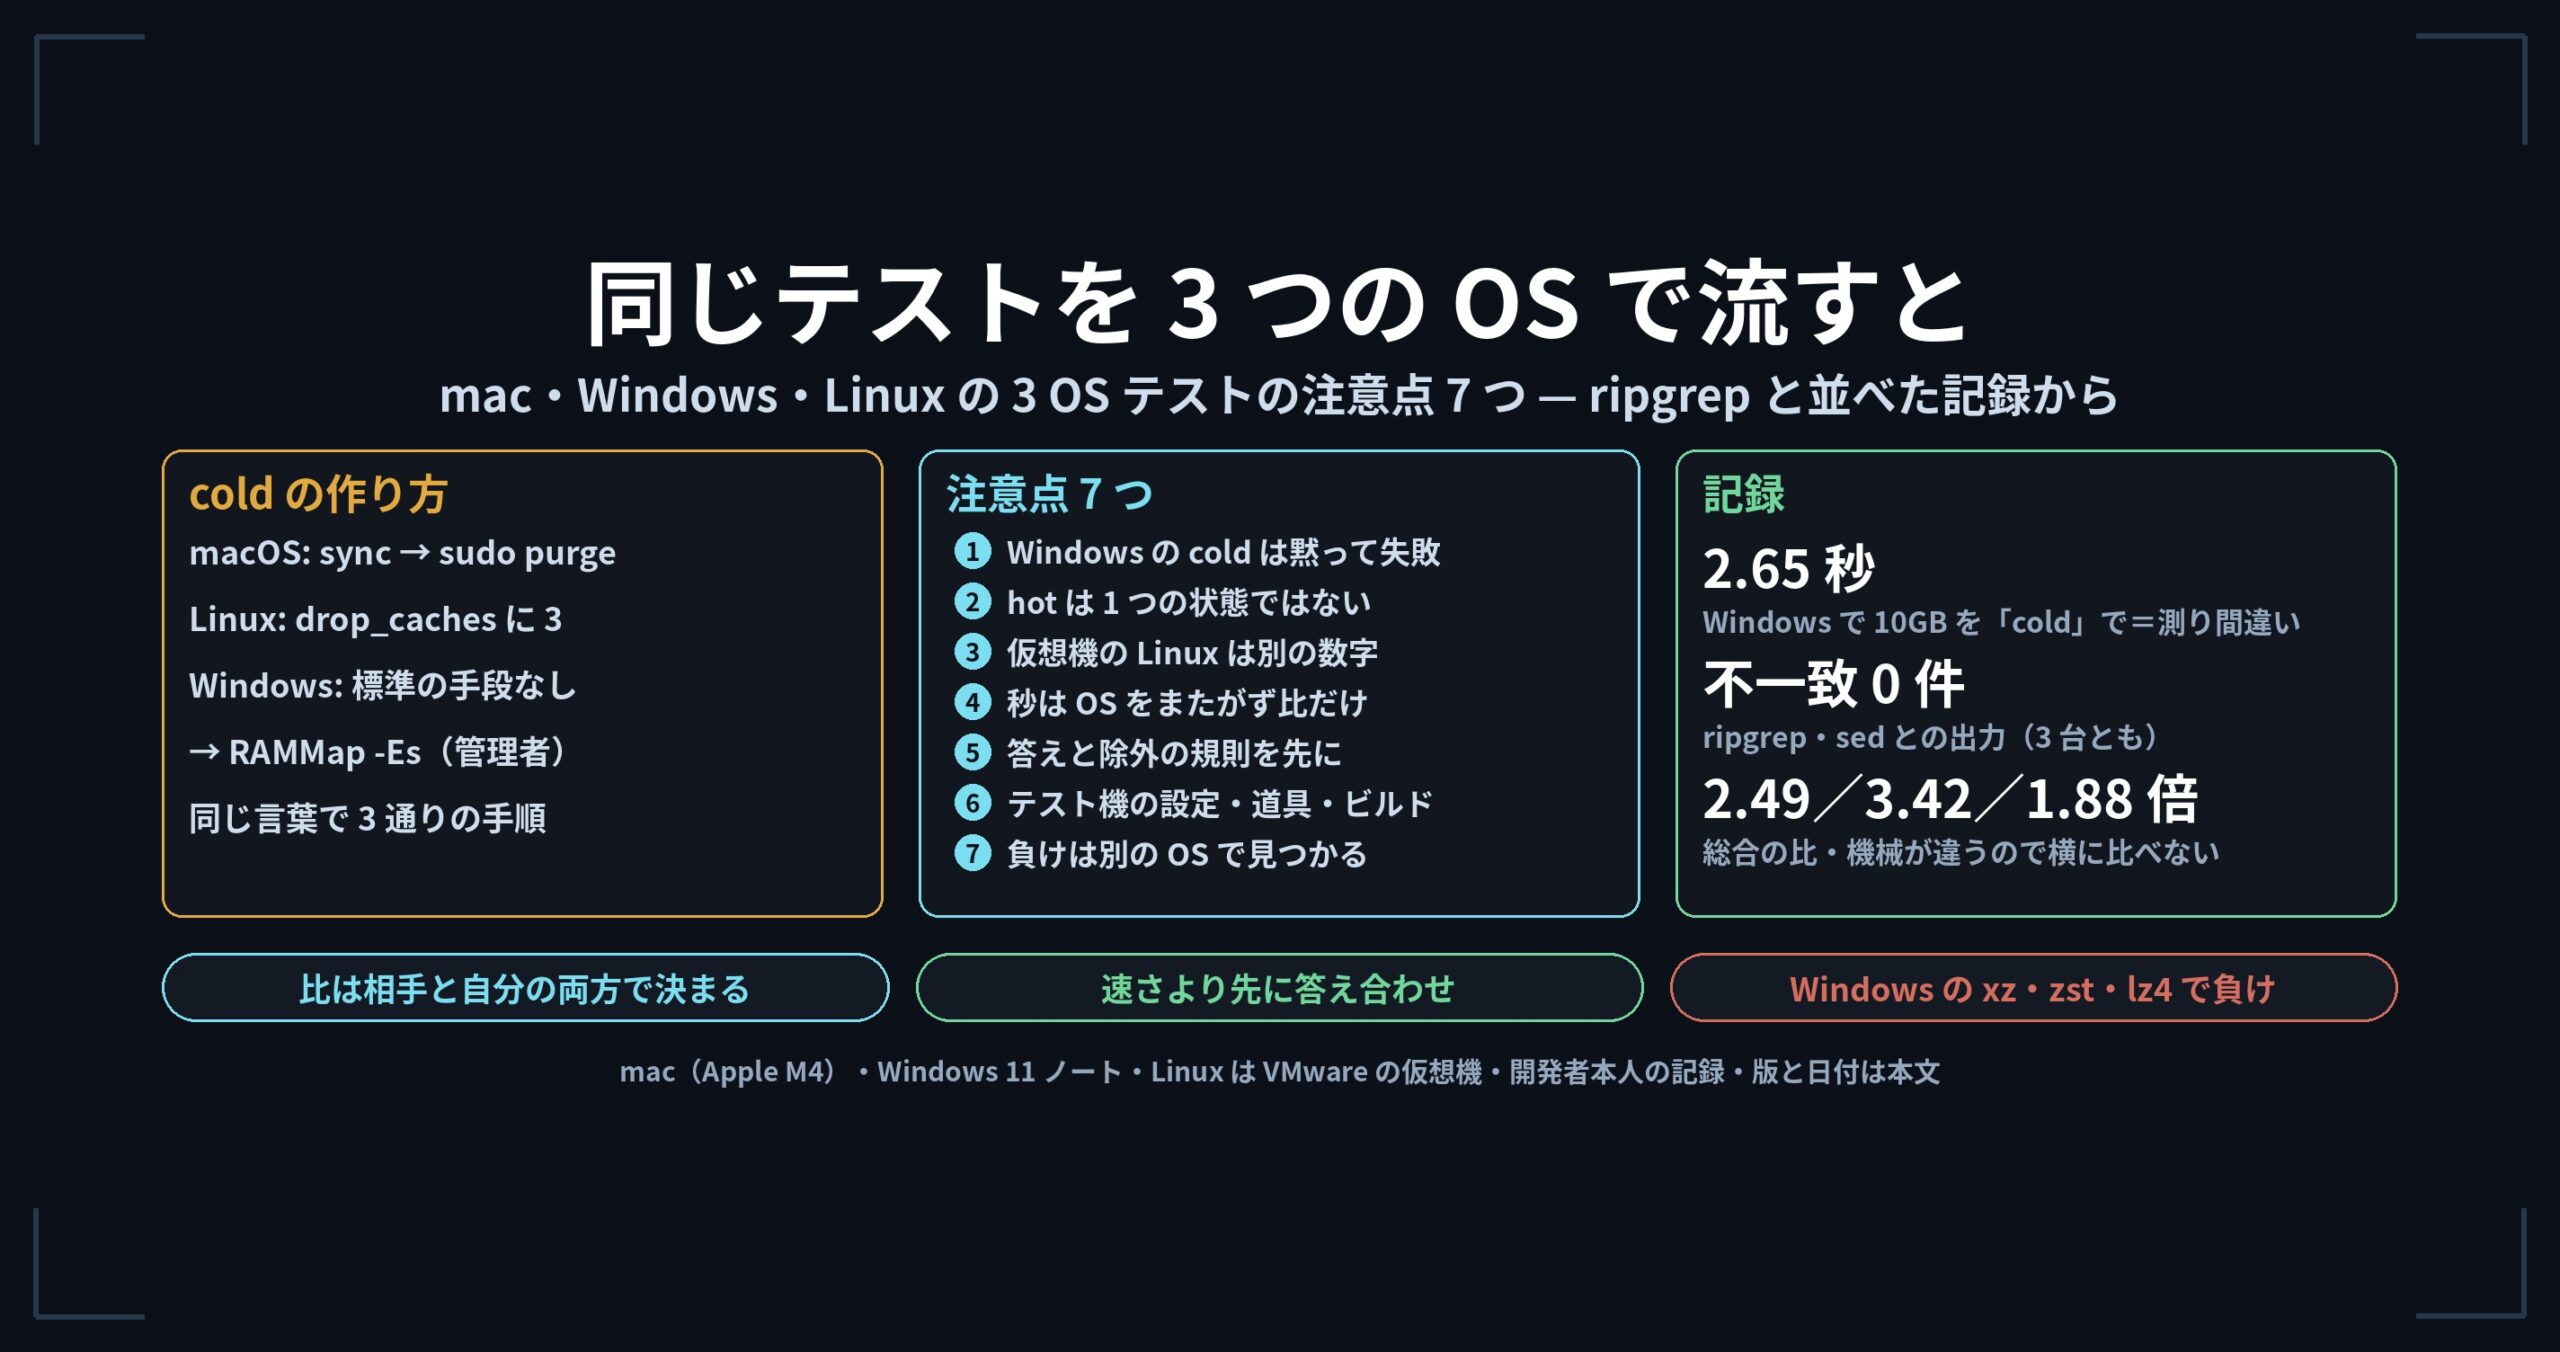
答え: 違うのは速さより先に「測り方」でした。キャッシュを空にする手順(cold)は OS ごとに別物で、Windows では黙って失敗します。「2 回目(hot)」もメモリの空きで別の状態になります。秒は OS をまたいで並べず、それぞれの機械の上での比だけを並べ、速さの前に答えの一致を確かめる。そうして初めて、Mac では出なかった負けが Windows で見つかりました。
このページは、3 つの OS で同じテストを流した記録 4 本(2026 年 9 月〜10 月)から、テストを組む人が詰まりやすい所を 7 つにまとめ直したものです。数字は元の記事の値をそのまま使い、新しく測った値はありません。
先に結論: 注意点 7 つ
- 「cold」は OS ごとに別の手順です。 macOS は
purge、Linux はdrop_caches、Windows には標準のコマンドが無い。 - Windows の cold は、黙って失敗します。 管理者権限と RAMMap が無いと、キャッシュを落とせないまま 2 回目として記録されます。
- 「hot」は 1 つの状態ではありません。 同じ 10GB でも、メモリの空き次第で載ったり載らなかったりします。
- 仮想機の Linux は「Linux の数字」ではありません。 ホスト側にキャッシュが残り、コアが少ないと結果の形まで変わります。
- 秒は OS をまたいで並べず、比だけを並べます。 比は、相手(ripgrep)と自分の両方で決まります。
- 速さの前に、答えと除外の規則をそろえます。 件数が違えば、どちらが速いかを比べる意味がありません。
- テスト機の設定・道具・ビルドの違いが、結果に入ります。 負けはたいてい、いつもと違う機械で見つかります。
3 台と、測ったもの
元の記事で使った 3 台です(Wide Field⑬・2026 年 10 月 4 日)。
| mac | Windows | Linux | |
|---|---|---|---|
| 機械 | Apple M4・論理 10・32GB・外付け USB SSD | x64・論理 8・15.6GB | aarch64・論理 2・7.0GB(VMware Fusion の仮想機) |
uvf の版 |
1.7.3.6.9 | 1.7.3.6.8 | 1.7.3.6.8 |
| スレッド | uvf 8・uvp 8(既定) |
uvf 4(設定)・uvp 8 |
uvf 2・uvp 2(既定) |
| ripgrep | 15.2.0 | 15.2.0 | 15.1.0 |
| 通しの時間 | 2 時間 20 分 | 4 時間 9 分 | 3 時間 29 分 |
1. 「cold」は OS ごとに別の手順
キャッシュを捨てた直後の 1 回目(cold)を作る方法が、OS ごとに違います。同じ「cold」という言葉が、3 通りの手順を指しています(3OS テスト#0)。
| OS | cold の作り方 | 注意 |
|---|---|---|
| macOS | sync のあと sudo purge |
purge が全部を落とし切らないことがある。再起動した直後の cold も別に 1 回取る |
| Linux(VMware) | sync のあと drop_caches に 3 を書く |
ホスト側の Mac にもキャッシュが残る(4 章) |
| Windows | RAMMap の -Es(待機リストを空にする) |
標準のコマンドが無い。 RAMMap が無ければ再起動のあと手で測る |
# macOS
sync && sudo purge

# Linux
sync && echo 3 | sudo tee /proc/sys/vm/drop_caches
Windows の手順は、ほかの 2 つと同じものを落としている保証がありません。Windows の cold は、ほかの OS の cold より条件が緩いと思って読むことにしています。
2. Windows の cold は、黙って失敗する
Windows で 10GB のファイルを「キャッシュを落とした状態」で読んだ記録が 2.65 秒でした。3.8GB/s で、この機械の媒体には出ない速さです(改善記⑫)。
原因は権限でした。RAMMap は管理者権限で動かさないとキャッシュを落とせません。権限が足りなくてもエラーで止まらず、キャッシュ破棄が黙って失敗し、その後の「cold」がただの 2 回目として記録されます。秒数は普通に出るので、表を見ただけでは気づけません。
気づけたのは、素読みの速さを超えていたからです。上限を先に測っておくと、上限を超える数字は「速い証拠」ではなく「測り間違いの証拠」として読めます。
取り直した回では、キャッシュ破棄が 171 回きちんと走りました。cold と 2 回計は取り直した回の値だけを使い、前の回は丸ごと捨てています。 一部だけ差し替えると、同じ表の中に条件の違う行が混ざるからです。ついでに、10GB の uvf の 2 回目が 45.94 秒という外れ値も、取り直したら 29.25 秒(以前の版 v1.6.3 で 29.22 秒)になり、書きかけていた「Windows の 10GB には謎の遅さがある」という説明ごと撤回しました。
3. 「hot」は 1 つの状態ではない
2 回目(hot)は「直前に一度読んだ状態」のつもりでしたが、OS をまたぐと別の状態を指していました(改善記⑫)。
| 環境 | メモリ | 10GB の ripgrep・2 回目(秒) | |
|---|---|---|---|
| Mac | 32GB | 11.08 | メモリに載っていない |
| Windows | 16GB | 約 4.7 | 載った |
| Linux(仮想機) | 8GB | 17.18 | 載らない |
Windows の方がメモリは少ないのに、10GB が載りました。空きメモリは総量ではなく、そのとき何が使われていないかで決まります。 hot は「どれだけキャッシュに残っているか」という連続した量で、ここをそろえずに 10GB の 2 回目の倍率を環境どうしで並べると、キャッシュの当たり外れを性能の差として書くことになります。
そこで、10GB の 2 回目は環境どうしで比べないと決め、いまの 3OS テストでは 実メモリの 6 割を超えるファイルは cold だけ測る決まりにしています(3OSテスト#0)。
4. 仮想機の Linux は「Linux の数字」ではない
Linux は VMware Fusion の仮想機(ゲスト)で測っています。仮想化の分が秒に乗るので、「Linux 実機ならこうなる」とは書けません。 しかも仮想機の中でキャッシュを落としても、ホスト側の Mac には別のキャッシュが残ります。 いまは、仮想機の cold を作るときにホスト側の purge も一緒に走らせています(--cold-hook)が、ホスト側の揺れが完全に消えるとは言えません(3OSテスト#0)。
コアの数で、結果の形そのものも変わりました。2 コアの仮想機では、uvp の 3GB・検索 7 種の 2 回計が ripgrep と互角(ripgrep の方が 1.01 倍速い)でした。Mac・Windows では 1.75 倍・1.97 倍速かった項目です(改善記⑫)。uvp は索引(.uwvz、圧縮形式+索引)を展開するのに CPU を使うので、コアが少ないと、読む量が減る利点と引き換えが成り立たなくなります。
5. 秒は OS をまたいで並べず、比だけを並べる
3 台は CPU・メモリ・ディスクがすべて違います。そこで、それぞれの機械の上で「ripgrep の時間 ÷ こちらの時間」を出し、その比だけを並べています(1 より大きければこちらが速い。1.5 倍未満は「同等」)。
検索 7 種(素の検索・-i・-E・行頭つきの -E・-E -i・-v・-E -v)の 1 回目+2 回目の合計です(Wide Field⑬)。
ripgrep の時間 ÷ uvf の時間(倍) |
mac | Windows | Linux |
|---|---|---|---|
| 3GB | 1.00 | 1.48 | 1.31 |
| 10GB | 1.16 | 1.90 | 1.13 |
| 50GB | 1.13 | 2.47 | 1.33 |
Mac だけを見ていると「uvf は ripgrep と同等」で終わります。Windows では同じ uvf が 1.5〜2.5 倍速く出ました。ただしこれは「Windows の方が UwView に有利」ではなく、Windows のこの機械では ripgrep の 1 回目が遅かったと読むのが正しい読み方です。比は、相手と自分の両方で決まります。
総合(96 項目・uvf+uvp)は mac 2.49 倍・Windows 3.42 倍・Linux 1.88 倍でした。この 3 つの数字も、横に並べて「どの OS で一番効くか」を読むためのものではありません。
6. 速さの前に、答えと除外の規則をそろえる
速く終わっても答えが違えば、速いとは言えません。テスト一式では、ケースごとに終了コード・ヒットした行の数・(大事なところでは)行番号そのものを正解として持たせ(cases.json)、全部一致したときだけ合格にしています。終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です(3OSテスト#0)。
| mac | Windows | Linux | |
|---|---|---|---|
| 入力の種類(文字コード・圧縮 7 形式・空のファイルなど) | 66 合格 | 66 合格 | 66 合格 |
| 複数ファイル | 36 合格 | 34 合格・2 省略 | 36 合格 |
除外の規則(.gitignore など) |
43 合格 | 43 合格 | 43 合格 |
| 速さの比較での出力の突き合わせ | 不一致 0 | 不一致 0 | 不一致 0 |
(Wide Field⑬)
除外の規則も、答えの一部です。 .gitignore の読み方が ripgrep と違えば、探すファイルが違い、件数が違います。件数が違えば、どちらが速いかの比較そのものが崩れます。そこで、読むファイル・強さの順番・! の取り消しまで ripgrep 15 に合わせ、rg --files と一覧が一致することを 43 項目・3 つの OS で確かめました(Wide Field⑦)。
ここで引っかかったのが、.gitignore は git のリポジトリーの中でだけ効くという ripgrep の決まりです。.git フォルダーごと複製していない写しでは、.gitignore を置いても git ではないので読まれません。これは実際にテストで引っかかりました。
巨大なデータは配布せず、種を固定した生成器で作り、SHA-256 で照合しています。x86_64 と aarch64 で同じバイト列になることも確かめました(3OSテスト#0)。どの OS でも同じファイルを探していることを、速さより先に保証するためです。
7. テスト機の設定・道具・ビルドの違いが、結果に入る
3 台で流して見つかったのは、製品の違いより先に、テスト機の違いでした(Wide Field⑬)。
- 設定ファイル: Windows の
uvfのスレッドは 4 本でした。既定(論理プロセッサの数まで)ではなく、テスト機の設定ファイルにそう書いてあったからです。 - 道具の有無: Windows の 2 件の省略は、テスト機に Python が無く「zip を作る手段がない」ためでした。製品の問題ではありません。
- 相手の版: ripgrep は mac・Windows が 15.2.0、Linux は 15.1.0 です。
- ビルドの形: Mac と Linux の配布物は NativeAOT(前もって機械語にした形)ですが、Windows は「中身を 1 つにまとめた実行ファイル」で、起動のたびに準備が要ります。NativeAOT はその OS の上でしかビルドできないので、Mac から Windows 用を作るとこうなっていました。
そして、Mac では出なかった負けが Windows で見つかりました。 圧縮ファイルを rg -z と uvf で探した 1 回目+2 回目の合計です。
| 3GB の圧縮ファイル | mac | Windows | Linux |
|---|---|---|---|
| xz | ripgrep の方が 1.09 倍速い | ripgrep の方が 1.69 倍速い | uvf が 1.06 倍速い |
| lz4 | uvf が 1.12 倍速い |
ripgrep の方が 1.51 倍速い | uvf が 1.38 倍速い |
| gz | uvf が 1.30 倍速い |
uvf が 1.37 倍速い |
uvf が 2.08 倍速い |
1.5 倍を超えて負けたのは、Windows の xz(3GB)・zst(1GB)・lz4(1GB・3GB)の 4 か所です。見立ては、①Windows 版が NativeAOT でなく起動のたびに固定の時間が乗る、②スレッドの設定が 4 本、③ウイルス対策の検査、の 3 つですが、この記事の元になった時点では、どれも確かめていません。 確かめ方(設定を消して流し直す・Windows の上で NativeAOT のビルドを作る)だけを決めてあります。
負けているところ・書けないこと
- Windows の xz・zst・lz4 で、
uvfが ripgrep より 1.5〜2.1 倍遅い(7 章)。原因は見立てのままです。 - 2 コアの Linux(仮想機)では、
uvpの 1 回目(索引を作る分)が重く、zst・lz4・平文の 2 回計で ripgrep の方が 1.2〜1.4 倍速い結果でした(Wide Field⑬)。1 回しか探さないならuvfか ripgrep で足ります。 - Linux の値は仮想機の値です。 Linux 実機の性能としては読めません。
- Windows の cold は、ほかの OS より条件が緩いと考えています(1 章)。
- 秒は OS をまたいで比べていません。 同じ表に 3 つの OS が並んでいても、比べているのは各機械の中の比です。
持ち帰れること
- cold の作り方は OS ごとに書き、成功したかを確かめる。 失敗しても止まらない手順は、上限を超える数字で見つけるしかありません。
- hot は状態ではなく量。 メモリに対するファイルの大きさを決めてから測る。
- 環境をまたぐときは、比だけを並べる。 比は相手と自分の両方で決まる。
- 速さより先に、答えと「何を探しているか」をそろえる。 終了コード・件数・行番号、それに除外の規則まで。
- 負けは、いつもと違う機械で見つかる。 1 台で「速い」と書かない。
元の記事
- 速さの話をする前に決めること — 3OSテスト#0
- 同じテスト一式を mac・Windows・Linux で流したら、Windows で負けが見つかりました — Wide Field⑬
- Windows の「cold」が嘘だったので全部測り直した — 改善記⑫
- ripgrep と同じ除外規則にそろえた — Wide Field⑦
テストの手順書と結果の様式は、公開リポジトリーの testsuite フォルダーにあります。
あわせて読む
UwView を試す
- UwView のダウンロード(Windows・macOS・Linux)/GitHub の Releases
- ソースコード(GitHub)
- 同じファイルに何度もたずねるなら、索引を持つ UwView Pro(1 ライセンスで全 OS)
- 2 つのファイル・フォルダーを比べるなら、同じエンジンを使う姉妹ツール UwDiff
※ 数字はすべて開発者本人が測ったもので、測った環境・版・日付の条件付きです。環境によって変わります。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。