UwView(ユーダブリュービュー) は、巨大なログ・テキストを開いて探す Windows・macOS・Linux 用のビューアです。ファイルをメモリに載せずに読むので、10GB・50GB・258GB でもすぐに開き、gz・zst など 7 形式の圧縮ファイルや Word・Excel・PDF の中も検索できます。無料版(CLI は uvf)と、索引で 2 回目以降の検索を速くする有料版 UwView Pro(uvp)、2 つのファイル・フォルダを比べる姉妹ツール UwDiff(uvd)があります。
日本語のログには、英語圏の記事にほとんど書かれていない工程が 1 つ余分にあります。そのバイト列を、どの文字コードとして読むかを決める工程です。ここで詰まると、cat で画面が壊れ、自動判定は外れ、grep は動いているのに 0 件を返します。この場面について、このサイトではこれまで 4 本の記事を書いてきました。2 本は罠と切り分けの手順、2 本は UwView の検索の中で文字コードをどう扱うようにしたかの記録です。
このページは、その 4 本の答えを 1 か所にまとめたものです。比べた相手は iconv・nkf・grep・ripgrep です。数字はすべて開発者本人の実測なので、その前提で読んでください。負けている場面と、まだ読めない文字も、そのまま書きます。
- 先に結論: 化ける・当たらないの多くは「バイト列をどう読むか」を道具が先に決めてしまうことから起きる。確認は原本を開いたまま読み方を切り替えるのが早い。同じファイルを何度も探すなら、変換を索引を作る 1 回に閉じ込めると、2 回目からは元の文字コードに関係なく同じ速さになる
- 1. cat した瞬間に画面が壊れる — Shift-JIS と UTF-8 の端末
- 2. 自動判定が外れる — 先頭だけ見て決める、EUC-JP と CP932 が似ている
- 3. 先頭のバイトで挙動が変わる — BOM と UTF-16
- 4. 日本語が検索で当たらない — 文字コード・表記ゆれ・異体字の 3 つの層
- 5. もっと古い層と新しい層 — EBCDIC 疑い、改行の無いファイル、絵文字で行がずれる
- 6. 索引の中を UTF-8 にそろえる — 変換を 1 回に閉じ込めた実測
- 7. -i の大小無視と、ケルビン記号 U+212A
- 負けているところ・同等のところ
- 各回を読む
- リンク
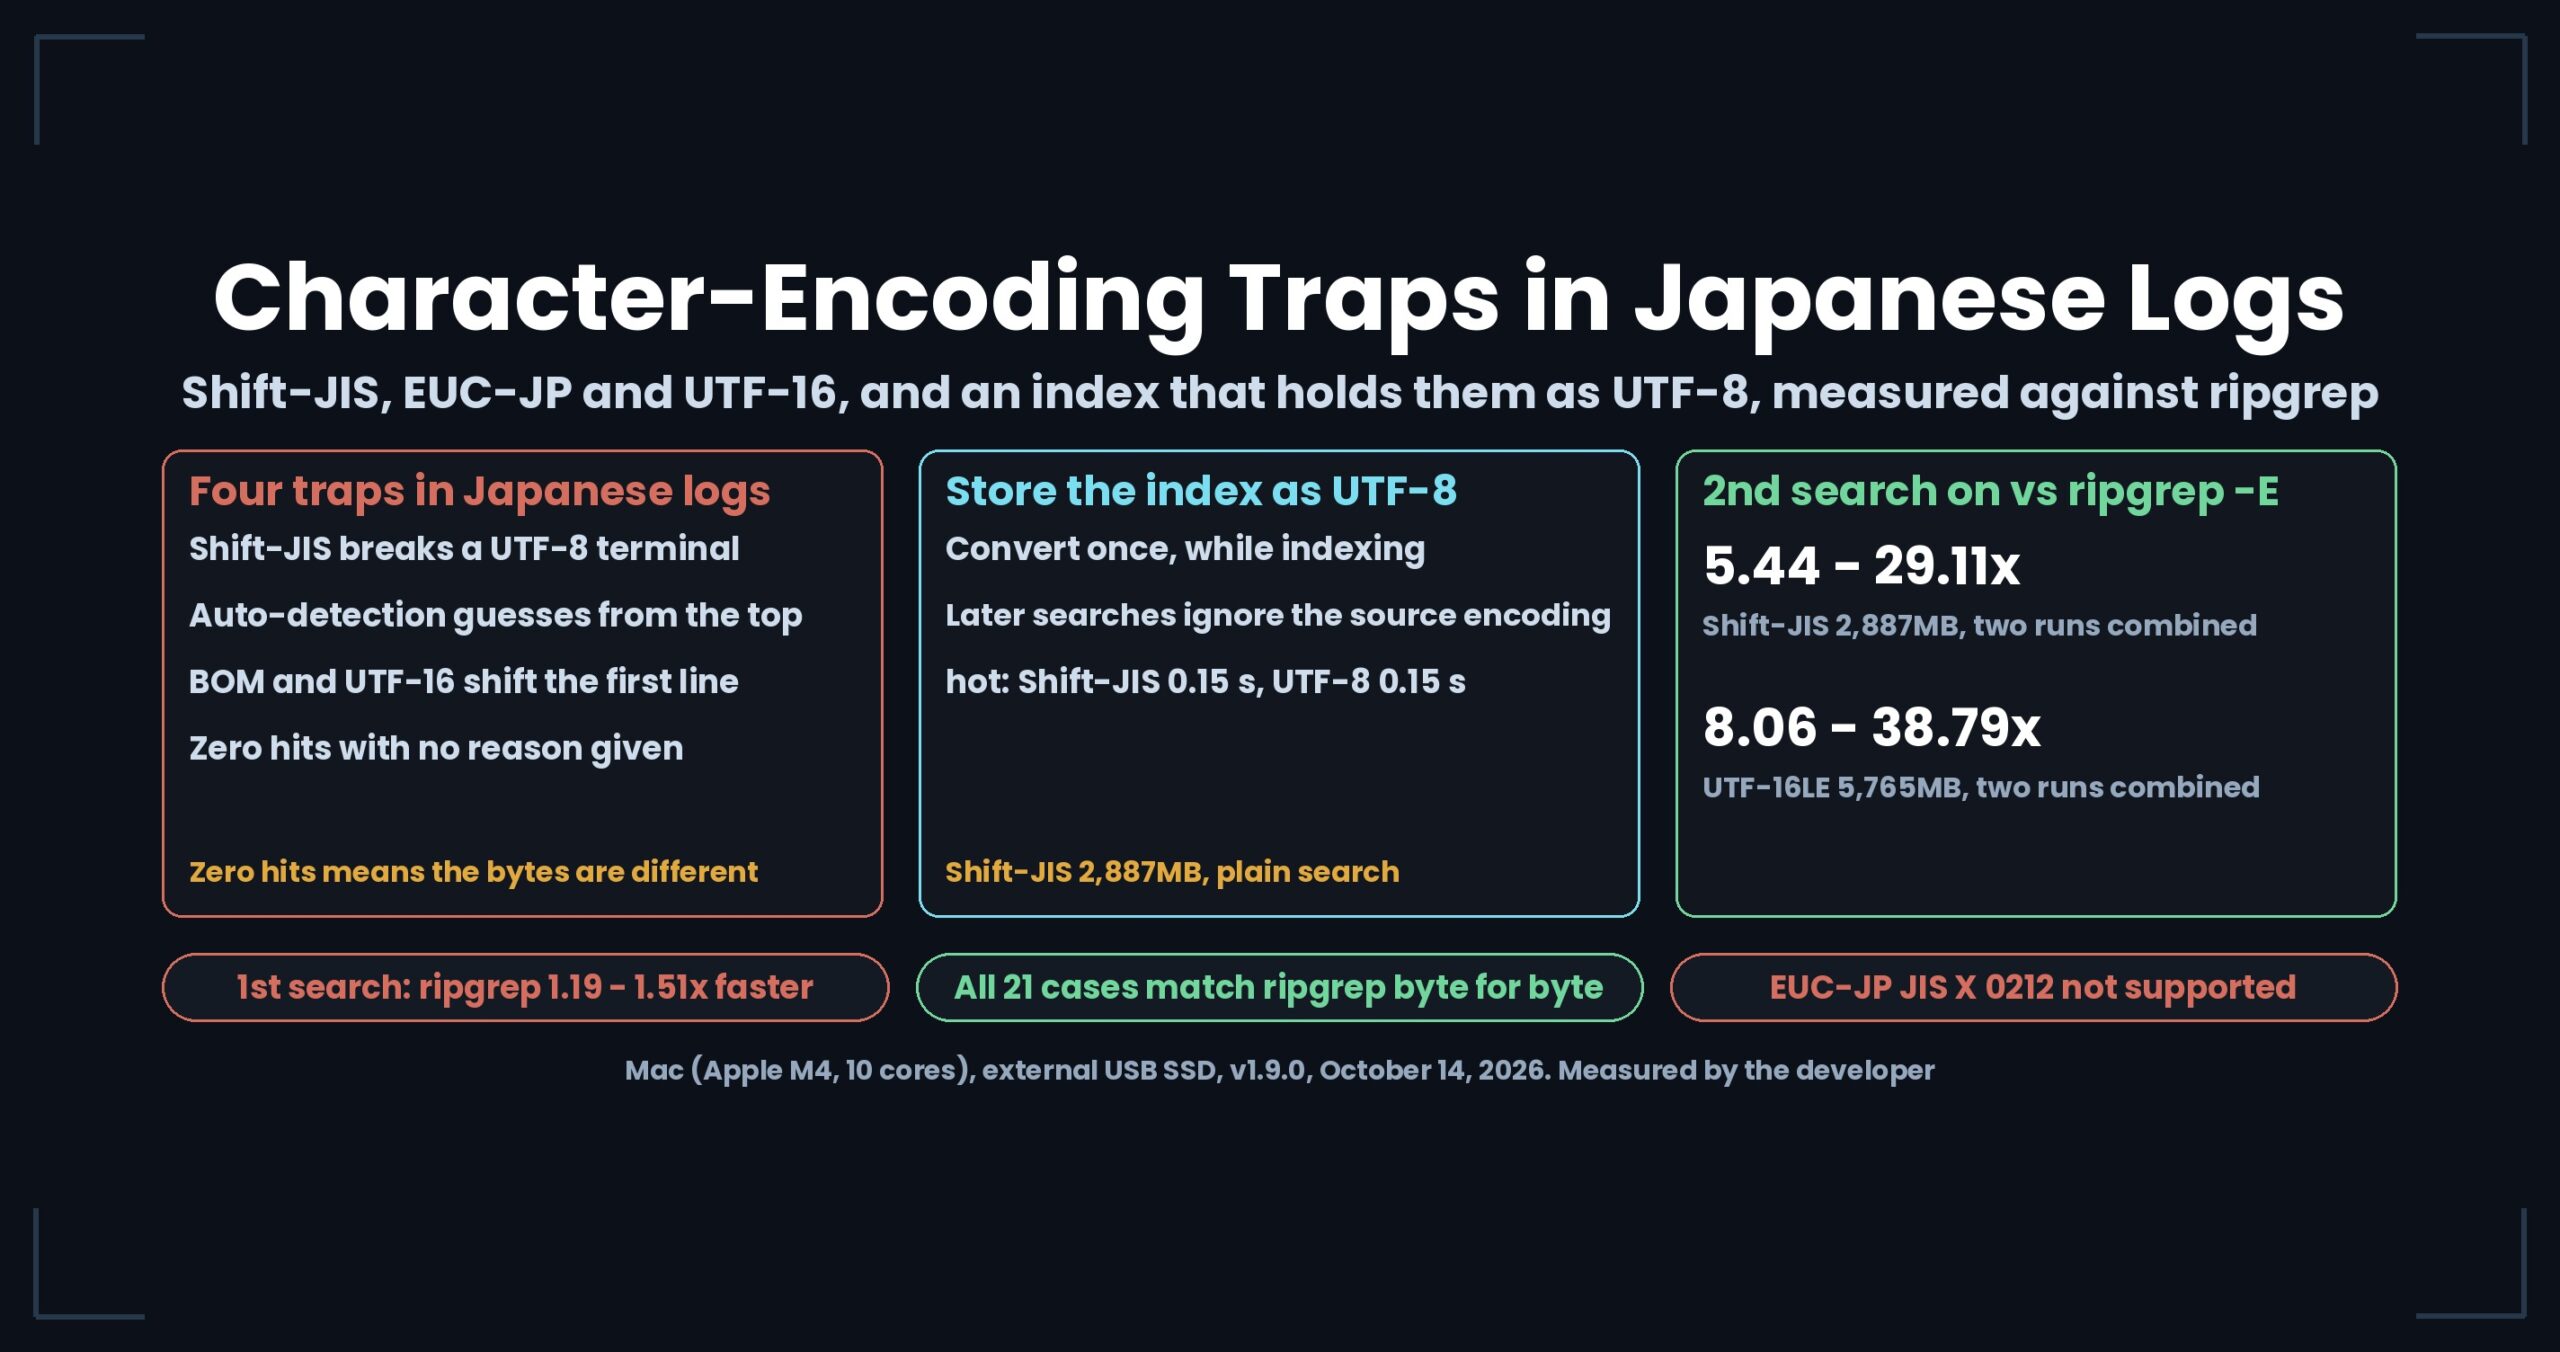
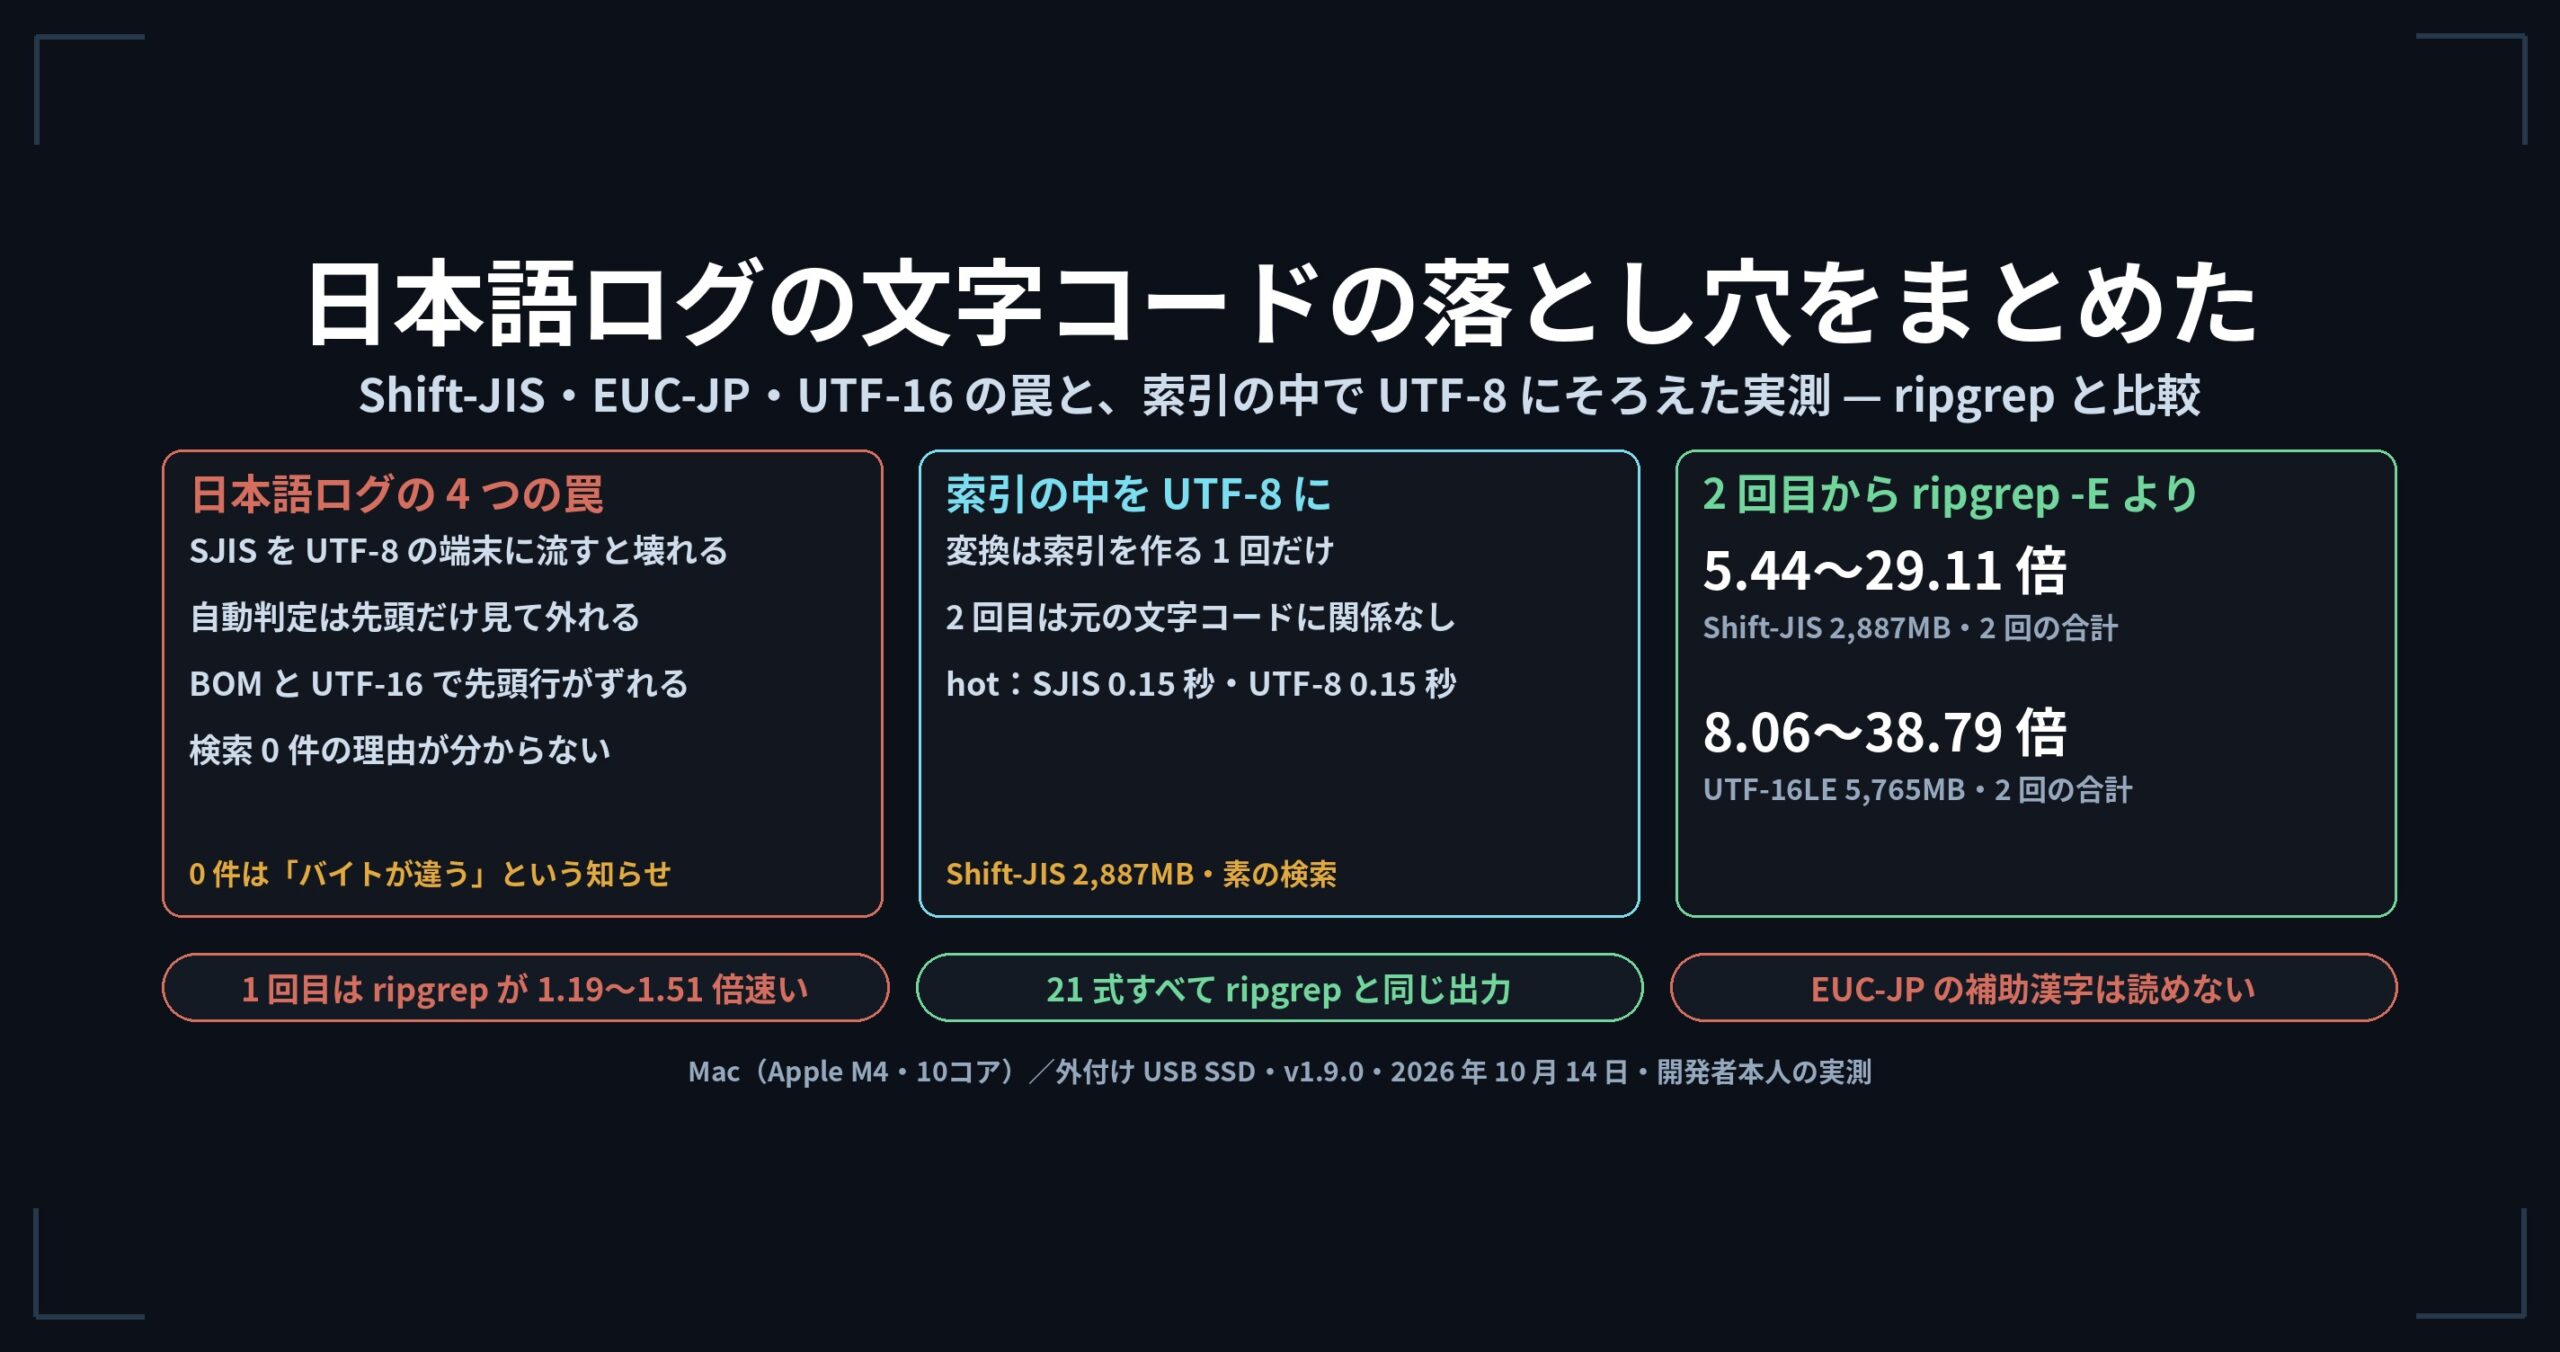
先に結論: 化ける・当たらないの多くは「バイト列をどう読むか」を道具が先に決めてしまうことから起きる。確認は原本を開いたまま読み方を切り替えるのが早い。同じファイルを何度も探すなら、変換を索引を作る 1 回に閉じ込めると、2 回目からは元の文字コードに関係なく同じ速さになる
- 罠は 4 つに分けられます。 Shift-JIS を UTF-8 の端末に流して画面が壊れる、自動判定が外れる、先頭の BOM や UTF-16 で先頭行だけ挙動が変わる、検索が 0 件なのに理由が分からない。どれも、変換して別のファイルを作るより、原本のまま読み方を切り替えて見比べるほうが早く決着します。
- 0 件は、検索が失敗した合図ではありません。 バイト列が思っていたものと違う、という静かな知らせです。0 件が返ってきたら、まず先頭のバイトを見ます。
- UwView Pro(巨大ファイルを、いつでも瞬時に)は、索引の中を UTF-8 にそろえました。 変換は索引を作る 1 回だけになり、2 回目からは Shift-JIS 2,887MB で ripgrep(
-E shift_jis)の 5.44〜29.11 倍、UTF-16LE 5,765MB で 8.06〜38.79 倍でした。索引を作る 1 回目は ripgrep の方が 1.19〜1.51 倍速いので、1 回だけ探すなら ripgrep で足ります。
1. cat した瞬間に画面が壊れる — Shift-JIS と UTF-8 の端末
Windows の業務システムのログを、手元の macOS・Linux の端末で cat すると、文字が化けるだけでなく端末の表示そのものが崩れることがあります(詳しくはこの記事)。Shift-JIS(実務では CP932)の 2 バイト文字は、2 バイト目が ASCII の文字と重なる作りです。「ソ」「表」「能」の 2 バイト目は 0x5C(バックスラッシュ)と同じバイトです。
- 変換して読むなら
iconv -f CP932 -t UTF-8 app.log | less。-f Shift_JISではなく-f CP932を指定します。NEC 特殊文字(①・㈱)や IBM 拡張漢字(﨑・髙)は素の Shift_JIS の規格の外なので、そこで変換が止まります。 - ただし、変換した先はもう原本ではありません。
//IGNOREで不正なバイトを捨てると、それこそが手がかりだった場合に消えてしまいます。数 GB のログを毎回パイプに流す待ち時間も残ります。
2. 自動判定が外れる — 先頭だけ見て決める、EUC-JP と CP932 が似ている
文字コードの判定は、バイトの分布から推測するしかありません。外れる条件はだいたい決まっています(記事・続編)。
| 外れる条件 | 起きること |
|---|---|
| 先頭が ASCII だけ | 日本語が数万行先にしか出ないログで、先頭を見た判定が「UTF-8」と決めてしまう |
| EUC-JP と CP932 が似ている | どちらで変換しても「2 バイトで、それらしく」化ける。EUC-JP の半角カナ(0x8E+1 バイト)が多いほど、誤変換がもっともらしくなる |
| 途中で変わっている | サーバのロケールを ja_JP.eucJP から ja_JP.UTF-8 に変えた日を境に、同じファイルの途中で文字コードが変わる。iconv -f は 1 ファイルに 1 つしか指定できない |
| どちらとしても正しい | あるバイト列が UTF-8 としても CP932 としても通ることがある。検査は候補を減らせても、決めきれない |
確かめ方は、file・nkf --guess・chardetect の 3 つに聞いて割れたら混在を疑う、日本語が最初に出る位置を grep -n -P '[^\x00-\x7F]' app.log | head -1 で探してそこを見る、先頭だけ head -c 4000 app.log | iconv -f EUC-JP -t UTF-8 >/dev/null に通してみる、などです。それでも本当にやりたいのは、読み方を切り替えて化けが直るかを目で見ることです。切り替えるたびに 12GB を読み直す道具では、この往復が回りません。
3. 先頭のバイトで挙動が変わる — BOM と UTF-16
CSV のパーサが 1 行目だけ落ちる、grep '^timestamp' が当たらない。原因は、先頭に付いた UTF-8 の BOM(EF BB BF)の 3 バイトです。表示では見えません。Excel を通したファイルでよく混ざります。
UTF-16 はさらに手前で止まります(続編)。ASCII の 1 文字が 2 バイトになるので、E は 0x45 ではなく 0x45 0x00 です。grep Error が探すバイト列はファイルの中に一度も現れず、0 件が返ります。grep は「Binary file matches」とだけ言い、wc -l も狂います。Windows のイベントログを PowerShell で書き出すと、既定で UTF-16LE になります。
- 先頭を見る癖が、いちばんの防御です。
head -c 16 access.csv | xxdでefbbbf、xxd app.txt | head -3でFF FE(UTF-16LE)が見えれば決まります。 tr -d '\000'で NUL を落とすと ASCII だけ読めるようになりますが、日本語の部分は壊れ、しかも壊れたことが表示から分かりません。BOM をsedで消すのも、原本の書き換えです。
4. 日本語が検索で当たらない — 文字コード・表記ゆれ・異体字の 3 つの層
画面には「エラー」と出ているのに、「エラー」で探すと 0 件。日本語の検索は 3 つの層のどこでも外れ、どの層で外れたのかを検索結果は教えてくれません(記事)。
| 層 | 外れ方 | 汎用の手当て |
|---|---|---|
| 文字コード | UTF-8 で打った「エラー」と、CP932 で書かれた「エラー」はバイトが違う | 検索語のほうを変換する:grep "$(echo 'エラー' \| iconv -f UTF-8 -t CP932)" app.log |
| 表記ゆれ・正規化 | 半角カナと全角、NFC と NFD(macOS 由来の「が」が「か+濁点」になる) | uconv -x nfc で正規化してから探す(ファイルの書き換えになる) |
| 異体字・互換文字 | 髙/高、﨑/崎、ハイフン類の取り違え、波ダッシュ問題 | 検索語を漢字 1〜2 文字まで短くし、両方の書き方で探す |
grep -i は日本語の全角・半角には効きません。3 つとも、決め手は当たらなかった語のまわりを開いて、何が書かれているかを目で見ることです。
5. もっと古い層と新しい層 — EBCDIC 疑い、改行の無いファイル、絵文字で行がずれる
続編では、1998 年のログ、メインフレームから来たデータ、問い合わせフォームの絵文字まで広げました。
- EBCDIC を疑って
dd conv=asciiを通すと、二重に壊れます。 元が CP932 なら、変換表を当てた時点で元のバイトは失われます。最初に打つべきはxxd data.dat | head -20です。ただの CP932 だと分かっても、汎用機まわりのファイルは 1 レコード 250 バイトのような固定長で改行が無く、SO/SI の制御文字で 1 バイトと 2 バイトの領域が切り替わることがあります。行を単位に動くgrep・awk・lessの前提が崩れます。 - 絵文字の行で行番号と桁がずれます。 「1 文字」の数え方が、バイト数・コードポイント数・UTF-16 の単位数・見た目の文字数の 4 つあるからです。行番号がずれる主な原因は、絵文字そのものより、エスケープされずにログに入ったユーザー入力の改行や、片方だけになったサロゲートです。
LC_ALL=Cにすると速くなる代わりに、日本語で探せなくなります。
4 つの場面とも、詰まるのは「もう一度、別の読み方で見たい」と思った瞬間でした。UwView の画面は UTF-8・Shift-JIS(CP932)・EUC-JP・UTF-16 を自動で判定し、外れたときは索引を作り直さずにその場で切り替えて見比べられます。
6. 索引の中を UTF-8 にそろえる — 変換を 1 回に閉じ込めた実測
画面とは別に、検索コマンドの速さにも文字コードの問題が残っていました。前の版の .uwvz(uvp 用の圧縮形式+索引)は元の文字コードのまま中身を持っていたので、Shift-JIS のファイルは検索のたびに 3GB 分の変換が走っていました。前の版(1.8.1.9)で Shift-JIS 2,887MB の 7 パターンを 2 回ずつ測ると 2.53〜4.41 秒です。
v1.9.0 “Full Spectrum” で、.uwvz の中身を Shift-JIS・EUC-JP・UTF-16 のときも UTF-8 に変えて持つようにしました(Full Spectrum①)。相手は ripgrep 15.2.0 に -E <文字コード> を付けて、同じ文字コードを正しく探させた値です。測ったのは 2026 年 10 月 14 日、Mac(Apple M4・10コア・メモリ 32GB・外付け USB SSD)です。
| 索引を作る 1 回目 | uvp(秒) |
ripgrep -E(秒) | 結果 | .uwvz の大きさ |
|---|---|---|---|---|
| Shift-JIS 2,887MB | 4.93 | 3.35 | ripgrep の方が 1.47 倍速い(同等) | 262.1MB(元の 9.1%) |
| EUC-JP 2,887MB | 5.01 | 3.32 | ripgrep の方が 1.51 倍速い | 262.1MB(元の 9.1%) |
| UTF-16LE 5,765MB | 7.76 | 6.53 | ripgrep の方が 1.19 倍速い(同等) | 262.3MB(元の 4.5%) |
| 2 回目から(Shift-JIS 2,887MB・cold と hot の合計) | ripgrep(秒) | uvp(秒) |
ripgrep ÷ uvp(倍) |
|---|---|---|---|
素の検索 東京 |
4.44 | 0.48 | 9.25 |
-i 大小無視 HIGHWAY |
4.79 | 0.79 | 6.06 |
-E 正規表現 |
4.69 | 0.81 | 5.79 |
-E 行頭つき |
4.60 | 0.69 | 6.67 |
-E -i 併用 |
4.74 | 0.85 | 5.58 |
-v 当てはまらない行 |
6.53 | 1.20 | 5.44 |
-E -v 併用 |
8.15 | 0.28 | 29.11 |
- 3 つの文字コードをまとめると、2 回分の合計で Shift-JIS 5.44〜29.11 倍・EUC-JP 5.38〜23.26 倍・UTF-16LE 8.06〜38.79 倍です。
-E -vの行だけ桁が違うのは文字コードの話ではなく、ヒットしない行のかたまりを読まずに飛ばす別の仕組みが効いているためで、文字コードの手当てだけで説明できるのは 5.44〜9.25 倍のほうです。 - 出力は 7 パターン × 3 文字コード=21 式すべてで、ripgrep と 1 バイトも同じでした。
- hot だけを見ると、素の検索は Shift-JIS で 0.15 秒、UTF-8 の元ファイルでも 0.15 秒でした。索引の中が UTF-8 なら、元が Shift-JIS だったかどうかは 2 回目からの速さに出ません。
- 前の版では、6GB の UTF-16 を元の文字コードのまま探すと
Specified argument was out of the rangeで落ちる不具合もありました。1,000MB までは正しく動くので気づきにくいものでした。
7. -i の大小無視と、ケルビン記号 U+212A
文字コードに近い話をもう 1 つ。無料版の uvf で -i(大文字と小文字を無視)を付けると、3GB の hot の検索が ripgrep に 4.3 倍負けていました(改善記③・v1.6.3)。全部の行を UTF-16 の文字列に作り直してから正規表現に当てていたためです。
バイトのまま a と A を同じに扱えば速くなりますが、Unicode の大小無視は ASCII の中に閉じていません。そこで BMP の全 65,536 文字を a〜z・A〜Z と突き合わせて数えたところ、ASCII の英字と同じに扱われる文字は k に対するケルビン記号 U+212A の 1 文字だけでした。k・K を含む語のときだけ遅い道に回し、残りはバイトのまま探すようにしています。ripgrep の -i も U+212A を同じに扱い、grep -i は扱いませんでした。
| 3GB・hot | 直す前(秒) | 直した後(秒) | ripgrep(秒) |
|---|---|---|---|
| 素の検索 | 1.20 | 0.50 | 0.33 |
-i |
2.72 | 0.66 | 0.63 |
-E -i |
9.36 | 1.67 | 0.60 |
バイトのまま探してよいのは、ASCII がそのままのバイトで現れる文字コードだけです。 Shift-JIS の「ソ」(83 5C)の 2 バイト目はバックスラッシュと同じバイトで、UTF-16 の改行は 0A 00 です。この 2 つは文字コードを見て、従来の道に回しています。
負けているところ・同等のところ
- 索引を作る 1 回目は、ripgrep の方が速いです。 Shift-JIS で 1.47 倍(同等)、EUC-JP で 1.51 倍、UTF-16LE で 1.19 倍(同等)。1 問しか探さないなら
ripgrep -Eで足ります。 - EUC-JP の補助漢字(JIS X 0212)は、いまも読めません。 「・」になります。
-extractで戻したものは、必ずしもバイト単位で一致しません。 同じ字に番号が 2 つある字(髙・﨑・№・Ⅲ など)は標準の番号で、壊れたバイトは「・」で戻ります。ハッシュで照合する用途には向きません。-extractは作っている途中の版で一度遅くなり(前の版の方が 2.29 倍速い状態)、並列にして直しました。-E -iは、3GB の hot でまだ ripgrep に 2.8 倍負けています(0.60 秒 対 1.67 秒・v1.6.3)。50GB では 2 回の合計で 1.05〜1.10 倍の同等です(v1.6.6)。- 文字コードの判定と手動の切り替えは、画面(GUI)の機能です。 コマンド(
uvf・uvp)は当たりを取る側に向いています。 - ここに並べた秒は Mac の値です。 OS をまたいで秒を比べてはいません。
各回を読む
- 日本語ログが読めない夜 — 文字コード4つの罠と切り分け手順
- EUC-JP・UTF-16・EBCDIC疑惑 — レガシー文字コードを2026年に読む
- Shift-JIS・EUC-JP・UTF-16 を索引の中で UTF-8 にそろえた — Full Spectrum①:ripgrep の -E より2回目から5.4〜38.8倍、ただし1回目は ripgrep が1.2〜1.5倍速い
- 自作CLIの -i が ripgrep に4.3倍負けていた — 改善記③:文字に戻さずバイトのまま畳んで 2.72秒→0.66秒(例外は U+212A だけ)
リンク
- 「巨大ファイルが開けない」の答えをまとめた(このまとめの 1 本目)
- UwView のダウンロード(Windows・macOS・Linux)
- UwView Pro(1 ライセンスで全 OS)
- ベンチマークのまとめ
※ 数字はすべて開発者本人が測ったもので、測った環境・版・日付の条件付きです。環境によって変わります。