2.65秒で、読めるはずがありませんでした。
Windows で 10GB のファイルを「キャッシュを落とした状態」で読んだ記録が 2.65秒。外付けでも内蔵でも、10GB を 2.65秒で読める媒体はこの機械にありません。
数字が速すぎる。ということは、測っているものが違います。
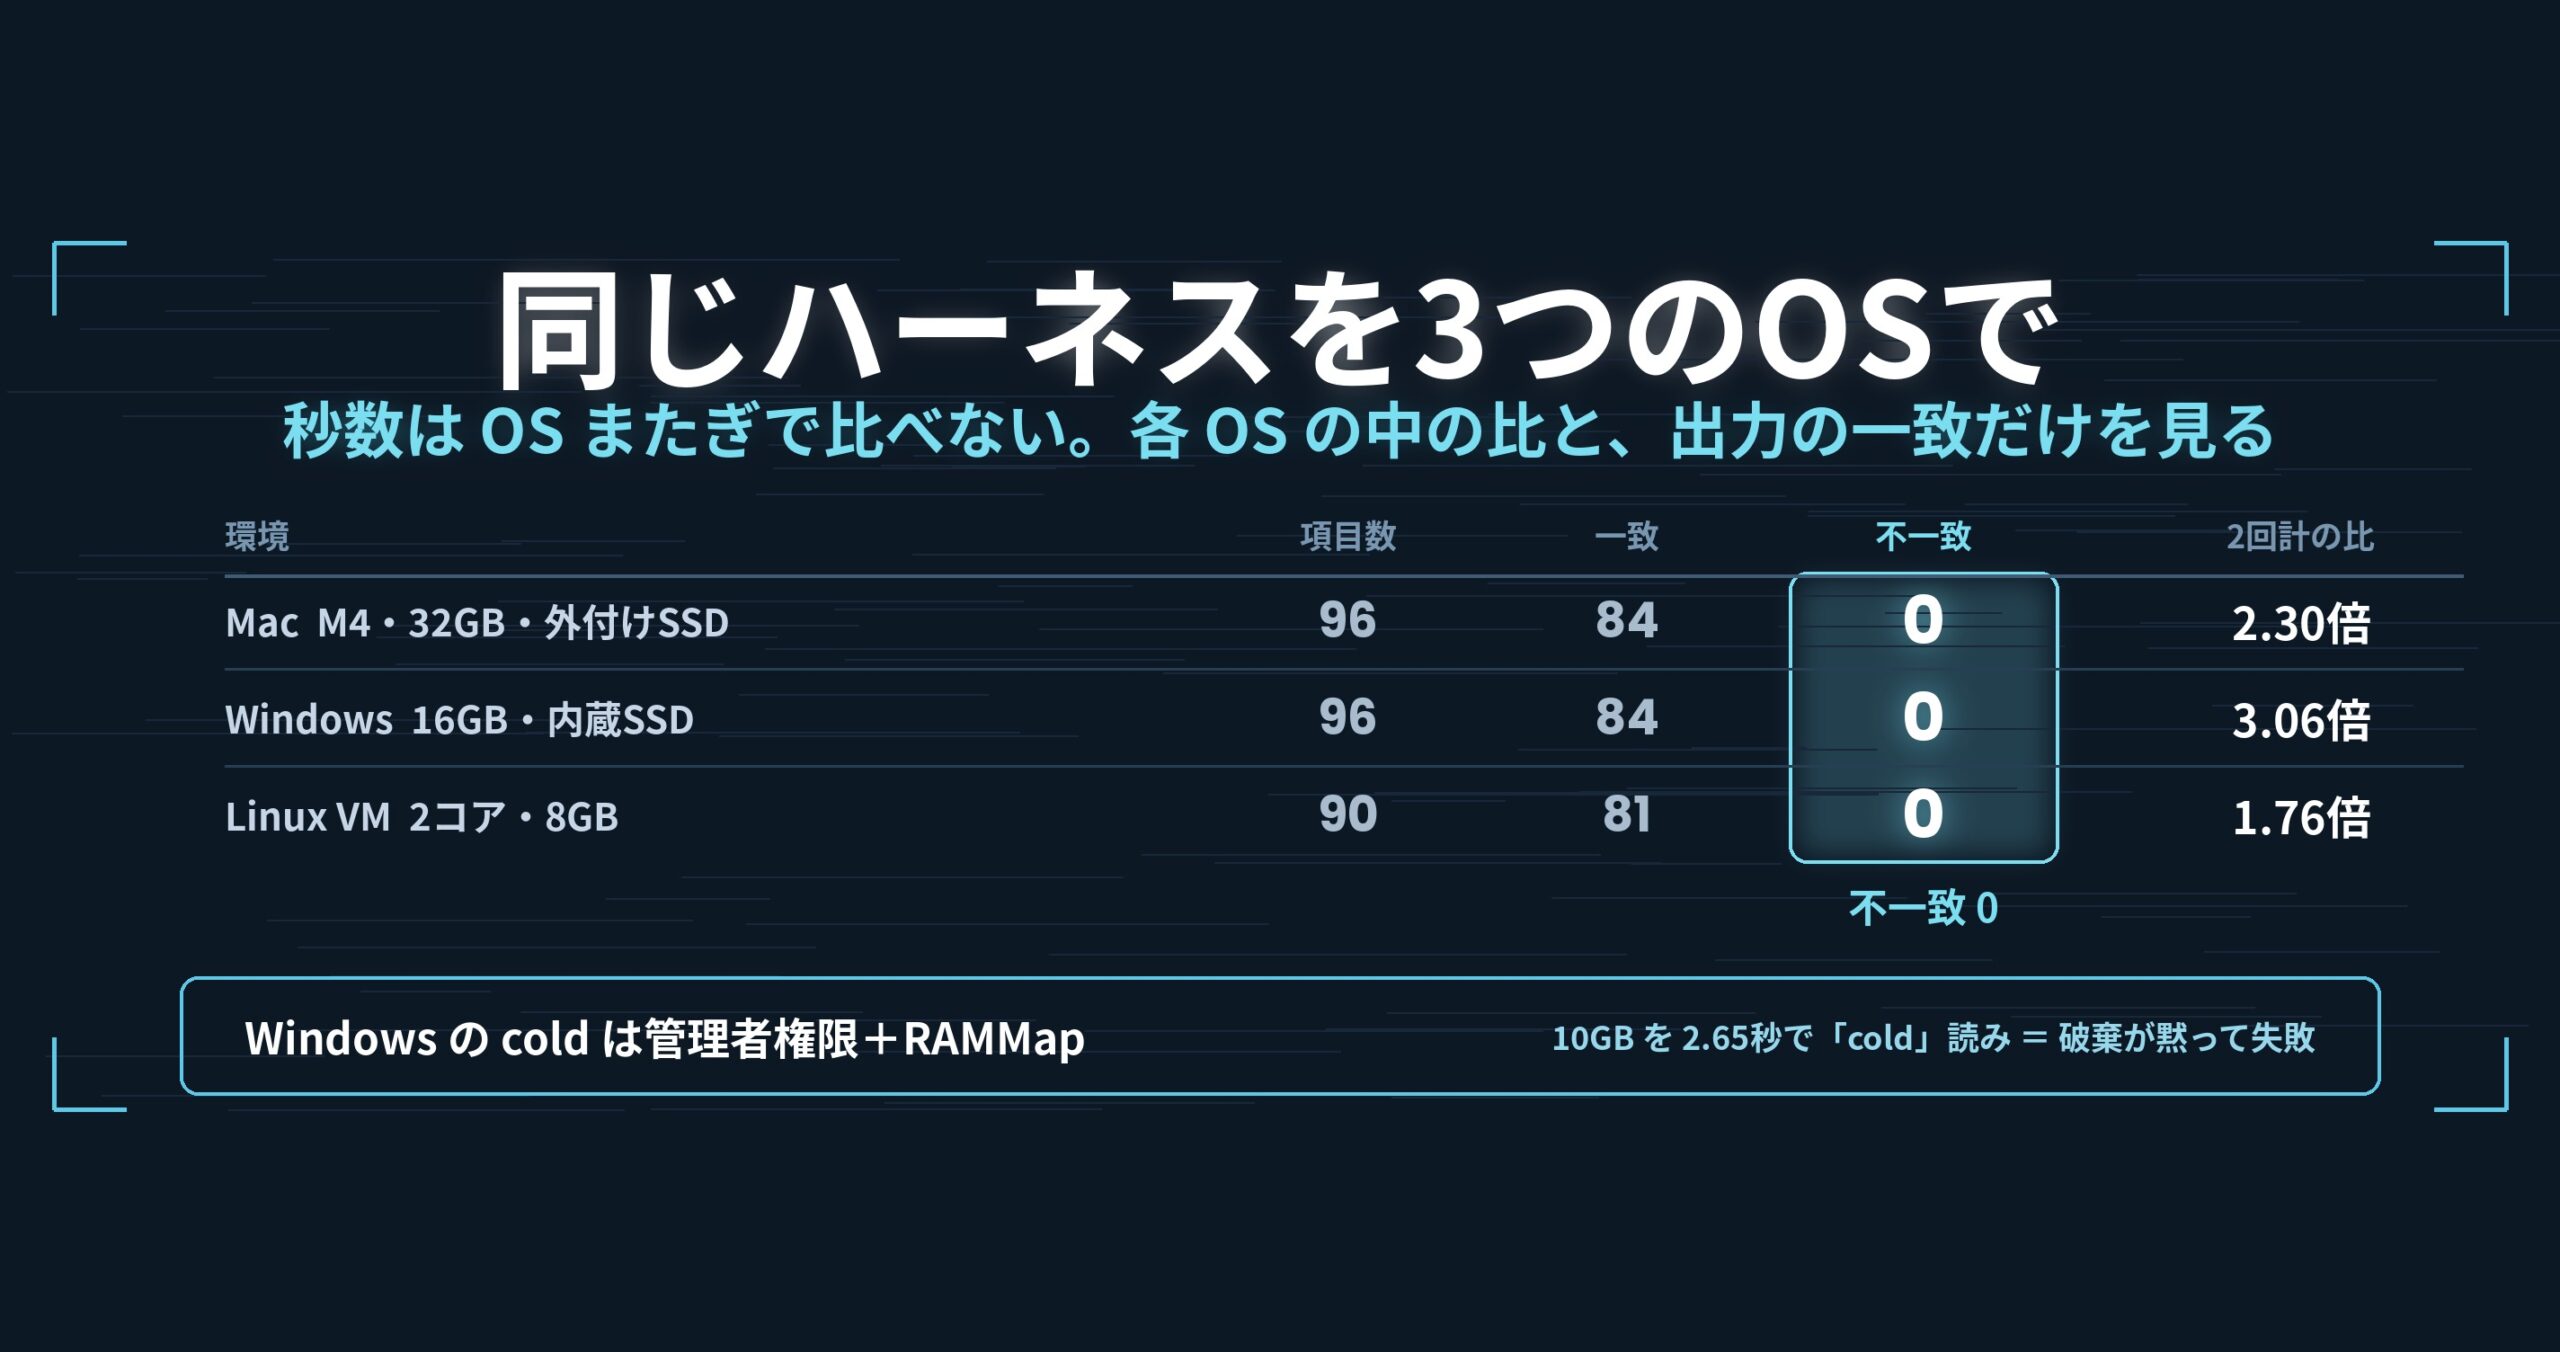
- 先に結論: 同じ計測ハーネスを Mac・Windows・Linux VM の 3環境で回しました。比較できた項目は Mac 96・Windows 96・Linux 90(Linux は gz 入力なし)、出力の不一致は 3環境とも 0 件(ripgrep・sed との突き合わせ)。全項目の合計(2回計)は Mac 2.30倍・Windows 3.06倍・Linux VM 1.76倍。ただしこの 3つの数字は同じ土俵ではありません——機械も媒体も別なので、秒数を OS またぎで比べることはせず、各 OS の中での比だけを書きます。そして最大の学びは速度ではなく手順のほうで、Windows は管理者権限と RAMMap が無いとキャッシュ破棄が効かず、「cold」の記録が丸ごと無効になります。実際に 1回分を捨てて取り直しました。v1.6.6 “First Light”・ripgrep 15.2.0(Linux は 15.1.0)。詳細は記事末尾。
- 問題: 1つの OS で測った数字は、1つの OS の話でしかない
- ハーネスの形: 1項目につき cold と hot を 1回ずつ
- 踏んだ罠(1): Windows の「cold」は、管理者権限が無いと成立しない
- 踏んだ罠(2): 「hot」は 1つの状態ではない
- 数字: 各 OS の中での比だけを並べる
- 外れ値の扱いを、先に決めておく
- 正直に書いておくこと
- 持ち帰れる一般論: 測定の手順は、測定結果より先に壊れる
- 使っている道具
- リンク
先に結論: 同じ計測ハーネスを Mac・Windows・Linux VM の 3環境で回しました。比較できた項目は Mac 96・Windows 96・Linux 90(Linux は gz 入力なし)、出力の不一致は 3環境とも 0 件(ripgrep・sed との突き合わせ)。全項目の合計(2回計)は Mac 2.30倍・Windows 3.06倍・Linux VM 1.76倍。ただしこの 3つの数字は同じ土俵ではありません——機械も媒体も別なので、秒数を OS またぎで比べることはせず、各 OS の中での比だけを書きます。そして最大の学びは速度ではなく手順のほうで、Windows は管理者権限と RAMMap が無いとキャッシュ破棄が効かず、「cold」の記録が丸ごと無効になります。実際に 1回分を捨てて取り直しました。v1.6.6 “First Light”・ripgrep 15.2.0(Linux は 15.1.0)。詳細は記事末尾。
この記事は「First Light」連載の第 12 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
問題: 1つの OS で測った数字は、1つの OS の話でしかない
ここまでの連載で出した秒数は、ほぼ全部が同じ Mac のものです。それで足りる場面もありますが、足りない場面もあります。
- 比較相手の ripgrep は、OS によって得意不得意が変わります
.uwvz(uvp用の圧縮形式+索引)を展開する処理は CPU を使うので、コア数が少ない機械では不利になります- キャッシュを落とす方法が OS ごとに違い、落ちたつもりで落ちていないことがあります
3環境で回すことにした理由は、速さを自慢するためではありません。Mac でだけ成り立っている結論が混じっていないかを確かめるためです。
ハーネスの形: 1項目につき cold と hot を 1回ずつ
各項目で、次の順に測ります。
sync(書き込みを吐き出す)- キャッシュ破棄(Mac は
sudo purge、Windows は RAMMap、Linux はdrop_caches) - 10秒待つ
- cold(1回目)
- hot(2回目・キャッシュが効いた状態)
「2回計」は cold + hot の合計です。1問目に索引を作る道具(uvp)と、毎回読み直す道具(ripgrep)を並べるには、1回目と 2回目を分けて記録したうえで、合計も出すのがいちばん誤解が少ないと考えています。片方だけ見せると、どちらの側にも都合のよい絵が作れてしまいます。
そして速さより先に、出力の一致を見ます。ripgrep や sed -n p と同じ入力を与えて、出た行が 1行ずれていないか。ここが合っていない道具の秒数には意味がありません。
踏んだ罠(1): Windows の「cold」は、管理者権限が無いと成立しない
冒頭の 2.65秒です。
Windows には、Mac の purge や Linux の drop_caches に当たる標準コマンドがありません。ファイルキャッシュを落とすには RAMMap のような道具が要り、しかも管理者権限で動かす必要があります。
権限が足りないとどうなるか。エラーで止まってはくれません。 キャッシュ破棄が黙って失敗し、その後の「cold」がただの 2回目として記録されます。秒数は普通に出るので、表を見ただけでは気づけません。
気づけたのは、物理的にあり得ない速さだったからです。10GB を 2.65秒なら 3.8GB/s。この機械の媒体には出ない値でした。第 9 回に書いた「素読みの帯域を超える数字は、速い証拠ではなく測定ミスの証拠」の、そのままの実例です。
取り直した run では、キャッシュ破棄が 171回きちんと走りました。cold と 2回計はその run の値だけを使い、前の run は捨てています。 一部だけ差し替えると、同じ表の中に条件の違う行が混ざるからです。
副産物: 外れ値が 1つ消えた
捨てた run には、10GB の uvf hot が 45.94秒という外れ値がありました。取り直したら 29.25秒。以前の版(v1.6.3)の 29.22秒とほぼ同じです。
再現しない値は、注記を書くのではなく消します。 常駐ソフトか発熱による一時的な揺れだったと判断し、「Windows の 10GB には謎の遅さがある」という書きかけの説明ごと撤回しました。
踏んだ罠(2): 「hot」は 1つの状態ではない
もう 1つ、OS をまたいだときに初めて見えたことがあります。同じ「hot」という言葉が、機械によって別の状態を指していました。
10GB のファイルに対する ripgrep の 2回目は、こうなりました。
| 環境 | メモリ | 10GB の ripgrep hot |
|---|---|---|
| Mac | 32GB | 11.08秒(載っていない) |
| Windows | 16GB | 約 4.7秒(載った) |
| Linux VM | 8GB | 17.18秒(載らない) |
Windows のほうがメモリは少ないのに、10GB が載りました。空きメモリは総量ではなく、そのときに何が使われていないかで決まります。
つまり「hot」は、どれだけキャッシュに残っているかという連続量です。ここを揃えずに 10GB の hot 倍率を環境間で並べると、キャッシュの当たり外れを性能差として書くことになります。そこで、10GB の hot だけは環境間で比べないと決めました。
数字: 各 OS の中での比だけを並べる
比較できた全項目の合計(2回計=cold + hot)
| 環境 | 項目数 | 2回計の比(相手 ÷ こちら) |
|---|---|---|
| Mac(M4・10コア・32GB・外付け USB SSD) | 96 | 2.30倍 |
| Windows(ノート PC・16GB・内蔵 SSD) | 96 | 3.06倍 |
| Linux VM(VMware・2コア・8GB) | 90 | 1.76倍 |
3つとも「7項目以上の合計は 1.3倍未満を差と呼ばない」という基準(第 9 回)を超えているので、差として書けます。ただし 2.30 と 3.06 と 1.76 を並べて「Windows がいちばん効く」と読むのは、半分しか正しくありません。 Windows で比が大きいのは、この機械で ripgrep 側が遅いからでもあります。比は、相手と自分の両方で決まります。
検索 7種の合計(2回計・uvp 対 ripgrep)
| 環境 | 3GB | 10GB | 50GB |
|---|---|---|---|
| Mac | 1.75倍 | 2.79倍 | 3.08倍 |
| Windows | 1.97倍 | 2.51倍 | 2.85倍 |
| Linux VM(2コア) | 1/1.01(互角) | 1.99倍 | 1.86倍 |
Linux VM の 3GB だけが互角です。 1/1.01 なので、勝ちでも負けでもありません。
理由ははっきりしています。2コアの VM では .uwvz の展開が CPU で律速するからです。索引を持っている側の利点は、読む量が減ることと引き換えに CPU を使うことで得ています。コアが 2つしかないと、その交換が成立しません。ripgrep が素直に読むほうが強い、という結果になります。
第 7 回で「3GB は固定費が見える大きさ」と書きましたが、Linux VM では固定費ではなく CPU 台数が理由でした。同じ症状でも、環境が変われば原因が変わります。
出力の一致
| 環境 | 一致 | 不一致 |
|---|---|---|
| Mac | 84項目 | 0 |
| Windows | 84項目 | 0 |
| Linux VM | 81項目 | 0 |
この表がいちばん大事だと思っています。秒数の表は条件が変われば変わりますが、出力が違っていたらその道具は使えません。3環境で 1件も食い違わなかったことは、秒数のどの行よりも先に書くべき結果でした。
外れ値の扱いを、先に決めておく
Mac の 3GB に、比較相手側の cold が 10.69秒という行がありました。同じ処理を別の書き方で流した行は 4.87秒です。倍以上ずれています。
このとき、選択肢は 3つあります。速いほうを使う(自分に不利)、遅いほうを使う(自分に有利)、両方載せる。
決めた規則はこうです。同じ内容の処理が 2通りで測れているときは、相手側が速いほうの行を使う。 つまり自分に不利なほうです。理由は単純で、外れ値の判定を自分の有利・不利で決めないための規則を先に持っておきたかったからです。前回の集計でも同じ扱いをしているので、版をまたいだ比較も崩れません。
正直に書いておくこと
- 3つの環境は同じ土俵ではありません。 Mac は外付け USB SSD、Windows は内蔵 SSD、Linux は仮想マシンです。秒数を OS またぎで比べていません。書いているのは各 OS の中での比だけです
- Linux は2コア・メモリ 8GB の VM 1台の結果です。実機の Linux でも同じになるとは限りません。コア数の少ない VM であることが、3GB の互角にそのまま効いています
- Windows の 10GB は hot でキャッシュに載ります。10GB の hot 倍率は環境間で比べないでください
- 比較相手の版は Mac・Windows が ripgrep 15.2.0、Linux が 15.1.0 で、完全には揃っていません
sudoが使えない事情で、一部の測定はpurgeなしです。50GB はメモリ 32GB の 1.6倍あり、通し読みではキャッシュに残らないため実質 cold として扱っていますが、厳密な cold ではありません- Linux には gz 入力を用意していないため、項目数が 90 と少なくなっています。同じ 96項目で 3環境を比べたわけではありません
- 「2回計」は cold と hot の合計です。1回目だけを見れば別の絵になります(索引を作る側が不利になります)
- 私は比較の一方の開発者です。その分は割り引いてお読みください
持ち帰れる一般論: 測定の手順は、測定結果より先に壊れる
(1)速すぎる数字を、成果として受け取らない。 今回いちばん危なかったのは、遅い数字ではなく速い数字でした。2.65秒は、表の上では良い結果に見えます。媒体の素読み速度という上限を知っていたから気づけました。上限を先に測っておくことは、自分の数字を疑うための道具でもあります。
(2)キャッシュを落とす手順は、OS ごとに「黙って失敗する」。エラーを返してくれないので、落ちたことを別の方法で確かめる必要があります。破棄が走った回数を記録する、cold と hot の差が期待どおり出ているかを見る——手順そのものにも検算が要ります。
(3)環境を増やす目的は、勝ち負けを増やすことではありません。 増やすと、ある環境でだけ成り立っていた説明が壊れます。今回なら「3GB が弱いのは固定費のせい」が、Linux では「コア数のせい」に変わりました。説明が壊れる場所を見つけるために環境を増やす、と考えるほうが健全でした。
(4)出力の一致を、秒数より前に置く。 速さの表は条件で動きますが、答えが違う道具は条件に関係なく使えません。一致の表を先に見る習慣は、自分の実装を守るためにも効きます。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
自分の環境で同じ測り方をするときの形です。
# 1項目の型: キャッシュを落として 1回目、続けて 2回目
sync && sudo purge && sleep 10
/usr/bin/time -p uvp huge.log 'ERROR' > /dev/null   # cold(1問目・索引を作る)
/usr/bin/time -p uvp huge.log 'ERROR' > /dev/null   # hot(2問目)

# 速さより先に、同じ行が出ているかを確かめる
uvp huge.log 'ERROR' -out mine.txt
rg 'ERROR' huge.log > theirs.txt

# 行だけ出す(sed -n p 相当)の突き合わせ
uvp huge.log 'ERROR' -grep

# 終了コードの確認(見つからない場合)
uvp huge.log 'ZZZ-not-found'; echo $?
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。2 が返った実行の秒数は採用しません(打ち切った実行と完走した実行は比べられません)。
正直に書くと、1問目は uvp が ripgrep より少し遅くなります——.uwvz(uvp 用の圧縮形式+索引)を先に作るぶんで、50GB なら 59.0秒 対 54.9〜55.8秒=6〜7%(v1.6.6.1)。効いてくるのは 2問目からで、同じ 50GB の検索が 6.56秒、ripgrep に対して 8.4倍速くなります。3GB のような小さいファイルでは同等です。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 5 回: 同じコマンドで件数が揺れた話(打ち切りと終了コード): https://uvp.y42u.net/blog/uwview-fl05-deterministic-count/
- 第 7 回: 3GB でだけ負けた理由は固定費だった: https://uvp.y42u.net/blog/uwview-fl07-3gb-fixed-cost/
- 第 8 回: gz を展開せずに探す(Windows・Linux も計測): https://uvp.y42u.net/blog/uwview-fl08-gz-without-extract/
- 第 9 回: どこからを「差」と呼ぶかの基準: https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- 81 項目を ripgrep・sed と 1 行ずつ突き合わせた話: https://uvp.y42u.net/blog/uvp-vs-ripgrep-sed-81-checks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。