line 48,213,996 だけが残っている。
エラーはそれだけ。その行を、いま見られますか。
パイプラインが教えてくれるのは座標だけで、現物は別の場所にあります。
データパイプラインの障害は、アプリケーションの障害と性質が違います。落ちるのは処理ではなく入力データで、原因は自分たちのコードの外にあり、しかも証拠は数十GBの中の1行です。今回はその4場面——落ちた行の前後を見る、学習コーパスの異物を探す、毎月同じ巨大ファイルを開き直す、そして変換する前に原本を見る——を、それぞれ「何が詰まるのか」から順に見ます。
- 先に結論: UwView Pro なら行番号を打ち込むだけで48,213,996行目へ跳べ、跳んだ先は抽出済みの断片ではなく原本なので、前後を好きなだけ広げて読めます。索引と圧縮はサイドカーに保存されるので、翌月また同じ入力ファイルを開くときは行番号付きのまま開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。直す段に進んでも原本は書き換わりません。修正は差分ファイルに積まれ、途中でやめて翌日続きから再開できます(詳細は記事末尾)
- 1. 行番号だけが残された
- 2. コーパス50GBの「変な行」
- 3. 毎月、同じ31GBを開き直す
- 4. 変換する前に、原本を見る
- 4つに共通していたもの
- 使っている道具
- リンク
先に結論: UwView Pro なら行番号を打ち込むだけで48,213,996行目へ跳べ、跳んだ先は抽出済みの断片ではなく原本なので、前後を好きなだけ広げて読めます。索引と圧縮はサイドカーに保存されるので、翌月また同じ入力ファイルを開くときは行番号付きのまま開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。直す段に進んでも原本は書き換わりません。修正は差分ファイルに積まれ、途中でやめて翌日続きから再開できます(詳細は記事末尾)
本記事は「パイプラインに投入する前後の生データを、手元で読む」段階の話です。データの取り扱い可否・持ち出し範囲・保管方針は、所属組織および委託元の規程に従ってください。
1. 行番号だけが残された
状況
月次バッチが落ちます。朝、通知が来ています。
ログを見ます。書いてあるのは1行です。
ERROR: failed to parse record at line 48213996: unexpected field count (expected 12, got 13)
情報としては十分に見えます。行番号があり、期待値があり、実際の値がある。それでも、直せません。
13フィールドになった原因が、その行を見ないと分かりません。区切り文字がデータの中に混ざったのか、クォートが閉じていないのか、前の行の改行が抜けて2行が繋がったのか。どれも起こりますが、どれが起きたかは現物を見るまで決まりません。
そして入力ファイルは 31GB です。
なぜ起きるか
パイプラインは「壊れた行」を報告するようには作られていないからです。
パーサが返せるのは、自分が止まった位置と、自分の期待との差だけです。「なぜ13になったか」はパーサの関心の外にあります。
さらに厄介なことに、報告された行番号が、探すべき行とは限りません。
- クォートが閉じていないと、パーサはそこから数十行を1レコードとして飲み込みます。エラーが出るのは飲み終わった場所で、原因は数十行前です
- 改行コードが混在していると、パーサの数える行と、エディタが数える行がずれます(第13回で扱いました)
- ヘッダ行をスキップする実装では、1行ぶんずれた番号が報告されます
- 並列で読んでいる場合、報告されるのはチャンク内の相対位置のことがあります
つまり行番号は、探し始める場所であって、答えの場所ではありません。だから「その行だけ」を抜き出す対処では届かず、前後を広げて読める必要が出てきます。
汎用ツールでの対処と限界
まず、その行を見に行きます。
# 前後20行を切り出す(行番号は原本の座標ではなくなる点に注意)
sed -n '48213976,48214016p' input.tsv

# 素直に書くと末尾まで読み続けるので、範囲の終わりで止める
sed -n '48213976,48214016p;48214017q' input.tsv

# フィールド数が想定と違う行を全部拾う(1周かかる)
awk -F'\t' 'NF!=12 {print NR": "NF}' input.tsv | head -50
3本目が効きます。壊れた行が1つなのか、数千あるのかで、対応がまったく変わるからです。1つなら手で直し、数千なら生成元を疑います。
限界は3つ。
ひとつめ、sed は範囲を先に決めなければいけないこと。±20行を見て、原因がもっと前にあると分かったら、±200行で引き直します。そのたびに先頭から48,213,976行を数え直します。31GBのファイルで、当てが外れるたびに1周です。
ふたつめ、切り出した瞬間に原本の座標が消えること。sed の出力の1行目は、原本の 48,213,976 行目です。その対応関係は頭の中にしかありません。切り出したファイルの中で「ここが怪しい」と見つけても、原本の何行目かを計算し直す必要があります。引き継ぎ資料に書けるのは、この計算を間違えなかった場合だけです。
みっつめ、awk の全量走査は「思いつくたびに1周」になること。フィールド数で拾って、次はクォートの数で拾って、次は行長で拾って——調べ方をひとつ思いつくたびに31GBを舐めます。探索の速度が、思考の速度ではなくI/Oの速度に律速されるのが、この段階でいちばん効いてくる制約です(第15回)。
2. コーパス50GBの「変な行」
状況
機械学習の学習データを作ります。収集したテキストを結合したコーパスが 50GB あります。
前処理スクリプトを書き、学習を回します。数時間後、損失曲線が妙な形になります。あるいは、出力に見覚えのない文字列が混ざります。
原因はデータのどこかにあります。しかし「どこか」を特定する方法が、学習の側からは出てきません。
なぜ起きるか
検品の基準を、事前に言葉にできないからです。
パイプラインの障害(1章)には「フィールド数12」という明示的な基準がありました。コーパスの検品には、それがありません。探しているのは「変な行」であって、「変」の定義は見てから決まります。
実際に混ざるものを並べると、事前に全部を列挙するのが無理だと分かります。
- 同じ行の大量の繰り返し — クロール時のエラーページが数万行、まったく同じ内容で入っています
- HTMLやJSONの残骸 — 抽出漏れのタグ、エスケープされたままの
&、生のscriptタグ - 極端に長い1行 — Base64で埋め込まれた画像が1行として入り、その1行だけで数MBあります
- 文字コードの事故 — 一部のソースだけがShift_JISのまま結合され、UTF-8として読むと化けます(第3回)
- 意図しない個人情報 — これは件数ではなく、1件あってはいけない種類のものです
最後のものが、検品を「サンプリングでいい」と言えなくしています。1万行を抜いて確認して問題がなかったことは、残り全部が問題ないことを意味しません。
汎用ツールでの対処と限界
分布を見るところから始めます。
# 1行の長さの分布(極端な外れ値が先に出る)
awk '{print length}' corpus.txt | sort -n | tail -20

# 完全重複の上位(メモリを食うのでサイズに注意)
sort corpus.txt | uniq -c | sort -rn | head -20

# 非ASCII以外の制御文字が入っている行を数える
grep -cP '[\x00-\x08\x0B\x0C\x0E-\x1F]' corpus.txt

# HTMLタグの残骸
grep -cE '</?(script|div|span|br)\b' corpus.txt
行長の分布が、いちばん安く効きます。数MBの1行は、それ自体が異常の証拠だからです。
限界は3つ。
ひとつめ、sort が50GBに耐えないこと。完全重複を数える素直な方法は全体のソートですが、これはファイルサイズぶんの一時領域と、それ相応の時間を要求します。--parallel や -T で緩和はできますが、「ちょっと確認する」の重さではなくなります。
ふたつめ、件数が出ても現物が分からないこと。grep -c は「1,247件あります」と答えますが、その1,247件が同じ種類の1つの問題なのか、7種類の別々の問題なのかは、実物を見るまで決まりません。grep で抜き出せば見られますが、抜き出した瞬間にコーパスの中での位置が消えます。「このソースから来た塊」なのか「全体に散っている」のかは、位置が分からないと判断できません。
みっつめ、検品は往復になること。異常を見つけ、前処理を直し、作り直し、また検品します。1回が数十分なら、往復のたびに数十分です。この往復回数が減らないことが、コーパス作りがいつまでも終わらない理由になります。
3. 毎月、同じ31GBを開き直す
状況
月次バッチの入力は、毎月だいたい同じ構造の巨大ファイルです。
先月も開きました。その前の月も開きました。開くたびに同じことをします。ヘッダを確認し、レコード数を数え、日付の範囲を見て、既知の問題パターンがないか検索します。
作業そのものは30分です。ただし開くまでに数分かかり、検索するたびに数十秒待ちます。毎月、同じように待ちます。
なぜ起きるか
待ち時間が「一度きりのコスト」として扱われているからです。
3分の待ちは、その場では許容されます。コーヒーを淹れに行けばいい程度です。問題は、それが月次×年12回×担当者の人数で積み上がることと、より本質的には、3分の待ちがあると人は確認を減らすことです。
- 「ついでにあれも見ておこう」が起きなくなります。開き直すコストが高いので、一度で済ませようとします
- 検索を思いついても、すでに閉じていれば実行しません
- 結果として、確認の網が、待ち時間に合わせて細くなります
そしてもうひとつ。毎月の作業には、前月の自分が何を確認したかが残っていません。同じ検索条件を毎回組み直します。組み直すたびに少しずつ違い、比較可能性が失われます。調査手順が個人の記憶の中にしかない、という話と地続きです。
汎用ツールでの対処と限界
定型作業なので、スクリプトにするのが正攻法です。
#!/bin/sh
# monthly-check.sh — 毎月の入力ファイルに同じ確認をかける
f="$1"
echo "== header =="; head -1 "$f"
echo "== lines  =="; wc -l < "$f"
echo "== date range =="; head -2 "$f" | tail -1 | cut -f1; tail -1 "$f" | cut -f1
echo "== known bad patterns =="
grep -cE '\t\t|^\t|\t$' "$f"        # 空フィールド
awk -F'\t' 'NF!=12' "$f" | wc -l    # フィールド数の異常
これで確認内容は固定され、前月との比較もできます。確認項目をファイルに書いておくこと自体に価値があります。
限界は2つ。
ひとつめ、スクリプトは「決めた確認」しかしないこと。数値が前月と違っていたとき、次にすることは決まっていません。そこから先は必ず現物を開いて目で見る作業になり、待ち時間は結局そこで発生します。スクリプト化で消えるのは定型部分だけです。
ふたつめ、毎回ゼロから読む構造は変わらないこと。上のスクリプトは wc -l で1周、grep -c で1周、awk で1周——31GBを3周します。先月も3周しました。前回読んだ結果が、どこにも残っていません。
4. 変換する前に、原本を見る
状況
外部から受け取った 258GB のXMLを、パイプラインに取り込みます。
仕様書があります。スキーマ定義もあります。変換スクリプトを書き、パイプラインに載せます。数時間走って、途中で落ちます。あるいは、落ちずに完走して、出てきた件数が想定と合いません。
どちらの場合も、次にすることは同じです。原本を見に行きます。
そして 258GB のXMLは、たいていのエディタでは開きません。
なぜ起きるか
仕様書は「あるべき姿」を書いたもので、受け取ったファイルは「実際にそうなったもの」だからです。
この2つは、外部からデータを受け取る場面ではほぼ必ずずれます。
- 仕様にないタグが混ざる — 送り元が拡張した項目が、こちらの仕様書には反映されていません
- 省略の扱いが違う — 空要素なのか、要素ごと無いのか。仕様書に書かれていない差が、パーサの挙動を分けます
- 文字参照とエスケープ —
&amp;のような二重エスケープは、送り元の変換段が二重になっていた痕跡です - 途中でフォーマットが変わる — 数年分を一括で受け取ると、途中で送り元のシステム更改を跨いでいることがあります
- 末尾が切れている — 転送が途中で止まったファイルは、先頭を見ても分かりません
最後のものが象徴的です。ファイルの末尾を見るだけで分かる問題が、開けないせいで分からない。 変換を走らせて数時間待ってから気づくことになります。
汎用ツールでの対処と限界
開かずに形を確かめます。
# 先頭と末尾(末尾が閉じタグで終わっているか)
head -c 2000 huge.xml
tail -c 2000 huge.xml

# タグの種類と出現数(大まかな構造の把握)
grep -oE '<[a-zA-Z_][a-zA-Z0-9_:.-]*' huge.xml | sort | uniq -c | sort -rn | head -30

# XMLとして妥当か(ストリーミングで検証)
xmllint --noout --stream huge.xml

# 特定タグの周辺だけを見る
grep -n -m 5 -A 10 '<UnexpectedTag' huge.xml
tail -c が安くて効きます。末尾が閉じタグで終わっていなければ、それ以上の調査は不要で、送り直しを依頼する話になります。
限界は3つ。
ひとつめ、grep はXMLの構造を知らないこと。タグ名を数えられても、入れ子の深さや親子関係は分かりません。「このタグがどのレコードの中にあるか」は、構造を理解する道具か、人間の目のどちらかが要ります。
ふたつめ、xmllint --stream は最初のエラーで止まること。エラーが100箇所あっても、報告されるのは1つめだけです。直して、走らせて、次のエラーを知る——これを100回繰り返すことになります。そして1回が数十分です。
みっつめ、「見に行く」の往復が重いこと。エラーが 1,800万行目だと言われて、そこを見て、そこだけでは分からず前を見て、さらに前を見る。この往復が、原本を開けるかどうかで根本的に変わります(ネタ帳で何度も触れてきた「258GBを1ファイルとして開く」は、本来こういう場面のための話です)。
4つに共通していたもの
| 場面 | 手がかり | 詰まる原因 | 汎用ツールでの対処 | 残る問題 |
|---|---|---|---|---|
| バッチが落ちた | 行番号1つ | 報告された位置と原因の位置が違う | sed で±N行を切り出す |
範囲を先に決める必要。切り出すと原本の座標が消える |
| コーパス検品 | 基準が未定義 | 「変」の定義が見てから決まる | 行長・重複・制御文字の分布 | 件数は出ても現物と位置が分からない |
| 毎月の入力確認 | 前月と同じ手順 | 待ち時間ぶん確認が細くなる | 確認スクリプトを固定する | 毎回ゼロから読む。前回の結果が残らない |
| 変換前の原本確認 | 仕様書 | 仕様と現物がずれる | head/tail/タグ数え |
往復が重い。エラーは1つずつしか出ない |
4つは工程も担当者も違います。それでも右端の列が似た形をしているのは、4つとも「現物の、その場所を、文脈ごと見る」ことが要求されていて、そこがいちばん高くついているからです。
パイプラインの世界では、データは通り過ぎていくものとして扱われます。読み込まれ、変換され、書き出される。人間が現物を見ることは例外的な事態で、だから例外的な事態のための道具が、手元にありません。落ちたときだけ、sed と awk を組み合わせて即席の窓を作ることになります。
必要な条件を3つに整理します。
- 行番号で跳べて、跳んだ先が原本であること — 切り出した断片では、前後を広げるたびに作り直しになります
- 同じファイルへの2回目以降が軽いこと — 検品も月次確認も、1回で終わりません。往復回数が減らない以上、1回あたりのコストを下げるしかありません
- 直す段でも原本が残ること — 移行やデータ修正では、比較の基準になる元のファイルが最後まで必要です
冒頭の line 48,213,996 に戻ります。あれは行番号が足りなかったのではありません。その行へ行く手段が、31GBの前で止まっていただけです。
使っている道具
私が開発している UwView(無料)は、巨大なテキストを開いた瞬間から表示・スクロール・検索できるビューアです。ファイル全体をメモリへ読み込まないので、RAM より大きいファイルでも開けます。索引はバックグラウンドで作られ、完成すると行番号が付きます(他のビューアの多くは索引が終わるまで先頭しか見えません)。分割も抽出もしないので、原本は1本のまま・無改変のまま扱えます。
- 行番号を指定して跳ぶ: 1章の 48,213,996 行目は、番号を打ち込めばその場所が開きます。跳んだ先は原本なので、前後を好きなだけ広げて読めます。
sedのように範囲を先に決める必要がなく、当てが外れてもファイルを読み直しません - 末尾へ一足で行く: 4章の「末尾が閉じタグで終わっているか」は、258GBでも開いてすぐ確認できます。
tail -cと違い、そのまま上へ遡れます - 文字コードは開いたまま切り替えられます(UTF-8 / Shift-JIS(CP932) / EUC-JP / UTF-16 を自動判定)。2章のコーパスに混ざったShift_JIS由来の化けは、変換ファイルを作らずに確かめられます
ここから先が UwView Pro の領分です。
- 索引と圧縮を保存する: 3章に直接効きます。一度開いたファイルは2回目以降行番号付きのまま瞬時に開き直せます(47.73GBのテキストで実測0.02〜0.07秒。特定環境での測定例で、環境により異なります)。「開き直すのが高いから確認を減らす」という判断が要らなくなります
- 検索条件を保存して、翌日そこから再開する: 3章の「毎月同じ条件を組み直す」に対して、条件そのものを成果物として残せます。セッションも復元されるので、月次作業を前月の続きとして始められます
- 多段階検索(ドリルダウン): 絞り込んだ結果をさらに絞れます。2章の「1,247件が何種類の問題なのか」を、抽出ファイルを作らずに画面の上で仕分けられます。タブに
語(件数)が並び、原本の行番号は最後の段まで保持されます(多段階検索の記事) - 集計(頻度ランキング): 正規表現で拾った値の出現回数を並べ、行をクリックすればその箇所へ降ります。2章の分布確認に近いことを、ファイルを何周もせずに行えます。ただし合計や平均のような数値計算はしません——系譜は
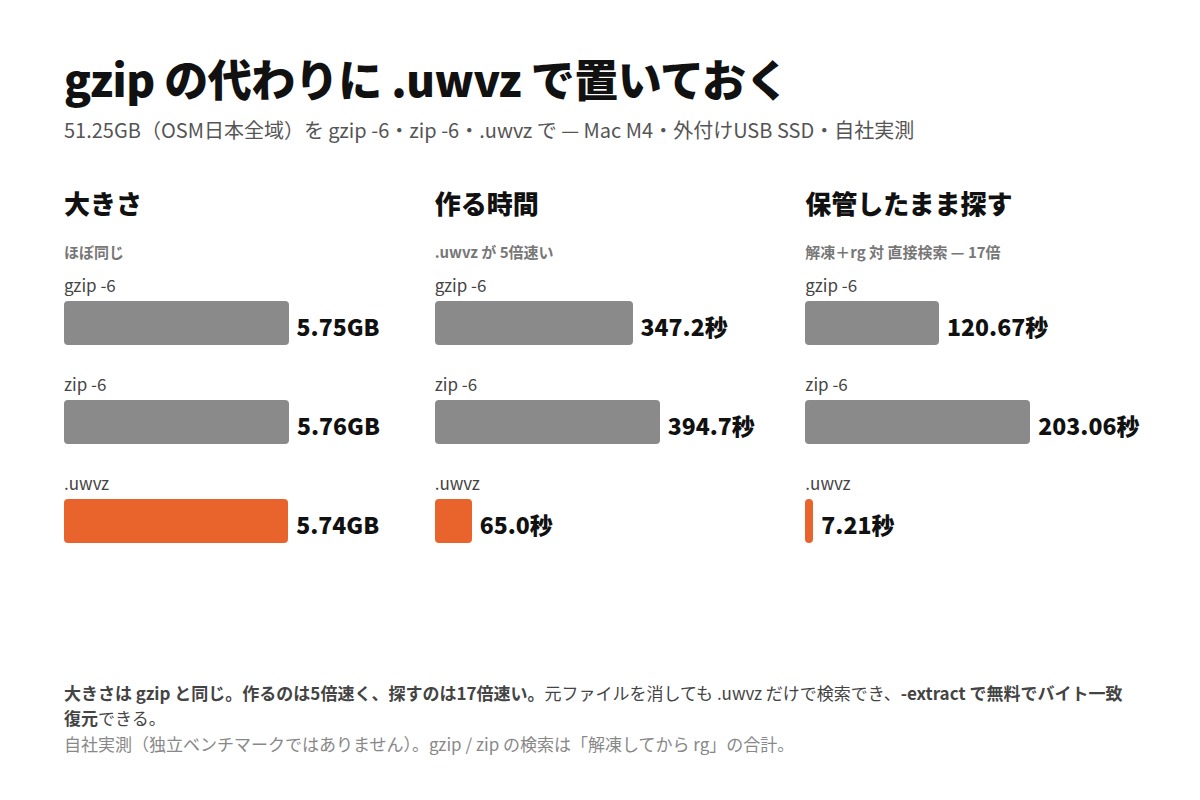
grep -oE | sort | uniq -cの側です - 約1/9で保管しつつ検索できる: 月次の入力ファイルを年12本ぶん保持する運用では、保管と再確認が両立します(第8回)
そして、この連載で「見つけたあと、直す段で原本を書き換えることになる」と書いてきた部分に、v1.4.0 で Edit Upgrade が入りました。移行・データ修正の仕事に直接効きます。
- 原本を書き換えません。 修正も一括置換も、差分ファイル(
.ewvz)に積まれます。1章で壊れた行を直すときも、比較の基準になる元のファイルが最後まで手元に残ります - 修正のコストがファイルサイズに依存しません。 計測では、10GB・1億行のファイルに対する21,994箇所の一括置換が16.8秒でした(計測記事。macOS・外付けSSD・
.uwvz化済みファイルでの1回の計測で、環境により異なります) - 途中でやめて、翌日続きから。 全体を保存し直さずに中断・再開できます。2章のコーパス検品のように何日もかかる仕事のための性質です
正直に書いておきます。UwView は検証ツールでもETLでもありません。
- 1章の「フィールド数が違う行を全量から拾う」は
awkの仕事です。この道具の出番はその後——出てきた行番号を現物に当てる段です - CSVやXMLの構造を理解しません。 列名でのソートも、型チェックも、スキーマ推定も、XMLの入れ子の検証もしません。「巨大CSVエディタ」「XMLエディタ」を期待すると外れます
- 集計に合計・平均はありません。 2章の重複件数を数えるのは
sortとuniqの仕事です - パイプラインの実行も、スケジュールも、再実行も、監視もしません
- Edit Upgrade の編集対象は
.uwvz化したファイルです。生のCSVをその場で直す使い方ではなく、いったん.uwvzにしてから扱う設計で、View License への追加ライセンスとして動きます(単体では動作しません) - 対応するのはテキストです。Parquetやデータベースのバイナリダンプは対象外です
コマンドラインから同じことをする
v1.6.0 で uvp コマンドが付きました(無料版には uvf)。GUI と同じ .uwvz を使うので、CLI で作った索引はそのまま GUI でも効きます。この記事の4章に対応させると、こう書きます。
# 1章: 疑わしいレコードのまわりを±40行の文脈つきで見る(範囲を先に決めない)
uvp input.tsv 'order_id=A1B2C3' -C 40

# 1章の続き: そのまま GUI へ渡して、行番号で跳んで前後を広げる
uvp input.tsv 'order_id=A1B2C3' -C 40 -open

# 2章: コーパスの行頭30文字で頻度を数える(大量重複の塊が上位に出る)
uvp corpus.txt -uniq '^(.{0,30})' -head 20

# 3章: 毎月の入力に同じ確認をかける。結果は圧縮して保存できる
uvp 2026-09.tsv 'ERROR' 'timeout' -out check-202609.txt.gz

# 4章: .uwvz にしておけば、原本を消したあとでも探せる
uvp huge.xml.uwvz '<UnexpectedTag'
uvp huge.xml.uwvz -extract -out restored/   # 元の形へ戻すのは無料
終了コードは grep と同じ 0=あり・1=なしに、2=上限に当たって打ち切った(既定は無制限。-limit N で上限を決めたときだけ)が加わります。if uvp input.tsv 'ERROR'; then がそのまま書けるので、3章の確認スクリプトにそのまま混ぜられます。
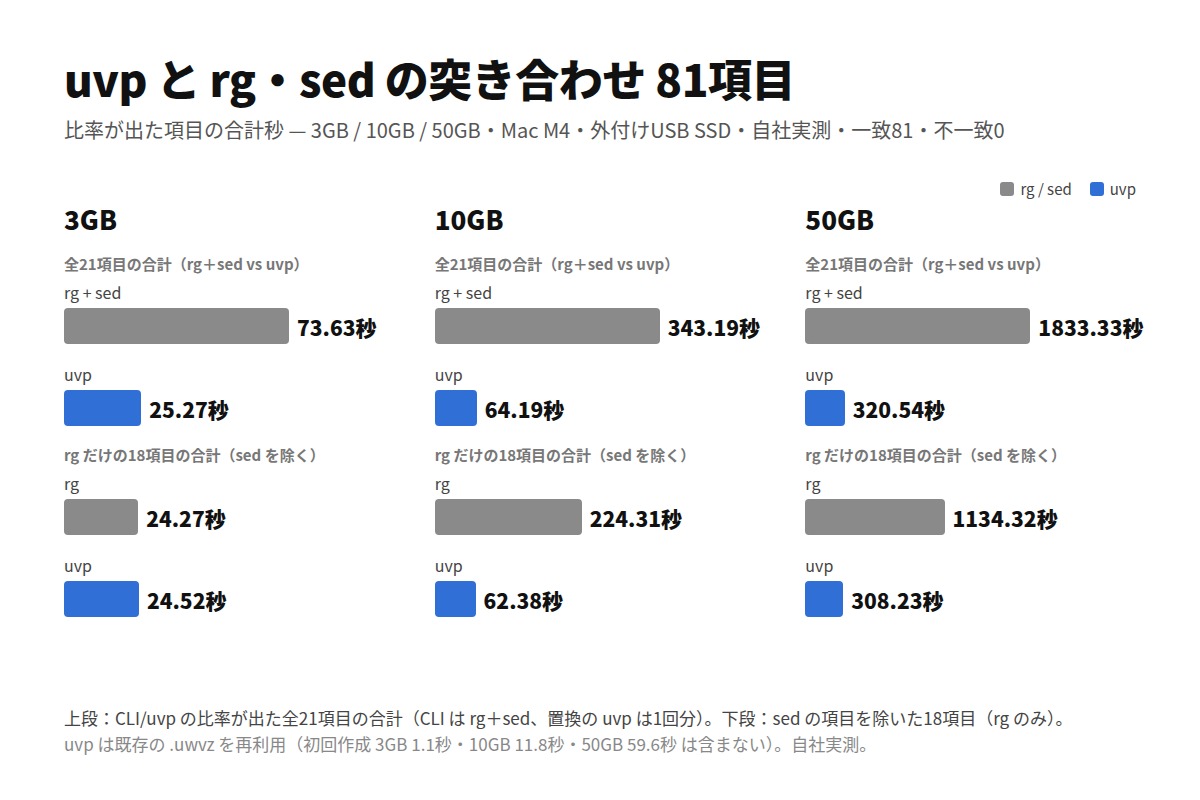
正直に書くと、1問目は ripgrep のほうが 15〜20% 速いです(uvp は先に索引を作るため)。3GB程度でメモリに収まるファイルなら、2問目以降も rg のほうが速いままです。uvp が効くのは10GBを超えて、同じファイルに2回以上聞くときです(実測記事。Mac M4・外付けUSB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
できるのは、見つけること・現物を示すこと・原本を壊さずに直すことです。月次の入力確認や、数日がかりの移行データ修正に当たっているなら、まず試してみてください。
- 14日間無料で試す(View+Edit の全機能・支払い情報の登録なし)
- UwView Pro(View) — 永続索引・圧縮キャッシュ検索・約1/9保管で、開き直しも検索も一段速くなります(全OS対応・買い切り/月額プランあり)
- Edit Upgrade — 非破壊の差分編集・巨大ファイルの一括置換・中断して翌日再開(View License への追加ライセンス)
リンク
- 第1回: 巨大ファイルに沈む4つの定番ツールと、その先: https://uvp.y42u.net/blog/uwview-ps01-huge-file-tool-limits/
- 第3回: 文字コード4つの罠と切り分け手順: https://uvp.y42u.net/blog/uwview-ps03-japanese-encoding-traps/
- 第8回: 圧縮保管と検索の両立: https://uvp.y42u.net/blog/uwview-ps08-compressed-archive-search/
- 第9回: 構造化データを生のまま読む4場面: https://uvp.y42u.net/blog/uwview-ps09-read-raw-structured-data/
- 第13回: 巨大データ検品の4技法: https://uvp.y42u.net/blog/uwview-ps13-huge-data-inspection/
- 第15回: コマンドライン職人芸の限界線4本: https://uvp.y42u.net/blog/uwview-ps15-cli-craft-limits/
- 第17回: 開発環境とログの4つの摩擦: https://uvp.y42u.net/blog/uwview-ps17-dev-env-log-friction/
- 第20回: 監査対応を仕組みで乗り切る4項目: https://uvp.y42u.net/blog/uwview-ps20-audit-log-retrieval/
- 1億行の一括置換を計測する: https://uvp.y42u.net/blog/uep-100m-lines-replace-all/
- uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- 絞り込んだ先からさらに絞り込む(多段階検索): https://uvp.y42u.net/blog/uvp-drilldown-search/
- その順に現れる箇所だけを探す(シーケンシャル検索): https://uvp.y42u.net/blog/uvp-sequence-search/
- ソースコード(GitHub): https://github.com/amru195704/UwView
開発者より: アプリ・Kindle本・オープンソースの一覧は GitHub: amru195704 にまとめています。
お願い
本記事の情報は参考目的で掲載しており、正確性・完全性を保証するものではありません。掲載したエラーメッセージ・行数・ファイルサイズ・件数はすべて説明のための例であり、特定の実在するデータや案件を示すものではありません。CSV/TSVのクォート解釈・改行コードの扱い・XMLの文字参照の扱いは、パーサやライブラリの実装・バージョンにより異なります。コマンド例は環境(GNU/BSD、awk・sed・sort・grep・xmllintの実装差、grep -Pの可否等)により調整が必要です。オプション名や既定値は必ず手元のmanで確認してください。記載した実測値は特定の1環境での測定例であり、同じ結果を保証するものではありません。ディスクの種類・ファイルシステム・断片化・暗号化・ページキャッシュの状態・同時に動いている他のプロセスにより、結果は大きく変わります。学習データ・移行対象データの取り扱いは、所属組織および委託元の規程、ならびに適用される法令に従ってください。誤記・不正確な情報がございましたら、コメント欄よりご指摘いただければ、確認のうえ修正いたします。