正規表現だけ遅い。
同じ 50GB のファイルを、同じ道具で探しています。違うのは -E を付けたかどうかだけ。それで秒数がほぼ倍になりました。比較相手の ripgrep には、この段差がありません。
段差を消す鍵は、正規表現を速くすることではありませんでした。
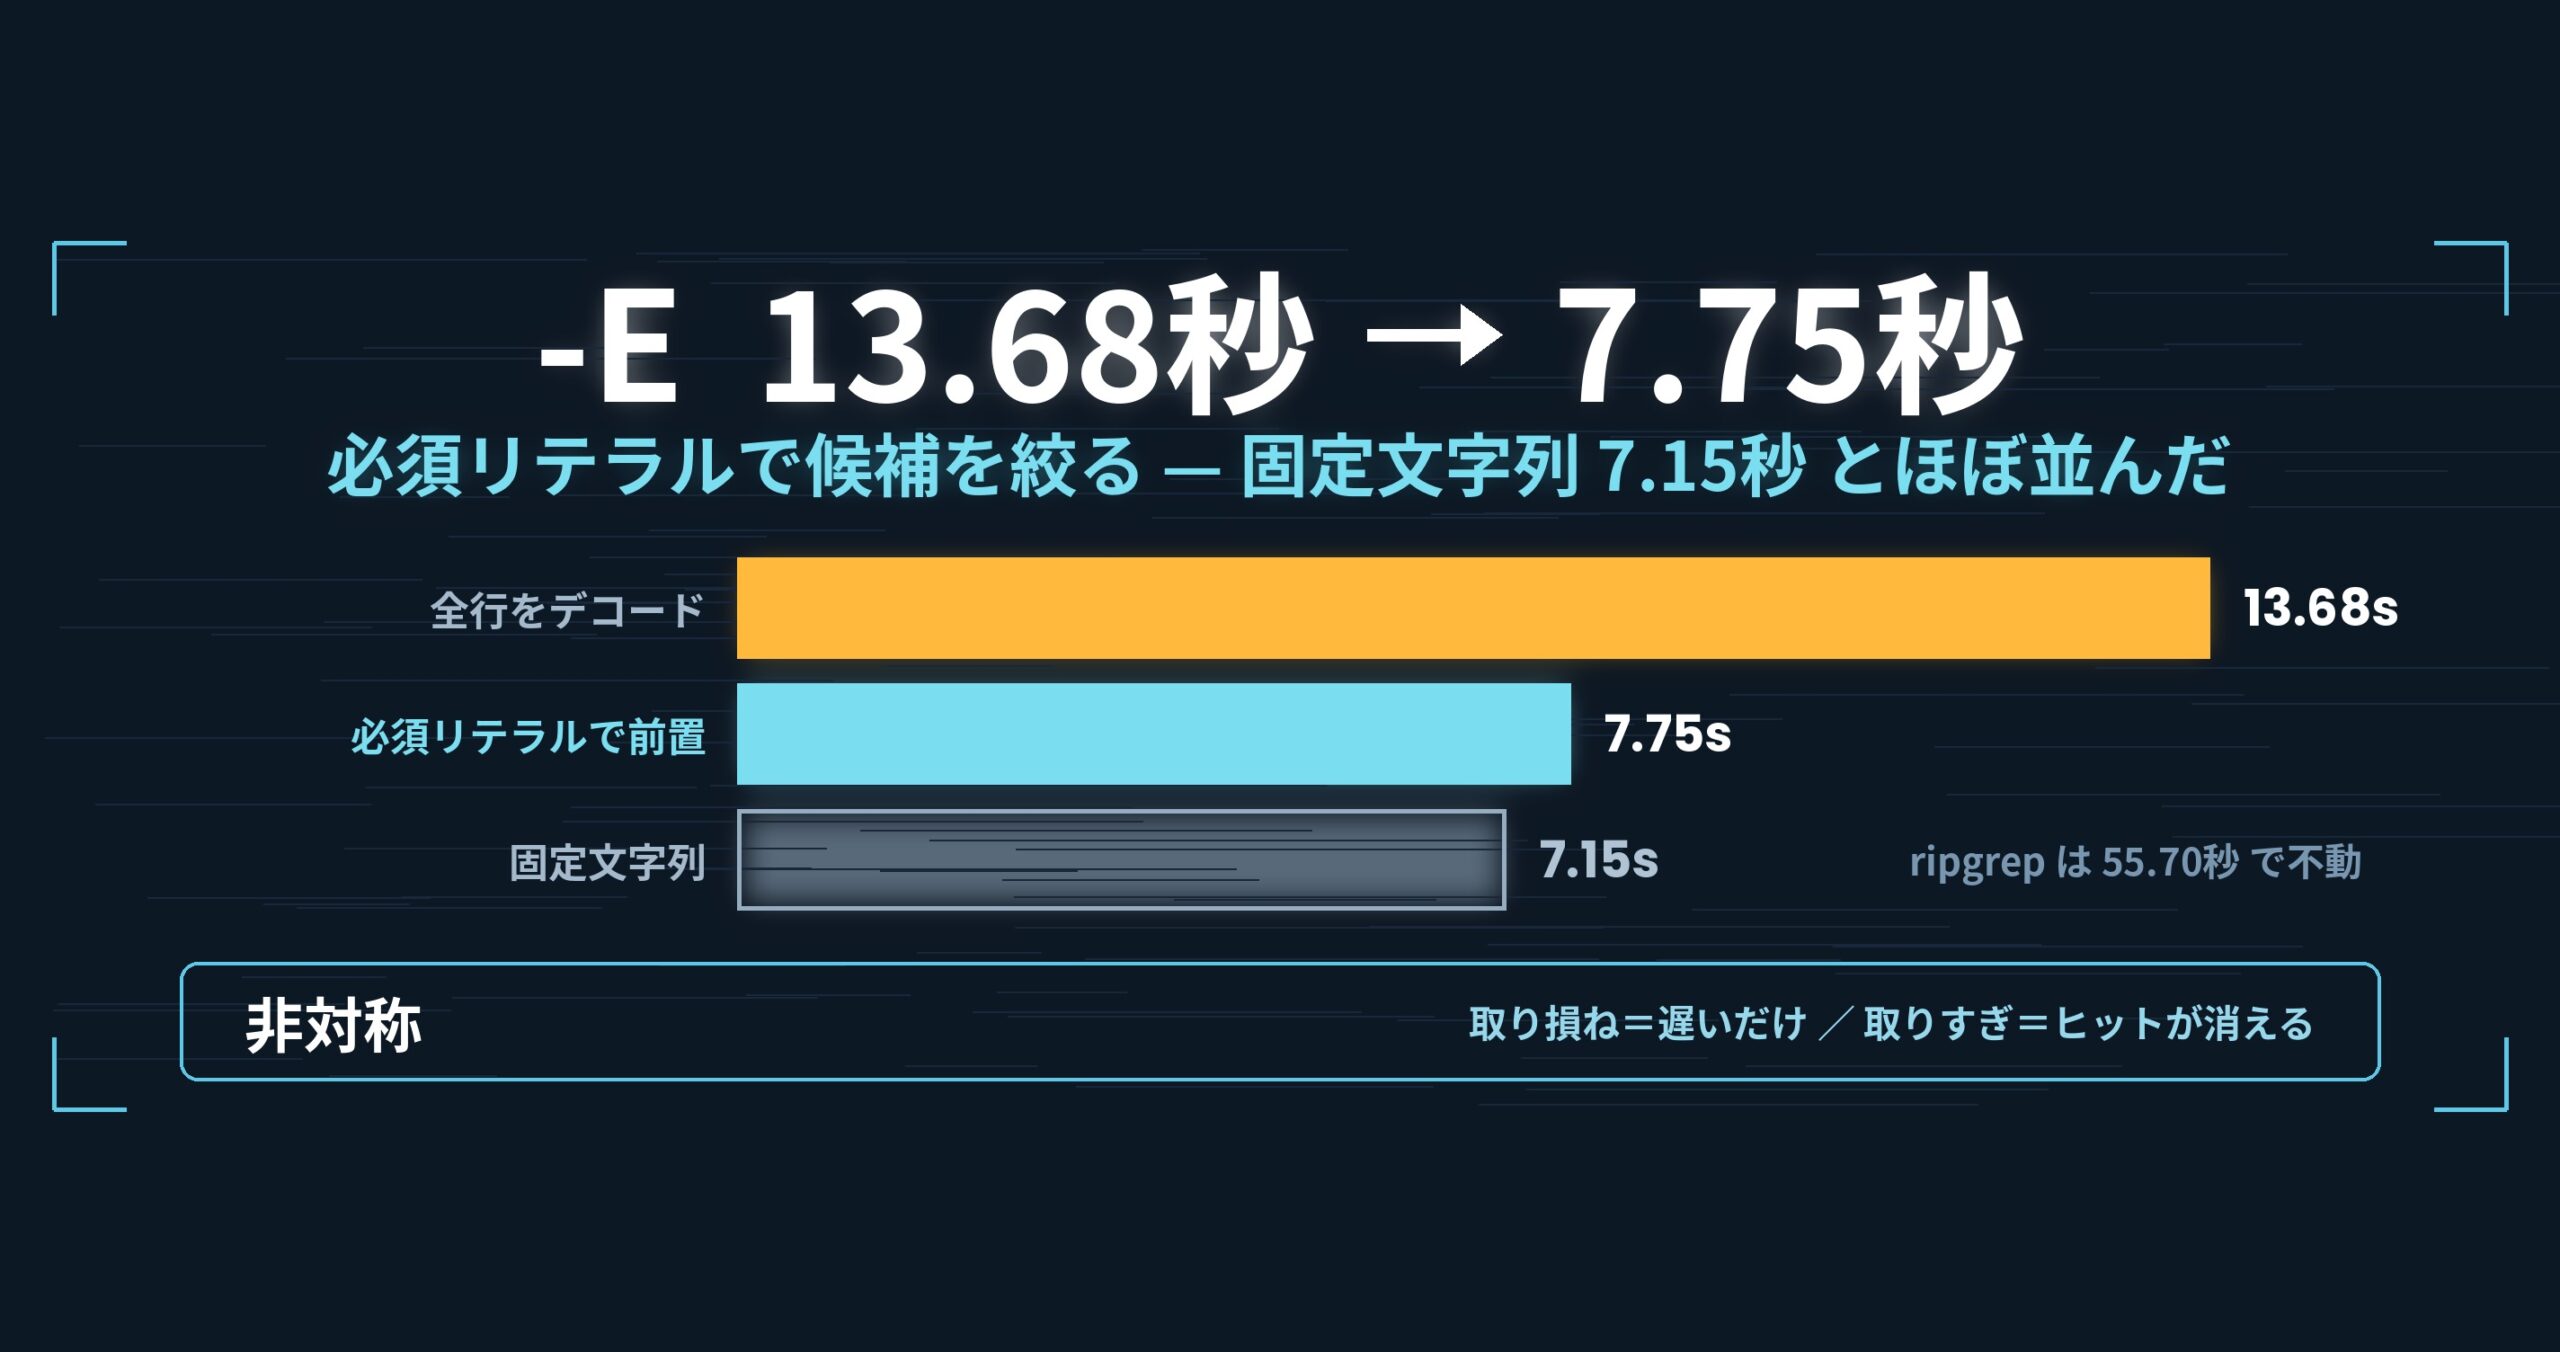
- 先に結論: 正規表現から「この式に当たる行が必ず含む文字列」を保守的に取り出し、SIMD で候補行を絞ってから正規表現に当てる形にしたところ、50GB の -E が 13.68 秒 → 7.75 秒になり、固定文字列の 7.15 秒とほぼ並びました(ripgrep は同じ 50GB で -E 55.70 秒・固定 55.66 秒)。この 1.77 倍は、自分たちのベンチ基準(単項目 1.5 倍未満は「差」と呼ばない)をぎりぎり超えた大きさです。差と呼ぶ以上の裏付けは本文に書きます。リテラルが取り出せない式([0-9]{3}-[0-9]{4}" 等)は 12.88 秒で退行なし。すべて Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・.uwvz 再利用時の測定例です。詳細は記事末尾。
- 問題: -E を付けた瞬間、固定文字列の倍近くかかった
- 原因: 当たりようのない行まで、全部 UTF-16 に戻していた
- 手当て: 「この式に当たる行は、必ずこの文字列を含む」を取り出す
- 数字: 13.68 → 7.75 秒、固定文字列の 7.15 秒とほぼ並んだ
- 持ち帰れる一般論: 間違い方の「非対称」を先に見つける
- 使っている道具
- リンク
先に結論: 正規表現から「この式に当たる行が必ず含む文字列」を保守的に取り出し、SIMD で候補行を絞ってから正規表現に当てる形にしたところ、50GB の -E が 13.68 秒 → 7.75 秒になり、固定文字列の 7.15 秒とほぼ並びました(ripgrep は同じ 50GB で -E 55.70 秒・固定 55.66 秒)。この 1.77 倍は、自分たちのベンチ基準(単項目 1.5 倍未満は「差」と呼ばない)をぎりぎり超えた大きさです。差と呼ぶ以上の裏付けは本文に書きます。リテラルが取り出せない式([0-9]{3}-[0-9]{4}" 等)は 12.88 秒で退行なし。すべて Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・.uwvz 再利用時の測定例です。詳細は記事末尾。
この記事は「First Light」連載の第 4 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。今回扱う必須リテラルの取り出しは v1.6.0 の時点で入っていたもので、First Light に至る前提にあたります。
問題: -E を付けた瞬間、固定文字列の倍近くかかった
50GB のファイル(OpenStreetMap の XML・51,254,526,392 バイト・8.9 億行)に対して、.uwvz(圧縮キャッシュと索引)を作り終えた状態から聞いています。
50GB・.uwvz 再利用 |
uvp |
ripgrep 15.2.0 |
|---|---|---|
| 固定文字列の検索 | 7.49 秒 | 55.66 秒 |
正規表現 -E |
13.68 秒 | 55.70 秒 |
ripgrep の 2 行を見比べてください。55.66 と 55.70。正規表現を渡しても、ripgrep はほとんど何も変わりません。これは偶然ではなく、ripgrep が「正規表現でも速度が落ちない」ことを設計として掲げているからです。
いっぽう uvp は 7.49 → 13.68。自分の固定文字列に対して 1.83 倍負けています。速い側にいても、この段差があると「正規表現を書くと遅くなる道具」として使われてしまいます。実際の調査では -E 'timeout|refused' のような書き方が主役になるので、ここが重い道具は使いどころで重いことになります。
問いはこうなります。なぜ正規表現にしただけで、同じファイルの読み出しに倍の時間がかかるのか。
原因: 当たりようのない行まで、全部 UTF-16 に戻していた
当時の -E の経路は素直なものでした。
- 行のバイト列を UTF-16 の文字列にデコードする
- その文字列を .NET の正規表現エンジンに当てる
第 3 回の -i とまったく同じ形です。そして同じ理由で遅い。一致する行はごく一部なのに、デコードは全部の行に走る。50GB・8.9 億行なら 8.9 億回。
固定文字列の検索にはこの工程がありません。バイト列のまま SIMD で探して、当たった行だけを取り出せばいい。7.49 秒と 13.68 秒の差は、まるごと「一致判定にたどり着くまでの準備」の代金でした。第 3 回と同じ構図が、-i ではなく -E の側にもう一度立っていたことになります。
ここで方向を間違えると、正規表現エンジンの最適化に向かいます。ですが 6 秒の大半はエンジンに入る前に使われているので、エンジンをいくら速くしても取り返せません。削るべきは、エンジンに渡す行の数そのものでした。
手当て: 「この式に当たる行は、必ずこの文字列を含む」を取り出す
正規表現には、たいてい逃げられない部分があります。timeout|refused に当たる行は、必ず timeout か refused のどちらかを含みます。ERROR:\s+\d+ に当たる行は、必ず ERROR: を含みます。この「必ず含む文字列の集合」を必須リテラルと呼ぶことにして、パターンから機械的に取り出すようにしました(RegexLiterals)。
取り出せたら、検索はこうなります。
- 必須リテラルのどれかを、バイト列のまま SIMD で探す(固定文字列の検索そのもの)
- 当たった行だけデコードして、正規表現に当てる
正規表現エンジンに届く行が、一致候補だけに減ります。1 の工程は固定文字列の検索と同じ速さなので、-E の秒数は「固定文字列の検索 + ごく少数の行のデコード」に近づきます。
取り出しの規則は「取り損ねる側」に倒す
必須リテラルの抽出には、間違い方が 2 種類あります。この 2 つは対称ではありません。
- 取り損ねた(本当は必須なのに拾えなかった)→ 絞り込みが弱くなるだけ。答えは変わらない
- 取りすぎた(必須でないものを必須と決めた)→ その文字列を含まない一致行が、候補にすら上がらず消える
後者は検索結果が静かに欠ける、という一番たちの悪い壊れ方です。なので抽出は全面的に保守的な側へ倒しました。
| 構文 | 扱い |
|---|---|
a? / a* / a{0,3} |
必須でない(0 回でも成立する)→ 取らない |
a+ |
1 回分だけ必須として取る |
(a\|b) |
集合として取る(a と b の両方を候補に) |
IgnoreCase 付き |
扱わない(畳み込みの範囲が絡むので手を出さない) |
| 判断がつかない構文 | 取らない → 従来のデコード経路へ |
「取れなければ従来どおり」という退路を必ず用意しておくのが肝心で、これがあるおかげで抽出器が賢くなくても壊れません。賢さは速度にしか効かず、正しさには効かない——そういう配置にしてあります。
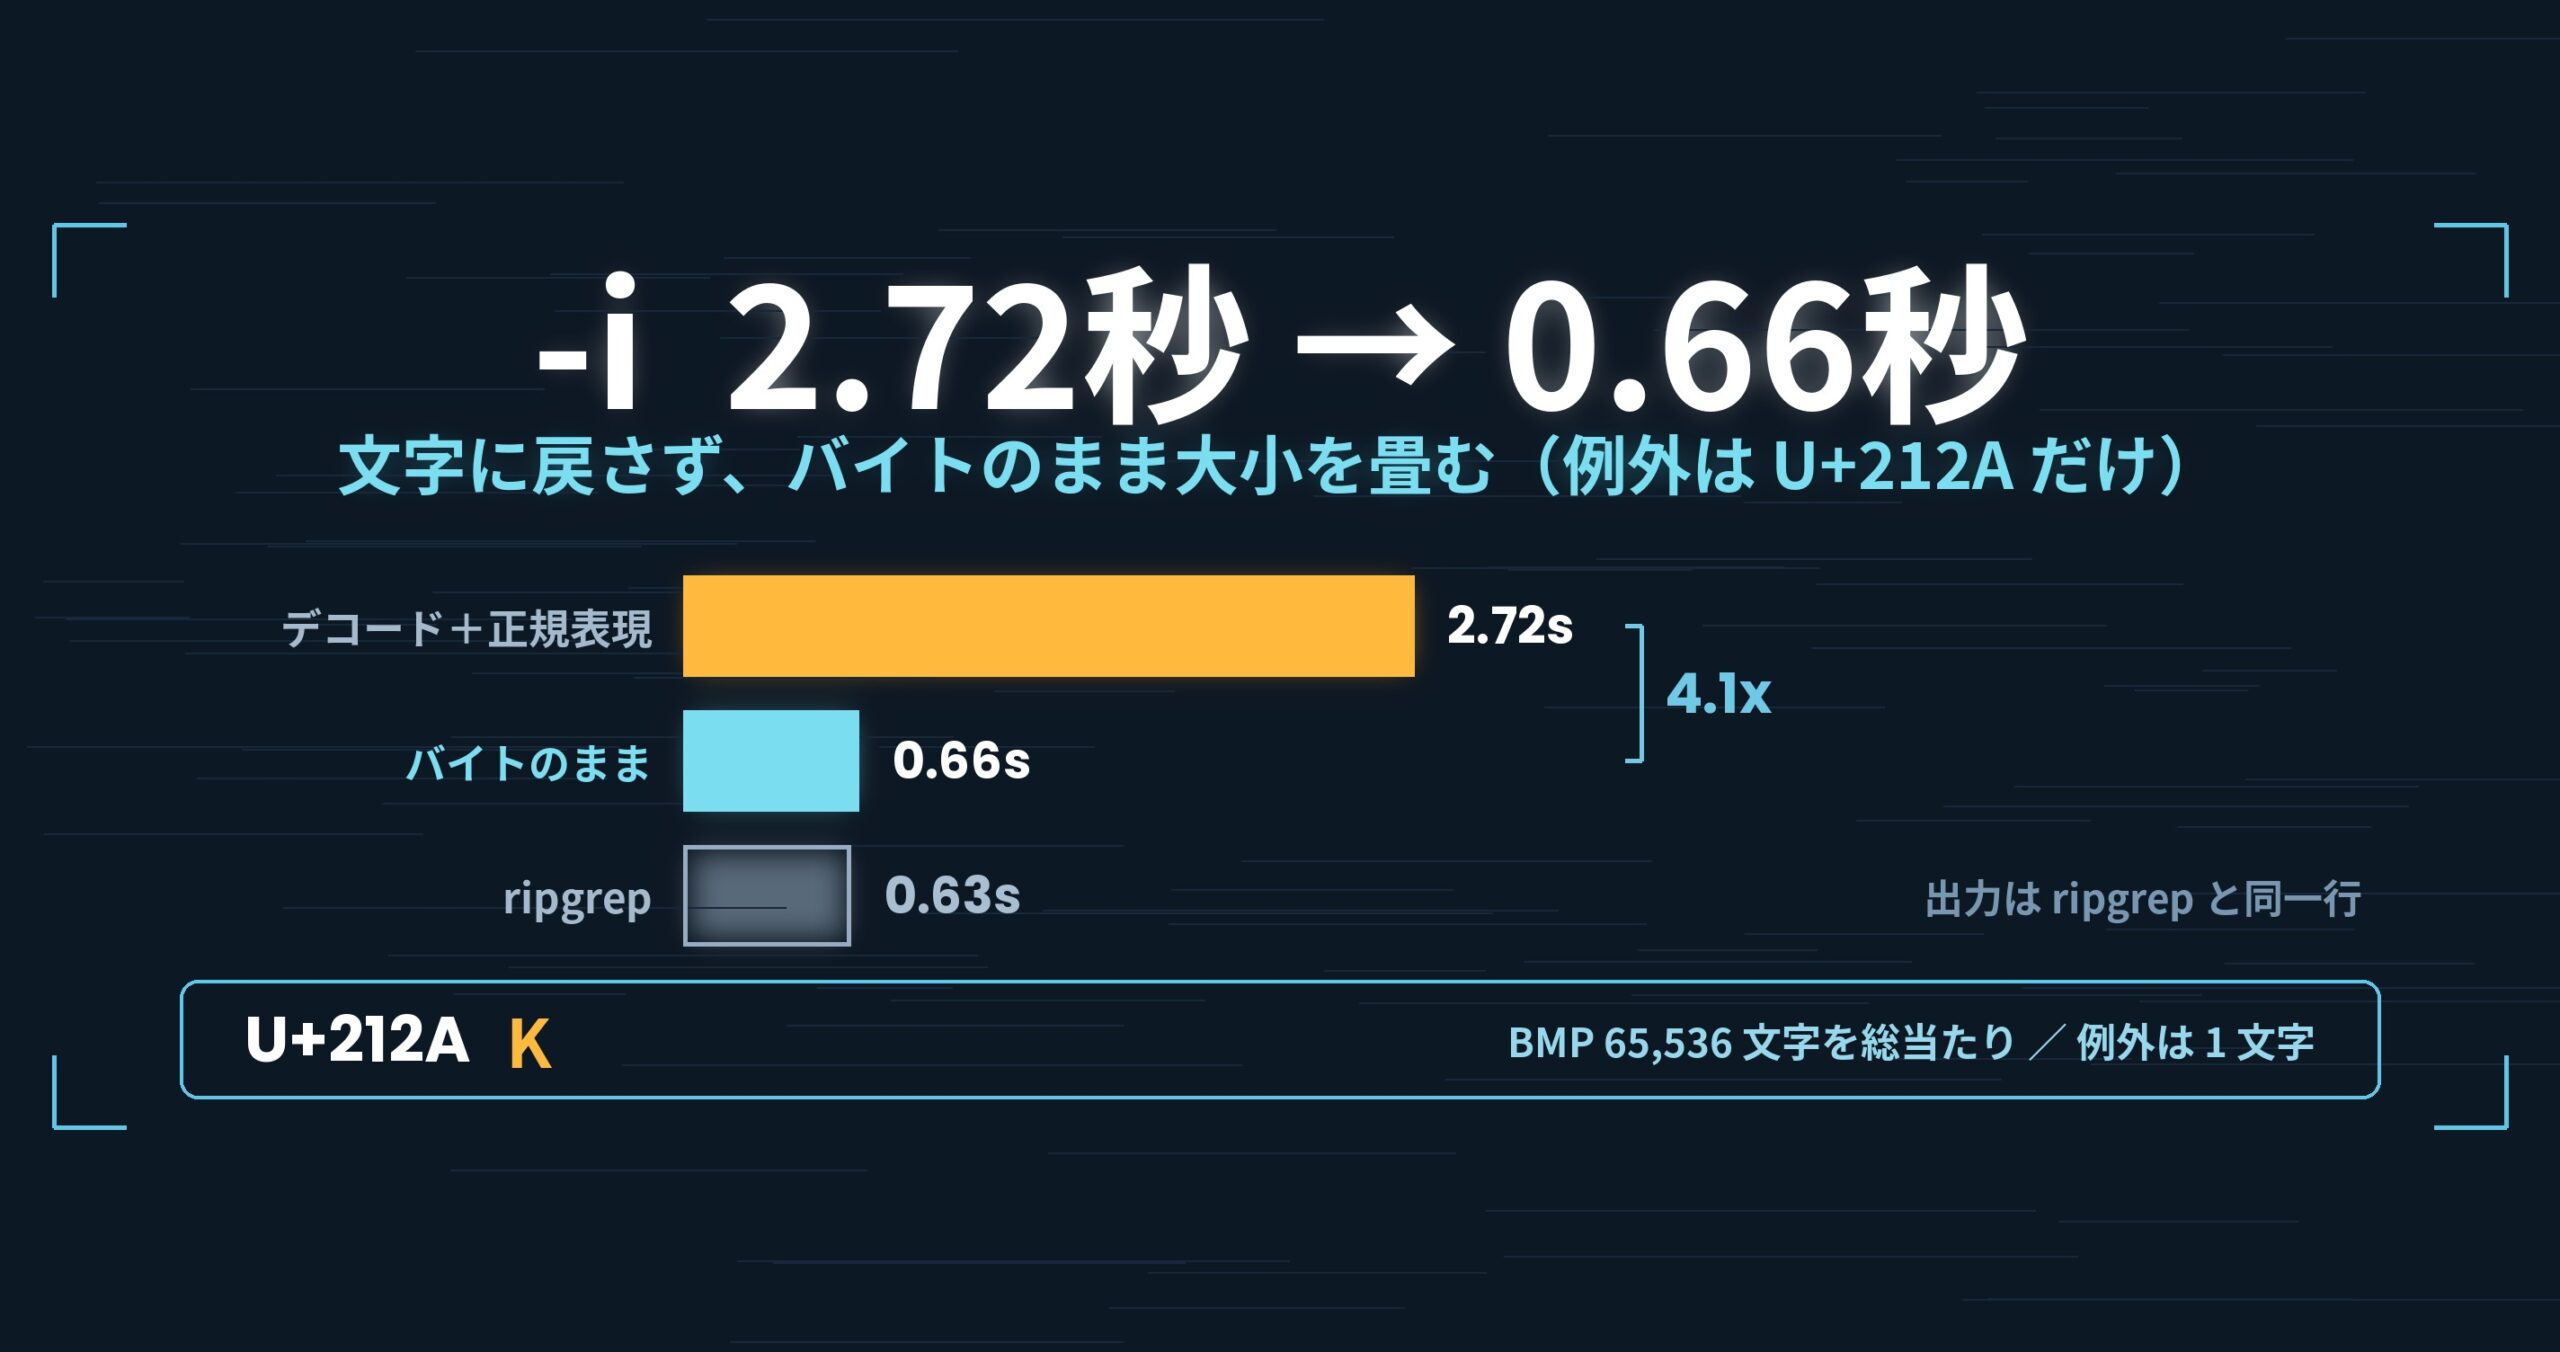
-E -i(正規表現と大小無視の併用)で必須リテラルを扱わないのも同じ理由です。第 3 回で書いたとおり、大小無視の畳み込みは ASCII の外に例外(U+212A)を持ちます。ここに必須リテラルの論理を重ねると、「必ず含む」が本当に必ずなのかを保証しにくくなる。代わりに -E -i では「k を含まない最長の連続部分」を目印に使っていて、絞り込みの力は落ちますが取りこぼしは起きません。
数字: 13.68 → 7.75 秒、固定文字列の 7.15 秒とほぼ並んだ
50GB・.uwvz 再利用・2026-09-15 の 2 ラン(Mac M4・メモリ 32GB・外付け USB SSD・ripgrep 15.2.0)
| 50GB | 改修前(10:33) | 改修後(17:02) | ripgrep |
|---|---|---|---|
正規表現 -E(602,805 件) |
13.68 秒 | 7.75 秒 | 55.70 秒 |
| 固定文字列(94,979 件) | 7.49 秒 | 7.15 秒 | 55.66 秒 |
| リテラルを取り出せない式 | — | 12.88 秒 | 67.60 秒 |
7.75 秒と 7.15 秒。これが言いたかったことのすべてです。正規表現を書いても、固定文字列とほぼ同じ時間で返ってくる——ripgrep が持っていて、自分たちに無かった性質が入りました。
ripgrep との比でいえば -E は 4.06 倍から 7.19 倍になりますが、これは uvp 側が速くなった結果であって、ripgrep が遅くなったわけではありません(55.70 秒は前後で動いていません)。
1.77 倍は、基準のすぐ上でしかない
ここは自分たちに不利なので、独立した見出しにして書きます。
この連載では単項目で 1.5 倍未満の変化を「差」と呼ばないと決めています。13.68 → 7.75 は 1.77 倍。基準は超えていますが、超え方は 1.2 倍ぶんしかありません。基準のすぐ上にある数字を、基準の遥か上にある数字と同じ顔で出すのは誠実ではないので、裏付けを 2 つ添えます。
- 予測と実測が一致した。 改修の前に立てた予測は「必須リテラルで候補を絞れば、
-Eは固定文字列の検索に着地する」でした。実測は 7.75 秒 対 7.15 秒。狙った場所に落ちています。単に「速くなった」ではなく、事前に指定した値に当たったことが裏付けになります - 対照群が動いていない。 ripgrep は 55.70 → 55.70 で不動。そしてリテラルを取り出せない式は 12.88 秒で退行していません。もし測定環境そのものが速くなっていたなら、この 2 つも一緒に速くなるはずです
逆に、この 2 つが無ければ 1.77 倍は書きませんでした。基準を通っただけの数字は、通ったという事実以上のことを何も保証しません。境目のすぐ上にいるときほど、別の角度からの裏付けが要ります。
なお、この連載の基準はもともと「単項目 2 倍未満は差と呼ばない」でしたが、2026-09-25 に 1.5 倍へ下げました。下げた以上、境目付近の数字には今回のような裏付けを添えるのを既定にします。
正直に書いておくこと
- 上の数字は
.uwvz(圧縮キャッシュと索引)が既にある状態、つまり同じファイルに 2 回目以降に聞いたときの値です。.uwvzを作る 1 回目は別の話で、50GB ではuvpが ripgrep より 6〜7% 遅い(59.0 秒 対 54.9〜55.8 秒・v1.6.6.1) - 10:33 と 17:02 は別のランです。同日・同じ機械・同じファイルですが、外付け USB SSD は測るたびに揺れます。だからこそ対照群(ripgrep とリテラル抽出不能の式)を同じランに置いています
- 件数が違う 2 つの検索(602,805 件と 94,979 件)を並べているので、厳密な同条件比較ではありません。それでも「正規表現のほうが 6 秒重い」という段差の説明には足ります
-E -iの併用にはまだ負けが残っています。3GB ホットで ripgrep 0.60 秒 対 1.67 秒(第 3 回)
持ち帰れる一般論: 間違い方の「非対称」を先に見つける
前段フィルタを作るとき、最初に問うべきは「どれくらい絞れるか」ではありません。「間違えたとき、どちらに壊れるか」です。
今回の非対称はこうでした。取り損ねれば遅いだけ、取りすぎれば答えが消える。片側の間違いだけが致命的なら、設計はそちらへ全振りできます。「判断がつかないものは取らない」「知らない構文が出たら従来経路へ落ちる」という素朴な規則で十分になり、抽出器を賢くする必要が無くなります。
賢いフィルタを作ろうとすると、たいてい「ここまでは必須と言えるはずだ」という微妙な判断が増え、そのどれか 1 つが間違った日に結果が静かに欠けます。速度のための仕掛けで正しさを賭けるのは割に合いません。速度は測れば分かりますが、静かに欠けた結果は誰も気づかないからです。
もう 1 つ。段差は、相手の側にあるかどうかを見ると原因が絞れます。 今回は ripgrep の -E と固定文字列が 55.70 と 55.66 で並んでいました。同じ仕事で相手に段差が無いなら、その段差は仕事に固有のものではなく、自分の実装に固有のものです。比較対象は速さの物差しとしてだけでなく、「その遅さは必然か」を判定する道具としても使えます。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
# 3章: 正規表現で探す(必須リテラルは自動で取り出される)
uvp huge.log -E 'timeout|refused'

# 3章: 必須リテラルが取り出せない式でも、そのまま動く(従来経路へ落ちる)
uvp huge.log -E '[0-9]{3}-[0-9]{4}'

# 4章: 大小無視と併用する(この組み合わせは目印の取り方が変わる)
uvp huge.log -E 'timeout|refused' -i

# 5章: 2語で絞り込む(1語目の結果の中から2語目を探す)
uvp huge.log 'ERROR' 'payment'

# 5章: 前後の文脈ごと見る/結果をファイルに書き出す
uvp huge.log 'FATAL' -C 5
uvp huge.log 'FATAL' -out fatal.txt

# 5章: 探した結果を、そのまま画面に渡して開く
uvp huge.log -E 'timeout|refused' -open
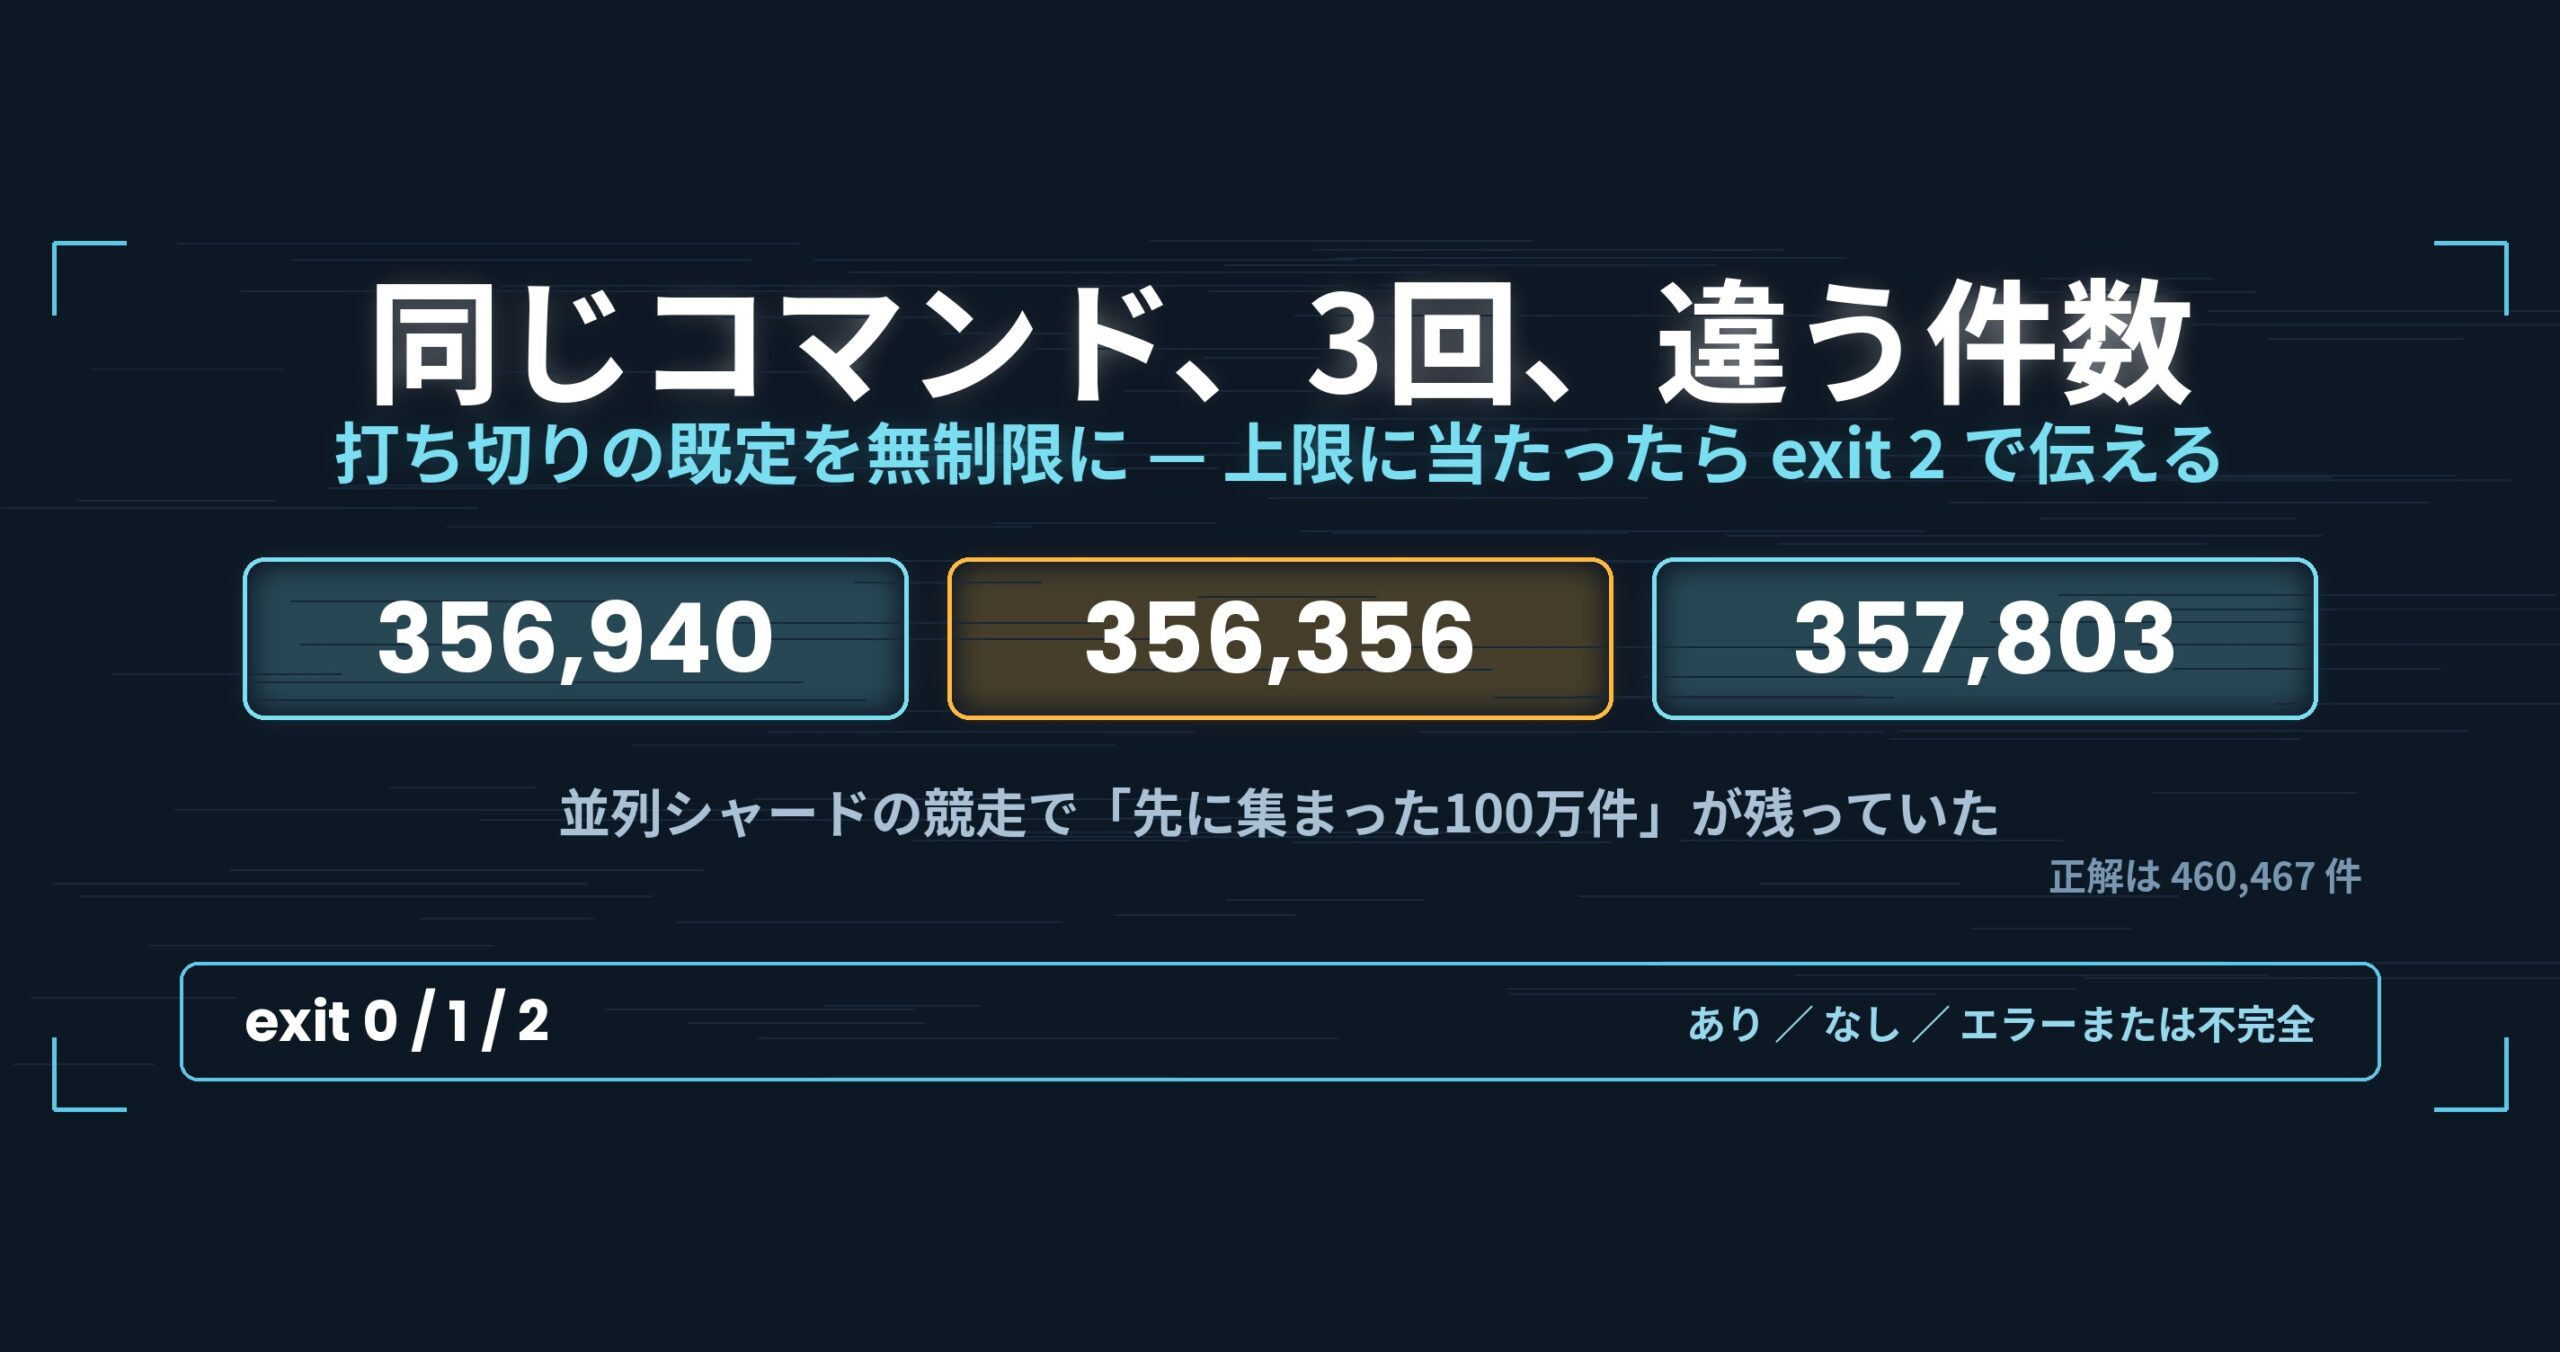
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全。if uvp huge.log -E 'timeout|refused'; then がそのまま書けます。
正直に書くと、1 問目は uvp が ripgrep より少し遅くなります——.uwvz(圧縮+索引)を先に作るぶんで、50GB なら 59.0 秒 対 54.9〜55.8 秒=6〜7%(v1.6.6.1)。効いてくるのは 2 問目からで、同じ 50GB の検索が 6.56 秒、ripgrep に対して 8.4 倍速くなります。3GB のような小さいファイルでは同等——索引を引く意味が薄くなります。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac M4・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 1 回: 「速さの道具ではありません」と書いた日の内訳: https://uvp.y42u.net/blog/uwview-fl01-v160-confession/
- 第 2 回: 2 回半読んでいた CLI を 1 回にする: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 3 回:
-iを文字に戻さずバイトのまま畳む: https://uvp.y42u.net/blog/uwview-fl03-ignorecase-u212a/ - uvp コマンドを付けました(ripgrep との実測比較): https://uvp.y42u.net/blog/uvp-cli-release-vs-ripgrep/
- 1 問目の負けを縮めた話(v1.6.6.1): https://uvp.y42u.net/blog/uvp-v1661-search-while-building/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。