6割しか出ていませんでした。
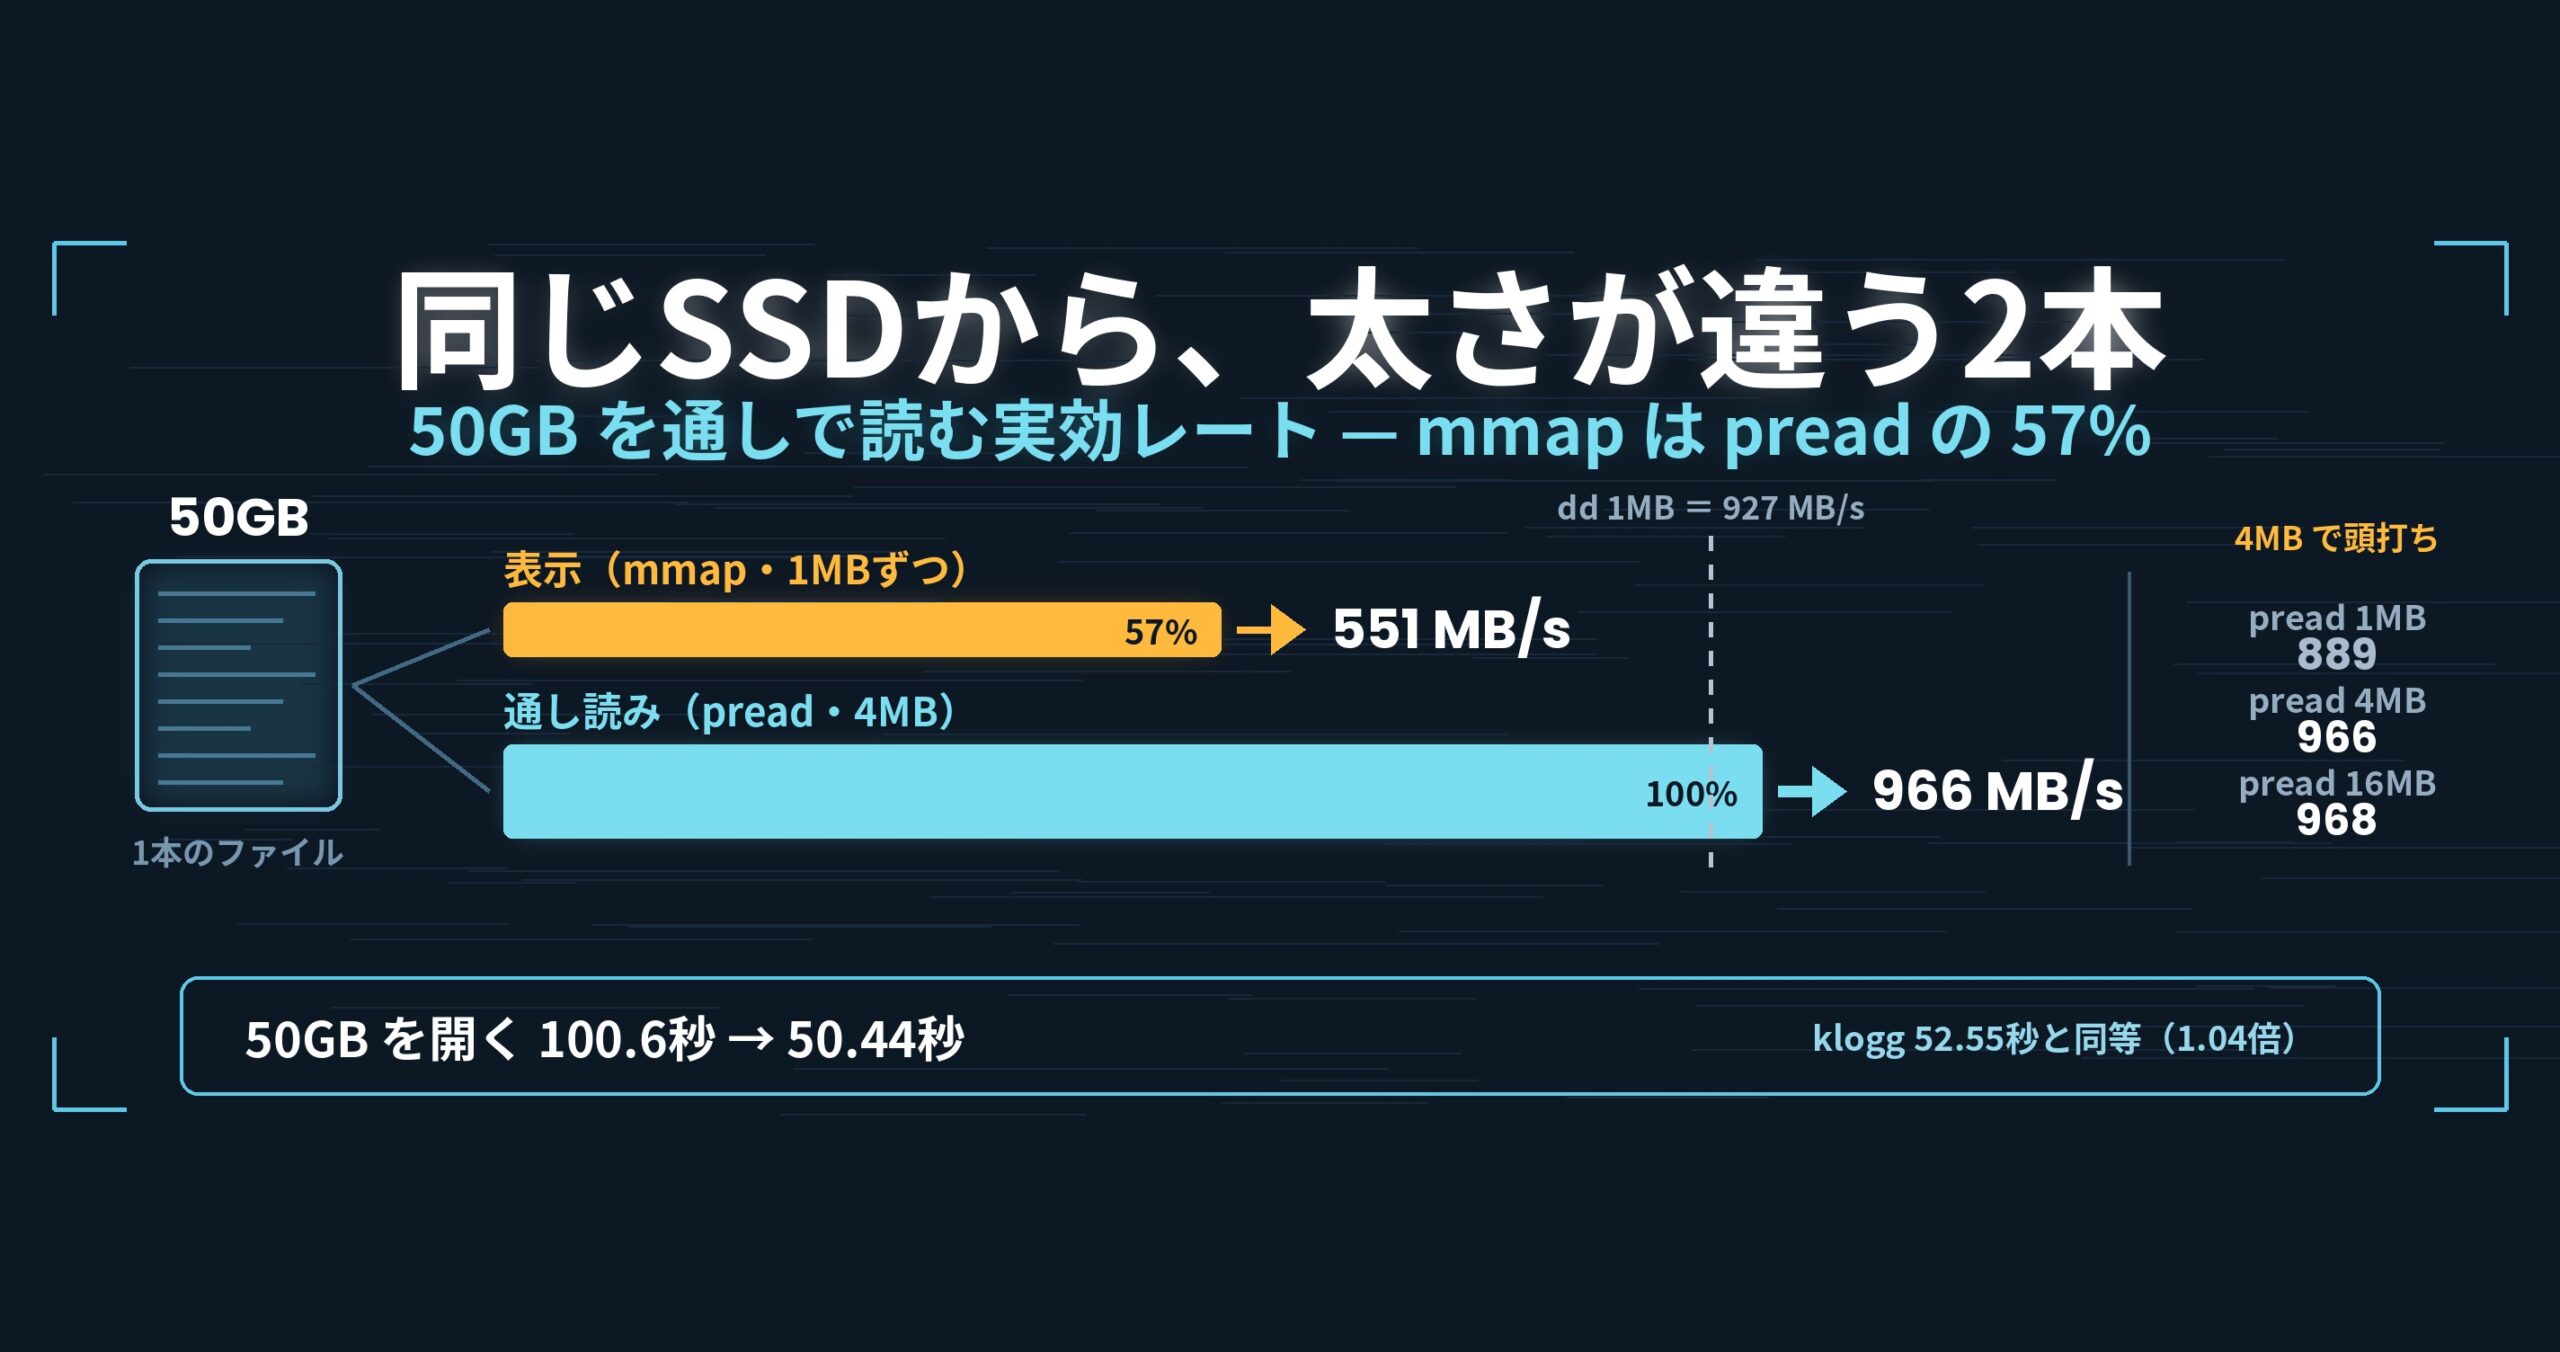
外付け USB SSD は dd で測ると 927MB/s 出ます。ところが同じ SSD から同じ 50GB を、mmap で 1MB ずつ読むと 551MB/s。半分強です。
なぜ遅いのか。そして、どちらの読み方が「正しい」のか。
- 先に結論: 同じファイルに読み方を2つ持たせました。表示は mmap のまま、索引作成と全文検索だけ pread(RandomAccess)に分離——これだけで 50GB を開く時間が 100.6秒→50.44秒(486→969MB/s)、検索が 88.9秒→53.50秒(550→914MB/s)になりました。比較相手の klogg(同じ 50GB を開く 52.55秒)に対して約2倍負けていたところが、ほぼ並びました。実効レートの確定値は dd 927/mmap+1MB 551/pread+1MB 889/pread+4MB 966/pread+16MB 968MB/s——mmap は pread の 57%、そして 4MB で頭打ちです。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・3巡の中央値。詳細は記事末尾。
- 問題: コマンドを速くしたら、画面が取り残された
- 原因: 読み方を1つしか持っていなかった
- 手当て: 読み取り元を2つに分ける
- 数字: 50GB で、開くが半分になった
- 正直に書いておくこと
- 持ち帰れる一般論: 「速い読み方」は用途で決まる
- 使っている道具
- リンク
先に結論: 同じファイルに読み方を2つ持たせました。表示は mmap のまま、索引作成と全文検索だけ pread(RandomAccess)に分離——これだけで 50GB を開く時間が 100.6秒→50.44秒(486→969MB/s)、検索が 88.9秒→53.50秒(550→914MB/s)になりました。比較相手の klogg(同じ 50GB を開く 52.55秒)に対して約2倍負けていたところが、ほぼ並びました。実効レートの確定値は dd 927/mmap+1MB 551/pread+1MB 889/pread+4MB 966/pread+16MB 968MB/s——mmap は pread の 57%、そして 4MB で頭打ちです。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML・3巡の中央値。詳細は記事末尾。
この記事は「First Light」連載の第 10 回です。v1.6.6 には「First Light」というペットネームを付けました。画面もコマンドもファイルを 1 回読むだけで開いて探せるようになり、UwView としてひとつ完成した形になった版だからです。
問題: コマンドを速くしたら、画面が取り残された
連載の第 2 回で、コマンドライン側は 50GB の検索を 203秒から 50.82秒にしました。ところがその改善は、同じコードベースにある画面(GUI)側にはほとんど降りてきませんでした。
当時の 50GB の実測はこうです。
| 操作 | UwView(当時) | klogg 24.11 | 比 |
|---|---|---|---|
| 開く(行番号の索引ができるまで) | 100.6秒 | 52.55秒 | 1.91倍 負け |
| 検索(開いた後) | 88.9秒 | 55.59秒 | 1.60倍 負け |
| 通し(開く→検索) | 189.5秒 | 108.14秒 | 1.75倍 負け |
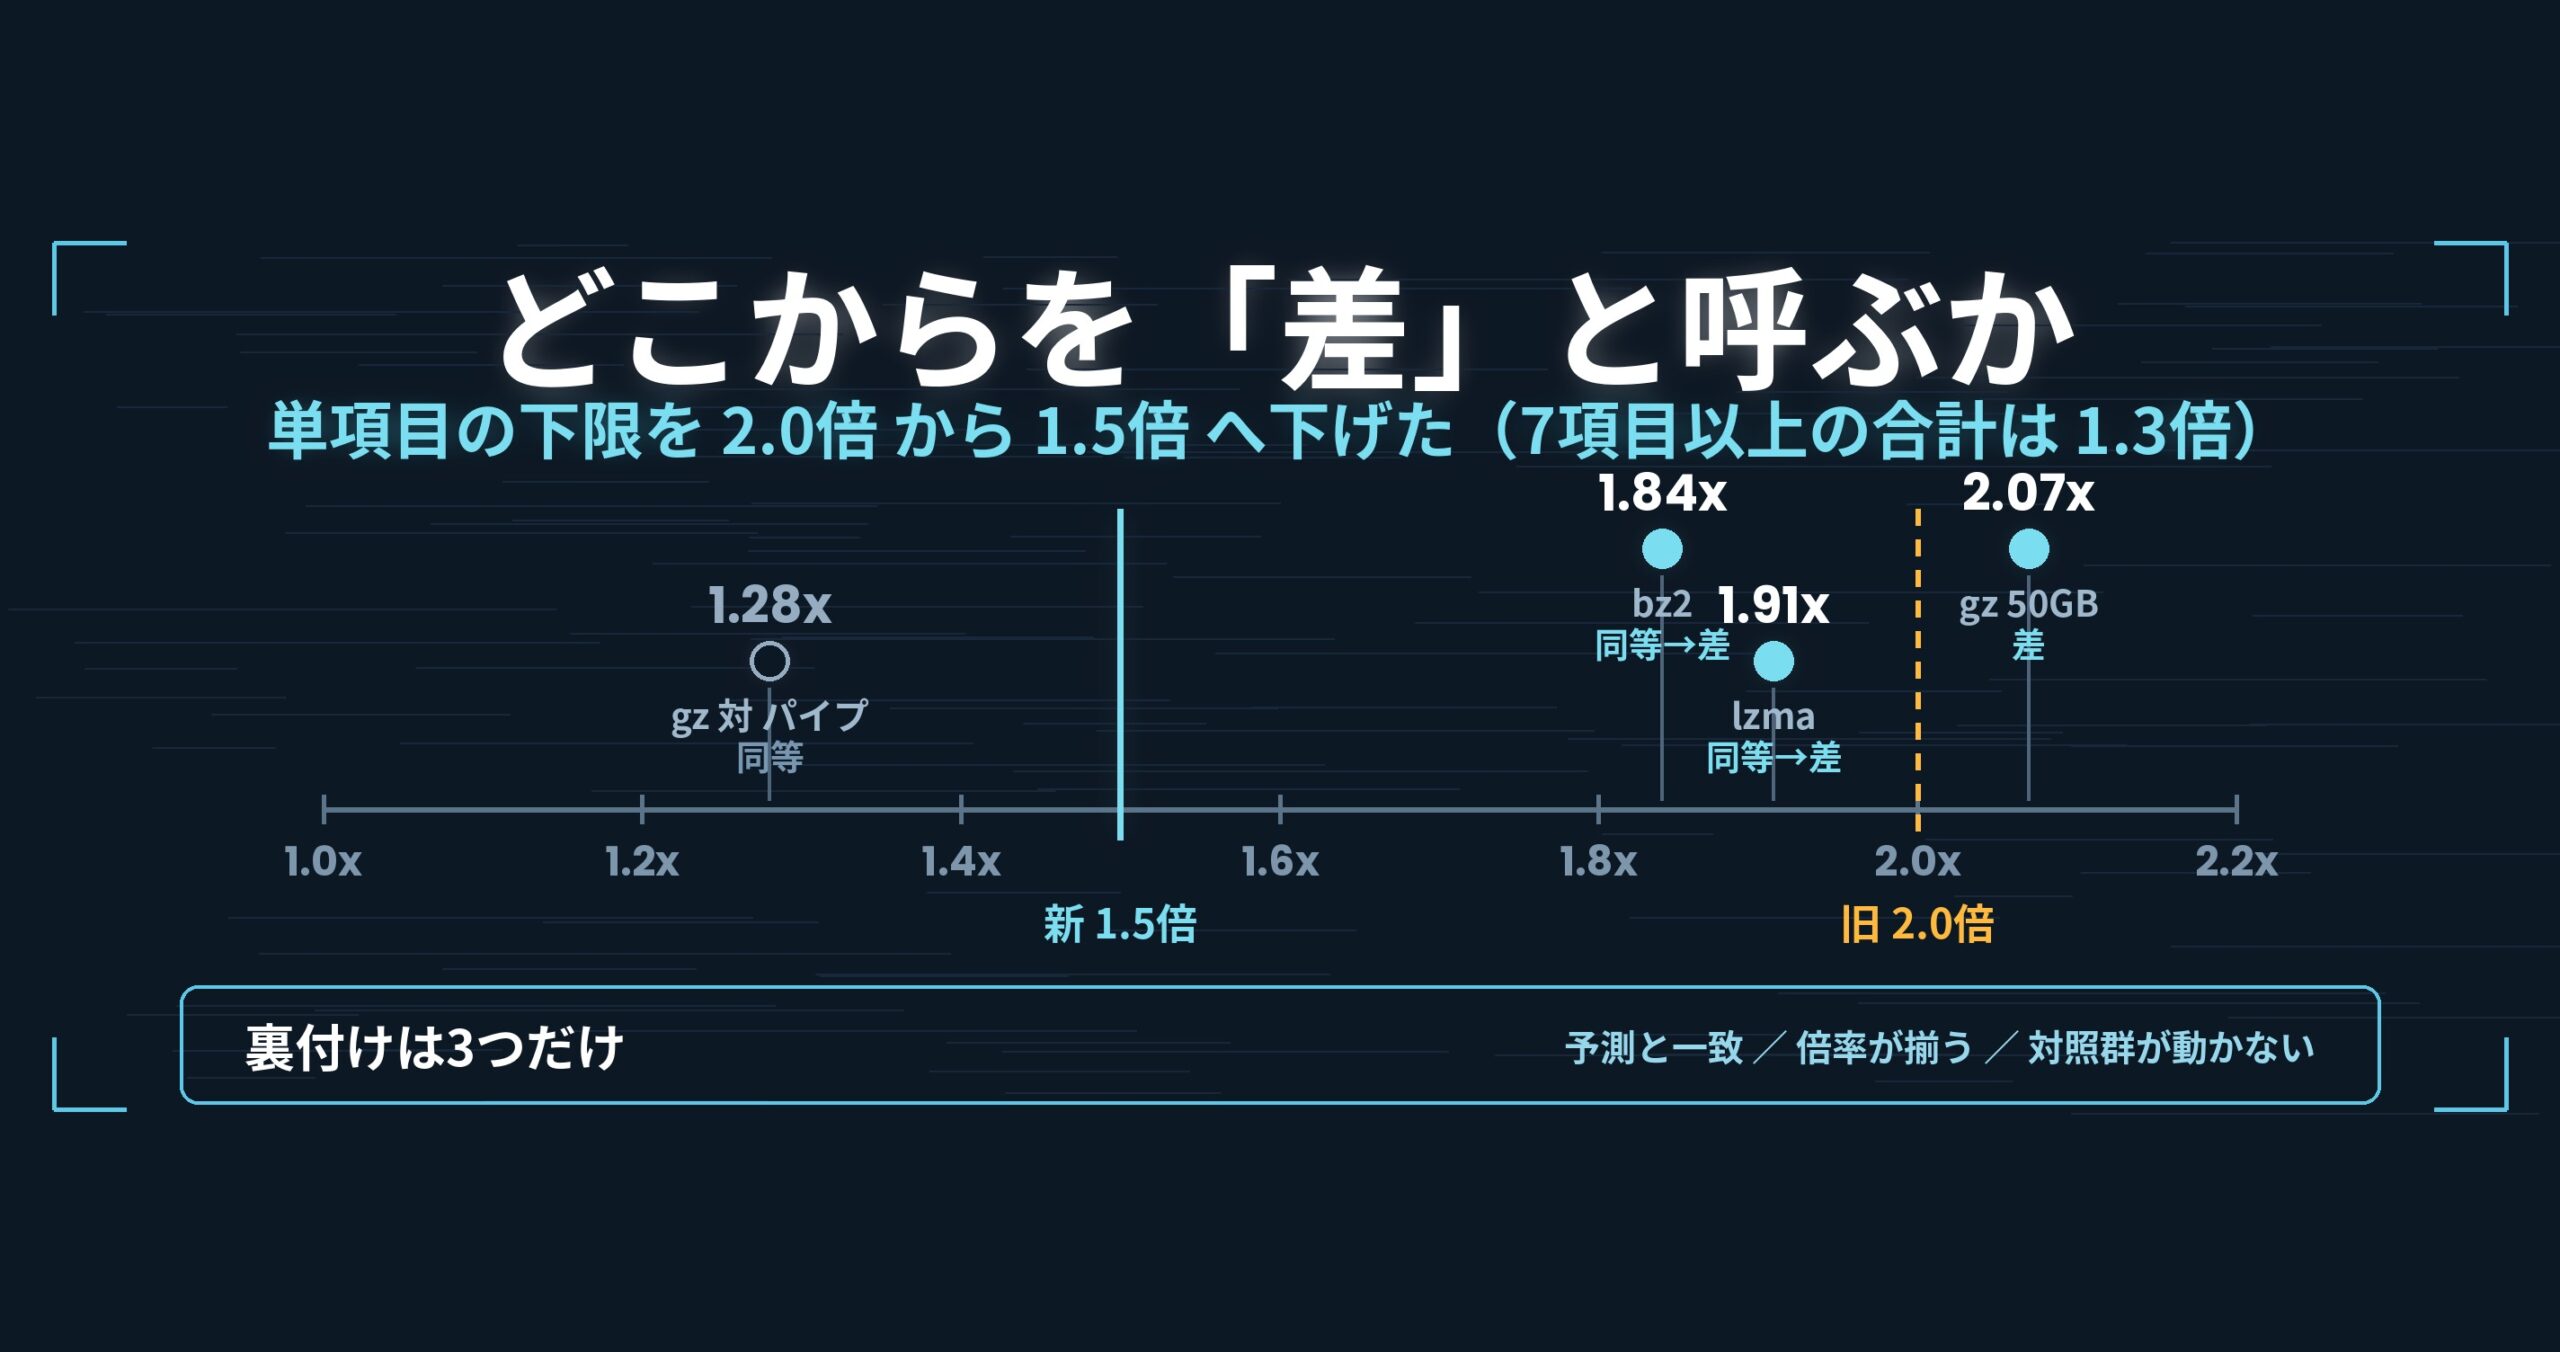
どちらも単項目で 1.5倍を超えているので、これは「差」です(判定の基準は第 9 回に書きました)。しかも同じ機械・同じファイルで、コマンドライン側は 50.82秒。同じ製品の中で、画面だけが 2倍の時間を使っていました。
最初は検索の実装を疑いました。画面側だけ余計な処理を挟んでいるのだろう、と。外れでした。
原因: 読み方を1つしか持っていなかった
分かったのは、遅さの原因が検索の仕方ではなく、読み方と読む回数だったことです。
読み方 — mmap は順次読みで帯域の6割
画面側はファイルを開くときに mmap(メモリマップ)を使います。ファイルをアドレス空間に貼り付けて、配列のように触れる仕組みです。好きな場所をすぐ覗けるので、スクロールする画面には理想的でした。
問題は、その mmap を索引作成にも全文検索にも使い回していたことです。どちらも先頭から末尾まで通しで読む処理です。
実効レートを測り直しました(2026-09-20・50GB・3巡の中央値)。
| 読み方 | 実効レート | pread+4MB 比 |
|---|---|---|
dd(媒体の素の帯域の目安・1MB) |
927MB/s | — |
mmap + 1MB ずつ |
551MB/s | 57% |
pread(RandomAccess)+ 1MB ずつ |
889MB/s | 92% |
pread + 4MB ずつ |
966MB/s | 100% |
pread + 16MB ずつ |
968MB/s | 100% |
mmap が落ちる理屈は、はっきりしています。触った瞬間にページフォルトが起き、カーネルがページを用意して、そこから自分のバッファへコピーが入ります。順次読みでは、この往復が全バイトに 1回ずつかかります。 pread は「このオフセットから 4MB くれ」と 1回頼むだけなので、往復の回数が桁で減ります。
面白いのは 4MB で止まることです。16MB にしても 968MB/s——2MB/s しか動きません。つまり 4MB の時点で律速が媒体側に移っています。ここから先は読み方をどう工夫しても伸びません。並列に読ませても 960MB/s 前後で止まりました(媒体が飽和している)。だから通し読みは単線のままにしています。スレッドを増やす改修をしなかったのは、増やしても伸びないと測ってから決めたからです。
数字が2つ、ぴったり符合した
ここで気づいたことが 1つあります。改善前の検索が 550MB/s だったことです。
mmap の上限が 551MB/s。検索の実測が 550MB/s。検索は、読み方の上限にぴったり張り付いていました。 判定の仕方を工夫する余地はここには無くて、読み方を変えるしか手が無かったということです。
一方、索引作成は 486MB/s でした。551 より遅い。読み方の上限より下にいるので、こちらは読み方以外にもう 1つ足を引っ張るものがあります。それは改行の数え方でした(IndexOf に替えた話は次の第 11 回で書きます)。
同じ「遅い」でも、上限に張り付いているのか、上限より下にいるのかで、直す場所が変わります。
読む回数 — 開くときに1回、検索でもう1回
もう 1つは単純な話です。画面は開くときに索引のために 1回読み、検索でもう 1回読んでいました。通しで 189.5秒は、ほぼ 100.6 + 88.9 です。コマンドライン側は 1回しか読んでいません(第 2 回)。
手当て: 読み取り元を2つに分ける
やったことは、DocumentSession に通し読み専用の読み取り元(ScanSource)を足すことです。
- 表示は
mmapのまま。これは変えません。開いた直後に末尾へ飛べる、任意の位置をすぐ覗ける、追記されたら貼り直して伸ばせる(Tail)——この性質はmmapでしか安く手に入りません - 索引作成と全文検索だけ
pread。先頭から末尾まで通しで読むと分かっている処理だけを、新しく足したSequentialFileByteSource(RandomAccessで 4MB ずつ)に向けます
commit は 83e1e4e(SequentialFileByteSource.cs)と 08fd81d(画面側をそこに繋ぐ)です。
言い方を変えると、「ファイルをどう読むか」を 1つに決めるのをやめました。 入力は同じ 1本のファイルで、用途が 2つある。ランダムアクセスは mmap、通し読みは pread。用途ごとに読み方を選べる形にしたのが、この回の設計上の変更点です。
読む回数のほうは、索引が未完成のまま検索が始まったら、走行中の索引作成を止めて 1回読みで両方やる形にしました(コマンドライン側と同じ判定コード)。読み切ったときだけ索引を採り、上限で打ち切ったときは採りません。
踏んだ罠: pread は同期で返る
一度ハングさせています。pread は同期で返るので、UI スレッドで回すと await しても一度も制御が戻りません。50GB なら 50秒、258GB なら 4分半の無応答です。Task.Run で背景へ逃がして直しました(64f80c7)。
再発防止に入れたテストは、秒数を見るものではありません。ヒットの通知が、呼び出し元と別のスレッドから来ることを確かめます。UI スレッドで回していれば必ず落ちるので、時間に依存しません。「遅い」をテストするのは難しいけれど、「別スレッドから来る」なら決定的に書けます。
数字: 50GB で、開くが半分になった
| 操作(50GB) | 前 | 後 | 倍率 | klogg 24.11 |
|---|---|---|---|---|
| 開く(索引ができるまで) | 100.6秒(486MB/s) | 50.44秒(969MB/s) | 1.99倍 | 52.55秒 |
| 検索(開いた後) | 88.9秒(550MB/s) | 53.50秒(914MB/s) | 1.66倍 | 55.59秒 |
| 索引作成中に検索(1回読み) | ハング | 50.6秒(966MB/s) | — | — |
| 開く+あとから検索 | 116.4秒(59.98 + 56.38) | 同構成なら同左 | — | 108.14秒 |
開く・検索ともに klogg とほぼ並びました。 1.04倍・1.04倍なので、これは「勝った」ではなく「同等」です(単項目 1.5倍未満)。約2倍負けていたところが同等になった、という言い方までが正確です。
そして「索引作成中に検索」の 50.6秒は 966MB/s——pread+4MB の上限 966MB/s と同じ値です。媒体の限界で走っています。
258GB のファイルに当てはめると、読み方の違いだけで 459秒 対 273秒の見積りになります(実測ではなく帯域からの換算です)。
正直に書いておくこと
- 上の秒数はすべて Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML(51,254,526,392 バイト。記事では「50GB」と書いています)での測定例です。内蔵 NVMe や別の OS では数字が変わります。とくに媒体が速くなると
mmapとpreadの差はもっと開くはずですが、そこは測っていません - 改善後の索引作成が 969MB/s で、
ddの 927MB/s を上回っています。順序が逆に見えますが、これはddを 1MB ブロックで測ったからで、媒体の真の上限ではありません(pread+4MB の 966〜968MB/s のほうが上限に近い)。素読みより速い数字が出たら、まず測り方を疑うべきという第 9 回の話の実例です - 帯域の 4 値は 2026-09-20 に 3巡して取り直した中央値です。それ以前にソースコードのコメントに書いていた値(別日の 1巡)とは少しずれます。記事には取り直した値だけを載せています
- klogg との比較は、開く操作から件数が確定するまでをストップウォッチ 1本で測った手計測です。人間の操作時間が入ります。自動計測ではありません
- 私は比較の一方の開発者です。その分は割り引いてお読みください
- ripgrep が
mmapを使わない理由についても測ったことがありますが、それは別の記事にまとめてあります。本記事は「自分のアプリの読み方」の話に絞りました
持ち帰れる一般論: 「速い読み方」は用途で決まる
(1)mmap は速い/遅いではなく、向き不向きです。 ランダムアクセスなら圧勝、順次読みなら pread の 57%。同じ API が用途によって 2倍近く違います。「mmap は速い」という一般論は、どちらの用途の話かを言わないと意味を持ちません。
(2)1つの入力に、複数の読み方を持たせてよい。 抽象化の教科書は「ファイルを読む」を 1つのインターフェイスに寄せろと言います。それは正しいのですが、通しで読むと分かっている経路だけを別の実装に向けるのは、抽象化の敗北ではなく設計です。今回は表示(mmap)と通し読み(pread)の 2本で足りました。
(3)上限に張り付いているかどうかを、先に見る。 検索は 550MB/s で、読み方の上限 551MB/s に張り付いていました。張り付いている処理は、その工程をどう最適化しても動きません(読み方を替えるしかない)。逆に索引作成は 486MB/s で上限より下だったので、そちらには読み方以外の原因がありました。「遅い」を見たら、まず上限を測って、張り付いているかを判定する。 この 1手で、直す場所が決まります。
(4)ブロックサイズは、伸びなくなるところまで測る。 1MB → 4MB は 889 → 966MB/s で効きますが、4MB → 16MB は 966 → 968MB/s です。測らずに「大きいほど速い」でメモリを積むと、無駄に常駐が増えるだけでした。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
コマンドラインから同じことをする
この回の変更は画面側のものですが、読み方の違いは手元でも確かめられます。
# 媒体の素の帯域の目安(ブロックサイズを変えて何度か)
dd if=huge.log of=/dev/null bs=1m count=20000
dd if=huge.log of=/dev/null bs=4m count=5000

# 1回読みで検索する(コマンドライン側は最初からこの形)
/usr/bin/time -p uvf huge.log 'ERROR' > /dev/null

# 探した結果をそのまま画面へ渡す(2回読みにしない。第6回)
uvf huge.log 'ERROR' -open

# 件数だけ先に知る
uvf huge.log 'ERROR' -count
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
正直に書くと、1問目は uvp が ripgrep より少し遅くなります——.uwvz(uvp 用の圧縮形式+索引)を先に作るぶんで、50GB なら 59.0秒 対 54.9〜55.8秒=6〜7%(v1.6.6.1)。効いてくるのは 2問目からで、同じ 50GB の検索が 6.56秒、ripgrep に対して 8.4倍速くなります。3GB のような小さいファイルでは同等です。無料の uvf は、どのサイズでも ripgrep と同等です(実測記事。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での測定例で、環境により異なります)。
リンク
- 第 2 回: 2回半読んでいたコマンドを1回にした話: https://uvp.y42u.net/blog/uwview-fl02-one-pass-rawgrep/
- 第 6 回: 探した結果を画面に渡して2回読みを1回に: https://uvp.y42u.net/blog/uwview-fl06-cli-to-gui-handoff/
- 第 7 回: 3GB でだけ負けた理由は固定費だった: https://uvp.y42u.net/blog/uwview-fl07-3gb-fixed-cost/
- 第 9 回: どこからを「差」と呼ぶかの基準: https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- ripgrep が 50GB で mmap を使わない理由: https://uvp.y42u.net/blog/uvp-rg-no-mmap-50gb/
- klogg と開く・探す・通しで比べた話: https://uvp.y42u.net/blog/uvp-klogg-open-lose-flow-win/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。