変換が毎回入っていました。
Shift-JIS の 3GB を探すと、ヒットした行を数える前に、3GB 分の文字コード変換が走ります。2回目も、3回目も、同じ変換です。
索引を持っているのに、なぜ毎回変換していたのか。その答えは、索引の中身を何で持つかという、1行の決めごとでした。
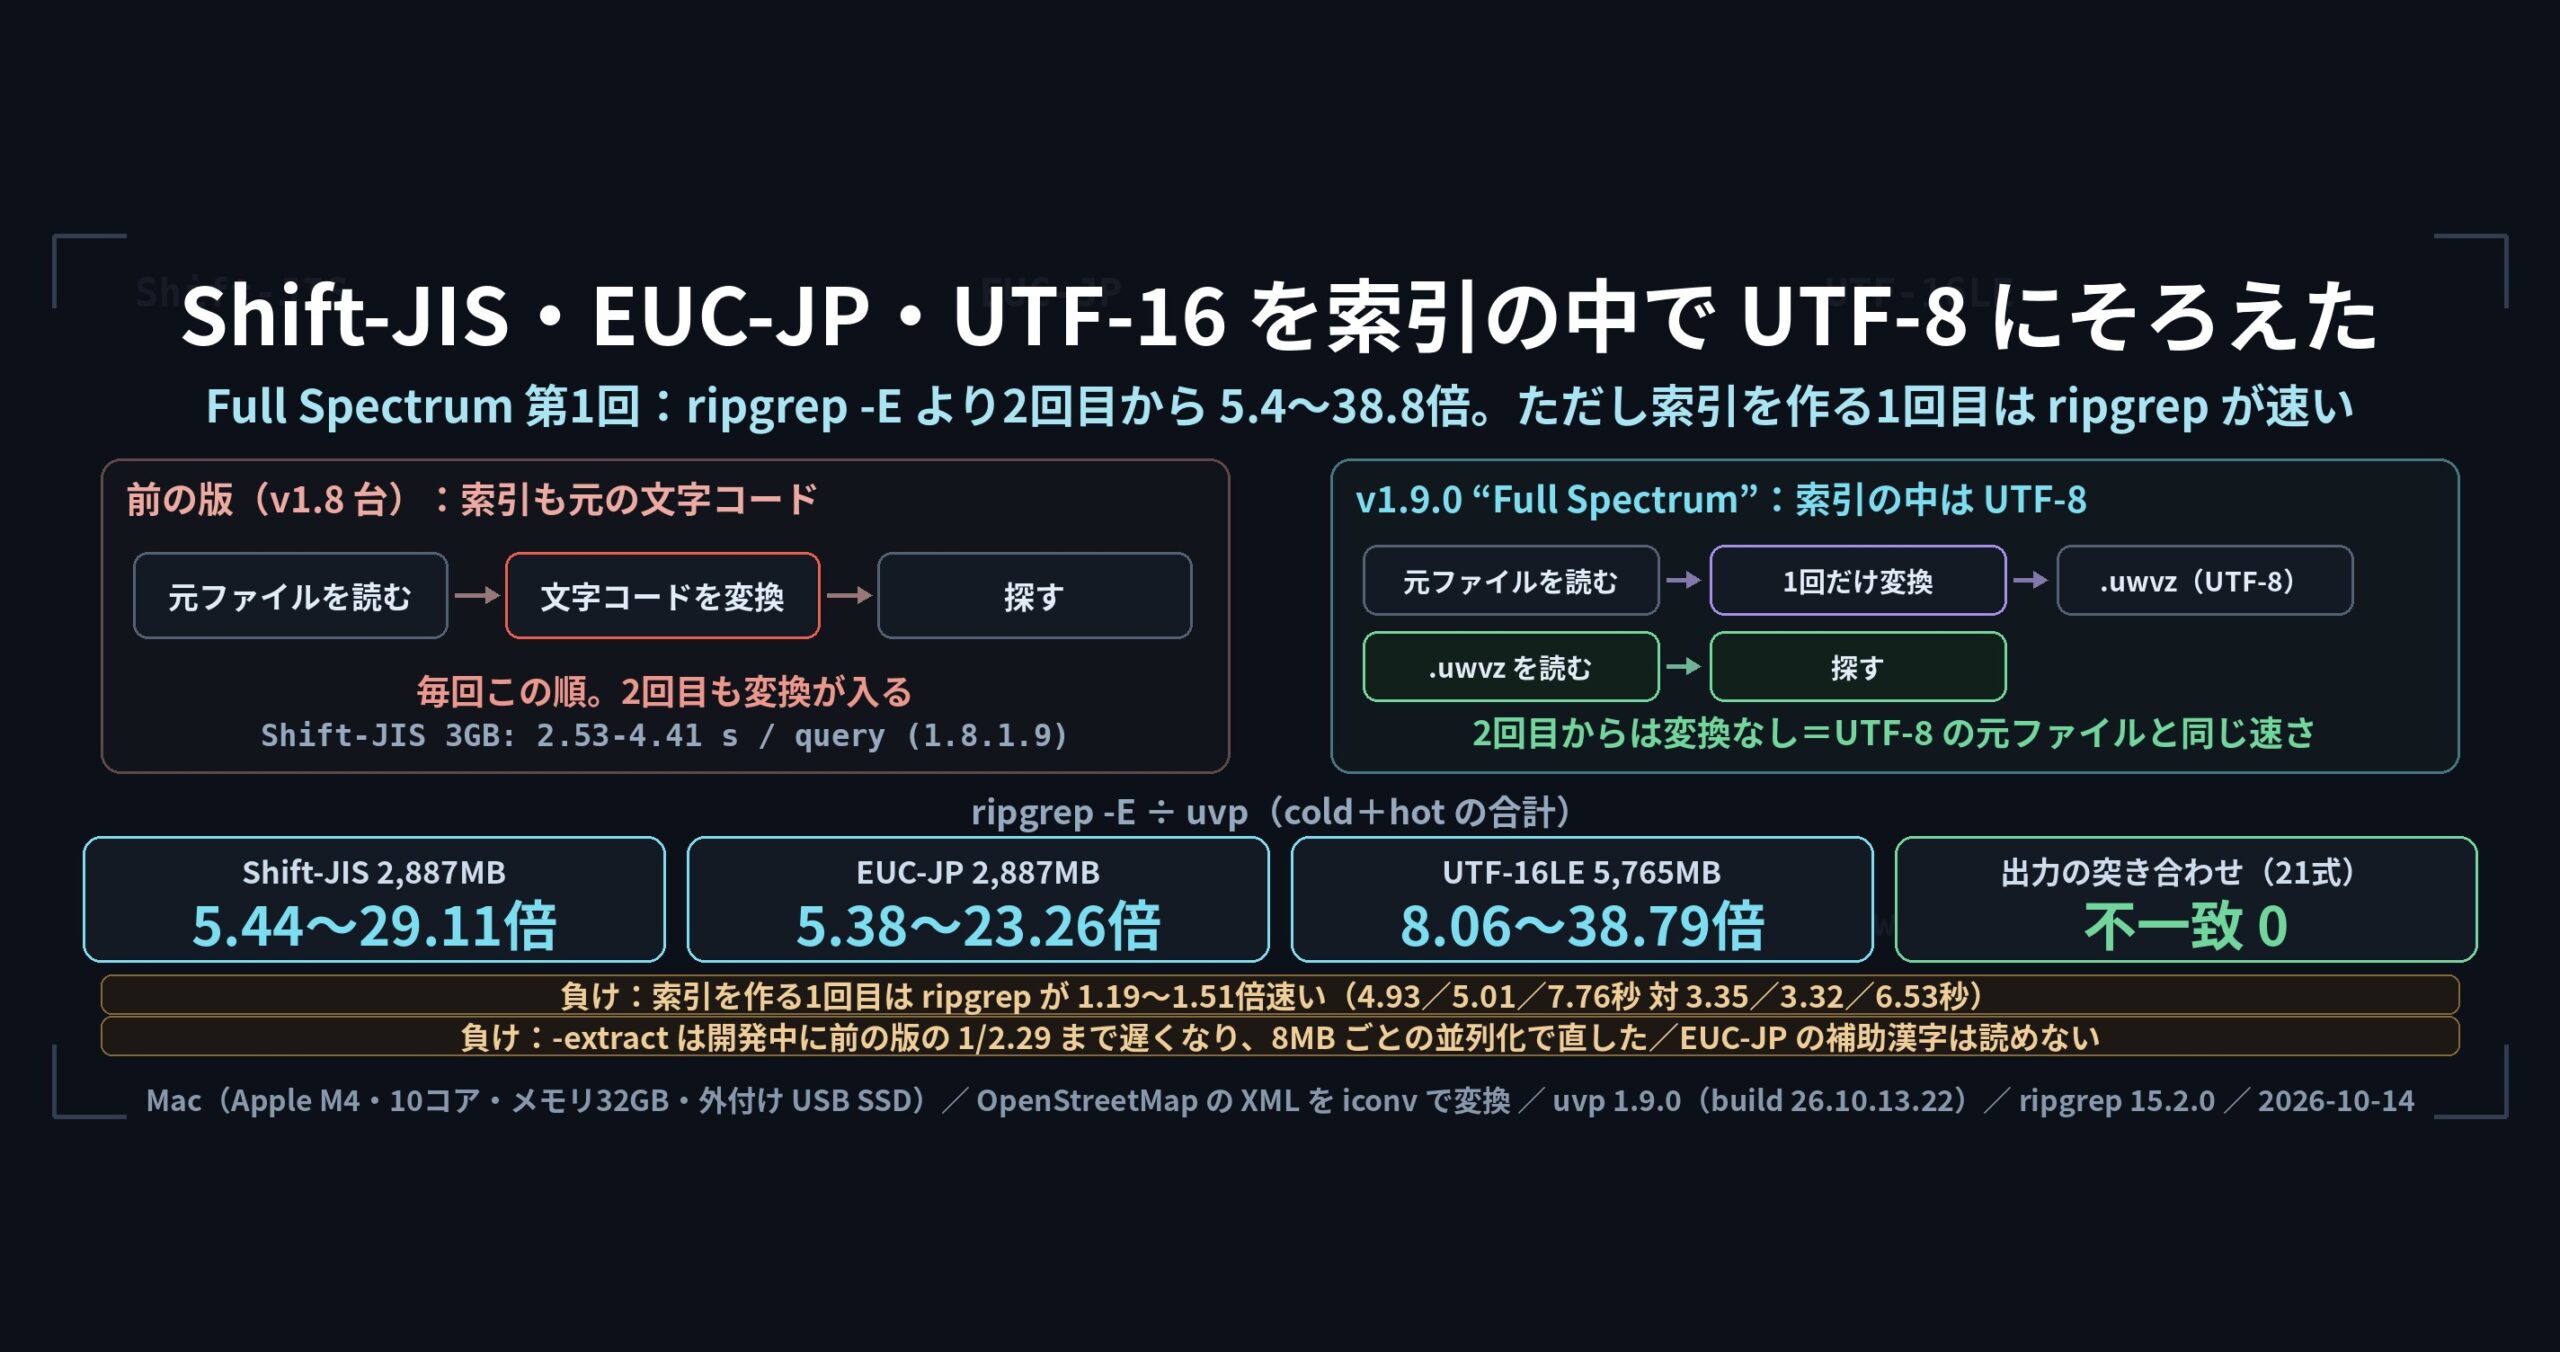
先に結論: 索引の中を UTF-8 にそろえたら2回目から5.4〜38.8倍になったが、索引を作る1回目は ripgrep の方が1.19〜1.51倍速い
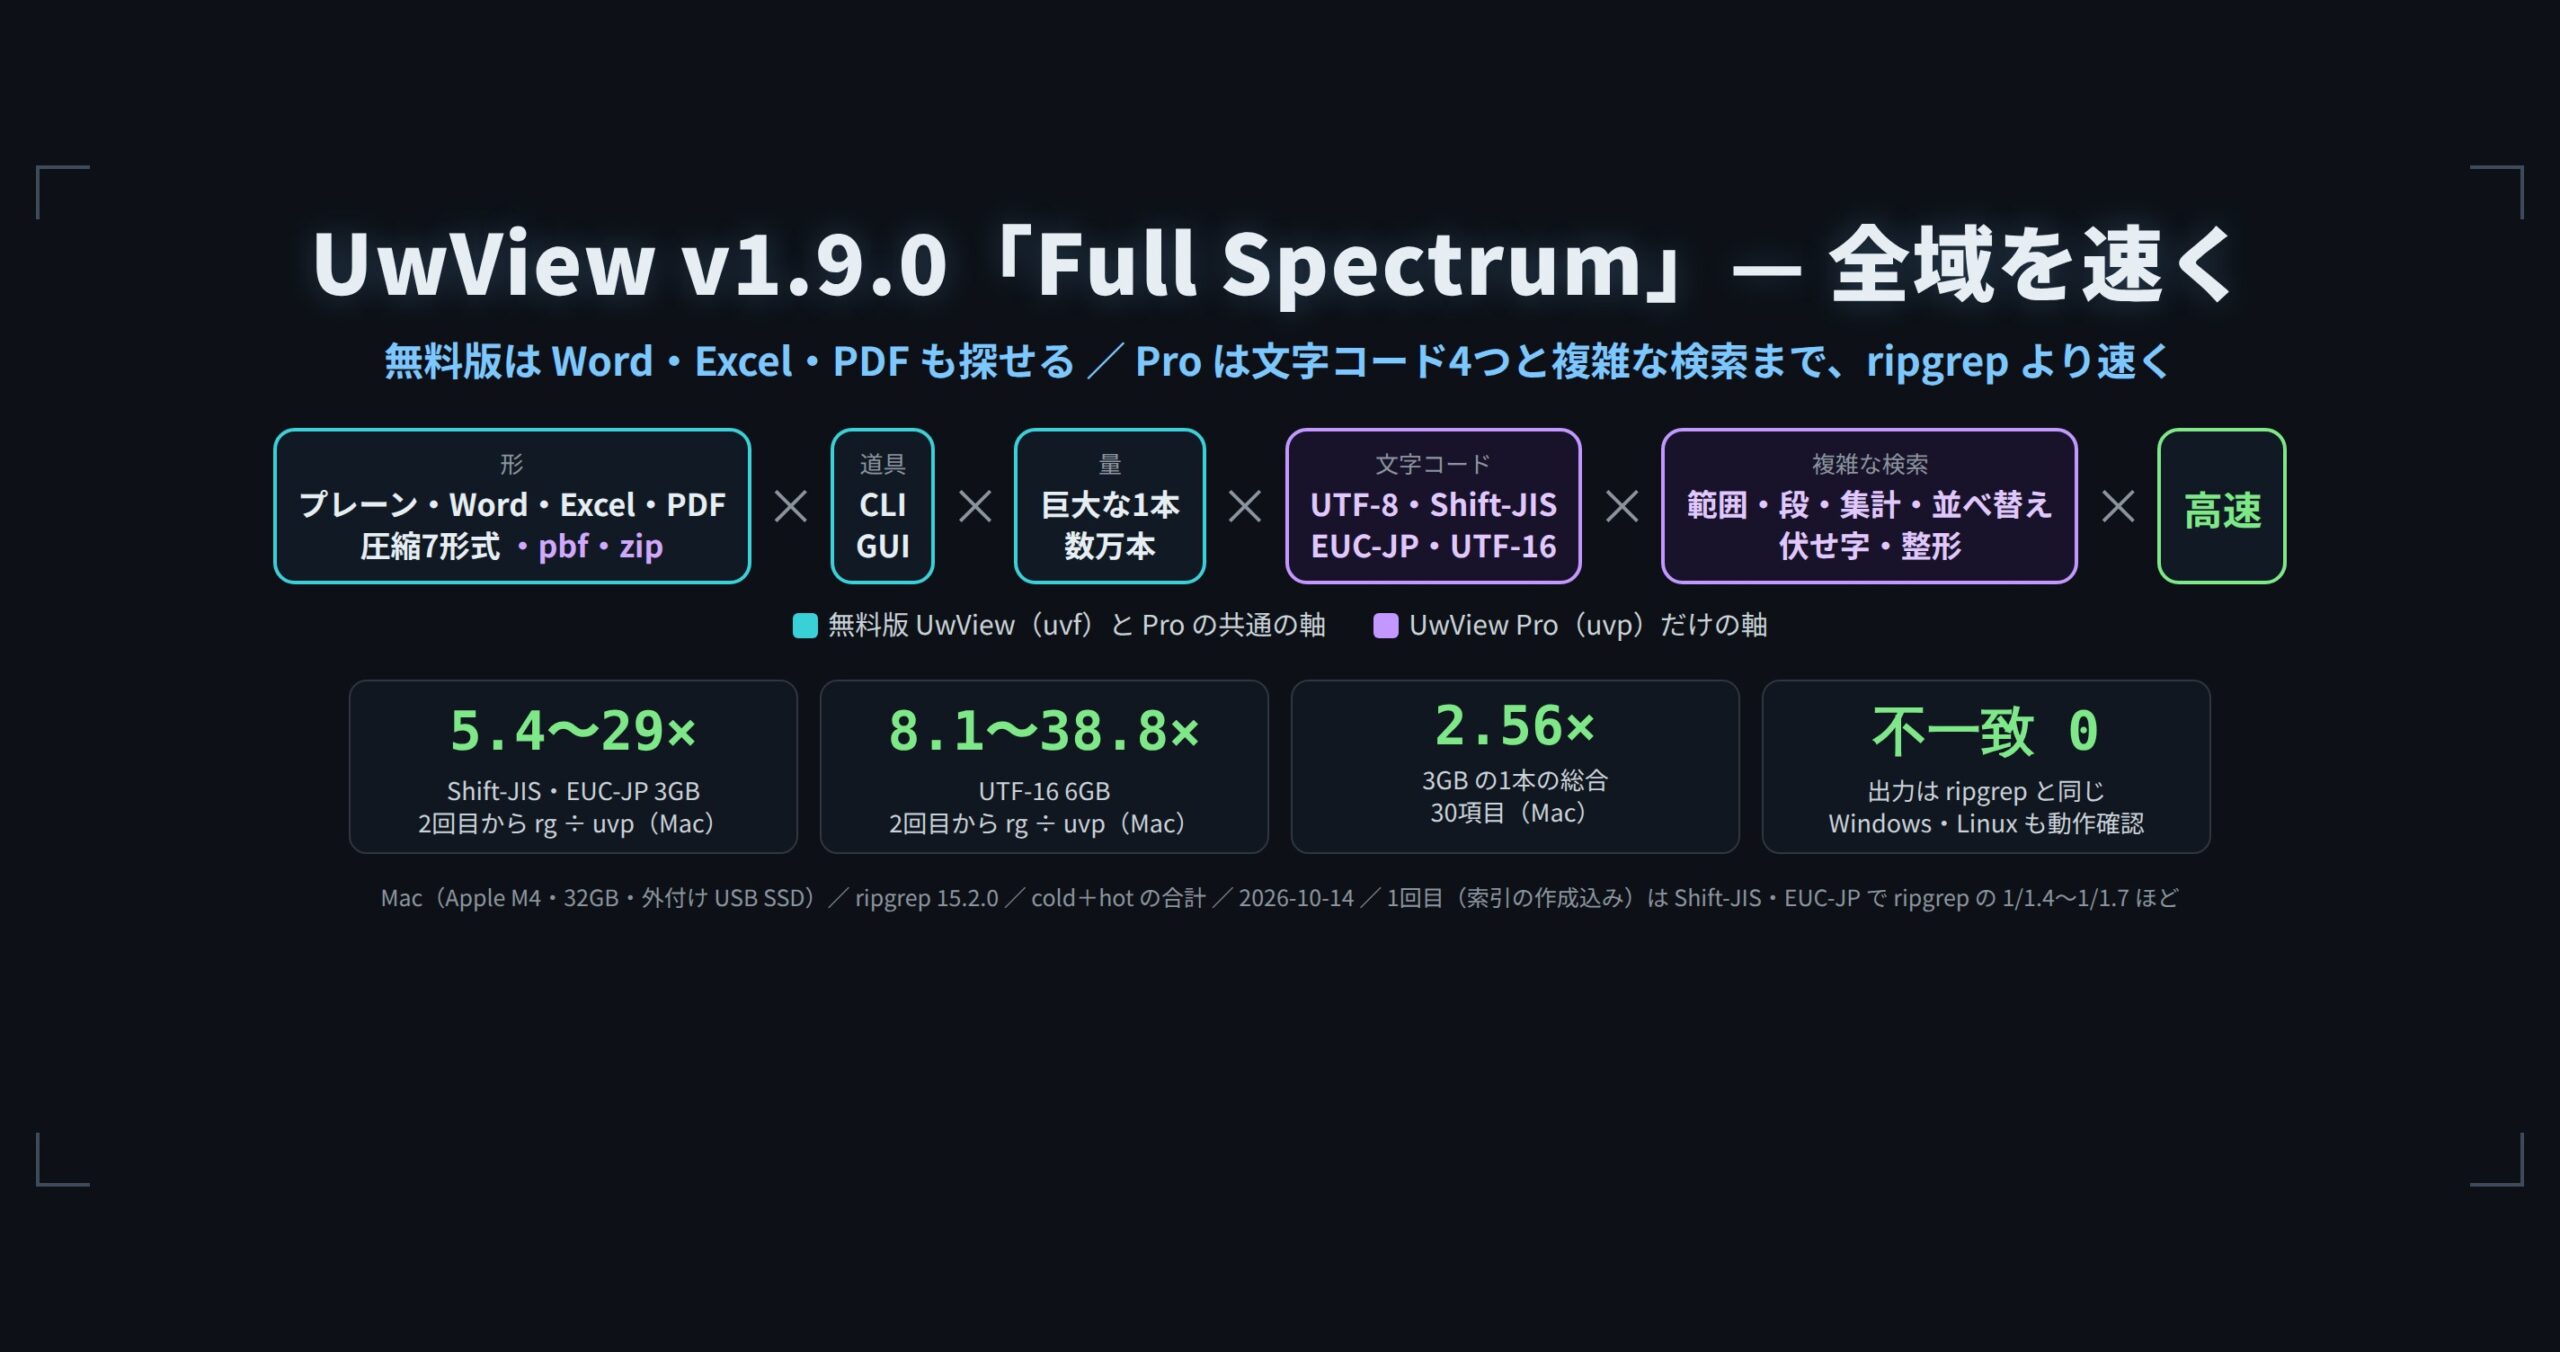
.uwvz(uvp 用の圧縮形式+索引)の中身を、Shift-JIS・EUC-JP・UTF-16 のときも UTF-8 に変えて持つようにしました。変換は索引を作る1回だけになり、2回目からの検索は UTF-8 のファイルを探すのと同じ速さになります。Mac で測った2回分の合計で、Shift-JIS 3GB が rg -E shift_jis の 5.44〜29.11倍、EUC-JP 3GB が 5.38〜23.26倍、UTF-16LE 6GB が 8.06〜38.79倍。出力は7パターン×3文字コード=21式すべて ripgrep と1バイトも同じで、終了コードも同じでした。
負けを先に書きます。索引を作る1回目は ripgrep の方が速いです——Shift-JIS で 4.93秒 対 3.35秒(ripgrep の方が 1.47倍速い=1.5倍未満なので同等)、EUC-JP で 5.01秒 対 3.32秒(ripgrep の方が 1.51倍速い)、UTF-16LE で 7.76秒 対 6.53秒(同等)。さらに -extract(元の文字コードに戻す)は、作っている途中の版で前の版の 1/2.15〜1/2.29 まで遅くなり、並列化で作り直しました。EUC-JP の補助漢字(JIS X 0212)は、いまも読めません。
uvf・uvpは私が作っている UwView の検索コマンドです(uvfは無料版、uvpは有料版 UwView Pro)。この記事の数字は v1.9.0 “Full Spectrum”(2026年10月14日公開・build 26.10.13.22)を Mac(Apple M4・10コア・メモリ32GB・外付け USB SSD)で 2026年10月14日に測ったものです。v1.9 には「Full Spectrum」というペットネームを付けました。Shift_JIS・EUC-JP・UTF-16 のファイルも中を UTF-8 にそろえ、文字コードやファイルの種類を問わず、同じ速さで探せるようになった版だからです。
問題: 索引を持っているのに、検索のたびに 3GB を変換していた
uvp は1回目に .uwvz を作り、2回目からはその中を探します。前の版(v1.8 台・Finder Scope)の .uwvz は、元のファイルの文字コードをそのまま持っていました。Shift-JIS のファイルなら、索引の中身も Shift-JIS です。
そうすると、検索のたびにこうなります。
- 探す文字列(UTF-8)を Shift-JIS に変える、あるいは読んだバイトを UTF-8 に変える
- どちらにしても、ヒットするかどうかを決める前に、読んだ分の変換が入る
- 2回目も3回目も同じ変換が入る。索引があってもここは減らない
実際の数字で見ると、前の版(1.8.1.9)で Shift-JIS 2,887MB の7パターンを2回ずつ測ると 2.53〜4.41秒でした。UTF-8 の同じ内容なら 0.3秒台で終わる検索です。索引で「読む回数」を1回に減らしたところまでは効いていて、その先の「文字にする回数」が残っていたということです。
ついでに、もっと悪いことも起きていました。6GB の UTF-16 を元の文字コードのまま探すと、Specified argument was out of the range で落ちます(終了コード 2)。1,000MB までは正しく動くので気づきにくい不具合で、1.8.1.9・1.8.3.14 でも同じでした。読み込みの持ち越し(文字の途中で切れた分)が読み込み枠を超えるのが原因です。
原因: 「元のバイト位置」を守るために、元の文字コードを持っていた
では、なぜ最初から UTF-8 で持たなかったのか。理由は速さではなく、位置です。
uvp の索引は、元のファイルの何バイト目に何行目があるかを持っています。画面(GUI)で開いたときに、コマンドが作った索引をそのまま差し込めるのも、-extract で元のファイルに戻せるのも、この位置が元のファイルと一致しているからです。文字コードを変えると、バイトの位置がずれます。 Shift-JIS の2バイトの字は UTF-8 で3バイトになるので、同じ行の先頭でも何バイト目かが変わります。
位置がずれた索引を元のファイルの画面に差し込むと、行がずれて表示されます。だから「変えない」が既定でした。ここを変えるには、位置が混ざる道を全部ふさぐ必要がありました。
手当て: 版4の .uwvz は常に UTF-8・常に単独で開く
直し方は、次の4つです。
1. .uwvz は常に UTF-8(版4)にする。 版3以前の .uwvz は読まず、開けなければ作り直します。「元の文字コードのまま作る」指定(--keep-encoding)は一度作りましたが、外しました。選べるようにすると、どちらで作った索引かで速さと戻し方が変わり、画面とコマンドで食い違う道が増えます。1本に決めたほうが説明も試験も簡単になる、という判断です。
2. そろえた .uwvz は常に単独で開く。 元のファイルの画面に差し込む道(行索引の差し込み・元ファイル画面からの検索・作りかけへの追記・束ねへの書き足し)は、メタデータの長さと時刻で照合して弾きます。ヘッダーの時刻を 0 にしてあるので、照合に通りません。gz を開くときと同じ扱いになります。
3. 行ごとに文字にする。 ここが一番細かい罠でした。.NET の CP932 の既定の読み方は、0x82 0x0A(2バイト文字の途中で切れたバイト+改行)を1文字にまとめて改行を食べます。素直に流し読みすると、改行の数が元のファイルと変わり、行番号がずれます。改行の数が変わるときは行単位で読み直して、行番号を元と同じに保つようにしました。
4. 壊れたバイトは「・」にする。 指示では U+FFFD(替え字)にする予定でしたが、いまの画面と検索は CP932 の既定の読み方なので「・」で表示されます。索引の中も「・」にそろえておくと、検索の出力が前の版と1バイトも変わりません。ここは「正しさ」より「前と同じ」を取りました。
戻すとき(-extract)の約束も、1つ弱くしました。バイト単位の一致は約束せず、「文字として同じもの」を戻します。 同じ字に番号が2つある字(NEC 選定 IBM 拡張の ED40 など)は、Windows と同じ標準の番号(FA5C)で戻ります。そのぶん、戻して比べる処理をやめられたので、索引の作成が 9.67秒から 5.33秒になりました(開発中の版での測定。元の文字コードのまま作っていた頃の 5.01秒と同等)。手元の業務データ(CAD 変換の Shift-JIS の CSV・テキスト 123本・213MB)では、123本とも元とバイト一致で戻りました。
数字: 2回目から5.4〜38.8倍、1回目は ripgrep が速い
測ったのは、OpenStreetMap の XML(2,892MB・UTF-8)を iconv で Shift-JIS・EUC-JP・UTF-16LE に変えたファイルです。相手は ripgrep 15.2.0 に -E <文字コード> を付けて、同じ文字コードを正しく探させた値です。cold はキャッシュを破棄して10秒待ってから、hot はその直後に測りました。
索引を作る1回目(.uwvz を消して1問探す)
| ファイル | uvp(秒) | ripgrep -E(秒) | 向きと倍率 | .uwvz(MB) |
|---|---|---|---|---|
| Shift-JIS 2,887MB | 4.93 | 3.35 | ripgrep の方が 1.47倍速い(同等) | 262.1(元の 9.1%) |
| EUC-JP 2,887MB | 5.01 | 3.32 | ripgrep の方が 1.51倍速い | 262.1(元の 9.1%) |
| UTF-16LE 5,765MB | 7.76 | 6.53 | ripgrep の方が 1.19倍速い(同等) | 262.3(元の 4.5%) |
索引を作るぶんだけ遅い、という当たり前の結果です。1問しか探さないなら、ripgrep -E の方が速いです。
2回目から(Shift-JIS 2,887MB・cold と hot の合計)
| パターン | ヒット(行) | ripgrep(秒) | uvp(秒) | ripgrep ÷ uvp(倍) | |
|---|---|---|---|---|---|
| A1 | 素の検索 東京 |
11,274 | 4.44 | 0.48 | 9.25 |
| A2 | -i 大小無視 HIGHWAY |
940,482 | 4.79 | 0.79 | 6.06 |
| A3 | -E 正規表現 k="highway[^"]*" |
928,301 | 4.69 | 0.81 | 5.79 |
| A4 | -E 行頭つき ^ *<tag k="name" |
222,072 | 4.60 | 0.69 | 6.67 |
| A5 | -E -i 併用 K="NAME[^"]*" |
491,643 | 4.74 | 0.85 | 5.58 |
| A6 | -v 当てはまらない行 =" |
7,698,790 | 6.53 | 1.20 | 5.44 |
| A7 | -E -v 併用 ^ +< |
1 | 8.15 | 0.28 | 29.11 |
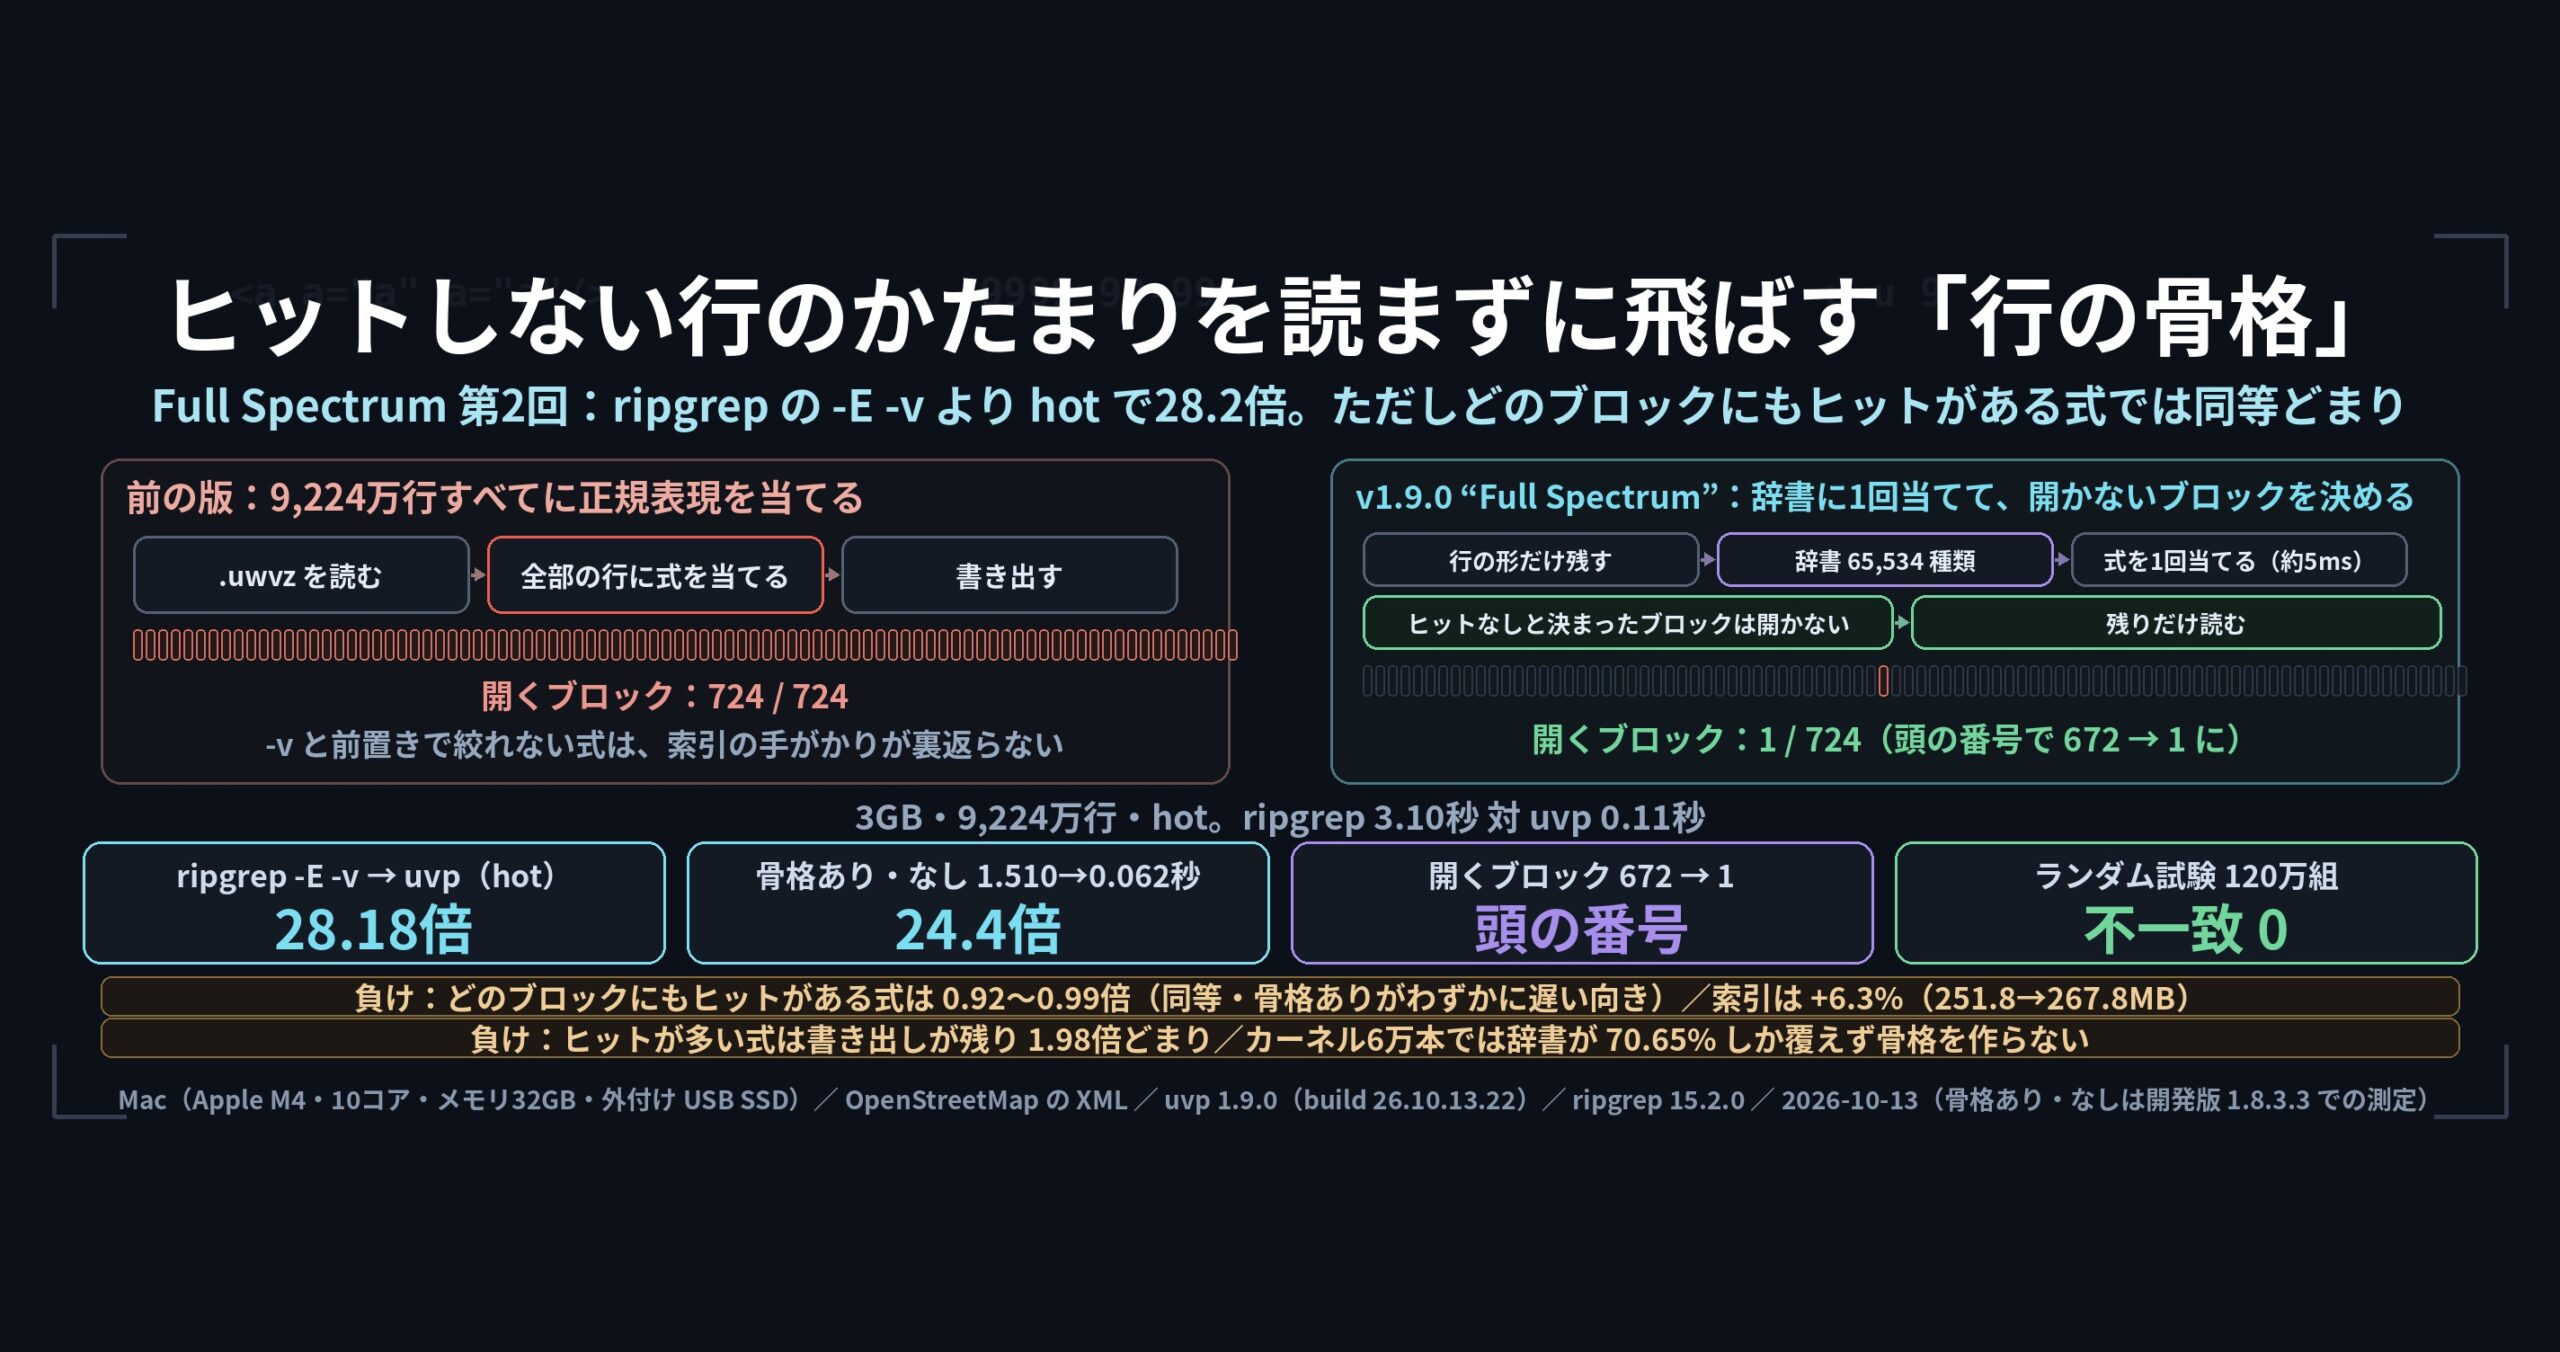
A7 だけ桁が違うのは、文字コードの話ではありません。 v1.9.0 には、ヒットしない行のかたまりを読まずに飛ばす仕組み(行の骨格)も入っていて、A7 のような式ではそれが効きます。文字コードの手当てだけで説明できるのは A1〜A6 の 5.44〜9.25倍のほうです。A7 の仕組みは、この連載の次の回で単独で書きます。
3つの文字コードをまとめると、2回分の合計で Shift-JIS 5.44〜29.11倍・EUC-JP 5.38〜23.26倍・UTF-16LE 8.06〜38.79倍。A7 を外せば 5.38〜16.50倍です。UTF-16 が大きく出るのは、元のファイルが2倍(5,765MB)あって ripgrep が毎回その全部を読むからで、uvp の索引は 262.3MB しかありません。
hot だけを見ると、文字コードによる差が消える
| Shift-JIS・hot(秒) | uvp | 参考: UTF-8 の元ファイルを探した uvp |
|---|---|---|
| A1 素の検索 | 0.15 | 0.15 |
A2 -i |
0.33 | 0.34 |
A3 -E |
0.30 | 0.32 |
A6 -v |
0.53 | 0.54 |
これが今回いちばん言いたいところです。索引の中が UTF-8 なら、元が Shift-JIS だったか UTF-8 だったかは、2回目以降の速さに出ません。 変換は索引を作る1回に閉じ込められました。
負け: -extract の退行と、補助漢字
-extract は一度遅くしました。 UTF-8 から元の文字コードへ書き戻す処理を1本の流れでやったため、Shift-JIS 2,887MB の戻しが 7.88秒。前の版(1.8.1.9・元のまま持っていたので変換なし)の 3.44秒に対して、前の版の方が 2.29倍速い状態です。8MB の塊ごとに展開と変換を並べ、順に書くように直して、hot の参考値で 1.03秒まで戻しました。塊の境目は UTF-8 の文字の切れ目に合わせ、後ろを3バイト余分に読んで前の塊が受け持ちます。v1.9.0 の計測では Shift-JIS 3.52秒・EUC-JP 3.51秒・UTF-16LE 6.71秒(cold で 3GB・6GB を書き出す分を含む)で、いずれも元とバイト一致で戻りました。
EUC-JP の補助漢字(JIS X 0212)は読めません。 「・」になります。試験用のデータも補助漢字を落として作っています。ヘルプにも書いてあります。
戻したものは、必ずしもバイト一致になりません。 同じ字に番号が2つある字(髙・﨑・№・Ⅲ など)は標準の番号で、壊れたバイトは「・」で戻ります。ハッシュで照合する用途には向きません。-info の「中の文字コード」の行で、何を変換したかは確かめられます。
持ち帰れる一般論: 索引は「読む回数」だけでなく「文字にする回数」も閉じ込められる
索引を持つ道具を作ると、最初に減らすのは読む回数です。ファイルを1回だけ読む。そこまでは分かりやすい。
ただ、読んだあとに毎回かかる変換が残っていると、索引の効きは途中で止まります。文字コードの変換、改行の数え直し、正規化、小文字化——どれも「読む」ではなく「文字にする」側の仕事です。これらは索引を作るときに1回だけやって、結果を索引の中に置けるものが多い。
その代わりに払うのは、位置が元のファイルとずれることです。だから、ずれた索引が元のファイルの画面やバイト一致の戻しと混ざらないように、道を1本に決めて他をふさぐ必要があります。どちらでも選べるようにすると、組み合わせの数だけ試験が増えます。今回「元のまま作る」指定を外したのは、速さのためではなく、この道の数を増やさないためでした。
uvp ならこう書く
uvp japan.sjis 東京                   # 1回目に .uwvz(UTF-8)を作って探す
uvp japan.sjis 東京                   # 2回目からは索引の中を探す(変換なし)
uvp japan.sjis -i HIGHWAY             # 大小を無視
uvp japan.sjis 'k="highway[^"]*"' -E  # 正規表現
uvp japan.sjis '="' -v                # 当てはまらない行
uvp japan.sjis -info                  # 中の文字コードと、元の文字コードを見る
uvp japan.sjis -extract back.txt      # 元の文字コードに戻して書き出す
uvf japan.sjis 東京                   # 無料版は索引を作らず、そのつど読む
終了コードは grep と同じで、0=ヒットあり・1=ヒットなし・2=エラーまたは結果が不完全です。無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
リンク
- v1.9.0「Full Spectrum」の公開告知(この版の全体像): https://uvp.y42u.net/blog/uwview-v190-full-spectrum/
- 前の連載の総まとめ(複数ファイル・圧縮7形式・zip・pbf): https://uvp.y42u.net/blog/uwview-wf15-wide-field-recap/
- 索引で「読む回数」を1回にするまで(First Light 総集編): https://uvp.y42u.net/blog/uwview-fl13-first-light-recap/
- 2回目の検索の4割を占めていた改行の数え方: https://uvp.y42u.net/blog/uwview-wf12-newline-hot/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、Shift-JIS の古いログや巨大なテキストを、2回目から一段速く探したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も速くなります(全 OS 対応・買い切り/月額プランあり・14日間の無料試用つき)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。