ヒットが、重い。
API のレスポンスをそのまま落としたファイルを開くと、改行が1つもない——そんな JSON に出会ったことがあると思います。行で区切られていないので、エディタもコマンドも「1行」として扱います。
では、そのとき遅くなるのは読むところでしょうか、それとも別のところでしょうか。
今回は改行のない1行のファイルを 1MiB から 1GiB まで4段用意し、同じファイルに対して「ヒットあり」と「ヒットなし」を分けて測りました。遅かったのは、走査ではないほうでした。
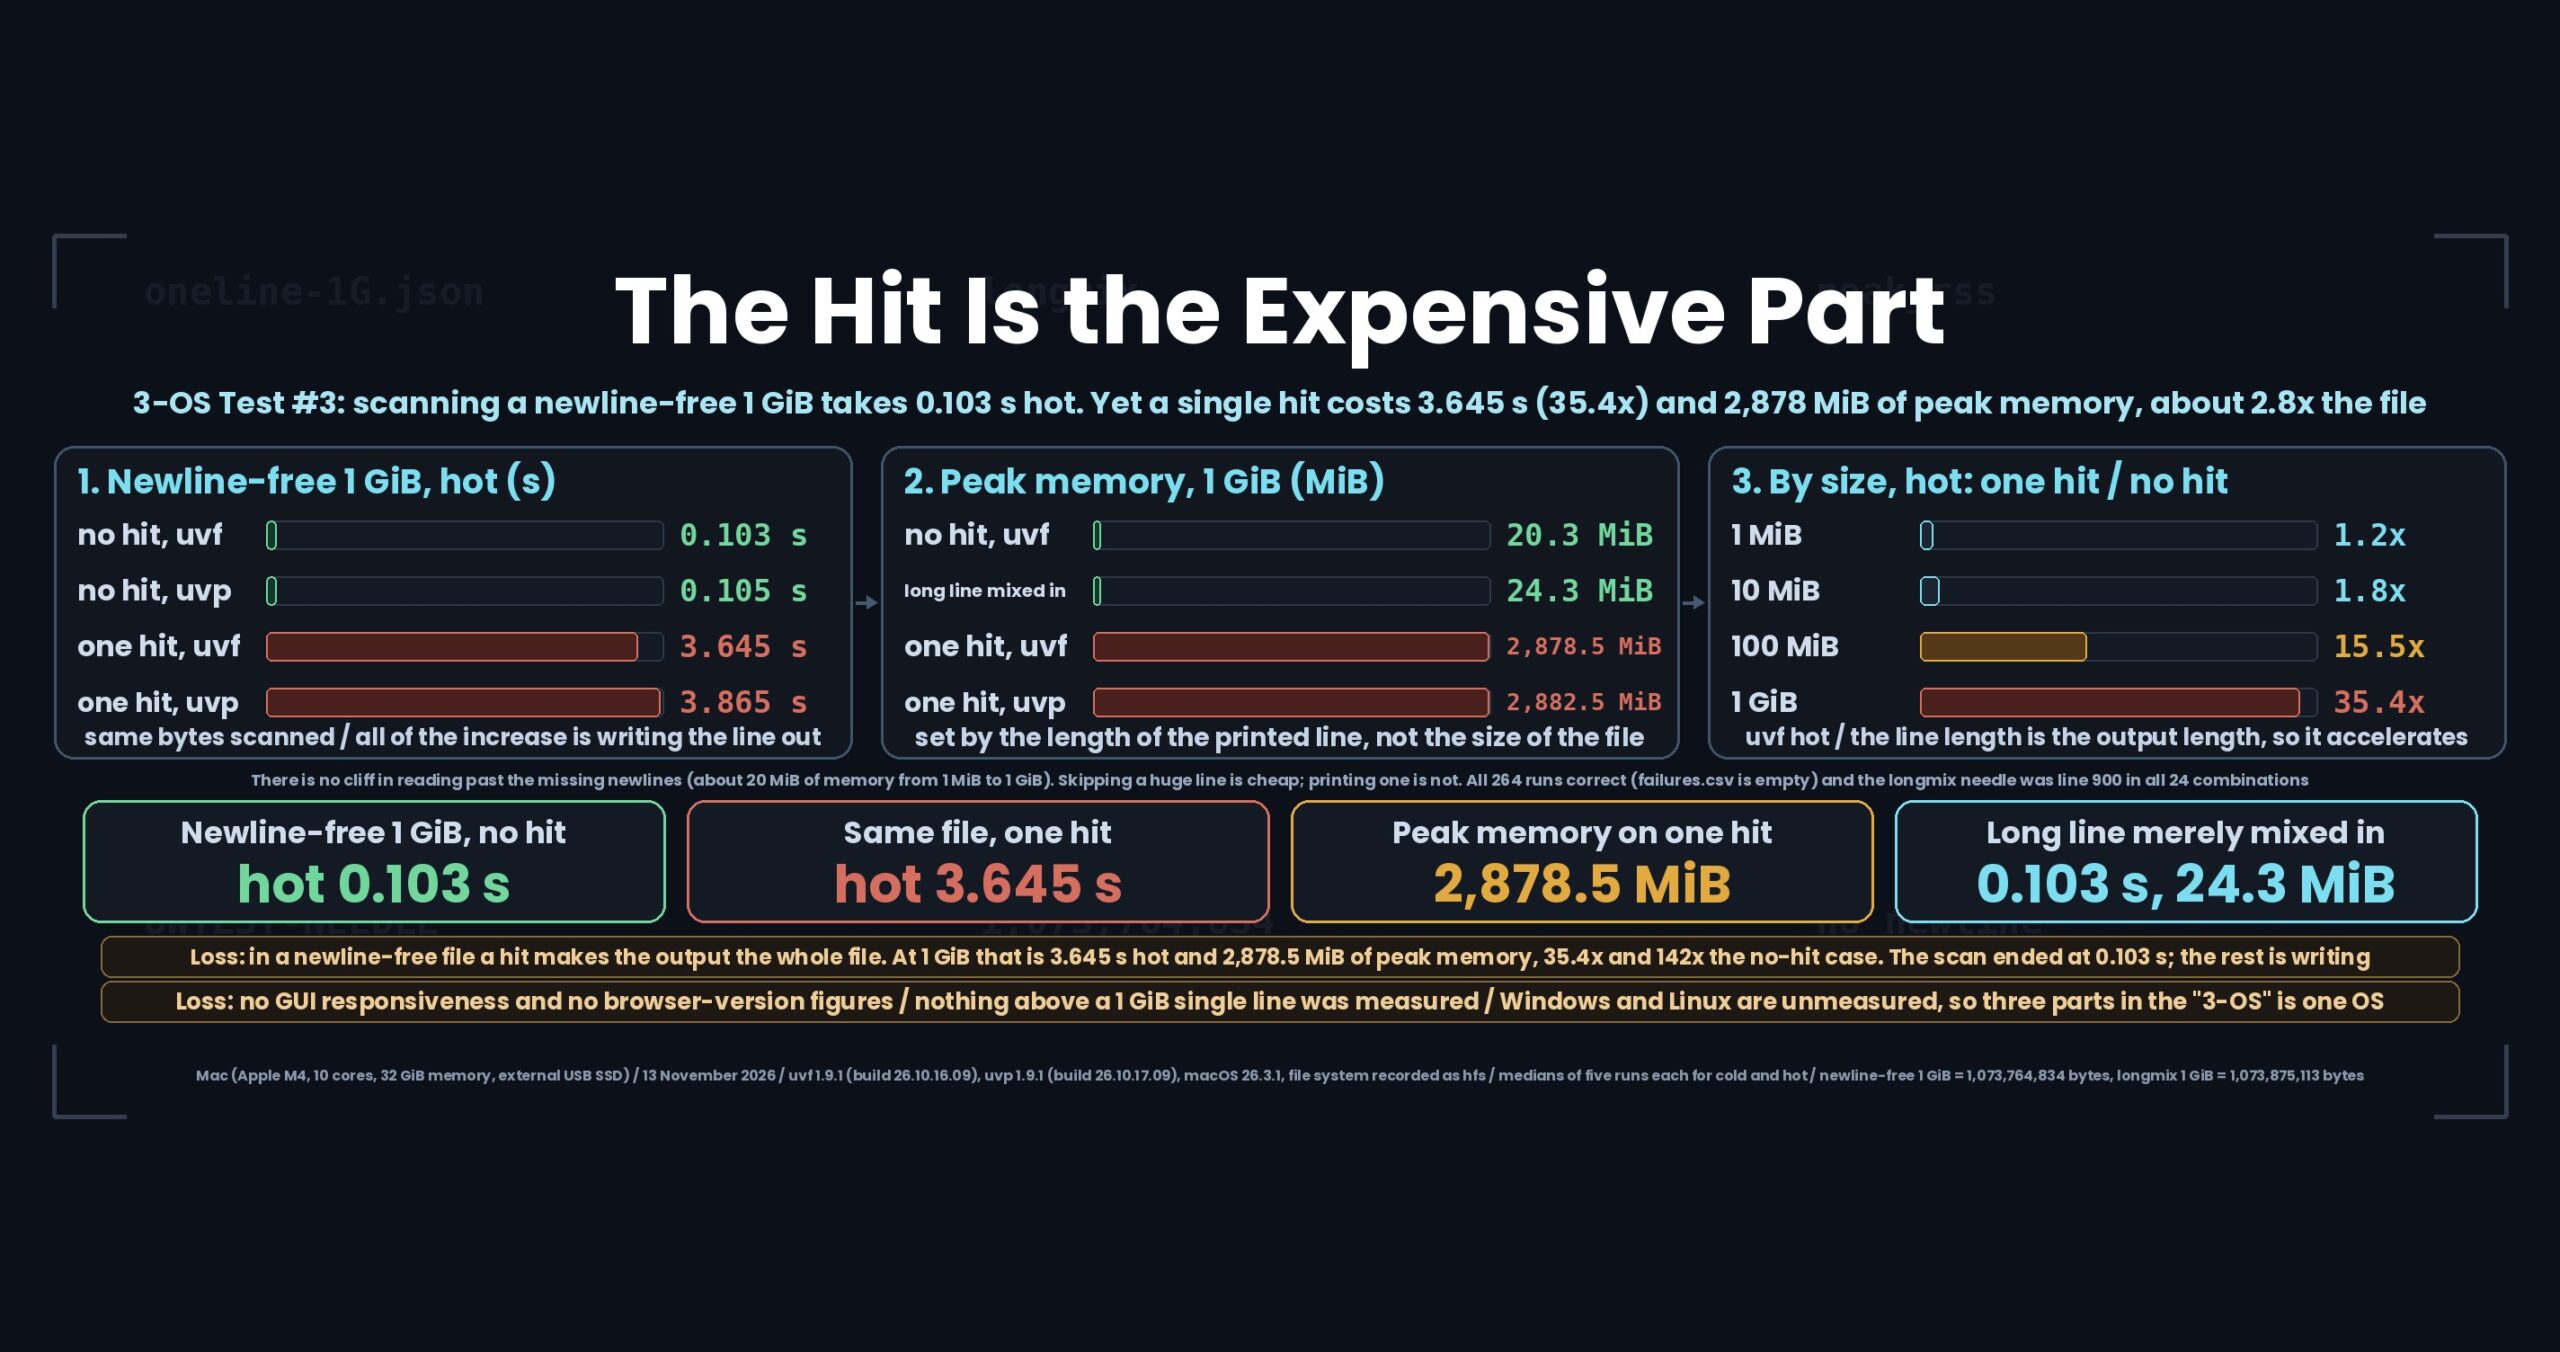
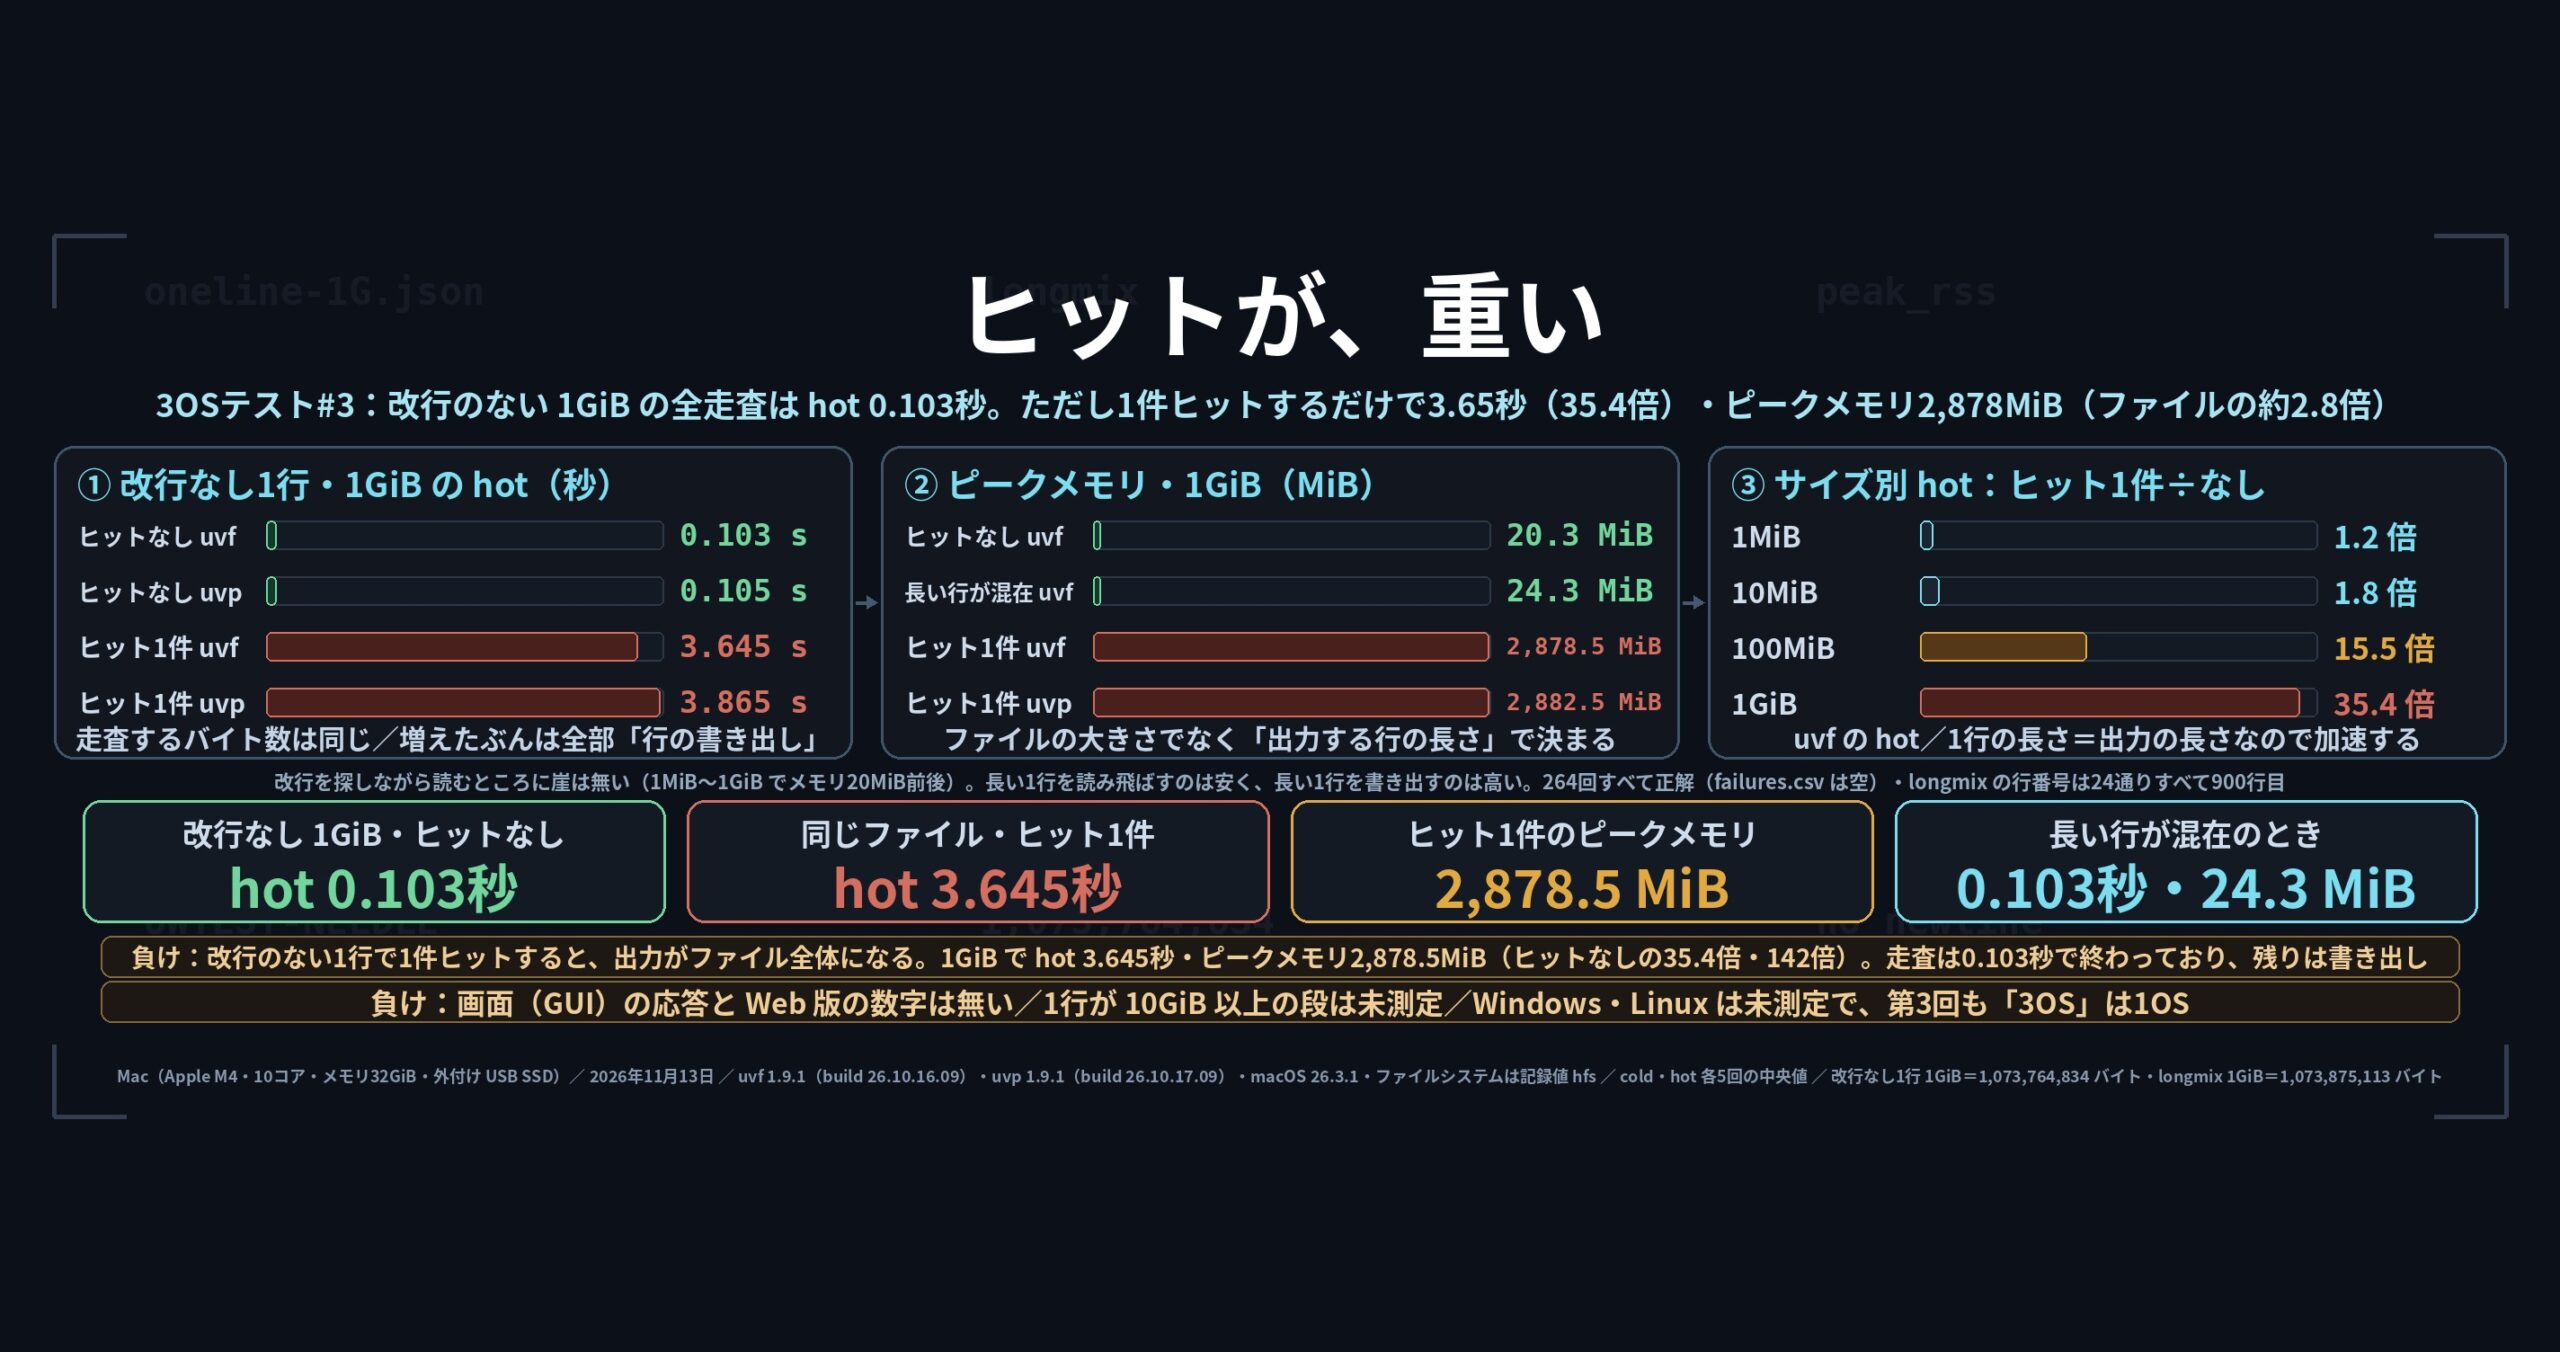
先に結論: ヒットなしなら 1GiB を hot 0.10秒で走査。ただし1件ヒットするだけで3.6秒、メモリは2,878MiB
負けを先に書きます。
改行のない1行で1件ヒットすると、同じファイルのヒットなしの約35倍かかります。 1GiB(1,073,764,834バイト)の1行ファイルで、ヒットなしの hot が uvf 0.103秒・uvp 0.105秒。末尾に UWTEST-NEEDLE を入れてヒット1件にすると、hot は uvf 3.65秒・uvp 3.87秒——35.4倍・36.8倍です。走査するバイト数は同じなので、増えたぶんは全部「ヒットした行を書き出す」ぶんです。その行が、ファイルほぼ全体なのですから。
ピークメモリも同じ理由で膨らみます。 ヒットなしの 1GiB では uvf 20.3MiB・uvp 24.4MiB で済んでいたものが、ヒット1件では uvf 2,878.5MiB・uvp 2,882.5MiB になりました。ファイルサイズ(1,024MiB)の約2.8倍、ヒットなしのときの約142倍です。100MiB の1行でも約300MiB(約3.0倍)でした。1行を丸ごとメモリに持つと、こうなります。
そのうえで、確かめられたことを並べます。
- 走査そのものは速いままでした。 改行のない 1GiB を全部読んでヒットなしと答えるまで、hot で uvf 0.103秒・uvp 0.105秒。改行で区切られた通常のログと同じ桁です。「改行がないと遅い」は、少なくとも走査には当てはまりません
- 長い1行が「混ざっている」だけなら、代償はありません。 1,000行のうち500行目だけが 1GiB の1行で、
UWTEST-NEEDLEは900行目——という形(longmix)では、hot が uvf 0.103秒・uvp 0.106秒、ピークメモリは uvf 24.3MiB・uvp 28.4MiB。長い行を読み飛ばすのは安いが、長い行を出力するのは高いという切り分けになります - 行番号はずれませんでした。
longmixの needle は900行目です。1GiB の1行をまたいだあとでも、24通りすべてで900行目として正しく報告されました - cold でも同じ向きです。 1GiB の1行で、ヒットなしの cold が uvf 2.78秒・uvp 2.88秒、ヒット1件では uvf 6.64秒・uvp 6.66秒。2.39倍・2.31倍。cold はディスクの読み出しが乗るので倍率は小さくなりますが、差は消えません
- 無料版 uvf と有料版 uvp は、このテストでは同等でした。 cold・hot の中央値を24通り見比べて、いちばん開いたのが 100MiB・ヒット1件の hot で1.29倍(uvf のほうが速い)。この連載の「1.5倍未満は同等」の線の中です
- 264回すべて正解でした。
failures.csvは見出しだけで中身がありません
uvfは無料版 UwView、uvpは有料版 UwView Pro の検索コマンドです。数字はすべて 2026年11月13日に Mac(Apple M4・10コア・メモリ32GiB・外付け USB SSD)で測った結果の CSV から採りました。版は uvf 1.9.1(build 26.10.16.09)・uvp 1.9.1(build 26.10.17.09)、macOS 26.3.1。この回は Mac だけで、Windows と Linux は未測定です。 cold・hot の作り方と数字の読み方は第0回で決めたとおりです。※ファイル容量の表記について:本記事の「1MiB」「10MiB」「100MiB」「1GiB」はバイト÷1024ⁿ の値です。実ファイルは生成器が作るので端数が付き、1GiB の1行ファイルは 1,073,764,834バイト(約1.0007GiB)です。各表に実バイト数を書きました。macOS の容量表示(SI・÷1000ⁿ)では 1.07GB と表示されます。
問題: 「改行がないと遅い」の、どこが遅いのか
改行のない巨大な1行は、ログの世界ではよくある形です。API のレスポンスを無加工で保存したもの、圧縮を考えて minify した JSON、1件のイベントを巨大な1オブジェクトで吐くサービス——いずれも改行が入りません。
こういうファイルが遅いという話はよく聞きます。ただ、どこが遅いのかは曖昧なまま語られがちです。候補は3つあります。
- 読むところ。改行を探しながら読むので、改行が無いと何かが壊れるのではないか
- 行に切るところ。1行の長さが分からないまま読み進めるので、バッファの作り直しが起きるのではないか
- 出すところ。ヒットした行を表示するとき、その「行」がファイル全体なのではないか
このうち 3 は考えれば当たり前ですが、数字で何倍になるのかは測らないと分かりません。1 と 2 が効いているのかも、分けて測らないと分かりません。
そこで今回は、同じファイル・同じ走査量で、ヒットの有無だけを変えた組み合わせを作りました。ヒットなしの時間は「読む+行に切る」までの代金、ヒットありとの差は「出す」ぶんの代金です。さらに、長い1行がファイル全体である場合と、1,000行の中に1本混ざっている場合を分けました。
テスト条件
機械(この回は Mac だけ)
| 機械のラベル | 中身 | メモリ | 保存先 | ファイルシステム | 種類 |
|---|---|---|---|---|---|
mac-m4-32g-usbssd |
MacBook Air(Apple M4・10コア) | 32GiB | 外付け USB SSD | hfs(記録値) |
実機 |
linux-vmware-fusion |
— | — | — | — | 未測定 |
win11-16g |
— | — | — | — | 未測定 |
OS は macOS 26.3.1(arm64)、仮想化なし。ファイルシステムは結果の env.json に hfs と記録されました。
この回に Linux と Windows の値はありません。 連載の決まりで新しく測るのは Mac だけ、他の2つは以前に測った値を使うことにしていますが、改行のない巨大な1行のテストには以前の値がありません。 したがって VMware の割り当ても今回は該当しません。第3回の時点でも、連載名の「3OS」はまだ1OS です。
データ
2種類あります。どちらも生成器が種を固定して作るので、どの OS で作っても同じバイト列になります。
oneline-<サイズ>.json — 改行が1つもない1行(末尾の改行もなし)。JSON のいちばん最後に UWTEST-NEEDLE が入っています(ヒット1件のケース)。ヒットなしのケースでは、入っていない語を探しました。
longmix-<サイズ>.log — 普通のログ行1,000行のうち500行目だけが指定サイズの長い1行の JSON で、UWTEST-NEEDLE は900行目(普通の長さの行)にあります。
| ファイル | バイト数 | SHA-256 |
|---|---|---|
oneline-1M.json |
1,048,676 | 70041ee8569592e4… |
oneline-10M.json |
10,486,036 | 39d2b4bf7e029c32… |
oneline-100M.json |
104,859,953 | a4ef6156e2b5d59f… |
oneline-1G.json |
1,073,764,834 | e6f7c2f8b0bdf625… |
longmix-1M.log |
1,158,358 | 5c8c58434bdb574c… |
longmix-10M.log |
10,595,795 | 78ed288a8fa084bc… |
longmix-100M.log |
104,969,777 | c6b342caeb0ac36c… |
longmix-1G.log |
1,073,875,113 | 51860c8eb92e24ef… |
データは配布しません。作ったあと SHA-256 で照合してから測っています。
測り方
12通りのケース(4サイズ × oneline ヒットあり/oneline ヒットなし/longmix)を、uvf と uvp の両方で回しました。cold・hot それぞれ5回測って中央値を採り、「そのセッションで最初の1回」は first として分けています。cold は毎回 sync のあと sudo purge、hot は記録しない空回しを1回入れてから5回です。正解は、終了コードとヒットの数が期待どおりのときだけ ok です。
first は1回しか測っていないので、この記事では製品どうしの比には使いません(小さいサイズでは最大2.9倍開きますが、これは1回測りのばらつきです)。
結果
表1: 改行のない1行・ヒットなし(Mac のみ・秒)
出力は0行、終了コードは1です。「読む+行に切る」までの代金です。
| サイズ | バイト数 | uvf cold(秒) | uvf hot(秒) | uvp cold(秒) | uvp hot(秒) | uvf ピークメモリ(MiB) | uvp ピークメモリ(MiB) |
|---|---|---|---|---|---|---|---|
| 1MiB | 1,048,676 | 0.167 | 0.0068 | 0.175 | 0.0085 | 16.3 | 20.4 |
| 10MiB | 10,486,036 | 0.184 | 0.0084 | 0.210 | 0.0103 | 20.3 | 24.5 |
| 100MiB | 104,859,953 | 0.425 | 0.0173 | 0.433 | 0.0191 | 20.3 | 24.4 |
| 1GiB | 1,073,764,834 | 2.78 | 0.103 | 2.88 | 0.105 | 20.3 | 24.4 |
改行が1つもない 1GiB を、hot で0.10秒。 ピークメモリは 1MiB のときから 1GiB まで20MiB前後で動きません。改行を探しながら読むところに、崖はありませんでした。
表2: 同じファイル・ヒット1件(Mac のみ・秒)
表1 と同じサイズ・同じ走査量です。違いは、末尾の UWTEST-NEEDLE が見つかって、その「行」=ファイル全体が出力されることだけです。
| サイズ | バイト数 | uvf cold(秒) | uvf hot(秒) | uvp cold(秒) | uvp hot(秒) | uvf ピークメモリ(MiB) | uvp ピークメモリ(MiB) |
|---|---|---|---|---|---|---|---|
| 1MiB | 1,048,676 | 0.157 | 0.0080 | 0.179 | 0.0101 | 18.2 | 22.3 |
| 10MiB | 10,486,036 | 0.206 | 0.0150 | 0.191 | 0.0161 | 48.5 | 52.5 |
| 100MiB | 104,859,953 | 0.661 | 0.269 | 0.695 | 0.348 | 299.5 | 303.6 |
| 1GiB | 1,073,764,834 | 6.64 | 3.65 | 6.66 | 3.87 | 2,878.5 | 2,882.5 |
同じ製品の中で、表1 と表2 を割ったのがこの記事の答えです。
| サイズ | hot:ヒット1件 ÷ ヒットなし | cold:ヒット1件 ÷ ヒットなし | ピークメモリ:ヒット1件 ÷ ヒットなし |
|---|---|---|---|
| 1MiB | uvf 1.2倍・uvp 1.2倍 | uvf 0.9倍・uvp 1.0倍 | uvf 1.1倍・uvp 1.1倍 |
| 10MiB | uvf 1.8倍・uvp 1.6倍 | uvf 1.1倍・uvp 0.9倍 | uvf 2.4倍・uvp 2.1倍 |
| 100MiB | uvf 15.5倍・uvp 18.2倍 | uvf 1.6倍・uvp 1.6倍 | uvf 14.8倍・uvp 12.4倍 |
| 1GiB | uvf 35.4倍・uvp 36.8倍 | uvf 2.4倍・uvp 2.3倍 | uvf 142倍・uvp 118倍 |
小さいうちは見えません。10MiB で1.8倍、100MiB で15倍、1GiB で35倍。1行の長さがそのまま出力の長さになるので、効き方が加速します。
表3: 長い1行が1,000行の中に混ざっている(Mac のみ・秒)
UWTEST-NEEDLE は900行目——長い行ではないほうにあります。走査量は表1・表2 とほぼ同じです。
| サイズ | バイト数 | uvf cold(秒) | uvf hot(秒) | uvp cold(秒) | uvp hot(秒) | uvf ピークメモリ(MiB) | uvp ピークメモリ(MiB) |
|---|---|---|---|---|---|---|---|
| 1MiB | 1,158,358 | 0.166 | 0.0072 | 0.157 | 0.0084 | 16.5 | 20.5 |
| 10MiB | 10,595,795 | 0.190 | 0.0087 | 0.200 | 0.0103 | 24.3 | 28.4 |
| 100MiB | 104,969,777 | 0.429 | 0.0177 | 0.442 | 0.0194 | 24.3 | 28.4 |
| 1GiB | 1,073,875,113 | 2.85 | 0.103 | 2.84 | 0.106 | 24.3 | 28.4 |
表1(ヒットなし)とほとんど同じ数字です。 1GiB の hot は uvf 0.103秒・uvp 0.106秒、ピークメモリは uvf 24.3MiB・uvp 28.4MiB。1GiB の長い1行がファイルの中にあるだけなら、読み飛ばす代金はほぼゼロでした。表2 の 3.65秒・2,878MiB と比べると、同じ 1GiB の1行が、出力に入るかどうかで35倍・142倍変わることになります。
そして行番号です。 1GiB の1行をまたいだあとの900行目を、longmix の24通りすべてで900行目として報告しました。長い行の途中でバッファを作り直しても、行の数え方が崩れた形跡はありません。
メモリは「いちばん長い1行」で決まる
ピークメモリをもう一度並べます。1GiB のケースだけです。
| ケース | uvf(MiB) | uvp(MiB) | ファイルに対して |
|---|---|---|---|
oneline-1G ヒットなし |
20.3 | 24.4 | 約 0.02倍 |
longmix-1G(長い行は出力しない) |
24.3 | 28.4 | 約 0.02倍 |
oneline-1G ヒット1件 |
2,878.5 | 2,882.5 | 約 2.8倍 |
ファイルの大きさではなく、出力する行の長さでメモリが決まっています。 2.8倍という係数は、1GiB の文字列を持って書き出すまでに作業用の複製が1つか2つできている形です。32GiB のメモリなら 1GiB の1行は通りますが、その先は今回測っていません。
負け: 「1件見つけただけ」で35倍になる
1つめ。改行のない巨大な1行は、ヒットした時点で出力がファイル全体になります。 これが今回の負けです。1GiB で hot 3.65秒、ピークメモリ 2,878MiB。走査は0.10秒で終わっているのに、残りの3.5秒は書き出しです。ヒット件数は1件なのに、です。
言い換えると、改行のないファイルの検索は「見つかったら高い」という性質を持ちます。普通のログならヒット1件の代金はその1行ぶん、1行しかないファイルではファイル1個ぶんです。
2つめ。画面(GUI)の応答は数字にしていません。 測ったのはコマンドの検索時間だけです。手順書には「開いて1行目の末尾へ移動し、検索して、窓が応答し続けるか見る」という手作業の項目がありますが、無人の計測では回せていません。1行100MiB の JSON を画面で開いて快適かは、この記事では答えられません。
3つめ。10GiB 以上の1行は測っていません。 今回の最大は 1GiB の1行です。メモリの係数が約2.8倍なら、10GiB の1行は 32GiB のメモリに収まらない見込みですが、見込みを数字として書くことはしません。 境目がどこかは、測ってから書きます。
4つめ。Web 版の数字がありません。 今回あるのは uvf と uvp のコマンドの時間だけです。
正しさ: 264回すべて ok、失敗は0件
速さの前に、答えが合っていたかです。
12通りのケース × 2製品 = 24通りを、first 1回・cold 5回・hot 5回の計264回回して、すべて ok でした。failures.csv は見出しの1行だけで、中身がありません。
oneline-*-needle: ヒット1件・終了コード0。改行のないファイルなので、報告される行番号は1行目ですoneline-*-nohit: ヒット0件・終了コード1。264回のうち88回がこれで、全部0件でしたlongmix-*-needle: ヒット1件・終了コード0・行番号は900。長い1行をまたいでも数え間違いなし- cold と hot で結果が変わった回はありません。 速くなっただけです
連載の弱点の一覧には現在10件が載っていますが、このテストからの追加はありません。 10件はすべて文字コード・改行の種類・日本語の文字・異常系に関するもので、第4回以降で扱います。改行のない1行については、遅いという弱点はあっても、間違えるという弱点は出ませんでした。
持ち帰れる一般論: 改行のないファイルを扱うときの4つ
1つめ。「出力の量」を先に見積もります。 改行のないファイルでは、ヒット1件の出力がファイル全体になりえます。検索する前に「見つかったら何が出てくるか」を考え、端末に直接流さないようにします。ファイルに書くか、head -c で先頭だけ見るか、件数だけ数えるかです。道具は問いません。
2つめ。「件数だけ」のモードを使います。 多くの検索コマンドには、ヒットした行を出さずに件数やファイル名だけを返す指定があります。改行のない1行では、これが35倍の差になります。「あるかどうか知りたいだけ」なら、出力を切るのが一番効きます。
3つめ。メモリは「いちばん長い1行」で見積もります。 ファイルサイズではありません。今回の係数は、出力する1行の長さの約2.8倍でした。道具を選ぶ前に、awk '{ if (length($0) > m) m = length($0) } END { print m }' で最長行を調べておきます。
4つめ。長い1行が「混ざっている」のは怖くありません。 1,000行のうち1本だけ巨大という形は実務でよくありますが、今回の数字ではほぼ無料でした(1GiB の長い行を含むファイルで hot 0.10秒・メモリ24MiB)。怖いのは、その長い行がヒットしたときだけです。
uvp ならこう書く
今回のテストで実際に使った書き方です。改行のない1行のための特別なオプションはありません。普通に渡すだけです。
# 改行のない1行の JSON を検索する(ヒット1件 = ファイル全体が出力される)
uvf oneline-1G.json UWTEST-NEEDLE
有料版はコマンド名だけが変わります。
uvp oneline-1G.json UWTEST-NEEDLE
ただし上は、1GiB の行がそのまま端末に流れます。 実務では出力を切ります。件数だけなら -c、ファイル名だけなら -l です。
# 件数だけ(改行のない1行では、これが35倍の差になる)
uvf oneline-1G.json UWTEST-NEEDLE -c
uvp oneline-1G.json UWTEST-NEEDLE -c

# ヒットしたファイル名だけ
uvf *.json UWTEST-NEEDLE -l
uvp *.json UWTEST-NEEDLE -l
行の中身がどうしても見たいときは、先頭だけ取ります。
uvf oneline-1G.json UWTEST-NEEDLE | head -c 2000
uvp oneline-1G.json UWTEST-NEEDLE | head -c 2000
長い1行が混ざったファイルで、長い行を避けて探すこともできます。正規表現(-E)で行の長さを縛るやり方です。
# 300文字までの行だけを対象にする
uvf longmix-1G.log '^.{0,300}UWTEST-NEEDLE' -E
uvp longmix-1G.log '^.{0,300}UWTEST-NEEDLE' -E
無料版は GitHub Releases から入ります(Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop、Linux は Snap)。
再現方法
この回のテストの手順は、公開リポジトリーにあります。記事と食い違っていたら、向こうが正しいと思ってください。
- 数字の読み方と cold・hot の作り方の決まり: https://github.com/amru195704/UwView/blob/main/testsuite/docs/00-rules.md
- 改行のない巨大な1行の回の手順(このテストの元): https://github.com/amru195704/UwView/blob/main/testsuite/docs/04-longline.md
- 弱点の一覧: https://github.com/amru195704/UwView/blob/main/testsuite/weak-points.md
- 一式のフォルダー: https://github.com/amru195704/UwView/tree/main/testsuite
自分の機械で回すなら、tools/gen.py の --set longline でデータを作り、tools/check.py data で SHA-256 を照合してから tools/run.py を走らせます。1GiB の段まで作ると作業用の空きが5GB ほど必要です。結果のフォルダー(results/ の下)は、この記事の時点では未公開です。
リンク
- 第0回(cold と hot の作り方・数字の読み方): https://uvp.y42u.net/blog/uwview-xt00-rules/
- 第1回(1GiB から 100GiB まで・1億行と10億行): https://uvp.y42u.net/blog/uwview-xt01-1gb-to-100gb/
- 第2回(cold と hot はどれだけ違うか・5回の幅): https://uvp.y42u.net/blog/uwview-xt02-cold-vs-hot/
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
次回(第4回)は文字コードです。総当たりで読み込ませて、自動判定が何を外すか、改行コードと BOM で行数がどこでずれるかを見ます。
そして、改行のない巨大な JSON を何度も開いて探すなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も毎回ゼロからにならずに済みます(全 OS 対応・買い切りと月額の2通り・14日間の無料試用つき。料金は価格ページをご覧ください)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。