【追記 2026-10-16】いまの速さ — v1.9.0 でも、2回目は ripgrep と同等のままです
本文の数字は 1.7.3.6.8・1.7.3.6.9(2026年10月3〜4日)のものです。同じ Mac で、いまの版 v1.9.0(2026年10月13日)を測りました。
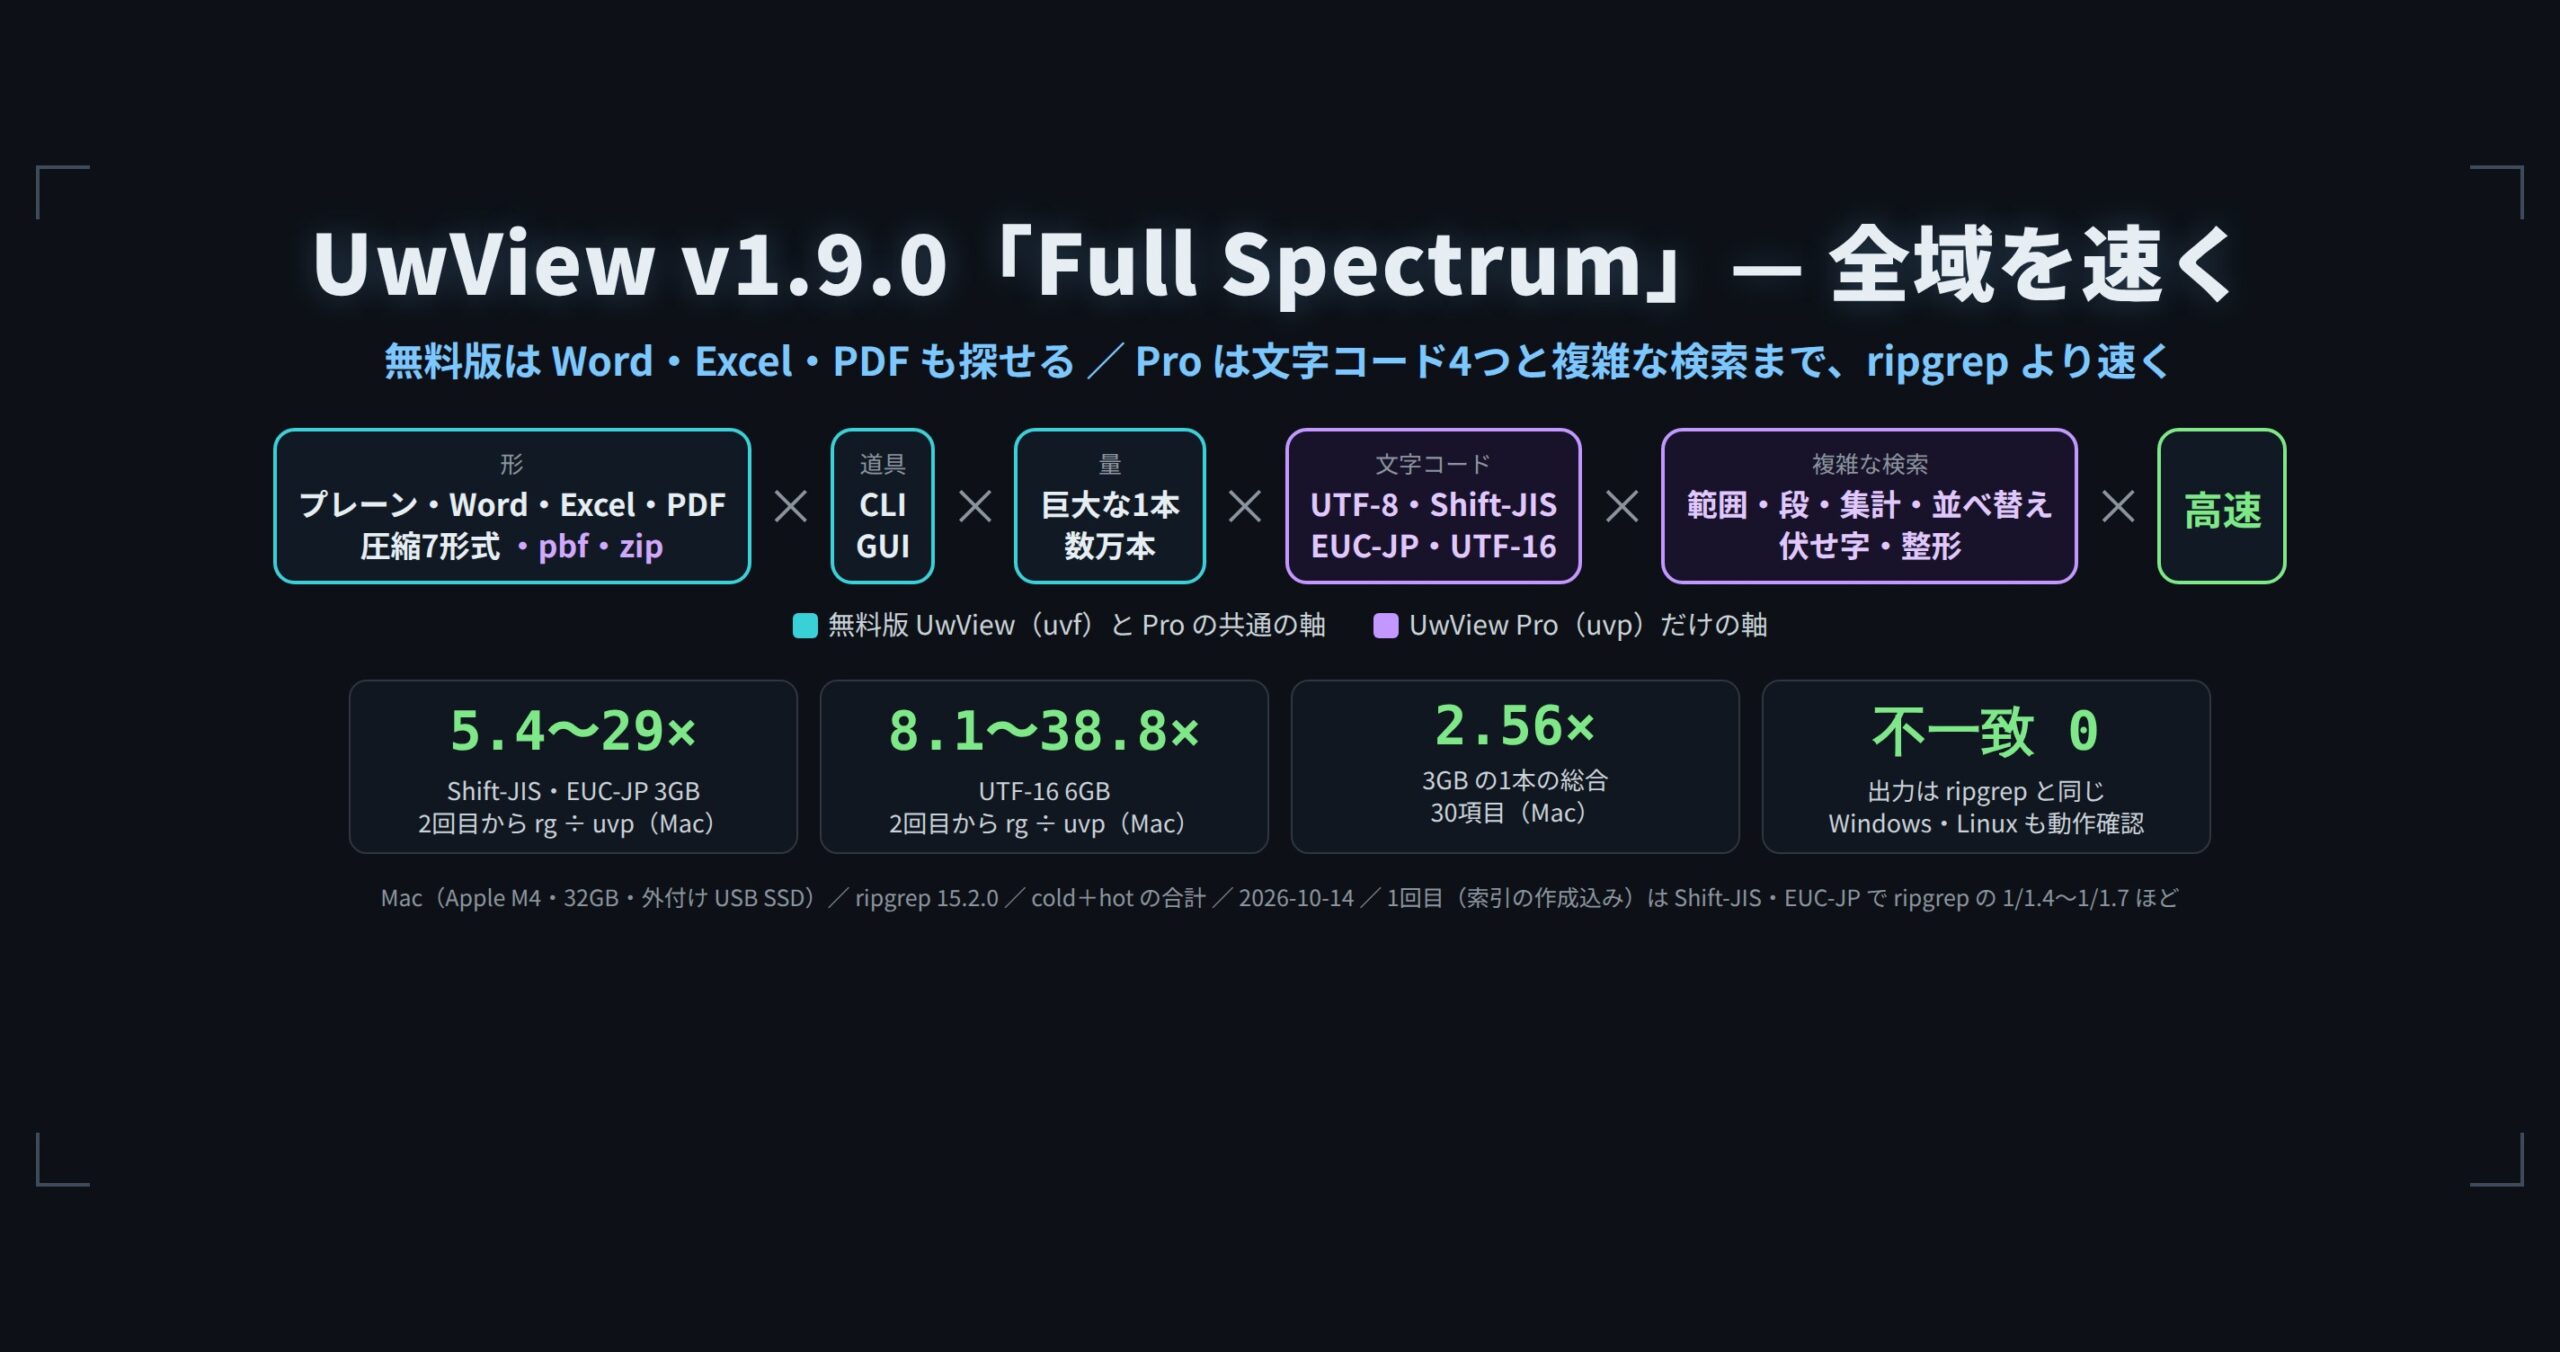
ripgrep ÷ 無料版 uvf(2回目)本文(1.7.3.6.8〜1.7.3.6.9) いま(v1.9.0) 3GB 文字列 1.07〜1.11倍(0.27秒) 1.07倍(0.29秒 対 0.31秒) 検索7種の2回目の合計(3GB/10GB) 1.20/1.19倍 1.22/1.19倍 参考: uvp・3GB 文字列— 1.8倍(0.17秒) 本文の結論は変わりません。2回目から大きく速くしたいときは、索引を持つ
uvpです(検索7種で ripgrep の 3.44倍・3GB)。詳しくはベンチマークとv1.9.0「Full Spectrum」の記事。
改善記⑪で、こう書きました。
「改行を数える速さは、外付け SSD から読む限り秒数に出ない。媒体が速くなったときに初めて効く準備だ」
その「速い媒体」は、新しい機材ではありませんでした。**同じファイルを2回目に探すときの、メモリ(ページキャッシュ)**です。
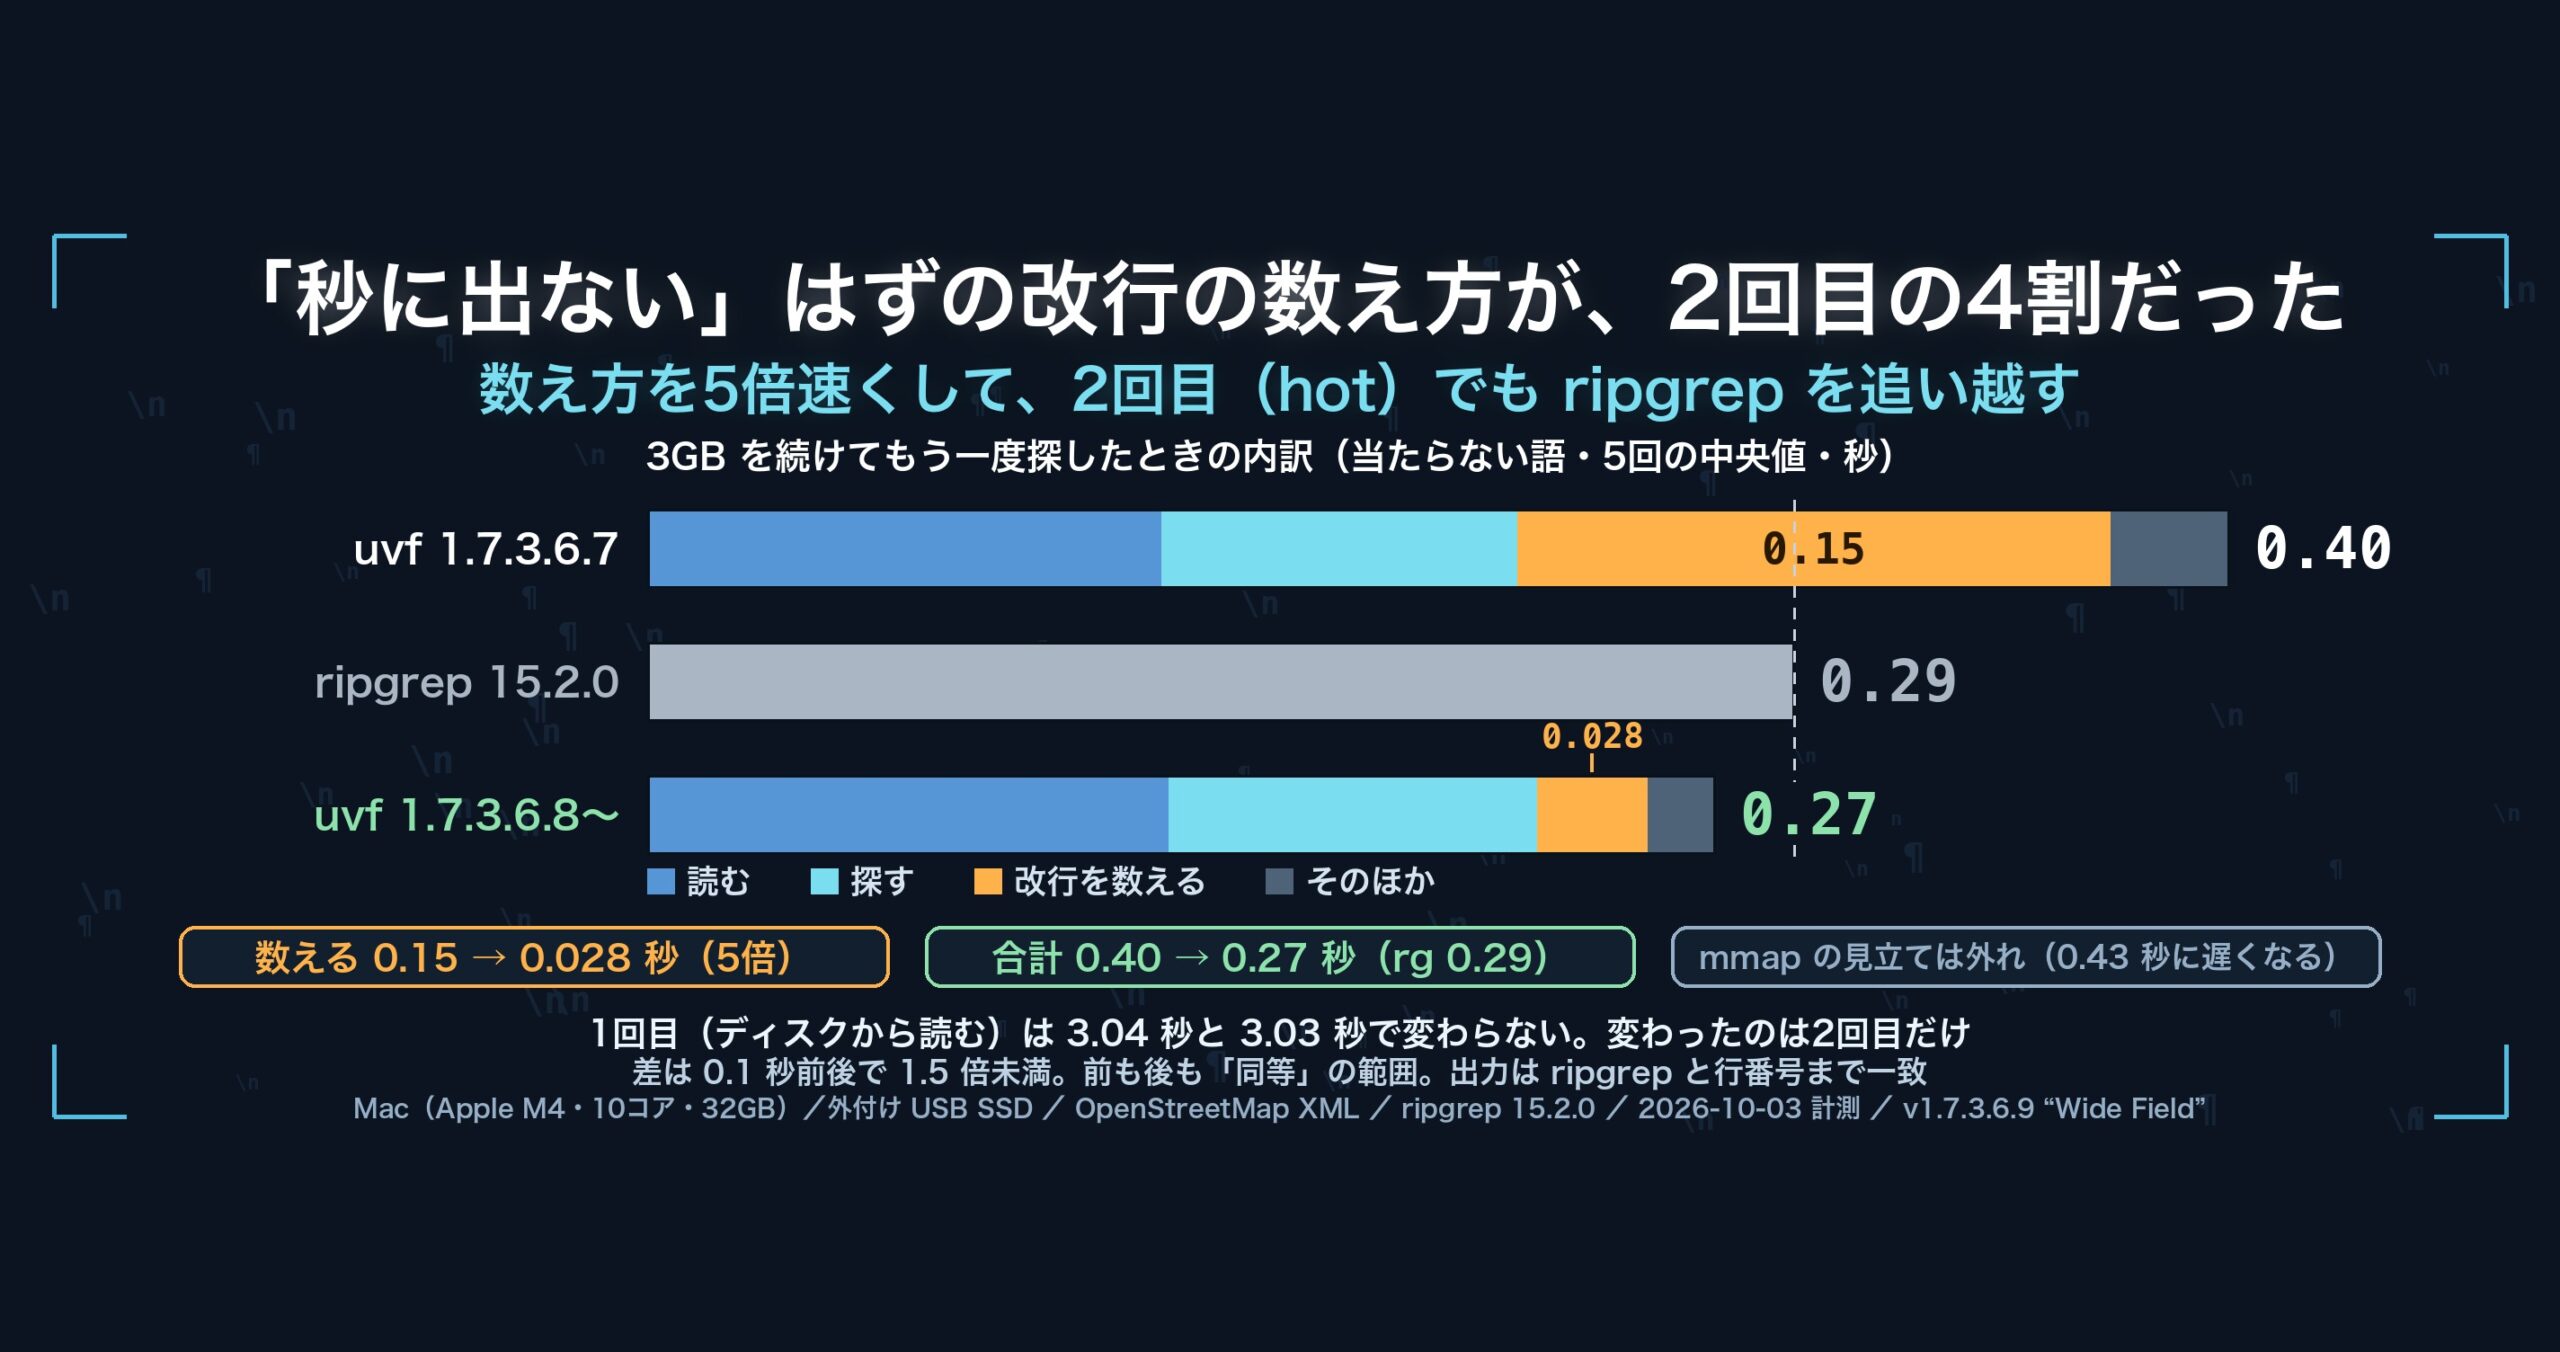
- 先に結論: 同じファイルを続けて探す2回目(hot)で、uvf は ripgrep より 1.3〜1.4倍遅いままでした。内訳を測ると、3GB で 0.40秒のうち 0.15秒が「行番号のために改行を数える」処理でした。数え方を、16バイトずつ改行と比べた結果をそのまま足し込む形に替えて 0.15秒 → 0.028秒(5倍)。2回目は **3GB 0.40 → 0.27秒(ripgrep 0.29)、10GB 1.28 → 0.85秒(ripgrep 0.95)**になり、ripgrep を追い越しました。1回目(ディスクから読む)は変わりません
- 先に、負けていたところを書きます
- 見立ては4つ
- 測ってみると、当たったのは H1 だけでした
- 遅かったのは「数えること」より「数え方」
- 数字: 2回目は ripgrep を追い越し、1回目は変わらない
- 正直に書いておくこと
- 持ち帰れる一般論: 「秒に出ない」は、条件つきの言葉
- 使っている道具
- リンク
先に結論: 同じファイルを続けて探す2回目(hot)で、uvf は ripgrep より 1.3〜1.4倍遅いままでした。内訳を測ると、3GB で 0.40秒のうち 0.15秒が「行番号のために改行を数える」処理でした。数え方を、16バイトずつ改行と比べた結果をそのまま足し込む形に替えて 0.15秒 → 0.028秒(5倍)。2回目は **3GB 0.40 → 0.27秒(ripgrep 0.29)、10GB 1.28 → 0.85秒(ripgrep 0.95)**になり、ripgrep を追い越しました。1回目(ディスクから読む)は変わりません
uvfは私が作っている UwView(v1.7.3.6.9 “Wide Field”・2026年10月4日)の無料の検索コマンドです。この改修は 1.7.3.6.8 で入りました。Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap の XML で測っています。
先に、負けていたところを書きます
1回目(キャッシュを捨てた直後)は、前の版から uvf のほうが ripgrep より少し速いのです。ディスクの速さで頭打ちになるので、読み方(pread で 4MB ずつ)の差が出ます。
ところが2回目(ファイルがメモリに載った状態)は、ずっと負けていました。
| 2回目(hot)・3回の中央値・秒 | ripgrep | uvf 1.7.3.6.7 |
ripgrep との比 |
|---|---|---|---|
3GB 東京 |
0.28 | 0.38 | 1/1.36 |
| 3GB 当たらない語(0件) | 0.28 | 0.40 | 1/1.43 |
10GB 東京 |
0.94 | 1.29 | 1/1.37 |
| 10GB 当たらない語(0件) | 0.92 | 1.25 | 1/1.36 |
差は 0.1〜0.35秒です。人には分かりません。1.5倍未満なので、この連載の決まりでは「同等」です。
それでも気になりました。3GB と 10GB で比が同じなので、起動の時間ではなく読む速さそのものの差です。10GB で ripgrep は毎秒 約 10GB、uvf は 約 7.4GB。しかも当たりが 0 件でも同じ差なので、出力ではなく「読んで探す」部分にあります。
見立ては4つ
| # | 見立て | 確かめ方 |
|---|---|---|
| H1 | 行番号のために、読んだバイトの改行を全部数えている(当たりが無くても) | 数えないで走らせる |
| H2 | pread でページキャッシュからコピーする分(ripgrep は mmap で直接読む) |
mmap で読ませる |
| H3 | 4MB のブロックが CPU のキャッシュより大きく、読む・探す・数えるの間に落ちる | ブロックを小さくする |
| H4 | 起動・後始末の固定分 | 空のファイルを探す |
先に直し方を考え始めると、どれも「効きそう」に見えます。なので、直す前に、時間の内訳を出す仕掛けを入れました(UV_TRACE=1 で、読む・探す・数える・出すの合計を表示します)。
測ってみると、当たったのは H1 だけでした
3GB・当たらない語・2回目・5回の中央値です。
| 測ったもの | 3GB | 10GB | 分かったこと |
|---|---|---|---|
| 空のファイル | 0.02 | — | H4 は外れ |
| 前の版 | 0.40 | 1.28 | 内訳:読む 0.13・探す 0.09・数える 0.15 |
数えない(UV_NOCOUNT=1・測るためだけ) |
0.24 | 0.76 | 数える分を抜くと ripgrep より速い |
mmap で読む(UV_SOURCE=mmap) |
0.43 | 2.03 | 遅くなる。H2 は外れ |
| ブロック 256K・1M・4M・16M | 0.27〜0.30 | — | 大きさで変わらない。H3 は外れ |
ripgrep / rg --no-mmap |
0.29 / 0.29 | 0.95 / 0.95 | ripgrep も mmap の有無で変わらない |
H2 は、私がいちばん「ありそう」と思っていた見立てでした。 「ripgrep は mmap でコピーせずに読むから速い」。もっともらしい話です。ところが rg --no-mmap でも 0.29秒で同じでした。こちらを mmap にすると、むしろ遅くなりました(毎回ページを割り当て直す分)。もっともらしい話を、測る前に直していたら、遅くする改修を入れていたところです。
そして、数える処理は 0.15秒。2回目の検索全体の 4割でした。
ripgrep も、行番号の分を払っている
3GB 東京・2回目 |
行番号あり | 行番号なし |
|---|---|---|
| ripgrep | 0.30 | 0.24 |
ripgrep も、行番号を出すと約2割遅くなります。どちらも払っている費用で、払い方が違っていた、ということです。
遅かったのは「数えること」より「数え方」
uvf は改行を .NET の Span.Count で数えていました。これ自体、内部でまとめて比べる(SIMD の)作りです。改善記⑪のときは 1バイトずつの数え方から、IndexOf で跳ぶ形にしましたが、こちらの道(uvf の検索)は前から Span.Count でした。
それでも 3GB で 0.15秒。毎秒 約 20GB です。外付け SSD(毎秒 約 0.97GB)から読む1回目なら、20倍の余裕があって秒には出ません。ページキャッシュから読む2回目は、その余裕が無かったわけです。
替えた数え方は、こうです。
- 16バイトずつ、改行(
\n)と比べる。合ったバイトは「−1」(全ビットが 1)、合わないバイトは 0 になる - その結果を、バイトのまま足し込み先から引く(−1 を引く=1 を足す)。足し込み先は 16個の 1バイトの数
- 1バイトの数は 255 であふれるので、255回ごとにまとめて合計する
// 64 バイトずつ、4 つの足し込み先に分けて引く。255 周ごとに合計する
a0 -= Vector128.Equals(Vector128.LoadUnsafe(ref start, (nuint)i), newline);
a1 -= Vector128.Equals(Vector128.LoadUnsafe(ref start, (nuint)(i + 16)), newline);
...
total += Sum(a0) + Sum(a1) + Sum(a2) + Sum(a3);
比べた結果を毎回「何個合ったか」に直す処理を、255回に1回にしただけです。**3GB で 0.15秒 → 0.028秒(5倍)**になりました。数える分は、数えないとき(0.24秒)との差で 0.03秒しか残っていません。
「探すのと数えるのを1回の読みで済ませる」という、もっと大きな直し方も候補にありました。読むのが2回のままでも、数えるのが5倍速くなった時点で目標に届いたので、手間と危うさの小さいほうで止めました。
数字: 2回目は ripgrep を追い越し、1回目は変わらない
2回目・5回の中央値・秒(開発機・2026年10月3日)
| 検索 | 前(1.7.3.6.7) | 後(1.7.3.6.8) | ripgrep | ripgrep との比(後) |
|---|---|---|---|---|
| 3GB 当たらない語 | 0.40 | 0.27 | 0.29 | 1.07 |
3GB 東京 |
0.40 | 0.27 | 0.30 | 1.11 |
3GB -E 'k="highway[^"]*"' |
0.53 | 0.42 | 0.50 | 1.19 |
3GB -E '^ *<tag k="name"' |
0.45 | 0.33 | 0.45 | 1.36 |
| 10GB 当たらない語 | 1.28 | 0.85 | 0.95 | 1.12 |
10GB 東京 |
1.40 | 0.88 | 0.96 | 1.09 |
- 1回目は変わりません(3GB
東京:前 3.04秒・後 3.03秒)。ディスクから読む速さで決まるからです。 -v(当たらない行を出す)は別の道を通るので、変わりません(3GB 1.32秒)。- 出力は前後で1バイトも変わらず、行番号を含めて ripgrep と完全に一致しています。数え方のテストには、乱数のデータで素朴な数え方と一致すること、64バイトと 255回の切れ目、全部が改行のデータ、CR は数えないこと、を入れました。
オーナーのテスト一式(キャッシュを捨てて 10秒待つ → 1回目 → 続けて2回目・2026年10月4日・1.7.3.6.9)でも、同じ傾向でした。
| 7つの検索の2回目の合計・秒 | ripgrep | uvf |
|---|---|---|
| 3GB | 7.60 | 6.31 |
| 10GB | 12.58 | 10.61 |
正直に書いておくこと
- 差は 0.1秒前後で、1.5倍未満です。 前も後も、この連載の基準では「同等」です。人が待って分かる差ではありません。
- 改善記⑪の「数え方の改善は秒に出ない」は、1回目(ディスクから読む)については今も正しいです。外れていたのは「媒体が速くなるのは、機材が変わるとき」という思い込みのほうでした。同じ機械でも、2回目はメモリが媒体になります。
- 改善記⑪で入れた
IndexOfは画面の索引作りの道で、今回のSpan.Count→ 足し込みはuvfの検索の道です。別の処理です。 - 50GB はメモリ(32GB)に収まらないので、2回目もディスクから読みます。この改修は効きません。
- UwView Pro の
uvpでは、1本のファイルを読みながら索引を作る1回目と、複数のファイルを束ねるときの行数の数えに効きます。索引(.uwvz)を探す道と画面の検索は、この数え方を使っていないので変わりません。 - 前後の比較は開発機での5回の中央値、テスト一式はオーナーの1回ずつの測定です。数字はすべて Mac(Apple M4・10コア)・メモリ 32GB・外付け USB SSD・OpenStreetMap XML での例です。秒数を環境またぎで比べないでください。
- 私は自分の製品について書いています。その分は割り引いてお読みください。
持ち帰れる一般論: 「秒に出ない」は、条件つきの言葉
(1)律速は、条件ごとに測り直す。 1回目はディスク、2回目はメモリ、50GB の2回目はまたディスク。同じコマンドでも、どこで詰まっているかは条件で入れ替わります。改善記⑪の結論は、1回目の条件で測ったものでした。
(2)直す前に、内訳を出す。 4つの見立てのうち、私がいちばん信じていた H2(mmap)は外れで、直していたら遅くなっていました。内訳を出す仕掛けは、出荷ビルドに残しています(UV_TRACE=1)。
(3)相手の「速い理由」を、推測で決めない。 「ripgrep は mmap だから速い」は、rg --no-mmap を1回走らせれば確かめられることでした。
(4)いちばん小さい直し方で、目標に届いたら止める。 読みを1回にまとめる大きな直し方は、行番号がずれる危うさと引き換えです。数え方の差し替えなら、比べる相手(素朴な数え方)がはっきりしています。
使っている道具
UwView は巨大テキスト・巨大ログのビューアです(無料版 UwView/有料版 UwView Pro)。
# 2回目の内訳を見る(読む・探す・数える・出すの合計が標準エラーに出る)
UV_TRACE=1 uvf huge.log NO_SUCH_WORD

# ripgrep と同じ答えかを先に確かめる
uvf huge.log 'ERROR' > mine.txt
rg -n 'ERROR' huge.log > theirs.txt
終了コードは grep と同じで、0=あり・1=なし・2=エラーまたは結果が不完全です。
無料版は GitHub Releases から。Mac は brew install --cask amru195704/uwview/uwview、Windows は Scoop(scoop bucket add uwview https://github.com/amru195704/scoop-uwview → scoop install uwview)でも入ります。
リンク
- 改善記⑪: 改行を1.88倍速く数えられるようにしたのに、秒数は1秒も動かなかった: https://uvp.y42u.net/blog/uwview-fl11-newline-vs-media/
- 改善記⑩: mmap は順次読みで帯域の6割しか出ない: https://uvp.y42u.net/blog/uwview-fl10-mmap-vs-pread/
- 測って分かった「差」の下限(1.5 倍未満を差と呼ばない理由): https://uvp.y42u.net/blog/uwview-fl09-difference-threshold/
- ripgrep と正規表現の書き方はどこまで同じか: https://uvp.y42u.net/blog/uwview-wf09-regex-vs-ripgrep/
--jsonと--tune: https://uvp.y42u.net/blog/uwview-wf11-json-and-tune/- v1.7.3.6.9 のリリースノート: https://github.com/amru195704/UwView/blob/main/2-doc/release-body-v1.7.3.6.9.md
- 実測の全データ(ベンチマーク一覧): https://uvp.y42u.net/benchmarks/
- ソースコード(GitHub): https://github.com/amru195704/UwView
そして、ストレージを専有している巨大ログを圧縮して保管し、さらに高速に検索したいなら UwView Pro をどうぞ。永続索引・圧縮キャッシュ検索・約 1/9 保管で、開き直しも検索も一段速くなります(全 OS 対応・買い切り/月額プランあり)。
開発者より: アプリ・Kindle 本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。